Pull to refresh
16K+
66
Стас Выщепан@gandjustas

Оптимизирую программы

42,1
Rating
114
Subscribers
Send message

Как ломается модульный монолит и как с этим бороться
Level of difficultyHard
Reading time23 min
Reach and readers5.5K

В микросервисах логические границы удерживаются границами процесса и хранилища. Для пересечения надо явно написать удаленный вызов, сделать контракт и обновить как минимум два сервиса. В монолите нет механизма контроля логических границ. Одна часть кода в любой момент может сослаться на другую, сборка и тесты это пропустят. Даже в рантайме может может все работать без ошибок. Но таких ссылок станет много и монолит превратится в big-ball-of-mud.

Эти же явные границы микросервисов помогают настраивать деплой. Структура сервисов и их зависимости видны в коде (не всегда очевидно, но всегда явно) и “случайно” их нарушить сложно. В модульном монолите структура деплоя не отражена вообще.

В прошлой статье я описал как сделать контроль зависимостей между модулями в рантайме, но хотелось бы раньше. Закончил статью списком поломок, которые не замечают ни сборка, ни локальная отладка.

В этой статье я покажу как превратить ошибки нарушения границ и деплоя в ошибки компиляции и красные тесты.
Читать далее

Модульная модель данных в EF Core

Level of difficultyMedium
Reading time14 min
Reach and readers6.3K

В прошлой статье мы разобрали какие средства для создания модульных приложений есть в ASP.NET. Каждый модуль может регистрировать свои сервисы и использовать свои эндпоинты и страницы. Но данные у каждого модуля свои.

На практике даже если у каждого модуля своя база данных, то живут они все на одном сервере (кластере). Причин этому несколько. Во-первых серверы баз данных гораздо проще и дешевле масштабировать горизонтально, чем вертикально. Во-вторых один сервер баз данных вполне может обслужить десяток веб-серверов сравнимой мощности, если запросы оптимальные, на веб-серверы используют кэширование, а аналитическая нагрузка идет на реплики.

Поддерживать разные хранилища данных для разных модулей когда у вас весь проект пилит одна команда, а в эпоху ИИ — один AI-инженер, выглядит совсем плохой идеей.

Поэтому сегодня разберем как сделать модульную модель данных, когда каждый модуль видит свое подмножество сущностей, а хост собирает это все в одну базу данных.

Читать далее

Модульный монолит в ASP.NET из коробки

Level of difficultyMedium
Reading time15 min
Reach and readers6.3K

Прошлую статью я закончил на том, что Google в 2023 году выпустил фрейморк для модульных приложений Service Weaver. Можно писать и запускать приложение как монолитное, а потом в конфиге указать какие компоненты на каких машинах запускать и приложение становилось распределенным.

Вы удивитесь, но в ASP.NET встроена модульность начиная с версии Core 2.0 (2017 год). Вы можете сделать сделать приложение которое загружает сервисы, контроллеры, страницы и даже EF модели из разных сборок в один хост. Все это собирается в один исполняемый образ. Переменная окружения при запуске задает какие модули загружать.

Загрузили все модули — получили монолит, в котором заказы и клиенты джойнятся одним SQL-запросом. Оставили в одном контейнере модуль заказов, а в другом модуль клиентов — получили два сервиса, которые ходят друг к другу по HTTP. Пересобирать ничего не нужно, в Program.cs нет ни слова о модулях, а всё целиком запускается и отлаживается по F5. Решение «резать или не резать» становится обратимым.

Все это без единого стороннего NuGet-пакета — только ASP.NET Core и EF Core. В конце разберём, почему у Google то же самое не взлетело, и какую цену за «из коробки» придётся заплатить.

Читать далее

Модульность без микросервисов: почему она того стоит

Level of difficultyEasy
Reading time14 min
Reach and readers7.7K

Монолит пилят на микросервисы вводят ради четырёх обещаний: производительности, отказоустойчивости, чистых границ и независимых релизов. А потом оказывается, что команда одна, база одна, язык один, а сервисов больше, чем разработчиков, — и ни одно из обещаний толком не выполняется.

Это не только моё впечатление. Инженеры Google во главе с Санджаем Гемаватом, соавтором MapReduce и Bigtable, разобрали, почему микросервисы не дают того, ради чего их вводят, и пришли к выводу, что некоторые их проблемы прямо противоречат обещанным выгодам. Для проверки они сложили в один процесс настоящий интернет-магазин из 11 микросервисов и получили в 9 раз меньше ядер и в 14 раз меньшую задержку.

Я повторил опыт на самом простом примере, какой смог придумать, — функции, которая складывает два числа. Через HTTP и gRPC её вызов стоит в 3,5 раза больше CPU и памяти, чем прямой, через RabbitMQ — в 6,3 раза. Бизнес-логики там ноль: это цена одного только вызова.

А потом проверил на настоящем .NET-приложении — eShop, эталонном микросервисном приложении Microsoft. После перевода на модули оно занимает в 4 раза меньше памяти, вместо десяти развёртываемых единиц стало три, RabbitMQ не понадобился, а кода стало на 39% меньше. По дороге нашлись несколько дефектов исходной версии, которые возникали из-за несогласованности кода сервисов.

Ниже разберём каждое из четырёх обещаний и посмотрим, что происходит на практике.

Читать далее

Очередь на Postgres: масштабирование, inbox и сравнение с Kafka и RabbitMq

Level of difficultyMedium
Reading time19 min
Reach and readers5.8K

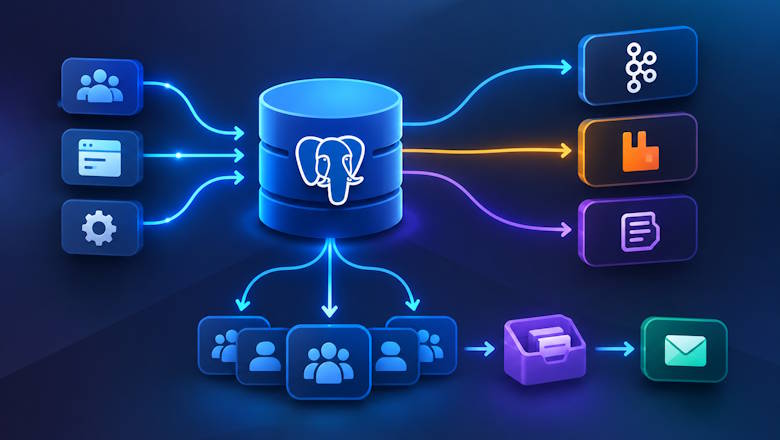
В прошлой статье я утверждал, что Kafka не нужна, если событие и результат бизнес-операции пишутся в PostgreSQL одной транзакцией. Только ленивый не написал Главное Возражение в комментариях: слот логической репликации не делится между читателями, каждый вычитывает журнал целиком — значит, читатели и станут узким местом.

Я решил проверить это утверждение. Сравнить сколько ресурсов потребляют консьюмеры очередей по сравнению сравнению с чтением логической репликации при увеличении их количества.

Это не вердикт по выбору транспорта: в конце будут условия, при которых брокер нужен, и они следуют из тех же цифр.

Читать далее

Оптимизируем отпуск как инженеры: искусство продавать выходные

Level of difficultyMedium
Reading time15 min
Reach and readers4.8K

Каждую осень HR просит запланировать отпуска на следующий год. Обычно люди сразу берут между майскими, кто-то подбирает даны под день народного единства, а многие просто ставят на декабрь, чтобы потом двигать можно было.

А я задался вопросом - можно ли найти оптимальный отпуск под запросы и открыл VS Code\Jupiter с F# (пока оно еще работает). Всё живёт в Jupyter-ноутбуке с ядром .NET Interactive — да, F# умеет в ноутбуки, питонисты, не ревнуйте.

Спойлер: солвер нашёл способ заработать на отпуске 85 тысяч. Мне не понравилось.

Читать далее

Сортировка слиянием, часть 2

Level of difficultyHard
Reading time13 min
Reach and readers9.3K

Это продолжение статьи «Сортировка слиянием — не так просто, как кажется». Там я довёл тестовое задание — отсортировать 100 ГБ строк вида число. текст за час — до 32 минут: пайплайн из пяти стадий на Channels, Brotli, sort keys во временных файлах. Сортировка, конечно же, с учетом культуры.

Прошлое решение мне не нравилось: много низкоуровневой возни, бенчмарки показывали, что отдельные части можно сделать лучше, но увязать их вместе было нетривиально. Самое главное, что на случайных строках решение никак не укладывалось в один час.

Год назад, когда появилось время, я начал переделывать решение. Даже сделал черновик поста, но переработка затянулась, а пост по таймеру опубликовался сам, когда я забыл переставить дату.

Итог: 100 ГБ случайных строк (худший случай для сжатия) на обычном HDD — за 52 минуты.

Рассказываю, как код к этому пришёл: тут и предложение из комментариев, которое сработало слишком хорошо, и CSR-раскладка, которую подсказал ИИ, и малоизвестные части .NET.

Читать далее

Как и зачем я сделал свой маппер

Level of difficultyEasy
Reading time16 min
Reach and readers5.3K

Я не люблю Clean Architecture, не люблю DTO и не люблю мапперы.

Они превращают сохранение одной строки в базу в путешествие через четыре проекта, три слоя абстракций и папку Mappings, в которую никто не заглядывал со времён первого коммита. Чтобы добавить одно поле на форму, надо поменять сущность, DTO, команду, валидатор, профиль маппинга и тест на профиль маппинга. Шесть файлов ради одной колонки. А если в одном из них забыть, никто ничего не скажет.

Поэтому я, конечно же, написал маппер.

Если серьёзно, то есть два места, где проблема настоящая. В этой статье я расскажу, что это за места, почему популярные мапперы их нормально не закрывают и что я в итоге с этим сделал.

AI SLOP WARNING. Большую часть кода этой библиотеки написали нейросети, как и 98% текста этой статьи. Я ставил задачи, проверял и исправлял. Если вас это оскорбляет - дальше можно не читать, ничего хорошего вас там не ждёт.

Читать далее

Очередь на Postgres: почему Kafka не нужна

Level of difficultyMedium
Reading time8 min
Reach and readers8.7K

Это история про архитектуру одного сервиса. Рассказанная до конца, а не только до того места, где обычно останавливаются статьи про архитектуру. Намеренно упрощена бизнес-логика, чтобы не размывать основной смысл.

Сервис принимал запрос, писал строку в базу, отвечал 201. Никто не пишет статей про такой код, потому что в нём нечего обсуждать.

Рано или поздно один сервис перестаёт быть одним сервисом. Появляется второй, которому важно узнать о том же событии — обсчитать аналитику, обновить поисковый индекс, отправить письмо. Возникает соблазн просто дёрнуть его по HTTP, и это первая ошибка, которую все совершают и все же исправляют: синхронный вызов делает вас настолько же надёжным, насколько надёжен самый хрупкий из ваших соседей.

Значит нужно асинхронно, через брокер. И почти всегда этим брокером оказывается Kafka.

Читать далее

Ваш кэш в Redis неэффективен, что с этим делать?

Level of difficultyMedium
Reading time21 min
Reach and readers9K

Однажды в проде контейнеры одного из сервисов начали падать по OutOfMemory. Контейнерам было выделено по 4 ГБ оперативной памяти, нагрузка была вполне обычной: десятки страниц в секунду.

Расследование показало, что проблема была в JSON-конфиге.

Схема была стандартная. В базе данных хранился JSON. При запросе приложение доставало его из базы, выполняло дополнительную обработку — заполнение вычисляемых полей, обогащение справочниками — и сохраняло результат в Redis. Подавляющее большинство пользователей запрашивало один и тот же JSON и ходило за ним в Redis.

Из-за ошибки в обработке закэшированный JSON распухал до десятков мегабайт. В кэш писались не только нужные поля, но и вложенные коллекции, история изменений, сериализованные справочники.

Казалось бы, если мы запрашиваем один и тот же JSON, размер не должен так критично влиять.

Но всё оказалось интереснее…

Читать далее

Merge для IAsyncEnumerable<T>

Level of difficultyMedium
Reading time10 min
Reach and readers8.3K

В рамках одного из обсуждении с чатах я предложил использовать функцию Merge для  IAsyncEnumerable<T>, чтобы объединить результаты чтения однотипных данных из разных источников. Но когда попытался сделать пример оказалось что такой функции в System.Linq.Async нет. Есть аналог в Reactive Extensions, но тащить библиотеку для одного примера не захотел и решил написать сам.

Читать далее

Система резервации заказов на Postgres, продолжение

Level of difficultyHard
Reading time8 min
Reach and readers6.8K

В комментариях к предыдущему посту "Система резервации на 600 заказов в секунду без буферизации и другой дичи" только ленивый не упомянул явные блокировки в Postgres, как способ борьбы с дедлоками.

Это не удивительно, так как select for update - очень популярный прием во всех СУБД, даже на Хабре есть статья на эту тему.

Что же окажется быстрее?

Система резервации на 600 заказов в секунду без буферизации и другой дичи

Level of difficultyHard
Reading time23 min
Reach and readers11K

Я прочитал статью, и меня поразило, сколько сомнительных решений можно использовать для одной простой задачи.

В этой статье я расскажу, как правильно создать сервис для конкурентных обновлений остатков данных в базе данных. Буду использовать .NET, C#, Entity Framework и PostgreSql.

Читать далее

Сортировка слиянием — не так просто, как кажется

Reading time20 min
Reach and readers38K

В одной конторе соискателю на позицию Senior C# developer выдали тестовое задание: отсортировать файл со строками определенного формата.

Требования такие:

* Формат строки: число, точка, пробел, далее любые символы до конца строки.

* Порядок сортировки — сначала сортируем текстовой части строки, потом по числу если текстовые части совпадают.

* Кодировка — UTF-8.

* Размер файла — 100гб - гарантированно больше объема ОП.

Должно отработать за 1 час на машине проверяющего, вряд ли там будет супер-быстрый SSD и огромное количество оперативной памяти.

Как и многие другие программисты, узнав о таком тестовом задании, я возмутился. Внешнюю сортировку слиянием практически всех проходили в ВУЗе, но практически никто никогда не писал её. Задача очень непрактическая и непонятно какие навыки проверяет. Так мне казалось.

Эта задача вызвала бурные обсуждения о способах её решения. Многие программисты, причисляющие себя к рангу senior, предложили использовать базы данных, ибо не барское это дело - вручную писать алгоритмы сортировки. Некоторые даже попытались сделать решение на Apache Spark. Однако никто до конца задачу не решил, ибо мало кому удалось отсортировать в нужном порядке даже 10ГБ файл менее чем за 15 минут без SSD.

Я подумал, что стоит решить задачу до конца с помощью программирования, и тоже причислить себя к рангу senior developer.

Читать далее

Воины и волшебники, часть пятая, финал

Reading time7 min
Reach and readers3.7K

В последних четырех эпизодах мы изо всех сил пытались закодировать правила нашей бизнес-области — которые, напомню, могут быть волшебниками и воинами, заказами и оплатами или чем-то еще — в систему типов C#. Выбранный нами инструмент, кажется, сопротивляется нашим попыткам, и поэтому, возможно, самое время сделать шаг назад и спросить, на правильном ли мы пути.

Фундаментальной идеей в первом и втором эпизодах было использование системы типов для обнаружения и предотвращения нарушений правил предметной области во время компиляции. Эта попытка в значительной степени потерпела неудачу из-за сложности представления подтипа с ограничением, например, «Волшебник — это игрок, который не может использовать меч. В нескольких наших попытках мы закончили тем, что выбрасывали исключения, так что правило применялось средой выполнения, а не компилятором.

В третьем и четвертом эпизодах этой серии мы увидели, что также было трудно понять как вызвать правильный код для обработки различных конкретных правил, а также куда поместить этот код. Даже если оставить в стороне проблемы с очень многословным и сложным шаблоном посетителя и опасным шаблоном динамического вызова, у нас все еще есть фундаментальная проблема: почему «Паладин в церкви атакует оборотня с мечом» является ответственностью одного из этих типов, а не другого?

Читать далее

Воины и волшебники, часть четвертая

Reading time4 min
Reach and readers3.1K

В прошлой статье мы увидели что для одинарной диспетчеризации, то есть выбора метода по типу времени выполнения одного аргумента, мы можем использовать виртуальные методы. Для двойной диспетчеризации мы можем использовать шаблон проектирования с неподходящим названием "Посетитель". Он работает, но имеет недостатки. Он тяжеловесный, сложный для понимания и плохо расширяется для множественной диспетчеризации.

Прошлый раз я сказал, что C# не поддерживает двойную диспетчеризацию. Это была наглая ложь! На самом деле C# поддерживает множественную диспетчеризацию. Вы можете выбрать метод на основании типа времен выполнения любого количества аргументов.

Читать далее

Воины и волшебники, часть третья

Reading time6 min
Reach and readers4.3K

Итак, давайте отвлечемся на несколько эпизодов. Мы временно оставим в стороне проблему того, как мы можем иметь и Игрока с Оружием, и Волшебника с Посохом (или Кинжалом). Предположим, что мы можем все это представить в виде типов.

У нас есть еще одна проблема. Предположим, у нас также есть классы Оборотней и Вампиров, которые являются разновидностью Монстров. Нам нужно правило, которое гласит, что если Воин попытается ударить Оборотня после полуночи, то вероятность успеха будет снижена. (У волшебников нет такого штрафа, потому что… магия?)

Подождите минутку — разве текущий момент времени это не после полуночи всегда? Короче, когда можно безопасно кормить могваев? Хотя это увлекательная проблема, я уверен, что это не та проблема, о которой я хочу говорить сегодня.

Читать далее

Воины и волшебники, часть вторая

Reading time4 min
Reach and readers4.8K

В этой серии мы исследуем проблему «игрок может использовать оружие, волшебник — разновидность игрока, посох — разновидность оружия, а волшебник может использовать только посох». Лучшее решение, которое мы придумали до сих пор — выдать нарушение преобразования типа во время выполнения, если разработчик допустил ошибку. Это не кажется оптимальным решением.

(Если вы не читали первую статью серии, то обязательно начните с нее)

создадим решение лучше

Воины и волшебники, часть первая

Reading time2 min
Reach and readers7.7K

Распространенная проблема, которую я вижу в объектно-ориентированном проектировании:

* Волшебник — это разновидность игрока.
* Воин — это разновидность игрока.
* У игрока есть оружие.
* Посох — это разновидность оружия.
* Меч — это разновидность оружия.

Но прежде чем мы углубимся в детали, я просто хочу отметить, что на самом деле я не говорю здесь о чем-то специфичном для жанра фэнтезийных ролевых игр. Всё в этой серии одинаково хорошо применимо к корпоративным приложениями, но о волшебниках и воинах писать интереснее, так что вот.

давайте напишем несколько классов

Неполная, неточная и наполовину выдуманная история исключений

Reading time9 min
Reach and readers8.6K

Давным-давно, когда деревья были маленькие, дискеты большие, а трава зеленая, все писали на языках низкого уровня. В этих языках все было целыми числами. Переменные были числами, массивы были и структуры были просто адресами (числами) и смещениями (тоже числами). Даже если указывали тип данных, то он определял только размер памяти для значения.

В эти старые добрые времена было очень мало причин почему программа не могла продолжить работу. Например деление на ноль, неправильное обращение к памяти (например обращение по адресу равному нулю) или неправильная инструкция процессора (это когда уже совсем все плохо). Если что-то такое происходило операционная система без капли смущения грохала вашу программу.

Чтобы программа не грохалась, а выдавала осмысленное сообщение и давала возможность продолжить работу, надо было добавить проверку.

Читать далее
1

Information

Rating
178-th
Location
Москва, Москва и Московская обл., Россия
Date of birth
Registered
Activity

Specialization

Software Architect, Delivery Manager
Lead
C#
.NET Core
Entity Framework
ASP.Net
Database
High-loaded systems
Designing application architecture
Git
PostgreSQL
Docker