19th Nervous Breakdown
Приближение релиза PostgreSQL 19 к официальному вышло нервным. Появилась даже статья именно с таким названием: 19th Nervous Breakdown. Нервный срыв. Написал статью известный в сообществе человек, грамотный - Кристоф Питтус (Christophe Pettus), который ведёт свой блог The Build и возглавляет команду PGX (то есть PG Experts). Его любимая тема - разбор GUCов, но тут он сделал исключение - ведь и релиз исключительный в обоих смыслах: 1. уникальный, 2. сколько ж из него исключили!
Ну а название он придумал шикарное: оно отсылает к древней песне.
И это статья, пожалуй, самая основательная из тех, где говорят о причинах кризиса. А это даже не кризис: это Дырокалипсис (Vulnpocalypse - гибрид слов vulnerability и apocalypse). А ещё - Поезд откатов (откатов в хорошем, точнее, не в самом плохом смысле - Revert Train).
Мем Валнпокалипс завирусился в профессиональных списках рассылки по кибербезопасности (например, oss-security) примерно с июня 2026 года - как описание лавины уязвимостей, которые массово хлынули как результат ИИ-фазинга и автоматизированного ревью кода, а конкретней - с приходом Claude Mythos (да и Opus, похоже).
Ну а в контексте постгреса этот новенький мем-термин использовал Петер Айзентраут (Peter Eisentraut) в своём детальном разборе причин задержки релиза и массовых откатов (на него ссылается и Кристоф в The Patch Is Coming From Inside the House). И сам Кристоф.
На тему постгресового дырокалипсиса было немало статей, в том числе на русском. Итак, мой выбор - эта статья Кристофа Питтуса про нервный срыв: не (только) из-за её эффектного названия. Она вся по делу.
Он начинает с хроники событий: "За последние три недели [статья от 15 сентября] он [релиз] потерял две функции, которые были заголовками каждого поста «что нового в 19», написанных с июня, включая и мой пост [то есть SQL/PGQ in PostgreSQL 19: Graph Queries Without the Graph Database - о графах мы ещё поговорим ниже]. 31 августа Брюс Момджан (Bruce Momjian) написал в рассылке-hackers: «чувствуется, что мы находимся в беспрецедентной ситуации». [Кристоф здесь имеет в виду ответ Брюса на письмо Роберта Хааса (Robert Haas) с красивым сабжем: scary patch contest - конкурс стрёмных патчей]. Неделю спустя Джошуа Дрейк (Joshua Drake) предложил перенести релиз на весну 2027 года. Никто его не поддержал. Но и никто не засмеялся."
Роберт Хаас, кстати, был не совсем оригинален в названии, да и ситуация не то, чтобы совсем уникальна, по поводу релиза PostgreSQL 11 уже писали Scariest patch tournament - там был "турнир" стрёмных. Но, поясняет Кристоф, масштаб не тот.
Дальше Кристоф вводит нас в "Зал славы откатов с 19-го августа":
ALTER TABLE ... MERGE/SPLIT PARTITION: откатили 26–27 августа, «из-за множества проблем с проектированием, которые слишком поздно исправлять в этом цикле релиза».
Графы свойств SQL/PGQ: откатили 7 сентября. 124 файла, 15 859 удалений в master.
Пакетная обработка RI fast-path: удалена из REL_19_STABLE 10 сентября её собственным коммиттером.
GROUP BY ALL: откатили до беты 3.
Нетекстовые форматы вывода pg_dumpall: откатили до беты 2.
Привязка регистра идентификаторов к провайдеру и изменение LC_COLLATE в postmaster: откатил Джеф Дэвис (Jeff Davis) в течение первых двух недель сентября.
Работа над подкомандами CREATE SCHEMA: откатил Том Лейн (Tom Lane) во вторую неделю сентября, потому что это изменило смысл операторов в версии 18.
Всё еще в дереве исходного кода и всё еще предмет споров: REPACK (CONCURRENTLY) [в 1-м релизе кандидате, вышедшем 15-го октября, пункт REPACK остался, его немного пофиксили]; FOR PORTION OF и функции pg_get_*_ddl() [это в списке Кристофа, сейчас он уже тоже в "зале славы"]; контрольные суммы, отключаемые онлайн [там же].
Ещё он напоминает о том, что 8 функций приняли за пять недель - Брюс в апреле подсчитал: 220 новых пунктов (фич), которые попадут в 1-ю бету, ну а Кристоф написал у себя статью Two Hundred and Twelve Things.
"Коммиты в последнюю минуту - это традиция PostgreSQL, и они никого не должны шокировать. Но в этот раз отличие заключается в том, какие это были функции. Это не «функции-листики», которые можно вырезать скальпелем" - пишет Кристоф в Нервном срыве. Это функции, затрагивающие серьёзные архитектурные решения.
Кашу заварил Роберт Хаас, который натравил на релиз Клода. "Я попросил Claude оценить, какие патчи для v19 самые страшные, основываясь на количестве и типе багов, исправленных после заморозки. Результаты ниже, с удалением нескольких особенно едких замечаний от LLM". Жалко, что удалил, было бы любопытно оценить ядовитость Клода :)
В статье есть главка The LLM in the room - LLM в комнате. И здесь Кристоф тоже высказывается сбалансированно, здраво. После перечисления вклада в поиск багов всё более многочисленных любителей ИИ, он пишет:
"Течение не всегда в одну сторону. Дэвид Роули (David Rowley) вернул комментарий с «ужасным запахом ИИ»; Том Лейн отклонил набор сгенерированных ИИ тестовых случаев как «не стоящих усилий по разработке и бесконечных трат времени на прогон тестов»; Міхаіл Нікалаеў [Mihail Nikalayeu, из Беларуси] обозначил свой собственный набор тестов как сгенерированный ИИ и непроверенный. Это правильные инстинкты, и они применяются патч за патчем."
А теперь главный вопрос:
ПРОЦЕСС ПОЛОМАЛСЯ?
И ответ:
НЕТ. Но он неправильно настроен, и только что прошедший сентябрь показывает, где именно. Никто меня не спрашивает, но мое мнение: проводите конкурс стрёмных патчей в мае, а не в августе.
В статье ещё много подробностей, полезных и для понимания постгресовых механизмов, но ещё больше для понимания механизмов самого сообщества. И весьма любопытный пассаж ближе к финалу статьи:
"Я (и PGX) тоже использую эти [ИИ-] инструменты, и написать этот пост мне помогал Claude - похоже, что Claude стал в нашем проекте ИИ-стандартом. Я упоминаю об этом, потому что норма раскрытия информации, которую Том Лейн только что установил в сообщении коммита, это очень хорошо, и она должна применяться к сообщениям в блогах так же, как и к патчам."
Кристоф говорит о не о формальном нормативе, который приняло сообщество - ничего подобного не происходило. Просто Том Лейн, великий и ужасный, написал:
Полное раскрытие информации: первоначальные черновики этого патча были созданы с помощью Claude Opus 4.8.
Почему он великий, и почему ужасный - см. дальше.
Итак: фичи, которые уже откатили, решили перечислить в релизе PostgreSQL 19 Beta 4 - вот официальный список в официальном порядке:
Откатили поддержку SQL/PGQ (запросов к графам свойств).
Откатили возможность включения и отключения контрольных сумм данных в режиме онлайн (на лету).
Откатили поддержку темпоральных (привязанных ко времени) операций обновления и удаления, реализуемых через предложение
FOR PORTION OF.Откатить команды
ALTER TABLE ... MERGE PARTITIONSиALTER TABLE ... SPLIT PARTITIONS(объединение и разделение секций).Удалить функции
pg_get_role_ddl(),pg_get_tablespace_ddl()иpg_get_database_ddl().Откатить изменение, которое принудительно устанавливало значение локали
LC_COLLATEвCдля главного процессаpostmaster.
Реакция Петера Айзентраута (Peter Eisentraut) самая, пожалуй, оптимистичная. Статью The reverts will continue until morale improves (мораль тут в широком смысле) он заканчивает так:
"PostgreSQL 19 всё равно станет шикарным релизом. REPACK CONCURRENTLY, логическая репликация последовательностей (сама по себе ранее отмененная фича) и подсказки планировщику с помощью pg_plan_advice - и это лишь некоторые ключевые нововведения - сделают этот релиз очень привлекательным. И он будет очень надежным - благодаря всей этой дополнительной проверке.
Сейчас сложно что-то предсказывать. Несколько месяцев назад я говорил, что в PostgreSQL 20 может не быть новых функций, только исправления ошибок. Оказалось, что события развиваются быстро, и теперь в PostgreSQL 19, можно сказать, вдвое меньше крупных функций, чем ожидалось тогда. Но зато у нас уже есть несколько отличных фич, готовых на 80%, которые стоят в очереди на PostgreSQL 20, и где осталось доделать эти самые недостающие 80%!"
Про 80% - это он шутит: в программистском фольклоре последние 20% работы всегда занимают 80% времени.
Реструктуризация любимых обзоров
Самое время напомнить о постоянных (если не героических) усилиях нашего коллеги Павла Лузанова, анализирующего и обозревающего новые фичи, принятые на коммитфестах. На этот раз он решил финальную, 5-ю часть обзора разбить на 4 части. Предыдущие вот:
А пятую серию Павел решил поделить для удобства по интересному принципу: в соответствии с темами курсов, которые читают и сертифицируют в Отделе Образования Postgres Professional.
А именно:
PostgreSQL 19: Коммитфест 2026-03 Часть 5.1 (QPT) (en) - это по теме курса QPT. Оптимизация запросов;
Часть 5.2 (DBA1, DBA2) (en) - тема соответствует курсам DBA1: Администрирование PostgreSQL 16. Базовый курс и DBA2. Настройка и мониторинг,
Часть 5.3 (DBA3, DBS) (en) - DBA3. Резервное копирование и репликация и DBS. Основы безопасности PostgreSQL 16;
Часть 5.4 (SQL, DEV1, DEV2) (en) - SQL, DEV1. Разработка серверной части приложений PostgreSQL 16. Базовый курс и DEV2. Расширенный курс.
Have fun, как говорится.
Книги
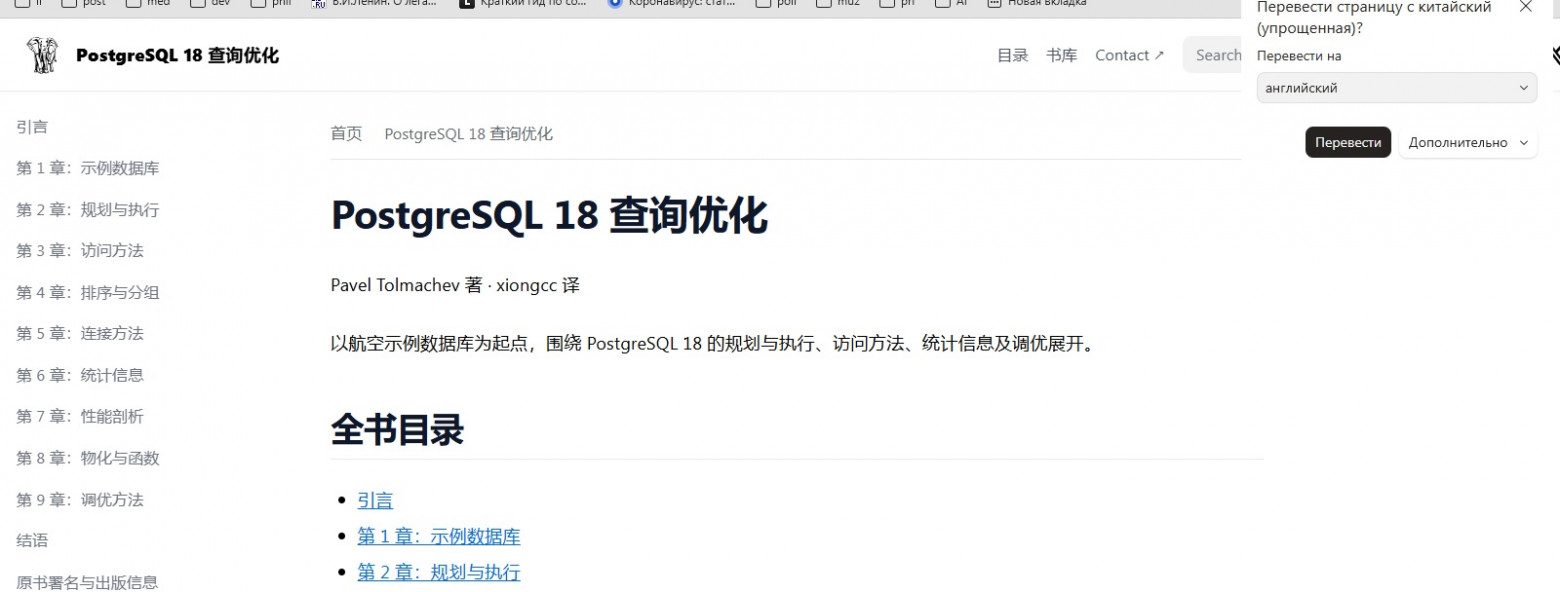
PostgreSQL 18 Query Optimization: A Free 199-Page Book
Вот что пишет об этой книге Павла Толмачёва (Pavel Tolmachev) Postgres Weekly:
Курс Postgres Pro по настройке запросов переработан в компактную книгу, которая теперь доступна на английском языке. В ней рассказывается о том, как работает планировщик запросов, рассматриваются методы доступа, стратегии соединения таблиц, статистика, чтение планов выполнения и подходы к настройке запросов. Вот PDF. Вот страница русской версии.
Вот русская страничка книги PostgreSQL 18 Оптимизация запросов, а это - PDF-версия.
Но это ещё что! Уже есть и китайская версия! Ссылка есть на английской страничке книги на сайте Postgres Professional.
Консерватор vs. Революционер
Здесь я хочу рассказать о двух любопытных событиях:
вышло огромное интервью с Томом Лейном: Tom Lane on the Architectural Decisions That Shaped 30 Years of Postgres,
Майкла Малиса (Michael Malis) - автора pgrust пригласили в подкаст Postgres FM.
Вы справедливо возмутитесь: Том - классик. Он 25 лет работает с Postgres, он один написал, небось, строк кода чуть ли не столько же, сколько все остальные вместе взятые. Это он-то - консерватор? А рядом Майкл Малис, который то ли для шутки, то ли провокации ради переписал Postgres на rust. Это нелепо.
Возможно. Но я просто хочу обозначить полюса.
В интервью в блоге Snowflake Том отвечает на вопросы Элизабет Гаррет Кристенсен (Elizabeth Garrett Christensen). У неё в Снежинке титул Developer Advocate. Вообще-то она специализируется на образовательном контенте и продвижении Snowflake Postgres, она и сама раздаёт интервью, и подготовилась к интервью с Томом она основательно. Теперь оба они в Снежинке, ведь в прошлом году Снежинка прикупила Crunchy Data. Элизабет и сама писала о дырокалипсисе: What Is Happening with PostgreSQL 19? Там есть немало о тонкостях функционирования сообщества, о типичных сценария откатов фич.
Том рассказывает, что Postgres пришёл из Беркли без WAL. Он считает, что ключевым релизом был 8.0, как раз из-за появления WAL. Это была революция. Postgres стал тем, чем он стал.
Том и Элизабет больше всего говорят о работе с памятью. Единственный, как мне кажется, недостаток интервью связан с этим: куски разговора о памяти разбросаны по интервью. Там и о процессах/потоках (в том числе в контексте современного железа), о C, о контекстах процессов, о разделяемых буферах.
Элизабет слегка провоцирует: сейчас, мол, ведутся разговоры о том, чтобы сделать что-то по-другому - без VACUUM и WAL.
Том: "Я помню один разговор примерно в 2000 году: какой-то парень подошел ко мне на выставке, он был, очевидно, очень глубоким экспертом по Oracle. И он сказал мне: «Вы, ребята, сделали это правильно. А мы сделали это неправильно». Я люблю вспоминать его слова."
Он сам много занимался оптимизатором и много рассказывает о нём и о стоимостной модели. И о Bison & Flex, и о том, что сам он работает в интерфейсе Emacs. Как все великие (ок, многие) он скромен:
"Том: Я рассматриваю свою работу с Postgres скорее как огромное накопление не очень крупных отдельных частей. Я мог бы выделить то или иное, но, вероятно, ни одна из них сама по себе не звучала бы так уж масштабно."
В словах Тома нет, кажется, и следа сомнений, всё ли так сделали в Postgres. Во всяком случае в главных архитектурных решениях. Он очень осторожно принимает изменения. Поэтому многие считают его - при всём уважении - консерватором. Но ведь он консервативно отстаивает вполне революционные принципы, в основном заложенные ещё Майклом Стоунбрейкером. Например, Том считает так: если новая функция ядра не может быть адаптирована для работы с пользовательскими типами данных из расширений, она не будет принята. И он добился, что этому принципу жёстко следуют.
Мимо ИИ, конечно, не прошли. Здесь Том, который, конечно, пользуется ИИ, тоже сверхосторожен:
"Мы получаем огромное количество отчетов об ошибках и отчетов о проблемах безопасности, сгенерированных ИИ. Безусловно, многие из них являются действительными ошибками, которые нужно исправить. Но есть и изрядная доля мусора (slop) из-за того, что инструменты не понимают базовые архитектурные концепции. Надеюсь, мы сможем понять, как фильтровать эти вещи более эффективно."
Ну и решения принимать и обосновывать должен человек. Это, говорят, уже обсуждается и на формальном уровне.
Том пришёл в Postgres не из мира баз данных. Он выходец из мира строителей JPEG и PNG. Когда дошло дело до баз:
"В то время двумя разумными вариантами были Postgres и MySQL, и я посмотрел на кодовую базу MySQL и решил, что не хочу иметь с ней ничего общего."
А что же Майкл Малис, переписавший весь Postgres на rust с помощью Opus? То, что его пригласили в подкаст Николая Самохвалова и Майкла Кристофайдеса (Nikolay Samokhvalov & Michael Christofides) уже некоторый знак признания - очень ценим эти подкасты и их ведущих, они туда праздных хайпожоров не приглашают. Мы об этом проекте писали в Postgresso #6 (91), возьмём оттуда выжимку из его 4 Всадниках Постгрес-Апокалипсиса (не дырокалипсиса), то есть о принципиальных, архитектурных проблемах Postgres, с которыми так не хочется расставаться Тому Лейну:
Вакуум и Wraparound - ну это понятно.
Маловато соединений держит, и слабый параллелизм в исполнении запросов. Майкл вместе с Rust переходит на треды вместо процессов.
Плохие планы запросов. Майкл надеется научить pgrest более разумно действовать в сложных случаях.
JSON. По ним нет нормальной статистики, считает Майкл.
Он не безумец: признаёт, что это не для продакшн, это исследовательский проект. Хотя, нет, безумец: потратил $100K, пустив на свою игрушку деньги от продажи своей доли в предыдущем стартапе - Freshpaint.
Из нового: он теперь задумал побить все Postgres-ы - в том числе ClickHouse - за счёт быстрой JIT-компиляции (хочет за 5 микросекунд) - вообще уйти от интерпретации запросов.
Не только Postgres FM заинтересовались темой. Дэн Лу (Dan Luu) написал статью We should be more ambitious with the software we build.
Он говорит: Майкл Малис проводит настолько глубокое и обстоятельное тестирование, что в процессе нашёл ранее неизвестные баги в оригинальном PostgreSQL, например: численные ошибки в SP-GiST, баги кэша форматов JSONPath, проблемы переполнения типа money и утечки памяти.
Но самое интересное вот, в примечании:
«Я также связался с Малисом во время написания этой статьи и узнал о множестве интересных вещей, которые он делает. <...> в последний раз, когда мы обсуждали верификацию pgrust, он упомянул, что использовал Kani для проверки некоторых частей кода. С тех пор он перешёл на Lean и использует его для верификации вещей, которые слишком сложны для Kani».
Ого! Всё-таки Майк Малис самый настоящий революционер. Lean - заумная система проверки логического вывода. Ею пользуются математики, без неё бы и ИИ не сделал недавних сенсационных открытий.
Не то, чтобы Lean не использовали в софтверных компаниях. И в Microsoft (там он, в общем, и родился: от Леонардо де Мура - Leonardo de Moura), в AWS, в Google, в высокочастотном трейдинге, в блокчейнах и в Web3, в компаниях по кибербезопасности - там нужны формальные методы, доказывающие принципиальное отсутствие дыр. Но в таких проектах, как Postgres - пока нет. Разработчикам было не по зубам. А Opus - по зубам.
Он упоминает успешные эксперименты, где продвинутые модели с нуля реализовывали такие монструозные спецификации, как протокол IMAP или конвертер документов Pandoc (поддерживающий десятки форматов), проходя тесты с вероятностью успеха >99%.
Дэн приводит всем в пример Питера Гейгана (Peter Geoghegan) - хорошо нам известного разработчика ядра PostgreSQL: он за минуты навайбил плагин для редактора Neovim, который теперь идеально форматирует C-код.
Дэн - непростой дядька: работал инженером-программистом в Google и Stripe, где занимался вопросами производительности, надежностью систем и инфраструктурой. Теперь безумствует: несколько лет назад он ушел из корпоративного мира, чтобы развлекаться независимыми исследованиями и написанием статей. Ну ещё и консалтингом - всё же. Говорят, его любимое занятие - разносить в пух и прах маркетинговые заявления стартапов. А поди ж ты ...
Но это ещё не всё. В Postgresso #6 (91) мы писали:
Можно присвистнуть, покачать головой и задумчиво произнести: «это только начало». И оказывается, что в форумах уже кое‑что нашли: We're building Postgres in Rust. Using the LLVM of databases. Мы — это компания Turso (до этого они переписали на Rust SQLite).
И что же? Supabase is acquiring Turso - вот что. No comments, как говорится.
Конференции
Уже совсем скоро: PGConf.Академия 2026 пройдёт 16 ноября. Место называется Центр Культур ВШЭ, Покровский бул., 11, стр. 6, корпус Z, Москва. Доклады уже не принимаются, а регистрация ещё открыта. Расписание опубликовано, программа - тоже. Два потока.
Будут и знакомые докладчики, регулярно приезжающие на Академию - например, петербургский профессор Наталья Графеева НИУ ВШЭ Санкт-Петербург: Использование расширения pgvector для атрибуции почерков в средневековых рукописях. И Игорь Тот из Колледжа телекоммуникаций Университета связи и информатики: Манчкин SQL-квест. Изучение PostgreSQL через настольную карточную игру - мне запомнился его не менее оригинальный доклад на PGConf.Russia про кораблики: Разработка и внедрение автоматизированных моделей беспилотных парусников для экологического мониторинга с применением PostgreSQL.
Будут представители знатных ВУЗов, таких как Бауманка, МЭИ, Вышка, а будет и доклад, например, из Торжка: Дмитрий Шилин, представляющий Колледж Росрезерва, расскажет о Генерации комплексных заданий в формате демо-экзамена с использованием ИИ.
PostgreSQL Conference Nepal, 2026
Уже 21 ноября в Катманду! Организаторы конференции: Nepal PostgreSQL User Group, Kathmandu University, Institute of Engineering Pulchowk Campus Университета Трибхуван и Postgres Professional. Генеральным спонсором этого года стала местная компания Dharma of Data.
Доклады слать поздно, а вот регистрация открыта. Докладчики Докладчики интересные: знаменитый Брюс Момджан (Bruce Momjian, EDB), Марко Слот (Marco Slot, Snowflake), Олег Бартунов (Oleg Bartunov, Postgres Professional), Крис Трейверс (Chris Travers, Stormatics), Роберт Трит (Robert Treat, AWS) и другие - тоже интересные.
Не графья
Полезное дело ходить по конференциям. Увидел статьи Igor Suhorukov и вспомнил: Игорь Сухоруков же выступал на конференции PGConf.Russia с докладом. Проверил - да: Как поместить весь мир в обычный ноутбук: PostgreSQL и OpenStreetMap. 2023 год. Надо почитать его статьи. И не разочаровался. Например:
Which language should an AI agent use to search its memory: SQL or SPARQL? (нашлась и на русском: На каком языке ИИ-агенту искать по своей памяти: SQL или SPARQL?).
Эта статья, как ни странно, имеет отношение к нынешнему дырокалипсису. Дело в том, что самый большой урон в результате откатов потерпели патчи, связанные с графами - напоминаем: 124 файла, 15 859 удалений в ветке master. А ведь очень многие возлагают надежды на графы (не обязательно постгресовые, конечно) в связи с ИИ, а конкретнее с RAGами.
Игорь прочитал статью A Benchmark to Understand the Role of Knowledge Graphs on Large Language Model's Accuracy for Question Answering on Enterprise SQL Databases Хуана Секеды и компании (Juan Sequeda, Dean Allemang, Bryon Jacob) и решил проверить: так ли хороши для RAGов графы, как их малюют. Провел эксперимент: какой язык запросов лучше подходит для организации «памяти» ИИ-агента (GraphRAG):
традиционный SQL или
SPARQL (граф знаний).
Для тестирования использовались три локально развертываемые open-weight модели: DeepSeek V4.1 Flash, Gemma 4 31B и Qwen 3.8 27B. Модели тестировались в трех условиях: доступен только SQL, только SPARQL, или оба инструмента сразу.
SQL разгромил SPARQL:
Несмотря на ожидания, что графовые запросы лучше подходят для связей, все модели выбирали SQL чаще.
Ошибок при генерации SPARQL было в 2–3 раза больше, а стоимость запросов (в токенах) оказывалась в 1.6–2.5 раза выше.
Даже когда моделям давали выбор из обоих инструментов, они выбирали SQL в 135 из 135 запусков.
И ещё интересный побочный результат:
Общая точность всех моделей оказалась очень высокой (97–99%), что доказывает: для таких задач не обязательно использовать дорогие облачные API, подойдут и локальные модели.
Игорь нашёл перекос в методологии тех 3 авторов: граф знаний в том бенчмарке был обогащен подробной онтологией с описаниями смыслов сущностей и связей, а SQL-схема в том же бенчмарке содержала только базовый DDL (типы данных, имена таблиц и колонок) без каких-либо комментариев или контекста.
То есть не «SQL против Графа», а «плохо документированный SQL против хорошо документированного Графа». А в честном поединке за сердца LLMов Неграфья победили.
У автора много и других интересных статей. Недавняя: Мой PostgreSQL быстрее твоего и почти догнал ClickHouse.
Релизы: бэкапы
Новые бэкап-проекты и новые версии старых. Общее направление движения просматривается: более тщательные проверки, универсальность.
BackupDrill и ReviveDB (оба Supabase)
И оба проверяют жизнеспособность копии, не дожидаясь, когда она понадобится. Делают они это так:
Забирают бэкап из хранилища.
Разворачивают временную (одноразовую / ephemeral) базу данных (обычно в Docker).
Применяют туда бэкап.
Делают простую проверку на жизнеспособность (sanity check, например,
SELECT 1или проверку наличия ключевых таблиц).Только если всё прошло успешно, бэкап получает статус "Verified" (проверенный).
Временная база данных немедленно уничтожается.
А разница в том, что BackupDrill — это CLI-инструмент, который дает полный ручной контроль: запустили команду, она сделала дамп вашей базы Supabase, кладет его в ваш собственный S3-бакет и сразу же проверяет.
ReviveDB — автоматизированное решение для тех, кому надо выводить бэкапы проектов полностью за пределы экосистемы Supabase (outside Supabase).
Создан разработчиком kushsharma из Индии как будто специально для безопасников: шифрование (age) + сжатие (zstd) происходят на хосте до отправки. Данные пишутся в S3 с включенным Object Lock (защита от ransomware), а затем по расписанию разворачиваются для проверки каждой таблицы и файла.
Бэкапит не только PostgreSQL, но и MySQL, MariaDB, MongoDB, SQLite, файловые системы и IMAP-ящики. Документация здесь.
pg_hardstorage (Cybertec):
Непрерывный потоковый бэкап без агентов на стороне ОС: всё происходит через стандартный протокол репликации PostgreSQL (libpq). Агенту не нужен OS-доступ или ssh к хосту базы данных. Гарантированное восстановление PITR без потерь данных между бэкапами.
Один статический Go-бинарник масштабируется от лаптопа до продакшн-кластера на 100 ТБ.
Теперь процесс restore прерывается с ошибкой, если любой восстановленный файл выдаёт неправильную контрольную сумму страницы. Но можно подкрутитьchecksum-page-error=n , тогда будет только предупреждение.
Интересно, что релиз теперь постят от имени pgBackRest Community. Драма pgBackRest описана нами в Postgresso #5 (90). Проект живёт, а шрамы видны.
Postgres Pro Backup Enterprise 3.5.0
Новое:
Функциональность утилиты pgpro_backupstream перенесена в pg_probackup3 в виде команды receive-backup. Теперь удалённое восстановление выполняется только с помощью утилиты pg_probackup3.
В команду catchup добавлен параметр
--sync-replicaдля синхронизации реплики с ведущим сервером при расхождении историй линий времени, в том числе после повышения реплики.Реализован параметр
--wal-depth, позволяющий при очистке архива WAL сохранять сегменты, необходимые для PITR от заданного числа последних резервных копий на каждой линии времени.Реализована поддержка многопоточности (
-j/--threads) в команде retention.
Добавлен govulncheck workflow для сканирования уязвимостей. В списке поддерживаемых и тестируемых СУБД официально появилась OrioleDB (вместе с Cloudberry, MySQL и MariaDB).
Это не инструмент бэкапа, но он анонимизирует и бэкапы тоже: не только Dynamic Masking и Replica Masking, но и Backup Masking.
Разработчики: знаменитая PostgreSQL Dalibo Labs, а в ней известный нам Дамьен Клошар, а ещё Бенуа Лобро (Benoit Lobréau).
Ну и в заключение:
Победитель конкурса Странный вайбслоп
Может и не победитель, но проект диковатый: Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5
Скажу честно: я мало что понял в устройстве этих слоёв. Но пишут об этом проекте так:
"Обычные попытки заставить трансформер «помнить» что-то опираются на KV-кэш, который растет линейно с длиной контекста и является «грязной», неточной ассоциативной памятью. Автор Qwenputer нашел лазейку в архитектуре Qwen 3.5: использование Gated DeltaNet (GDN) — линейного RNN-механизма в слоях внимания. Манипулируя гейтом и используя one-hot кодирование, автор превратил слои GDN в точную, адресуемую RAM с O(1) доступом, размер которой не зависит от длины контекста."
Это точно посильней Фауста Гёте и, видимо, посильней, чем просто "вкорячить в Квен целый 32-битный процессор RISC-V, собрав его из математических операций самой нейронки."
Квенпьютер умеет выполнять программы на C и MicroPython. Автор, вроде, прогнал 18 миллионов инструкций подряд и не обнаружил ни одной ошибки.
На сегодня всё.