

Grok 4.5 вышел в июле 2026 года, но уже в августе xAI выпустила Grok 4.6 — всего через пять недель, по той же цене. Сейчас Grok 4.5 формально уже не флагман xAI. Тем не менее сравнение остается актуальным: Grok обновляется каждые пять-шесть недель, а ключевая архитектура и философия модели между версиями меняются не радикально, так что выводы применимы и ко всей линейке Грок в целом.
Claude Opus 4.8 и Grok 4.5 — это два принципиально разных подхода к дизайну, ценообразованию и целевым сценариям использования. Одна модель делает ставку на надежность и соответствие корпоративным стандартам, вторая — на скорость и цену за решенную задачу. Разбираем факты, а не заявления пресс-релизов.
Grok 4.5: обзор функций
Grok 4.5 — бывшая флагманская языковая модель xAI, представленная 9 июля 2026 года. Создана специально для кодинга, многошаговой агентной работы и задач с длинными документами. Контекстное окно — 500 000 токенов, цена — $2 за миллион входных токенов (ваш запрос) и $6 за миллион выходных (ответ ИИ), поддерживается настраиваемый уровень рассуждений.
В основе модели — параметрический фундамент V9 на 1,5 триллиона параметров, который xAI называет совместно обученным с Cursor. Это объясняет сильную производительность grok ai в задачах кодинга и агентных бенчмарках.
Илон Маск позиционировал модель так: «Это Opus-class модель, но быстрее, более токенно-эффективная и дешевле». То есть, якобы Grok 4.5 сравним с Opus 4.7, но намного быстрее конкурента. Здесь важно, что Маск сравнивал модель с Opus 4.7, а не 4.8, между ними есть разрыв, и он уже не в пользу Grok.
Claude Opus 4.8: что нужно знать
Claude Opus 4.8 выпущен 28 мая 2026 года — флагман Anthropic, расположенный выше Sonnet 5 и ниже нового уровня Fable 5 и Mythos. Позиционируется как топовая модель Клода для рассуждений и агентных задач: длинные агентные цепочки, многошаговая генерация кода, сценарии, где наджнеость важнее скорости ответа.
Контекстное окно — 1 миллион токенов, ценообразование — $5 за миллион входных и $25 за миллион выходных токенов. Модель работает как двигатель Claude Code — основного агентного инструмента Anthropic для разработчиков.
Бенчмарки: конкретные числа
По индексу Artificial Analysis Intelligence Index модели близки: 56 баллов у Grok 4.5 против чуть более высокого результата у Opus 4.8. По BenchLM, у Opus 4.8 расчетный балл 76.2 против 75.19 у Grok 4.5.
На SWE-Bench Pro — тест на кодинг в реальных репозиториях — Opus 4.8 набирает 69.2% против 64.7% у Grok 4.5, отрыв 4.5 процентных пункта в пользу Claude. На SWE-Bench Verified разрыв меньше: 88.60% у Opus 4.8 против 86.60% у Grok 4.5 — Opus ведет на 2 п.п.
На Terminal-Bench 2.1 картина обратная: Grok 4.5 набирает 83.3%, что заметно выше его общего рейтинга интеллекта и указывает на намеренный фокус xAI именно на терминальных агентных задачах.
На DeepSWE счет разделен по версиям бенчмарка: Grok 4.5 опережает на DeepSWE 1.0, Claude Opus 4.8 лучше на DeepSWE 1.1 с отрывом в 6 пунктов. На мультиязычном кодинге у Opus 4.8 результат 84.4% на SWE multilingual — данных Grok 4.5 по этому бенчмарку не опубликовано.
Итоговый счет по собственным опубликованным бенчмаркам xAI: Grok 4.5 побеждает в двух из четырех прямых сравнений и проигрывает в двух других. Счет 2:2 — фактически ничья при точечном сравнении.
Токенная эффективность: что не видно на лидерборде
Ни один бенчмарк-лидерборд не показывает этого напрямую, но именно этот фактор больше всего влияет на реальную стоимость задачи.
На том же наборе SWE-Bench Pro, где Opus 4.8 показывает более высокий процент успешных решений, он же тратит примерно в 4.2 раза больше выходных токенов на одну задачу, чем Grok 4.5. Это значит: даже там, где Opus 4.8 чаще решает задачу правильно — 69.2% против 64.7% — итоговая стоимость решения у Grok 4.5 может оказаться ниже, за счет сочетания более дешевого токена и меньшего числа токенов на ответ.
Artificial Analysis замерил стоимость прогона полного индекса: $0.36 на Grok 4.5, $1.23 на GPT-5.6 Sol и $2.34 на Claude Opus 5 при максимальном уровне рассуждения. Разница на порядок — весомый аргумент для любого, кто считает бюджет на большом масштабе.
Ценообразование
Базовые тарифы: у Opus 4.8 входные токены стоят $5.00 за миллион, выходные — $25.00 за миллион. У Grok 4.5 — $2.00 и $6.00 соответственно. Grok дешевле Opus примерно на 60% по вводу и на 76% по выводу.
Простая математика на смешанной нагрузке: миллион входных плюс миллион выходных токенов — Opus обойдется в $30, Grok 4.5 — в $8. Разница в 3.75 раза.
Но у Grok есть своя ловушка длинного контекста. Модель поддерживает до 500 тысяч токенов, и стандартное ценообразование удваивается выше порога в 200 тысяч токенов — до $4 за вход и $12 за выход. Opus 4.8 и Sonnet 5 в этом смысле выигрывают дважды при работе с длинными документами: контекстное окно больше, и наценки на пороге нет вообще. Для задач с большими кодовыми базами Grok 4.5 может внезапно подорожать вдвое, тогда как Opus 4.8 сохраняет плоский тариф вплоть до миллиона токенов.
Скорость и задержка
Grok 4.5 работает со скоростью около 90 токенов в секунду — заметно быстрее большинства конкурентов на этом уровне возможностей. По Claude Opus 4.8 точных данных о скорости в публичных источниках мы не нашли, но по общему опыту пользователей модель работает ощутимо медленнее.
Контекстное окно: важное различие
Максимальный контекст у Opus 4.8 — 1 000 000 токенов без каких-либо наценок. У Grok 4.5 — 500 000 токенов, и наценка вдвое при превышении 200 тысяч. Opus 4.8 здесь однозначно выигрывает: контекстное окно вдвое больше, и оно не становится дороже с ростом объема запроса.
Соответствие корпоративным стандартам
У Claude Opus 4.8 задокументированная история соответствия стандартам: SOC 2, ISO 27001, HIPAA BAA. Для регулируемого покупателя — банка, медицинской организации, юридической фирмы, госструктуры — это главное условие выбора. Тем, кто рассматривает Grok, стоит запросить актуальные условия SOC 2 и BAA напрямую у xAI перед отправкой конфиденциальных данных: публичной документации по этому вопросу мало.
Маск против реальных данных
Маск использовал Opus 4.7 для сравнения не случайно — именно это поколение соответствует Grok 4.5 по уровню. Grok 4.5 технически превосходит 4.7, но чуть уступает 4.8: выигрывает на одних бенчмарках, проигрывает на других, при заметно более низкой цене. Artificial Analysis помещает Grok 4.5 на пятое место в индексе интеллекта — позади Fable 5, GPT-5.6 Sol, Opus 4.8 и GPT-5.5.
Что говорят эксперты и сообщество
Когда Grok 4.5 набрал 83% на Terminal-Bench, это стало реальным вызовом для Anthropic — результат поставил модель впереди многих конкурентов, стоящих значительно дороже. Часть обзоров формулирует вопрос прагматично: если вы запускаете агента, который весь день пишет и правит код, вопрос не в том, кто выше в лидерборде, а в том, какая модель закрывает больше тикетов за доллар.
По ранним замерам сообщества Grok 4.5 находится примерно на уровне Opus 4.7, в нижней части топового тира: явно не лучше Opus 4.8 по чистоте рассуждения, но приближается к нему за долю стоимости на вывод. Еще один тезис из обзоров: Grok 4.5 побеждает в двух бенчмарках и проигрывает в двух других против Opus 4.8, при цене $2/$6 против $5/$25.
Сообщество Claude формулирует разделение задач так: Sonnet 5 лучше для агентного кодинга, computer use и безопасности. Opus 4.8 — для самых сложных многофайловых задач. Grok 4.5 — для высокообъемных агентных задач при высокой чувствительности к цене.
Древо решений из практических обзоров: для максимальной точности при рассуждении над репозиторием — Opus 4.8 или Fable 5. Для мультиязычной кодовой базы — Opus 4.8, с его 84.4% на SWE multilingual. Для юридических, медицинских и образовательных задач — Grok 4.5. Для терминальных и bash-агентных воркфлоу — Grok 4.5 или GPT-5.6 Sol. Для высокообъемного агентного цикла с чувствительностью к цене — Grok 4.5. Для минимума галлюцинаций и максимальной надежности — Opus 4.8.
Доступность из России
Прямая регистрация и оплата у обеих компаний из России не работают. Claude официальный сайт и claude ai ограничивают доступ по юрисдикции, у grok com и grok ai — та же ситуация: xAI не принимает российские карты.
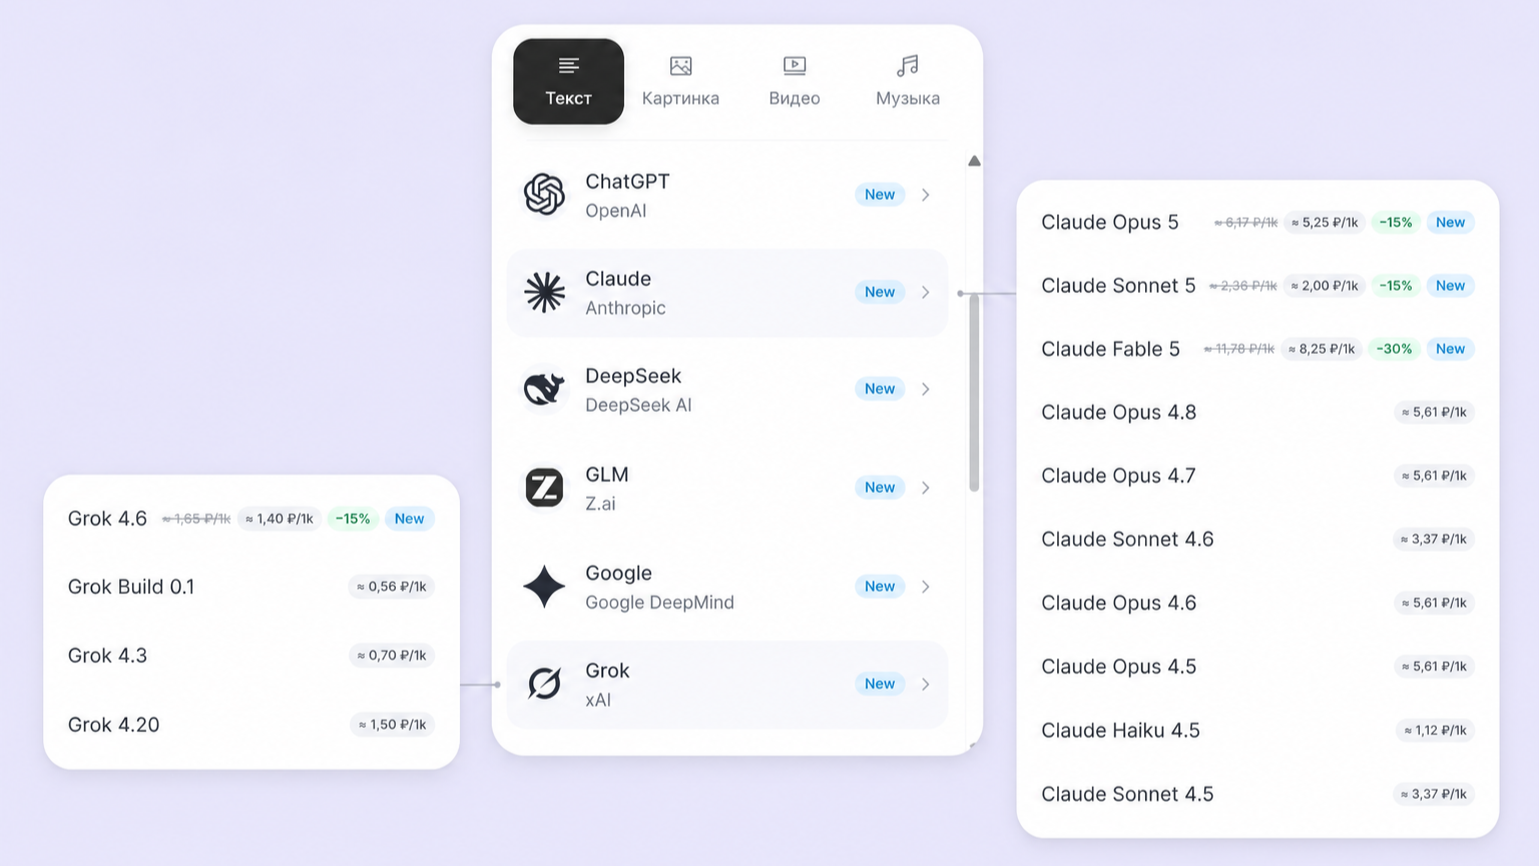
Простой, доступный и безопасный вариант без VPN — доступ через агрегаторы. SpeShu.AI дает доступ и к Claude, и к Grok в одном окне: оплата российскими картами и по СБП, русскоязычный интерфейс, стабильный доступ без VPN, регистрация без иностранного номера телефона.
У SpeShu.AI есть аналоговые модели: SpeShu Claude, SpeShu Gemini, SpeShu ChatGPT. Они не уступают официальным моделям и при этом работают без VPN, оплачиваются картой банков РФ и стоят дешевле. Также здесь вы можете протестировать более 300 моделей для текста, фото, видео и музыки.
Рыночный контекст: зачем сравнивать эти модели
Anthropic и xAI выбрали разные точки приложения усилий в один и тот же период 2026 года. Anthropic инвестирует в предсказуемость: биллинг, широкое контекстное окно без наценок, задокументированный комплаенс для регулируемых отраслей — ставка на корпоративного покупателя, для которого стабильность важнее скорости релизов. xAI, наоборот, выбрала темп: обновление флагмана каждые пять-шесть недель, агрессивная цена за токен, фокус на токенной эффективности вместо абсолютной точности. Это разные модели монетизации: Anthropic зарабатывает на доверии крупных клиентов, xAI — на объеме высоконагруженных агентных сценариев, где каждый цент за токен умножается на миллионы запросов.
Понимание этой разницы в стратегии объясняет, почему прямое сравнение по одному числу — кто выше в лидерборде — не дает полезный ответ. Вопрос не «какая нейросеть лучше», а чья философия совпадает с вашим сценарием использования: разовые сложные задачи, где цена не критична, или постоянный высокообъемный поток, где токенная эффективность решает бюджет на месяц вперед.
Итог: у кого что лучше
Grok 4.5 выигрывает:
По цене — дешевле Opus в 3.75 раза при равном объеме входа и выхода.
По скорости — около 90 токенов в секунду.
По токенной эффективности — в 4.2 раза меньше токенов на задачу на SWE-Bench Pro.
Сильнее на Terminal-Bench 2.1 с результатом 83.3%, на DeepSWE 1.0 и на задачах GDPval+ — юридических и финансовых сценариях.
Лучше подходит для высокообъемной агентной работы при ограниченном бюджете.
Claude Opus 4.8 выигрывает:
На SWE-Bench Pro — 69.2% против 64.7%, и на SWE-Bench Verified — 88.60% против 86.60%.
Сильнее на DeepSWE 1.1 и на мультиязычном кодинге с результатом 84.4%.
Контекстное окно вдвое больше и без наценок — 1M против 500K с удвоением цены выше 200K.
Надежнее в многошаговых агентных сценариях, где важно не терять инструкции по ходу длинной задачи.
Полностью закрывает вопрос комплаенса — SOC 2, ISO 27001, HIPAA. И немного впереди по общему Intelligence Index.
Для каких задач что выбрать
Не полагайтесь на один сервис под все задачи сразу — разница в цене между этими двумя моделями достаточно велика, чтобы стоило проверять обе на своих реальных запросах, а не полагаться только на общий рейтинг.
Grok 4.5 стоит выбрать, если вы оптимизируете под стоимость решения задачи, а не под абсолютную точность: высокообъемный агентный цикл, терминальные и bash-воркфлоу, юридические или финансовые задачи, где важна скорость обработки большого потока запросов при ограниченном бюджете.
Claude Opus 4.8 стоит выбрать, если нужен максимальный результат по кодингу в реальных репозиториях, надежность в длинных многошаговых агентных цепочках, работа с очень большими документами без скрытых наценок, и если ваша организация регулируется и должна подтверждать соответствие SOC 2, ISO 27001 или HIPAA.
Как это выглядит на практике: три сценария
Цифры бенчмарков задают направление, но решение обычно принимают на конкретной задаче. Разберем три частых сценария.
Первый — агент, который целый день пишет и правит код в реальном репозитории. Здесь разрыв в 4.5 процентных пункта на SWE-Bench Pro в пользу Opus 4.8 — реальное количество задач, решенных без повторной генерации. Но с учетом того, что Opus тратит в 4.2 раза больше токенов на ту же задачу, итоговый счет за месяц интенсивной работы может оказаться сопоставимым с Grok 4.5, даже несмотря на меньший процент успешных решений у последнего.
Второй — терминальный агент, который разворачивает окружение, гоняет тесты, чинит зависимости в bash. Здесь у Grok 4.5 явное преимущество: 83.3% на Terminal-Bench 2.1 против куда более скромного результата у большинства конкурентов на этом уровне цены. Если продукт построен вокруг CLI-агентов, разница ощутима уже на первой сотне запусков.
Третий — работа с очень большой кодовой базой или пакетом документов на сотни тысяч токенов. Здесь у Grok 4.5 включается наценка выше 200 тысяч токенов, и цена может удвоиться посреди рабочей сессии без явного предупреждения. У Opus 4.8 контекст вдвое больше и наценки нет вообще — для регулярной работы с объемными материалами это предсказуемее с точки зрения бюджета.
Паттерн релизов xAI: почему это важно для выбора
xAI обновляет флагманскую модель каждые пять-шесть недель — Grok 4.5 сменился на Grok 4.6 буквально через пять недель после выхода, по той же цене. Anthropic обновляет линейку заметно реже: между Opus 4.7 и Opus 4.8 прошло несколько месяцев. Это разница не только в цифрах версий, но и в стратегии: если вы завязываете продакшн-пайплайн на Grok, стоит закладывать более частую ревалидацию бенчмарков и цен, чем при работе с Claude — версии xAI устаревают быстрее, и то, что верно сегодня, может не быть верным уже через полтора месяца.
Подарок
Хотите на практике сравнить возможности разных языковых моделей на своих задачах — заберите бесплатный гайд «Как выжать 1000% из текстовых нейросетей».
Частые вопросы
Какая нейросеть лучше: Claude Opus 4.8 или Grok 4.5? Однозначного победителя нет. Opus 4.8 сильнее на кодинге в реальных репозиториях и надежнее на длинных задачах, Grok 4.5 в разы дешевле и токенно-эффективнее. Выбор зависит от приоритета: точность и комплаенс — Opus, стоимость и скорость — Grok.
Актуален ли еще Grok 4.5 или его уже заменили? На момент сравнения Grok 4.5 уже не флагман — 12 августа 2026 года xAI выпустила Grok 4.6 по той же цене $2/$6, всего через пять недель после 4.5. xAI обновляет модели каждые пять-шесть недель, так что при выборе стоит проверять актуальную версию на grok com.
Что дешевле — grok ai или claude нейросеть? Grok дешевле по прямому прайсу: $2/$6 за миллион токенов против $5/$25 у Opus 4.8 — разница в 3.75 раза на смешанной нагрузке. Но Opus решает больше задач с первой попытки, и при частых повторных генерациях итоговая экономия у Grok может быть меньше заявленной.
Доступен ли Grok в России без VPN? Прямая регистрация и оплата на grok com из России не работают, как и у claude официальный сайт. Рабочий путь без VPN — через агрегаторы вроде SpeShu.AI, с оплатой по СБП и русскоязычным интерфейсом.
Почему Илон Маск сравнивал Grok 4.5 именно с Opus 4.7, а не с 4.8? Потому что по уровню возможностей Grok 4.5 ближе именно к Opus 4.7 — предыдущему поколению флагмана Anthropic. Между 4.7 и 4.8 есть заметный разрыв в качестве, и сравнение Grok напрямую с более новой моделью выглядело бы менее выгодно для xAI. Независимые бенчмарки эту разницу подтверждают: Grok 4.5 выигрывает у Opus 4.8 не на всех задачах, а только там, где важна токенная эффективность.
Стоит ли выбирать grok нейросеть только из-за низкой цены? Низкая цена за токен — не то же самое, что низкая цена за решенную задачу. У Grok меньше токенов уходит на ответ, что усиливает экономию, но модель реже решает сложные задачи кодинга с первой попытки по сравнению с Opus 4.8. Если задачи требуют повторных генераций для достижения нужного качества, разница в итоговой стоимости может сократиться.
Заключение
Если вы оптимизируете под стоимость и высокообъемную агентную работу — выбор в пользу Grok 4.5 или его текущей версии Grok 4.6. Если нужен максимальный результат по кодингу и надежность на длинных задачах — Claude Opus 4.8. На кодинговом бенчмарке, где оба вендора публикуют числа напрямую, Opus ведет 69.2% против 64.7%, но Grok дешевле на десятки процентов и работает заметно токенно-эффективнее.
Учитывайте и разницу в темпе обновлений: xAI меняет флагман каждые пять-шесть недель, поэтому любые конкретные цифры по Grok стоит перепроверять перед принятием решения на масштаб — то, что верно сегодня, может измениться к следующему релизу. У Anthropic цикл обновлений заметно длиннее, а значит и параметры выбора остаются стабильными дольше. Попробовать обе модели в одном окне, без VPN и с оплатой в рублях, можно на SpeShu.AI.
Для читателей есть приятный бонус. Введите промокод HABRSPESHUAI при пополнении счета агрегатора и получите +15% на балланс.