

Текст сегодня может стать не только основой статьи, сценария или поста, но и полноценным звуком. Нейросеть для создания аудио из текста позволяет превратить обычный сценарий в голосовую дорожку, описание настроения – в музыкальную композицию, а готовые слова – в песню с вокалом. При этом результат сильно зависит от выбранной модели: одни лучше работают с речью, другие – с музыкой, а некоторые подходят сразу для нескольких форматов.
Если задача уже понятна, не обязательно собирать сложную цепочку из программ для записи, обработки и монтажа. Создавайте аудио с помощью нейросети, выбирая подходящий инструмент под конкретный формат: озвучку статьи, голос для ролика, фоновую музыку, песню или другой аудиоматериал. Такой подход удобнее, чем пытаться использовать одну и ту же модель для совершенно разных задач.

В этом обзоре разберем пять сервисов с разной специализацией: ElevenLabs, MiniMax, Suno, ACE-Step и Udio. Посмотрим, какая нейросеть для озвучки текста лучше подходит для речи, где доступна работа с клонированием голоса и какие решения стоит выбирать для создания песен и инструментальной музыки.
Какие виды аудио можно получить из обычного текста
Текстовый запрос для аудионейросети может выполнять сразу несколько ролей. Иногда это готовый сценарий, который нужно произнести без изменений, а иногда – описание желаемого звучания: например, спокойной фоновой музыки или энергичной песни. Поэтому перед генерацией полезно сначала решить, что должно получиться на выходе – речь, собственный цифровой голос или музыкальный материал.
Самый прямой вариант – озвучка текста нейросетью. В этом случае написанный материал становится основой голосовой дорожки: модель произносит его выбранным голосом с подходящей скоростью и интонацией. Такой формат пригодится для видео, обучающих уроков, инструкций, презентаций, аудиостатей и других материалов, где важно понятно донести содержание до слушателя.
Иначе работает генерация аудио нейросетью для музыкальных задач. Здесь текст необязательно должен прозвучать в готовом файле. Пользователь может описать атмосферу, жанр, темп, инструменты и развитие композиции, а модель на основе этих пожеланий создаст музыкальный вариант. Например, запрос может описывать легкий инструментальный фон без вокала для спокойного информационного ролика.
Еще один сценарий – нейросеть для клонирования голоса. Пользователь предоставляет образец речи, после чего модель воспроизводит характерные особенности звучания в новых фразах. Такой подход удобен при создании серии роликов, уроков или других регулярных материалов, где желательно сохранять один узнаваемый голос без новой записи каждого текста.
Музыкальные модели позволяют пойти еще дальше и превратить идею в песню. В запросе можно задать тему, настроение, характер вокала, инструменты и примерную структуру композиции. Таким образом, аудио с помощью нейросети – это не один формат, а сразу несколько способов работы с текстом: от обычной речевой озвучки до собственного голоса и полноценной музыки.
ТОП-5 ИИ для генерации аудио из текста
Для разных видов аудио нужны разные инструменты. Одни модели лучше подходят для речи и работы с голосом, другие ориентированы на музыку и песни. В подборку вошли пять нейросетей, которые закрывают основные сценарии генерации аудио.
ElevenLabs – для естественной озвучки текста, голосовых дорожек и работы с голосом.
MiniMax – сочетает озвучку, клонирование голоса и создание музыки.
Suno – помогает превращать текстовые идеи в песни и инструментальные композиции.
ACE-Step – подходит для создания музыки и дальнейшей переработки полученного материала.
Udio – используется для генерации песен, вокальных треков и инструментальной музыки с возможностью развивать первоначальную идею.
Такой набор позволяет подобрать ИИ для создания аудио не по количеству функций, а по конечной задаче: озвучить текст, получить собственный голос, сделать музыкальный фон или создать полноценную композицию.
Нейросеть | Лучше всего подходит для | Голосовая озвучка | Клонирование голоса | Создание музыки |
ElevenLabs | Естественной речи | Да | Да | Нет |
MiniMax | Универсальной работы со звуком | Да | Да | Да |
Suno | Песен и музыкальных композиций | Нет | Нет | Да |
ACE-Step | Музыкальной генерации и переработки | Нет | Нет | Да |
Udio | Песен и последовательной работы над треком | Нет | Нет | Да |
1. ElevenLabs – когда основной частью аудио должен быть голос
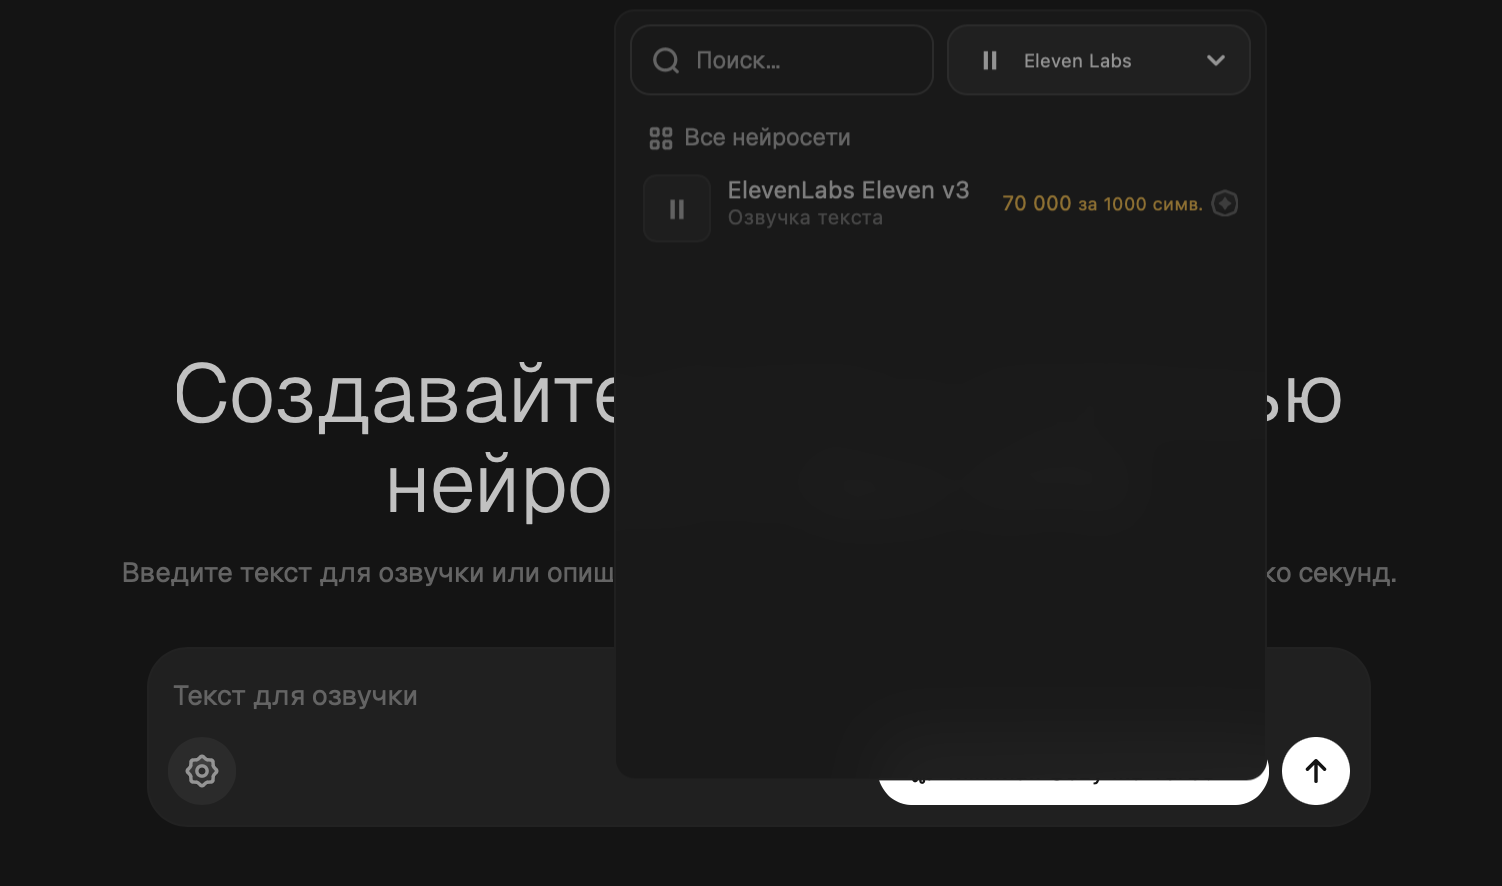
ElevenLabs стоит рассматривать прежде всего как инструмент для проектов, где на первом месте находится речь. Вместо самостоятельной записи пользователь загружает или вводит готовый текст, подбирает подходящую манеру звучания и получает голосовую дорожку. Такая нейросеть для озвучки текста удобна, когда нужно быстро подготовить понятную речь без записи каждой реплики вручную.
Для каких материалов подходит ElevenLabs
Главный сценарий – превращение готового сценария в речь. ElevenLabs озвучка может использоваться для объясняющих видео, инструкций, статей в аудиоформате, презентаций, обучающих материалов и закадрового сопровождения.
Особенно полезен такой подход при регулярном выпуске контента. Вместо повторной записи небольших исправлений можно изменить нужную фразу в тексте и заново получить только этот участок. Поэтому ElevenLabs нейросеть удобна не только для разовой озвучки, но и для материалов, которые периодически приходится обновлять.
Что влияет на естественность речи
Качество результата зависит не только от выбранного голоса. Большую роль играет сам текст. Сложное предложение с несколькими уточнениями может нормально выглядеть на странице, но звучать тяжело при чтении вслух.
Перед тем как озвучить текст нейросетью, полезно представить, как этот материал произнес бы обычный человек. Длинные фразы лучше разделять, важные мысли – выносить отдельно, а там, где нужна естественная остановка, использовать обычную пунктуацию.
Например, вместо фразы:
«Сервис позволяет создавать озвучку для роликов, инструкций, презентаций и других материалов, которые могут использоваться в работе, обучении или публикациях».
Для речи проще:
«Сервис помогает создавать озвучку для разных материалов. Это могут быть ролики, инструкции или презентации. Готовую дорожку можно использовать в работе, обучении и публикациях».
Так синтез речи нейросетью получает более понятную структуру, а готовый голос легче воспринимается на слух.
Как подбирать подачу под содержание
Один голос может звучать по-разному в зависимости от темпа и характера речи. Для инструкции обычно нужна спокойная и ровная подача, для короткого анонса – более энергичная, а для длинной статьи – нейтральная, чтобы голос не утомлял слушателя.
Поэтому при работе с генератором голоса из текста лучше начинать не с поиска самого эффектного тембра, а с вопроса: как должен звучать именно этот материал? Такой подход помогает быстрее подобрать подходящую озвучку и не переделывать весь текст после первой генерации.
Когда ElevenLabs будет удачным выбором
ElevenLabs логично выбирать, если конечный результат – человеческая речь. Например, нужно сделать дикторскую дорожку, превратить статью в аудио или добавить голос в видео. Для таких задач специализированная нейросеть для генерации голоса обычно удобнее музыкальных моделей.
Если же требуется песня, инструментальный фон или полноценная музыкальная композиция, лучше перейти к инструментам, которые изначально ориентированы на музыку. ElevenLabs в этой подборке занимает другую роль – помогает превратить написанный текст в естественно звучащую речь.
2. MiniMax – голос, клонирование и музыка в одном проекте
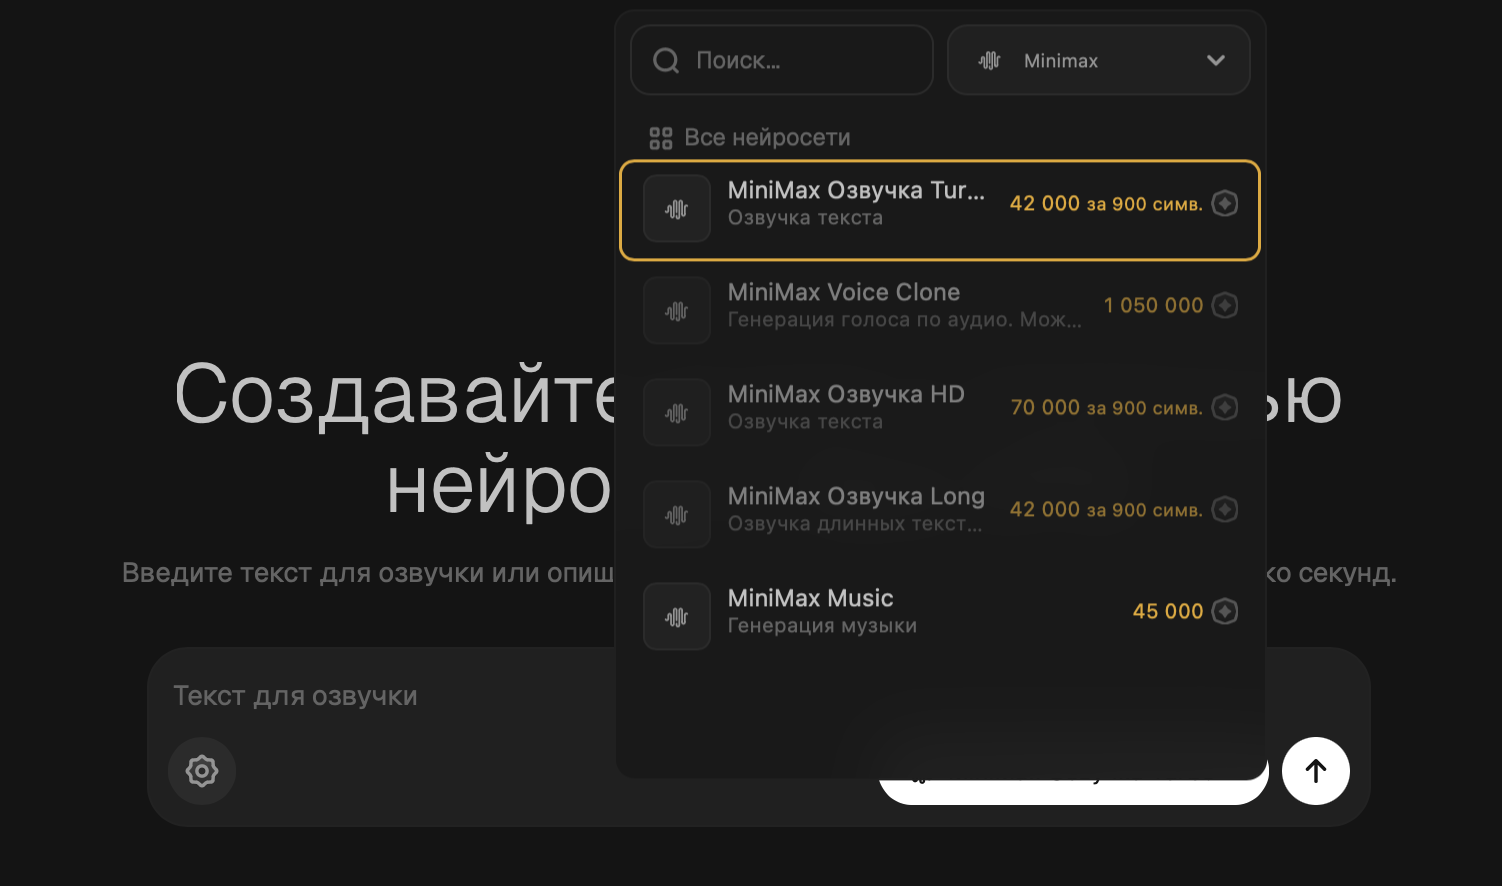
MiniMax интересна более широким набором сценариев. MiniMax Audio можно использовать для озвучки, работы с голосом и музыкальных задач, поэтому модель подойдет пользователям, которым одного преобразования текста в речь недостаточно.
Один текст – несколько вариантов результата
Одно из главных преимуществ такого подхода заключается в том, что текст может выполнять разную роль. В одном случае он становится речью, в другом описывает нужное звучание, а в третьем используется как основа музыкальной идеи.
Поэтому запрос ИИ текст в аудио стоит сначала конкретизировать для себя. Если нужно произнести исходный материал без изменений, выбирается речевой сценарий. Если хочется получить композицию, текст уже должен описывать жанр, настроение, инструменты и характер будущего звука.
MiniMax озвучка для речи и роликов
MiniMax озвучка подходит для ситуаций, когда нужно быстро превратить подготовленный сценарий в голосовую дорожку. Здесь действуют те же основные правила: текст должен быть удобным для восприятия на слух, а выбранная манера речи соответствовать содержанию.
Если требуется генерация речи нейросетью, не стоит перегружать один фрагмент сразу несколькими эмоциональными задачами. Например, попытка в одном предложении сделать голос спокойным, тревожным, радостным и торжественным чаще приводит к менее последовательной подаче. Лучше разделять такие части.
Как работает клонирование голоса
MiniMax клонирование голоса пригодится, когда требуется не просто стандартный голос из библиотеки, а узнаваемое звучание конкретного человека. Система получает образец речи, анализирует его особенности и на их основе формирует цифровой голос.
Чтобы клонирование голоса нейросетью получилось чище, исходная запись должна быть понятной. Желательно избегать фоновой музыки, сильного эха, шума улицы, разговоров других людей и резких перепадов громкости.
Такая нейросеть для создания голоса полезна авторам, которые регулярно озвучивают похожие материалы. Вместо новой записи каждого небольшого изменения можно подготовить обновленный текст и получить новую речевую версию с похожим характером звучания.
Использовать чужой голос без разрешения не стоит. Технология упрощает техническую сторону работы, но согласие человека и право на использование его записи по-прежнему имеют значение.
MiniMax для создания музыки
MiniMax музыка расширяет возможности модели за пределы обычной речи. Здесь текст становится описанием музыкального результата: можно определить характер композиции, темп, настроение и другие детали.
Если задача состоит в том, чтобы создать музыку нейросетью, полезнее написать не «сделай красивую мелодию», а конкретнее: «спокойная современная инструментальная композиция для технологичного ролика, мягкое вступление, средний темп, без вокала».
Чем понятнее музыкальная задача, тем меньше модели приходится самостоятельно додумывать направление. Поэтому хороший генератор аудио нейросеть требует от пользователя не профессиональных музыкальных знаний, а ясного описания того, что он хочет услышать.
Для кого удобен MiniMax
MiniMax особенно интересна для смешанных проектов. Например, в одном ролике может потребоваться голосовая дорожка, узнаваемая манера речи и отдельная музыка. В таком случае универсальный инструмент позволяет экспериментировать с несколькими видами аудио в рамках одного рабочего процесса.
Если пользователь ищет, где создать аудио нейросетью, но пока не уверен, понадобится ему только речь или дополнительно музыка, универсальность может оказаться важнее узкой специализации.
3. Suno – создание песен и музыки по текстовому описанию
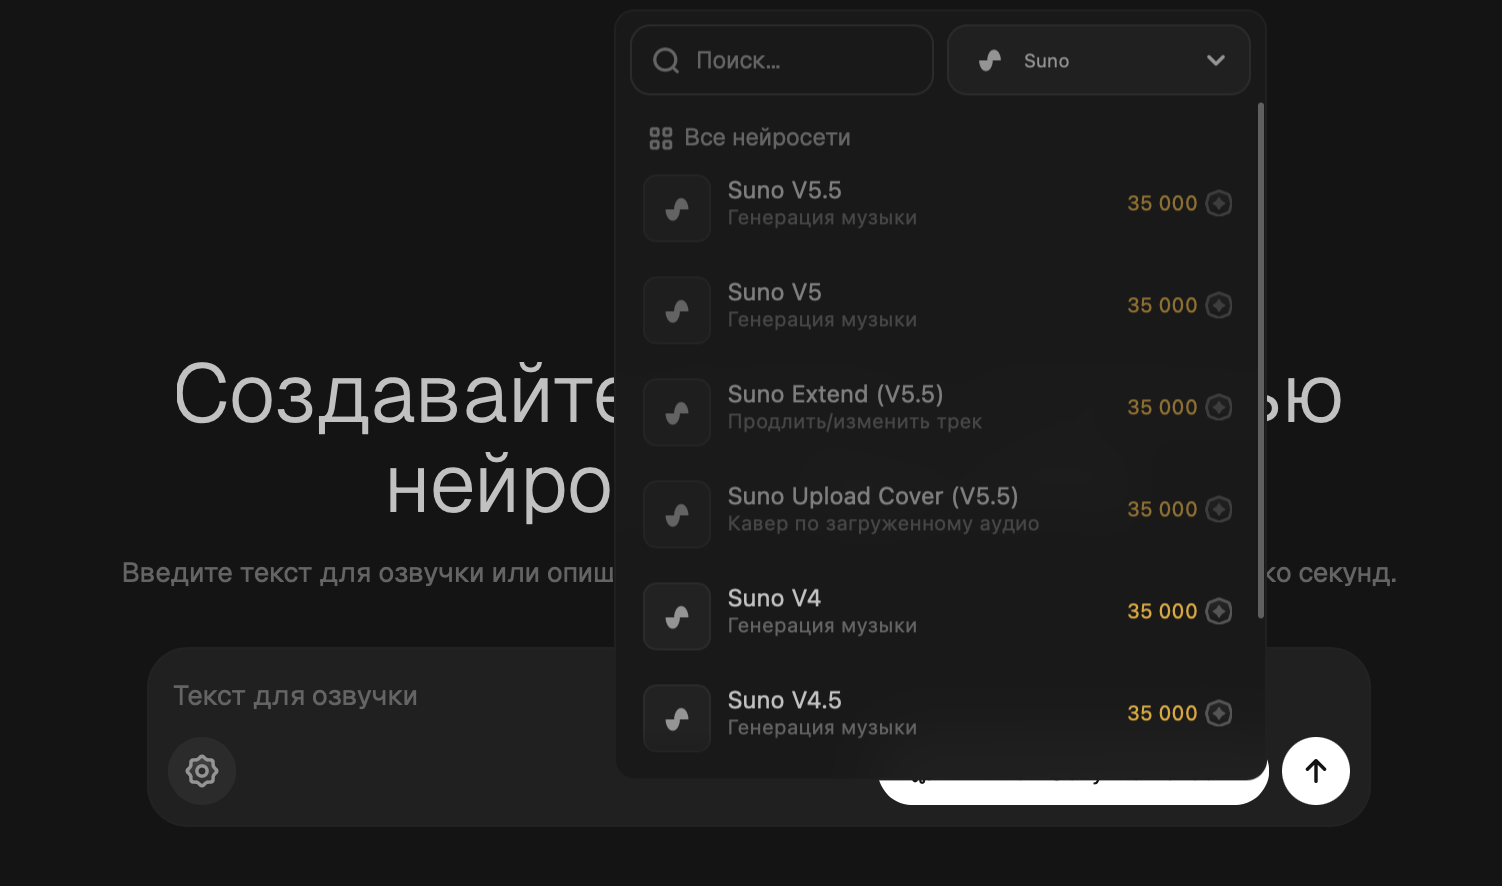
Suno работает уже с другой логикой. Suno нейросеть предназначена прежде всего для музыкального результата: пользователь описывает идею композиции, ее настроение и стиль, а модель создает музыку вместо обычной дикторской дорожки.
Что нужно написать вместо нот
Чтобы работать с музыкальной нейросетью, не требуется уметь записывать партитуру или самостоятельно сочинять мелодию. Гораздо важнее словами объяснить желаемый результат.
Для Suno генерации музыки полезно заранее определить:
общее настроение;
скорость композиции;
жанровое направление;
основные инструменты;
нужен ли вокал;
характер вокала;
тему текста;
желаемое развитие песни.
Так музыка из текста нейросеть создается не буквально из каждого введенного слова. Текстовое описание выступает инструкцией, которая задает направление генерации.
Suno создать песню с вокалом
Запрос Suno создать песню обычно предполагает не только мелодию, но и вокальную часть. Здесь важно разделять описание музыки и содержание самой песни, чтобы итог не получился слишком неопределенным.
Например, вместо запроса «песня о путешествии» полезнее описать атмосферу: энергичная композиция о поездке к морю, легкое летнее настроение, выразительный припев, мужской вокал, живой ритм и светлое звучание.
Так генерация музыки по тексту становится управляемее. Модель понимает не просто тему, а направление, в котором эту тему нужно раскрывать.
Инструментальная музыка без вокала
Suno можно использовать не только для песен. Если слова не нужны, стоит сразу указать, что композиция должна быть инструментальной.
Для удобного поиска музыкального направления можно использовать генератор музыки ИИ. Он особенно полезен, когда задача уже определена как музыкальная и речевая дорожка не требуется.
Как развивать удачную идею
Первая версия композиции не обязательно должна быть финальной. Если понравилось начало, настроение или припев, разумнее развивать сильную идею, чем каждый раз полностью менять направление.
Так Suno AI полезна не только как способ моментально получить песню, но и как инструмент поиска музыкального решения. Можно менять описание, уточнять характер звучания и постепенно приближать результат к нужной задаче.
4. ACE-Step – генерация и переработка музыкальных идей
ACE-Step подойдет тем, кому интересна не только первая генерация, но и дальнейшая работа с музыкальным материалом. ACE-Step нейросеть ориентирована на создание музыки по текстовому заданию и эксперименты с получившейся композицией.
Как описание превращается в музыкальную основу
В работе с ACE-Step полезно мыслить не отдельными ключевыми словами, а цельной сценой. Вместо перечисления «электроника, быстро, синтезатор» лучше представить, где будет звучать трек и какое ощущение должен создать.
Например: динамичная электронная композиция для короткого технологичного ролика, энергичное начало, плотный ритм, яркие синтезаторы, постепенное усиление к финалу.
Так ACE-Step музыка получает понятное направление. Модель знает не только набор характеристик, но и предполагаемую роль композиции.
Почему первую генерацию лучше воспринимать как основу
При создании музыки полезно отказаться от ожидания, что первая попытка должна сразу дать полностью готовую композицию. Генеративный подход удобнее использовать как последовательное создание и уточнение материала.
Сначала определяется общее направление, затем проверяется звучание. После этого можно понять, что именно требуется изменить: темп, плотность инструментов, характер вокала или структуру.
Так ИИ для генерации аудио используется не как кнопка случайного результата, а как рабочий инструмент. Чем понятнее пользователь оценивает промежуточную версию, тем точнее сможет сформулировать следующее изменение.
Для каких задач подойдет ACE-Step
ACE-Step может быть интересна авторам роликов, создателям фоновой музыки, разработчикам игровых проектов и пользователям, которые хотят экспериментировать с композициями. Это особенно удобно, когда требуется не просто получить один трек, а исследовать несколько направлений внутри одной идеи.
Такой подход отличает музыкальную нейросеть для аудио от обычного генератора речи. Здесь важны не только слова, но и ритм, настроение, развитие и взаимодействие отдельных частей композиции.
5. Udio – от короткой идеи к законченной композиции
Udio ориентирована на создание музыкального материала с вокалом или без него. Udio нейросеть подходит для пользователей, которые хотят сформировать музыкальную идею, получить начальный вариант и затем постепенно развивать его.
Из чего складывается хороший запрос для Udio
Хороший запрос должен отвечать хотя бы на несколько вопросов. Какой жанр нужен? Какое настроение должно появиться у слушателя? Нужны ли слова? Каким должен быть вокал? Какие инструменты будут определять звучание?
Например, запрос может выглядеть так: спокойная атмосферная композиция, мягкое фортепиано и струнные, медленный темп, без вокала, постепенное эмоциональное усиление во второй половине.
Так Udio генерация музыки получает больше опорных точек. Даже если пользователь не знает профессиональных музыкальных терминов, он может описать звучание обычными словами.
Песня с вокалом и инструментальная композиция
Udio можно использовать для двух принципиально разных направлений. Первое – полноценная песня, где музыка сочетается с вокалом. Второе – инструментальный материал, в котором голос вообще не требуется.
Для песни важны тема, эмоциональный характер и вокальная подача. Для фоновой музыки больше внимания стоит уделить инструментам, динамике и тому, насколько композиция будет заметной относительно другого контента.
Поэтому нейросеть для генерации песни и инструментальный генератор решают близкие, но не одинаковые задачи. В песне вокал может быть главным элементом, а в фоновом треке слишком активная мелодия иногда только мешает.
Как постепенно развивать композицию
Удобный подход – сначала определить сильный музыкальный фрагмент, а уже затем строить вокруг него более длинную композицию. Так проще сохранять единое настроение и не менять направление на каждом новом участке.
Именно поэтому генератор песни из текста нейросеть полезно воспринимать как инструмент для последовательной работы. Начальная идея становится отправной точкой, которую можно развивать до более полноценного результата.
Дополнительные инструменты RANVIK для работы с нейросетями
ИИ для создания и редактирования изображений – в разделе можно создавать картинки по текстовым запросам, улучшать исходные фотографии, повышать их разрешение, корректировать отдельные элементы и удалять фон.
Нейросети для генерации текстов – инструменты подходят для написания и переработки материалов, перевода, поиска новых идей, подготовки сценариев, публикаций, описаний и других видов текстового контента.
Создание видео с помощью ИИ – сервис помогает генерировать ролики по описанию, работать с содержимым кадра, добавлять анимацию, надписи, графические элементы и различные визуальные эффекты.
Платформа нейросетей RANVIK – единое онлайн-пространство с инструментами искусственного интеллекта для создания и обработки текста, изображений, видео и аудиоматериалов.
ИИ для генерации аудио – раздел предназначен для озвучивания текста, создания музыки и мелодий, а также подготовки аудиоматериалов с нужным характером и стилем звучания.
Оживление фотографии нейросетью – инструмент позволяет добавить движение статичному изображению и получить короткое видео с плавной анимацией и естественной динамикой.
Озвучка текста нейросетью – функция преобразует написанный материал в речь и позволяет подобрать подходящий голос, тембр, интонацию, эмоцию и характер подачи.
Нейросеть для генерации музыки – с помощью инструмента можно создавать музыкальные композиции и песни, задавая жанр, настроение, темп, стиль и другие особенности будущего трека.
Готовые промты для генерации фото – подборка запросов помогает подробнее формулировать идеи для нейросети, точнее задавать сцену, стиль и детали будущего изображения.
Готовые запросы для генерации видео – коллекция промтов упрощает создание роликов для рекламы, социальных сетей, презентаций, коротких видео и других творческих задач.
Как подготовить текст перед созданием аудио
Независимо от выбранной модели качество исходного текста сильно влияет на результат. Это особенно заметно при речевой генерации, где каждое длинное предложение, сокращение или необычное имя будет произнесено системой.
Если нужно создать аудио из текста онлайн, сначала уберите элементы, которые хорошо выглядят на странице, но плохо звучат вслух. Сложные скобки, длинные перечисления, ссылки, технические обозначения и перегруженные предложения лучше адаптировать.
Делите длинные предложения
Для слуха информация воспринимается иначе, чем при чтении. Человек не может глазами вернуться на начало фразы, поэтому длинная конструкция быстро теряет понятность. Так нейросеть для преобразования текста в голос получает более четкую структуру, а слушателю проще понять содержание.
Проверяйте числа и сокращения
Цифры, даты и аббревиатуры стоит отдельно прослушивать после генерации. Иногда написание, которое понятно человеку на экране, может быть произнесено не так, как ожидалось.
Если слово стабильно звучит неправильно, попробуйте написать его иначе или заменить сокращение полной формой. Это простой способ улучшить синтез речи нейросетью без изменения самого голоса.
Используйте пунктуацию как подсказку
Точки, запятые, двоеточия и тире помогают разделить речь на смысловые части. Не стоит расставлять десятки лишних знаков ради искусственных пауз, но обычная грамотная пунктуация действительно влияет на восприятие.
Когда ИИ текст в речь читает хорошо подготовленный сценарий, голос обычно звучит спокойнее и понятнее. Поэтому редактура текста перед генерацией часто дает больше пользы, чем бесконечная смена голосов.
Как подготовить текст песни
Текст для песни требует другого подхода. Здесь важны повторяемость, длина строк, место припева и общая логика развития истории.
Если используется нейросеть для создания аудио, ориентированная на музыку, лучше заранее разделить текст хотя бы на смысловые части. Не обязательно составлять сложную профессиональную схему, но куплет и припев должны выполнять разные функции.
Куплет рассказывает
В куплете можно развивать сюжет, добавлять детали и постепенно вести слушателя к основной мысли. Слишком много текста в одной части усложняет музыкальное оформление, поэтому длинные абзацы лучше сократить.
Припев запоминается
Припев желательно сделать короче и проще. Он может повторять главную мысль песни, содержать яркую фразу или эмоциональный образ.
Так создание аудио нейросетью становится более предсказуемым: модель получает не сплошную стену текста, а материал с понятной логикой.
Не перегружайте песню деталями
Если хочется рассказать целую историю, не обязательно помещать все события в один куплет. Некоторые подробности можно убрать, чтобы музыка и вокал оставались свободными.
Как написать промт для генерации аудио
Промт – это не набор красивых прилагательных, а краткое техническое задание. Чем точнее пользователь объясняет, что хочет услышать, тем легче модели выбрать направление.
Чтобы создать аудио с помощью нейросети, полезно сначала определить пять вещей: тип результата, настроение, темп, голос или инструменты и назначение готового файла.
Задача | Что стоит указать | Пример направления |
Озвучка | Тип голоса, возраст, темп, эмоция, назначение | Спокойный голос, средний темп, объясняющая подача |
Реклама | Энергия, скорость, эмоциональный акцент | Бодрая подача, четкая речь, активное начало |
Фоновая музыка | Жанр, инструменты, настроение, наличие вокала | Спокойная электроника, мягкие синтезаторы, без вокала |
Песня | Жанр, сюжет, вокал, темп, структура | Энергичная песня о путешествии, яркий припев |
Джингл | Длительность, настроение, характер бренда | Короткая светлая заставка с запоминающимся мотивом |
Для вдохновения можно посмотреть промпты для музыки и аудио ИИ. Готовые примеры лучше не копировать механически, а использовать как основу и менять под свою задачу.
Какие параметры голоса действительно важны
При речевой генерации пользователи часто слишком долго выбирают тембр и забывают о других характеристиках. На практике скорость, эмоциональность и манера подачи могут повлиять на восприятие не меньше самого голоса.
Скорость речи
Медленная речь подходит для сложных объяснений, расслабленных историй и материалов, где слушателю требуется время на осмысление информации. Но чрезмерно медленная подача может сделать простой ролик тяжелым.
Средний темп универсален для большинства информационных материалов. Если используется нейросеть для озвучки текста на русском, именно с него разумнее начинать тестирование.
Быстрая речь может хорошо работать в динамичных роликах и коротких рекламных сообщениях. Но чем выше скорость, тем проще потерять разборчивость имен, цифр и сложных терминов.
Эмоциональность
Не всегда более эмоциональный голос означает более качественный результат. Для инструкции слишком активная подача может отвлекать, а для праздничного ролика, наоборот, полностью нейтральная речь покажется скучной.
Поэтому генерация голоса нейросетью должна отталкиваться от содержания. Голос существует не отдельно от текста, а помогает передать его смысл.
Возраст и характер голоса
Возраст можно использовать как ориентир, а не как абсолютно точную характеристику. Формулировки вроде «молодой энергичный голос» или «зрелая спокойная подача» часто полезнее, чем попытка задать конкретное число.
При этом генератор голоса нейросеть на русском лучше направлять описанием характера звучания. Пользователь может не знать точных акустических терминов, но обычно хорошо понимает разницу между мягким, уверенным, серьезным и энергичным голосом.
Как управлять паузами и интонацией
Хорошая речь состоит не только из правильно произнесенных слов. Если система читает предложения без естественных смысловых остановок, даже качественный голос начинает звучать искусственно.
При работе с нейросетью для аудио сначала попробуйте обычную пунктуацию. Разбейте длинные предложения, добавьте точки там, где мысль заканчивается, и не превращайте целый абзац в одну фразу.
Где нужны заметные паузы
Небольшая остановка полезна:
после законченной мысли;
перед важным выводом;
между разными смысловыми частями;
перед финальной фразой;
при переходе от проблемы к решению.
Но не нужно ставить паузу после каждого короткого словосочетания. Иначе ИИ синтез речи будет звучать слишком дробно.
Как выделить важную мысль
Если ключевая фраза теряется внутри длинного предложения, вынесите ее отдельно. Часто это эффективнее попытки заставить систему интонационно выделить три слова внутри перегруженной конструкции.
Например: «Главное преимущество сервиса заключается в том, что генерация занимает мало времени».
Можно заменить на: «Главное преимущество – скорость. Пользователю не нужно самостоятельно записывать каждую реплику».
Так нейросеть текст в голос получает более выразительную структуру еще до начала синтеза.
Как получить длинную озвучку без заметных скачков
Большие статьи, главы книг и обучающие материалы лучше не превращать в один огромный блок. Работать с длинным текстом удобнее частями, особенно если планируются дополнительные исправления.
Когда используется генератор аудио из текста онлайн, разделите материал по естественным смысловым границам. Главу можно разбить на вступление, несколько разделов и финальную часть.
Сохраняйте один характер голоса
Если между фрагментами постоянно менять темп и эмоциональность, после объединения это будет заметно. Поэтому основные настройки стоит определить заранее и использовать последовательно.
Для длинного проекта нейросеть для создания аудио онлайн удобнее применять как часть процесса. Сначала тестируется короткий фрагмент, затем фиксируется подходящая манера, после чего озвучивается основной материал.
Делайте логичные места для склейки
Лучше заканчивать отдельный файл в конце абзаца или законченной мысли. Склейка посреди предложения почти всегда сложнее и заметнее.
Если нужно создать озвучку из текста на несколько десятков минут, не бойтесь разделять материал на небольшие части. При одинаковом голосе и настройках их можно собрать гораздо аккуратнее.
Проверяйте начало каждого следующего фрагмента
После паузы голос иногда воспринимается иначе, даже если технические настройки не изменились. Поэтому полезно прослушивать конец предыдущей части вместе с началом новой.
Так озвучка текста нейросетью онлайн превращается из простой генерации отдельных файлов в последовательную работу над цельным аудиоматериалом.
Как сделать музыку, которая не мешает голосу
Фоновая композиция должна поддерживать ролик, а не конкурировать с диктором. Особенно часто проблема возникает, когда музыка сама по себе звучит интересно, но содержит слишком активную мелодию.
Если используется нейросеть для генерации музыки, прямо укажите назначение трека. Формулировка «спокойная фоновая инструментальная музыка под голосовую озвучку» намного полезнее, чем просто «красивая музыка».
Не перегружайте середину композиции
Когда одновременно звучат плотные ударные, яркая мелодия и множество дополнительных инструментов, голос сложнее воспринимать. Для фонового сопровождения часто лучше более свободная аранжировка.
Это особенно важно, если создание звуков нейросетью используется для информационного ролика. Здесь содержание речи обычно важнее музыкальной выразительности.
Осторожнее с вокалом
Если поверх музыки будет диктор, полноценный вокал почти всегда создает конкуренцию за внимание. Человеческому слуху трудно одновременно разбирать две разные речевые линии.
Поэтому для закадрового сопровождения обычно разумнее создать музыку нейросетью без вокала. Песню с текстом лучше использовать там, где именно она является основным содержанием.
Учитывайте развитие ролика
Музыка необязательно должна звучать одинаково от начала до конца. Для вступления подойдет спокойное начало, перед ключевым моментом можно добавить динамики, а к финалу снова сделать композицию проще.
Так ИИ для генерации аудио и звуков может использоваться не просто для получения случайного фона, а для поддержки структуры всего материала.
Как соединить озвучку и музыку в одном проекте
Один из самых практичных сценариев – использовать разные нейросети для разных частей результата. Например, речь можно подготовить в ElevenLabs или MiniMax, а музыку – в Suno, ACE-Step или Udio.
Рабочая последовательность может выглядеть так:
Подготовить финальный сценарий.
Сделать речевую дорожку.
Проверить ее длительность.
Определить настроение музыкального фона.
Создать инструментальную композицию.
Подогнать музыку по длине.
Снизить ее громкость относительно речи.
Проверить начало, переходы и финал.
Так нейросети для работы с аудио можно комбинировать, не пытаясь заставить одну модель выполнять все задачи одинаково хорошо.
Сначала голос, потом музыка
Если главный элемент материала – речь, удобнее сначала получить финальную озвучку. Тогда становится известна реальная продолжительность ролика и места, где находятся важные фразы.
После этого нейросеть для создания музыки получает более понятную задачу. Можно сразу описать настроение, длительность и характер развития композиции.
Как подготовить запись для клонирования голоса
Качество исходника влияет на то, насколько убедительно будет звучать цифровой голос. Поэтому случайная запись из шумного кафе – далеко не лучший материал.
Если используется нейросеть для клонирования голоса, постарайтесь записать человека в относительно тихом помещении. Телефон можно использовать, если он находится достаточно близко и не записывает сильное эхо.
В записи должен говорить один человек
Фоновый разговор усложняет анализ. Еще хуже, если люди перебивают друг друга. Для клонирования голоса нейросетью лучше выбрать чистый фрагмент, где слышен только нужный голос.
Избегайте музыки
Музыкальный фон может смешиваться с характеристиками речи. Даже если человеку кажется, что музыка звучит тихо, модель получает общий аудиосигнал.
Говорите естественно
Не нужно специально менять голос, говорить слишком медленно или изображать диктора. Если цифровая копия нужна для обычной речи, исходный образец тоже должен быть максимально естественным.
Хорошая нейросеть для создания голоса лучше работает с материалом, который действительно отражает привычную манеру человека.
Как создать единый стиль аудио для серии материалов
Если выпускается не один ролик, а целая серия, каждую новую генерацию не стоит начинать с нуля. Лучше заранее определить несколько постоянных характеристик.
Для речи можно сохранить один голос, похожий темп и степень эмоциональности. Тогда генерация речи нейросетью будет восприниматься как единая линия, даже если темы роликов отличаются.
Для музыки можно выбрать постоянное направление: например, мягкая электроника с минимальным количеством инструментов и без вокала. Не обязательно использовать один и тот же трек, достаточно общей стилистики.
Так нейросеть для аудио помогает сформировать узнаваемое звучание. Пользователь перестает каждый раз искать совершенно новую подачу и постепенно создает собственный аудиостиль.
Какие нейросети для генерации аудио выбрать
Если главная задача – речь, стоит начинать со специализированных голосовых решений. ElevenLabs подходит для естественной озвучки, а MiniMax дополнительно интересна возможностями работы с голосом и музыкальными сценариями.
Для создания песен и инструментальной музыки больше подходят Suno AI, ACE-Step и Udio. Эти лучшие нейросети для генерации аудио в рамках подборки решают похожую музыкальную задачу, но отличаются подходом к созданию и дальнейшему развитию материала.
Поэтому запрос создать аудио нейросетью сначала стоит превратить в более конкретную цель. Нужна речь – выбирайте голосовую модель. Нужна песня – музыкальную. Требуется собственный голос – инструмент с клонированием.
Такой подход полезнее поиска абстрактно «самой лучшей» модели. ИИ для генерации аудио становится действительно эффективным только тогда, когда его специализация совпадает с конечным результатом.
FAQ
Как просить нейросеть правильно произнести сложную фамилию или название?
Да, но редкие имена иногда приходится дополнительно проверять. Если нейросеть текст в голос произносит слово неправильно, попробуйте изменить написание так, чтобы оно точнее передавало звучание, или разделить слово на более понятные части. Для важных роликов лучше сначала протестировать одну короткую фразу, а уже затем запускать полный сценарий.
Почему после объединения нескольких озвученных фрагментов слышен переход?
Причиной может быть разная длина паузы, громкость или слегка изменившаяся манера речи. При работе через ИИ текст в аудио лучше заканчивать каждый фрагмент законченной мыслью и оставлять небольшое пространство для монтажа. Также стоит сохранять одинаковые параметры голоса во всех частях проекта.
Можно ли использовать один и тот же голос во всех роликах?
Да, и для серии материалов это часто полезно. Постоянный голос помогает сформировать узнаваемую подачу, особенно если ИИ синтез речи используется для регулярных обучающих или информационных публикаций. Желательно также сохранять похожую скорость и эмоциональность, чтобы материалы звучали единообразно.
Что делать, если музыка хорошо звучит в наушниках, но плохо на телефоне?
Такое происходит, если основное впечатление строится на низких частотах или очень широком звучании. После того как генерация звуков нейросетью завершена, полезно прослушать композицию не только в наушниках, но и через обычный динамик телефона или ноутбука. Для фоновой музыки особенно важно, чтобы основная мелодия оставалась понятной даже на простом устройстве.
Заключение
Современная нейросеть для создания аудио может решать совершенно разные задачи – от чтения обычного текста до создания цифрового голоса, инструментальной музыки и полноценной песни. ElevenLabs удобна для речи, MiniMax сочетает несколько аудионаправлений, а Suno, ACE-Step и Udio ориентированы прежде всего на музыкальное творчество.
Главное – сначала понять конечную задачу, а уже потом выбирать инструмент. Хорошо подготовленный текст, конкретный промт и последовательная работа с результатом позволяют создать аудио нейросетью гораздо точнее, чем десятки случайных генераций без понятного направления.