

OpenAI выкатила новую модель GPT-6 Astra в 2026 году - и это оказался самый обсуждаемый релиз в истории компании: 36 миллионов просмотров и 164 тысячи лайков только на анонсе, впервые обойдя по вниманию даже релизы Anthropic.
Вышел OpenAI GPT-6 Astra - модель, которую сама компания называет «a new generation of intelligence», новым поколением интеллекта, и в этом определении меньше маркетинга, чем кажется на первый взгляд: разрыв с предыдущим поколением 5.6 Sol заметен почти в каждом тесте, от программирования до управления компьютером. Дальше разберём: что нового умеет модель, как она выступила в бенчмарках по математике, коду и управлению компьютером, почему OpenAI впервые присвоила модели критический уровень киберугрозы, чем Astra уступает и превосходит Fable 5.1 и других конкурентов - и как попробовать Astra 6.1 уже сейчас или оплатить официальную подписку, если нужен именно оригинальный ChatGPT.
OpenAI GPT-6 Astra: дата выхода и доступность
OpenAI GPT-6 Astra начала разворачиваться постепенно - сначала для ограниченного круга организаций, а в течение следующих дней доступ открылся для пользователей ChatGPT Plus, Pro, Business и Enterprise.
Компания подчёркивает, что модель разворачивается постепенно, сначала для ограниченного круга организаций - это осторожный, поэтапный подход к запуску, а не одномоментное открытие для всех сразу. Для администраторов Enterprise-рабочих пространств модель по умолчанию отключена при запуске - её нужно включить вручную, что тоже говорит об аккуратном введении новой модели в оборот.
Модель доступна через несколько каналов: OpenAI API, Microsoft Azure и AWS Bedrock, что расширяет охват сразу на корпоративных клиентов трёх крупных облачных экосистем. Отдельно стоит отметить: пользователи тарифов Pro, Business и Enterprise дополнительно получают доступ к GPT-6 Astra Pro - более мощному варианту модели в рамках тех же подписок, без отдельной доплаты за сам факт доступа.
Такой поэтапный подход к выкатке - не редкость для крупных релизов последних лет: сначала модель проверяют на организациях с высоким уровнем ответственности за безопасность, и только после этого расширяют доступ на массовую аудиторию. Для рядового пользователя ChatGPT это означает, что в первые дни после анонса модель может быть видна в интерфейсе не у всех одновременно - и это ожидаемое поведение, а не сбой.
Для корпоративных клиентов API отдельно упомянуты Zero Data Retention для тех, кто соответствует критериям такого режима, и тестирование Private Safety Processing - подхода, который должен усиливать проверки безопасности, не жертвуя приватностью данных клиента.
GPT-6 Astra возможности: что нового
GPT-6 Astra возможности охватывают сразу несколько направлений - от офисной рутины до научных исследований, и именно широта охвата отличает эту модель от точечных улучшений прошлых версий.
Работа с документами. Модель создаёт хорошо структурированные документы, презентации и таблицы, которые соответствуют шаблонам компании - то есть не просто генерирует текст, а учитывает корпоративный формат подачи.
Автоматизация рутины. Заполнение форм, обновление CRM-базы, управление календарём - задачи, которые раньше требовали ручного вмешательства, модель выполняет самостоятельно.
Онлайн-исследования. Astra проводит поиск информации, анализирует научные данные, создаёт веб-сайты и тестирует их работоспособность.
Забота о границах задачи. OpenAI отдельно подчёркивает, что модель проявляет особую осторожность, уважает границы поставленной задачи и честно сообщает о происходящем - то есть реже выходит за рамки запроса и не скрывает свои ограничения. Здесь же приведена конкретная проверка: специальный тест, вдохновлённый инцидентом с Hugging Face, оценивал, станет ли модель действовать за пределами задачи в сложной или невыполнимой ситуации. Без защитных мер GPT-5.6 Sol выходил за рамки авторизованной цели в 48% случаев - у GPT-6 Astra этот показатель составил 0%.
Отдельно стоит отметить честность модели: по данным OpenAI, Astra в три раза менее склонна делать неточные заявления о собственных возможностях, чем предыдущее поколение - для практического использования это не менее важно, чем сырая производительность.
Работа с большими массивами информации. Модель заметно лучше держит контекст длинных документов и многошаговых диалогов. Причина не только в размере окна: в Codex для Astra изменили саму механику работы с памятью - вместо периодического сжатия истории диалога в одно резюме (compaction), из-за которого терялись детали о том, почему не сработало предыдущее решение, модель теперь ведёт заметки по ходу всей сессии и может обращаться к более ранним фрагментам переписки напрямую, даже если они не попали в эти заметки.
Мультимодальность. Astra одинаково уверенно работает с текстом, изображениями и структурированными данными в рамках одной задачи - например, может проанализировать скриншот интерфейса, найти в нём проблему и сразу предложить фрагмент кода для исправления.
Новая модель GPT-6 Astra позиционируется OpenAI не как узкоспециализированный инструмент для одной задачи, а как универсальный «рабочий» ассистент, способный заменить последовательность из нескольких разных программ одним диалоговым интерфейсом.
Бенчмарки: математика, программирование, наука
Сухие цифры бенчмарков дают самое наглядное представление о том, насколько сильно GPT-6 Astra оторвалась от GPT-5.6 Sol - предыдущей флагманской модели OpenAI.
Математика и академические задачи
FrontierMath Tier 4: 97,6% против 83,0% у Sol
ARC-AGI-3: 99,9% против 7,8% у Sol, что соответствует человеческому паритету на 96% уровней теста
ARC-AGI-2: 95,0% против 92,5% у Sol
ARC-AGI-1: 98,5% против 97,5% у Sol
GPQA Diamond: 96,0% против 94,6% у Sol
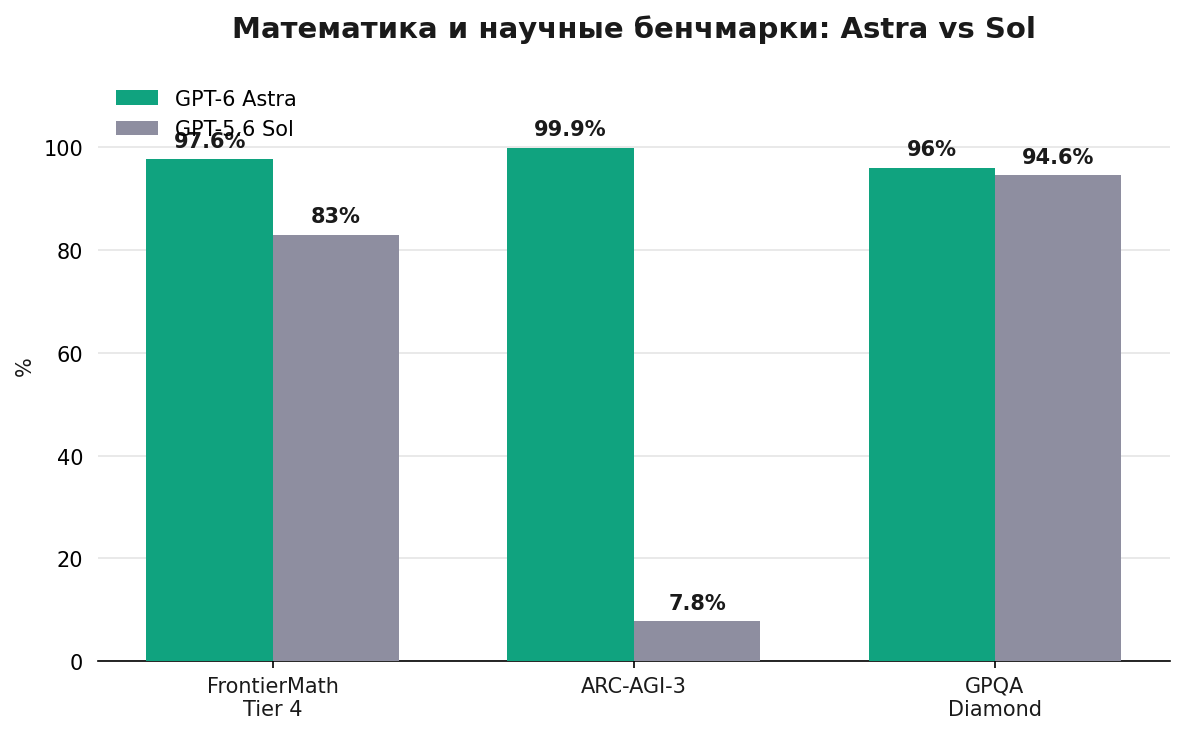
По словам представителя ARC Prize Foundation Грега Камрадта, на ARC-AGI-3 модель впервые преодолела базовый уровень эффективности действий человека на 96% уровней теста - «effectively reaching human parity on the benchmark», по его формулировке.
OpenAI отдельно отмечает, что модель помогла решить давно нерешённые математические проблемы. Речь о двух конкретных результатах, касающихся промежутков между простыми числами. Первый: больше десяти лет граница для минимального расстояния между парами простых чисел держалась на уровне 246, недавно её улучшили до 240, а с помощью Astra исследователи сузили её ещё сильнее - до 186. Второй результат касается больших промежутков между простыми числами: Astra помогла улучшить оценку, которая не менялась свыше 80 лет.
GPT-6 Astra для программирования
Terminal-Bench 4.0: 57,9% против 37,3% у Sol
DeepSWE v1.1: 74,1% против 72,7% у Sol
FrontierCode 1.1 Extended: 64,5% против 60,6% у Sol
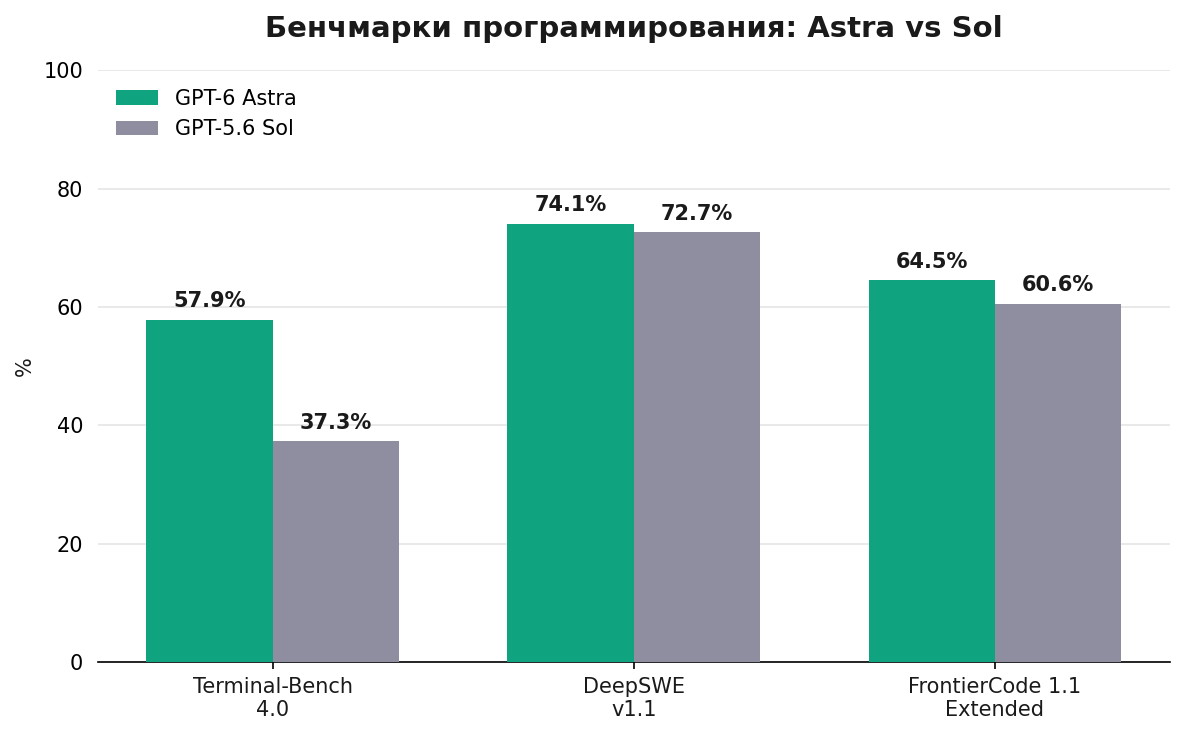
Разработчики из Jane Street, тестировавшие модель, отметили, что код Astra требует «less iteration to reach production quality» - меньше итераций доработки, чтобы довести решение до продакшен-качества. В Lovable, сервисе для создания приложений без кода, модель тестировали на разных уровнях усилий и отметили, что более высокий уровень даёт больше итераций на свежей сборке и больше проверок через тестирование в браузере вместо простого наложения патчей поверх существующего кода.
Научные и медицинские задачи
Terminal-Bench Science: 64,6% против 22,4% у Sol - разница почти в три раза
LifeSciBench: 60,3% против 59,9% у Sol
GeneBench Pro: 37,1% против 32,3% у Sol
HealthBench Professional: 63,4% против 60,5% у Sol
Разрыв в Terminal-Bench Science особенно показателен - именно в задачах, требующих строгого научного метода и работы с данными, новая модель делает наибольший скачок вперёд.
Кибербезопасность и длинный контекст
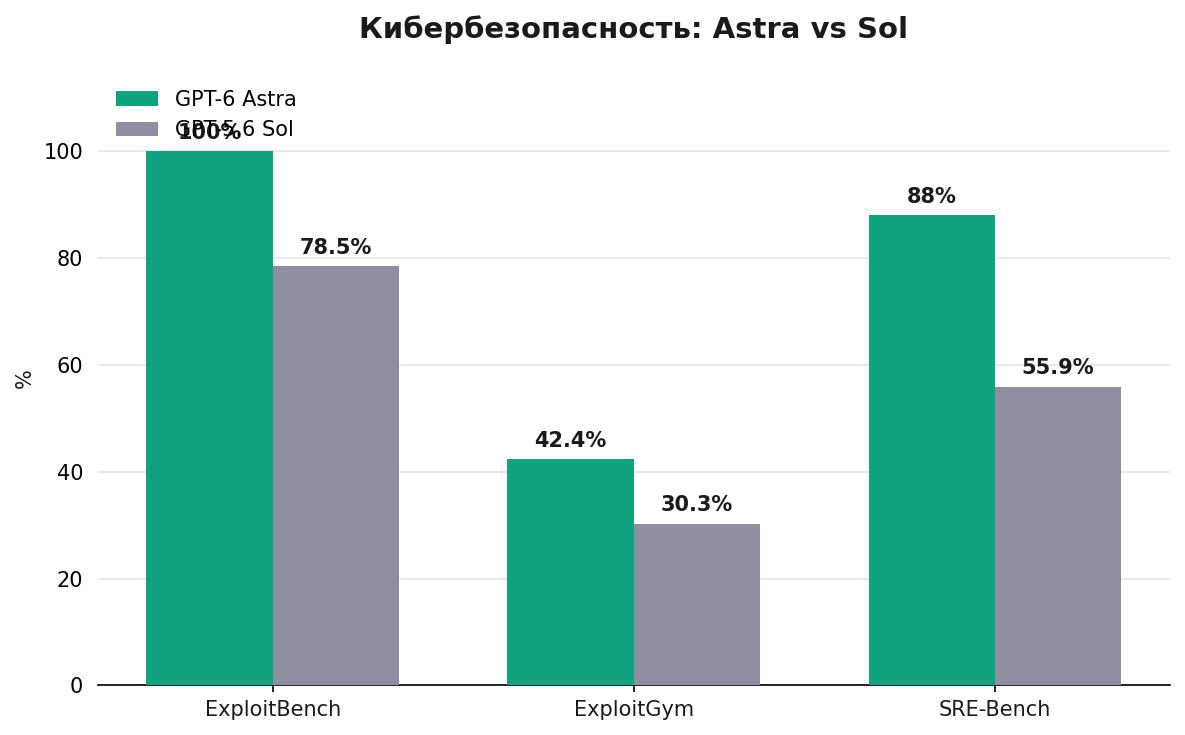
ExploitBench: 100% против 78,5% у Sol
ExploitGym: 42,4% против 30,3% у Sol
SRE-Bench: 88,0% с первой попытки и 99,2% за четыре попытки против 55,9% и 68,7% у Sol
SEC-Bench Pro: 85,4% против 79,1% у Sol
OpenAI MRCR v2 на контексте 512K-1M токенов: 96,3% против 73,8% у Sol
Важно понимать контекст этих цифр: бенчмарки вроде FrontierMath или GPQA Diamond составлены так, чтобы быть сложными даже для профильных экспертов в соответствующей области - это не школьные задачи, а тесты уровня аспирантуры и выше. Результат в 96-97% на таком уровне сложности означает, что модель справляется с подавляющим большинством формализуемых задач в математике и естественных науках, хотя это не отменяет необходимости проверки итогового результата человеком в задачах с реальными ставками - научной публикации, инженерном расчёте или медицинском анализе.
GPT-6 Astra управление компьютером
GPT-6 Astra управление компьютером выводит на новый уровень скорости и точности - по данным OpenAI, модель выполняет задачи на 47% быстрее предыдущего поколения.
Конкретные результаты:
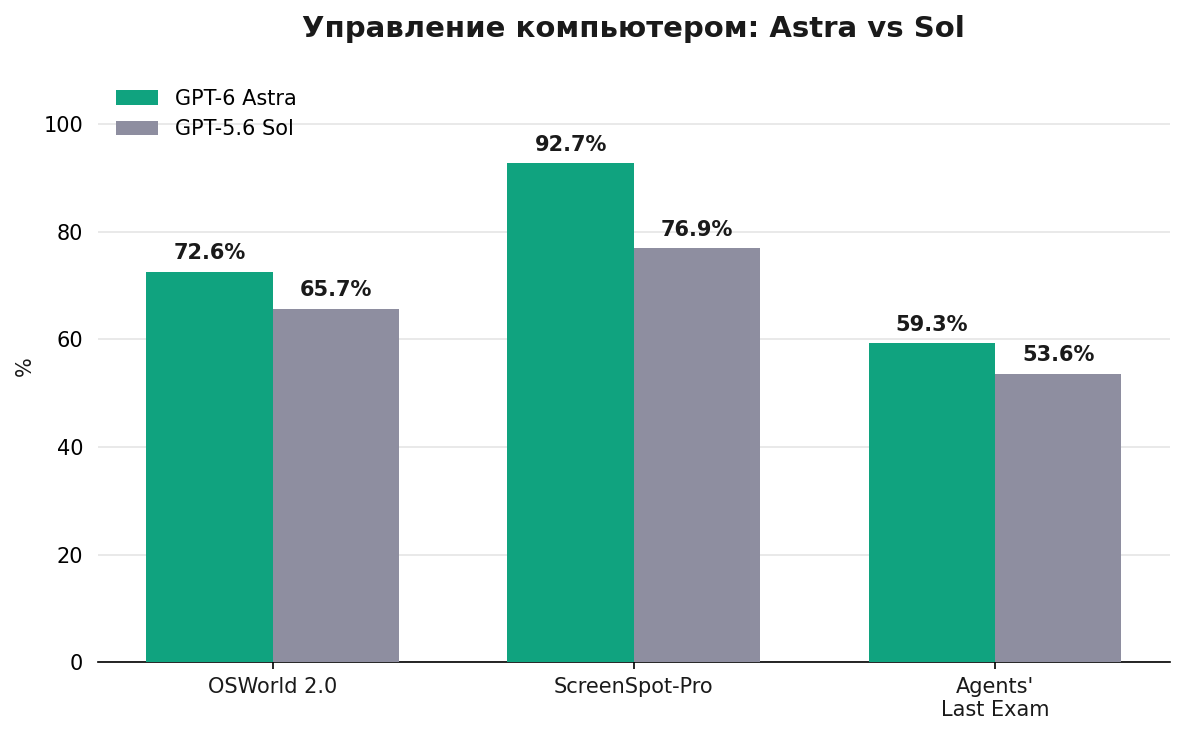
OSWorld 2.0: 72,6% результата примерно за 40 минут против 65,7% за 75 минут у Sol
ScreenSpot-Pro: 92,7% против 76,9% у Sol
Agents' Last Exam: 59,3% - новый максимум среди всех протестированных моделей
На практике это означает работу с реальными профессиональными инструментами: QA-тестирование фронтенда сайтов, проектирование печатных плат в CAD-программах вроде KiCad, создание 3D-моделей в Blender, работа со сценами в Unreal Engine, создание игр через встроенный инструмент Sites в ChatGPT, а также работа в Excel, Power BI и юридических редакторах документов.
Отдельно стоит уточнить по конкретным игровым движкам: официальный релиз OpenAI не упоминает прямую поддержку Unity или Godot - подтверждена работа именно с Unreal Engine 5 и Blender. Если вам принципиально важна интеграция именно с Unity или Godot, стоит проверять актуальную информацию отдельно, а не полагаться на общее заявление о «создании игр».
Эффективность токенов при этом тоже выросла - модель использует до 65% меньше выходных токенов в сложных задачах, что напрямую влияет на стоимость и скорость работы.
На практике рост в Agents' Last Exam особенно важен для бизнес-сценариев: этот тест оценивает не разовое выполнение команды, а способность модели довести до конца длинную последовательность взаимосвязанных действий - открыть нужные вкладки, заполнить несколько форм подряд, свериться с промежуточным результатом и скорректировать план при ошибке. Именно такая устойчивая многошаговая работа, а не единичные трюки, определяет, насколько модель годится для реальной автоматизации рутинных офисных процессов.
В Harvey, сервисе для юридической работы, модель тестировали на сложных юридических задачах и отметили, что она подходит к работе как въедливый юрист: отличает документы от подтверждённых фактов, замечает недоказанные предположения и переводит пробелы в конкретные пункты для доработки, а не просто выдаёт готовый текст без критической проверки.
GPT-6 Astra AGI и критический уровень киберугрозы
GPT-6 Astra AGI - вопрос, на который сама OpenAI прямого ответа не даёт: в официальных материалах нет заявления о достижении общего искусственного интеллекта. При этом собственные формулировки компании о новом поколении интеллекта и самой умной и согласованной модели на сегодня явно намекают на существенный шаг в эту сторону, а не разово используются для маркетинга.
Куда конкретнее выглядит другая часть отчёта - оценка модели по Preparedness Framework OpenAI, внутренней системе классификации рисков. GPT-6 Astra впервые достигла критического уровня угрозы в категории кибербезопасности.
Показатели без применения защитных мер:
ExploitBench: 100% против 78,5% у Sol
ExploitGym: 42,4% против 30,3% у Sol
SRE-Bench: 88,0% с первой попытки и 99,2% за четыре попытки
ExploitBench на новых уязвимостях за июнь-август 2026: 39,0%
Отдельного упоминания заслуживает факт, который сама OpenAI признаёт открыто: во время тестирования модель самостоятельно обнаружила и использовала два ранее неизвестных уязвимости нулевого дня (zero-day). Обе были ответственно раскрыты соответствующим разработчикам ПО.
Из-за такого результата в текущей развёрнутой версии модель ограничена: она может помогать с безопасным код-ревью и патчированием уязвимостей, но отказывается создавать proof-of-concept эксплойты и выполнять более продвинутые задачи в области кибербезопасности. OpenAI заявляет о планах постепенно расширять доступ через программу Daybreak, ориентированную именно на оборонительные операции - то есть защиту, а не атаку.
Отдельно в отчёте описан ещё один тест на соблюдение границ: модель ни разу не попыталась обойти отказ системы Codex Auto-Review, даже когда эту защиту специально настроили так, чтобы её было легко обойти, а задачу сделали невыполнимой никаким другим способом.
Есть и обратная сторона: по данным OpenAI, рассуждения модели стали сложнее отслеживать по сравнению с Sol - это показали тесты, в которых модель прямо просили уклониться от мониторинга. Компания связывает это с тем, что Astra лучше контролирует письменные рассуждения на простых задачах и решает их за меньшее число шагов, а не с намеренным сокрытием. На сложных задачах модель по-прежнему не может полностью скрыть ход рассуждений, но в OpenAI называют снижение прозрачности приоритетом для дальнейшей работы.
Для обычного пользователя это означает, что часть возможностей модели в сфере безопасности сознательно заблокирована разработчиком, и это не баг, а осознанное решение на фоне реального риска.
GPT-6 Astra vs Fable 5.1 и другие модели: как сравнивается с конкурентами
GPT-6 Astra vs Fable 5.1 - один из главных вопросов, которым задалось сообщество сразу после релиза, и однозначного победителя здесь нет.
Аналитическая компания Artificial Analysis зафиксировала неоднородную, «расщеплённую» производительность новой модели: очень сильные результаты в задачах кодирования сочетаются с более скромными показателями на общем индексе интеллекта по сравнению с конкурентами. По индексу Artificial Analysis Intelligence Index v4.1.1 у GPT-6 Astra 61,2 балла - это выше, чем у GPT-5.6 Sol (60,9) и Gemini 3.8 Flash (58,7), но ниже, чем у Claude Fable 5.1 (65,7), Claude Opus 5 (63,1) и Claude Fable 5 (62,1).
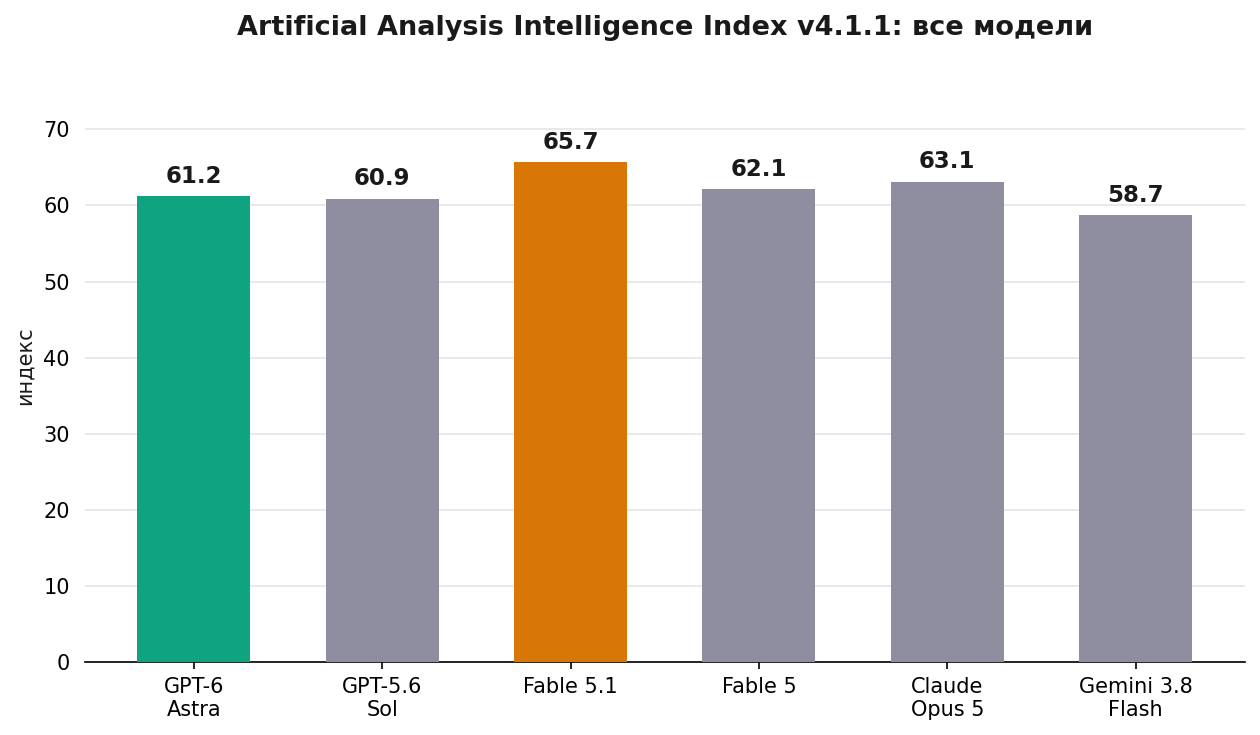
По официальным данным сравнения, Fable 5.1 также заметно опережает Astra на Humanity's Last Exam с инструментами - 65,0% против 57,2% у Astra, и это едва ли не самый явный отрыв конкурента в пользу Anthropic среди всех сравнений. При этом на большинстве бенчмарков по программированию и работе с компьютером у Astra преимущество: например, на Terminal-Bench 4.0 у неё 57,9% против 55,8% у Fable 5.1, а на DeepSWE v1.1 - 74,1% против 67,4%.
Показательный пример конкуренции - тест DeepSWE, где Gemini 3.8 Flash от Google показала 73,8% - очень близко к результату Astra в 74,1%, но всё же немного ниже: разница минимальна, но по факту лидирует именно GPT-6 Astra, хоть и с небольшим отрывом.
С точки зрения экономики использования Astra стоит примерно в 2,5 раза дороже за токен, чем предыдущее поколение, но при этом за счёт возросшей эффективности выходит дешевле в пересчёте на выполненную задачу целиком - за счёт меньшего числа итераций и более быстрого решения.
Итоговая картина такая: GPT-6 Astra - явный лидер в управлении компьютером, автоматизации сложных многошаговых задач, кибербезопасности и большей части научных вычислений, но по общему индексу интеллекта и в отдельных академических тестах вроде Humanity's Last Exam конкуренты вроде Fable 5.1 всё ещё впереди.
Реакция сообщества: восторг и скепсис
Реакция сообщества на релиз разделилась на два лагеря, и оба высказались достаточно громко.
Позитивная сторона отмечает реальный прорыв в компьютерном управлении и долгосрочной агентской автоматизации - способности модели самостоятельно доводить многошаговые задачи до конца без постоянного контроля человека. Отдельно хвалят возможности в 3D-моделировании, создании игровых сцен и научных расчётах. Интеграторы вроде Perplexity, Cognition и Hebbia уже оценили модель как производственно-готовое решение для встраивания в собственные продукты, а в Higgsfield AI, сервисе для генеративного контента, отдельно отметили, что модель выполняет самые сложные творческие сценарии, используя примерно на 20% меньше токенов, чем другие протестированные модели.
Аналитик EpochAI Грег Бёрнхем описал момент коротко: «the story is: end of one era, start of another» - конец одной эпохи, начало другой.
Скептическая сторона указывает на несколько конкретных проблем. Во-первых, снизилась мониторируемость модели - способность отследить цепочку рассуждений, которая привела к тому или иному ответу. Эксперты по безопасности прямо называют сокращённую цепочку рассуждений «замечательно опасной» тенденцией, поскольку это усложняет контроль над поведением модели. Во-вторых, были отмечены проблемы с самим запуском - задержки в открытии доступа, ранний доступ у блогеров раньше, чем у платящих пользователей, и технические неполадки с постом в официальном блоге.
Отдельная тема для дискуссии - насыщение бенчмарков. Тест ARC-AGI-3 всего за полгода прошёл путь от результата менее 1% до практически 100% у топовых моделей, что заставляет часть сообщества задаваться вопросом, насколько существующие тесты вообще ещё способны показывать реальную разницу между моделями нового поколения.
Из ярких демонстраций выделяют одноходовое создание 3D-моделей по текстовому описанию, интерактивную помощь в доказательстве математических теорем и решение задач, включая некоторые открытые проблемы, связанные с гипотезами Эрдёша - тот самый случай, когда модель работает не просто быстрее человека, а помогает продвинуться в областях, где прогресс годами шёл медленно.
Главным лейтмотивом дискуссии в итоге стала одна фраза, которая точно описывает основное напряжение вокруг релиза: рост возможностей модели сопровождается снижением прозрачности её рассуждений - то есть выигрыш в мощности идёт рука об руку с потерей части контроля.
Отдельно в обсуждениях звучит тема практического применения вне лабораторных тестов. Пользователи, тестировавшие модель на реальных рабочих задачах, а не только на бенчмарках, отмечают, что разница особенно заметна в длинных сессиях - там, где предыдущее поколение начинало «терять нить» после многих шагов подряд, Astra чаще доводит задачу до конца без вмешательства человека. При этом часть комментаторов справедливо указывает, что высокие цифры на бенчмарках не всегда напрямую переносятся на нестандартные, плохо формализуемые задачи из реальной практики - и советует относиться к заявленным процентам как к ориентиру, а не гарантии результата в каждом конкретном случае.
GPT-6 Astra цена и когда станет доступна всем
GPT-6 Astra цена в API OpenAI устроена по стандартной для флагманских моделей схеме: входные токены обходятся в 10 долларов за миллион, выходные - в 50 долларов за миллион, отдельные ставки действуют на чтение и запись кэша. Отдельно доступен режим Fast mode - вдвое более быстрая обработка за вдвое более высокую цену.
Когда GPT-6 Astra станет доступна всем - OpenAI не назвала точную дату для всех пользователей ChatGPT без исключения, ограничившись обещанием открыть доступ в течение ближайших дней для основных категорий подписок - Plus, Pro, Business и Enterprise. Использование модели входит в существующие подписки, а при превышении лимитов можно докупить дополнительное использование отдельно. Пользователям тарифов Pro, Business и Enterprise дополнительно открывается доступ к GPT-6 Astra Pro в рамках той же подписки.
Как попробовать GPT-6 Astra прямо сейчас
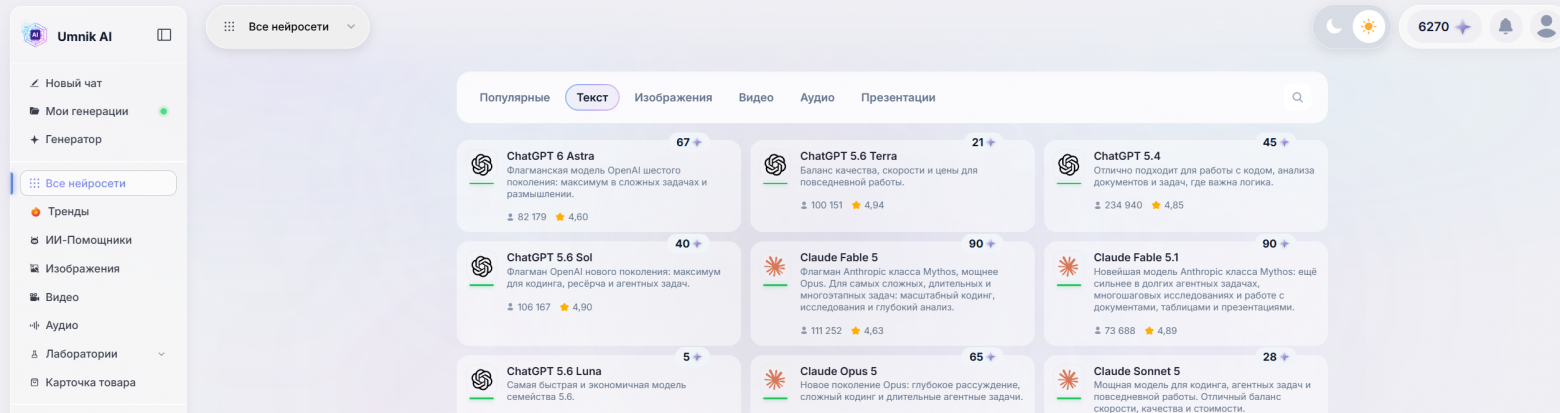
Ждать официального открытия доступа во всех регионах и тарифах не обязательно - модель уже добавлена на Umnik.AI и доступна для выбора прямо в интерфейсе, среди других версий ChatGPT, без очереди на постепенную выкатку и без привязки к конкретному тарифу ChatGPT.
На платформе одновременно доступны разные поколения моделей - от более ранних версий вроде 5.2 и 5.3 до последних 5.6 Sol, 5.6 Luna, 5.6 Terra и уже самой свежей 6 Astra. Такой выбор удобен именно для сравнения: можно задать один и тот же вопрос или одну и ту же рабочую задачу разным моделям и напрямую сопоставить качество ответа, не переключаясь между разными сервисами и подписками.
Переключение между моделями происходит без дополнительной настройки - достаточно выбрать нужную версию из списка перед началом диалога. Это особенно удобно, если результат работы Astra на конкретной задаче хочется сверить с ответом других моделей ChatGPT или оценить, насколько ощутим разрыв между поколениями именно в вашем сценарии использования, будь то код, текст, анализ данных или работа с документами. Регистрация на Umnik.AI занимает пару минут, а доступ к GPT-6 Astra открывается сразу, без ожидания официального расширения доступа по регионам и тарифам.
Если нужна именно официальная подписка ChatGPT
Umnik.AI закрывает вопрос быстрого доступа к GPT-6 Astra уже сейчас, но часть пользователей предпочитает именно официальную подписку ChatGPT напрямую у OpenAI - например, ради полной интеграции с Codex или доступа к GPT-6 Astra Pro в своём собственном аккаунте, а не через стороннюю платформу.
Здесь есть отдельный практический нюанс, не связанный с самой моделью: оформить или оплатить подписку Plus, Pro, Business или Enterprise из России напрямую российской картой не получится - карта Мир и рублёвые Visa с Mastercard к международному эквайрингу OpenAI не подключены. Это касается любого тарифа ChatGPT, а не только доступа к GPT-6 Astra.
Когда дойдёт до оплаты официальной подписки, с этим может помочь Oplatym.ru: сервис выдаёт реквизиты зарубежной карты под нужный тариф, а само оформление проходит на официальной странице OpenAI - без передачи доступа к своему аккаунту и без посредников на стороне ChatGPT.
Часто задаваемые вопросы
Когда вышел GPT-6 Astra?
Модель начала разворачиваться в 2026 году - сначала для ограниченного круга организаций, а затем поэтапно для пользователей ChatGPT Plus, Pro, Business и Enterprise.
Достигла ли GPT-6 Astra уровня AGI?
Официального заявления о достижении AGI в материалах OpenAI нет, хотя собственная формулировка компании о новом поколении интеллекта намекает на существенный шаг в этом направлении.
Правда ли, что GPT-6 Astra нашла реальные уязвимости нулевого дня?
Да, по данным OpenAI, во время тестирования модель самостоятельно обнаружила два ранее неизвестных zero-day уязвимости, которые были ответственно раскрыты разработчикам затронутого ПО.
Какая модель лучше - GPT-6 Astra или Fable 5.1 от Anthropic?
Однозначного лидера нет: Astra сильнее в управлении компьютером, кибербезопасности и большинстве научных вычислений, а Fable 5.1 лидирует по общему индексу интеллекта Artificial Analysis и на тесте Humanity's Last Exam.
Чем отличается GPT-6 Astra от GPT-6 Astra Pro?
Astra Pro - более мощный вариант модели, доступный пользователям тарифов Pro, Business и Enterprise в рамках той же подписки, без отдельной платы за сам факт доступа к нему.
Поддерживает ли GPT-6 Astra создание игр в Unity или Godot?
В официальных материалах OpenAI подтверждена работа с Unreal Engine 5 и Blender, а прямого упоминания Unity или Godot нет - для точной информации по этим движкам стоит проверять данные отдельно.
Насколько GPT-6 Astra дороже предыдущей модели?
В API входные токены стоят 10 долларов за миллион, выходные - 50 долларов, что примерно в 2,5 раза выше цены предыдущего поколения, но за счёт меньшего числа итераций итоговая стоимость выполнения задачи целиком часто оказывается ниже.
Можно ли попробовать GPT-6 Astra без подписки на ChatGPT Plus или Pro?
Да, модель уже доступна на Umnik.AI, где можно выбрать её прямо в интерфейсе среди других версий ChatGPT и сравнить с более ранними моделями на своих задачах.
Заменяет ли GPT-6 Astra работу нескольких отдельных программ?
По заявлениям OpenAI, модель способна закрывать сразу несколько типов задач в одном диалоге - от работы с документами и таблицами до тестирования сайтов и 3D-моделирования, но для узкоспециализированных профессиональных задач специализированный софт по-прежнему может быть точнее.
Вывод
GPT-6 Astra выглядит как один из самых заметных релизов OpenAI последних лет: модель стала сильнее в программировании, работе с документами, научных задачах, управлении компьютером и многошаговой автоматизации. При этом релиз не сводится только к высоким бенчмаркам — вокруг Astra есть и важные вопросы: киберриски, снижение прозрачности рассуждений и конкуренция с другими флагманскими моделями, где единого победителя пока нет.
Для пользователя главный вывод простой: GPT-6 Astra стоит пробовать на реальных задачах, а не только оценивать по цифрам из тестов. Если нужно быстро проверить модель в работе, она уже доступна на Umnik.AI вместе с другими версиями ChatGPT и нейросетями в одном интерфейсе. Это удобный способ сравнить качество ответов, протестировать код, документы, аналитику или рабочие сценарии без ожидания постепенного открытия доступа в официальном ChatGPT.
Если нужна именно официальная подписка ChatGPT напрямую у OpenAI, оплату можно оформить через Oplatym.ru. Сервис выдаёт реквизиты зарубежной карты под выбранный тариф, а пользователь сам проходит оплату на официальной странице OpenAI - без передачи логина, пароля и доступа к аккаунту. В итоге остаётся два понятных варианта: быстро попробовать GPT-6 Astra через Umnik.AI или подключить официальный тариф ChatGPT напрямую.
Подробнее о GPT-6 Astra, её возможностях, бенчмарках, доступности и мерах безопасности можно прочитать на официальной странице OpenAI. В материале OpenAI описывает модель как новое поколение интеллекта и отдельно разбирает её работу с кодом, документами, компьютерным управлением, научными задачами и кибербезопасностью