В репозитории проекта лежит 203 килобайта промптов. Это примерно треть от объёма всего PHP-кода, и при этом ни одного промпта в коде нет: все они — YAML-файлы, которые проходят ревью, версионируются и выкатываются вместе с релизом.
Пришли мы к этому не сразу, и по дороге выяснилось, что «вынести промпт в конфиг» — это не одно решение, а десяток мелких, каждое из которых можно принять неправильно.
Проект под NDA, поэтому все примеры промптов в статье выдуманы: я взял нейтральный сценарий с ботом поддержки. Структура файлов, код обработки и грабли — настоящие.
Почему не в коде и не в админке
Промпт в коде — это deploy ради запятой, и мы это уже проходили с текстами интерфейса. Но у промптов есть своя специфика, из-за которой они уезжают из кода раньше всего остального.
Промпт правит не разработчик. Его правит тот, кто отвечает за качество ответов модели, и правит он его постоянно: подкрутил формулировку, посмотрел на выдачу, откатил, попробовал иначе. Цикл измеряется часами, а не спринтами.
Очевидный ответ на это — редактируемое поле в админке. Мы так и сделали в первой версии, и получили ровно то, что получают все: промпт на проде отличается от промпта на стейдже, никто не помнит, кто и зачем поменял абзац про формат ответа, и откатиться можно только по памяти. Ревью нет, истории нет, дифф посмотреть негде.
Git решает все четыре проблемы сразу, ценой одной: чтобы поправить промпт, нужно уметь сделать коммит. Для нашей команды это оказалось приемлемым обменом.
Единица — не промпт, а способность
Первая существенная мысль: файл описывает не текст, а целиком «умение» системы что-то сделать с помощью модели.
code: summarize-ticket
description: "Сжать обращение пользователя до сути"

provider: fast-cloud
model: small-instruct

config_params:
  max_tokens: 512
  temperature: 0.2

response_type: string

system_templates:
  ru: |-
    Ты помощник оператора поддержки. Сожми обращение до трёх пунктов:
    что сломалось, когда началось, что пользователь уже пробовал.
    Не придумывай деталей, которых нет в тексте.
  en: |-
    You are a support agent assistant. Compress the ticket into three points:
    what broke, when it started, what the user already tried.
    Do not invent details that are not in the text.

user_templates:
  ru: |-
    @foreach($messages as $message)
    {{ $message['role'] }}: {!! $message['content'] !!}
    @endforeach
  en: |-
    @foreach($messages as $message)
    {{ $message['role'] }}: {!! $message['content'] !!}
    @endforeach
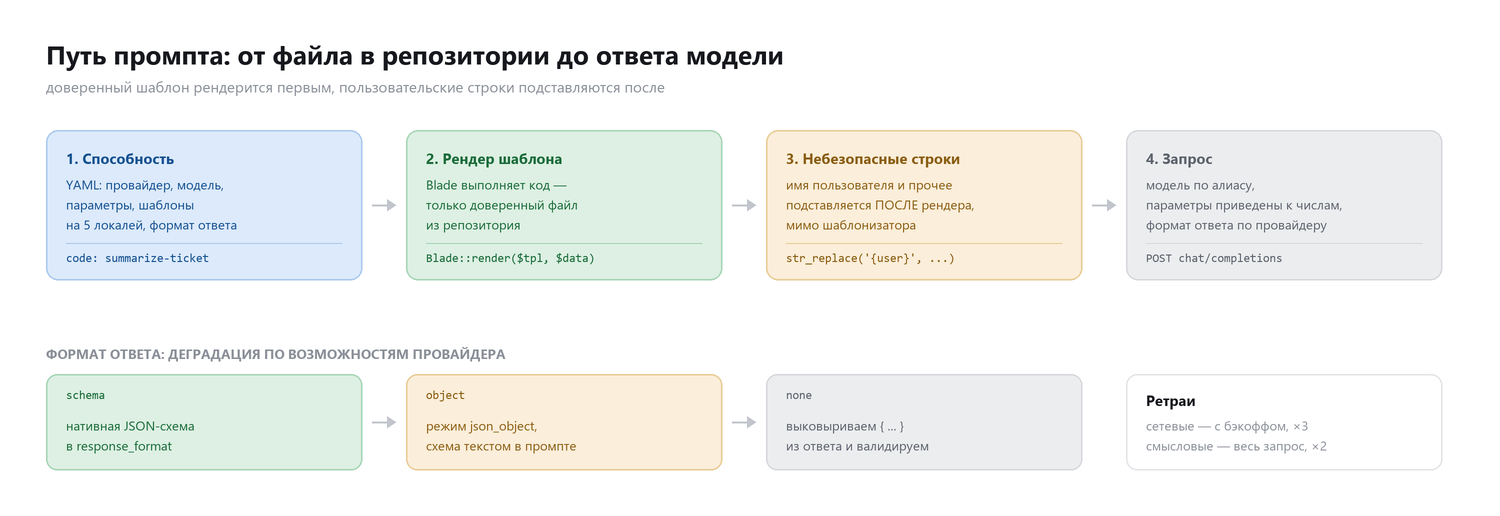
В одном файле лежит всё, что определяет поведение: провайдер, модель, параметры генерации, системный и пользовательский шаблоны на каждом языке, ожидаемый формат ответа.
Это важно, потому что промпт без параметров бессмысленен. Один и тот же текст с temperature: 0.2 и temperature: 0.9 — это два разных поведения, и если температура живёт в коде, а текст в файле, то воспроизвести вчерашний результат нельзя. Меняется что-то одно — меняется способность целиком, и версионируется она тоже целиком.
Код вызывает это по имени и ничего не знает ни про провайдера, ни про модель:
$summary = $ai->execute($bot, $chat, 'summarize-ticket', ['messages' => $history]);
Blade внутри YAML
Промпт почти никогда не бывает константой. В него нужно подставить историю сообщений, профиль, контекст — то есть нужен шаблонизатор. Мы не стали писать свой:
private function renderPrompt(?string $template, array $data): ?string
{
    return $template ? Blade::render($template, $data) : null;
}
Одна строка, и в промптах доступен весь Blade: циклы, условия, обращение к свойствам объектов. Цикл по истории сообщений из примера выше — это ровно он.
Теперь честная часть. Blade::render() компилирует шаблон в PHP и выполняет его. Это означает, что содержимое YAML-файла — исполняемый код, и человек, который правит промпт, технически может выполнить что угодно на сервере.
Для нас это приемлемо ровно потому, что промпты лежат в репозитории и проходят ревью: файл нельзя поменять в обход процесса. Но если вы собираетесь дать редактирование промптов в админку — а это ровно то, к чему тянет продакт, — то полноценный шаблонизатор туда пускать нельзя. Нужен ограниченный движок без выполнения кода и без доступа к файловой системе. Выбор между «мощно» и «безопасно» тут делается один раз и не пересматривается.
Порядок подстановки решает
В промптах есть ещё один слой подстановок, и он сделан подчёркнуто примитивно:
$systemPrompt = Blade::render($systemTemplate, $inputData);

$systemPrompt = str_replace(
    ['{char}', '{user}'],
    [$characterName, $userName],
    $systemPrompt
);
Сначала рендерится доверенный шаблон из репозитория. И только потом, обычным str_replace, в уже готовый текст подставляются строки, пришедшие от пользователя, — его имя, например.
Порядок здесь не стилистический, а защитный. Если отдать пользовательское имя внутрь Blade::render() как часть шаблона, то человек, назвавшийся {{ config('app.key') }}, получит в ответе ключ приложения. Пользовательские данные не должны попадать в шаблонизатор, они подставляются после него.
Выглядит как мелочь на две строки. Стоит примерно столько же, сколько любая другая инъекция.
Пять языков — это не перевод
Промпты у нас существуют в пяти локалях, и первое заблуждение было в том, что это задача перевода.
На практике языковая версия промпта — это отдельная настройка, у которой своя жизнь. Модель, которой пишут по-русски, ведёт себя иначе, чем та же модель на английском: по-другому держит формат, чаще сбивается на другой язык, иначе понимает инструкцию про длину ответа. В итоге в неанглийских шаблонах появляются добавки, которых в английском нет вообще — явное требование отвечать на нужном языке, уточнение формата, запрет на мета-комментарии.
Отсюда практическое следствие: тест на «во всех ли локалях есть шаблон» нужен, а тест на «совпадает ли смысл» бесполезен. Промпты на разных языках обязаны различаться, и различаться они будут тем сильнее, чем дальше язык от английского.
Ещё одна вещь, которую стоит завести сразу: проверка, что набор подстановок одинаков во всех локалях. Переводчик легко переведёт {user} вместе с остальным текстом, и вы получите промпт, в котором вместо имени написано слово «пользователь». На выдаче это проявится не ошибкой, а странностью, и искать её будете долго.
Провайдер тоже данные
В файле способности указан не полный идентификатор модели, а короткое имя:
provider: fast-cloud
model: small-instruct
Расшифровывается оно в файле провайдера:
code: fast-cloud
base_url: "https://api.example.com/v1"
api_key: "${FAST_CLOUD_KEY}"
schema_support: "schema"
supported_models_names:
  small-instruct: vendor/small-instruct-v3
  big-reasoner: vendor/big-reasoner-2507
А в коде это одна строчка с фоллбэком:
'model' => $provider->supported_models_names[$version->model] ?? $version->model,
Смысл в том, что способность говорит «мне нужна быстрая маленькая модель», а не «мне нужна vendor/small-instruct-v3». Когда провайдер переименует модель или вы решите переехать на другого, правится один файл провайдера, а не девять файлов способностей. Фоллбэк на случай, если алиаса нет: тогда значение уходит как есть.
Про ключи. В YAML лежит ${FAST_CLOUD_KEY} — плейсхолдер, который импортёр при загрузке разворачивает в значение из конфига:
if (preg_match('/^\$\{([^}]+)\}$/', $apiKey, $matches)) {
    return config("ai.providers.{$matches[1]}");
}
В репозитории — имя переменной, в окружении — значение. Строку с ключом тоже можно написать прямо в файле, и это ровно та возможность, которую стоит закрывать на ревью: один раз кто-нибудь вставит настоящий ключ «на минутку потестировать», и он останется в истории гита навсегда.
YAML типизирует не так, как вы думаете
Мелочь, которая стоила нам часа.
config_params:
  max_tokens: "1024"
  temperature: "0.2"
Кавычки вокруг чисел появились случайно — кто-то скопировал из соседнего файла. YAML послушно сделал из них строки, строки уехали в тело запроса, и провайдер ответил ошибкой валидации, потому что ждал числа.
Чинится либо дисциплиной, либо кодом. Мы выбрали код:
return array_map(function ($value) {
    if (is_numeric($value)) {
        return str_contains((string) $value, '.') ? (float) $value : (int) $value;
    }

    return $value;
}, $configParams);
Приведение параметров к числам перед отправкой. Некрасиво, но это ровно та защита, которая нужна, когда конфиг правит человек: файл не обязан быть идеальным, поведение обязано быть предсказуемым.
Три уровня поддержки схемы
Если от модели нужен структурированный ответ, начинается самое интересное: провайдеры умеют это по-разному. У нас три варианта, и они описаны прямо в конфиге провайдера:
enum SchemaSupport: string
{
    case SCHEMA = 'schema';   // умеет json_schema
    case OBJECT = 'object';   // умеет только json_object
    case NONE   = 'none';     // не умеет ничего
}
Дальше деградация по уровням. Если провайдер понимает JSON-схему — отдаём её в response_format и получаем гарантию структуры от самого провайдера. Если умеет только «отвечай валидным JSON» — включаем этот режим, а схему дописываем текстом в конец системного промпта, причём на языке пользователя:
$payload['response_format'] = ['type' => 'json_object'];

$instruction = self::SCHEMA_INSTRUCTIONS[$locale] ?? self::SCHEMA_INSTRUCTIONS['en'];
$systemPrompt .= "\n\n{$instruction} " . json_encode($schema, JSON_UNESCAPED_UNICODE);
Схема в промпте текстом — это не гарантия, а просьба. Поэтому есть третий слой, самый некрасивый во всём проекте:
private function extractJsonPayload(string $body): string
{
    $start = strpos($body, '{');
    $end = strrpos($body, '}');

    return $start !== false && $end > $start
        ? substr($body, $start, $end - $start + 1)
        : $body;
}
Мы просто выковыриваем из ответа всё между первой { и последней }, потому что модель любит обернуть JSON в «Конечно! Вот ваш ответ:» и тройные кавычки. Полученное парсится и валидируется по схеме, и только после этого считается ответом.
Я долго сопротивлялся этой функции. Потом посмотрел на долю ответов, которые она спасает, и перестал.
Два вида ретраев
Запрос к модели может провалиться двумя принципиально разными способами, и лечатся они разным.
Сетевой провал. Таймаут, 502, разорванное соединение. Лечится обычным ретраем с экспоненциальной паузой — тут ничего нового:
Http::baseUrl($provider->base_url)
    ->withToken($provider->api_key)
    ->timeout(60)
    ->retry(
        times: 3,
        sleepMilliseconds: fn (int $attempt) => min(1000 * (2 ** $attempt), 10000),
    )
Смысловой провал. Ответ пришёл, код 200, но внутри пустая строка, или невалидный JSON, или структура не проходит по схеме. Сеть тут ни при чём, повторять надо не транспорт, а весь запрос целиком. У нас на это отдельный внешний цикл, ровно две попытки.
Почему две. Каждая попытка — это деньги и секунды ожидания пользователя. Если модель дважды подряд не смогла выдать валидный ответ на один и тот же промпт, третья попытка скорее всего тоже не сможет: проблема не в удаче, а в промпте или в модели. Честнее показать ошибку и записать случай в лог, чем молча жечь бюджет.
Что писать в лог и чего не писать
Каждый вызов модели можно залогировать целиком: тело запроса, тело ответа, время, провайдер, модель, статус. На проде мы этого не делаем:
// На проде логируем только ошибки
if (!app()->isLocal() && $status === 'success') {
    return;
}
Причины две, и обе весомые.
Первая скучная: это самая быстрорастущая таблица в базе. Тело запроса к модели — это системный промпт плюс история сообщений, десятки килобайт на строку. Логировать успехи на потоке означает писать в базу мегабайты в минуту.
Вторая важнее. В теле запроса лежит переписка пользователя. Лог вызовов модели — это персональные данные, со всеми вытекающими: срок хранения, доступ, удаление по запросу. Если вы пишете туда всё подряд «на всякий случай», вы завели себе хранилище чужих разговоров и, скорее всего, не заметили этого.
Ошибки при этом писать обязательно — иначе разбирать жалобу «бот ответил ерунду» вы будете по описанию пользователя. Мы храним статус, провайдера, модель, время выполнения и детали ошибки; тело — только для неуспешных вызовов.
Как это вообще тестировать
Ответ модели недетерминирован, ассертом его не проверить. Но это не значит, что тестировать нечего — просто тестируется не то, что кажется.
Что реально проверяется автоматически:
шаблон рендерится и не падает на пустых данных;
у каждой способности есть шаблоны во всех локалях;
набор подстановок совпадает между локалями;
JSON-схема способности сама по себе валидна;
параметры генерации после нормализации — числа, а не строки.
Всё это ловит ровно те ошибки, которые у нас случались: сломанный шаблон, забытую локаль, переведённый плейсхолдер, кавычки вокруг числа. Ни один из этих тестов не смотрит на качество ответа — качество проверяется руками и глазами, и с этим надо смириться.
Отдельно полезен снапшот отрендеренного промпта. Меняете шаблон — видите в диффе итоговый текст, который уйдёт в модель, со всеми подстановками. Это единственный способ заметить, что ваша правка на одну строчку внезапно выкинула половину контекста.
Чего инструмент не чинит
В папке с промптами у нас лежит файл с названием вида text-reply-with-journal orig.yaml.
Это копия основного файла, сделанная перед экспериментом. Человек хотел иметь возможность вернуться к рабочей версии и сделал то, что делают все: скопировал файл рядом. При том, что у нас есть версионирование в базе, история в гите и откат деплоем.
Второй такой же артефакт — закомментированная JSON-схема в другом файле. Эксперимент не взлетел, схему закомментировали, комментарий остался.
Вывод, который мне не нравится, но который я вынужден признать: положить промпты в git — это половина решения. Вторая половина — привычка работать с ними как с кодом, и она не появляется от того, что файлы переехали. Копия файла рядом и закомментированный блок — это ровно те же симптомы, что и index_old.php в проектах двадцатилетней давности, просто в новом контексте.
Чеклист
Если будете выносить промпты из кода:
Единица хранения — не промпт, а способность: текст, провайдер, модель, параметры и формат ответа в одном файле.
Параметры генерации версионируются вместе с текстом. Иначе вчерашний результат невоспроизводим.
Шаблонизатор нужен, но помните, что он выполняет код. В админку такой пускать нельзя.
Пользовательские данные подставляются после рендера шаблона, а не внутри него.
Языковые версии промпта — не перевод. Они обязаны различаться.
Тест на полноту локалей и на совпадение подстановок между ними.
Модель в способности указывается алиасом, расшифровка — у провайдера.
В репозитории имя переменной окружения, а не ключ. На ревью смотреть отдельно.
Числа в YAML приводите к числам в коде. Кавычки появляются сами.
Деградация по уровням поддержки схемы: нативная схема → json-режим со схемой в промпте → выковыривание JSON из текста.
Сетевые и смысловые ретраи — разные механизмы. Смысловых хватает двух.
Логи вызовов модели — это персональные данные. На проде пишите ошибки, а не всё подряд.
Интересно, кстати, как у вас устроен пункт 11. Мы остановились на двух смысловых попытках с одним и тем же промптом, но встречал подход, где вторая попытка идёт с упрощённым промптом или на другой модели. Выглядит логично, хотя и добавляет ещё одну ветку, которую надо тестировать.