Вступление
Stable Diffusion произвела революцию в создании изображений по текстовому описанию. GPT-2, GPT-3(.5) и GPT-4 отлично справляются с разнообразными языковыми задачами. ChatGPT познакомил широкую публику с этими языковыми моделями. Сейчас уже ясно, что большие языковые модели (large language models, LLM) никуда не денутся и существенно изменят экосистему текстов и изображений в интернете. Мы изучили, что может произойти с GPT‑{n}, когда большинство текстов в интернете окажутся сгенерированы LLM. Выяснилось, обучение на сгенерированном контенте приводит к необратимым дефектам в моделях: у них исчезают хвосты исходного распределения контента.
Мы назвали этот эффект «коллапс модели», он может возникать в LLM, вариационных автоэнкодерах (variational autoencoders, VAE) и в моделях гауссовых смесей (Gaussian mixture models, GMM). Явление универсально для всех обучаемых генеративных моделей. К нему следует отнестись серьёзно, если мы и дальше хотим обучать модели на больших данных из интернета. Мы убеждены, что информация о подлинных взаимодействиях людей с системами будет становиться всё ценнее по мере того, как в данных из интернета растёт доля контента, сгенерированного LLM.
Проблема обучения моделей
Разработка LLM — очень трудоёмкий процесс, требующий больших объёмов обучающих данных. Однако хотя современные LLM2,4–6, включая GPT-3, обучались преимущественно на текстах, созданных людьми, это может измениться. Если обучающие данные большинства будущих моделей также будут собираться из интернета, то они неизбежно будут обучаться на данных, произведённых их предшественниками. В этой работе мы исследуем, что происходит, когда текст, произведённый, например, некоторой версией GPT, составляет большую часть обучающего набора последующих моделей. Что происходит с поколениями GPT‑{n} при росте n?
В результате исследования мы обнаружили, что неразборчивое обучение на данных, произведённых другими моделями, вызывает «коллапс модели» — дегенеративный процесс, в ходе которого со временем модели забывают истинное лежащее в основе распределение данных, даже при отсутствии сдвига распределения во времени.
Примеры коллапса модели для GMM, VAE и LLM показывают, что со временем модели начинают терять информацию об истинном распределении: сначала исчезают хвосты, а выученное поведение с каждым поколением сходится к точечной оценке с очень малой дисперсией. Этот процесс неизбежен даже в случаях почти идеальных условий для долгосрочного обучения, то есть при отсутствии ошибки оценивания функции.
В литературе упоминаются два близких к коллапсу модели понятия: катастрофическое забывание (catastrophic forgetting)7, возникающее в рамках непрерывного обучения без постановки задач, и отравление данных (data poisoning)8,9, злонамеренно приводящее к нежелательному поведению. Ни то, ни другое не способно полностью объяснить явление коллапса модели, поскольку постановка принципиально иная, но они дают другой взгляд на наблюдаемое явление. Коллапс модели может иметь более широкие последствия, их мы тоже рассмотрели в этой статье.
Доступ к исходному распределению данных критически важен: в задачах обучения, где важны хвосты лежащего в основе распределения, необходим доступ к реальным данным, произведённым людьми. Иными словами, массовое использование LLM для публикации контента в интернете будет загрязнять сбор данных для обучения их преемников: данные о взаимодействиях людей с LLM будут становиться всё более ценными.
Что такое коллапс модели?
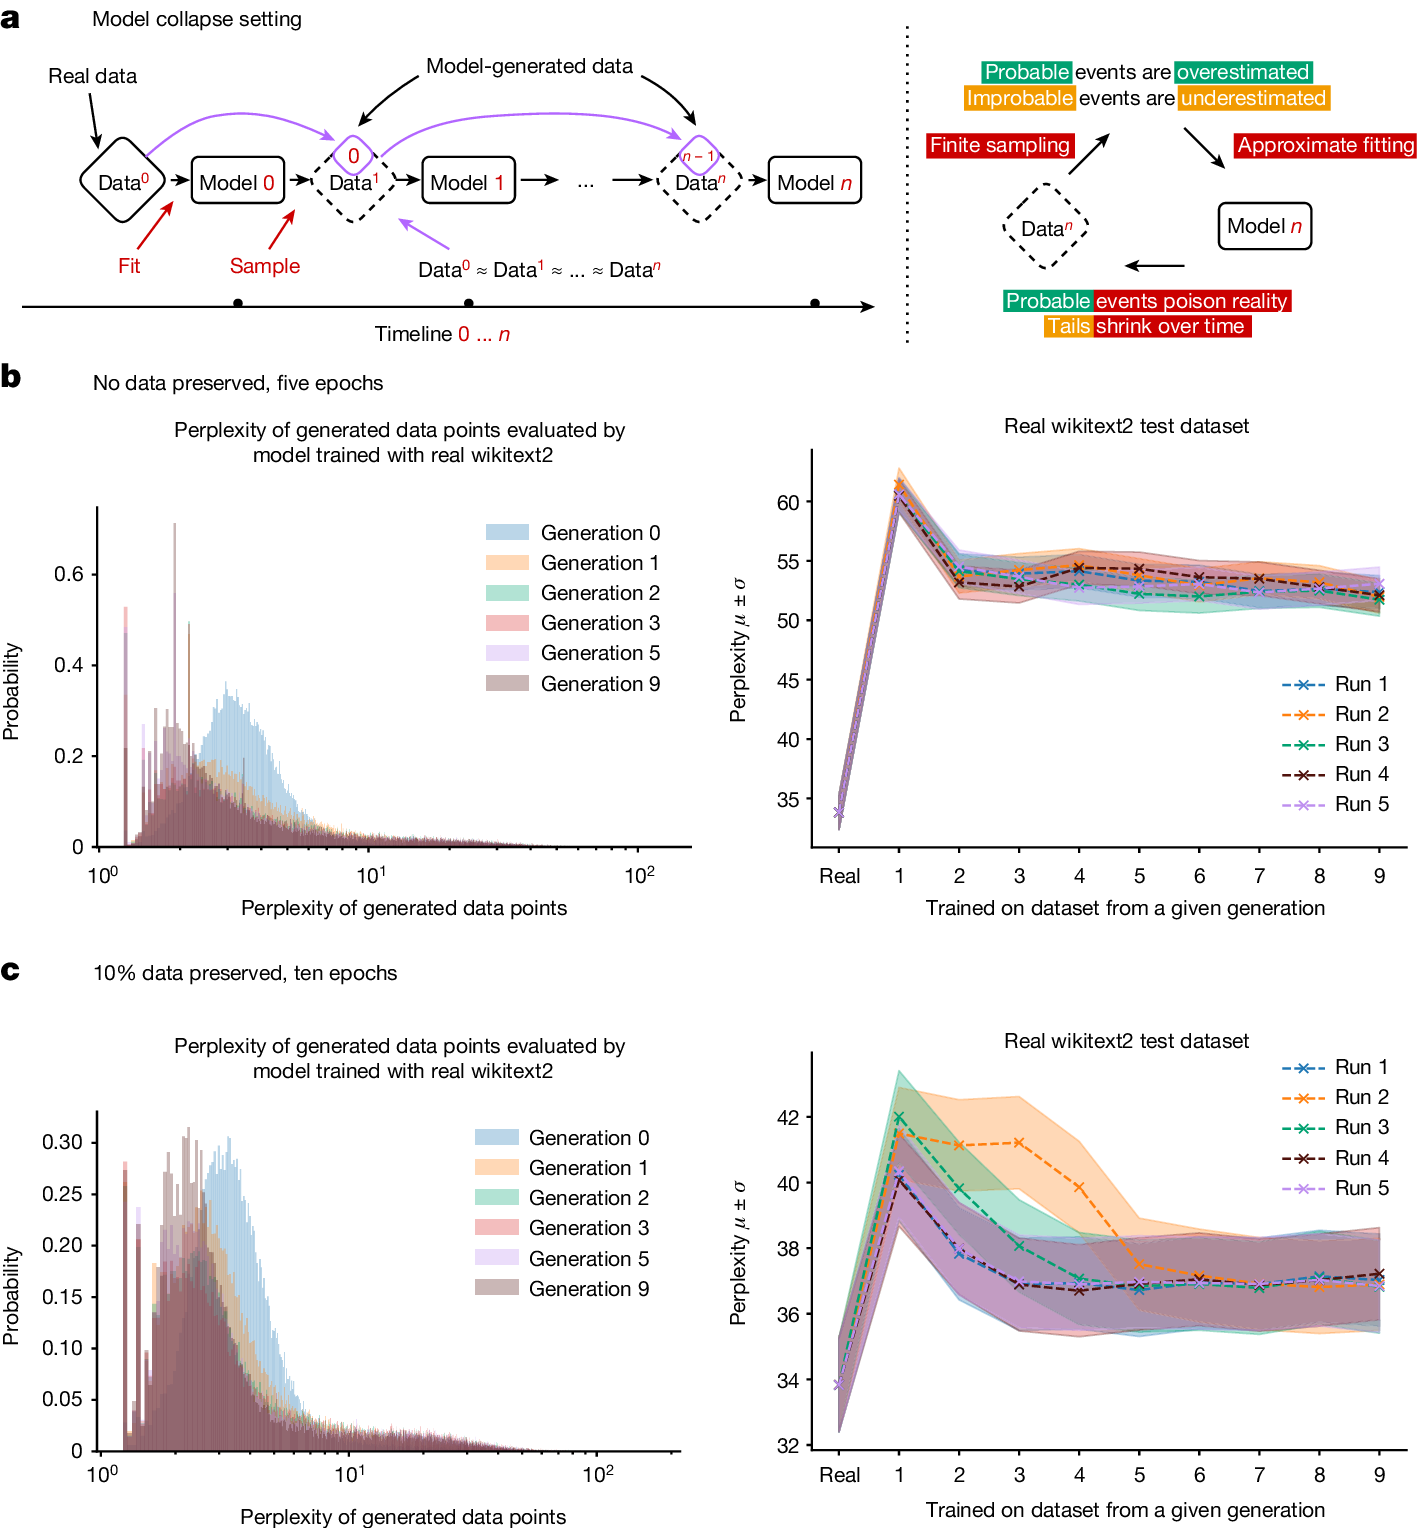
Коллапс модели — это дегенеративный процесс, затрагивающий поколения обученных генеративных моделей. При этом данные, которые модели генерируют, в итоге загрязняют обучающий набор следующего поколения. В свою очередь, модели, обученные на загрязнённых данных, неверно воспринимают реальность. Процесс изображён на рис. 1 a. Мы выделяем два особых случая: ранний коллапс модели и поздний коллапс модели. При раннем коллапсе модель начинает терять информацию о хвостах распределения; при позднем коллапсе модель сходится к распределению, мало похожему на исходное, часто с существенно уменьшенной дисперсией.
Этот процесс происходит из‑за трёх конкретных ошибок, которые накапливаются по мере смены поколений и вызывают отклонение от исходной модели:
Ошибка статистической аппроксимации. Это основной тип ошибки, возникающий из‑за конечности числа выборок и исчезающий при стремлении числа выборок к бесконечности. Он возникает потому, что на каждом шаге повторной выборки существует ненулевая вероятность потери информации.
Ошибка функциональной выразительности. Это вторичный тип ошибки, возникающий из‑за ограниченной выразительности аппроксиматора функций. В частности, нейронные сети являются универсальными аппроксиматорами лишь при стремлении их размера к бесконечности. В результате нейронная сеть может вносить ненулевую вероятность вне носителя (support) исходного распределения или нулевую вероятность внутри носителя исходного распределения. Простой пример ошибки выразительности — попытка приблизить смесь двух гауссиан одной гауссианой. Даже при идеальной информации о распределении данных (то есть бесконечном числе выборок) ошибки модели будут неизбежны. Однако при отсутствии двух других типов ошибок это может произойти только в первом поколении.
Ошибка функциональной аппроксимации. Это вторичный тип ошибки, возникающий прежде всего из‑за ограничений процедур обучения, например структурного смещения стохастического градиентного спуска10,11 или выбора целевой функции12. Эту ошибку можно рассматривать как возникающую в пределе бесконечных данных и идеальной выразительности на каждом поколении.
Каждый из перечисленных факторов может как усилить, так и ослабить коллапс модели. Большая аппроксимирующая мощность может даже оказаться палкой о двух концах: лучшая выразительность способна противодействовать статистическому шуму, давая хорошее приближение истинного распределения, но она же может этот шум усилить. Чаще всего мы получаем каскадный эффект, при котором отдельные неточности складываются и приводят к росту суммарной ошибки. Например, переобучение модели плотности заставляет модель неверно экстраполировать и приписывать области высокой плотности областям низкой плотности, не покрытым носителем обучающего набора; затем они будут сэмплироваться с произвольной частотой.
Стоит отметить, что существуют и другие типы ошибок. Например, компьютеры на практике обладают ограниченной точностью. Теперь обратимся к математике, чтобы объяснить, как перечисленное порождает наблюдаемые ошибки, как разные источники могут складываться и как можно количественно измерить среднее расхождение моделей.
Подведём теорию
Мы утверждаем, что процесс коллапса модели универсален для генеративных моделей, которые рекурсивно обучаются на данных, порождённых предыдущими поколениями. Мы количественно оценили ошибки из предыдущего раздела с помощью двух математических моделей. Они достаточно просты, чтобы дать аналитические выражения для интересующих величин, но при этом воспроизводят явление коллапса модели: дискретное распределение при отсутствии ошибок функциональной выразительности и аппроксимации и многомерное гауссово приближение, отражающее совместное действие ошибок функциональной выразительности и статистических ошибок.
Общий стохастический процесс, который мы называем обучением на поколенческих данных, таков. Набор данных в поколении i есть 𝒟i, состоящий из независимых одинаково распределённых случайных величин Xji с распределением pi; через j ∈ {1,…, Mi} обозначен размер набора данных. Переходя от поколения i к поколению i + 1, мы стремимся оценить распределение выборок в 𝒟i приближением pθi+1. Этот шаг мы называем функциональной аппроксимацией:
pθi+1 = ℱθ(pi)
Затем набор данных 𝒟i+1 порождается выборкой из
pi+1 = αi pθi+1 + βi pi + γi p0
где неотрицательные параметры αi, βi, γi в сумме дают 1, то есть представляют собой доли данных, взятых из разных поколений. Это соответствует смешиванию данных из исходного распределения (γi), данных, использованных предыдущим поколением (βi), и данных, сгенерированных новой моделью (αi). Мы называем это шагом выборки. Для последующих математических моделей мы полагаем βi = γi = 0, то есть используются данные только одного шага, тогда как численные эксперименты проводятся при более реалистичном выборе параметров.
Дискретные распределения при точной аппроксимации
Рассмотрим дискретное распределение вероятностей в отсутствие ошибок функциональной аппроксимации и выразительности, то есть ℱ(p) = p. В этом случае коллапс модели возникает только из‑за статистических ошибок на шаге выборки. Сначала начинают исчезать хвосты (маловероятные события) из‑за низкой вероятности их выбора, и со временем носитель распределения сжимается. Обозначив размер выборки через M, рассмотрим состояние i с вероятностью q ≤ 1/M: ожидаемое число выборок со значением i, происходящих из этих событий, будет меньше 1. На практике это означало бы потерю информации о них. Рассматривая в более общем виде некоторое состояние i с вероятностью q, с помощью стандартной формулы условной вероятности можно показать, что вероятность потери информации (то есть того, что на некотором поколении не будет выбрано ни одного данного) равна 1 − q; это означает, что распределение должно сойтись к дельта‑функции, расположенной в некотором состоянии, причём вероятность оказаться в определённом состоянии равна вероятности выбрать это состояние из исходного распределения.
Это можно показать напрямую, рассматривая процесс
Xi → ℱ → pi+1 → Xi+1
как цепь Маркова, поскольку Xi+1 зависит только от Xi. Более того, если все Xji имеют одно и то же значение, то в следующем поколении аппроксимированное распределение будет в точности дельта‑функцией, и поэтому все Xji+1 также будут иметь одно и то же значение. Отсюда следует, что цепь Маркова содержит хотя бы одно поглощающее состояние, и, следовательно, с вероятностью 1 она сойдётся к одному из поглощающих состояний, это известный факт. Для этой цепи единственные поглощающие состояния — это состояния, соответствующие дельта‑функциям. Наблюдая за развитием коллапса модели, мы гарантированно приходим в постоянное состояние, потеряв всю информацию об исходном распределении к моменту поглощения цепи. Это рассуждение работает и в общем случае, поскольку представления с плавающей точкой дискретны, что делает цепь Маркова по параметрам модели дискретной. Таким образом, пока параметризация модели допускает дельта‑функции, мы к ним придём, поскольку — из‑за ошибок выборки — единственно возможные поглощающие состояния суть дельта‑функции. Исходя из сказанного, в случае дискретных распределений при идеальной функциональной аппроксимации должны возникать как ранний коллапс модели, когда отсекаются только маловероятные события, так и поздний коллапс, при котором процесс начинает схлопываться в единственную моду.
Многомерное распределение Гаусса
Вслед за обсуждением дискретных распределений мы приводим более общий результат, который можно показать в варианте приближения Гаусса, где каждое поколение аппроксимируется с использованием несмещённых оценок среднего и дисперсии. Аналогичный результат справедлив и в более общем случае.
Коллапс гауссовой модели (теорема). Предположим, что исходные данные выбраны из распределения 𝒟0 (необязательно распределения Гаусса) с ненулевой выборочной дисперсией. Предположим, что Xn подгоняются рекурсивно с использованием несмещённых выборочных оценок среднего и дисперсии предыдущего поколения,
Xjn | μn, Σn ~ 𝒩(μn, Σn)
при фиксированном размере выборки. Тогда
𝔼[𝕎22(𝒩(μn, Σn), 𝒟0)] → ∞; Σn → 0 (почти наверное) при n → ∞,
где 𝕎2 обозначает расстояние Вассерштейна-2 между истинным распределением и его приближением в поколении n.
Это означает, что приближение n‑го поколения не только расходится сколь угодно далеко с исходным, но и схлопывается до нулевой дисперсии по мере роста числа поколений с вероятностью 1. Результаты очень похожи на наблюдаемые в дискретном случае; эта теорема иллюстрирует эффект поздней стадии коллапса модели, когда процесс начинает схлопываться до нулевой дисперсии. Можно увидеть и раннюю стадию коллапса модели.
Коллапс модели в языковых моделях
Коллапс модели универсален для различных семейств моделей машинного обучения. Однако если небольшие модели, такие как GMM и VAE, обычно обучаются с нуля, то LLM устроены иначе. Их переобучение с нуля настолько дорого, что обычно они инициализируются предобученными моделями, такими как BERT4, RoBERTa5 или GPT-2, которые обучены на больших текстовых корпусах. Затем они дообучаются под различные прикладные задачи14.
Мы исследовали, что происходит с языковыми моделями, когда их последовательно дообучают на данных, сгенерированных другими моделями. Все эксперименты, описанные в этой работе, можно легко повторить с более крупными языковыми моделями в режиме без дообучения, чтобы продемонстрировать коллапс модели. Учитывая, что обучение одной умеренно крупной модели даёт объём CO2, вдвое превышающий выбросы среднего американца за всю жизнь, мы решили не проводить такой эксперимент, а сосредоточиться на более реалистичной постановке для доказательства концепции. Отметим, что даже описанные в этой работе эксперименты с языковыми моделями выполнялись неделями.
Наиболее распространённый вариант обучения языковой модели — дообучение, при котором каждый цикл обучения начинается с предобученной модели и свежих данных. Данные берутся из другой дообученной предобученной модели. Поскольку обучение ограничено получением моделей, близких к исходной предобученной, а точки данных, сгенерированные моделями, обычно дают очень малые градиенты, можно было бы ожидать, что после дообучения модель изменится лишь умеренно.
Дообучали каузальную языковую модель OPT-125m6 на наборе данных wikitext216. Обученные модели генерировали данные с применением лучевого поиска с шириной 5. Обучающие последовательности были разделены на блоки длиной 64 токена; затем для каждой последовательности токенов в обучающем наборе модель просили предсказать следующие 64 токена. Так из исходного обучающего набора получили искусственный набор данных того же размера. При нулевой ошибке модель воспроизвела бы исходный набор wikitext2.
Обучение каждого поколения начинали с генерации из исходных обучающих данных. Каждый эксперимент выполнялся пять раз, результаты показаны как пять отдельных прогонов с разными зёрнами случайности. Исходная модель, дообученная на реальных данных wikitext2, достигла средней перплексии 34 против базового уровня 115 при нулевом выстреле, то есть успешно освоила задачу. Для максимального реализма, базовой моделью для последующих поколений служила модель с наилучшими результатами на исходной задаче, оценёнными на исходном валидационном наборе wikitext2; это означает, что на практике наблюдаемый коллапс модели может быть ещё более выраженным. Варианты обучения:
Пять эпох, без сохранения исходных обучающих данных. Модель обучается пять эпох, начиная с исходного набора данных, но исходные данные не сохраняются для последующих прогонов. Общая производительность на исходной задаче показана на рис. 1 b. Обучение на сгенерированных данных позволяет адаптироваться к лежащей в основе задаче, теряя часть производительности — от 20 до 28 пунктов перплексии.
Десять эпох, с сохранением 10% исходных обучающих данных. Модель обучается десять эпох на исходном наборе, и при каждом новом поколении обучения случайно выбирается 10% исходных точек данных. Общая производительность на исходной задаче показана на рис. 1 c. Сохранение исходных данных позволяет лучше дообучать модель и приводит лишь к незначительному ухудшению производительности.
Оба режима обучения привели к ухудшению производительности моделей. Однако обучение на сгенерированных данных возможно и модели способны успешно освоить (часть) лежащей в основе задачи. В частности, по рис. 1 видно, что коллапс модели происходит: плотность выборок с низкой перплексией накапливается по мере смены поколений. В результате растёт вероятность, что со сменой поколений выборочные данные аналогичным образом схлопнутся к дельта‑функции.
Пояснения к рисунку
1 a: Коллапс модели — это дегенеративный процесс обучения, в котором модели со временем начинают забывать маловероятные события, поскольку «отравляются» собственным отражением реальности. Первичные данные курируются людьми; затем обучается модель 0 и из неё сэмплируются данные; на шаге n данные добавляются к общим данным шага n − 1, и эта комбинация используется для обучения модели n. Данные, полученные методом Монте‑Карло, в идеале должны быть статистически близки к исходным при условии, что процедуры подгонки и сэмплирования идеальны. Этот процесс отражает, что происходит в реальной жизни с интернетом: сгенерированные моделями данные заполоняют всё.
1 b,c: Производительность моделей OPT-125m разных поколений, оценённая на исходном тестовом наборе wikitext2. Слева показаны гистограммы перплексий каждой отдельной обучающей последовательности данных, произведённой разными поколениями, в оценке самой первой модели, обученной на реальных данных. Со сменой поколений модели склонны производить выборки, которые исходная модель, обученная на реальных данных, скорее произведёт. В то же время у поздних поколений появляется гораздо более длинный хвост. Поздние поколения начинают производить выборки, которые исходная модель никогда бы не произвела, то есть начинают неверно воспринимать реальность, опираясь на ошибки, внесённые их предшественниками. Справа для каждого независимого прогона показаны средняя перплексия и её стандартное отклонение. По оси x отложено поколение модели. «Real» обозначает «модель 0», обученную на исходном наборе wikitext2; модель 1 обучена на данных, произведённых моделью 0, модель 2 — на данных, произведённых моделью 1, и так далее, причём все сгенерированные наборы данных одинакового размера. Мы обнаружили, что модели, обученные на сгенерированных данных, способны освоить часть исходной задачи, но с ошибками, что видно по росту перплексии.
Важно отметить, что наблюдаемое поведение согласуется с теоретическим обоснованием. Точнее говоря, во всех экспериментах поколенческое обучение проводится лишь для конечного (обычно небольшого) числа поколений, тогда как теоретическое обоснование, в основном, сформулировано в пределе стремящегося к бесконечности числа поколений. Однако как видно из экспериментов с VAE и GMM, сходимость к дельта‑функциям и конкретные скорости такой сходимости сильно зависят от специфики рассматриваемой задачи, и полный коллапс может как произойти, так и не произойти даже после небольшого числа шагов. Потенциально заметное расхождение с исходной моделью может возникнуть уже после нескольких поколений.
Рисунок 1 b,c слева показывает гистограммы перплексий отдельных точек данных, сгенерированных моделями разных поколений, в оценке первой модели, обученной на реальных обучающих данных wikitext2. Здесь со сменой поколений модели склонны производить больше последовательностей, которые исходная модель произвела бы с более высокой вероятностью. Наблюдаемый эффект аналогичен эффекту для VAE и GMM, где со сменой поколений модели начинали производить выборки, которые исходная модель производила бы с более высокой вероятностью. В то же время мы обнаруживаем, что сгенерированные данные имеют гораздо более длинные хвосты, что говорит о том, что часть данных исходная модель никогда бы не произвела, — это ошибки, накапливающиеся из‑за обучения на поколенческих данных.
Пример
Пример текстовых выходов модели OPT-125m, подверженной коллапсу модели: модели деградируют от поколения к поколению, причём каждое новое поколение обучается на данных, произведённых предыдущим поколением. Исходный текст эксперимента приведён без перевода, поскольку это дословные выходы модели.
Вход (Input): some started before 1 360 — was typically accomplished by a master mason and a small team of itinerant masons, supplemented by local parish labourers, according to Poyntz Wright. But other authors reject this model, suggesting instead that leading architects designed the parish church towers based on early examples of Perpendicular. Выходы (Outputs): Gen 0: Revival architecture such as St. John’s Cathedral in London. The earliest surviving example of Perpendicular Revival architecture is found in the 18 th‑century Church of Our Lady of Guernsey, which dates from the late 19 th century. There are two types of perpendicular churches: those. Gen 1: architecture such as St. Peter’s Basilica in Rome or St. Peter’s Basilica in Buenos Aires. There is no evidence that any of these buildings were built during the reign of Pope Innocent III, but it is possible that they may have been built during the reign of his successor, Pope Innocent. Gen 5: ism, which had been translated into more than 100 languages including English, French, German, Italian, Spanish, Portuguese, Dutch, Swedish, Norwegian, Polish, Hungarian, Slovak, Lithuanian, Estonian, Finnish, Romanian, Bulgarian, Turkish, Croatian, Serbian, Ukrainian, Russian, Kazakh, Kyrgyz. Gen 9: architecture. In addition to being home to some of the world’s largest populations of black‑tailed jackrabbits, white‑tailed jackrabbits, blue‑tailed jackrabbits, red‑tailed jackrabbits, yellow‑. |
Абляция: повторы
Данные, сгенерированные языковыми моделями в экспериментах, в итоге содержали большое количество повторяющихся фраз, как в примере выше. Проблема повторов наблюдалась почти во всех моделях генерации текста17,18. Чтобы исключить её как причину коллапса модели, мы добавили численные эксперименты, в которых модели явно стимулировали производить неповторяющиеся последовательности со штрафом за повтор 2,0. Из‑за этого модели производили продолжения с более низкой оценкой, чтобы избежать повторов, что дополнительно ухудшало производительность последующих моделей. Перплексии моделей смещались по поколениям в сторону более вероятных последовательностей токенов в оценке модели, обученной на исходном распределении реальных данных. В частности, применение этого требования в экспериментах с LLM приводило к удвоению перплексии по сравнению с исходной. Модели остаются столь же подверженными коллапсу модели, если не более.
Описанный процесс показывает, что дообучение языковых моделей не сдерживает эффекты коллапса модели и дообучаемые модели также уязвимы. Со сменой поколений модели склонны производить более вероятные последовательности из исходных данных и начинают вносить свои собственные маловероятные последовательности, то есть ошибки.
Последствия имеет коллапс модели для лежащей в основе динамики обучения LLM
Долгосрочные атаки отравления языковых моделей — не новость. Например, мы видели появление клик‑, контент‑ и тролль‑ферм — своего рода человеческих «языковых моделей», задача которых — вводить в заблуждение социальные сети и поисковые алгоритмы. Негативное влияние, которое эти атаки отравления оказали на результаты поиска, привело к изменениям в поисковых алгоритмах. Например, Google понизил в выдаче «фермерские» статьи19, уделив больше внимания контенту от заслуживающих доверия источников, таких как образовательные домены, а DuckDuckGo полностью их удалил20. LLM отличает масштаб, в котором такое отравление может происходить, как только оно автоматизировано. Сохранение способности LLM моделировать маловероятные события необходимо для справедливости их предсказаний: такие события часто важны для маргинализированных групп. Маловероятные события также жизненно важны для понимания сложных систем21.
Наша оценка указывает на «преимущество первопроходца» в обучении таких моделей, как LLM. Обучение на выборках из другой генеративной модели может вызвать сдвиг распределения, который со временем приводит к коллапсу модели. Это, в свою очередь, заставляет модель неверно воспринимать лежащую в основе задачу обучения. Чтобы долго поддерживать обучение, нужно обеспечить доступ к исходному источнику данных и появление со временем новых данных, не сгенерированных LLM. Необходимость отличать данные, сгенерированные LLM, от прочих данных ставит вопросы о происхождении контента, собираемого из интернета: неясно, как можно отслеживать сгенерированный LLM контент в масштабе. Один из вариантов — координация в рамках сообщества, гарантирующая, что разные стороны, участвующие в создании и развёртывании LLM, делятся информацией, необходимой для решения вопросов происхождения. Без доступа к данным, созданным людьми, обучать новые версии LLM станет всё труднее.
Вклад авторов
И. Шумайлов и З. Шумайлов предложили и развили идею, руководили исследованием и математическим моделированием, разработали эксперименты с GMM и VAE. И. Шумайлов и И. Чжао разработали эксперименты с языковыми моделями. Н. Паперно, Я. Гал и Р. Андерсон осуществляли научное руководство и сопровождение проекта. Все авторы участвовали в написании рукописи. Я. Гал поддерживается стипендией Turing AI Fellowship, финансируемой Office for Artificial Intelligence правительства Великобритании через UK Research and Innovation (номер гранта EP/V030302/1) и реализуемой Институтом Алана Тьюринга (Alan Turing Institute).
Данные и код
Код для всех экспериментов общедоступен.13
Данные, использованные в экспериментах с VAE, доступны в источнике 22. Данные, использованные в экспериментах с LLM, доступны в источнике 17.
Дополнительные материалы (PDF), дополнительные данные (ZIP‑архив для скачивания)
Источники
Radford, A. et al. Language models are unsupervised multitask learners. OpenAI blog1, 9 (2019).
Brown, T. et al. Language models are few‑shot learners. Adv. Neural Inf. Process. Syst.33, 1877–1901 (2020).
OpenAI. GPT-4 Technical Report. https://cdn.openai.com/papers/gpt-4.pdf (2023).
Devlin, J., Chang, M.‑W., Lee, K. & Toutanova, K. in Proc. 2 019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers) (eds Burstein, J., Doran, C. & Solorio, T.) 4171–4186 (Association for Computational Linguistics, 2019).
Liu, Y. et al. RoBERTa: a Robustly Optimized BERT Pretraining Approach. Preprint at https://arxiv.org/abs/1907.11692 (2019).
Zhang, S. et al. Opt: open pre‑trained transformer language models. Preprint at https://arxiv.org/abs/2205.01068 (2022).
Aljundi, R., Kelchtermans, K. & Tuytelaars, T. Task‑free continual learning. in: Proc. 2 019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 11254–11263 (IEEE, 2019).
Carlini, N. & Terzis, A. in Proc. Tenth International Conference on Learning Representations (ICLR, 2022).
Carlini, N. et al. in Proc. 2 024 IEEE Symposium on Security and Privacy (SP) 179 (IEEE, 2024).
Mousavi‑Hosseini, A., Park, S., Girotti, M., Mitliagkas, I. & Erdogdu, M. A. in Proc. Eleventh International Conference on Learning Representations (ICLR, 2023).
Soudry, D., Hoffer, E., Nacson, M. S., Gunasekar, S. & Srebro, N. The implicit bias of gradient descent on separable data. J. Mach. Learn. Res.19, 1–57 (2018).
Gu, Y., Dong, L., Wei, F. & Huang, M. in Proc. Twelfth International Conference on Learning Representations (ICLR, 2024).
Shumailov, I. & Shumaylov, Z. Public code for Model Collapse (0.1). Zenodo 10.5281/zenodo.10866595 (2024).
Bommasani, R. et al. On the opportunities and risks of foundation models. Preprint at https://arxiv.org/abs/2108.07258 (2022).
Strubell, E., Ganesh, A. & McCallum, A. in Proc. 57 th Annual Meeting of the Association for Computational Linguistics (eds Korhonen, A., Traum, D. & Màrquez, L.) 3645–3650 (Association for Computational Linguistics, 2019).
Merity, S., Xiong, C., Bradbury, J. & Socher, R. in Proc. 5 th International Conference on Learning Representations (ICLR, 2017).
Keskar, N. S., McCann, B., Varshney, L. R., Xiong, C. & Socher, R. CTRL: a conditional transformer language model for controllable generation. Preprint at https://arxiv.org/abs/1909.05858 (2019).
Shumailov, I. et al. in Proc. 2 021 IEEE European Symposium on Security and Privacy (EuroS&P) 212–231 (IEEE, 2021).
Google. Finding more high‑quality sites in search. Google https://googleblog.blogspot.com/2011/02/finding‑more‑high‑quality‑sites‑in.html (2011).
Mims, C. The search engine backlash against “content mills”. MIT Technology Review https://www.technologyreview.com/2010/07/26/26327/the‑search‑engine‑backlash‑against‑content‑mills/ (2010).
Taleb, N. N. Black swans and the domains of statistics. Am. Stat.61, 198–200 (2007).
LeCun, Y., Cortes, C. & Burges, C. J. C. The MNIST database of handwritten digits. http://yann.lecun.com/exdb/mnist/ (1998).