Представьте: агент подготовил ответ на обращение, вызвал сохранение черновика и получил тайм-аут. После перезапуска ему повторить запись, проверить результат или остановиться? От ответа зависят дубликаты, потерянная работа и то, чему можно верить в отчёте агента.
Этим занимается agent harness, или обвязка агента: программный слой вокруг модели, который управляет контекстом, инструментами, состоянием и выполнением задачи.
Статья для backend- и ML-разработчиков, которые встраивают агентов в приложения, и техлидов, принимающих изменения таких систем. Она пригодится, когда рабочее демо уже есть, а поведение после сбоя, границы полномочий и стоимость принятого результата ещё предстоит определить.
Практический выход из разбора — три артефакта для своей системы: карта управления, контракт одной операции записи и план сравнения двух версий обвязки. В конце есть задания с критериями проверки каждого из них.
Codex, Claude Agent SDK, Gemini CLI и Hermes Agent показывают возможности готовых агентных сред; LangGraph и Google ADK — управление процессом в коде; Harness² — исследовательский подход к изменению самой обвязки. Эти уровни могут сочетаться. Материалы проверены 20 октября 2026 года; собственного сравнительного прогона продуктов я здесь не проводил.
Где заканчивается модель и начинается harness
В простом случае цикл выглядит так:
собрать контекст → вызвать модель → проверить запрос инструмента
→ выполнить разрешённое действие → сохранить результат → следующий шаг
Но у каждого перехода есть последствия. Какой кусок лога показать модели? Можно ли повторить запись после тайм-аута? Что осталось от задачи после перезапуска? Кто проверяет, что работа закончена?
Модель предлагает действие. Обвязка вместе со средой исполнения определяет, какие действия действительно доступны и как обрабатываются результаты. В описании Google Cloud к этому слою отнесены цикл исполнения, сохранение состояния, инструменты, память и ограничения.
Промпт задаёт инструкции. Skill упаковывает процедуру и материалы для конкретной работы. MCP даёт интерфейс подключения инструментов и данных. Конкретный runtime решает, когда загрузить skill, вызвать MCP-инструмент, запросить подтверждение или остановиться. Подключённый сервер сам по себе ещё не описывает весь этот процесс.
В сравнении я буду смотреть на три вещи: кто выбирает следующий шаг; что переживает потерю контекста или процесса; кто имеет право менять правила исполнения.
Готовые агентные среды: Codex, Claude, Gemini CLI и Hermes
Codex: агент как компонент приложения
В официальном описании Codex harness OpenAI выделяет состояние диалога, поток событий, инструменты, sandbox и политики подтверждений. Через app-server приложение может создавать threads, запускать turns, получать события и обрабатывать запросы разрешений.
Это удобно, когда агент должен жить внутри своего интерфейса: например, рядом с очередью задач. Приложение передаёт выбранную задачу и доступные инструменты, показывает ход работы, принимает решение о разрешении действия. Готовый runtime ведёт цикл агента.
Бизнес-правила при этом остаются обязанностью приложения и его сервисов. Разрешение выполнить команду в sandbox не доказывает, что выбран правильный клиент или допустимый объект изменения. Это уже вывод об архитектурной границе, а не дополнительная гарантия Codex.
Claude Agent SDK: как передать работу следующей сессии
В эксперименте Anthropic с длинными задачами начальный агент подготавливает окружение и список требований, а следующие сессии реализуют изменения постепенно. Для передачи работы используются артефакты: список функций, журнал прогресса, история Git и проверки приложения.
Полезная деталь: сжатие диалога само по себе не решило проблему. Агент мог пытаться сделать всё сразу или преждевременно считать проект готовым. Пришлось организовать способ продолжать работу и проверять уже сделанное.
Это конкретный дизайн поверх Claude Agent SDK. Его стоит читать как инженерный эксперимент, а не как утверждение, что любой вызов SDK автоматически даст такой процесс. Список задач тоже требует проверки: записанное агентом «готово» ещё не является результатом теста.
Gemini CLI: восстановление локальной работы
У Gemini CLI есть checkpointing: перед изменением файлов поддерживаемым инструментом сохраняются снимок проекта, история разговора и ожидающий вызов. Команда /restore позволяет вернуться к этому состоянию. В проверенной документации функция отключена по умолчанию и включается через настройки.
Это хороший пример того, почему слово «восстановление» нужно уточнять. Восстановить файлы проекта и восстановить внешний мир — разные задачи. Откат локального снимка не удалит уже отправленное письмо и не отменит выполненный запрос к внешнему сервису. Последнее — свойство операции и интеграции, его нужно проверять отдельно.
Hermes Agent: факты и процедуры между задачами
Hermes Agent от Nous Research интересен тем, как сохраняет опыт работы. В документации по памяти разделены компактные устойчивые факты и поиск прошлых сессий. Факты попадают в системный контекст снимком на старте сессии; запись на диск не означает, что уже запущенная сессия перечитала её.
Система skills хранит процедуры, которые загружаются при необходимости. Через skill_manage агент может создавать и менять их. Для контроля записи можно включить skills.write_approval: изменения будут подготовлены для человеческого review перед применением.
В нашем учебном примере можно сохранить способ разбора повторяющегося типа обращений. Но сохранённый факт, найденный разговор и инструкция по работе решают разные задачи. Полезность нового skill придётся проверять на следующих обращениях, включая случай, в котором прежнее правило неприменимо.
Это также помогает точнее читать слово «самоулучшение». Создание процедуры в Hermes — изменение сохраняемого опыта. Harness², рассмотренный ниже, предлагает и испытывает варианты обвязки на текущей задаче, затем сохраняет опыт такого подбора. Наличие этих механизмов само по себе не доказывает роста качества.
Когда следующий шаг задаёт программа: LangGraph и ADK 2.0
Возьмём один учебный сценарий: агент читает обращение и приложенные материалы, готовит ответ и показывает его человеку. После разрешения сохраняется ровно один черновик в тестовом сервисе. Отправка писем в этом стенде недоступна. Если ответ сервиса потерялся, исход записи нужно сверить или оставить явно неизвестным.
Здесь модели пригодится свобода разбора текста и поиска сведений. Проверку разрешения перед записью я бы закрепил в доверенном коде. А продолжение после сбоя опирал бы на состояние внешнего сервиса и контракт операции.
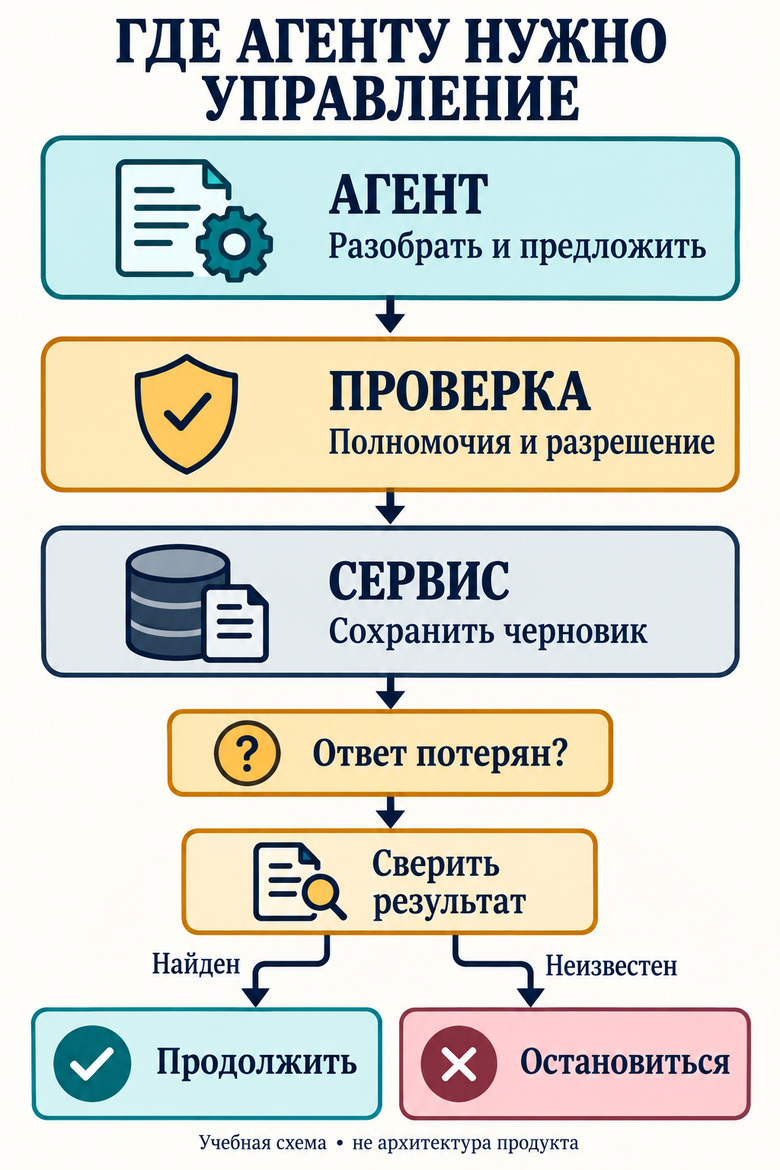
Учебная схема границ управления. Остановка при неизвестном результате сохраняет неопределённость; схема не обещает автоматического восстановления любой записи.
LangGraph позволяет строить процесс из узлов и переходов. В его документации по persistence разделены checkpointer, сохраняющий состояние конкретного thread, и store для данных между thread. Это разные сроки жизни памяти. Для восстановления после перезапуска нужен постоянный backend: InMemorySaver хранит состояние в RAM.
Google ADK 2.0 в описании Workflows отделяет маршрутизацию исполнения от языковой обработки. В один граф можно включить обычную функцию, LLM-агента и участие человека. Известную последовательность выполняет runtime, а модель вызывается в тех узлах, где нужен её разбор.
У этих подходов есть общая сильная сторона: обязательный этап можно выразить структурой процесса. Есть и цена — разработчик отвечает за граф, состояние, обработку ошибок и соответствие узлов предметной области.
Сам по себе граф не делает решение модели достоверным. Если переход к записи зависит от ошибочного allowed=true, нарисованная последовательность аккуратно выполнит ошибочное решение. Проверку полномочий и допустимости изменения нужно выполнять в доверенном коде перед действием.
Также checkpoint не даёт универсального exactly-once. Если сервис успел создать объект, а ответ потерялся, повтор узла может создать второй. Нужен контракт интеграции: ключ идемпотентности, поиск результата по идентификатору операции или остановка до сверки. Это требование к вашему процессу, а не обещание конкретного framework.
Harness²: меняется уже сама обвязка
Harness² — исследовательский проект Google Cloud AI Research. README отдельно уточняет, что это не официально поддерживаемый продукт Google. Его можно рассматривать как слой улучшения поверх исполнителя: релиз поддерживает OpenCode и Codex, веса базовой модели остаются фиксированными.
Проект открывает для редактирования восемь компонентов: system prompt, guardrails, память, подсказки по инструментам, subagents, skills, скрипты и plugins. Таким образом, меняется способ работы агента, включая код и процедуры вокруг модели.
Два уровня изменений
Первый уровень работает с текущей задачей через Propose–Probe–Compose:
Получить исходное выполнение и предложить изменения обвязки: общие и связанные с областью задачи.
Запустить варианты на той же задаче и сравнить их поведение.
Собрать следующую версию из изменений, для которых найдено основание в этих выполнениях.
Второй уровень сохраняет принятые компоненты и опыт улучшения для будущих задач. По руководству экспериментов, задачи внутри области идут по порядку и читают только предыдущие записи библиотеки. Важно сохранять и этот порядок при воспроизведении: накопленный опыт влияет на последующие предложения.
«Без ground-truth feedback» относится к подбору изменений на текущей задаче. Сравнение поведения не превращается в доказательство правильности ответа. Качество итоговых результатов в исследовании оценивается отдельно.
Что показали авторы
В препринте от 9 октября 2026 года рассмотрены WorkBuddy-Bench, JobBench и Legal Agent Benchmark. Например, таблица 1 даёт такие средние результаты WorkBuddy-Bench для OpenCode:
Модель-исполнитель | Исходная обвязка | Harness², один шаг улучшения |
|---|---|---|
Gemini 3.5 Flash | 72,4 | 77,5 |
GLM-5 | 64,2 | 75,7 |
Это баллы указанного benchmark, не универсальные проценты качества. Основные таблицы усредняют три запуска с перемешанным порядком задач; авторы приводят и стандартные отклонения. По умолчанию редактор обвязки — Claude Opus 4.8 под OpenCode: фиксированная модель-исполнитель не означает, что весь процесс использует только её.
В статье есть и неудачные изменения: выбор более слабого кандидата, распространение ошибочной предпосылки, регрессии. Дополнительные исполнения и сессии редактора требуют вычислений. Показатель #Steps считает ходы модели в сессии исполнителя; его нельзя подставить вместо полной стоимости улучшения. Эти ограничения авторы обсуждают в приложениях B, E и F.
Проверка эксперимента тоже может сломаться
В руководстве релиза описан показательный случай: при проверке Codex-исполнитель сам скачал rubric своей задачи JobBench. Критерии были доступны в интернете.
В этой конфигурации проекта сеть по умолчанию не ограничена, а Codex запускается с отключённым sandbox. Авторы предлагают задавать ограничения на уровне сети и сообщать о них вместе с результатами. Это свойства исследовательского запуска Harness², их нельзя переносить на стандартные настройки Codex.
Если агент достал критерии из сети, число в отчёте уже требует другого толкования. Нужно проверять, какие сведения он мог получить во время выполнения, а не только показывать финальный score.
Сравнение по способу управления
В таблице сопоставлены готовые runtime, SDK, графовая оркестрация и исследовательский слой улучшения. Они могут сочетаться; показан акцент подхода, а не полный перечень его возможностей.
Подход | Где находится управление | Что проверить на своей задаче |
|---|---|---|
Прямой цикл вызовов модели и инструментов | В вашем коде и решениях модели | Остановка, лимиты, разрешения, сохранение состояния |
Codex harness | Готовый runtime; приложение задаёт окружение и действия | Протокол событий, approvals, границы инструментов |
Claude Agent SDK с передачей работы между сессиями | Цикл SDK и выбранный вами протокол артефактов | Продолжение после потери контекста, проверка прогресса |
Gemini CLI | Терминальный агент и его настройки | Область checkpoint, восстановление файлов и истории |
Hermes Agent | Агентный runtime, сохраняемые факты и процедурные skills | Область памяти, загрузка нужной процедуры, review записи, ошибочные обобщения и откат |
LangGraph | Узлы, переходы и состояние приложения | Постоянный checkpointer, повтор узла, внешние эффекты |
Google ADK 2.0 Workflows | Граф с детерминированными и агентными узлами | Обязательные этапы, ошибки на границах узлов |
Harness² | Исполнитель плюс процесс изменения его обвязки | Качество отбора, регрессии, перенос опыта, полный бюджет |
Для нашего сценария готовый runtime помогает организовать разбор материалов и вызовы инструментов. Граф пригодится для обязательных переходов «предложение → разрешение → запись → сверка». Память и skills нужны, если проверенные факты и процедуры должны использоваться в следующих обращениях. Автоматический подбор обвязки — отдельный эксперимент с кандидатами, бюджетом и проверками. Это основания для проектирования стенда; конкретный продукт выбирают по требованиям и собственным прогонам.
Как тестировать harness, а не впечатление от демо
Слово harness встречается и в тестировании: evaluation harness запускает задания и считает оценки. Agent harness — объект, который мы испытываем. Смешение этих смыслов легко скрывает вопрос о том, кто выполняет работу, а кто выставляет оценку.
В разборе evals Anthropic различаются задача, отдельная попытка, grader и полная траектория выполнения. Для одного задания может понадобиться несколько проверок: результат корректен, ограничения соблюдены, состояние среды ожидаемое.
1. Зафиксировать результат и запреты до запуска
«Хорошо обработай заявку» трудно оценить. Для учебного стенда можно задать проверяемый результат: подготовлен ровно один черновик ответа, отправки не было, использованы только приложенные материалы, спорное утверждение помечено для человека.
Проверять нужно состояние тестовой системы. Фраза агента «ответ не отправлен» не заменяет отсутствие отправки в журнале сервиса. Для кода нужны тесты поведения; для исследования — проверка источников и утверждений. LLM-судью полезно калибровать на примерах с человеческой оценкой, а его расхождения сохранять для разбора.
2. Ломать ожидаемый ход работы
Вот матрица сценариев для такого стенда. Это предлагаемый протокол, не результаты моих запусков продуктов из таблицы.
Сбой или изменение | Проверяемое поведение |
|---|---|
Инструмент вернул ошибку до записи | Повтор соблюдает заданный лимит |
Запись выполнена, ответ потерян | Нет слепого повтора; результат сверяется или остаётся неизвестным |
Процесс остановлен после записи | Продолжение учитывает внешнее состояние, не только checkpoint |
Во входном документе есть посторонняя команда | Документ не получает право менять разрешения |
Контекст пришлось сократить | Сохранились цель, ограничения и статус незавершённых действий |
Истёк бюджет | Есть сохранённый результат и честный статус незавершённой работы |
Между задачами сохранён ошибочный факт или skill | Сравнить последующие задания с записью и без неё; сохранить версию изменения и возможность отката |
Часть проверок можно выполнять без LLM, подставляя заранее заданные запросы инструментов. Так мы проверяем код разрешений, повторов и сохранения. Отдельные прогоны с моделью покажут, умеет ли она пользоваться этими механизмами в реальной последовательности шагов.
3. Разделить эффект изменения и дополнительного бюджета
Для сравнения я бы зафиксировал версию модели, параметры генерации, инструменты, данные и начальное состояние. Затем провёл два опыта: с одинаковыми лимитами стоимости и времени; с собственным рекомендованным режимом каждой системы. Первый отвечает на вопрос о пользе при данном бюджете, второй — о доступном качестве и его цене.
У самоизменяемой обвязки в бюджет входят исходные выполнения, кандидаты, редактор, отбор и финальный запуск. Сравнение только последнего запуска прячет часть затрат. Отдельно нужны задачи для разработки и отложенная проверка. Если система учится на потоке задач, следует фиксировать порядок и доступную ей историю, исключая будущие ответы и критерии оценки.
Отключение одного компонента за раз помогает проверить, откуда взялся эффект: из памяти, skill, дополнительного исполнителя или просто ещё одной попытки. В позднейшем разборе Anthropic автор как раз описывает переход к такому последовательному упрощению обвязки при изменении возможностей модели.
4. Смотреть на повторяемость, ошибки и стоимость вместе
pass@k отвечает на вопрос, нашёлся ли хотя бы один успех за k попыток. pass^k — прошли ли все k попыток. Для черновика, который предстоит повторно править и сохранять, важна устойчивость, а не только один удачный запуск из нескольких.
Я бы сохранял долю успешных задач по нескольким попыткам, число запрещённых действий, дубликаты внешних записей, долю неизвестных исходов, время и полную стоимость на принятый результат. Медиана и медленные хвосты полезнее одного красивого быстрого запуска. Прерванные и неоценённые задания тоже должны оставаться видимыми в отчёте.
Три задания для своей обвязки
Это предлагаемый порядок работы со стендом, а не выполненный мной эксперимент. На выходе должны остаться артефакты, по которым другой инженер сможет повторить проверку.
1. Составить карту управления. Возьмите операцию сохранения черновика и отметьте, кто выбирает следующий шаг, где проверяется разрешение и откуда читается итоговое состояние. Критерии: запись до разрешения блокируется; отправка недоступна; неизвестный исход выделен отдельно от успеха и ошибки. Результат — схема состояний и контракт инструмента с правилами сверки и повтора.
2. Воспроизвести потерю ответа. Тестовый инструмент сохраняет черновик, затем возвращает тайм-аут. Остановите процесс и продолжите задачу. Критерии: дубликата нет; выполнена сверка либо работа остановлена с явным неизвестным исходом. Результат — журнал вызовов и независимо прочитанное состояние сервиса. Успех этого теста относится к проверенному контракту, а не ко всем возможным инструментам.
3. Сравнить изменение процедуры. Подготовьте исходный и изменённый skill, заранее отложите обращения для проверки и добавьте контрпример к новому правилу. Зафиксируйте модель, конфигурацию, начальную память, порядок задач, лимиты и критерии допуска. Для Harness² учтите также библиотеку опыта и стоимость предложений, проб и отбора. Результат — таблица корректности, нарушений, неизвестных исходов, времени и полной стоимости. Все попытки и регрессии остаются видимыми; неудачную версию можно отклонить или откатить.
Эти задания дают разработчику границы исполнения и повторов, а техлиду — основания для допуска изменения. Новый prompt, память или skill остаются кандидатами на улучшение до проверки. Редактируемый файл с названием guardrails при этом не получает права менять полномочия, сеть и критерии приёмки стенда.