

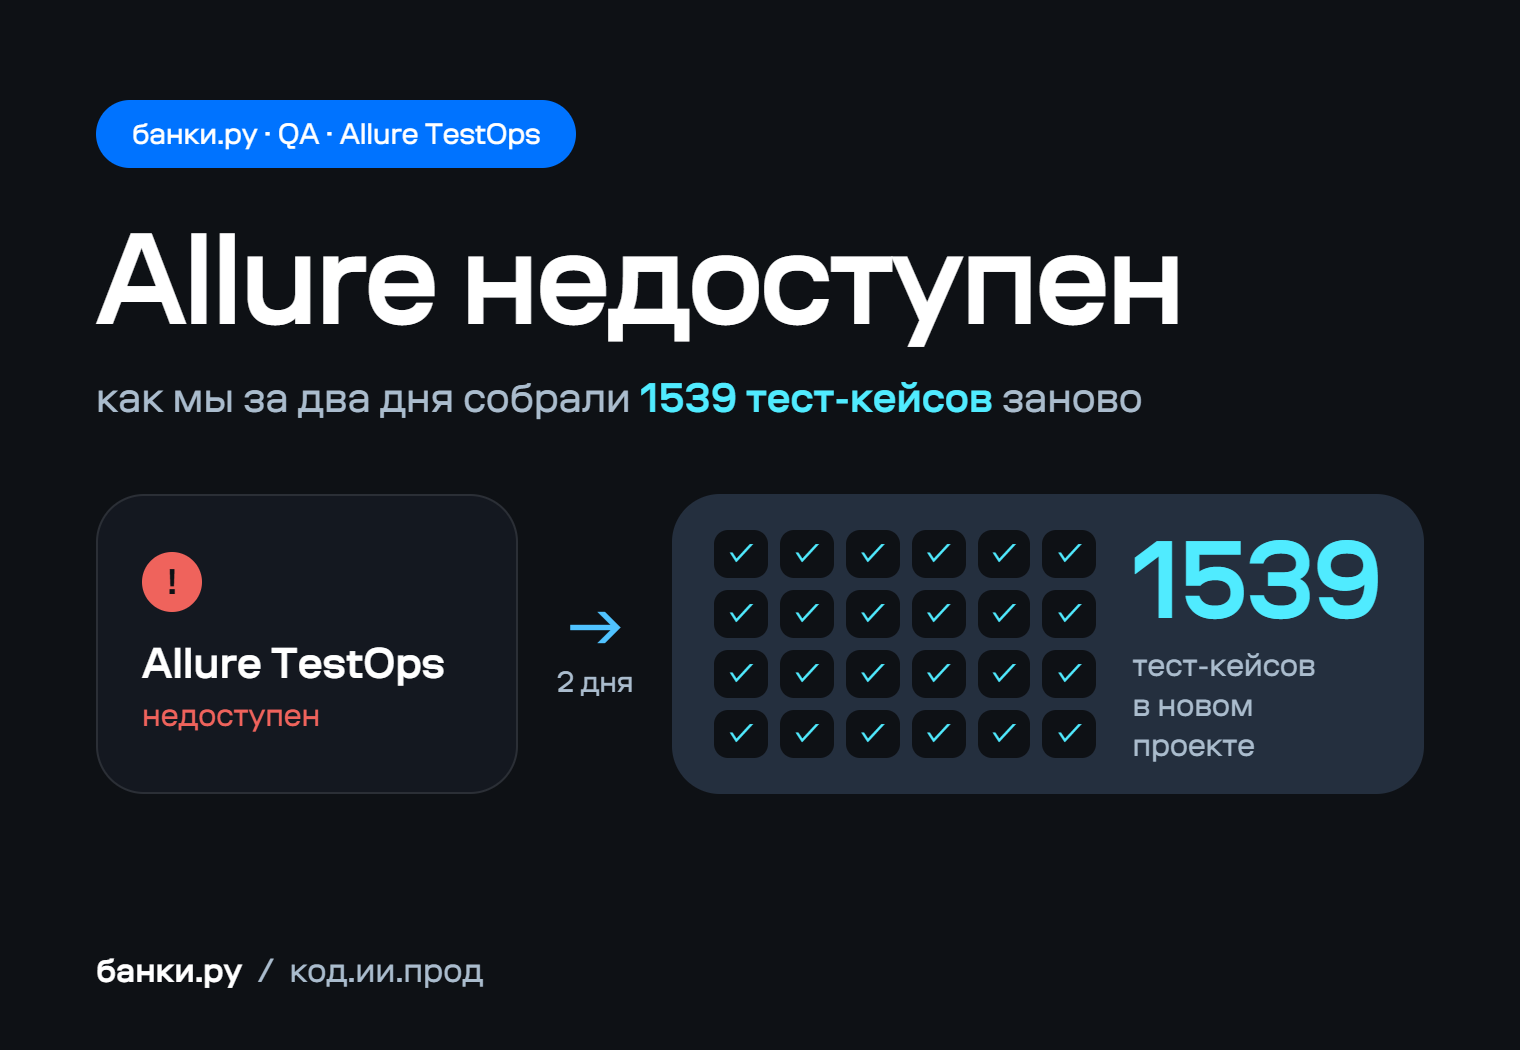
Всем привет! Меня зовут Костя, я QA-инженер в Банки.ру. 12 октября наш проект в Allure TestOps (это TMS, система управления тестированием) с 1539 тест-кейсами стал недоступен, и штатно восстановить его не получилось. К 14 октября мы собрали его заново. Помогли JSON-выгрузка от 2 октября и вики в Obsidian, где записано устройство проекта.
Расскажу, как это сработало, чего вернуть не удалось и как хранить копию рабочих знаний вне конкретного сервиса.
Коротко:
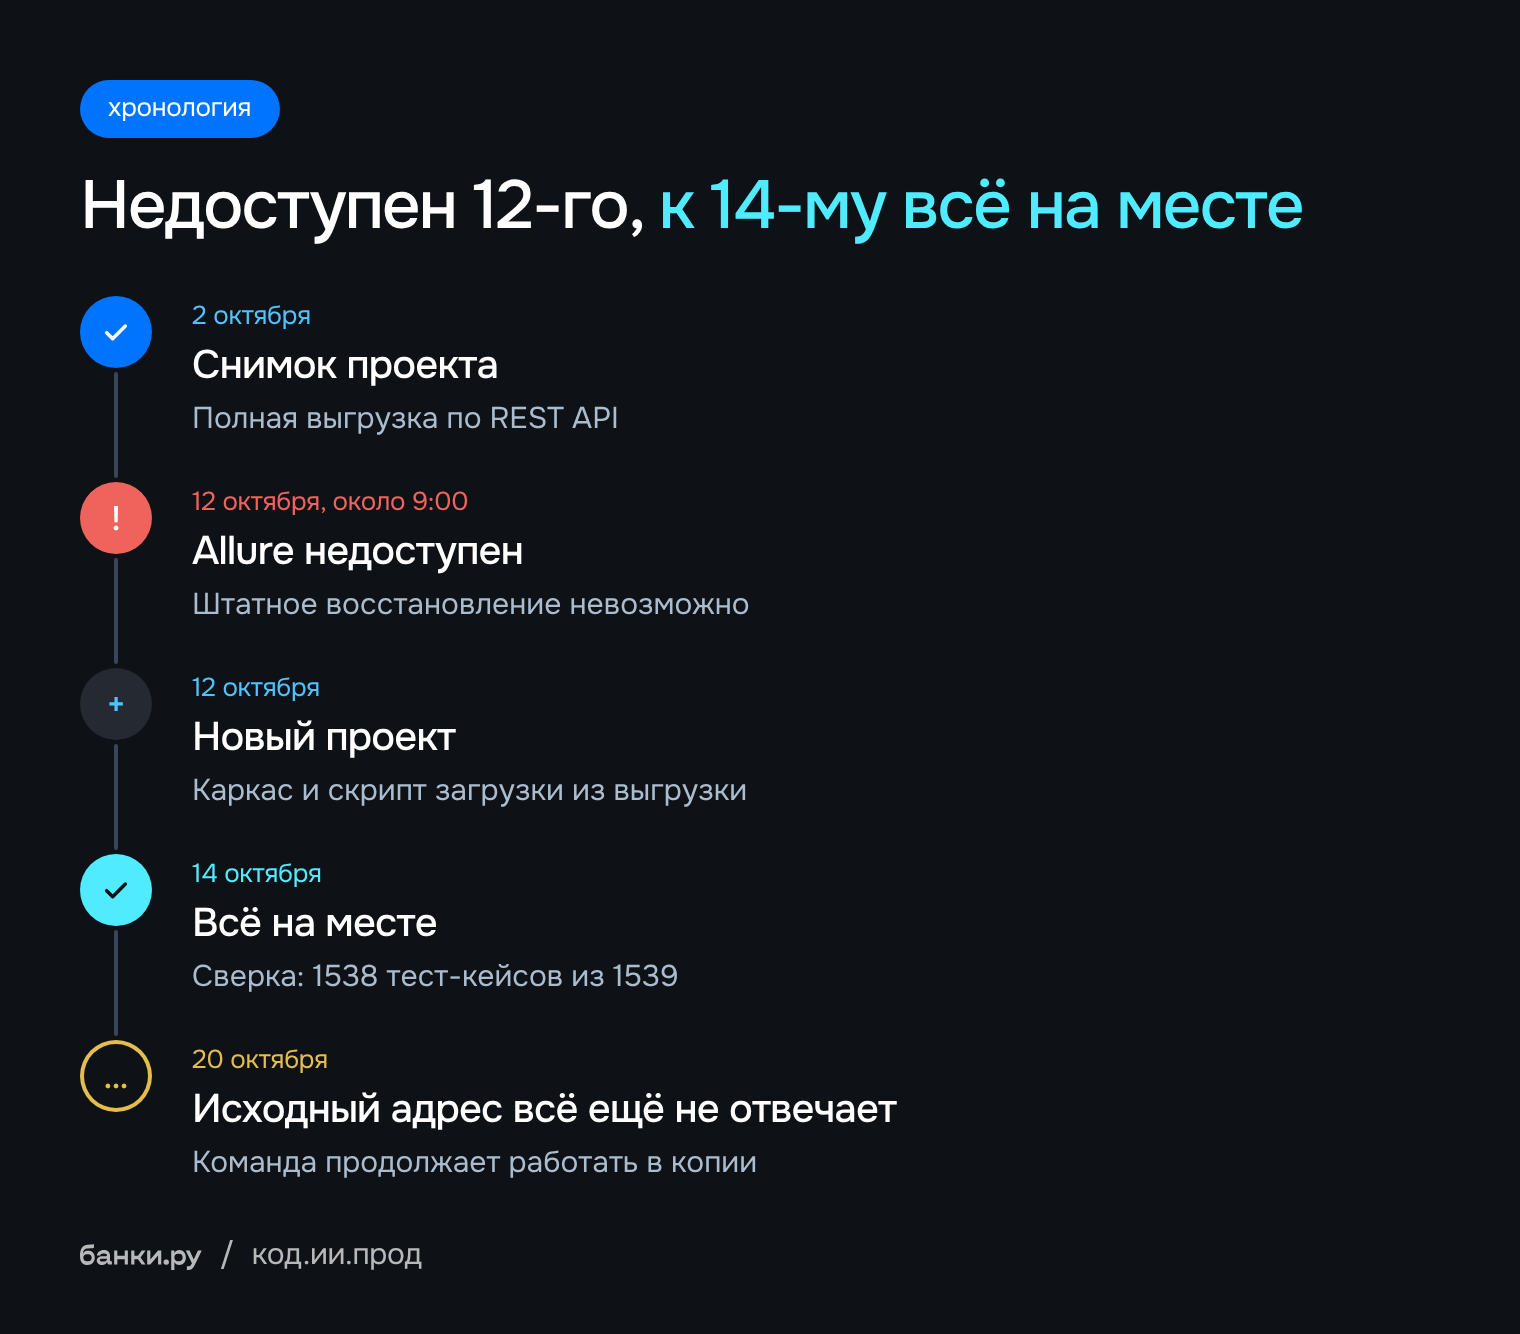
12 октября проект в Allure с 1539 тест-кейсами стал недоступен.
Собрали по JSON-выгрузке от 2 октября и вики в Obsidian.
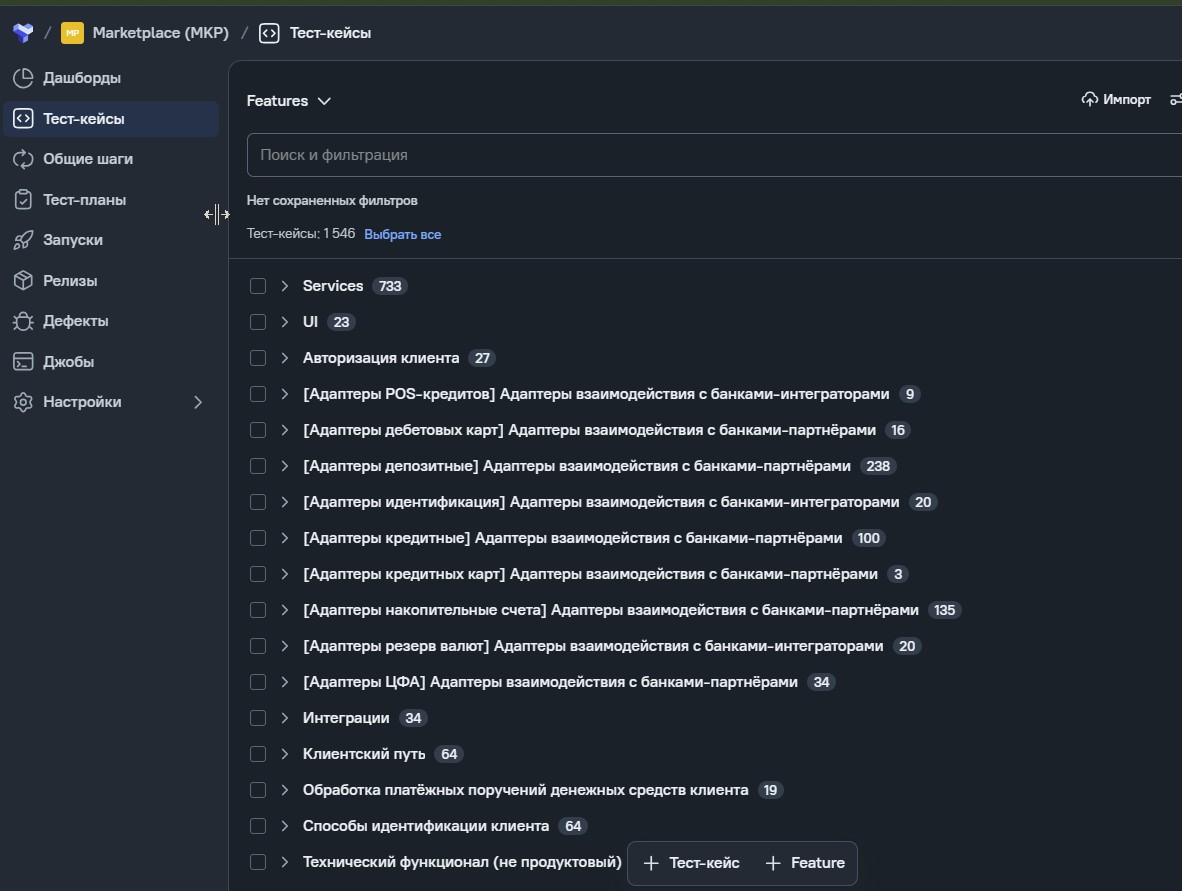
К 14 октября проект был собран заново, при сверке совпали 1538 тест-кейсов из 1539.
Вложений и истории прогонов в копии не было.
К 20 октября исходный адрес всё ещё не отвечал, и команда работала в собранной копии.
Что произошло
Allure TestOps был развёрнут на инфраструктуре, которая 12 октября около девяти утра по Москве стала недоступна. Штатное восстановление оказалось невозможно, и мы стали искать, из чего собрать проект заново. Недоступным стало всё содержимое проекта: 1539 тест-кейсов, 14 общих шагов и вложения.
Что лежало заранее: вики и выгрузка
Выручили две вещи, и обе заранее лежали в Obsidian. Я веду там вики для работы с агентом. Про Obsidian как инструмент личных конспектов уже писал мой коллега (статья про связку с Zotero). Здесь речь о командной вики, с которой работает агент. После каждой задачи в неё записывается, как устроены сервисы, какие баги нашлись и как работает Allure. Это папка markdown-файлов по паттерну Карпати. Сырые источники лежат отдельно и не правятся, поверх них LLM собирает страницы, а правила описывают, как это делать. Описание паттерна лежит в гисте Карпати, разбор есть в гайде. Вики лежит в git и читается без приложения.
Наполняет её мой скилл wiki: он записывает находки после задачи и ищет по вики перед ней. Про скиллы я писал в прошлой статье, сам скилл лежит в моём репозитории. Агент читает страницы вики, поэтому в ней нет личных токенов и персональных данных клиентов. Confluence у нас тоже есть, но для агента страницы проще держать в markdown-файлах.
Чтобы агент не выдумывал факты, страница записывается только с источником: код, трейс, SQL, страница Confluence. Нет источника — пометка HYPOTHESIS, то есть «возможно, но не точно». Общую вики команды обновляют через pull request: каждое изменение смотрит ещё один человек.
Теперь о двух вещах, на которых держалось восстановление.
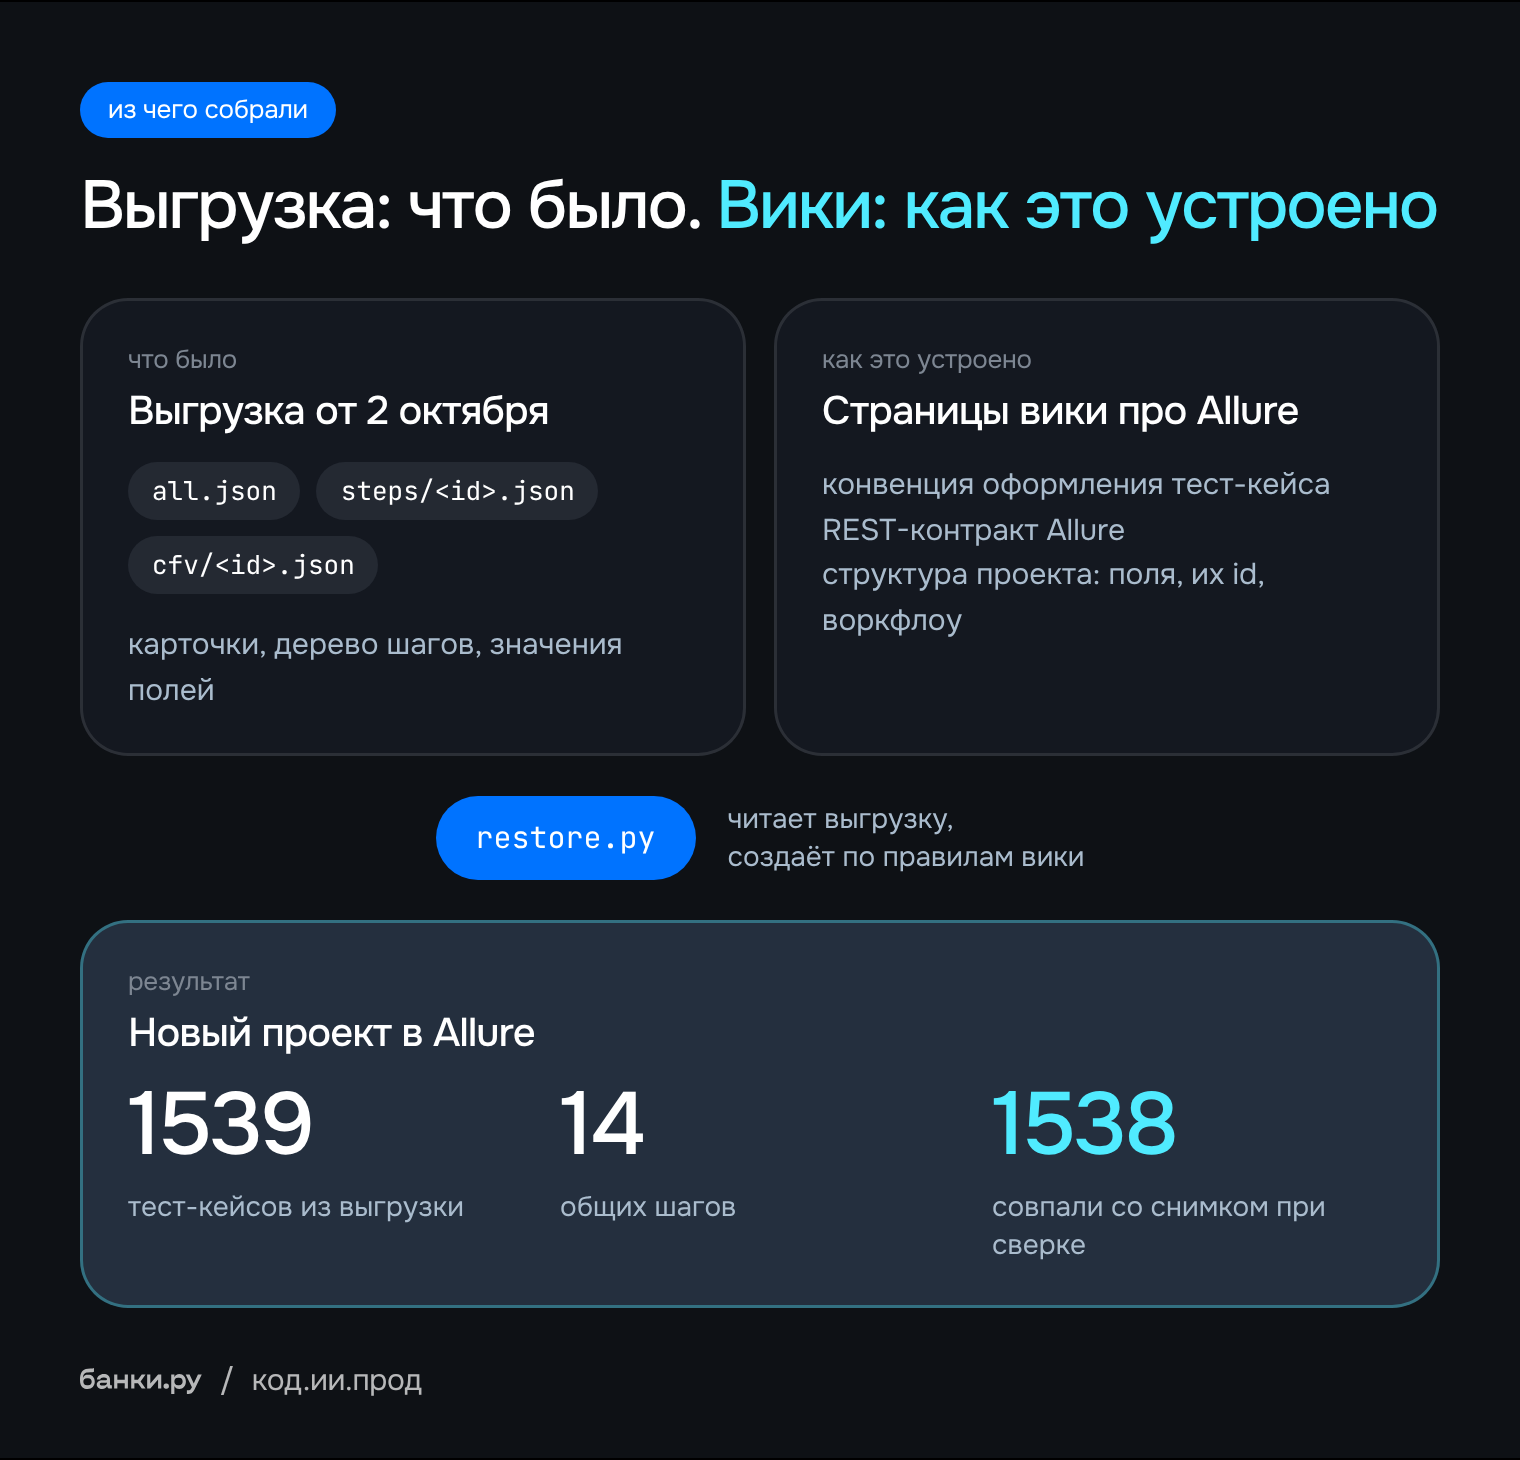
Выгрузка проекта. Полный снимок от 2 октября: программа забрала данные через REST API, то есть через интерфейс Allure для программ:
all.json— карточки всех тест-кейсов;steps/<id>.json— дерево шагов каждого тест-кейса с разметкой, ожидаемым результатом и общими шагами;cfv/<id>.json— значения полей Feature, Story, Layer.
Снял я её 2 октября не как бэкап, а для другой задачи: искать тест-кейсы по тексту шагов. Нам отчасти повезло: такую выгрузку стоит делать нарочно.
Страницы вики про Allure. Они отвечают на вопрос «как всё устроено»:
конвенция оформления тест-кейса: заголовок, описание, шаги, ожидаемый результат;
REST-контракт Allure: какие запросы можно отправлять и что Allure отвечает;
структура проекта: поля и их id, дерево, воркфлоу статусов.
Выгрузка говорит, что было, страницы говорят, как это устроено. Вместе этого хватило, чтобы собрать проект заново.
Как собрали проект заново
Порядок действий на рисунке, ниже он разобран с кодом. Если вам интересна только организационная часть, переходите к разделу «Как мы страхуемся сейчас».
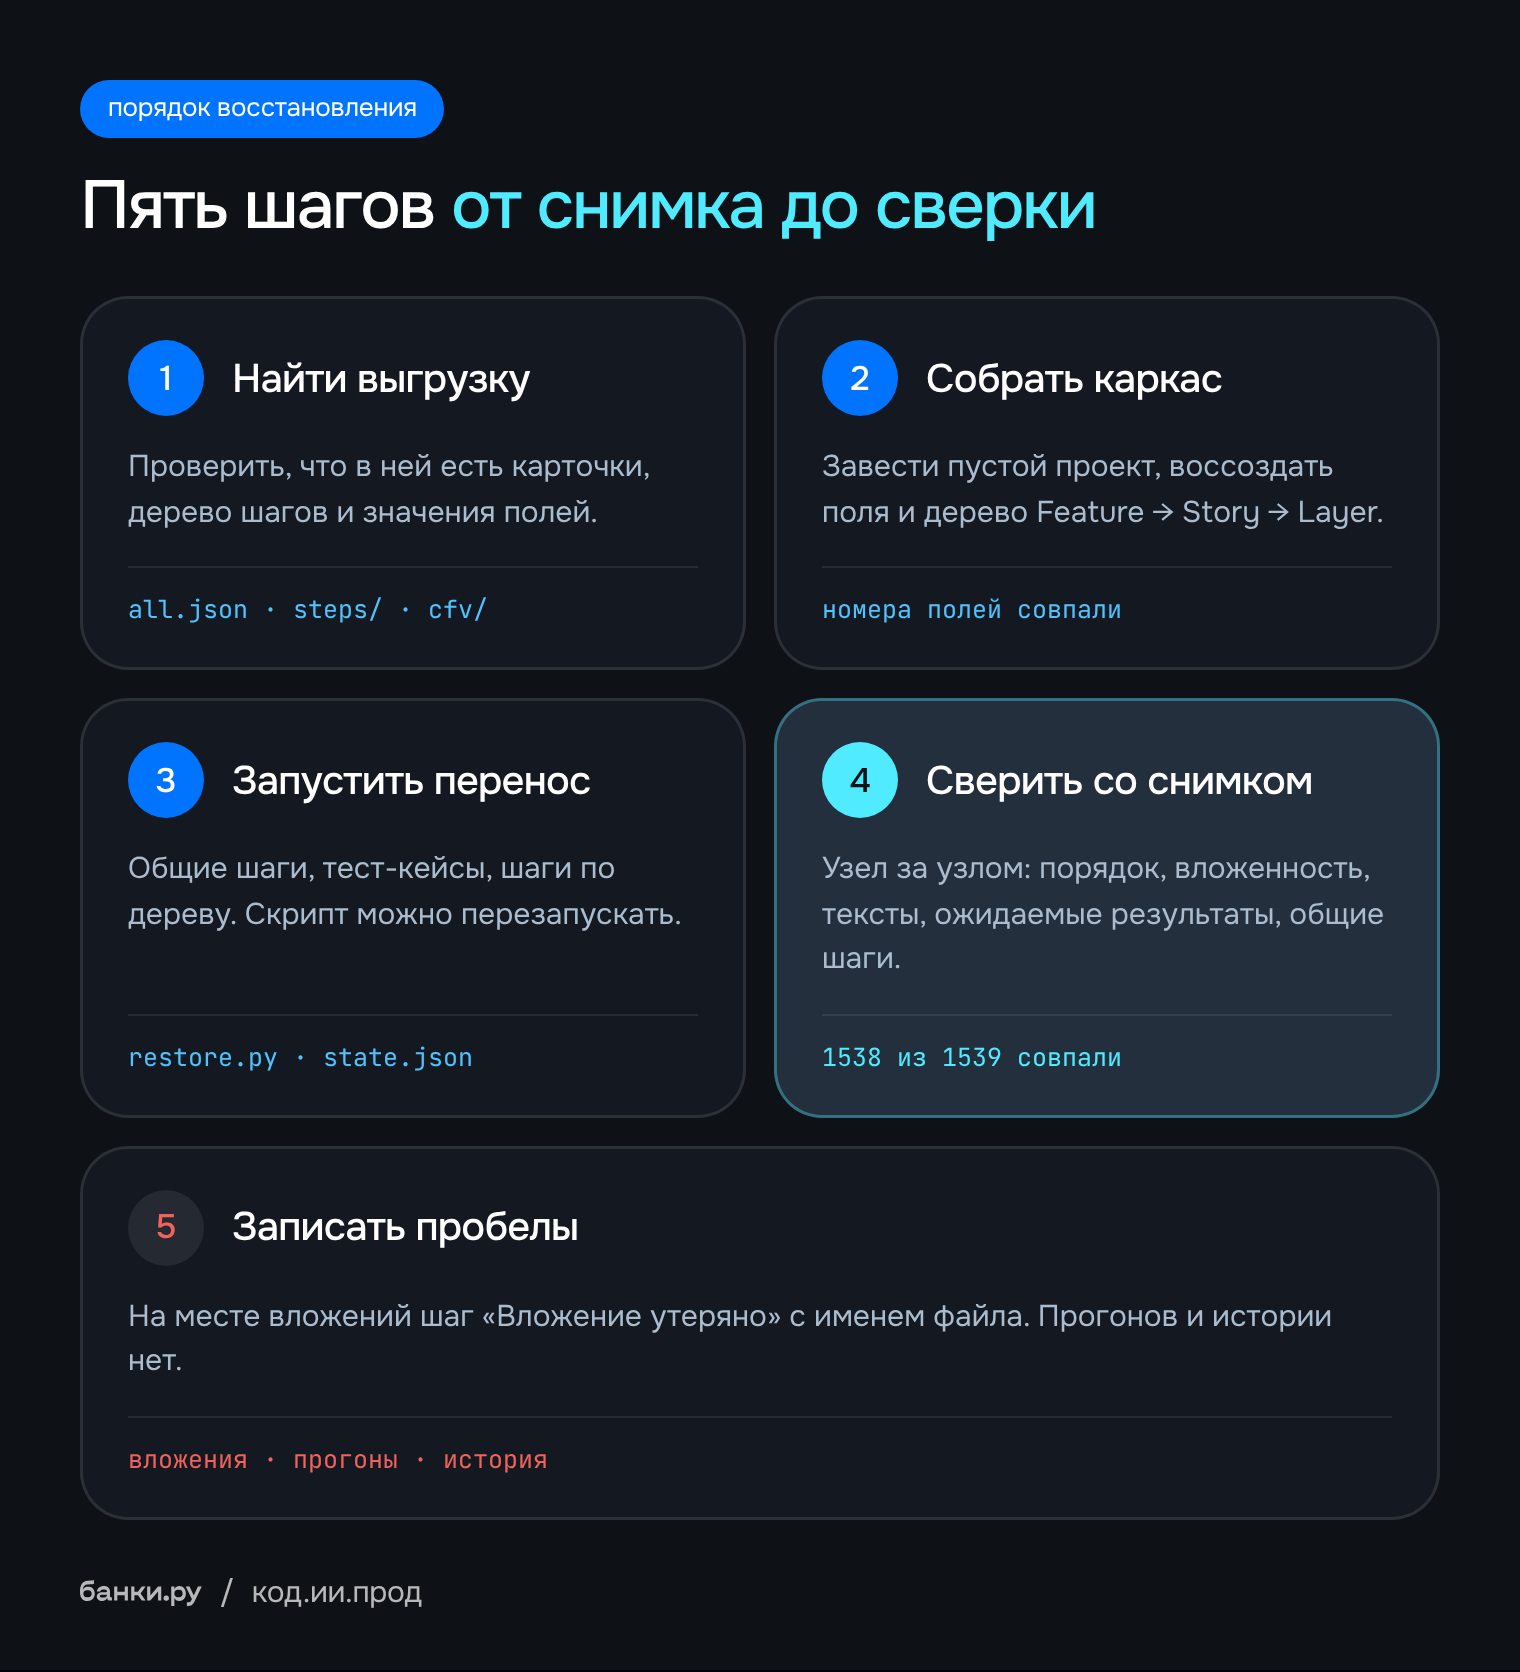
В тот же день мы завели пустой проект на другом сервере Allure и воссоздали каркас. Дерево осталось прежним: Feature → Story → Layer, по нему Allure группирует тест-кейсы. Поля: Feature, Story, Layer, Epic, Feature1, Feature2, Method. Номера совпали со старыми. Системные Epic (−1), Feature (−2) и Story (−3) одинаковы на любом сервере. Пользовательские Layer (16), Method (14), Feature1 (2) и Feature2 (3) на новом сервере тоже получили прежние номера. Поэтому значения из cfv/<id>.json ложились без пересчёта. Если у вас номера разойдутся, понадобится таблица соответствия полей.
Allure принимает команды от программ через REST API (документация). На старом сервере поиск жил по адресу /api/rs/testcase/__search, на новом он /api/testcase/__search, остальные ручки на обоих под /api/.
Скрипт restore.py прочитал выгрузку и создал в новом проекте общие шаги (POST /api/sharedstep), тест-кейсы (POST /api/testcase) и шаги по дереву (POST /api/testcase/step). Общий шаг создаётся один раз, когда на него впервые ссылается тест-кейс. Скрипт можно перезапускать. Соответствие старых и новых номеров тест-кейсов он хранит в файле state.json, а недоделанный при обрыве тест-кейс удаляет и создаёт заново. Ссылки на старые тест-кейсы внутри шагов и описаний заменил второй скрипт по таблице соответствия mapping.csv.
Сверка со снимком шла узел за узлом: порядок и вложенность шагов, тексты, разметка, ожидаемые результаты, общие шаги. Совпали 1538 тест-кейсов из 1539. В последнем нашлись два лишних шага из моей правки от 5 октября: она сделана после снимка. Ещё семь тест-кейсов, созданных после выгрузки, мы собрали из рабочих файлов задач, поэтому в новом проекте их 1546.
Ядро скрипта переноса
Сначала нужен помощник api(): он меняет токен на короткоживущий Bearer через /api/uaa/oauth/token и повторяет запрос, если сервер ответил 502–504.
import os, time, requests

BASE = 'https://allure.example.com'      # адрес вашего Allure
S = requests.Session()
tok = requests.post(BASE + '/api/uaa/oauth/token', data={
    'grant_type': 'apitoken', 'scope': 'openid', 'token': os.environ['ALLURE_TOKEN']}).json()['access_token']
S.headers['Authorization'] = 'Bearer ' + tok


def api(method, path, body=None, **params):
    for attempt in range(4):
        r = S.request(method, BASE + path, json=body, params=params or None, timeout=90)
        if r.status_code in (502, 503, 504):
            time.sleep(5 * (attempt + 1))
            continue
        break
    r.raise_for_status()
    return r.json() if r.text else None
Теперь шаг. Он создаётся одним запросом. Если у шага есть разметка, отправляется только bodyJson: вместе с body Allure отвечает 400 step.onlyonedetail. Если сервер не принял разметку, restore.py повторяет запрос с простым текстом body; в сокращённом примере ниже этой ветки нет.
def add_step(owner_key, owner_id, body=None, body_json=None, parent=None, shared_step=None, with_er=False):
    dto = {owner_key: owner_id}              # testCaseId или sharedStepId
    if parent is not None:
        dto['parentId'] = parent
    if shared_step is not None:
        dto['sharedStepId'] = shared_step
    if body_json:
        dto['bodyJson'] = body_json
    elif body is not None:
        dto['body'] = body
    path = '/api/testcase/step' if owner_key == 'testCaseId' else '/api/sharedstep/step'
    params = {'withExpectedResult': 'true'} if with_er else {}
    r = api('POST', path, dto, **params)
    return r['createdStepId']
Дерево шагов копируется рекурсивно: у каждого шага берутся дочерние шаги и ожидаемый результат. Шаг-вложение заменяется шагом «Вложение утеряно» с именем файла, а соответствие старого вложения и шага-заглушки записывается в state.json. Полный код с проверками лежит в репозитории.
Чего не оказалось в собранной копии
Этого не было в выгрузке от 2 октября, поэтому оно не попало в собранный проект. Итоги и потери на рисунке, подробности в таблице.
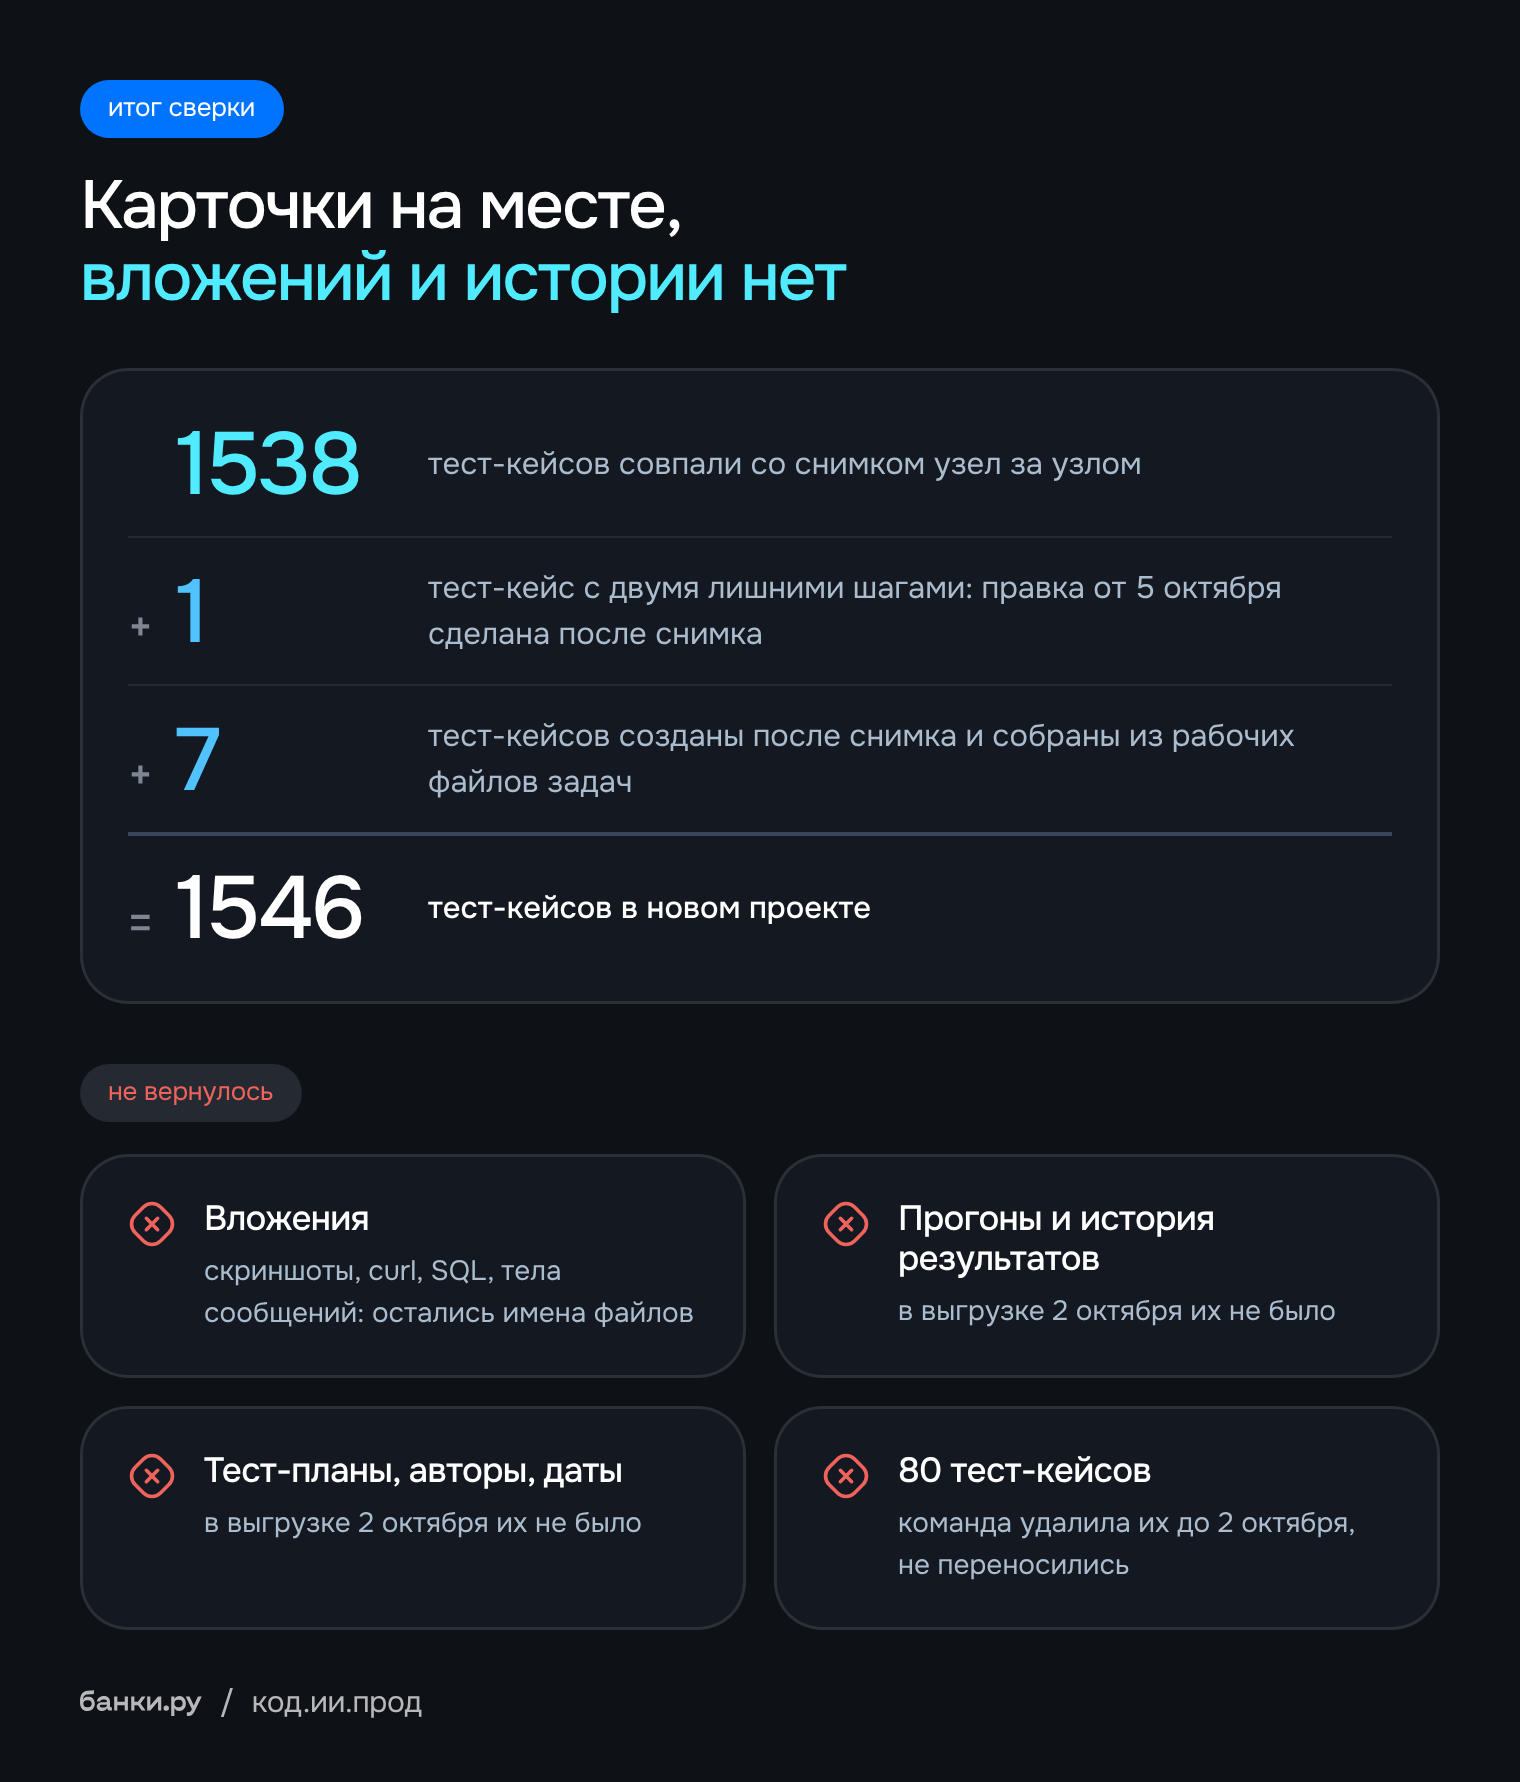
Что | Что с ним |
|---|---|
Вложения: скриншоты, curl-запросы, SQL, тела сообщений | Ручка |
Прогоны, история результатов, тест-планы, авторы, даты создания | В выгрузке их не было |
80 тест-кейсов | Упомянуты в вики, но в выгрузке отсутствуют: команда удалила их до 2 октября. Не переносились |
Что было дальше
Ждать мы не могли: к 20 октября исходный адрес всё ещё не отвечал, а работа над задачами шла. Команда работала с тест-кейсами в собранной копии.
Как мы страхуемся сейчас
Хранилище тест-кейсов копируют так же, как остальные рабочие данные: в нём накоплено много рабочего времени команды.
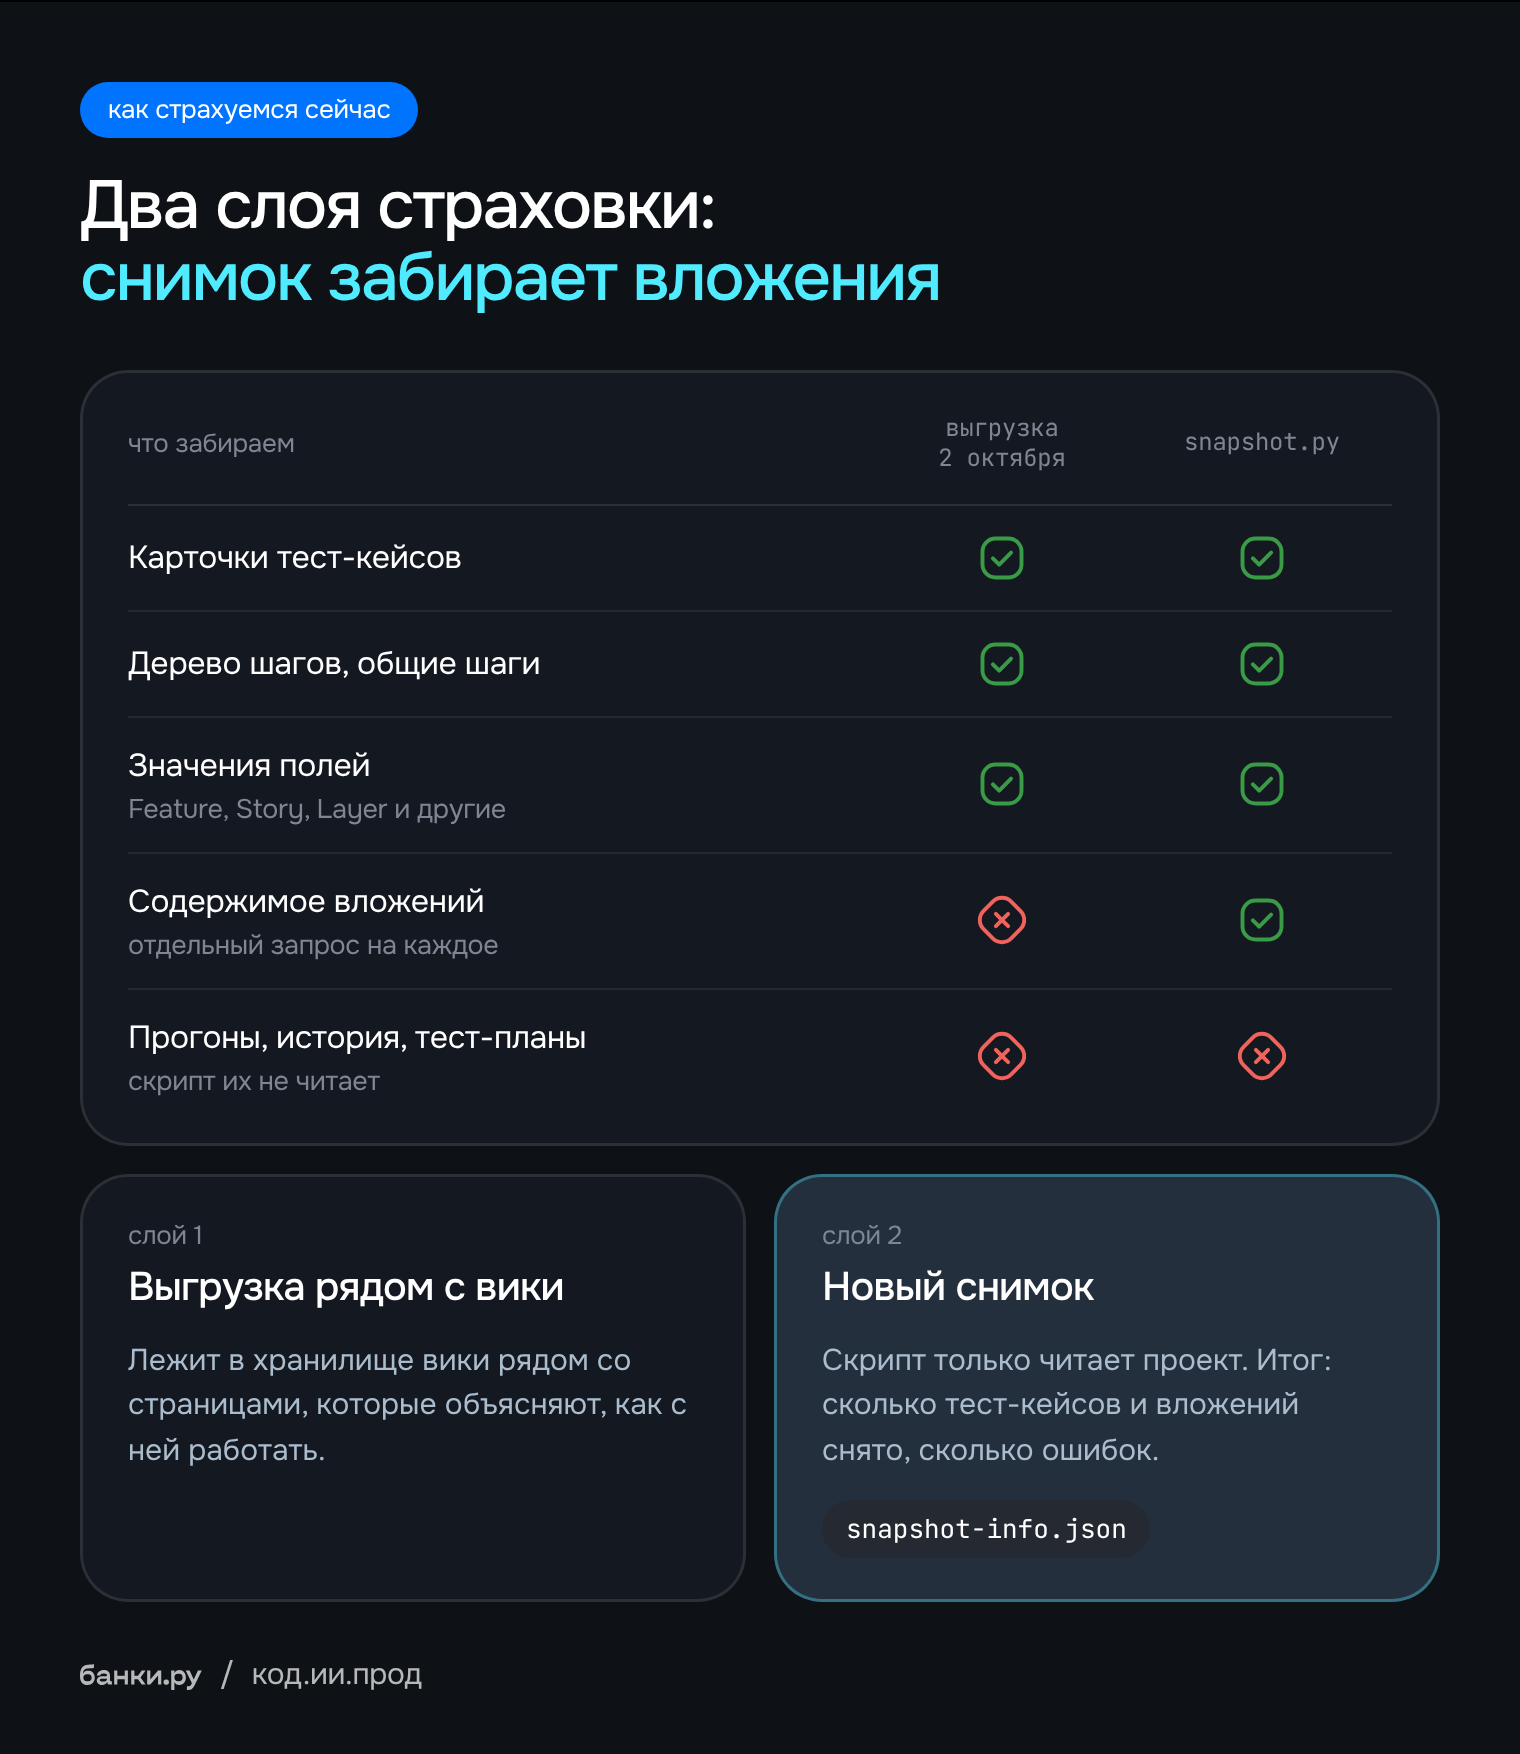
Теперь у нас два слоя. Выгрузка проекта лежит в хранилище вики рядом со страницами, которые объясняют, как с ней работать. Для нового снимка есть скрипт snapshot.py. Он только читает проект: забирает карточки, шаги и значения полей, а содержимое вложений, в отличие от первой выгрузки, скачивает отдельными запросами. В конце он пишет snapshot-info.json: сколько тест-кейсов и вложений снято и сколько запросов закончилось ошибкой, так что расхождение видно сразу. Прогонов, истории результатов и тест-планов нет и в новом снимке: скрипт их не читает.
С чего начать
Рабочие чаты с агентом лежат у сервиса, и знания из них тоже можно потерять.
1. Не оставляйте знания только в чате. Чат с агентом похож на доску в переговорке: всё важное нужно сфотографировать, пока её не стёрли. В конце рабочей сессии отправьте агенту промпт: «Сделай выгрузку всех ключевых материалов, архитектурных решений, промптов и наработок из нашего диалога в единый итоговый Markdown-документ, оформленный так, чтобы его можно было без потери контекста импортировать в другой инструмент для работы с агентами». Файл сохраните в Obsidian, Notion или репозитории проекта.
2. Заведите минимальную структуру вики. Нужны папка sources/ для сырья, папка wiki/ для страниц, файл index.md как оглавление, файл log.md как журнал и правила для агента. Граф и связи дорастут по ходу работы.
3. Выгружайте данные своих систем в читаемый формат. У меня это тест-кейсы из Allure через API. Скрипт snapshot.py забирает карточки, шаги, значения полей и вложения и ничего не меняет в проекте:
ALLURE_URL=https://allure.example.com ALLURE_TOKEN=<токен> ALLURE_PROJECT=<id> python snapshot.py
Токен создаётся в профиле пользователя, скрипт сам меняет его на короткоживущий Bearer. Шаги каждого тест-кейса он запрашивает отдельно и в несколько потоков: у меня полторы тысячи запросов заняли около минуты. Вложения скачиваются тоже: ручка /step отдаёт только их имена, содержимое запрашивается отдельно.
Оба скрипта лежат в репозитории: snapshot.py снимает проект, restore.py восстанавливает тест-кейсы из снимка. Восстанавливайте только в пустой тестовый проект и сначала на нескольких тест-кейсах.
Команда дана для bash. В Windows PowerShell переменные задаются так: $env:ALLURE_URL = '...'.
4. Возьмите готовый скилл с правилами для агента и командами /wiki-* из открытого репозитория. Команды записывают находки, ищут по вики и проверяют её на битые ссылки и дубли.
Как подключить Claude к Obsidian
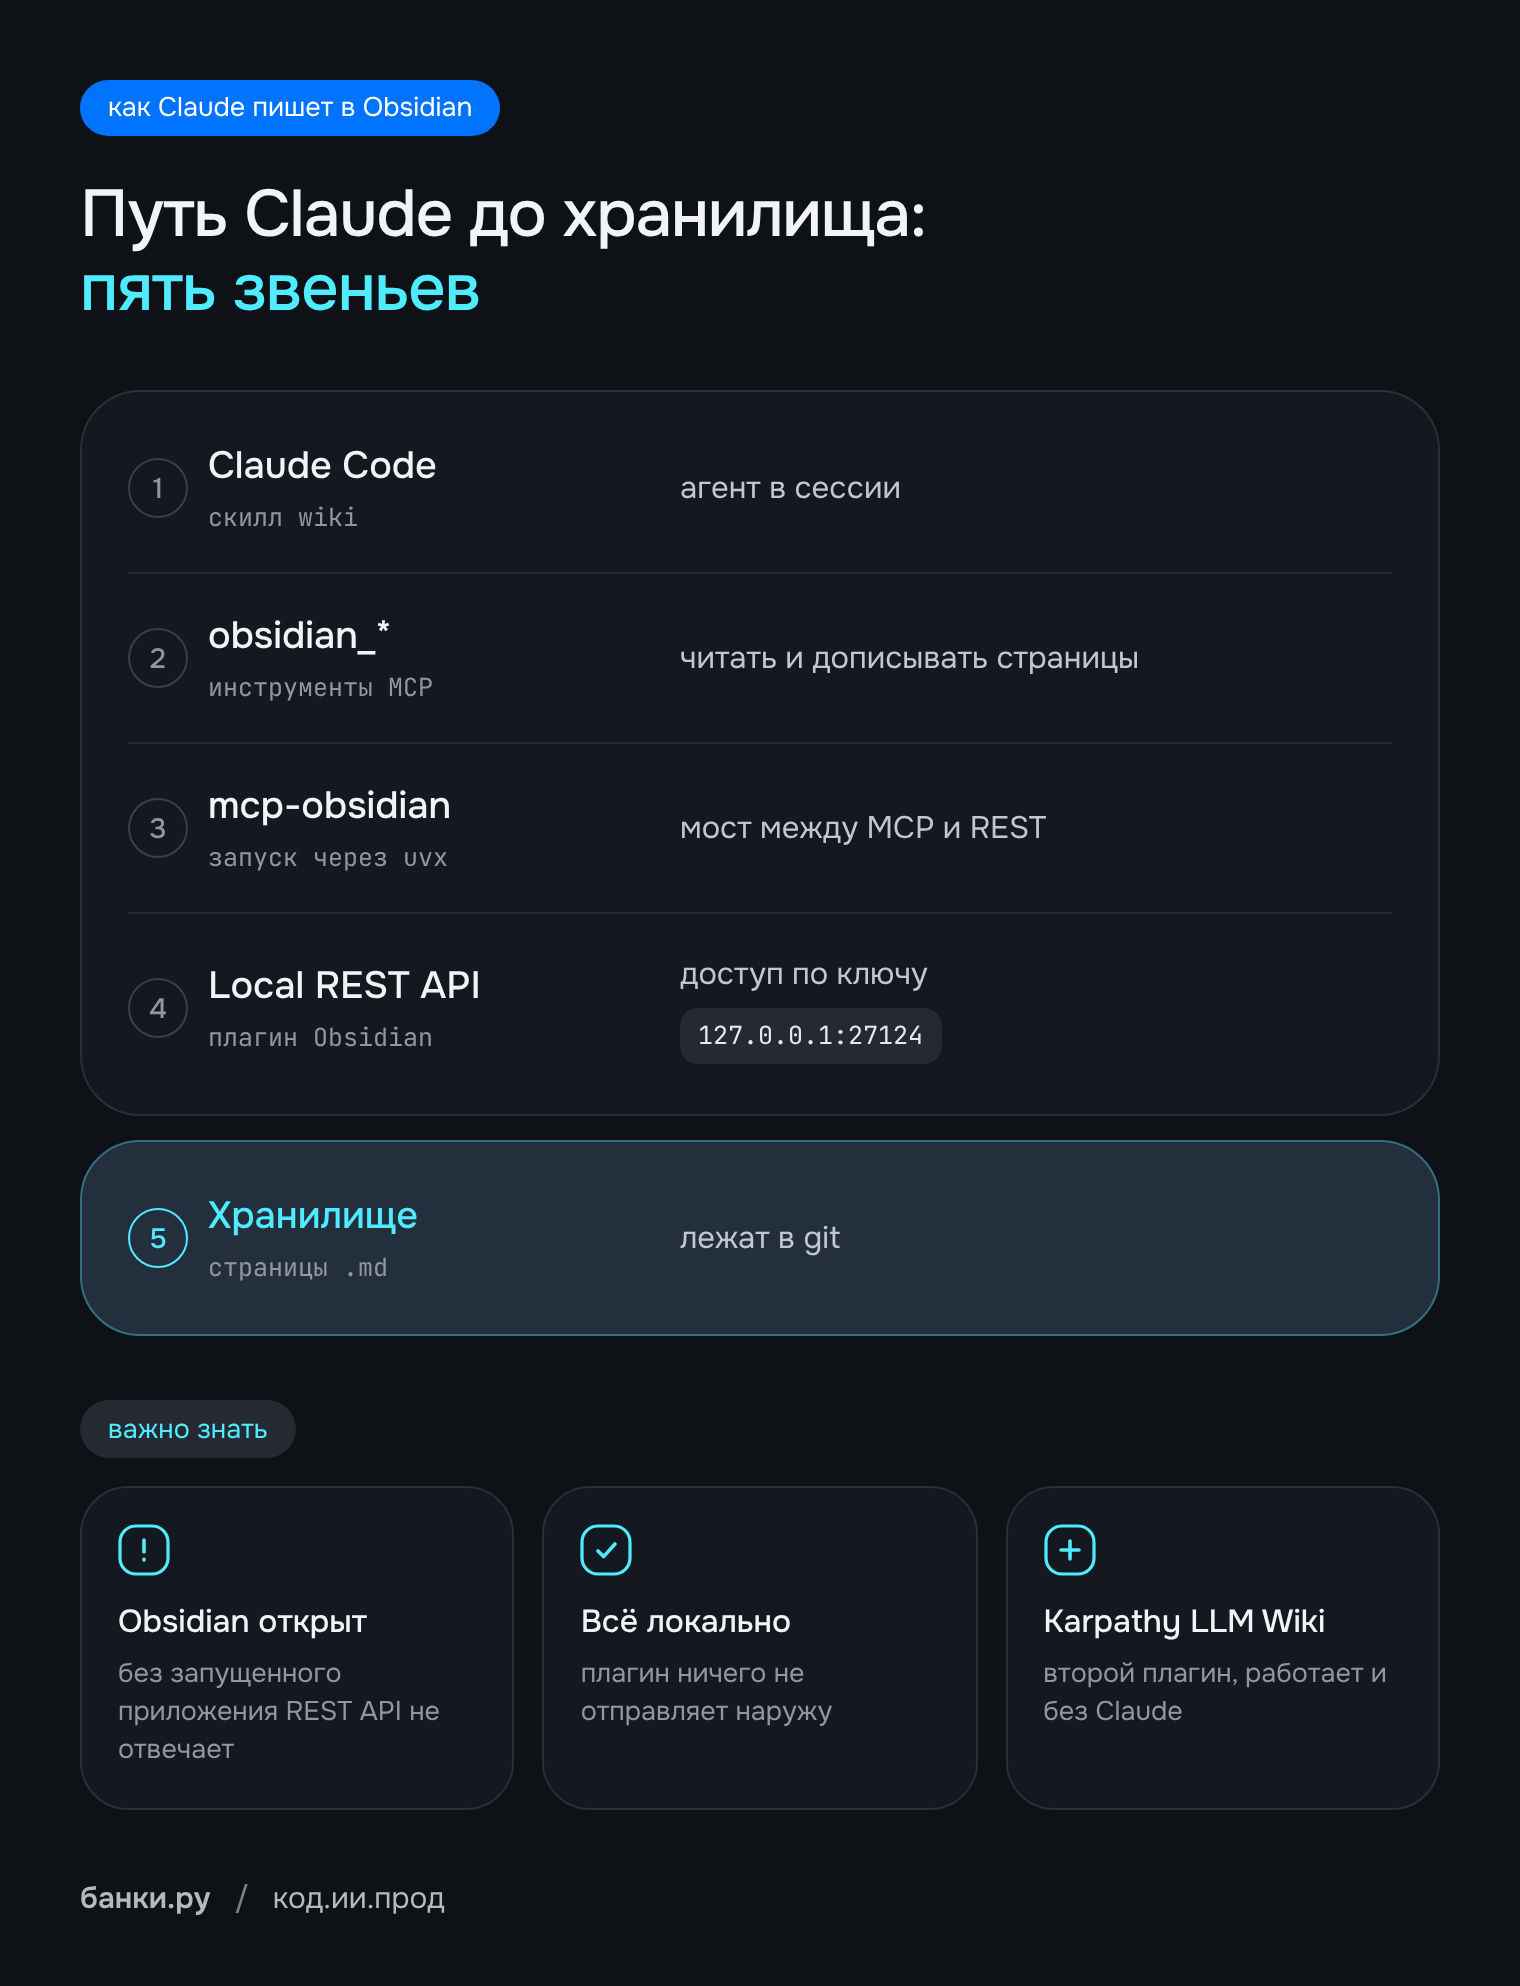
Поставьте в Obsidian плагин Local REST API with MCP (Settings → Community plugins). Он поднимает локальный REST API и MCP-сервер, наружу ничего не отправляет, но Obsidian должен быть открыт: иначе агент получит connection refused. Скопируйте ключ плагина и выполните:
claude mcp add obsidian -s user \
  -e OBSIDIAN_API_KEY=<ключ> -e OBSIDIAN_HOST=127.0.0.1 -e OBSIDIAN_PORT=27124 \
  -- uvx --with 'mcp<2.0.0' mcp-obsidian
Порт 27124 — HTTPS-порт плагина с самоподписанным сертификатом. Версию библиотеки mcp держите ниже 2.0.0, иначе переходник ломается. Статус Connected в claude mcp list зелёный и при неверном ключе, поэтому проверяйте подключение настоящим запросом к хранилищу. В PowerShell команду claude mcp add пишите в одну строку, без \.
Второй плагин, Karpathy LLM Wiki, ведёт index.md и log.md внутри Obsidian и работает и без Claude.
Что в итоге
Вики не заменяет бэкап: выгрузка дала данные, вики объяснила, как с ними обращаться. Из них мы за два дня собрали проект, в котором команда продолжила работу.
А как вы храните копию тест-кейсов вне TMS: выгрузки, экспорт, что-то ещё? Поделитесь в комментариях, интересно собрать варианты. Спасибо, что прочитали!

