При выборе встраиваемой платформы даташитов мало. Многое не разглядеть даже между строк: частота и ширина шины там есть, а как поведёт себя связка процессора, нейропроцессора и внешней памяти под реальной нагрузкой - нет.
Раньше такое знание добывалось долгими экспериментами и нередко заканчивалось отказом от части намеченных целей и лишними схемотехническими решениями.
Сегодня такой набор тестов создаётся молниеносно. Я прогнал на шести отладочных платах Renesas, ST и NXP, с нейропроцессорами и без.
Насколько чтение внешней flash медленнее SDRAM? Что быстрее: 16-битная PSRAM или 32-битная SDRAM? Так ли необходим нейропроцессор?
Спойлер: два ответа из трёх оказались не такими, как я ожидал.
Нейропроцессоры добрались до микроконтроллеров. Производители заявляют десятки гигаопераций в секунду (GOPS) и сотни MAC за такт, и кажется, что осталось выбрать, у кого цифра больше. Я выбирал микроконтроллер с NPU для нового модуля и запустил один и тот же набор тестов на шести отладочных платах Renesas, ST и NXP. Выяснилось, что сами нейропроцессоры на одинаковых моделях почти равны, а скорость вывода в реальной задаче отличается вдвое, и решает её контроллер внешней памяти, а не NPU, не процессор и не частота flash.
Ниже собраны цифры чтения внешней flash и RAM, исполнения кода из неё, результаты CoreMark, сравнение Ethos-U55 в RA8P1 и Neural-ART в STM32N657 на одних и тех же сетях, во сколько раз медленнее те же сети на Cortex-M7 без нейропроцессора и что происходит, когда NPU и процессор делят одну flash.
Задача
Требуется найти аппаратную платформу для универсального модуля интернета вещей. И не хочется быть связанным архитектурой готовых модулей: разрабатывая свой модуль, можно самому выбрать микроконтроллер, тип и объём внешней памяти, ширину шин и схему питания. Но чтобы спроектировать такую платформу без слепого копирования чужих решений, нужно заранее понять, как связка процессора, NPU и внешней памяти ведёт себя под реальной нагрузкой.
От будущей платформы требуются:
нейропроцессор для локального запуска моделей;
внешняя Octal flash под программу и веса нейросетей с расшифровкой на лету, чтобы прошивку нельзя было просто считать;
внешняя RAM под буферы и рабочие данные;
промышленный диапазон от −40 до +105 °C и разумная стоимость компонентов.
Кандидатов с NPU два: Renesas RA8P1 (Cortex-M85 1 ГГц + Cortex-M33, Ethos-U55 на 256 MAC) и ST STM32N657 (Cortex-M55 800 МГц, Neural-ART 1 ГГц). Вместе с ними я провёл тесты ещё на четырёх платах без NPU, но с другими контроллерами внешней памяти и разной шириной шин, чтобы сравнить результаты CoreMark на разных ядрах, работу QSPI и Octal flash, а также 16- и 32-битную SDRAM и PSRAM.
Вопросы, на которые должны были ответить замеры:
Насколько медленнее программа и веса нейросети работают из внешней flash по сравнению с внутренней памятью?
Можно ли поставить PSRAM вместо SDRAM? PSRAM дешевле, экономичнее и занимает в 2–4 раза меньше выводов микроконтроллера.
Нужна ли flash на 166–200 МГц или хватит 133 МГц?
Какие результаты в CoreMark показывают сами процессорные ядра при работе из разных типов памяти и как на них влияют настройки компилятора?
Чей нейропроцессор быстрее на одинаковых моделях?
Как NPU и процессор уживаются на одной внешней flash?
Насколько нейропроцессор вообще необходим и что будет с теми же сетями на обычном процессоре?
Стенд
Плата | Микроконтроллер | NPU | Внешняя flash | Внешняя RAM |
|---|---|---|---|---|
EK-RA8P1 | RA8P1, Cortex-M85 1 ГГц | Ethos-U55, 500 МГц | Macronix MX25LW51245G, 64 МБ, Octal | SDRAM 32 бит, 64 МБ |
EK-RA8M1 | RA8M1, Cortex-M85 480 МГц | нет | Infineon S28HL512T, 64 МБ, Octal | нет |
STM32N6570-DK | STM32N657, Cortex-M55 800 МГц | Neural-ART, 1 ГГц | Macronix MX66UW1G45G, 128 МБ, Octal | PSRAM x16, 32 МБ |
MIMXRT1170-EVK | i.MX RT1176, Cortex-M7 996 МГц | нет | ISSI IS25WP128, 16 МБ, QSPI | SDRAM 32 бит |
MIMXRT1064-EVK | i.MX RT1064, Cortex-M7 600 МГц | нет | ISSI IS25WP064A, 8 МБ, QSPI; Winbond W25Q32JV в корпусе | SDRAM 16 бит |
STM32H747I-DISCO | STM32H747, Cortex-M7 400 МГц | нет | 2 × Micron MT25QL512, QSPI в 8 линий | SDRAM 32 бит |
Подробнее о каждой плате.
«Предел шины» означает, сколько байт в секунду физически проходит по линиям данных памяти на рабочей частоте; с ним сравниваются замеры ниже.
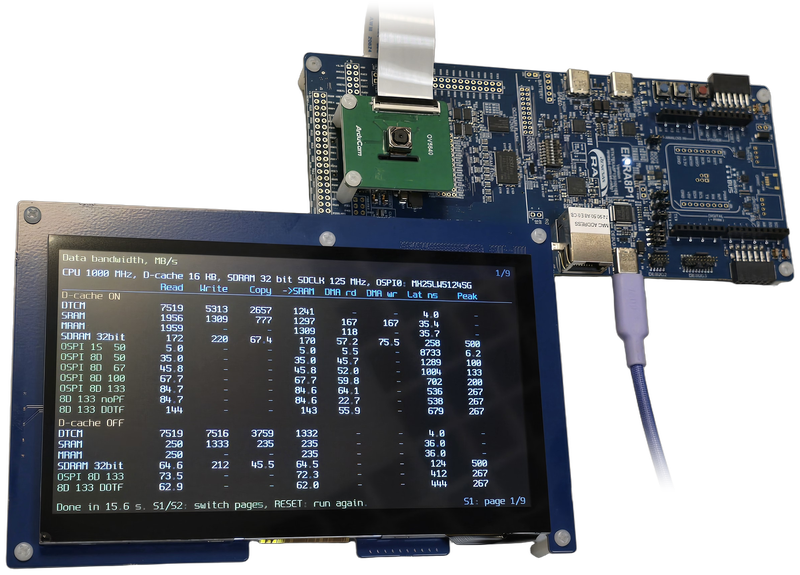
EK-RA8P1 (Renesas RA8P1)
Процессор: Cortex-M85, 1 ГГц, плюс второе ядро Cortex-M33.
Нейропроцессор: Arm Ethos-U55, 256 MAC, 500 МГц.
Внутренняя память: кэши команд и данных по 16 КБ; ITCM и DTCM по 128 КБ; SRAM 1,8 МБ; MRAM 1 МБ (энергонезависимая память вместо обычной flash, читается так же быстро, как SRAM).
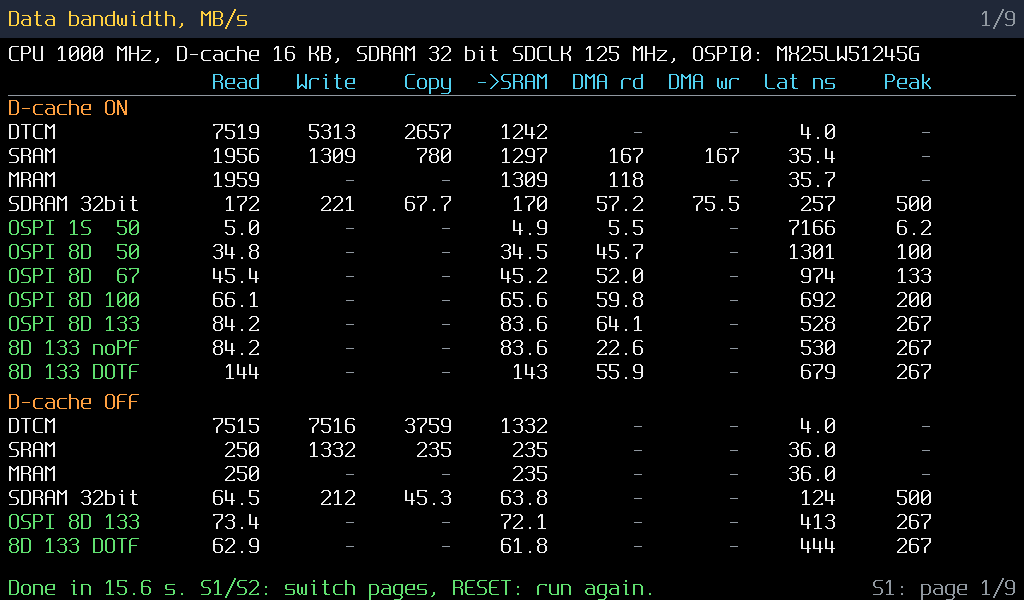
Внешняя flash: Macronix MX25LW51245G, 64 МБ, Octal (8 линий данных, DDR) до 133 МГц, контроллер OSPI с расшифровкой на лету (DOTF). Предел шины: 267 МБ/с.
Внешняя RAM: SDRAM ISSI IS42S32160F, 64 МБ, шина 32 бит, 125 МГц. Предел шины: 500 МБ/с.
На плате ещё: дисплей 1024 × 600, камера.
STM32N6570-DK (ST STM32N657)
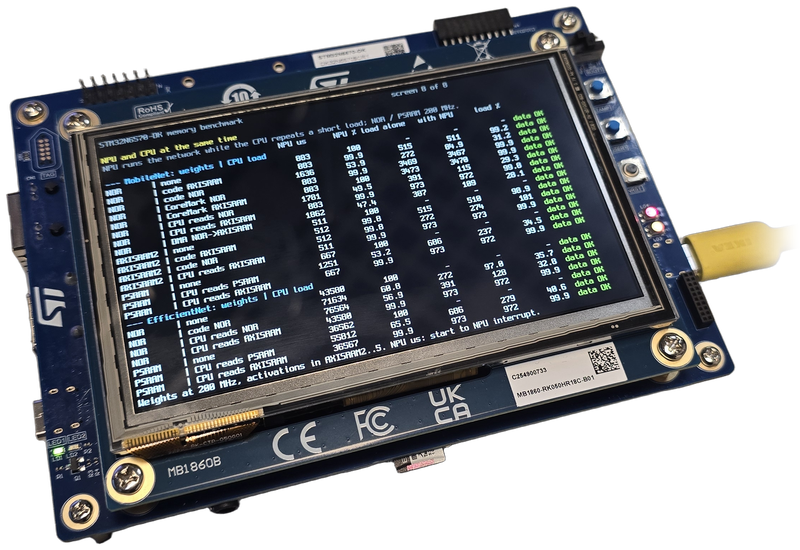
Процессор: Cortex-M55, 800 МГц.
Нейропроцессор: ST Neural-ART, 1 ГГц, со своим кэшем для чтения внешней памяти.
Внутренняя память: кэши команд и данных по 32 КБ; ITCM 64 КБ и DTCM 128 КБ с ECC; AXISRAM1 и AXISRAM2 по 1 МБ; AXISRAM3–6 по 448 КБ под нейропроцессор. Встроенной flash нет, программа загружается из внешней.
Внешняя flash: Macronix MX66UW1G45G, 128 МБ, Octal DDR до 200 МГц, контроллер XSPI2. Предел шины: 400 МБ/с.
Внешняя RAM: PSRAM AP Memory APS256XX, 32 МБ, 16 линий данных, DDR, 200 МГц, контроллер XSPI1. Предел шины: 800 МБ/с.
На плате ещё: дисплей 5", 800 × 480.
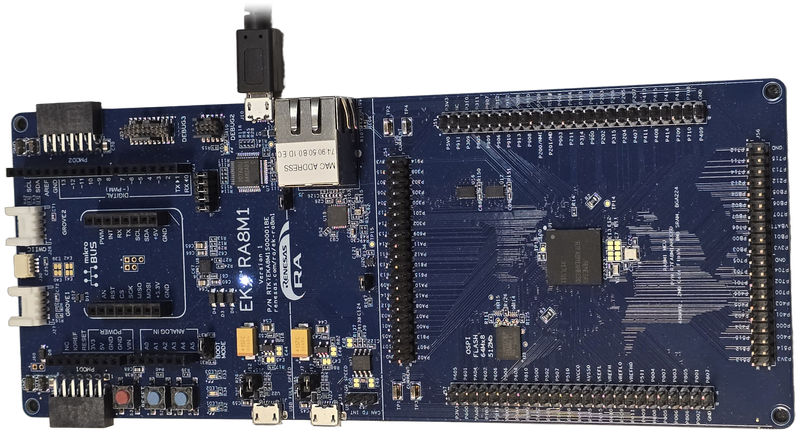
EK-RA8M1 (Renesas RA8M1)
Тот же контроллер OSPI, что у RA8P1, и flash Infineon, которую я сначала заложил в модуль.
Процессор: Cortex-M85 ревизии r0p2, 480 МГц.
Нейропроцессор: нет.
Внутренняя память: кэши команд и данных по 16 КБ; ITCM и DTCM по 64 КБ; SRAM 896 КБ; flash 2 МБ.
Внешняя flash: Infineon S28HL512T, 64 МБ, Octal DDR, по документации до 166 МГц. Контроллер OSPI у RA8M1 тактирует шину не выше 100 МГц, надёжно на этой плате работает на 80 МГц. Предел шины на 80 МГц: 160 МБ/с.
Внешняя RAM: нет.
На плате ещё: дисплея нет, результаты выводятся через J-Link RTT.
MIMXRT1170-EVK (NXP i.MX RT1176)
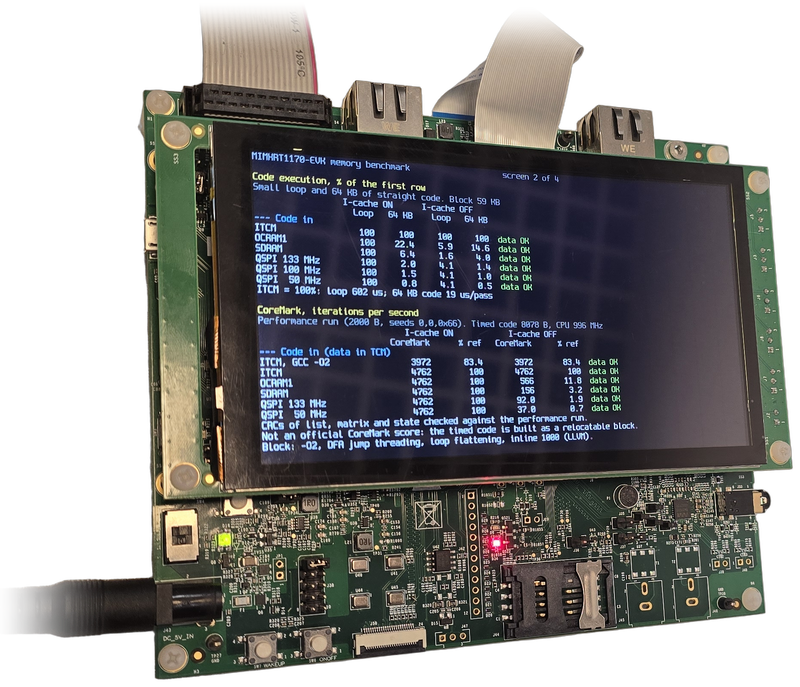
Контроллер FlexSPI для flash и SEMC для SDRAM.
Процессор: Cortex-M7, 996 МГц, плюс Cortex-M4.
Нейропроцессор: нет.
Внутренняя память: кэши команд и данных по 32 КБ; ITCM и DTCM по 256 КБ; OCRAM 2 × 512 КБ. Встроенной flash нет.
Внешняя flash: ISSI IS25WP128, 16 МБ, QSPI (4 линии, SDR), 133 МГц, контроллер FlexSPI. Предел шины: 66,5 МБ/с.
Внешняя RAM: SDRAM 64 МБ, шина 32 бит, 198 МГц, контроллер SEMC. Предел шины: 792 МБ/с.
На плате ещё: дисплей 720 × 1280 по MIPI DSI.
MIMXRT1064-EVK (NXP i.MX RT1064)
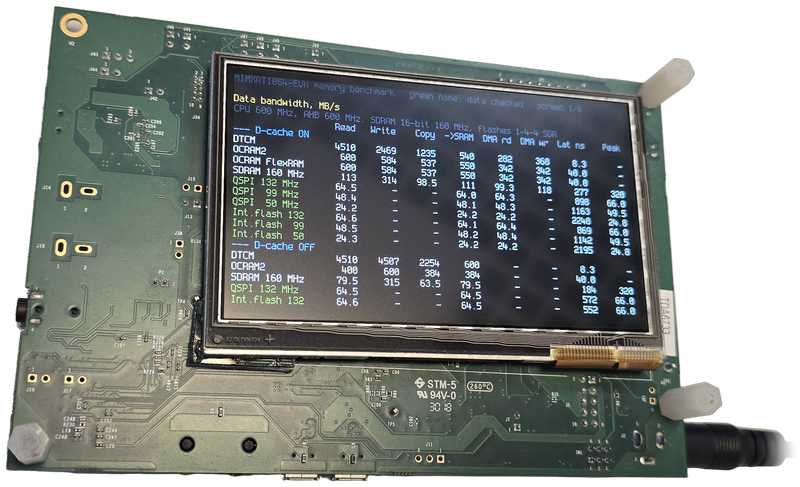
Младший i.MX RT, у которого flash стоит прямо в корпусе микроконтроллера.
Процессор: Cortex-M7, 600 МГц.
Нейропроцессор: нет.
Внутренняя память: кэши команд и данных по 32 КБ; FlexRAM 512 КБ, на этой плате поделена на ITCM 128 КБ, DTCM 128 КБ и OCRAM 256 КБ; OCRAM2 512 КБ.
Flash в корпусе: Winbond W25Q32JV, 4 МБ, QSPI на втором контроллере FlexSPI. Это обычная микросхема NOR flash внутри корпуса, и читается она как внешняя.
Внешняя flash: ISSI IS25WP064A, 8 МБ, QSPI (4 линии, SDR), 132 МГц, FlexSPI. Предел шины: 66 МБ/с.
Внешняя RAM: SDRAM ISSI IS42S16160J, 32 МБ, шина 16 бит, 160 МГц, SEMC. Предел шины: 320 МБ/с.
На плате ещё: дисплей 4,3", 480 × 272.
STM32H747I-DISCO (ST STM32H747)
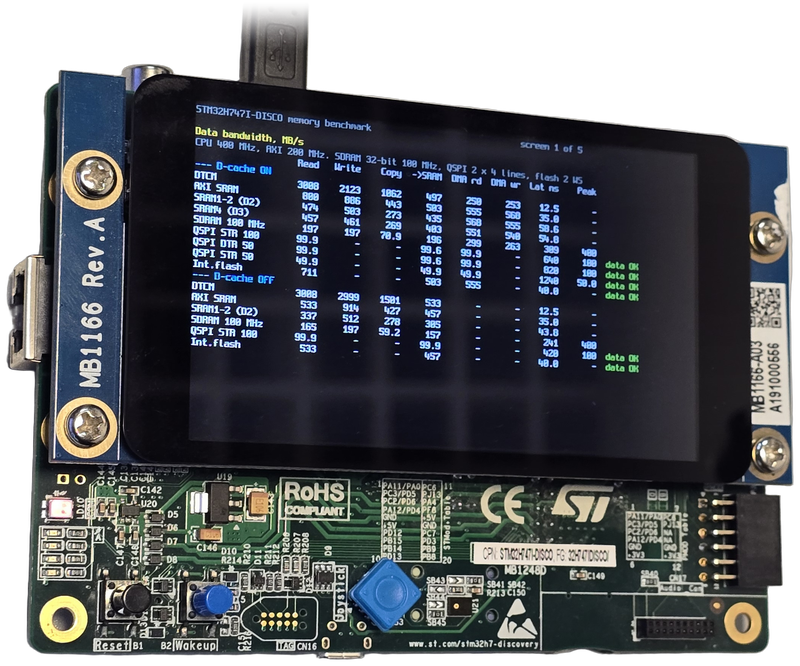
Опорная точка: проверенный STM32H7 с быстрой встроенной flash.
Процессор: Cortex-M7, 400 МГц (на этой плате ядро питается от SMPS, и 480 МГц недоступны), плюс Cortex-M4.
Нейропроцессор: нет.
Внутренняя память: кэши команд и данных по 16 КБ; ITCM 64 КБ, DTCM 128 КБ; AXI SRAM 512 КБ, SRAM1–3 288 КБ, SRAM4 64 КБ; flash 2 МБ в двух банках.
Внешняя flash: две Micron MT25QL512, 2 × 64 МБ, включены параллельно как одна QSPI на 8 линий, 100 МГц. Предел шины: 100 МБ/с.
Внешняя RAM: SDRAM ISSI IS42S32800J, 32 МБ, шина 32 бит, 100 МГц, контроллер FMC. Предел шины: 400 МБ/с.
На плате ещё: дисплей 4", 800 × 480 по MIPI DSI.
Методика измерений
На всех платах использовался один набор тестов. Для RA8 он написан на FSP в e2 studio, для ST и NXP вынесен в переносимое ядро на C, не зависящее от библиотек производителя: плата добавляет только список областей памяти, DMA и функции записи flash. Сборка ST и NXP выполнена через CMake и GCC 13.3, время замерялось по счётчику тактов DWT.
Что измерялось:
Данные: чтение, запись, копирование, DMA, задержка случайного чтения для каждой области памяти, с кэшем данных и без.
Код: 64 КБ линейного кода, который не помещается в кэш команд, и CoreMark, который помещается. Оба теста запускаются из каждого типа памяти, с кэшем команд и без. CoreMark собран в перемещаемый блок одним компилятором (LLVM) с одними и теми же ключами под каждое ядро, поэтому разница между платами определяется процессором и памятью, а не компилятором.
Flash: программирование 64 КБ, стирание, время обновления 2 МБ прошивки.
Нейропроцессор: время вывода сети с весами и рабочей областью в разных типах памяти.
Помехи: NPU или DMA работают, процессор в это время исполняет код или читает память. Сколько теряет каждая сторона.
microSD: запись и чтение порциями от 512 байт до 1 МБ.
Результаты выводятся на дисплей платы и в RTT или UART. МБ/с здесь равны 10⁶ байт в секунду.
Внешняя flash: всё решает контроллер
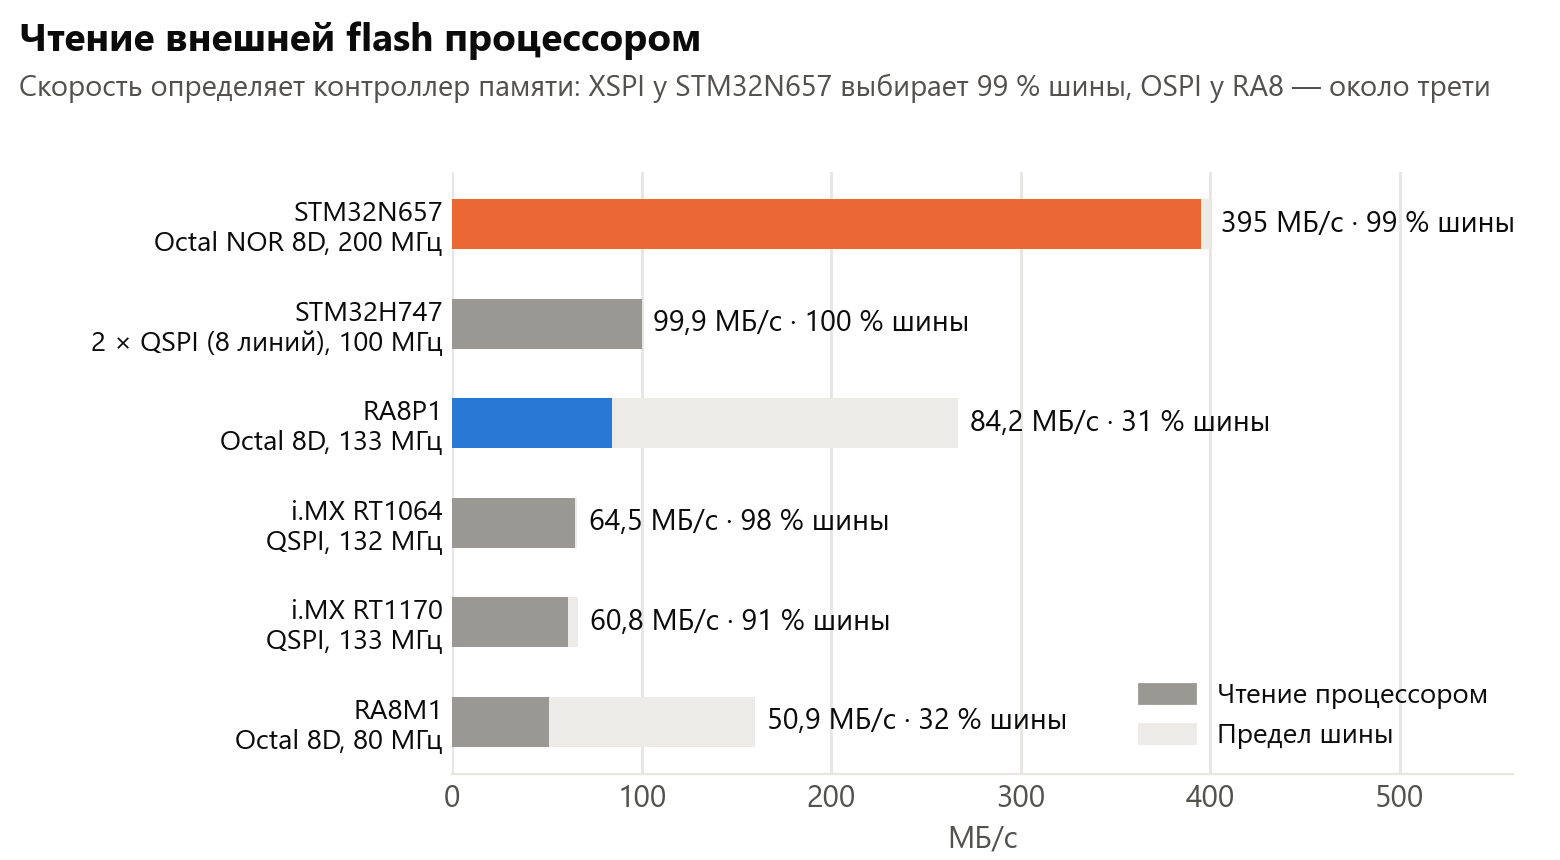
Главный результат всей работы виден на этом графике. Скорость чтения внешней flash определяется контроллером в микроконтроллере, а не микросхемой памяти и не её частотой.
STM32N657 читает Octal NOR на 200 МГц со скоростью 395 МБ/с (99 % от физического предела шины).
RA8P1 на 133 МГц получает 84 МБ/с (31 % шины). RA8M1 с другой flash показывает те же 32 %, значит, дело в контроллере OSPI, а не в микросхеме.
i.MX RT и STM32H747 используют 91–100 % пропускной способности обычной QSPI. В итоге i.MX RT1064 с дешёвой QSPI на 132 МГц всего на четверть медленнее RA8P1 с восьмипроводной Octal flash.
Почему у RA8P1 так. Каждая строка кэша в 32 байта оформляется как отдельная транзакция: команда, адрес, такты ожидания, данные. На 133 МГц это 373 нс на строку, отсюда 32 / 373 ≈ 86 МБ/с. Аппаратная предвыборка контроллера ничего не меняет.
Подтверждение нашлось случайно. Чтение через блок расшифровки на лету (DOTF) оказалось быстрее обычного: 144 МБ/с против 84. Я не поверил и перепроверил двумя таймерами и с перемещением окна DOTF, всё подтвердилось. DOTF читает из flash сразу 64 байта (две строки кэша), и вторую строку процессор получает из его буфера. Шифрование здесь бесплатное, а последовательное чтение почти вдвое быстрее. Зато случайные обращения через DOTF медленнее: 679 нс против 529 на строку.
Что это значит для выбора частоты flash: для RA8P1 flash на 166 МГц вместо 133 даст, по экстраполяции, около 100 МБ/с вместо 84. Переплачивать за неё смысла мало.
Код из внешней flash
Код, который помещается в кэш команд, работает с полной скоростью откуда угодно: CoreMark из flash на 50 МГц даёт те же 100 % скорости, что из ITCM. Проблемы начинаются, когда горячий код в кэш не помещается. Вот 64 КБ линейного кода:
На RA8P1 такой код из MRAM выполняется на 28,7 % скорости ITCM, из Octal flash на 2,5 %. Отсюда правило: «программа выполняется из внешней flash» годится только для редко исполняемого кода. RTOS, прерывания, драйверы и сетевой стек нужно размещать во внутренней памяти.
Процессор и ключи компилятора проверяем по CoreMark.
Ключи LLVM подбирались под Cortex-M85; для M7 и M55 они не подбирались, но и с ними результат лучше, чем у GCC с -O2.
С ключами проекта e2 studio по умолчанию (-O2 -fno-unroll-loops) RA8P1 даёт 4,45 CoreMark/МГц. Показатель 6,28 (ровно столько, сколько Arm заявляет для M85) получился только с DFA jump threading (+24 %), развёрткой циклов с порогом встраивания 1000 (+11 %) и слиянием вложенных циклов (+2,5 %). Итого +41 % без единой строчки кода. Цена в том, что блок CoreMark вырос с 2,9 до 6,9 КБ, и горячий код надо проверять на то, что он по-прежнему помещается в кэш команд.
По вычислениям RA8P1 в 1,8 раза быстрее STM32N657: 6284 итерации CoreMark в секунду против 3474.
Внешняя RAM: PSRAM против SDRAM
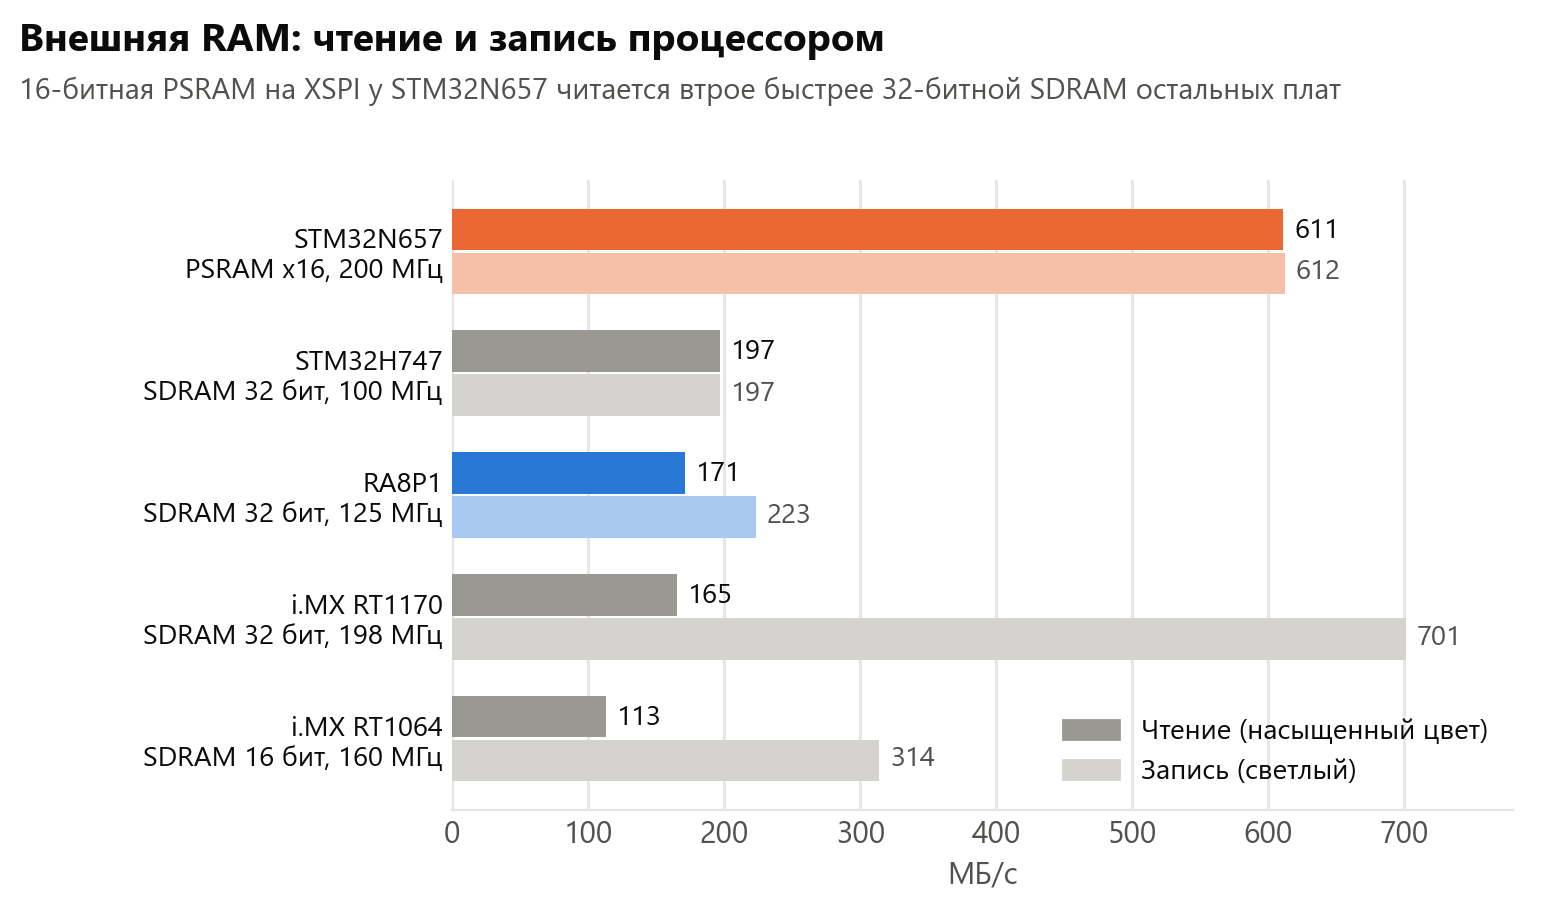
16-битная PSRAM у STM32N657 на 200 МГц даёт 611 МБ/с в обе стороны. Это втрое быстрее 32-битной SDRAM на всех остальных платах, хотя у SDRAM вдвое больше линий данных. Задержка одного чтения у них одинаковая, около 250 нс. Разница в том, какую долю пропускной способности шины использует контроллер: 76 % у XSPI с PSRAM против 34 % у контроллера SDRAM в RA8P1.
При этом PSRAM выигрывает и по всему остальному. Данные по даташитам для Micron MT48LC16M16A2 (SDRAM) и AP Memory APS12808L (Octal PSRAM):
SDRAM, 3,3 В | PSRAM, 1,8 В | |
|---|---|---|
Выводов микроконтроллера | 38–55 | 11–12 (x8), около 20 (x16) |
Непрерывное чтение или запись | ≈ 450 мВт | 43–60 мВт |
Простой | ≈ 130 мВт, пока контроллер не включил power-down | ≈ 0,2 мВт, сразу как снят выбор микросхемы |
Цена для модуля | ≈ $12 с отдельным преобразователем питания | $3–4 |
В работе PSRAM экономичнее в 7–10 раз, в простое в сотни раз. Для модуля с аккумулятором это решающий довод.
Ложка дёгтя: у RA8P1 PSRAM подключается к тому же контроллеру OSPI, что и flash. Если он и с ней будет использовать лишь треть пропускной способности шины, чтение составит около 85–120 МБ/с, то есть медленнее SDRAM. Это оценка: на EK-RA8P1 выводы второго OSPI заняты SDRAM и дисплеем, проверить PSRAM на ней нельзя.
Нейропроцессоры на одинаковых моделях
Сравнивать NPU по чужим моделям бессмысленно, поэтому я взял две int8-модели из примера ST для STM32N6570-DK: MobileNet v1 0.25 (96 × 96) и EfficientNet-V2 B1 (240 × 240, 7–8 МБ весов), и скомпилировал их для Ethos-U55 через Arm Vela. Время замерялось от запуска вывода до прерывания NPU, выход сети на всех вариантах совпадает.
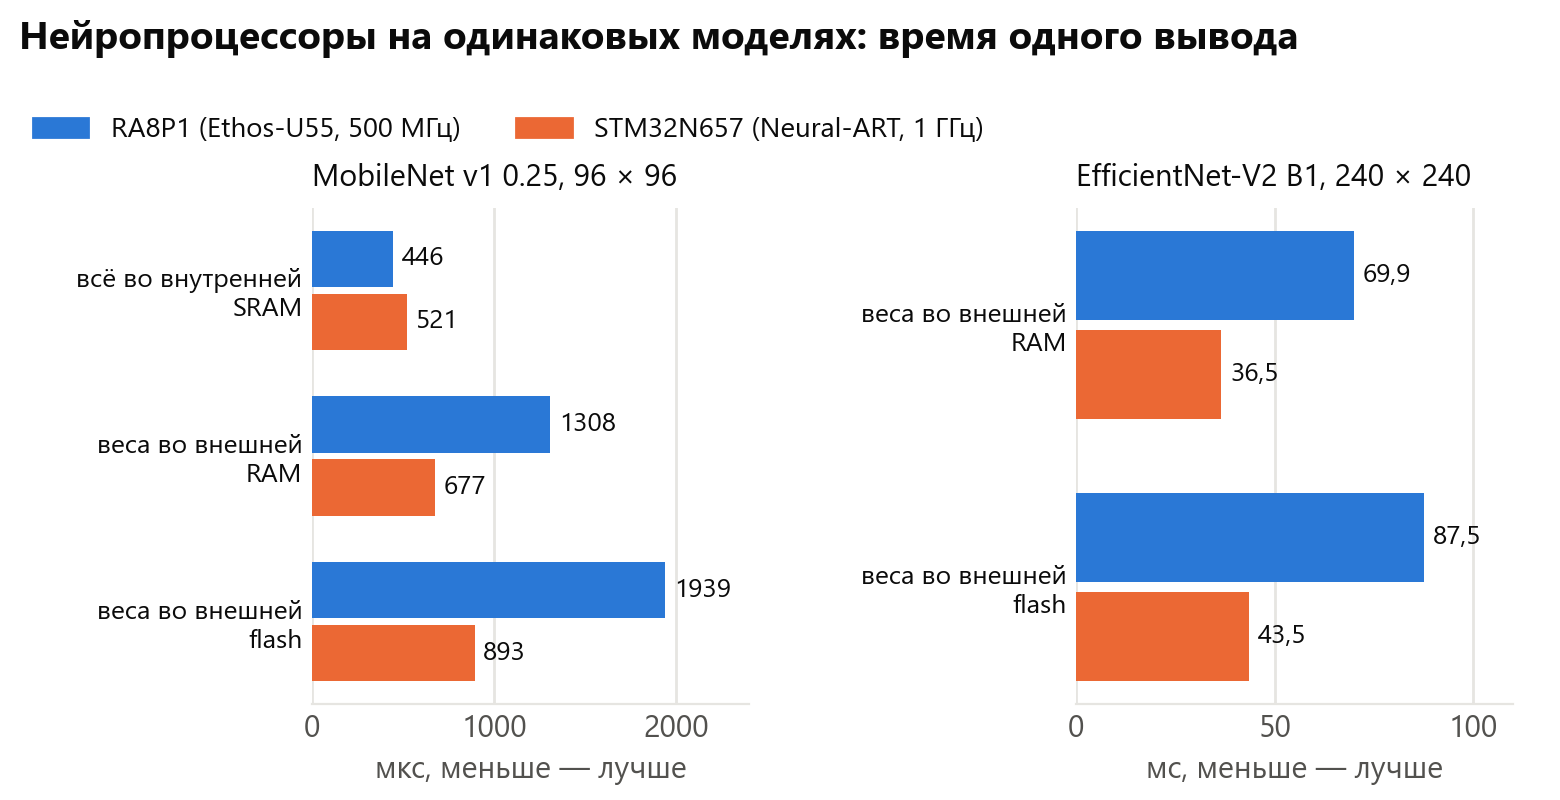
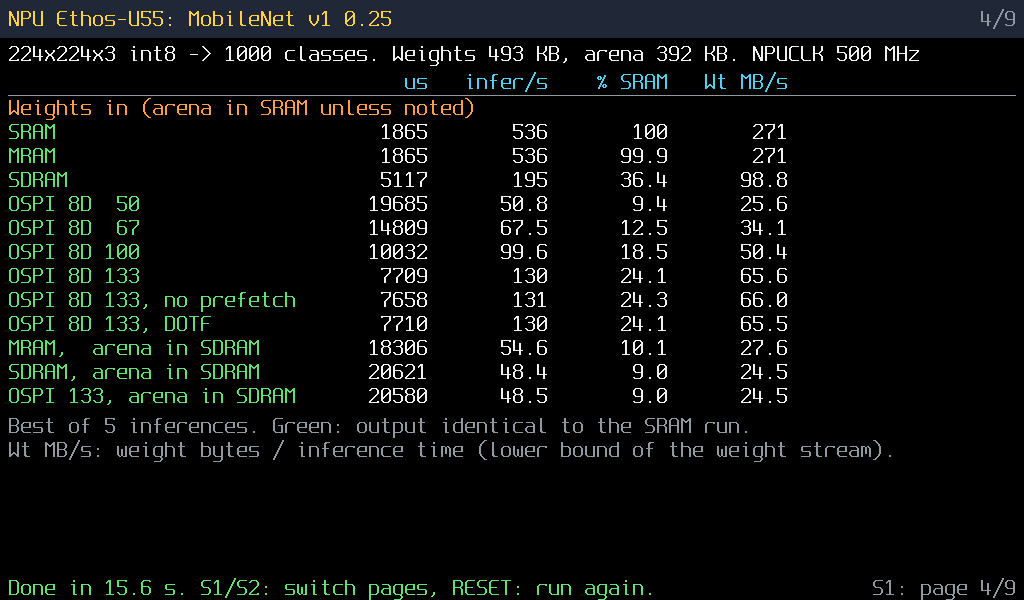
На малой модели, когда всё во внутренней SRAM, нейропроцессоры близки по скорости. RA8P1 с NPU на 500 МГц даже на 15 % быстрее Neural-ART на 1 ГГц: 446 мкс против 521.
Когда веса во внешней памяти, STM32N657 вдвое быстрее. EfficientNet-V2 с весами во flash выполняется за 43,5 мс против 87,5, то есть 23 вывода в секунду против 11. На одинаковой частоте flash (50 и 100 МГц) разница та же (в 1,6–1,9 раза), хотя после Vela весов у RA8P1 на 11 % меньше. Это тот же контроллер памяти с первого графика.
Рабочая область должна быть только во внутренней SRAM. Во внешней RAM вывод замедляется в 5–9 раз на RA8P1 и примерно в 30 раз на STM32N657. Рабочая область EfficientNet-V2 (около 1 МБ) помещается во внутреннюю SRAM обоих, так что это не ограничение, а правило размещения.
Отдельно на своих моделях для RA8P1: MobileNet с весами в MRAM работает так же быстро, как с весами в SRAM, и в 4 раза быстрее, чем с весами во flash. Малые модели стоит размещать в MRAM, большие во flash.
А что без NPU?
Чтобы понять, сколько на самом деле даёт нейропроцессор, я запустил те же две модели на двух платах без NPU: i.MX RT1176 (Cortex-M7, 996 МГц) и STM32H747 (Cortex-M7, 400 МГц). Сеть считает TensorFlow Lite Micro с оптимизированными ядрами Arm CMSIS-NN, это обычный путь для микроконтроллера без ускорителя. Вход тот же, и выход сети на обеих платах совпал до бита.
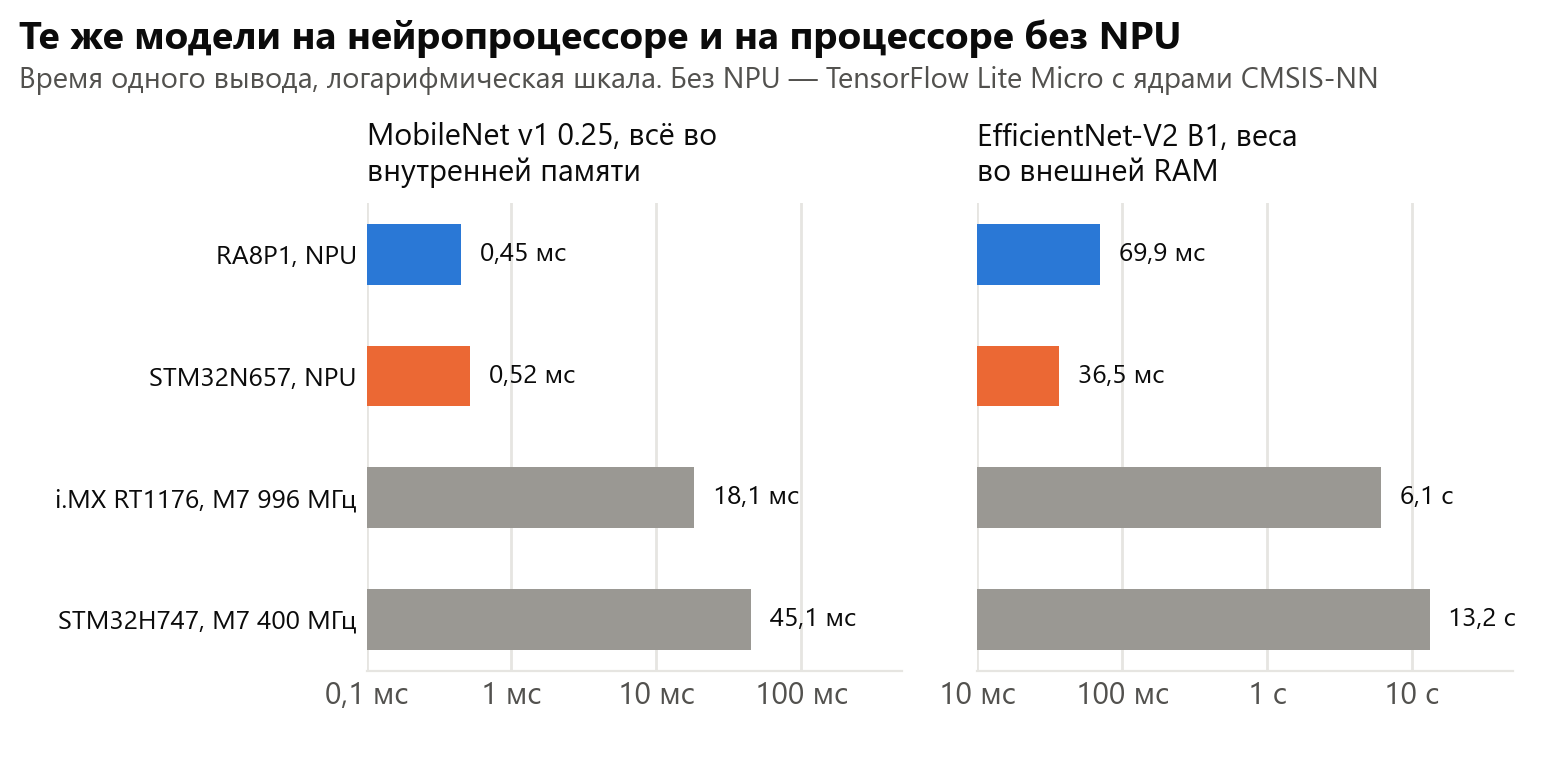
MobileNet, всё во внутренней памяти | EfficientNet-V2, веса во внешней RAM | |
|---|---|---|
RA8P1, NPU | 0,45 мс | 70 мс |
STM32N657, NPU | 0,52 мс | 37 мс |
i.MX RT1176, Cortex-M7 996 МГц | 18,1 мс (в 35–41 раз медленнее) | 6,1 с (в 88–168 раз) |
STM32H747, Cortex-M7 400 МГц | 45,1 мс (в 87–101 раз) | 13,2 с (в 189–362 раза) |
С малой сетью процессор справляется: 55 и 22 кадра в секунду. Где лежат веса, почти не важно: во внешней flash вывод медленнее всего на 7–22 %, время уходит на вычисления, а не на память. 70 % времени занимают обычные свёртки, 26 % поканальные.
С большой не справляется: 6 и 13 секунд на кадр. Кроме чистой арифметики, тут две причины. TFLM нужно 2 МБ рабочей области (вдвое больше, чем компиляторам ST и Arm для NPU), во внутреннюю память она не помещается, и вычисления идут из SDRAM. А 35–40 % времени занимает расчёт сигмоиды внутри функции активации swish: для неё в CMSIS-NN нет оптимизированного int8-ядра.
На такт оба Cortex-M7 одинаковы: 45,1 / 18,1 = 2,5, ровно отношение частот.
Для моих тестов граница получается такая: если хватает сети размером с MobileNet 0.25 и 20–50 кадров в секунду, нейропроцессор не обязателен. А протестированная EfficientNet-V2 B1 на Cortex-M7 уже не подходит для обработки видеопотока в реальном времени. Для другой архитектуры сети границу придётся измерить заново.
NPU и процессор на одной flash
Обычный сценарий: веса модели лежат во внешней flash, и там же часть программы. Что будет, если NPU и процессор обратятся к ней одновременно?
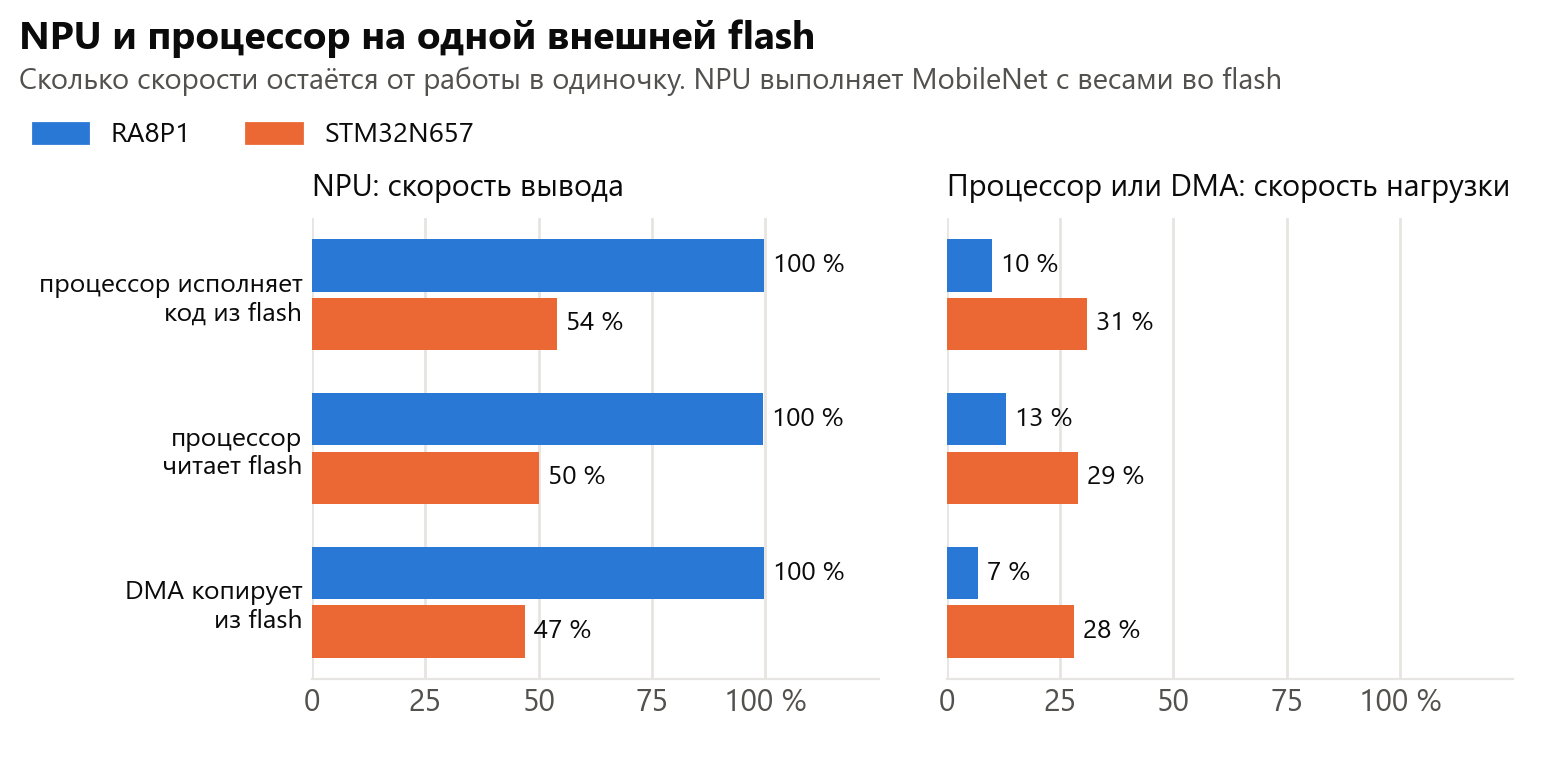
Контроллеры повели себя противоположно.
RA8P1 отдаёт flash нейропроцессору. NPU не замедляется вообще, а процессор и DMA получают 7–13 % своей скорости. Даже CoreMark, который живёт в кэше команд, теряет 28 %: редкие промахи кэша становятся очень дорогими.
STM32N657 делит flash примерно поровну. NPU замедляется вдвое, процессор сохраняет около 30 %. CoreMark из кэша не теряет ничего.
Вывод для обоих: веса NPU и горячий код нужно разводить по разным областям памяти. Веса во flash, тогда код в MRAM или SRAM. Код во flash, тогда веса в MRAM. Когда они в разных областях памяти, помех нет ни у одного: код из MRAM на RA8P1, пока NPU читает flash, сохраняет 99 % скорости.
Запись flash и обновление прошивки
Обновление почти целиком упирается в стирание, его задаёт сама микросхема. У MX25LW51245G можно читать другой банк, пока идёт стирание: программа и веса NPU продолжают работать из flash, пока новая прошивка пишется в соседний банк. S28HL512T так не умеет, а обновление 2 МБ на EK-RA8M1 заняло 23 с.
К чему приводят замеры
Окончательный выбор платформы ещё впереди, у каждого из двух кандидатов с NPU свой профиль:
RA8P1 выигрывает в задачах универсального управления и на небольших сетях: процессор в 1,8 раза быстрее, MRAM 1 МБ для горячего кода и малых моделей, есть выводы, допускающие 5 В, ЦАП и АЦП на 3,3 В.
STM32N657 выигрывает на больших сетях (веса больше 1–2 МБ) и при работе с изображениями или видео во внешней RAM: внешняя память у него в 3,6–4,7 раза быстрее, но сам модуль выходит дороже примерно на $5 при партии 100 штук и требует второй шины питания 1,8 В.
Если строить модуль на RA8P1, конфигурация памяти получается такой:
Flash: Macronix MX25LW51245G вместо Infineon S28HL512T. Она проверена на этом микроконтроллере, работает на 133 МГц, поддерживает чтение во время записи, обновление 2 МБ занимает 10 с. Замена дороже примерно на $6,7 на модуль.
RAM: Octal PSRAM 16 МБ вместо SDRAM. Она дешевле, экономичнее и занимает меньше выводов.
Частота flash: 133 МГц. Быстрее не нужно, скорость ограничивается контроллером.
Итоги
Скорость внешней памяти определяет контроллер в микроконтроллере. Сравнивайте не частоты flash и не ширину шины, а измеренные МБ/с.
На протестированной малой модели нейропроцессоры RA8P1 и STM32N657 близки по скорости, пока всё во внутренней SRAM. Как только веса уходят во внешнюю память, решает контроллер памяти.
Рабочая область сети должна размещаться только во внутренней SRAM. Во внешней RAM вывод медленнее в 5–30 раз.
Веса NPU и горячий код нужно размещать в разных областях памяти. На общей flash кто-то теряет от половины до 90 % скорости.
Код, не помещающийся в кэш команд, может выполняться из внешней flash в разы медленнее, чем из внутренней памяти. Горячий код нужно размещать отдельно.
Подбор ключей компилятора дал RA8P1 +41 % в CoreMark без изменения исходного кода. Цена за это — увеличение размера блока с 2,9 до 6,9 КБ.
PSRAM экономичнее SDRAM в 7–10 раз в работе и в сотни раз в простое. На хорошем контроллере она ещё и в 3 раза быстрее.
Без NPU малая сеть идёт на Cortex-M7 со скоростью 20–55 кадров в секунду, а большая даёт 6–13 секунд на кадр, что в 35–360 раз медленнее нейропроцессора.
Инструменты: e2 studio и FSP 6.3 для RA8, STM32CubeN6 1.4.1 и STM32CubeH7, MCUXpresso SDK 2.16, GCC 13.3 из STM32CubeCLT, LLVM (ATfE 21) из e2 studio, Arm Vela 5.2, TensorFlow Lite Micro и CMSIS-NN (main от 20.10.2026), модели взяты из STM32N6-GettingStarted-ImageClassification.