Привет, Хабр! Я Павел Молодан, продуктовый менеджер в UserGate. Последние 20 лет я работал в телекоме, а сейчас вместе с командой занимаюсь интеграцией аппаратного ускорения в продукты UserGate. В этой статье разберу, почему функции защиты замедляют межсетевой экран нового поколения, какие способы ускорения доступны и как FPGA помогает обрабатывать трафик, глубокую инспекцию, тяжелые сессии и шифрование. В финале покажу результаты наших экспериментальных платформ и приведу список вопросов, с которых стоит начинать такой проект у себя.
Как спортивный автомобиль превращается в мопед
Представьте мощный спортивный автомобиль на пустой прибрежной дороге. Пока работает только двигатель, машина легко набирает скорость. Затем водитель включает кондиционер, музыку, фары, вентиляцию и массаж сидений. Каждая новая функция забирает часть ресурса, и динамика разгона постепенно сглаживается.
С корпоративным файрволом происходит похожая история. Базовая фильтрация трафика показывает одну производительность. После включения потокового антивируса, системы обнаружения и предотвращения вторжений, SSL/TLS-инспекции, контроля приложений и контентной фильтрации профиль нагрузки меняется. Устройство продолжает выполнять свою работу, однако пропускная способность и задержка уже не соответствуют требованиям для простого L4-файрвола.
Причина понятна. Современный NGFW должен пропускать большие объемы данных, разбирать заголовки, сопоставлять пакеты с политиками, при необходимости расшифровывать поток, искать сигнатуры, определять приложение и пользователя, отфильтровывать URL. К этому добавляются видеоконференции, резервное копирование, синхронная репликация баз данных, VPN для удаленных сотрудников и сервисы с высокими требованиями к задержке.
Центральный процессор остается универсальным исполнителем. Он способен решать обширный набор задач и поддерживает сложную программную логику. Однако «универсализация» процессора сказывается на обработке потока: копировании данных, работе с памятью и кэшем, переключении контекста, балансировке между ядрами и доступе к общим ресурсам. При росте нагрузки часть этих операций становится «узким местом».
Задача инженера в таком случае — сохранить нужный набор защитных функций и обеспечить требуемую скорость на реальном профиле трафика.
Где производительность особенно важна
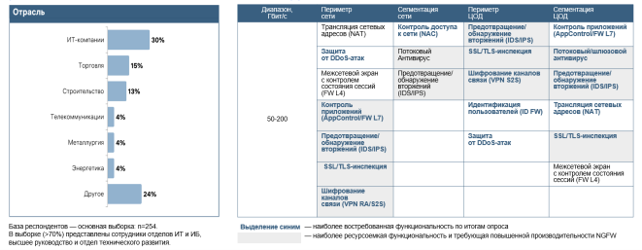
В исследовании функциональных потребностей, которое мы проводили в 2025 году, участвовали 254 респондента из разных отраслей. Более 70% выборки составили сотрудники подразделений ИТ и ИБ, руководители и специалисты технического развития.
Согласно результатам исследования самый нагруженный сценарий — обслуживание ЦОД в сегменте B2E. Для периметра и сегментации ЦОД одновременно востребованы IDS/IPS, SSL/TLS-инспекция, VPN, контроль приложений, потоковый антивирус, NAT и другие функции. Многие из них требуют значительных вычислительных ресурсов. Рабочий диапазон, как видно в таблице ниже, составлял от 50 до 200 Гбит/с.
Второй вывод касается формата поставки. Программно-аппаратные комплексы оказались предпочтительным форматом поставки во всех сегментах бизнеса: доля таких ответов составила от 53% до 73%. Респонденты связывали эту потребность с производительностью, надежностью и необходимостью заменить решения иностранных вендоров.
В совокупности эти результаты свидетельствуют о понятном инженерном запросе. На наиболее нагруженных участках требуется много функций защиты, часть функций ресурсоемка, а основной формат поставки предполагает работу с аппаратной платформой. Поэтому ускорение ПАК становится отдельной задачей продуктовой архитектуры.
Четыре группы методов ускорения
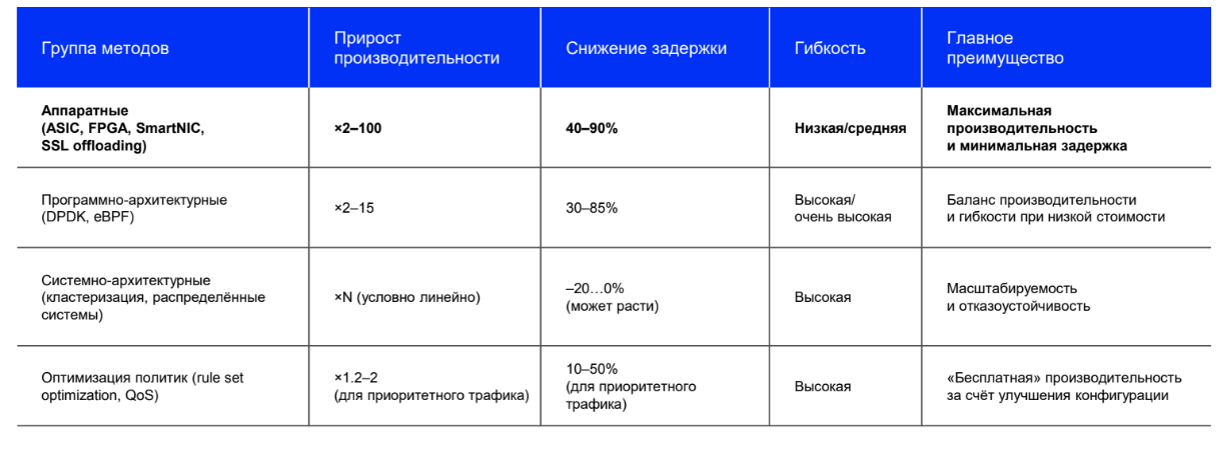
Повышать производительность можно разными методами. Мы выделяем четыре основные группы:
Аппаратные методы. ASIC, FPGA, SmartNIC и аппаратный SSL offloading берут на себя регулярные потоковые операции, которые эффективно реализуются в специализированной логике. Эта группа методов наиболее эффективна для задач повышения производительности и снижения задержки при обработке трафика.
Программно-архитектурные методы. DPDK и eBPF сокращают накладные расходы программного стека и помогают быстрее передавать пакеты между сетевым интерфейсом и приложением.
Системно-архитектурные методы. Кластеризация и распределенные системы обеспечивают горизонтальное масштабирование производительности и одновременно повышают отказоустойчивость.
Оптимизация политик. Удаление лишних правил, изменение их порядка, группировка и настройка QoS снижают объем работы для каждого потока. Иногда это самый быстрый способ вернуть системе запас производительности.
Эти подходы дополняют друг друга. Хорошая политика правил нужна и платформе с ускорителем. DPDK может работать рядом с аппаратным offload. Кластер помогает масштабировать систему после того, как производительность отдельного узла уже понятна. Наша команда сосредоточена на аппаратной части и прежде всего на FPGA.
Почему мы выбрали FPGA
Для аппаратного ускорения часто рассматривают ASIC и FPGA. Обе технологии предполагают специализированную обработку, однако их жизненный цикл устроен по-разному.
ASIC проектируется под заранее заданный набор задач. Технология обеспечивает максимальную производительность, низкое энергопотребление и низкую себестоимость одного устройства при очень больших тиражах, начиная примерно со 100 тысяч единиц. При этом разработка требует крупных вложений, а логику готовой микросхемы нельзя перепрограммировать под новый протокол или алгоритм.
FPGA содержит программируемые логические элементы. Сегодня на такой платформе можно ускорять IDS/IPS, после обновления конфигурации добавить обработку шифрования или изменить конвейер разбора пакета. Производительность остается высокой, обновление возможно в поле, время вывода решения обычно короче. Себестоимость одного устройства выше, а разработка при этом требует особых, редких инженерных компетенций.
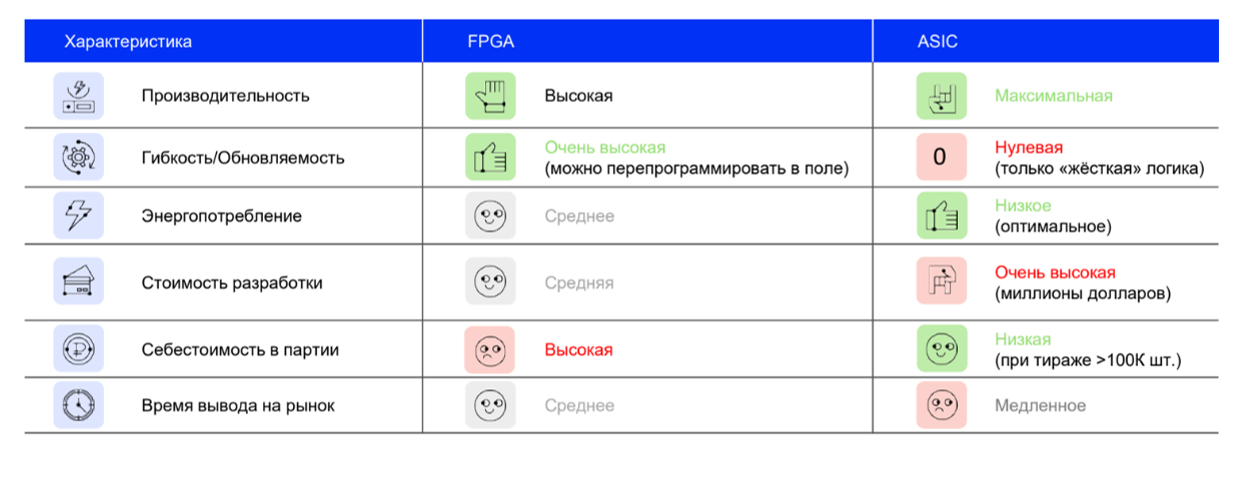
Для обеспечения безопасности возможность обновлять аппаратную логику особенно важна. Протоколы развиваются, появляются новые типы атак и новые требования к анализу пакетов. FPGA позволяет адаптировать ускоритель без замены всей платформы.
Это решение стоит денег. Разработка занимает время, а специалисты по FPGA, сетевому программированию, криптографии и продуктовой логике должны работать как одна команда. Мы не занимаемся разработкой ASIC, поэтому детальное сравнение стоимости двух направлений было бы спекуляцией с нашей стороны. По FPGA опыт у нас есть, и он показывает, что квалификация команды остается одним из главных ограничений.
Что происходит с пакетом внутри FPGA
В процессорной реализации пакет последовательно проходит цепочку стадий: парсинг, применение правила файрвола, расшифрование, сигнатурный анализ. Многоядерный CPU обрабатывает несколько потоков, при этом для каждого потока нужно распределять работу между ядрами и обращаться к памяти и общим структурам данных.
FPGA позволяет построить конвейер. Пока первый пакет находится на стадии IDPS, следующий может проходить расшифрование, еще один — проверку правила, а новый пакет поступает в парсер. Внутри отдельного пакета также можно распараллеливать операции и реализовывать специализированные аппаратные алгоритмы.
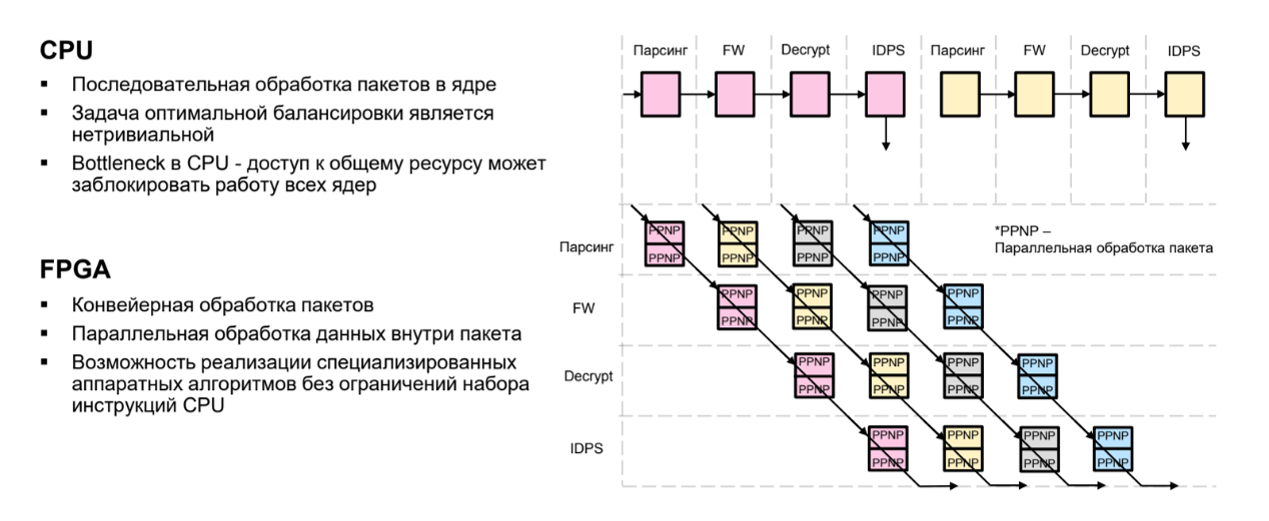
Каждый такт конвейера приносит результат. Поток данных проходит через заранее собранную схему, а количество параллельных блоков определяется тем, сколько логических элементов выделено под задачу. Такой принцип хорошо подходит для регулярных потоковых операций: парсинга, сопоставления с большим набором паттернов, генерации ключей и части функций шифрования.
CPU при этом сохраняет важную роль. На его стороне остаются сложные алгоритмы, управление, мониторинг и логика принятия решений. Архитектура распределяет функции между двумя вычислительными средами.
Как строится аппаратный fast path
Типовая платформа содержит сетевые порты, FPGA и центральный процессор. FPGA принимает поток с портов и обменивается с CPU данными и протоколом конфигурации. Дальше объем offload зависит от зрелости аппаратной реализации.
На первом этапе первый пакет новой сессии отправляется в CPU. Процессор применяет политики и решает, как обрабатывать поток. Затем в FPGA загружается flow rule, и последующие пакеты установленной сессии идут через аппаратный fast path.
Следующий уровень переносит в FPGA функции firewall, forwarding и NAT. По мере развития конвейера туда же можно добавить TLS и IDPS. В наиболее полном варианте из нашей схемы CPU отвечает за маршрутизацию, управление и функции, которые требуют сложной программной логики, а основной поток обрабатывается на аппаратном уровне.
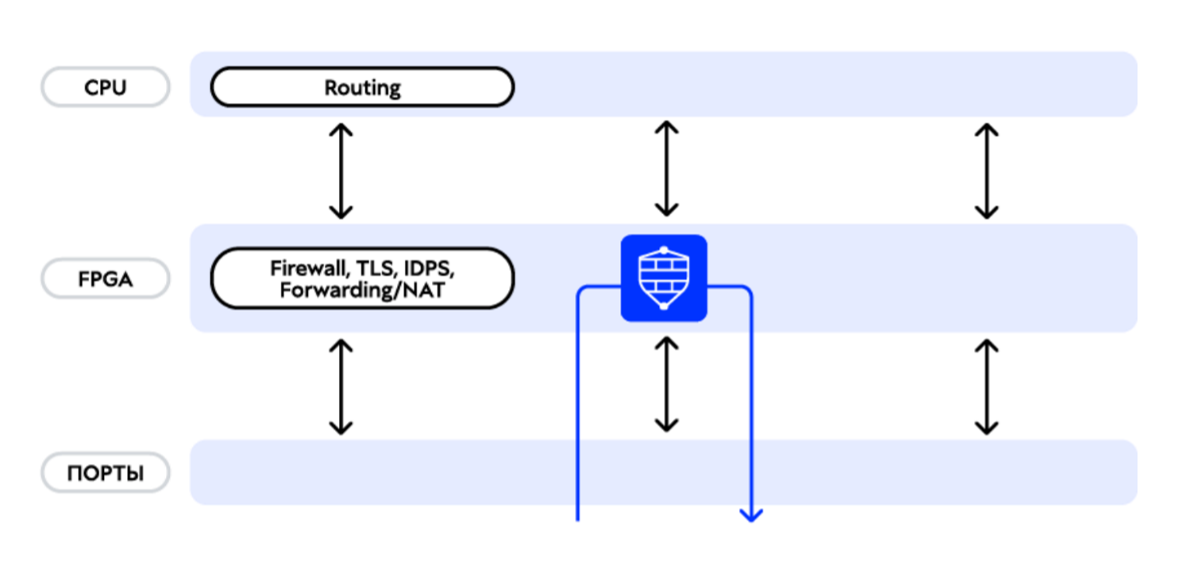
Эволюционный подход важен для разработки продукта. Команда переносит функции по одной, измеряет результат, проверяет совместимость — и только после этого расширяет аппаратный контур. Производительность растет вместе с долей операций, которые удается корректно выполнить в FPGA.
Пять эффектов аппаратного турбонаддува
1. Ускорение обработки сетевого трафика
Fast path снимает с CPU повторяющуюся обработку пакетов уже установленной сессии. Процессор принимает решение один раз, затем правило работает в FPGA. Освободившиеся ядра можно использовать для новых соединений, управляющей логики и функций, которые еще остаются в софте.
Итоговая цифра всегда зависит от размера пакета, профиля трафика, набора включенных функций и методики теста. Поэтому показатели простого L4 firewall, EMIX, IDPS и комплексного профиля следует измерять отдельно.
2. Комплексный анализ на высокой скорости
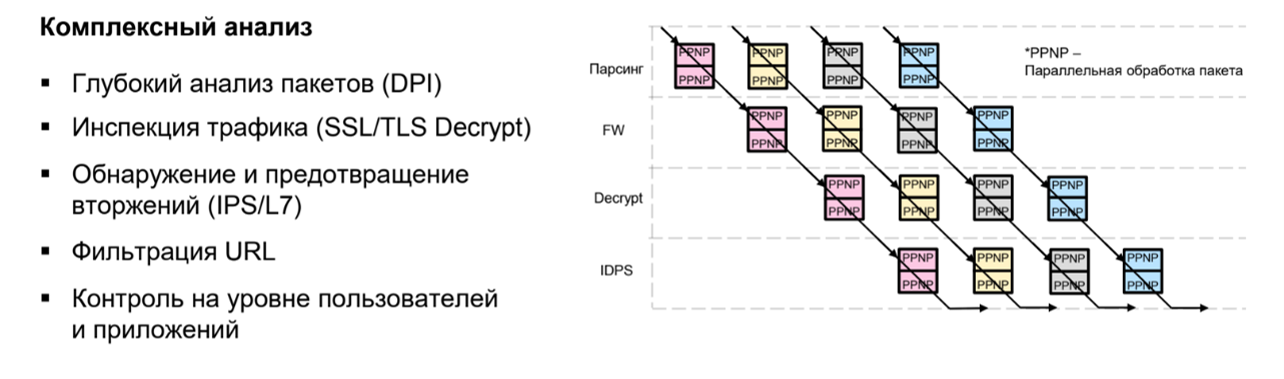
Глубокий анализ трафика требует расшифровки, разбора, проверки по сигнатурам, сопоставления с приложением и пользователем, затем применения правил фильтрации. В FPGA мы переносим тяжелые потоковые вычисления. CPU выполняет сложные алгоритмы и принимает итоговое решение.
На FPGA эффективно реализуются генерация ключей шифрования и поиск большого числа паттернов. Конвейер дает возможность выполнять парсинг, firewall, decrypt и IDPS параллельно для разных пакетов.
3. Снижение задержки
FPGA может начинать обработку после приема первых байтов заголовка. Полное размещение пакета в DRAM требуется только для отдельных сценариев. При процессорной обработке пакет обычно буферизуется, а задержка растет вместе с загрузкой системы.
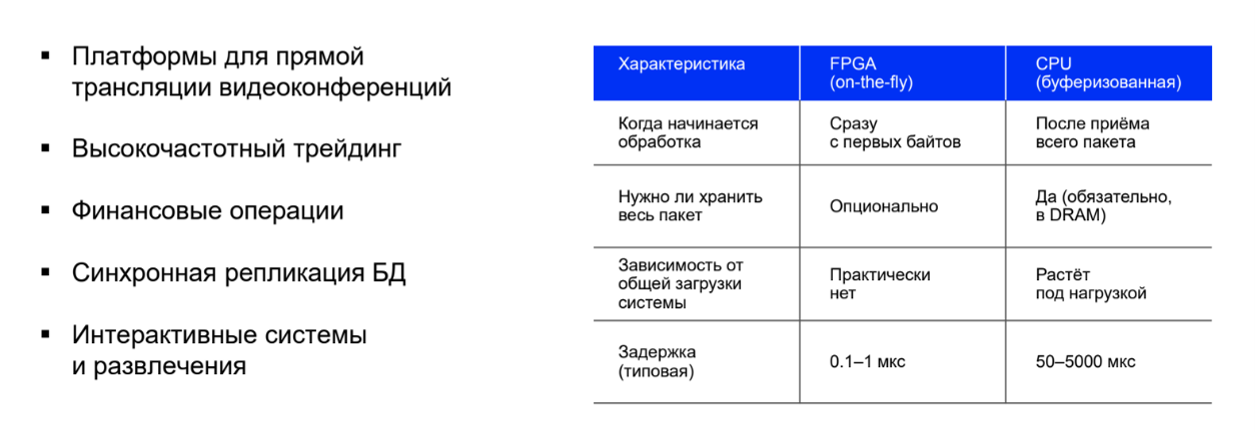
На рисунке выше для FPGA указана типовая задержка от 0,1 до 1 мкс, для CPU — от 50 до 5000 мкс. Это ориентиры для описанной архитектуры, а не универсальный сценарий для любого устройства. На результат влияют конкретный конвейер, размер пакета, активные профили защиты и способ измерения.
Микросекунды важны для синхронной репликации баз данных, финансовых операций, высокочастотного трейдинга, прямой трансляции видеоконференций и интерактивных систем.
4. Обработка elephant flows
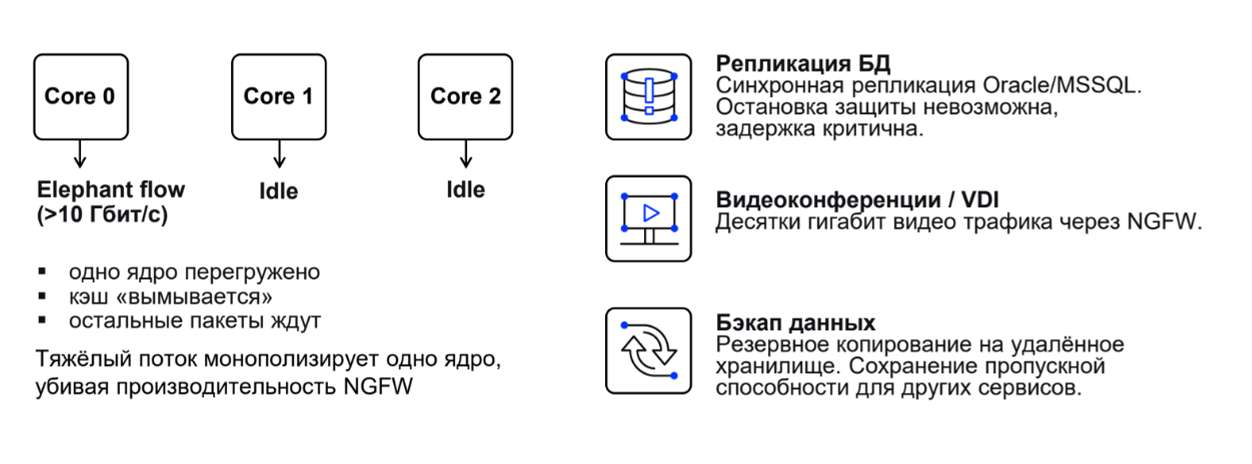
Elephant flow представляет собой одну объемную сессию со скоростью в единицы или десятки гигабит в секунду. Такой поток может занять одно процессорное ядро, вытеснить из кэша данные других потоков и заставить остальные пакеты ждать. Перераспределить одну сессию между ядрами намного сложнее, чем распределить множество независимых соединений.
FPGA переводит тяжелые сессии на аппаратный fast path, сохраняя микросекундную задержку и стопроцентную функциональность NGFW. Аппаратный fast path принимает тяжелую сессию целиком. Это помогает пропускать резервное копирование, репликацию Oracle или Microsoft SQL, видеоконференции и VDI через NGFW, сохраняя ресурс CPU для остального трафика.
5. Энергоэффективность
В наших материалах приведен расчетный пример обработки 100 Гбит/с. Сервер с двумя CPU потребляет около 450 Вт, FPGA — около 45 Вт. Для CPU только 30% энергии приходится на вычислительные ядра, остальное расходуют кэш и память, управление, копирование данных, шины и утечки. В FPGA большая часть энергии идет на логику, трансиверы и память.
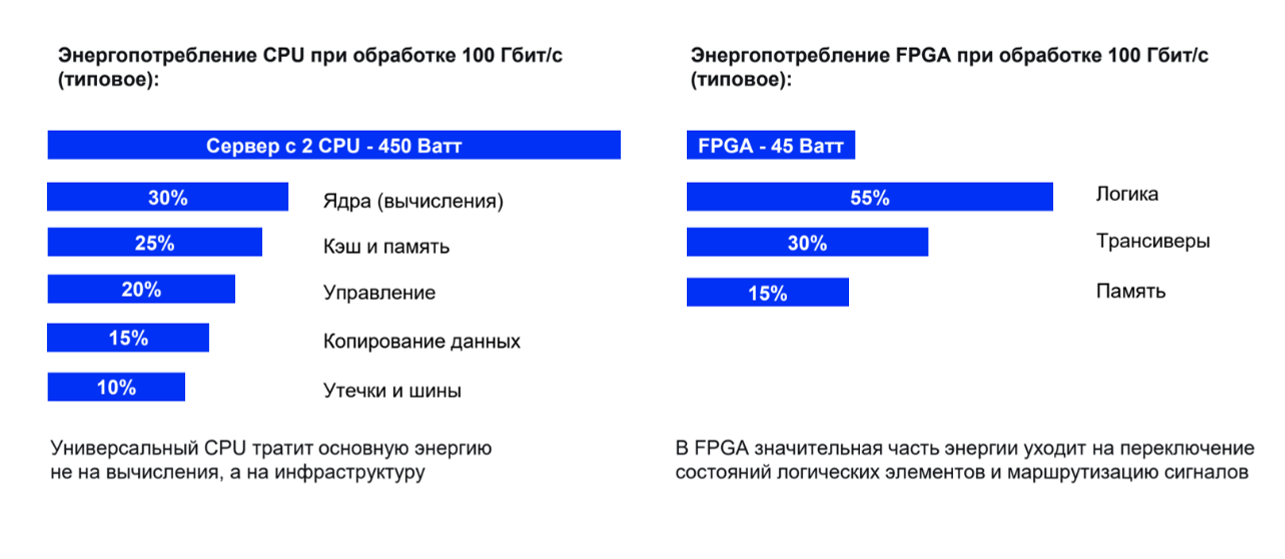
Этот пример показывает масштаб различий в конкретной модели. FPGA дает ту же производительность обработки трафика при 5–10% потребления CPU (что критически важно для масштабируемых «зеленых» ЦОД и крупных предприятий).
Для расчета TCO своей платформы нужны измерения на одинаковом трафике и одинаковом наборе функций, а также учет энергопотребления всей системы, охлаждения и требуемого количества устройств.
Что получилось на наших платформах
Здесь особенно важно разделять экспериментальные результаты, платформы в разработке и будущие направления. Ниже я описываю статусы и цифры, представленные в материалах на момент подготовки статьи.
«Катунь-2»: модульное ускорение IDPS
«Катунь-2» представляет собой PCIe-карту с FPGA. Ее можно устанавливать в слоты расширения, предназначенные для NIC; также предусмотрен вариант под разъем M.2. Карта подходит для платформ серий D, E и F, несколько модулей могут работать вместе.
В таблице испытаний один модуль добавляет 10 Гбит/с к показателю IDPS. Для платформы D приведен рост с 5 до 15 Гбит/с. Для E показаны 18 Гбит/с без карты, 28 Гбит/с — с одной картой, 38 Гбит/с — с двумя, 48 Гбит/с — с тремя. Для F результат растет с 30 Гбит/с без ускорителя до 90 Гбит/с с шестью модулями.
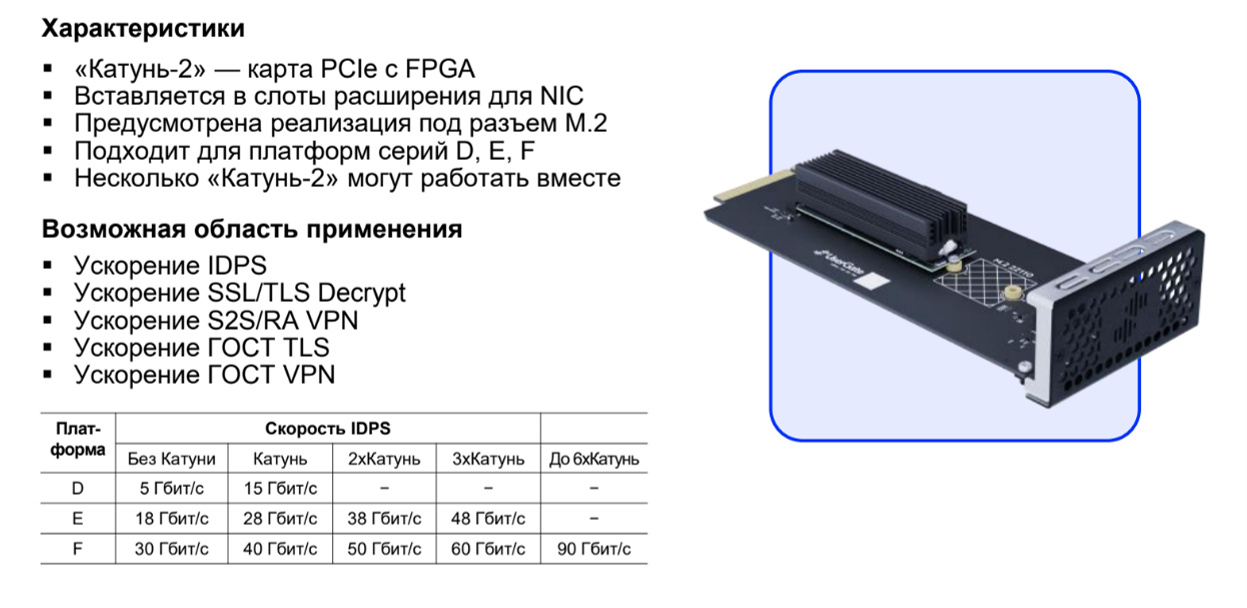
Текущая область применения связана с ускорением IDPS. В дальнейших планах есть SSL/TLS decrypt, S2S и remote access VPN, ГОСТ TLS и ГОСТ VPN.
FG и D250: одинаковый процессор, разный способ обработки
Рассматривать экспериментальную платформу FG имеет смысл в сравнении с D250: в них используется одинаковый процессор, а FG дополнительно содержит FPGA на 500 000 LUT.
Для D250 указаны 20 Гбит/с firewall и 0,5 Гбит/с IDPS. Для FG приведены 85 Гбит/с Firewall на профиле EMIX, 150 Гбит/с — L4 Firewall на UDP с пакетами 1518 байт, 25 Гбит/с — IPS. Показатель CPS составляет больше 90 000 соединений в секунду.
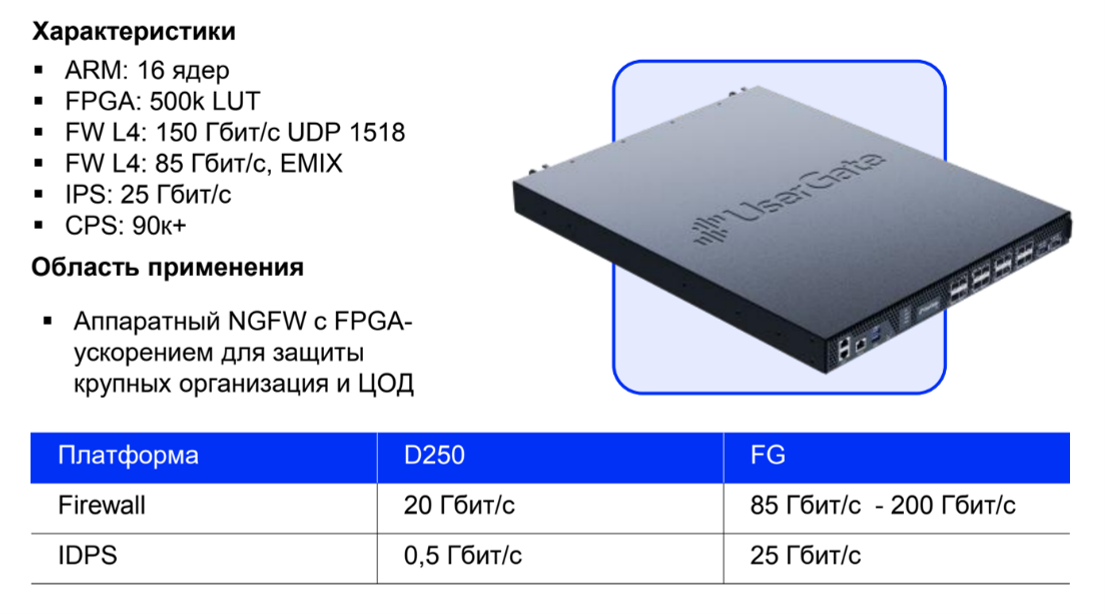
Разные значения firewall здесь связаны с разной методикой нагрузки. EMIX моделирует набор пакетов нескольких размеров, UDP 1518 показывает обработку крупных пакетов. Публиковать только цифру без названия профиля было бы некорректно.
Дальнейшая эволюция
Гибридная G9800 объединяет FG и F8010, то есть ARM-часть с FPGA и x86-платформу. Такое решение позволяет постепенно переносить новые функции на аппаратный уровень и одновременно развивать программную часть.
u5020 в материалах обозначена как платформа в стадии прототипа. Для нее рассматривается конфигурация с двумя ARM-процессорами по 256 ядер и FPGA примерно втрое крупнее чипа FG. Эти характеристики и целевые показатели относятся к прототипу.
В дорожной карте аппаратного ускорения для uDCFW, uNGFW, uSWG и uWAF перечислены IDPS, TLS, VPN, ГОСТ VPN, ГОСТ TLS и работа правил WAF. Статус каждой функции следует сверять с актуальным релизом продукта.
Что остается за пределами FPGA
Аппаратное ускорение требует ясной границы ответственности. Регулярные потоковые операции хорошо сопрягаются с FPGA. Сложная управляющая логика, маршрутизация, мониторинг и часть алгоритмов остаются в CPU. Параллельно отдельная команда может оптимизировать процессорную обработку и развивать DPDK.
Команда разработки должна объединять специалистов по FPGA, сетям, системному программированию, криптографии, тестированию и продуктовой логике. Такие компетенции редки и стоят дорого. Главная сложность часто связана с согласованием интерфейсов и общей методики тестирования.
Сертификация также входит в архитектурный план. На момент публикации статьи платформа FG прошла сертификацию ФСТЭК. Для ГОСТ обсуждался последовательный путь: сначала сертификация программной реализации, затем перенос функций на аппаратный уровень. Направления с ML также изучаются, однако подтвержденных результатов аппаратной реализации пока нет.
Чек-лист перед выбором ускорителя
Перед тем как добавлять в файрвол аппаратный турбонаддув, я советую ответить на восемь вопросов:
Где находится узкое место? CPU, память, копирование пакетов, очередь, одна тяжелая сессия, неоптимальные политики или межузловой обмен требуют разных решений.
Как выглядит реальный трафик? Нужны размеры пакетов, число сессий, CPS, доля шифрования, объем elephant flows и набор активных функций защиты.
Какая метрика важнее? Пропускная способность, задержка p99, производительность IDPS, число соединений или энергопотребление задают разные приоритеты.
Что можно улучшить посредством настройки? Пересмотр политик и программная оптимизация иногда дают нужный запас быстрее аппаратного проекта.
Какие операции подходят для offload? Регулярные потоковые вычисления и поиск паттернов — хорошие варианты. Сложная логика с частыми изменениями требует отдельной оценки.
Как будет обновляться аппаратная логика? Нужны безопасная доставка конфигурации, откат, совместимость версий и тестирование новых протоколов и сигнатур.
Сколько стоит весь жизненный цикл? В расчет входят ускоритель, команда, стенды, сертификация, энергия, охлаждение, сопровождение и время вывода функции.
Как сравнивать результаты? Все платформы нужно тестировать на одном профиле трафика, одинаковом наборе защит и по заранее согласованной методике.
Турбонаддув файрвола начинается с точного понимания нагрузки. FPGA дает высокий прирост, микросекундные задержки для подходящих операций, обработку тяжелых потоков и возможность обновлять аппаратную логику. CPU сохраняет управление и сложные алгоритмы, а системная архитектура связывает обе части в единый продукт.