
Как версионируемый QA-репозиторий помогает маршрутизировать контекст, повторно использовать процессы и сохранять обоснование выбора тестов.
Прежде чем поручить ИИ-агенту, работающему с кодом, написание тестов, нужно понять, как должна работать фича и какие компоненты она затрагивает. Требования, код, ограничения платформ и предыдущие решения хранятся в разных репозиториях и инструментах. Для каждой задачи приходится собирать нужные материалы и сопоставлять их.
В первой половине 2026 года я решал эту задачу, тестируя экосистему TON и TON Connect SDK.
В реестре было около 30 интеграций кошельков. К ним добавлялись несколько приложений, разные ОС, способы подключения, сети и версии SDK. Проверить все сочетания невозможно. А доступ агента ко всем источникам ещё не определяет, что именно ему нужно прочитать и проверить.
Поэтому вместо одного большого промпта со всей базой знаний использовал QA-репозиторий с указателями на нужные источники. Для каждой задачи агент получал требования, код и ограничения, которые к ней относились. Там же сохранялись выбранные проверки и обоснование выбора.
Процесс оформил как Process-as-Code: правила работы хранятся в файлах, версионируются в Git и проходят ревью, как код. В репозитории описано, что агент должен прочитать, какие ограничения учесть, как оформить результат и что проверить инженеру. Я проверял результаты и решал, можно ли переходить к следующей фазе.
Что я тестировал: TON Connect, SDK и демо-приложения
Приложение и кошелёк — две стороны интеграции. dApp — приложение, которое работает с кошельком пользователя. Оно может открываться в обычном браузере, WebView Telegram Mini App или WebView внутри кошелька. Сам кошелёк — отдельное приложение, веб-клиент или расширение. Telegram здесь служит средой выполнения части интеграций.
TON Connect — протокол обмена между приложением и кошельком. Приложение получает адрес подключённого кошелька и может запросить подпись или отправку транзакции. Ключи и обработка подписи остаются на стороне кошелька. Секретный ключ приложению не передаётся.
В исходниках TON Connect SDK несколько уровней:
@tonconnect/protocol— форматы сообщений и правила обмена между приложением и кошельком.@tonconnect/sdk— подключение, восстановление сессии и запросы к кошельку без готового интерфейса.@tonconnect/ui— готовый интерфейс подключения и выбора кошелька.@tonconnect/ui-react— React-обёртка с компонентами и хуками.
HTTP Bridge и JS Bridge — два способа доставки сообщений. HTTP Bridge передаёт зашифрованные сообщения через сервер-посредник. JS Bridge используется, когда кошелёк доступен из WebView или через расширение браузера: запрос передаётся через предоставленный кошельком JavaScript-интерфейс.
Также тестировал AppKit и WalletKit: клиентскую библиотеку для приложений и компоненты для реализации кошелька. Демо-приложение и демо-кошелёк помогали проверять обе стороны интеграции и готовить UI-интеграционные тесты.
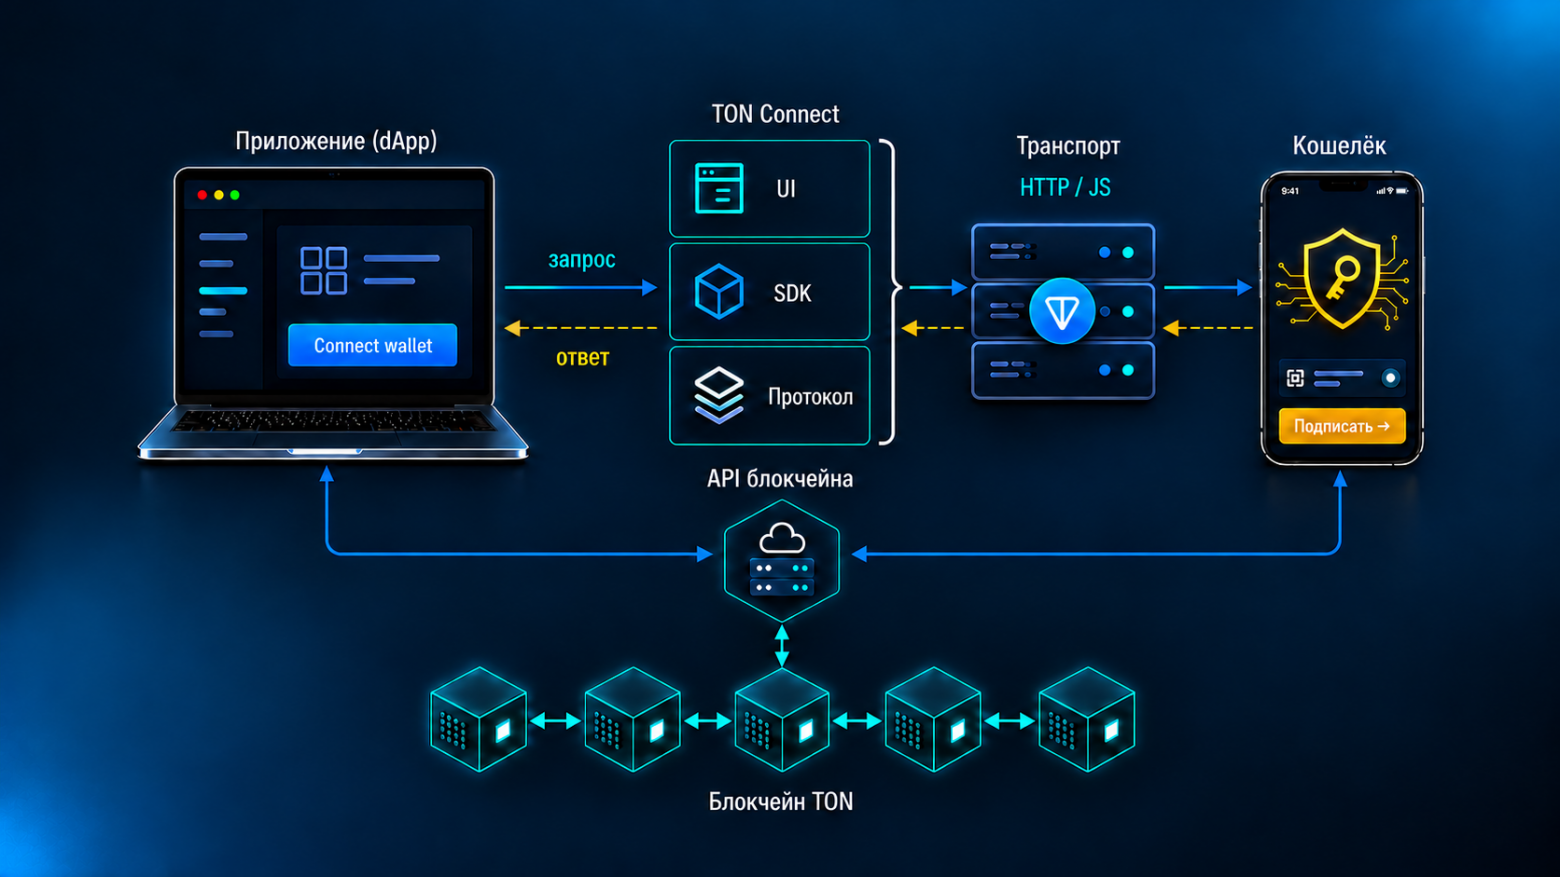
Верхняя ветка — запросы и ответы TON Connect. Нижняя — работа с API блокчейна. При запросе sendTransaction кошелёк отправляет подписанную транзакцию в сеть. Запрос подписи может завершиться ответом без отправки в блокчейн.
Матрица совместимости: как выбрать, что проверять
В область работы входили основной SDK, клиентский SDK, адаптер TON Connect, демо-приложения и тестовый раннер. Запрос на подключение, подпись или перевод проходит через несколько компонентов, которые развиваются независимо друг от друга.
Модель совместимости включала девять измерений. ОС — это Android, iOS, Windows и другие системы, а версия ОС учитывается отдельно. Контекст приложения показывает, где открыт dApp: в браузере, Telegram Mini App или WebView кошелька. Контекст кошелька показывает, в каком виде работает другая сторона интеграции: нативное приложение, веб-клиент, расширение или Mini App. Остальные измерения — сам кошелёк, транспорт, сеть блокчейна, версии SDK и контракта. Ниже — шесть из этих измерений и связанные с ними риски.
Измерение | Варианты | Почему важно |
Контекст приложения | Браузер (Chrome, Safari), Telegram Mini App, WebView кошелька | Один и тот же интерфейс и транспорт TON Connect работают в разных браузерах и WebView. |
Контекст кошелька | Нативное приложение, веб-клиент, расширение, Telegram Mini App | Кошелёк — независимая реализация другой стороны протокола. |
Транспорт | HTTP Bridge или JS Bridge | Это разные пути в коде и способы доставки запроса. |
Сеть блокчейна | mainnet / testnet | Несовпадение сетей должно явно блокироваться или обрабатываться. |
Версия SDK | Старая/новая версия SDK × версия интеграции кошелька | Возможность может появиться на одной стороне раньше, чем на другой. |
Версия контракта | Поддерживаемые версии контрактов | Поведение кошелька зависит не только от UI, но и от версии контракта. |
Для регулярного релизного тестирования использовал три основные интеграции из реестра — условно Wallet A, Wallet B и Wallet C. Остальные сочетания не считались покрытыми. В карте покрытия были отмечены непроверенные сочетания и причины их исключения.
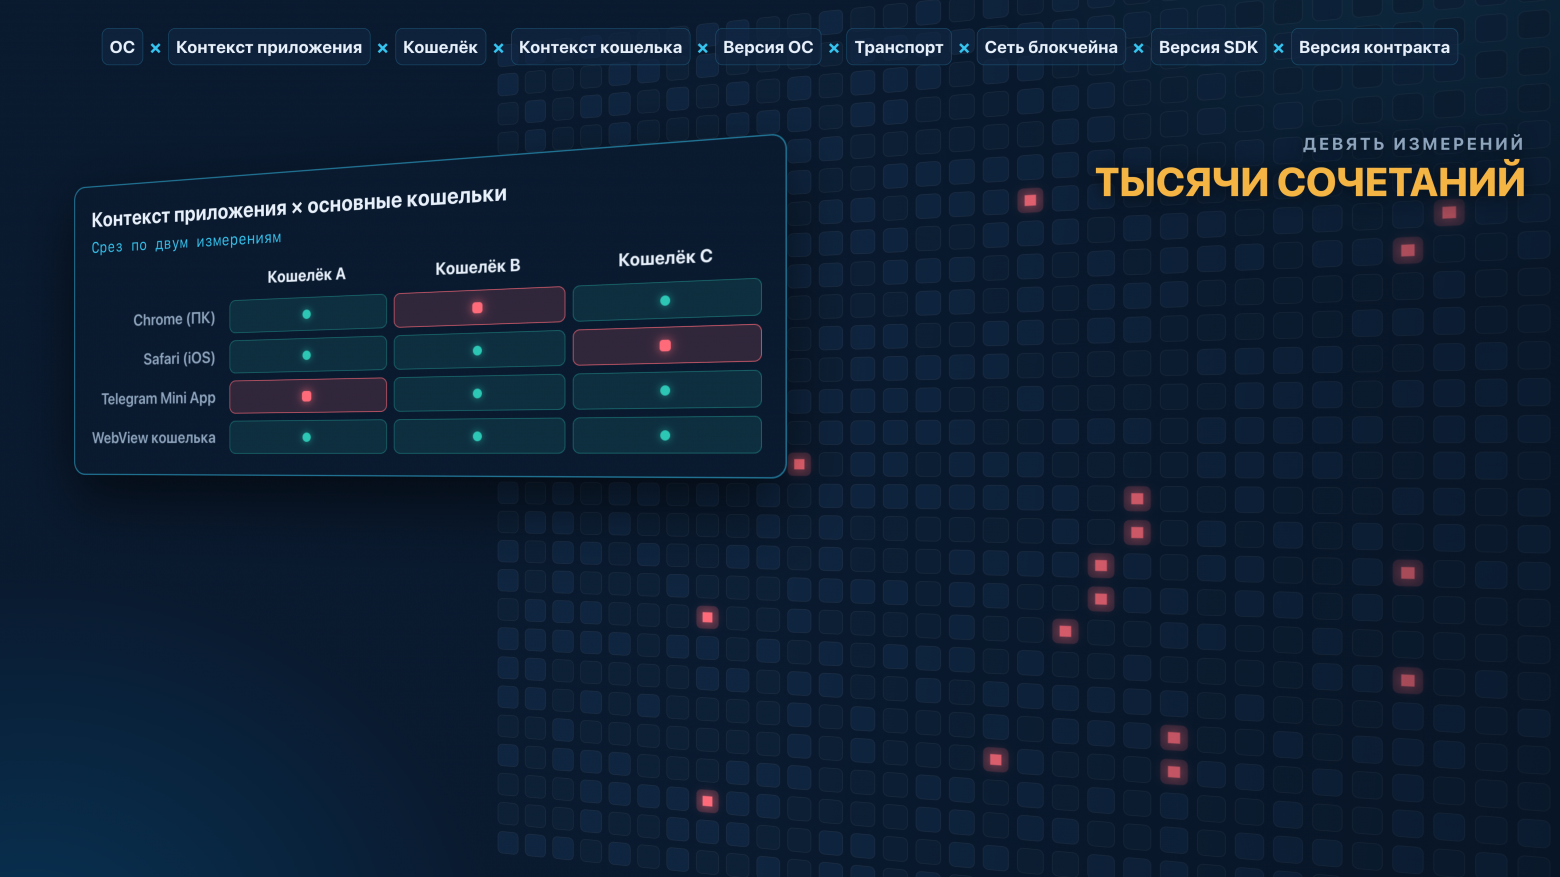
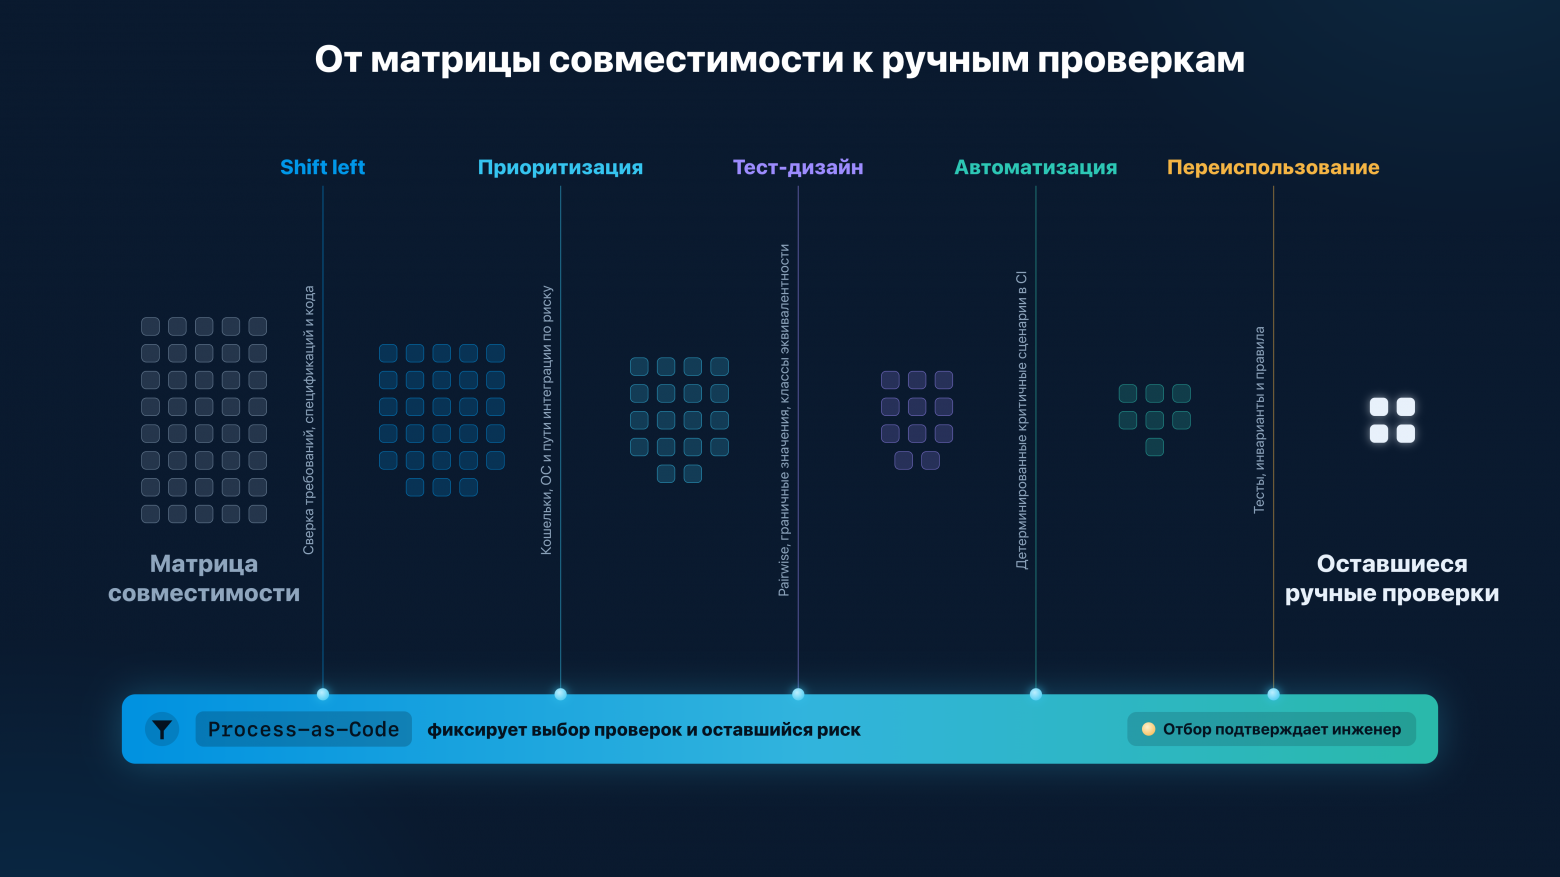
Ручной объём удалось сократить пятью механизмами:
Shift left. До ручного прогона агент сопоставлял PRD, дизайн, спецификацию и фактические изменения в коде. Неясности я разбирал с разработчиком.
Приоритизация. Сначала проверял ключевые кошельки, ОС и пути интеграции с учётом риска.
Тест-дизайн. Pairwise уменьшает число комбинаций, но не определяет, какие сочетания допустимы. Отдельно учитывал ограничения. Граничные значения и случаи с разным ожидаемым результатом оставались отдельными сценариями.
Автоматизация. Детерминированные критичные сценарии переходили в CI и не повторялись в каждом ручном регрессе.
Переиспользование. Полезные тесты, инварианты и правила сохранялись в репозитории и уменьшали объём работы для следующей фичи.
Число возможных сочетаний от этого не уменьшается. Зато видно, что проверено, какие риски остаются и что ещё нужно проверить вручную.
Маршрутизируйте контекст через версионируемый QA-репозиторий
Когда в QA включается агент, инструкций в промпте недостаточно. Исходный код продукта остаётся источником истины о реализации. Отдельный версионируемый QA-репозиторий определяет, как агент собирает, маршрутизирует и возвращает доказательства.
Изменения процесса проходят ревью. Поэтому предпосылки тест-плана, команды или решения о покрытии можно увидеть в diff, связать с автором и повторно использовать между продуктовыми репозиториями.
Артефакт | Назначение | Какой риск снижает |
Точка входа | Направляет агента к нужным документам по условиям | Агент загружает нерелевантный контекст и делает вывод до проверки первичных источников. |
Правила агента | Фиксируют повторяющиеся ошибки и способ их избегать | Непроверенное утверждение принимается за факт, выдумывается недостающая деталь или нарушаются согласованные границы работы. |
Спецификации и инварианты | Описывают ожидаемое поведение и условия, при которых оно меняется | Ложный дефект из-за пропущенной платформы, триггера или возможности кошелька. |
Контракты | Определяют, что разработка передаёт в QA и что QA возвращает | Теряются предположения, которых не видно в diff. |
Скиллы и шаблоны | Стандартизируют баг-репорты, тест-кейсы, тест-планы, PR и карты покрытия | Непредсказуемые артефакты и неверная маршрутизация. |
Тест-планы и матрицы | Сохраняют решение о покрытии для конкретного pull request или релиза | Объём проверки приходится восстанавливать снова и снова, а исключения остаются неявными. |
В начале сессии агент должен был выполнить три действия:
## Начало сессии

1. Прочитать rules/agent-rules.md.
2. Обновить данные репозиториев рабочей области через git fetch
   до анализа веток или кода.
3. Прежде чем отвечать на вопрос о поведении фичи,
   прочитать specs/invariants.md и перечислить применимые ограничения.
Эти правила направляли агента к источникам, которые нужно проверить до вывода о поведении фичи. Скилл баг-репорта задавал шаблон результата и правила маршрутизации в нужный проект.
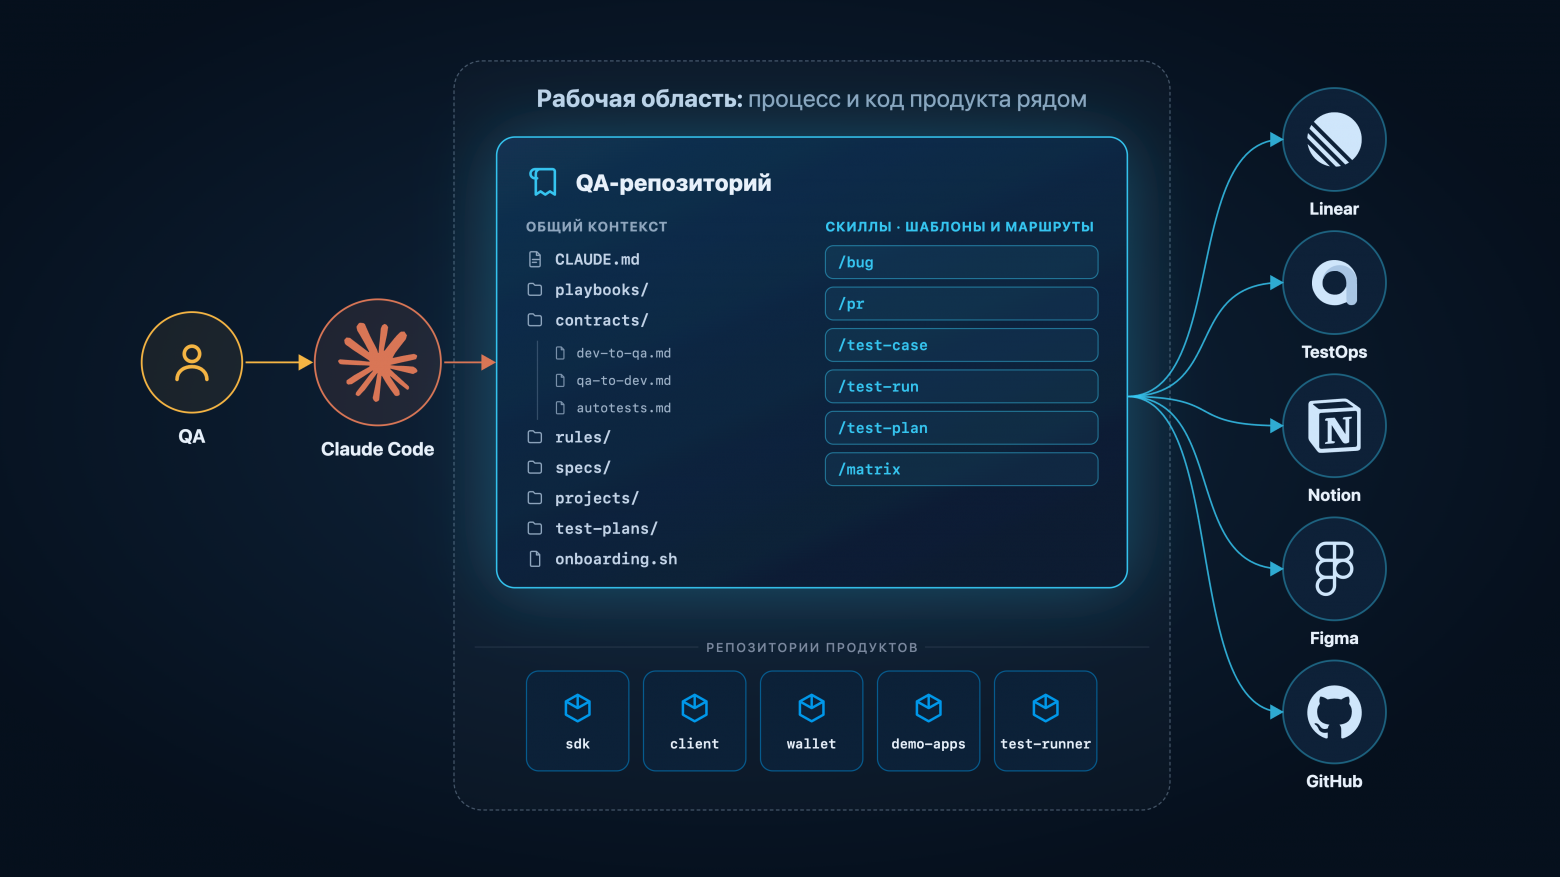
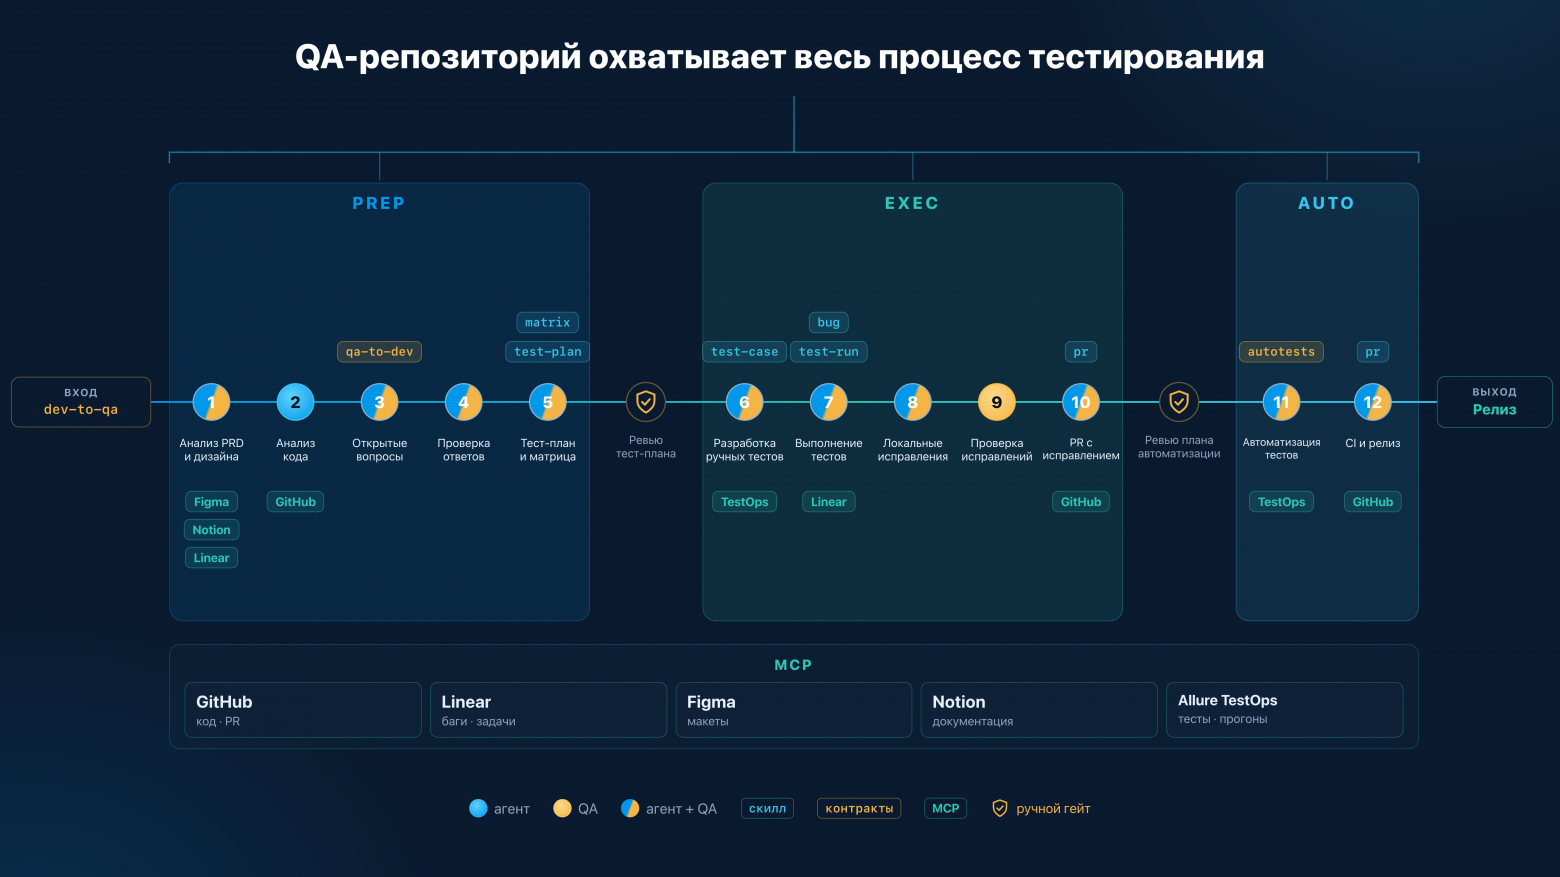
В этой реализации стандартные интеграции и MCP-серверы позволяют агенту читать код и документацию, работать с GitHub, Linear, Figma, Notion и Allure TestOps. Коннекторы не заменяют процесс: они дают доступ к данным и операциям, а инженер проверяет результат до перехода на следующую фазу или публикации во внешней системе. Фазовые гейты здесь были ручными: инженер проверял результаты и подтверждал переход. Часть условий перехода можно проверять автоматически, например наличие обязательных артефактов или результаты тестов.
PREP, EXEC и AUTO: переходы между фазами
Каждая фаза завершалась результатом, который можно было проверить на ревью.
PREP покрывает анализ и планирование, EXEC — ручное выполнение, AUTO — автоматизацию и CI. Агент ускорял PREP и AUTO и помогал собирать доказательства в EXEC.
Фаза | Вход | Работа агента | Инженер утверждает | Результат |
PREP | PRD, макеты, материалы передачи задачи, спецификация, diff | Находит расхождения, загружает инварианты, готовит вопросы, план и черновую матрицу | Объём проверки, предположения, вопросы к разработке, тест-план | Утверждённый тест-план и карта покрытия |
EXEC | Утверждённый план и окружение | Создаёт тест-кейсы, готовит черновики баг-репортов, анализирует затронутые компоненты | Результаты ручного прогона, классификацию находок и локальные исправления | Проверенные находки, доказательства, итоговая матрица |
AUTO | Итоговая матрица | Готовит UI-интеграционные тесты и фикстуры, отдельные E2E-сценарии и шаги прогона | Полноту проверок в тестах, границы моков, процесс запуска в CI | Тесты в продуктовом репозитории, UI-проверки в CI и отдельные E2E-прогоны |
Передача работы из разработки не должна повторять то, что агент может извлечь из кода. Она должна фиксировать то, чего в коде нет:
отклонения от спецификации и их обоснование;
предположения о внешних системах;
ограничения окружения и фича-флаги;
намеренно необработанные случаи;
фактический объём изменений и зоны повышенного риска.
У каждой фазы были свои условия завершения. PREP заканчивается после проверки источников, согласования объёма проверки и назначения владельца каждому открытому вопросу. EXEC начинается с утверждённого тест-плана. Переход в AUTO требует вручную классифицировать находки и зафиксировать границу теста: какое поведение использует реальную интеграцию, а какие внешние зависимости можно замокать, не потеряв проверяемый инвариант.
Тест с замоканным внешним сервисом может проверить запрос, который сформировал клиентский SDK. Но он не доказывает, что реальный сервис работает или что операция выполнилась в сети. Здесь сценарии с реальной отправкой запускаются отдельно: им нужно подтверждение человека, и они исключены из CI-гейта. Разрешения на запись во внешних системах оставались отдельным уровнем контроля.
Скилл для баг-репорта
Скилл для баг-репорта задавал требования к доказательствам, правила маршрутизации и условия остановки:
/bug <наблюдаемое поведение>

Доказательства: окружение, предусловия, воспроизведение,
фактический результат, ожидаемый результат, источник ожидания

Источники маршрутизации:
- Правила приоритетов: rules/bug-priority.md
- Карта ответственности: projects/team-ownership.md
- Карта проектов: projects/bug-routing.md

Определить: команду, проект, исполнителя, приоритет и метки.

Правила:
- Не заполнять неизвестные поля.
- Помечать корневую причину как гипотезу.
- Не создавать задачу, пока не подтверждены ожидаемый результат и маршрут.
- Если маршрут неоднозначен, остановиться и уточнить; не угадывать.
Агент собирал доказательства и готовил черновик баг-репорта. Я проверял факты и подтверждал создание задачи. Возможное исправление оставалось предложением до повторной проверки изменённой реализации.
Практический кейс: gasless-переводы
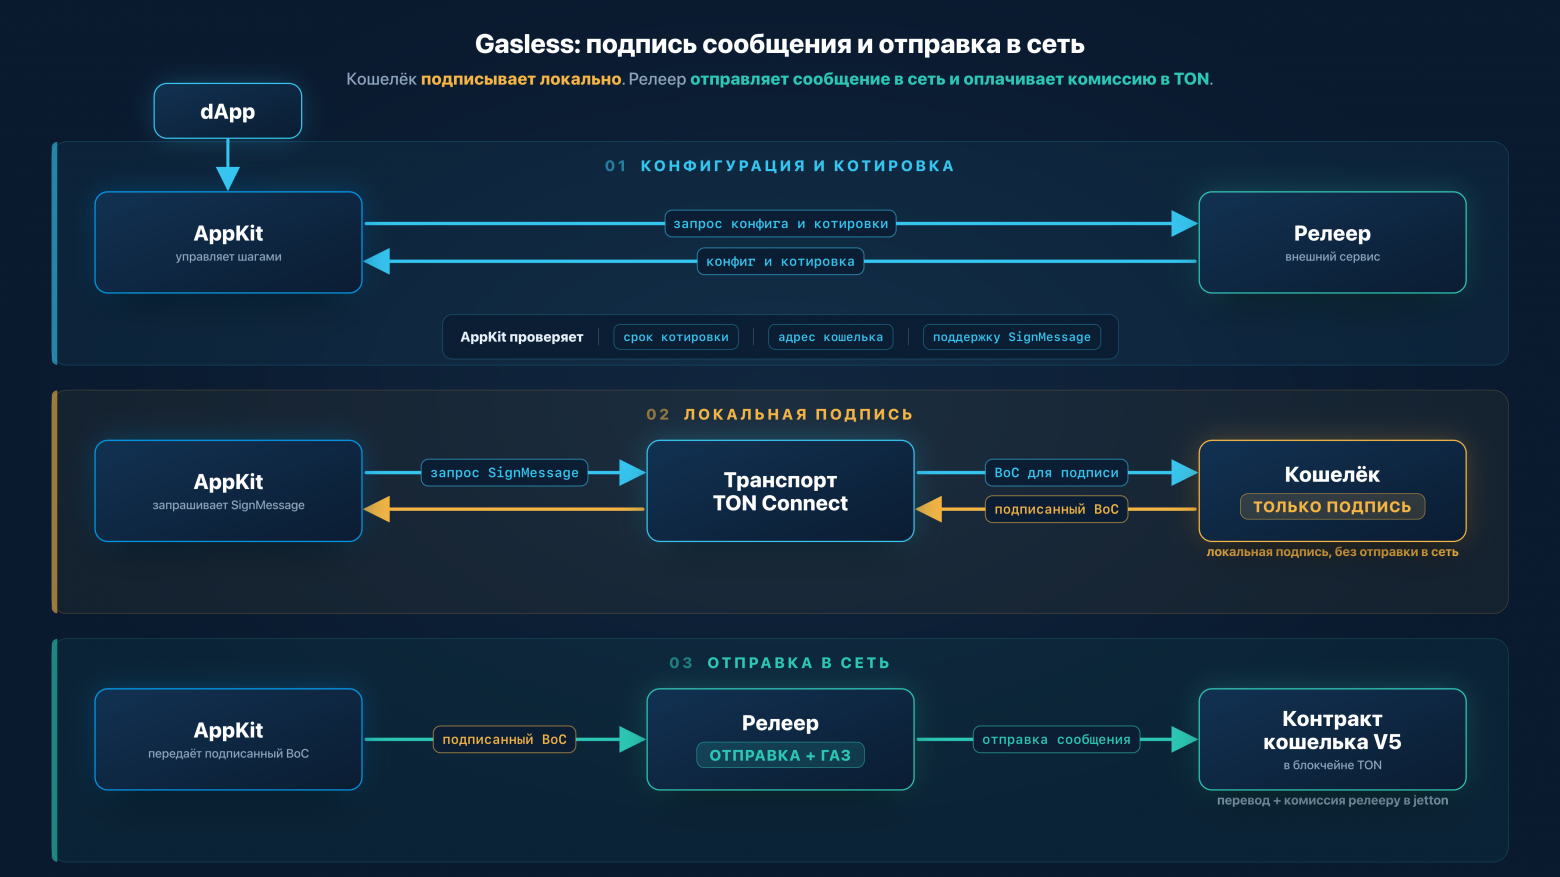
В AppKit я проверял gasless-переводы jetton — токенов в TON. В этом сценарии пользователь платил комиссию в jetton, а внешний релеер оплачивал сетевую комиссию в TON. Механика опиралась на Wallet V5.
AppKit получал конфигурацию и котировку, затем через TON Connect запрашивал подпись внутреннего сообщения. Кошелёк возвращал подписанное сообщение в формате BoC, а релеер отправлял его в сеть. Для тест-плана были важны поддержка нужного запроса кошельком, срок действия котировки и поведение при смене кошелька или сети.
PREP: от расхождений к тест-плану
Единого актуального описания фичи не было. Агент сопоставил документацию с кодом и нашёл расхождение: в документации ещё фигурировал estimateGasless, а в реализации уже использовался getGaslessQuote. Проверка истории Git показала, что API переименовали при рефакторинге. Я проверил этот вывод и оформил дефект документации.
В этой реализации требовались контракт Wallet V5 и заявленная приложением кошелька поддержка SignMessage. Одного V5 было недостаточно. Из этого условия получились два пути в тест-плане: успешный перевод с поддерживаемым кошельком и ожидаемый отказ без нужной capability.
Агент собрал расхождения и вопросы разработчику, я проверил их по коду и обсудил с разработчиком. По итогам обсуждения разработчик доработал несколько связанных мест:
после ошибки отправки старая котировка инвалидировалась, чтобы повторная попытка получала новую;
выбор токена для комиссии учитывал асинхронную загрузку конфигурации;
ошибки парсинга возвращались как типизированные ошибки;
при смене кошелька или сети режим gasless отключался.
После проверки соответствующих коммитов эти переходы вошли в тест-план. К ручному прогону были согласованы ожидания для успешного перевода, отказов и повторных попыток.
EXEC: ручной прогон и подготовка автоматизации
Протестированная версия независимого кошелька использовала контракт V5, но не заявляла SignMessage. Gasless оставался недоступным — это соответствовало ожидаемому поведению.
Для успешного пути я использовал контролируемый демо-кошелёк с поддержкой SignMessage. Вручную прошёл сценарий от включения gasless в dApp до подписи и проверки результата в mainnet. Перевод и комиссия списались в jetton, баланс TON не уменьшился.
Повторяемую подготовку между проверками выполняли скрипты, подключавшиеся к уже открытому Chrome через Chrome DevTools Protocol (CDP). В браузере сохранялось установленное по QR подключение к кошельку. Скрипты выполняли промежуточные действия, а подпись, критичные переходы UI и итог операции проверял вручную.
Дополнительные проверки на Playwright покрывали вёрстку на разных размерах экрана, состояние без подключённого кошелька, отображение ошибок релеера, XSS через замоканный ответ и отсутствие секретов в консоли. Эти результаты учитывались отдельно от ручного E2E-прогона. Одноразовые скрипты подготовки не считались самостоятельными тест-кейсами.
По итогам EXEC я уточнил матрицу автоматизации с учётом проверенных сценариев, доступного окружения и фикстур. Она определяла, какие проверки можно повторять в CI и какие требуют отдельного прогона с реальной отправкой.
AUTO: из матрицы в CI-тесты
Для UI-интеграционных проверок в CI я выбрал фикстуру из двух вкладок: тестируемый dApp и контролируемый демо-кошелёк. Между ними работал реальный TON Connect, кошелёк подписывал сообщение локально. Мок релеера перехватывал запросы конфигурации, котировки и отправки.
Тесты по согласованной матрице помог реализовать агент. На ревью я проверял ассерты и границы моков. В набор вошли, например, обновление котировки после смены токена комиссии, восстановление формы после отказа от подписи и отсутствие повторного запроса отправки.
Один из тестов выполнял локальную подпись и проверял запрос к релееру. Сокращённый фрагмент:
const capture: SendCapture = { requests: [] };
await mockGaslessConfig(app, { assets: [USDT_MASTER] });
await mockGaslessEstimateOk(app);
await mockGaslessSendOk(app, { capture });

await connectWallet({ widget, wallet });
await minter.openTransfer(USDT_MASTER);
await minter.enableGasless();
await minter.fillTransfer(DEFAULT_RECIPIENT, TRANSFER_AMOUNT);

await minter.sendButton.click();
await wallet.signMessage(true);

await expect.poll(() => capture.requests.length).toBe(1);
expect(capture.requests[0]?.boc).toBeTruthy();
expect(capture.requests[0]?.wallet_public_key).toBeTruthy();
Здесь проверялись однократность запроса и наличие BoC и публичного ключа. Доставку транзакции и её выполнение в блокчейне подтверждал отдельный E2E-прогон с реальной отправкой. TON Connect в CI оставался реальным, поэтому сетевые зависимости сохранялись.
E2E-сценарии с реальной отправкой исключались из обычного CI-прогона фильтром:
npx playwright test --config e2e.config.ts \
  --grep-invert "@real-send"
UI-интеграционные тесты из матрицы остались в продуктовом репозитории и запускались в CI на релевантных изменениях PR. Человекочитаемые шаги получались из тестового кода и публиковались в TestOps. Автоматизированные сценарии не дублировались отдельными ручными тест-кейсами.
Превращайте сбои в версионируемые правила
Повторяющиеся ошибки становились основой новых правил для агента. Например:
R2 — Проверяй утверждения «не затронуто» по ветке

Утверждение в передаче задачи о том, что область не затронута, — гипотеза.
Проверь её по текущей ветке и изменениям в коде. «Пакеты не менялись»
не означает, что «поведение не менялось»: регрессия может быть
в связующем коде приложения.
Чем приходится жертвовать
Эта архитектура не максимизирует автономность агента. Она ограничивает его полномочия, чтобы результаты оставались проверяемыми.
Решение | Польза | Цена и риск |
Отдельный репозиторий QA-процесса | Переиспользуемые правила и единый control plane для продуктов | Процесс может отставать от кода; агент обязан читать актуальную ветку и diff до вывода. |
Ручной гейт между PREP, EXEC и AUTO | Снижает риск выдуманных фактов, неверных границ проверки и слабых проверок в тестах | Инженер остаётся узким местом: пропускная способность процесса не масштабируется автоматически. |
Отбор комбинаций с учётом рисков | Объём тестирования остаётся управляемым | Непроверенные комбинации всё ещё риск; их нужно фиксировать явно. |
Моки внешних API в CI | Повторяемый CI-гейт без реальной отправки операций во внешнюю систему | CI не доказывает поведение реального кошелька или внешнего сервиса. |
Отдельный путь для проверки реальной интеграции | Проверяет выбранный сквозной путь интеграции | Нужны ручной запуск, контролируемое окружение и явное одобрение. |
Скиллы с маршрутизацией | Стандартизируют результат и место хранения | Маршрутизацию нужно поддерживать по мере изменений проектов и инструментов. |
Что изменилось на практике
Это практические оценки для задач с SDK сопоставимого масштаба на основе моей работы как основного QA-практика. Это не универсальные бенчмарки и не результаты контролируемого эксперимента.
Фаза QA | Без процесса с ИИ | Process-as-Code + агент | Комментарий |
PREP: анализ, планирование, декомпозиция, аудит | 8–14 ч | 2–4 ч | Агент готовит черновик с опорой на доказательства; инженер его валидирует. |
EXEC: ручное выполнение | 4–8 ч | 4–8 ч | Надёжная ручная проверка не становится существенно быстрее. |
AUTO: автотесты и CI | 16–32 ч | 6–14 ч | Агент ускоряет реализацию и рефакторинг; инженер оценивает полноту покрытия и достаточность проверок. |
Итого | 28–54 ч | 12–26 ч | Операционные оценки для сопоставимых фич. |
На момент этих оценок подход был внедрён недавно и глубоко применён только к ограниченной части продукта. Эти оценки не стоит читать как доказательство полного покрытия или измеренного снижения количества дефектов, ушедших в прод.
Самый большой эффект дал не автоматический финальный вердикт. Он появился потому, что сбор доказательств стал быстрее, а переделок из-за неограниченного контекста и незафиксированных предположений стало меньше.
Масштабируйте процесс, а не полномочия агента
Чтобы использовать этот подход в команде, нужно:
назначить владельцев правилам, спецификациям и инвариантам;
версионировать контракты скиллов и правила маршрутизации, а для каждого сохранённого артефакта фиксировать использованную редакцию процесса;
обновлять процесс по повторяющимся сбоям и переделкам после ревью.
В публичном companion-репозитории есть обобщённая версия структуры.
Начните с одного рискованного пути
Не начинайте с программы «автономный QA для всей компании».
Выберите одну фичу, которая проходит через несколько систем и регулярно требует ручного регресса.
Соберите минимальный полезный control plane: индекс контекста, несколько инвариантов, один контракт передачи работы, один скилл и матрицу покрытия.
Определите фазовые гейты до добавления автономности. Зафиксируйте, что агент вправе подготовить, что должен одобрить человек и где границу обеспечивают права учётных записей или защита веток.
Разделите детерминированные CI-проверки и результаты сквозных проверок с реальной интеграцией. Явно напишите, что доказывает каждый путь — и чего он не доказывает.
Считайте каждый повторяющийся сбой запросом на изменение control plane.
Цель — не автономный QA-агент. Цель — QA-система, которая может принять больше работы агента, не отдавая ему инженерные полномочия.
Английская версия: Building a Control Plane for AI Agents in Software QA

