Мы в отделе технической документации переводим много текста: технические справочники, интерфейсные строки, исходный код и комментарии к нему. Счет идет на сотни документов в самых разных форматах, которые нужно постоянно переводить. Платный облачный CAT‑сервис, которым мы пользовались, обходился все дороже и все меньше был под нашим контролем. Мы решили эту проблему сами: подняли on‑premise инфраструктуру локализации с LLM, почти без участия разработки. В статье пошагово разбираю, как мы к этому пришли — от выбора между Zing и Weblate до финального пайплайна с Serge, Dify и своей моделью.
Привет, Хабр! Меня зовут Руслан Ташметов. Я учусь в магистратуре МГУ на факультете искусственного интеллекта и работаю в YADRO с начала стажировки «Импульс» 2025 года.
Три требования к новому CAT‑инструменту
Начну с предыстории. Долгое время мы переводили документацию в Smartcat. Это удобный CAT‑инструмент (Computer‑Assisted Translation) с браузерным интерфейсом, памятью переводов, глоссариями и автоматической проверкой качества.
Но у удобства была цена, причем буквально: тариф считается по сетке за каждое загруженное в него слово (неважно, новое оно или уже переведенное), а проектов у нас сотни. Когда Smartcat на волне развития LLM превратился в «единую ИИ‑платформу для контента на любом языке» и подорожал, мы и перестали откладывать переход на локальные LLM.
Помимо снижения стоимости, к новому CAT‑инструменту у нас было три требования:
Размещение всей информации на серверах YADRO. При использовании сторонних сервисов перевода корпоративные тексты передаются на внешние серверы, то есть третьим лицам. Для нас было важно исключить такую передачу.
Возможность подключать и модифицировать параметры работы с LLM для перевода.
Наличие клиент‑серверной архитектуры или веб‑интерфейса для работы.
Zing vs Weblate: кто дожил до продакшена
В поисках CAT‑инструмента мы изучили отечественные и зарубежные решения. Нам хотелось избежать сложностей с оформлением договоров на получение услуг и дополнительных затрат, поэтому нас заинтересовали решения из области open source‑инструментов. После отсеивания инструментов по трем требованиям осталось два кандидата: Zing и Weblate.
Особенности Zing
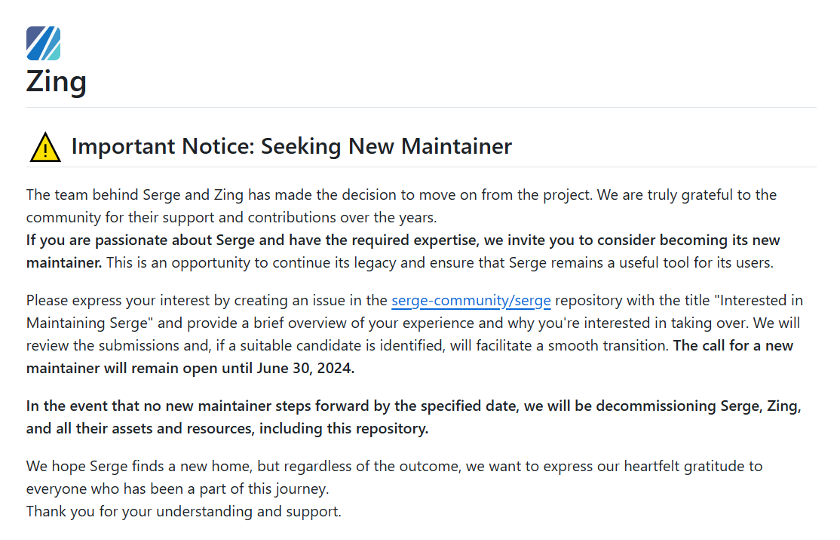
Zing выглядел логичным выбором. Это бесплатный сервер перевода от Evernote с открытым исходным кодом и веб‑интерфейсом. Zing разработали для бесшовной интеграции с Serge и поддержки всех его функций. Serge — это open source‑инструмент от Evernote, который вытаскивает тексты на перевод из Git‑репозитория и возвращает готовые переводы обратно.
Но это решение тяжело поддерживать. Команда Evernote официально объявила, что больше не поддерживает Zing и ищет нового мейнтейнера. При этом прямо было сказано: если сопровождающий не найдется, проект будет закрыт. Строить инфраструктуру на инструменте с таким будущим не хотелось.
Weblate: та же функциональность, но с поддержкой
С Weblate ситуация была другой. Проект активно развивается: выходят новые версии, исправляются ошибки, добавляются новые возможности, а в разработке участвует сообщество контрибьюторов. Помимо поддержки со стороны сообщества, у Weblate есть профессиональная поддержка от команды, которая развивает продукт. Поэтому с точки зрения сопровождения этот вариант выглядел значительно надежнее.
Подходил Weblate и по техническим требованиям: самостоятельный веб‑инструмент для локализации с API и интеграцией с системами контроля версий. В отличие от Zing, он не привязан к Serge, поэтому эти компоненты можно использовать и развивать независимо друг от друга.
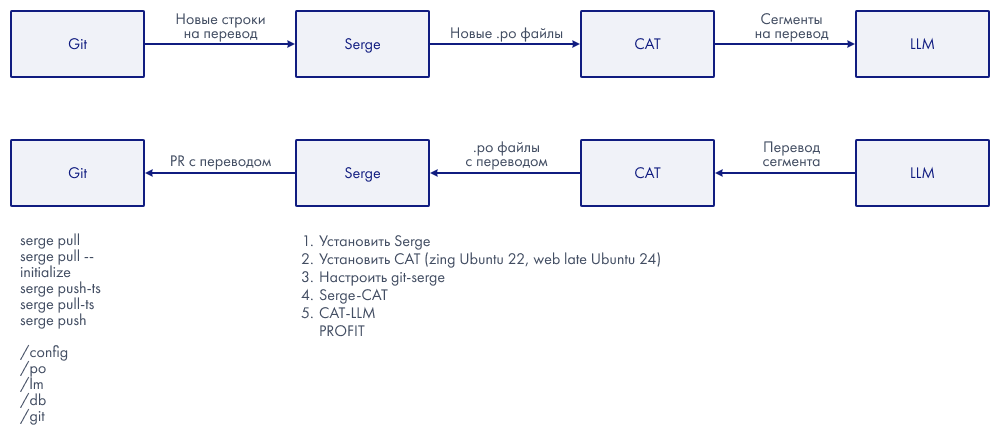
В итоге инфраструктура локализации сложилась из двух основных компонентов — Serge и Weblate. Они решают разные задачи и вместе образуют единый конвейер локализации.
Все форматы к одному знаменателю
Прежде чем перейти к инструментам, немного о форматах. У бизнеса есть запрос на перевод различных форматов файлов: DITA‑документы, UNI‑конфиги, PDF и исходный код. Чтобы не разбираться с каждым форматом по отдельности, текст на перевод извлекается из исходного файла и сохраняется в формате PO — это стандарт в индустрии локализации.
PO (Portable Object) — текстовый формат GNU gettext. Это просто пары строк:
msgid "Server configuration"
msgstr "Конфигурация сервера"
PO‑файлы также могут содержать комментарии переводчика и служебные пометки — например, идентификаторы строк, сведения об их источнике, контекст использования или другие метаданные, необходимые для обработки перевода. Формат легко читается человеком и универсален.
Напомню, что Serge находит нужные ветки и файлы, определяет в них текст, который должен попасть в локализацию, извлекает его и формирует PO‑файлы для переводчиков. Serge поддерживает разные типы файлов и использует соответствующие парсеры, чтобы извлекать из них переводимый текст. Благодаря этому один и тот же процесс локализации можно применять к разным компонентам продукта, даже если строки в них хранятся по‑разному.
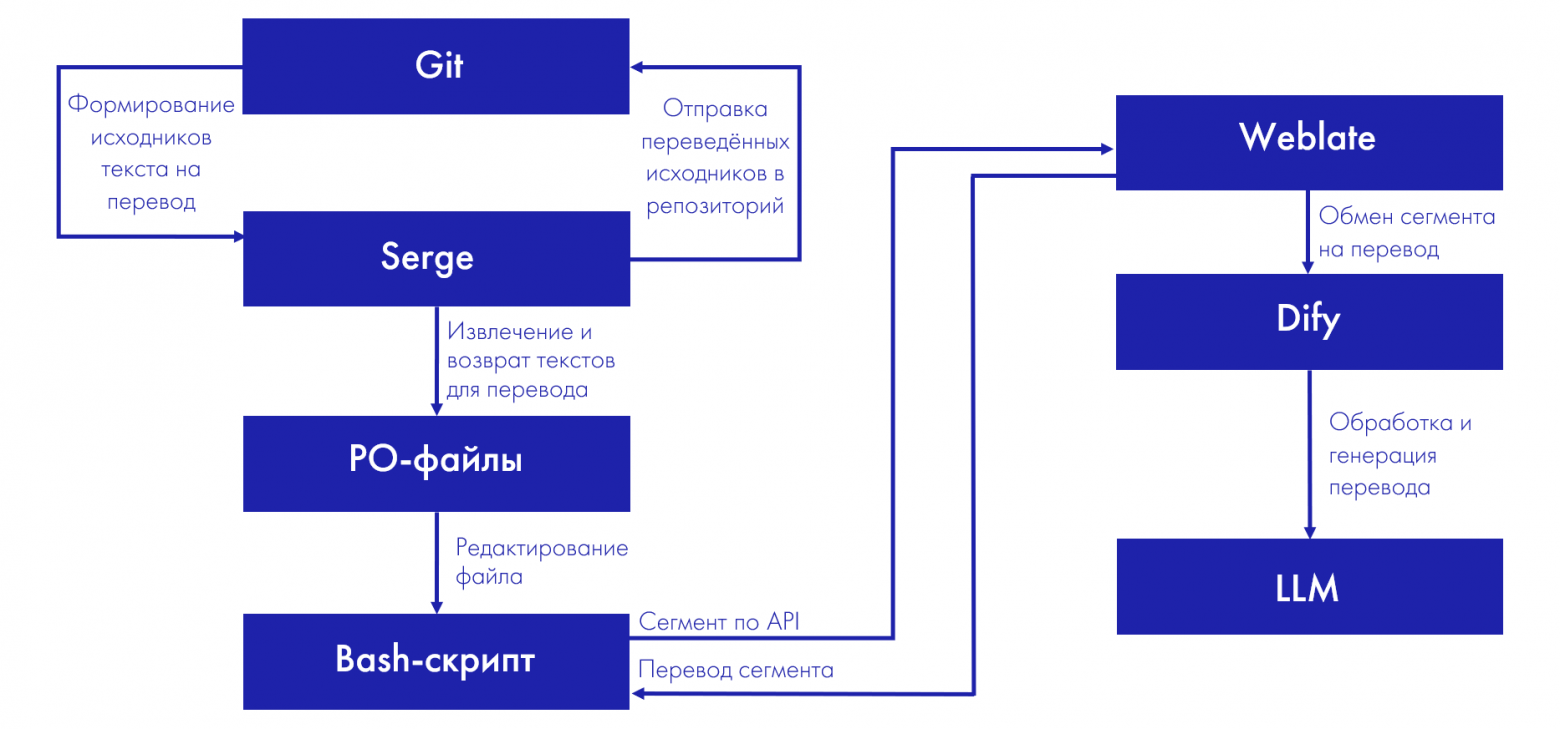
Serge автоматизирует весь цикл работы с переводами. В упрощенном виде процесс выглядит так: исходные файлы в Git → извлечение строк → PO‑файлы → перевод → интеграция переводов в исходные файлы → Git.
Сначала Serge получает исходные файлы из репозитория и с помощью подходящего парсера извлекает из них строки, предназначенные для перевода. Эти строки попадают в PO‑файлы, с которыми уже работают переводчики.
После перевода процесс идет в обратную сторону: Serge берет готовые переводы из PO‑файлов, с помощью того же механизма интегрирует их в исходные файлы и возвращает результат в систему контроля версий.
Такое разделение позволяет каждой стороне работать в привычной для нее среде. Разработчики продолжают работать с исходными файлами и Git, а переводчикам не приходится разбираться в форматах.
Но Serge — лишь часть локализационного цикла. Общий цикл выглядит так:
Обзор интерфейса и возможностей Weblate
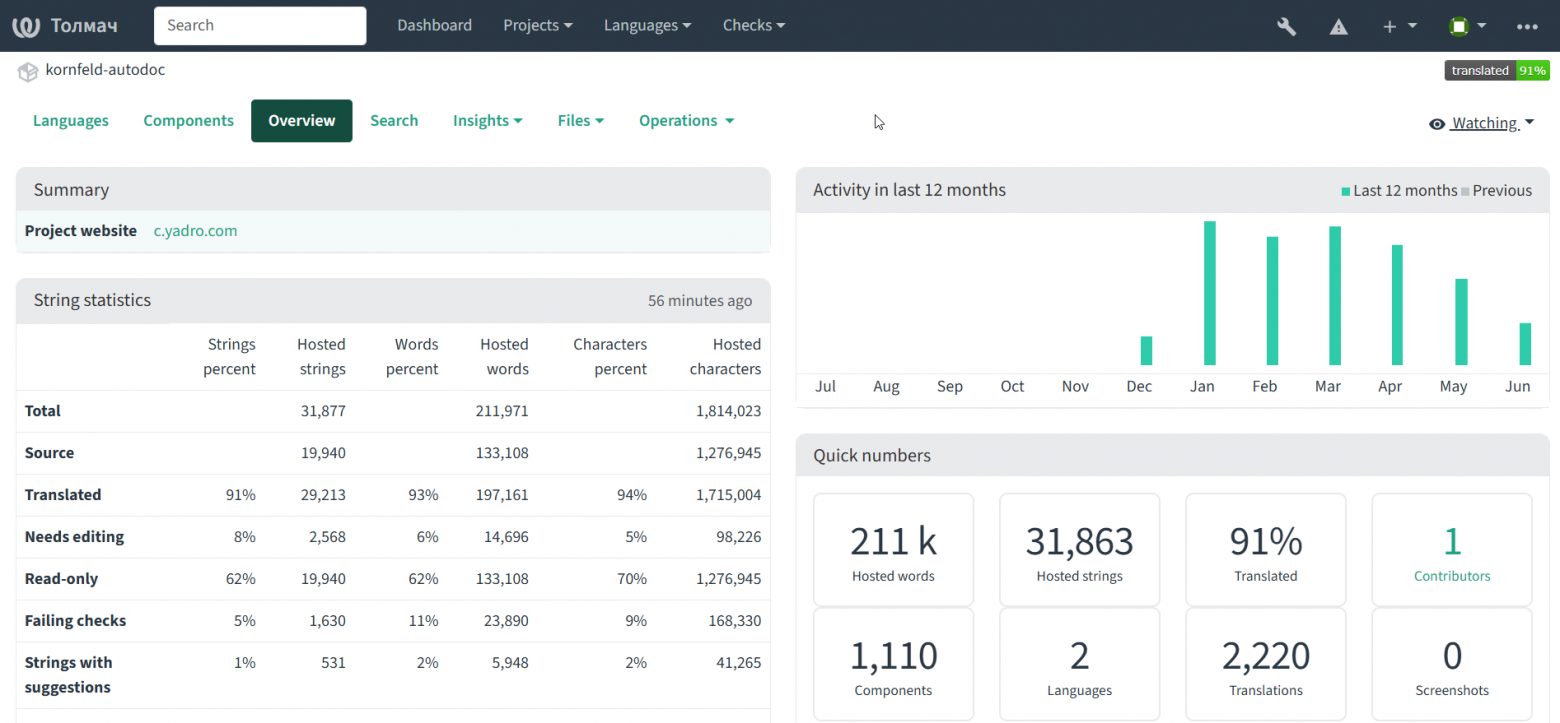
Сегменты для перевода в Weblate организованы по проектам и компонентам. Каждый проект называется ровно как репозиторий и содержит в себе компоненты — файлы на перевод.
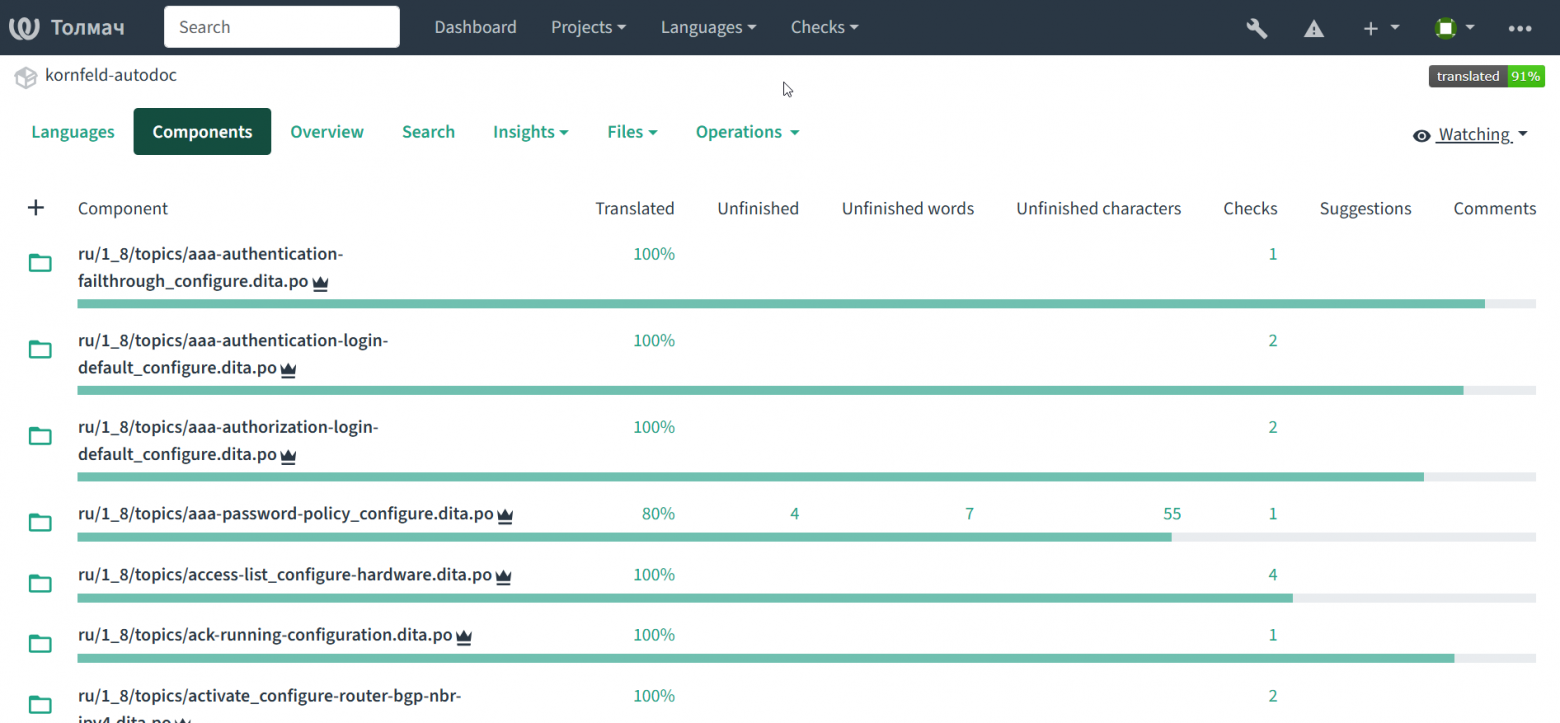
Weblate автоматически отслеживает статус каждой строки и категоризирует их: переведенные, незаконченные, непереведенные, с пометкой «К работе» и с пометкой о непройденной автоматической проверке на правильность перевода. Автопроверки помогают отлавливать и массово править частые ошибки в переводе. Например, в переведенной строке не хватает знака препинания, есть перенос строки или вообще находится тот же самый текст, что и в исходной строке.
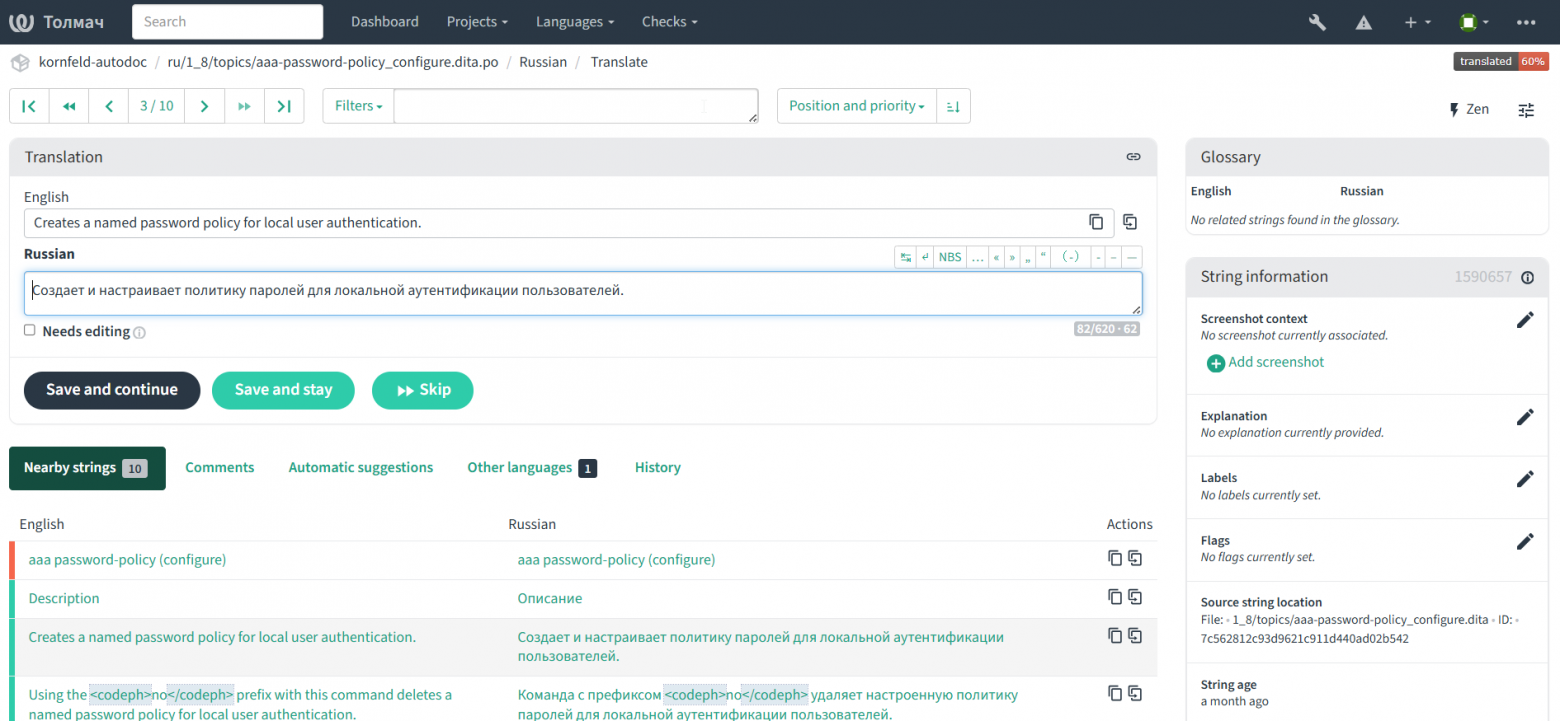
В окне редактирования компонента мы посегментно обрабатываем его содержимое, переключаясь между вкладками:
Nearby strings — соседние сегменты в компоненте для понимания контекста.
Other occurrences — то, как этот сегмент переводится в других компонентах.
Comments — можно предложить или обсудить с коллегами текущий перевод.
Automatic suggestion — автоматическое предложение для перевода с тремя возможными источниками: память переводов, схожесть перевода с другими компонентами и ИИ‑перевод.
Other languages — то, как исходный сегмент переводится на другие языки.
History — полная история изменений строки с датами и аккаунтами, вносившими изменения.
Для быстрого просмотра всего массива сегментов и перевода есть режим Zen.
Внутри мы назвали нашу сборку «Толмач» — в прошлом так называли переводчиков‑посредников, помогавших представителям разных народов понимать друг друга в дипломатии, торговле и других ситуациях, где особенно важна была точность коммуникации.
«Толмач» — это не только Serge и Weblate, но и интеграция с Dify и LLM. В основном наши заказчики видят только веб‑интерфейс, поэтому можно ошибочно подумать, что мы просто переименовали Weblate в Толмач, но это не так.
ИИ и ЫЫ
Самое интересное начинается на этапе перевода. Теперь вместо внешних сервисов типа DeepL или Google Translate мы используем собственный инференс‑кластер.
Инференс‑кластер — это выделенная локальная IT‑инфраструктура компании для запуска обученных моделей искусственного интеллекта. Он дает полный контроль: данные никуда не уходят, стоимость фиксирована инфраструктурой, а модель и промпт можно заменить в любой момент.
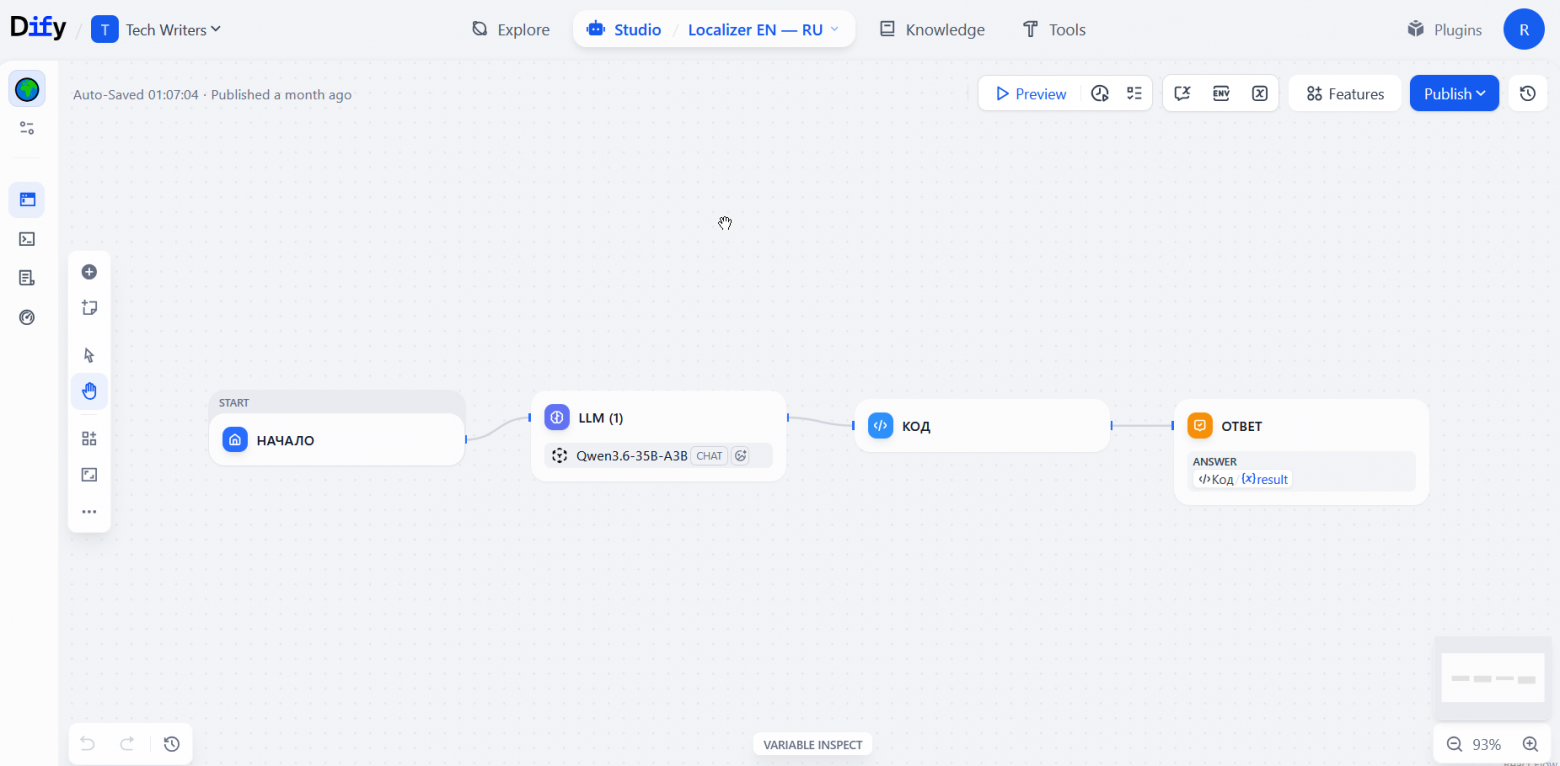
Роль прослойки между Weblate и моделью играет Dify — open source‑платформа для разработки и эксплуатации приложений на базе больших языковых моделей (LLM). По сути, это слой между моделью — Qwen, Deepseek, другой GPT‑подобной — и бизнес‑логикой. Dify позволяет собирать ИИ‑продукты без глубокого погружения в инфраструктуру.
Проект объединяет в себе:
конструктор LLM‑приложений (чат‑боты, ассистенты, агенты),
orchestration‑слой (workflow / пайплайны),
инструменты работы с базами знаний (RAG),
API‑шлюз для интеграции в существующие системы.
Интерфейс у Dify визуальный, логика задается через блоки. Пайплайн для перевода совсем прост: текст → модель → постобработка → ответ. Для перевода мы используем reasoning‑LLM Qwen3.6–35B‑A3B.
Промпты и буква Ё
Промпт для модели Qwen
You are a professional translator at an IT company that manufactures high‑tech equipment. All the terms are related to programming and engineering.
Translate the text from English into Russian, strictly following the instructions:
— DO NOT ADD YOUR OWN COMMENTS TO THE RESPONSE WITH THE TRANSLATED TEXT.
— Be sure to translate all lines of the original text.
— The formatting of the translated text must be exactly the same as in the original text.
— Do not invent markup and do not add extra tags to the translation.
— The number of lines in the translated text must be exactly the same as in the original text.
— The number of opening and closing tags in the translated text must be exactly the same as in the original text.
— If a word or words in the original text are enclosed in tags, then preserve exactly the same tags around the translation of that word or words.
— If the original text contains fragments that look like code, then leave these fragments unchanged in the translated text.
— If the original text contains fragments that look like code or those fragments are in codeblock or codeph tags, then leave these fragments unchanged in the translated text.
— If the original text contains words that are concatenated together or connected together with an underscore, then leave these words unchanged in the translated text.
Разберем следующий кейс: в документации исторически не принято использовать букву «ё». Если мы дадим модели строку «Hedgehog in the Fog», она переведет ее как «ёжик в тумане». При этом как бы мы ни пытались внушить ей через длинный промпт, что нам не нужна буква «ё» и «ёжик» на самом деле — «ежик», она всегда будет упорно выдавать «ё».
Вся эта мышиная (ежиная) возня в промптах, относящаяся к форматированию отдельных символов, сильно забивает «мозги» модели и прилично снижает качество перевода.
Поэтому все, что можно сделать кодом, нужно и правильно делать кодом:
def main(arg1: str):
 	text = arg1.replace("ё", "е").replace("Ё", "Е")

 	return {
     	"result": text
 	}
Когда мы открываем вкладку Automatic suggestion в окне редактирования компонента, Weblate отправляет исходную строку на перевод в Dify. На обработку строки снизу понадобилось примерно 0,63 секунды.
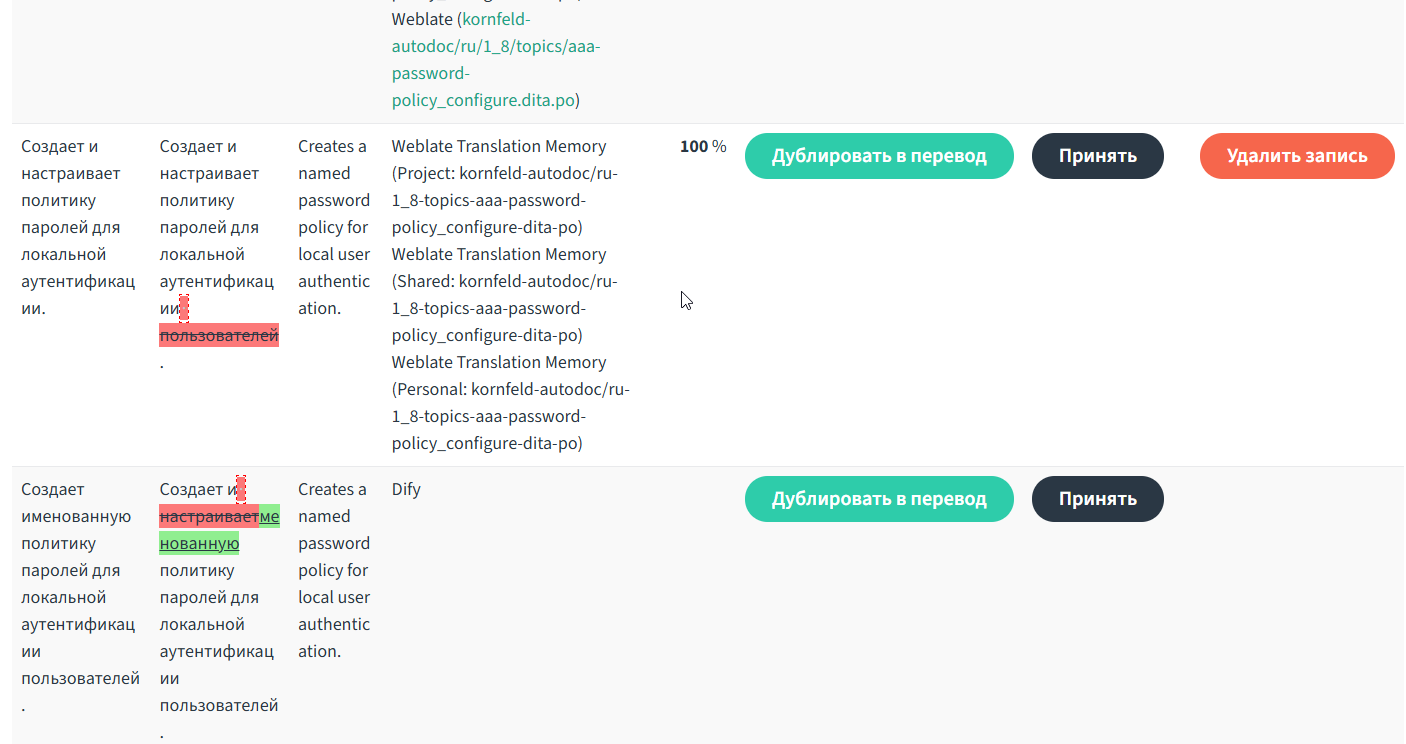
Weblate изначально поддерживает подключение сервисов машинного перевода, которые администратор может включить в разделе автоматических подсказок. Для интеграции с Dify мы добавили его через конфигурационные файлы Docker. При запросе подсказки Weblate передает исходную строку и доступный контекст в настроенный Dify. Там запрос обрабатывается языковой моделью, а полученный перевод возвращается и отображается пользователю в привычном интерфейсе.
Загрузку переводов в Weblate мы также автоматизировали, потому что стандартные команды для отправки и получения сегментов для Weblate не работали. После формирования PO‑файлов в Serge скрипт находит их в каталоге проекта и загружает через REST API в соответствующие компоненты Weblate. Скрипт проверяет наличие компонента, при необходимости создает его, а затем добавляет или обновляет файл русского перевода. Для обращения к API используется токенная авторизация. Weblate предоставляет отдельные API‑методы для создания компонентов, добавления языков и загрузки файлов переводов.
ЫЫ
Без проблем, конечно, не обошлось. Основные сложности, типичные для LLM:
может галлюцинировать и менять смысл,
не всегда соблюдает терминологию,
иногда ломает форматирование строк.
ИИ обеспечивает качественный перевод, но не всегда консистентный из‑за посегментной работы с текстом. Чтобы модель не добавляла чего‑то в духе «конечно, дружище, вот твой перевод: <blah-blah>», мы задействовали структурный выход — определили единственное поле: russian_translation: string, «Перевод исходного текста на русский язык». Ответ модели возвращается в формате JSON, после чего система извлекает значение этого поля. В JSON ИИ посторонний текст дописывать стесняется. И тогда системный промпт становится предельно лаконичным:
Переведи отрывок текста с английского на русский язык, сохранив его структуру.
Желаемый формат выхода в соответствующем поле блока в Dify:
{
   "type": "object",
   "properties": {
 "russian_translation": {
   "type": "string",
   "description": "Перевод исходного отрывка текста на русский язык."
 }
   },
   "required": [
 "russian_translation"
   ],
   "additionalProperties": false
 }
Но именно поэтому финальным этапом всегда остается вычитка документа техническим писателем или редактирование переводов через редакторский пайплайн. LLM остаются вероятностными системами и требуют дополнительных механизмов контроля — как на уровне формата, так и на уровне содержимого.
В шесть раз дешевле Smartcat
Раз уж мы считаем деньги — вот во сколько нам обходится перевод на собственном инференс‑кластере. Ниже разбивка по длине сегмента: чем он длиннее, тем дешевле каждое отдельное слово.
Расчет основан на стоимости видеокарты в 5 млн рублей, сроке ее службы в 5 лет и постоянной равномерной загрузке на уровне 30–40%. В него не входят затраты на сервер, электроэнергию, зарплаты обслуживающих инженеров и другие операционные расходы, поэтому реальная себестоимость будет выше.
Количество слов в промпте | Количество токенов | Общая стоимость в рублях | Стоимость слова в рублях |
1 | 500 | 0,4 | 0,4 |
50 | 700 | 0,56 | 0,0112 |
125 | 1000 | 0,8 | 0,0064 |
250 | 1500 | 1,2 | 0,0048 |
Даже в самом дорогом сценарии обработки одно слово обходится примерно в 0,40 рублей. Для сравнения: текущие тарифы Smartcat составляют около 2,5 рублей за слово, то есть примерно в шесть раз больше.
Стоимость слова зависит от длины сегмента: чем больше в нем слов, тем дешевле каждое из них. Самый дорогой случай — сегмент из одного слова, и даже тогда цена не превышает 40 копеек.
В следующей части статьи я дам полный гайд по развертыванию и разберу все кейсы, которые мы локализовали. Долой проприетарщину!