Я веду несколько сайтов на фреймворке Next.js, и по рабочим журналам на них чаще всего повторяются четыре ошибки: полная копия сайта на www, код 200 вместо 404 на несуществующих адресах, теги title и canonical не там, где их ждет робот, и лишние параметры в адресах.
В статье пройду по пути страницы от её находки поисковиком до включения индекс:
что получает робот и чем ответ сервера отличается от готовой страницы;
как Google выполняет JavaScript и сколько страница ждет по замеру Vercel и MERJ;
что сказано про JavaScript в справке Яндекса и почему этот режим в бете;
где Next.js с версии 15.2 кладет
titleиcanonicalдля разных ботов;почему несуществующий адрес отвечает 200 вместо 404;
как справиться с дублями:
www, canonical,Clean-param;как сообщить поисковикам о страницах, что значат статусы Search Console и при чем тут бюджет обхода;
что менялось в Next.js с 14 по 16 и какие семь проверок сделать у себя.
Что получает робот поисковика
У страницы на Next.js три версии: HTML из ответа сервера, страница после работы JavaScript и то, что поисковик записал в индекс. Разработчик смотрит на вторую, в браузере, а робот сначала получает первую.
Мартин Сплитт из Google в марте 2025 года заметил, что многие до сих пор смотрят исходный код. Индексирует же Google уже обработанный HTML: «A lot of people are still looking at view source. That is not what we use for indexing» (Search Engine Journal, 31.03.2025). Исходный HTML все равно важен: по первому ответу сервера Google решает, запускать ли JavaScript вообще.
Документация Google о JavaScript (обновлена 4 марта 2026) описывает: сканирование, рендеринг (выполнение скриптов, после которого получается готовая страница) и индексирование. На рендеринг идут все страницы с кодом 200, если мета-тег robots или заголовок не запрещают индексацию (Google Search Central). Страница может ждать очереди несколько секунд или дольше.
Обе версии видны так: curl (программа, которая скачивает страницу, как это делает робот) с разными User-Agent (так сайту представляется браузер или робот) показывает ответ сервера, а проверка URL в Search Console показывает страницу после рендеринга.
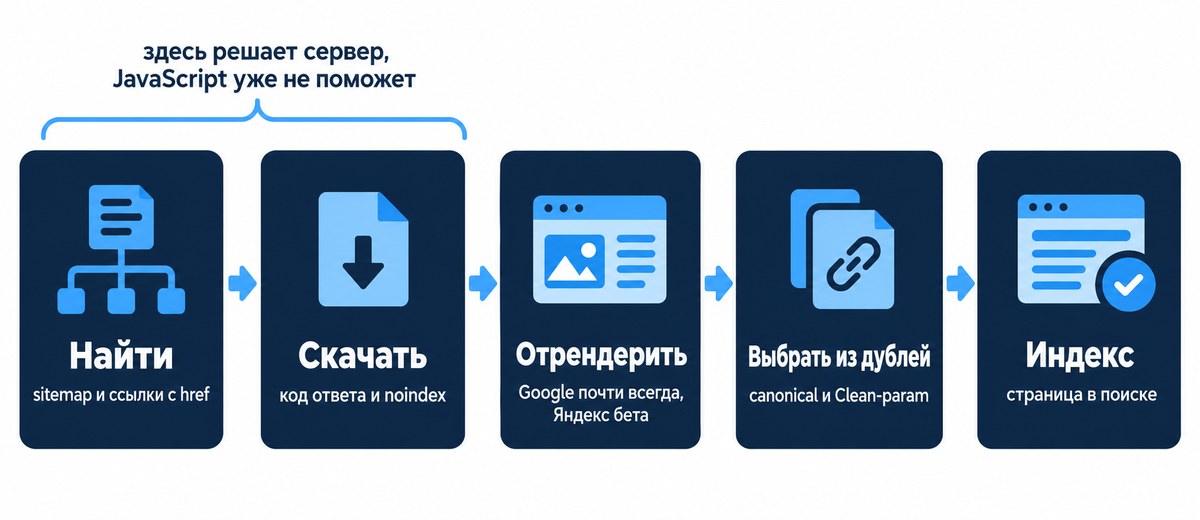
Путь страницы от обнаружения до индекса. На первых двух шагах решает ответ сервера, и JavaScript здесь не поможет.
Google: JavaScript выполняется, но сначала смотрят на ответ сервера
Самый крупный открытый замер сделали Vercel и MERJ. Они разобрали больше 100 000 обращений Googlebot за апрель 2024 года, в основном к nextjs.org, плюс данные двух небольших сайтов. Ответы с ошибками и неиндексируемые страницы они убрали (Vercel, 31.07.2024). Все остальные HTML-страницы, в том числе со сложным JavaScript, Google отрендерил полностью.
Сколько страница ждала между обходом и рендером, авторы посчитали по 37 000 страниц, у которых есть и запись в журнале сервера, и отметка о завершении рендера:
Доля страниц | Рендер завершился в течение |
|---|---|
25% | около 4 секунд |
50% | 10 секунд |
75% | 26 секунд |
90% | около 3 часов |
95% | около 6 часов |
99% | около 18 часов |
Сайтов было мало, поэтому для вашего домена это лишь ориентир. Авторы пишут, что четверть страниц отрендерилась за 4 секунды, так что представление о долгой очереди не подтвердилось: большие задержки были исключением.
Страницы с кодами 3xx, 4xx и 5xx Google не рендерил. Страницы с noindex в исходном HTML тоже, потому что скрипт, который собирался убрать этот тег, не успеет запуститься. Vercel пишет об этом, а документация Google подтверждает, что при noindex рендеринг может быть пропущен. Все, что решается до рендера, JavaScript на странице уже не изменит.
Из документации Google вытекают еще три правила:
Ссылки должны быть элементами
<a>с атрибутомhref. Переход черезonClickбез настоящей ссылки Google не увидит.Адреса с решеткой, например
#/products, Googlebot надежно не разбирает. Нужен History API, в Next.js он работает сразу.Canonical лучше задавать в HTML и не менять скриптом. На странице должен быть один тег canonical, иначе результат может быть неожиданным.
Динамический рендеринг, то есть отдельную версию страницы для ботов, Google называет временным обходным решением (страница обновлена 10 декабря 2025). Вместо него он советует серверный рендеринг (страницу собирает сервер), статическую генерацию (страницу собирают заранее, при сборке сайта) или гидратацию (браузер оживляет готовый HTML скриптами). Next.js все это умеет сам, так что пререндер-сервис для ботов не нужен.
Яндекс: JavaScript в бете, надежнее держать все в HTML
Раздел справки «Индексирование страниц с JavaScript» в Вебмастере помечен как бета (справка Яндекса). Настройка находится в разделе «Индексирование», подраздел «Рендеринг страниц JavaScript». По умолчанию включено «На усмотрение робота Яндекса»: робот сам решает, выполнять ли скрипты, и может сравнить, на какой версии страницы, с JavaScript или без него, контента больше.
Для сайта с серверным рендерингом в справке советуют запретить рендеринг. Я эту настройку у нас еще не переключал и результатов пока не знаю. Еще в справке предупреждают, что выполнение скриптов может создавать лишнюю нагрузку на сервер.
Если контент подгружается с задержкой, Яндекс предлагает объект window.YandexRotorSettings, он должен создаваться до события DOMContentLoaded. В нем есть параметр NoJsRedirectsToMain. Он нужен, потому что робот считает вызов window.history.back() переходом на главную, и на главную может попасть контент других страниц. Узнать об этом можно по выдаче: описание главной меняется на описание внутренней, а тег canonical главной подменяется адресом внутренней.
Свежего независимого замера работы Яндекса с JavaScript я не нашел, поэтому контент и метаданные лучше сразу отдавать в HTML ответа сервера.
Яндекс | ||
|---|---|---|
Выполнение JavaScript | да, для всех HTML-страниц в замере Vercel и MERJ | бета, по умолчанию на усмотрение робота |
Серверный рендеринг | вместо динамического рендеринга советует SSR, статическую генерацию или гидратацию | при серверном рендеринге справка советует запретить рендеринг в Вебмастере |
Дубли с параметрами | canonical, редиректы, sitemap |
|
Как сообщить о страницах | sitemap, проверка URL | переобход, sitemap, счетчик Метрики, IndexNow |
Где оказываются title и canonical
В Pages Router метаданные задавались через next/head. В App Router их задают функцией generateMetadata. Она работает только в серверных компонентах и появилась в Next.js 13.2.
С версии 15.2 метаданные динамических страниц стримятся. Это значит, что Next.js отправляет браузеру первый кусок HTML сразу, а теги дописывает в <body>, когда generateMetadata закончит работу (документация). Команда Next.js пишет, что проверила это на ботах, которые выполняют JavaScript и читают весь документ, как Googlebot.
Ботам, которые JavaScript не выполняют, Next.js делает исключение. Он узнает их по User-Agent, дожидается метаданных и кладет теги в <head>. Список ботов лежит в исходниках как регулярное выражение (html-bots.ts). В нем есть yandex, Bingbot, DuckDuckBot, baiduspider, facebookexternalhit, Twitterbot, LinkedInBot, Slackbot, WhatsApp и любые User-Agent с -Google или Google-, например AdsBot-Google и Google-InspectionTool. Обычный Googlebot под шаблон не попадает и получает стриминг.
Чтобы документация не оставалась словами, я воспроизвел поведение на чистом проекте с Next.js 16.2.1 и React 19.2.4. Там были две динамические страницы, у одной есть loading.tsx. Обе задавали title, description и (первая) canonical через generateMetadata с задержкой 300 мс. Я запросил их через curl -A с разными User-Agent и посмотрел, по какую сторону от </head> лежат теги. Ту же проверку несложно повторить на любом сайте.
Страница | Googlebot | YandexBot | Обычный Chrome |
|---|---|---|---|
динамическая, с | теги в | теги в | теги в |
динамическая, без | в | в | в |
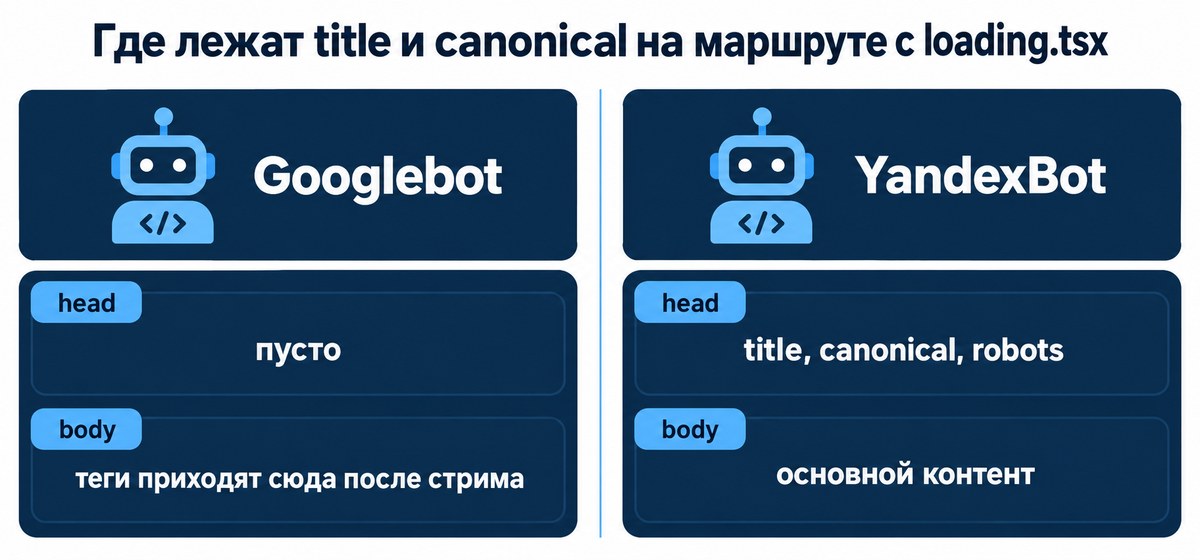
loading.tsx: Googlebot получает их в конце документа, YandexBot в начале.Результат совпал с документацией. Стриминг начинается там, где в маршруте есть граница Suspense, то есть место, где Next.js показывает запасной экран, пока данные грузятся. Пока у маршрута нет loading.tsx или своего Suspense, Next.js ждет метаданные, и теги лежат в <head> у всех. Статические страницы, собранные при сборке, не стримятся совсем: два наших dev-стенда с блогом отдали всем трем User-Agent одинаковый HTML с тегами в <head>.
А краулер, которого нет в списке, например самописный скрейпер или SEO-аудитор с нестандартным User-Agent, по логике списка получит поток и может отчитаться, что метаданных нет. Если теги нужны в <head> у всех, в документации есть крайняя мера, и это htmlLimitedBots: /.*/ в next.config, который отключает стриминг метаданных для всех ботов.
Код 200 вместо 404
На динамической странице неизвестный адрес должен давать 404. Документация Next.js про loading.js описывает, как страница отдает 200 вместо 404, хотя в коде нет ошибки. Ответ со стримингом всегда начинается с кода 200, заголовки уходят сразу. Тело начинает стримиться, когда показывается запасной экран Suspense (например, loading.tsx) или серверный компонент зависает внутри Suspense. notFound() дает 404 только до этого момента. После него код остается 200, а Next.js добавляет метатег robots со значением noindex. Документация оговаривает, что часть краулеров может посчитать такой ответ soft 404, а noindex не пускает страницу в выдачу.
Soft 404 по определению Google это страница с понятным сообщением «не найдено», которая отдает не код 404 (справка Search Console). Такие страницы Google продолжает сканировать и тратит на них бюджет обхода, то есть то число страниц сайта, которое робот готов скачать за раз. Сплитт в том же материале Search Engine Journal назвал ответ 200 вместо 404 одной из трех частых ошибок сайтов на JavaScript.
Это воспроизводится и на чистом проекте. Страница с loading.tsx, вызвавшая notFound(), отдала код 200 всем трем User-Agent. noindex лежал в <body> у Googlebot и в <head> у YandexBot. Тот же маршрут без loading.tsx вернул 404 и noindex в <head>. Поэтому проверку адреса лучше делать до loading.tsx. Что покажет curl у вас на несуществующем адресе?
Документация советует проверять, что адрес существует, в proxy.ts (в Next.js 16 это бывший middleware.ts) и отвечать 404 до начала рендера, держа проверку быстрой.
Дубли: www, canonical и параметры
Это самая частая беда в нашей практике. На трех проектах www-версия сайта отдавала 200 и содержала полную копию страниц, хотя canonical везде был правильный, без www. На одном проекте была и вторая дыра: http://www… вел на https://www…, то есть сначала на дубль и только потом дальше.
Яндекс в справке пишет, что адреса с www и без, с HTTP и HTTPS воспринимаются роботом как разные сайты и могут конкурировать в выдаче (справка «Переезд сайта на адрес с www и обратно»). Canonical подсказывает, какой адрес главный, но редирект работает сильнее. Документация Google ставит редирект и тег canonical в сильные сигналы, а sitemap в слабые (страница Google о дублях адресов).
На одном проекте мы сделали редирект в nginx отдельным блоком для www: return 301 https://домен$request\_uri. Путь и параметры сохраняются, а http ведет на нужный адрес за один переход. Делать то же внутри Next.js мы не стали, на сервере хватает одной строки. После правки адреса в другом регистре, /Blog и /BLOG, стали отдавать 404 вместо копии страницы. Сертификат уже покрывал оба имени, перевыпускать не пришлось.
В Next.js canonical задается через alternates.canonical. Относительный путь без metadataBase ломает сборку, поэтому metadataBase ставят в корневом layout. Адрес для canonical собирайте из пути, без searchParams: иначе в него попадут фильтры и метки.
Для лишних параметров в адресе (метки utm_*, фильтры) Яндекс предлагает директиву Clean-param. Справка рекомендует ее вместо Disallow, потому что она передает основному адресу накопленные показатели страницы. Без нее при множестве дублей робот медленнее обходит сайт. Записывается она так: Clean-param: p0[&p1&p2] [путь].
Директива работает из любого места файла, поэтому отдельный блок для Яндекса ради нее не нужен. Но если вы все же задаете правила именно для робота Яндекса, все его правила должны лежать в одной секции User-agent: Yandex, а строка User-agent: * для него игнорируется.
В robots.ts для нестандартных директив есть поле other, но оно появилось только в Next.js 16.3.0 (по истории версий в документации). У нас стоит 16.0.7, поэтому Clean-param лежит в статическом файле app/robots.txt:
User-agent: *
Disallow: /api/

Clean-param: utm_source&utm_medium&utm_campaign

Sitemap: https://example.com/sitemap.xml
Как сообщить, что страница существует
Файл sitemap.ts в Next.js работает как специальный обработчик маршрута и по умолчанию кэшируется. В примере документации 50 000 адресов названы лимитом Google на один файл, для больших каталогов есть generateSitemaps. В Next.js 16 параметр id у этой функции стал промисом, при обновлении с 15 его надо дожидаться через await.
Vercel в своем замере пишет: актуальный sitemap сильно сокращает, а то и убирает разницу во времени обнаружения страниц между разными способами рендеринга. Даты в lastModified я ставлю по реальному изменению страницы и не пишу new Date() на каждой сборке, иначе при любом деплое вся карта выглядит обновленной.
У Яндекса способов больше. По справке, об изменениях можно сообщить через переобход страниц, файлы Sitemap, обход по счетчику Метрики и протокол IndexNow, и рекомендуется совмещать несколько. Страница, отправленная на переобход, может индексироваться от 3 до 7 дней (справка «Как сообщить Яндексу о новых и измененных страницах»).
Discovered и Crawled: при чем тут бюджет обхода
В отчете Search Console два похожих статуса.
Discovered - currently not indexed: Google нашел адрес, но еще не сканировал его. Обычно потому, что сканирование грозило перегрузить сайт, и Google перенес его.Crawled - currently not indexed: страница просканирована, но в индекс пока не попала. Отправлять ее на сканирование повторно не нужно (справка Search Console).
Статус Duplicate without user-selected canonical справка называет штатной работой: Google выбрал основной адрес сам. А Duplicate, Google chose different canonical than user значит, что вы указали один canonical, а Google считает лучшим другой адрес.
Руководство Google по бюджету обхода адресовано трем видам сайтов. Это сайты от миллиона страниц с обновлением раз в неделю, от 10 000 страниц с ежедневными изменениями и тем, у кого большая доля адресов висит в статусе Discovered. Цифры Google называет ориентировочными. Блог на пару сотен статей по размеру не подходит ни под первый вид, ни под второй. Если же у вас в Discovered застряла большая часть адресов, руководство стоит прочитать. Для статуса Crawled бюджет обхода причиной быть не может, потому что страницу уже просканировали.
Что изменилось в Next.js с 14 по 16
В таблице только то, что влияет на индексацию, по руководству по переходу на 16 и справочнику по метаданным.
Версия | Что меняется для SEO |
|---|---|
14.0 |
|
15 |
|
15.2 | стриминг метаданных |
16.0 | синхронный доступ удален; |
16.3 | поле |
С включенным cacheComponents функция generateMetadata подчиняется тем же правилам, что остальные компоненты. Если метаданные зависят от cookies(), headers() или params, они откладываются до времени запроса.
Что бы я делал сегодня
Блогу со статическими страницами я бы начал со следующих проверок: curl пары страниц, код ответа на несуществующий адрес и редирект с www. Магазину или каталогу с фильтрами добавил бы canonical без параметров и Clean-param.
Снимите ответ сервера двумя User-Agent. Сравните
curl -A "Googlebot"иcurl -A "YandexBot"на статической странице, на динамической сloading.tsxи на несуществующем адресе. Смотрите код ответа и то, где лежатtitle,canonicalиrobots.Проверьте код 404. Если на маршруте есть
loading.tsx, вынесите проверку адреса вproxy.tsили уберите границу Suspense с этого маршрута.Оставьте один хост. Редирект с
wwwиhttpодним шагом на уровне веб-сервера, регистр адресов тоже проверьте.Задайте
metadataBaseи canonical без параметров.Добавьте
Clean-paramвrobots.txt. До Next.js 16.3 это статический файл.Отправьте карту сайта в оба кабинета. Даты в
lastModifiedдолжны быть настоящими.Проверьте ссылки в навигации и пагинации. Компонент
Linkвыводит<a href>, а у кнопки сrouter.pushhref нет, и Google по ней не пройдет.
Если данные грузятся на клиенте через useEffect, замер Vercel этот случай не покрывает: он описывает только время рендера HTML-страниц. На то, что бета-рендеринг Яндекса соберет такую страницу целиком, я бы не рассчитывал и перенес бы ключевой контент на сервер.