Зачем управлять рассуждением модели в конце 2026 года?
ИИ в юридической функции: разрыв между возможностями и реальным внедрением
В марте 2026 года Anthropic опубликовала исследование о влиянии ИИ на рынок труда. Авторы сопоставили каждой категории профессий две величины: долю рабочих задач, которые языковые модели теоретически способны выполнять, и долю задач, в которых Claude уже реально используется в профессиональной работе — наблюдаемое воздействие (observed exposure). В частности, в исследовании была приведена эффектная диаграмма:
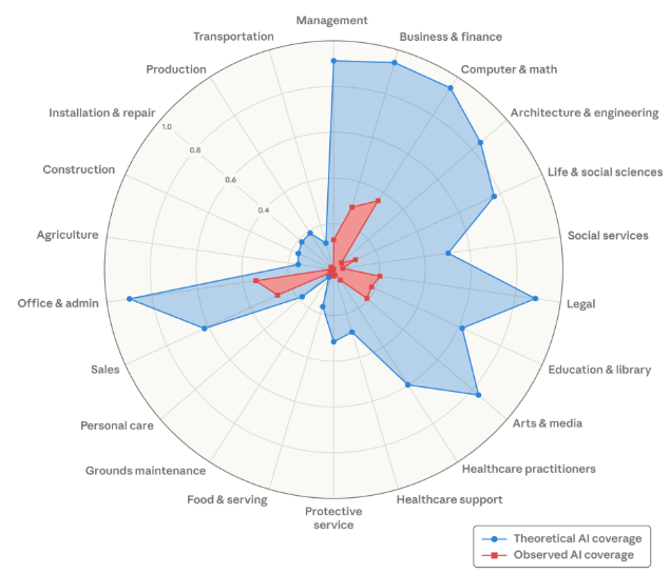
Диаграмма показывает долю задач, которые LLM теоретически способны выполнять (синяя область), и наблюдаемое на март 2026 покрытие (красная область) по категориям профессий или областей знаний. Разрыв между возможным и фактическим был велик почти везде. При этом право оказалось среди лидеров по теоретическим возможностям покрытия задач: по оценке Anthropic модели могли бы выполнять почти 90% задач юридических профессий, фактически ИИ покрывал около 20%, то есть в 4–5 раз меньше.
За полгода, прошедшие с момента публикации исследования, ситуация изменилась скорее вширь, чем вглубь. По данным ежегодного опроса Международной ассоциации юридических технологий ILTA (International Legal Technology Association), опубликованного в сентябре 2026 года, генеративный ИИ используют или тестируют 94% из более чем 500 опрошенных юридических фирм против 80% годом ранее. Однако полное развертывание по‑прежнему — редкость: большинство ИИ‑инструментов компании пока остаются на стадии пилотных проектов, либо используются точечно.
В России картина похожая. По данным исследования «Авито» и Право.ru (опубликовано в декабре 2025 года, опрошено более 500 юристов цифровых компаний и юридических фирм), около 88% респондентов уже используют нейросети в работе. При этом среди главных барьеров — опасение получить недостоверную информацию (84%) и необходимость тщательно проверять каждый результат (80%).
Промежуточный вывод: ИИ‑инструментами пользуются почти все, но в процессы их встраивают немногие.
Почему? — Кроме ограничений самих моделей, авторы исследования Anthropic называют правовые ограничения, требования к специальному программному обеспечению и обязательные этапы проверки результатов работы ИИ‑инструментов человеком. Последнее перекликается с барьерами, которые называют и российские юристы.
Казалось бы, достаточно выстроить и оптимизировать процессы, и ИИ можно внедрять. Отчасти это так: в компаниях и подразделениях с грамотно спроектированными процессами ИИ уже сегодня достаточно эффективно закрывает рутинные задачи и даже целые цепочки типовых сценариев (workflows). Но автоматизация юридической функции — отдельных юридических сценариев работы — упирается также в то, что ход рассуждения модели трудно проконтролировать, и одной оптимизацией процессов эту проблему не решить. В конце цепочки все равно стоит ответственное лицо — человек, который вынужден либо доверять ответу модели, либо перепроверять его целиком, и тогда выигрыш от автоматизации во многом теряется
Отсюда узкое место для того, кто в конечном итоге отвечает за юридическую функцию и встроен в контур работы ИИ‑агентов: как эффективно использовать знания, которые накапливаются в хранилищах, когда рутину отрабатывает агент, а человек от нее отстранен. Раньше эту рутину выполнял, например, помощник юриста. После себя он оставлял артефакты, понятные другому человеку (документы, заключения, переписку), а сам приобретал знания и опыт: навыки и умения начинающего специалиста складываются из многократного выполнения определенных действий при решении узких задач. Итог такого опыта — процедурное знание, то есть знание о том, как действовать в данных или похожих обстоятельствах. В хранилищах и логах остаются артефакты, но не процедура, в результате выполнения которой они были получены.
Декларативные и процедурные знания | Данные и Инструкции
В области исследований систем и методов искусственного интеллекта традиционно разделение на:
Декларативные знания (что) — знания об объектах и явлениях (о том, что говорят нормы и судебная практика). Сегодня их можно достаточно качественно представить и организовать, например в векторном или графовом виде.
Процедурные знания (как) — знания о том, как действовать в определенной среде, в частности — как можно использовать те или иные сущности (декларативные знания). Отдельного представления в агентных системах, как правило, не имеют, записаны в промптах и файлах инструкций (skills.md) тем же текстом, что и обрабатываемые данные.
У LLM нет встроенного механизма, который четко отделял бы данные от инструкций: контекст для нее — единый поток токенов, и модель не всегда может понять, что перед ней — часть обрабатываемого текста или указание, как его обрабатывать. С этим связана известная проблема дрейфа инструкций (instruction drift): по ходу длинного диалога модель все слабее следует исходной инструкции.
Для юридической сферы в большинстве практических сценариев это критично. Чтобы доверить агенту задачу в автономном контуре, юристу нужна гарантия, что в одном и том же сценарии агент пройдет одни и те же заранее определенные аналитические шаги: отклонение от процедуры здесь зачастую недопустимо. Без такой гарантии каждый результат приходится перепроверять, и автоматизация теряет смысл.
Поиск знаний и управление рассуждением — разные задачи
Ранее я разбирал методы векторного и графового RAG, которые позволяют организовать знания в домене: «Графы знаний в юридическом домене: как не потерять сложность при построении RAG‑системы» и эксперимент с LightRAG (часть 1, часть 2). Но хорошо организованные знания еще не гарантируют, что их правильно применят в сложном сценарии, состоящем из множества шагов: на каждом шаге модель может ошибиться и пронести ошибку дальше, накапливая неверный контекст.
Поэтому в сложных многошаговых задачах (а в юридической практике таких большинство) целесообразно контролировать не только качество поиска в хранилищах знаний, но и сам ход рассуждения модели. Там, где стандартная процедура уже есть или ее можно описать, модель должна пройти ее шаг за шагом.
Как встроить процедурные знания в контекст модели, отделив их от декларативных знаний и обрабатываемых данных?
TG‑RAG: процедура как граф
Один из ответов предложили исследователи Fudan University, Ant Group и Пекинского университета почты и телекоммуникаций (BUPT). Свою архитектуру TG‑RAG (Thought Guidance — Retrieval‑Augmented Generation) они представили на недавно прошедшей конференции ICML 2026:
Проблема: на сложных процедурах с ветвлениями и длинными цепочками рассуждения модели подвержены когнитивному дрейфу (Cognitive Drift), то есть отклоняются от заданного экспертного протокола.
Предложенное решение: процедура (SOP от Standard Operating Procedure) формализуется в граф, а программа исполняет его по шагам. На границах аналитических шагов она прерывает генерацию, вписывает директиву следующего шага прямо в ход рассуждения модели и подает на вход знания, нужные именно на данном шаге.
Статья: по ссылке.
GitHub фреймворка.
Архитектура TG‑RAG предполагает, что знания и процедура разделены и обрабатываются отдельно: процедура задает фарватер рассуждения, а знания подаются модели ровно тогда, когда они нужны, то есть на конкретном аналитическом шаге процедуры.
О чем эта статья
Идея показалась мне интересной, а для права — особенно уместной. В первой части подробно разберем, зачем праву управление ходом рассуждения, как устроена архитектура TG‑RAG, а также возможности и ограничения для ее адаптации в юридическом домене.
Во второй части планирую разобрать эксперимент, проведенный на собственных данных, а также ограничения подхода.
Кто я?
Меня зовут Сергей Слепухин. Прикладной лингвист и DS с фокусом на юридическом домене: исследую правовую область знаний и решаю практические задачи в этой сфере.
План статьи
LRM и сложные многошаговые задачи: что такое модели рассуждений, задачи multi‑step и multi‑hop, юридический пример (due diligence).
Особенности юридического домена.
Как сегодня управляют рассуждением модели: статический контекст, агенты и обвязка, место TG‑RAG среди существующих подходов.
TG‑RAG: граф экспертной процедуры (EPG), механизм его исполнения (IRG) и его реализация на юридическом примере.
Результаты авторов.
Выводы.
LRM и сложные многошаговые задачи
Large Reasoning Models
Авторы TG‑RAG задались вопросом, как повысить качество работы моделей рассуждений (Large Reasoning Models, LRM) в специализированных доменах.
Что за LRM?
LRM, как и обычные LLM, генерируют текст токен за токеном. Разница в том, что перед ответом LRM порождают явную цепочку рассуждения (Chain‑of‑Thought)? обычно между тегами <think> и </think>: разбивают задачу на шаги, проверяют промежуточные результаты, могут вернуться к ошибочному шагу и пересмотреть его, и только после этого формулируют ответ. Этому их специально учат, как правило, методами обучения с подкреплением.
Сегодня режим рассуждения есть у большинства флагманских моделей, в том числе открытых, например, в линейках Qwen и DeepSeek, которые использовали и авторы TG‑RAG.
Для нас здесь важно следующее: рассуждение — это обычный текст в том же контексте, что и заданный модели вопрос. Модель пишет его между тегами <think> и </think>, а ответ — после закрывающего тега. Если есть доступ к шаблону чата и «сырому» тексту запроса, например, у открытой модели, развернутой на собственном сервере с движком вывода vLLM, рассуждением можно управлять еще до того, как модель сгенерирует первый токен:
у Qwen3 режим рассуждения управляется параметром
enable_thinkingшаблона чата (по умолчанию он включен); приenable_thinking=Falseшаблон сам вставляет пустой блок<think>\n\n</think>\n\n, и модель сразу переходит к ответу;у моделей R1-Distill шаблон чата сам открывает рассуждение, добавляя
<think>\nв конец промпта;разработчики DeepSeek в README к R1 прямо рекомендуют «enforcing the model to initiate its response with „<think>\n“», то есть принудительно начинать ответ модели с открывающего тега (то есть иногда она пропускает рассуждение).
Итак, если рассуждение — обычный текст, его начало, конец или середину можно написать за открытую модель. На этой возможности и построен TG‑RAG. Программа с процедурной логикой сама дописывает текст после открывающего тега <think>, а модель продолжает его как собственную мысль: для нее вписанный текст ничем не отличается от сгенерированного ею самой.
Как рассуждают в сложных доменах: multi‑step & multi‑hop reasoning
В специализированных доменах (право, медицина, финансы) ответ редко получается в один шаг. Среди Complex reasoning tasks выделяют два типа:
Multi‑step reasoning — решение, которое получается через цепочку промежуточных выводов: каждый следующий шаг опирается на результат предыдущего. Классический пример — текстовые арифметические задачи из GSM8K: чтобы получить ответ, нужно выполнить несколько вычислений по порядку;
Multi‑hop reasoning — случай, когда для ответа нужно найти и связать несколько фактов из разных источников. Примером такого бенчмарка является StrategyQA: датасет устроен таким образом, что сами шаги рассуждения не заданы в вопросе явно, их нужно самостоятельно вывести, применив определённую «стратегию». Например, чтобы ответить на вопрос из названия статьи «Did Aristotle Use a Laptop?», модель должна догадаться сопоставить годы жизни Аристотеля и время появления ноутбуков.
Юридические задачи (Legal reasoning tasks), как правило, относятся к обоим типам сразу.
Пример: due diligence как граф процесса
Пример такой задачи, если поручить ее ИИ‑агенту — due diligence (DD) — комплексная проверка компании и (или) объекта сделки перед ее заключением.
Рассмотрим DD при покупке доли в уставном капитале ООО. Эта процедура, как правило, достаточно стандартизирована и может быть представлена в виде графа процесса: после запроса документов и интервью работа распадается на треки — корпоративный, активы, ключевые договоры, налоги, споры, долги и банкротство, регуляторика и санкции; вершины графа — отдельные проверки, а ребра задают их последовательность и условия перехода:
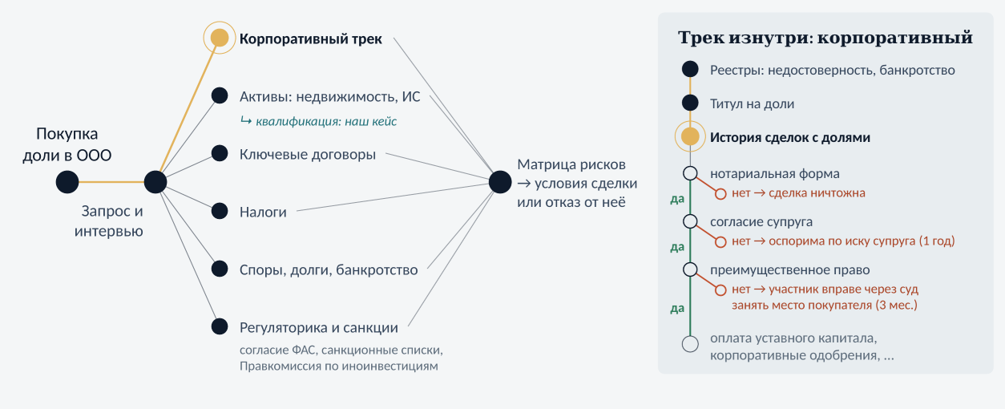
Треки в итоге сходятся в матрицу рисков, по которой принимается решение — согласовать условия сделки или отказаться от нее.
Представление процесса в виде графа показывает, что для успешного решения этой задачи модель должна учитывать знания из разных источников (multi‑hop reasoning) и проходить ветви каждого трека последовательно (multi‑step reasoning), иначе отчет на выходе будет неполным. Ошибкой здесь может быть не неверный факт, а пропущенный шаг, и именно поэтому ее трудно заметить.
Право — особый домен
Цена ошибки и проверка результата
Цена ошибки в юридическом домене высока, и ошибка нередко состоит не в неверном выводе, а в некорректно или необоснованно примененной процедуре. Это осложнят задачу проверки качества юридических ответов и работы ИИ‑агентов в юридических сценариях, в целом. Указанные сложности связаны с более общей и принципиальной проблемой сложности моделирования юридического языка, которую я подробно разбирал в первой части статьи «Law & Practice Ensemble RAG». Здесь приведу четыре фактора, важные для нашей темы:
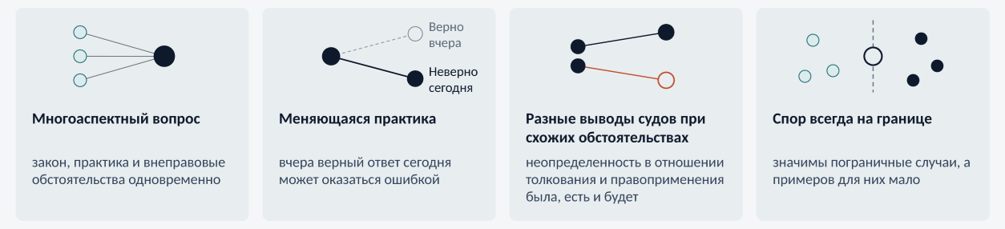
Право — это язык
Специфика юридических текстов состоит в том, что за привычными языковыми единицами стоит своя, особенная семантика. Юридический язык — язык особый, можно сказать, для специальных целей: план выражения он берет из естественного языка (лексику, грамматику, синтаксис), а план содержания у него свой — система понятий и концептов, своя прагматика. Например, согласно п. 1.2 ПДД велосипед не является механическим транспортным средством (на картинке слева), а распространенные слова, используемые носителями русского языка в повседневной речи (на картинке справа), в юридическом контексте приобретают особый смысл:
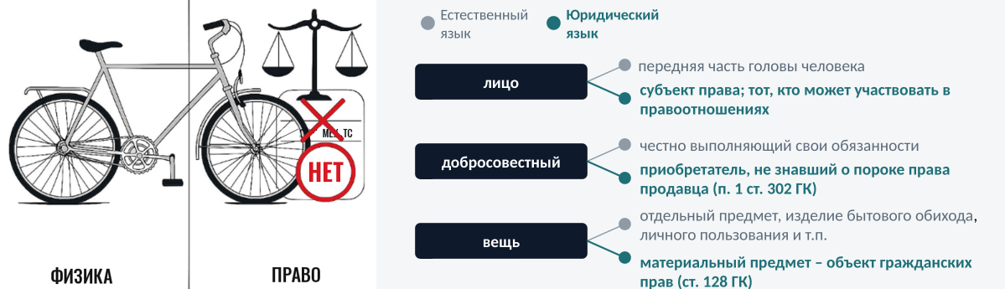
Более подробно проблему юридического языка разбирал в первой части статьи «Law & Practice Ensemble RAG».
Как это влияет на работу LLM?
Языковая модель обучается на общем корпусе, где общеупотребительные значения слов встречаются значительно чаще юридических. Распределение обучающих данных смещено относительно целевого домена (domain shift), поэтому модель склонна выбирать более частотное, общеязыковое значение вместо специального. Это систематическое отклонение нужно учитывать всем, кто применяет языковые модели в узкоспециализированных доменах.
Как измерить качество: юридические бенчмарки
Ранее я подробно разбирал проблему юридических бенчмарков во второй части статьи Law & Practice Ensemble RAG. Как создать ИИ‑ассистента, помогающего решать многоаспектные юридические задачи. Тогда (сентябрь 2025) вывод был такой: «Отсутствуют признанные и поддерживаемые специализированные юридические бенчмарки на русском языке». С тех пор ситуация мало изменилась.
Подходы к оценке решений языковых моделей и агентов можно разделить на три уровня — по тому, что подлежит оценке:
Оценка исхода: верен ли итоговый ответ. Так, например, устроена большая часть задач англоязычного, наиболее известного юридического бенчмарка LegalBench.
Такой тип оценки не всегда релевантен качеству: например, верный итоговый ответ, полученный после неверного или пропущенного шага, засчитывается как успех.Оценка рассуждения (Legal Reasoning) по критериям (рубрикам) — эксперт или LLM‑as‑a‑judge оценивает текст рассуждения по заданным критериям. Пример — бенчмарк LEXam (ICLR 2026), построенный на экзаменах юридического факультета Цюрихского университета: для открытых вопросов в нем указан ожидаемый ход рассуждения. Другой пример — BenGER (2026), немецкий бенчмарк, который проверяет, как модель сопоставляет обстоятельства дела с нормой: последовательно сопоставляет факты с каждым признаком нормы и делает вывод о ее применимости (в немецкой правовой доктрине этот метод называют субсумцией). Показательно, что максимальная разница между оценками самих проверяющих за одно решение составляет в нем в среднем 23,9 балла по 100-балльной шкале. Такая оценка измеряет качество рассуждения по заранее заданным критериям, но не соблюдение процедуры.
Оценка процесса — последовательность шагов модели сверяется с эталонной траекторией. Такие метрики (trajectory match) есть в инструментах оценки агентов, например в библиотеке agentevals: строгое совпадение порядка (strict), совпадение без учета порядка (unordered), подмножество и надмножество эталона (subset, superset). Юридических бенчмарков, которые сверяли бы траекторию модели с эталонной процедурой, мы не нашли.
Строгая оценка процесса требует эталона процедуры, а его в праве еще нужно построить.
Граф процедуры, о котором пойдет речь ниже, как раз может быть таким эталоном. В типовых сценариях работы, с регламентами, SOP и прочей стандартизацией, бенчмарк, построенный на принципах соблюдения процедуры, позволил бы измерить не только ответ, но и пройденный моделью путь, что в юридическом домене было бы особенно ценно.
Юридическое рассуждение: знание + процедура
Юрист, рассуждая при решении достаточно сложных вопросов, как правило, опирается одновременно на оба рассмотренных выше вида знания.
Декларативное знание (упрощенно) — что говорят нормы и практика по данному вопросу и как они связаны между собой. Его можно формализовать в виде графа знаний.
Процедурное знание (например, при подготовке юридического заключения) — что проверять и в каком порядке. Его тоже можно представить в виде графа — графа процесса.
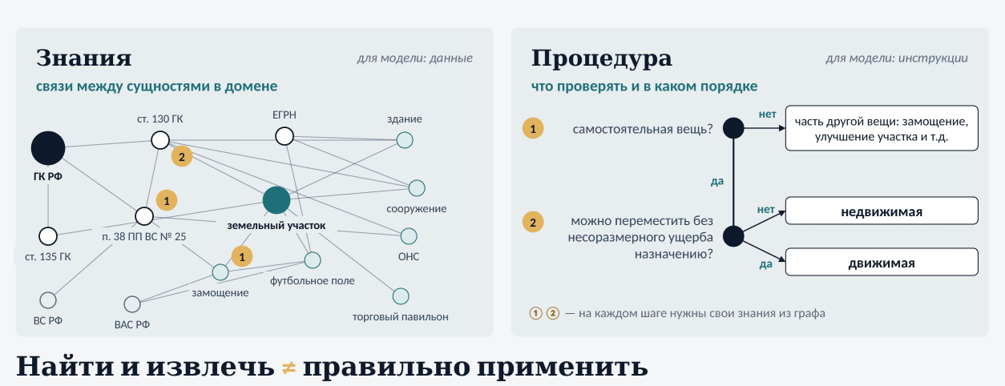
Возьмем юридическую задачу — квалификацию объекта имущества.
Чтобы ответить на вопрос, является ли объект недвижимым имуществом, сначала нужно выяснить, является ли он самостоятельной вещью (1 на рис.), есть ли у него собственное хозяйственное назначение. Например, асфальтовое покрытие площадки такого назначения, как правило, не имеет.
К следующему вопросу (2 на рис.) — можно ли переместить объект без несоразмерного ущерба назначению, имеет смысл переходить только после ответа на первый вопрос.
Такой подход выработан судебной практикой и закреплен в позициях Пленума ВС РФ и Президиума ВАС РФ. Порядок и полнота проверок здесь имеют значение: если модель, как и суды нижестоящих инстанций, будет опираться на физические характеристики объекта, не выяснив сначала его назначение, в пограничных случаях она с высокой вероятностью ошибется.
Может ли модель извлечь процедурное знание из графа знаний, вершины которого — сущности, а ребра — связи между ними? Отчасти — да. Но рассмотренный пример показывает: такой граф не гарантирует соблюдения обязательной процедуры. Проще говоря, он подсказывает, что с чем связано, но не в каком порядке это проверять.
Как сегодня управляют рассуждением моделей
Статический контекстный инжиниринг: все знания на вход модели
Авторы формализуют задачу управляемого рассуждения как задачу условной генерации:
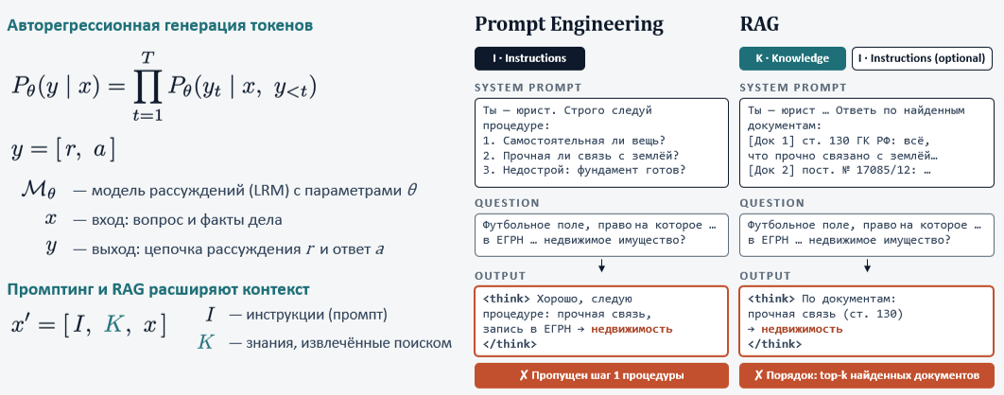
Традиционные методы промптинга и RAG пытаются управлять этим процессом, расширяя вход модели: они формируют уточненный контекст 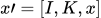 , где
 — статические инструкции,
 — найденные знания. Однако в этом случае дальнейшее рассуждение
 по‑прежнему определяется только внутренними априорными (параметрическими) представлениями модели: условие собирается до начала генерации, а дальше к нему добавляется только собственный текст модели.
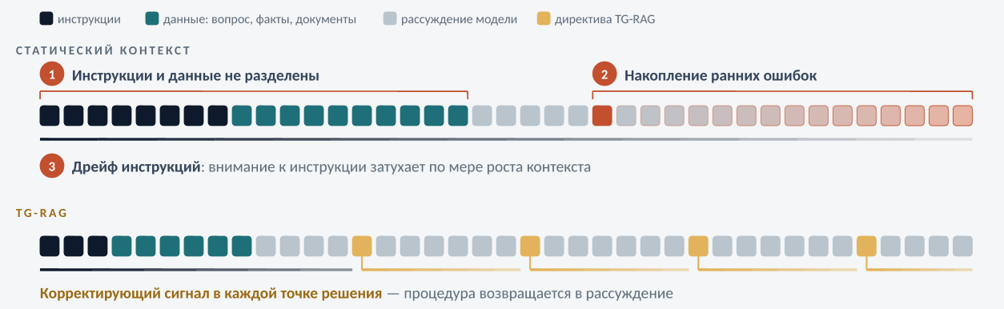
На задачах«сложного» юридического рассуждения такой статический контекстный инжиниринг может приводить к системным сбоям. На рис. выше — два типичных сбоя. В центральной панели процедура задана в системном промпте (или в md‑файле), но модель, «согласившись» ей следовать, сразу переходит к прочной связи с землей и записи в ЕГРН, пропуская первый шаг. В правой панели процедуры нет вовсе, и ход рассуждения задают найденные документы, ровно в том порядке, в котором их вернул модуль поиска.
Почему так происходит:
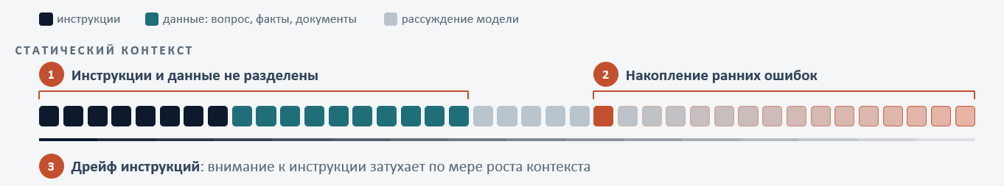
Для LLM системные инструкции, найденные документы и уже написанное рассуждение (reasoning trace) — токены одного потока, без явного разделения.
На рисунке выше — три механизма, которые мешают модели удерживать процедуру во время генерации:
Инструкции и данные не разделены: об этом шла речь выше.
Накопление ранних ошибок: для описания этого эффекта в англоязычной литературе есть устоявшийся термин — hallucination snowballing. Модель держится за ранние ошибки и строит на них новые, которых иначе не совершила бы.
Дрейф инструкций: исследователи фиксируют значимый дрейф от системной инструкции в длинных диалогах, связывая его с затуханием внимания (attention decay): следование плану, заданному в начале контекста, ослабевает по мере роста длины генерации.
Вместе эти и другие факторы приводят к так называемому когнитивному дрейфу (Cognitive Drift) — так авторы TG‑RAG называют «отклонение от заданного экспертного протокола». Процедура, поданная как пассивный контекст, остается не более чем подсказкой, которой не хватает обязательности («lacks enforceability»).
Авторы рассматривают существующие методы статического контекстного инжиниринга, отмечая их недостатки и ограничения:
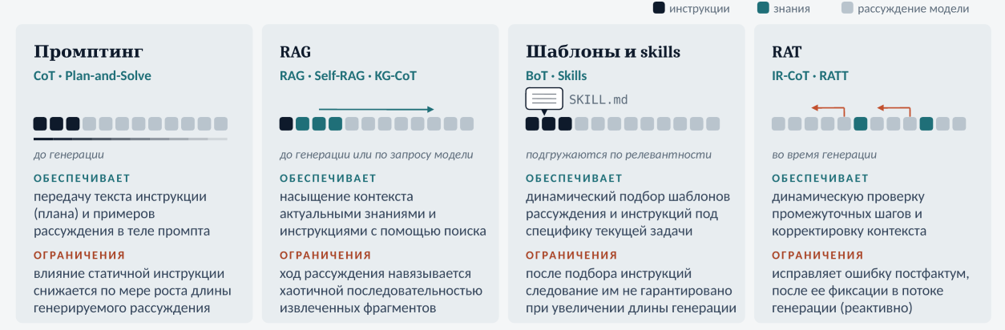
В общем, существующие методы подают инструкцию, процедуру как «passive contextual information» — пассивный контекст, лишенный механизма принудительного исполнения.
Агенты и обвязка
Архитектура агента предполагает автономную или полуавтономную работу в цикле, то есть на множестве итеративных шагов. Напрашивается вопрос: если обвязка (harness) условно сопровождает каждый такой шаг, нельзя ли настроить её так, чтобы контролировать или хотя бы снижать дрейф уже на границе шага? Частично — можно, и в этом сильная сторона агентной архитектуры.
Мне нравится модель агентной архитектуры, описанная известным инженером и исследовательницей Birgitta Böckeler: Agent = Model + Harness, где Harness — все, кроме самой модели. Обвязка устроена как система управления с двумя контурами:
Направляющие (guides) — механизмы прямого управления (feedforward controls). Они работают до действия агента: задают курс, формируют контекст, накладывают ограничения, чтобы повысить вероятность правильного результата с первой попытки (файлы с инструкциями, системные промпты, определения инструментов, скрипты инициализации).
Датчики (sensors) — механизмы обратной связи (feedback controls), которые срабатывают после действия агента: отслеживают его результат, выявляют отклонения от критериев и возвращают агенту обратную связь, чтобы он мог сам решить — идти дальше, повторить действие или исправить ошибку (детерминированные проверки, LLM‑as‑judge, human‑on‑the‑loop, постфильтры guardrails и др.).
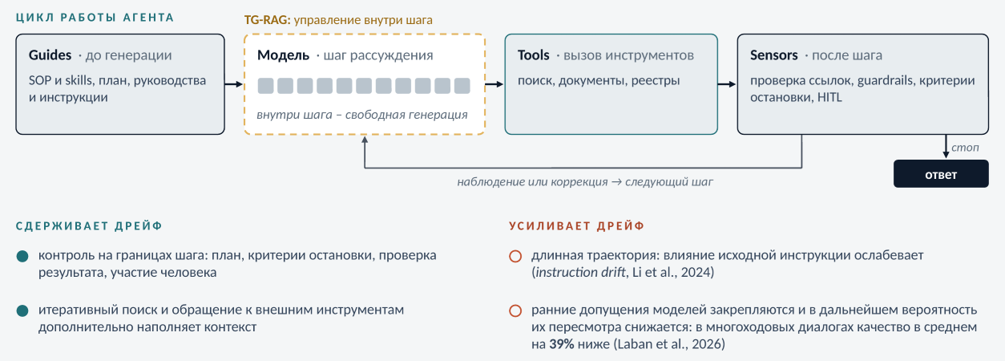
Для нас существенно следующее — грамотно собранная обвязка способна контролировать шаг на границах рассуждения агента — до и после. Но внутри шага, пока модель генерирует рассуждение, от когнитивного дрейфа ее ничто не удерживает: процедуру держит «в памяти» только сама модель.
TG‑RAG: Controllable Reasoning Steering
Авторы относят TG‑RAG к направлению Controllable Reasoning Steering — управлению ходом рассуждения LLM. Существующие подходы в рамках данного направления можно свести в матрицу:
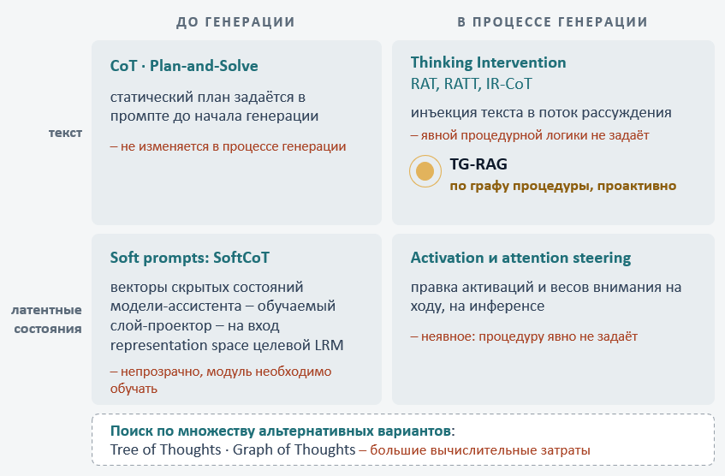
Матрица выше показывает, что существующие подходы к Controllable Reasoning Steering раскладываются по двум осям:
по горизонтали — когда происходит интервенция (до генерации или в процессе),
по вертикали — объект и (или) средство воздействия — текст или латентные состояния модели.
Вне обеих указанных осей стоят методы Tree of Thoughts и Graph of Thoughts — перебор множества альтернативных вариантов рассуждения. Плата за такую полноту поиска — относительно высокие вычислительные затраты.
По механизму TG‑RAG ближе всего к Thinking Intervention: управление тоже осуществляется явным текстом, вписанным в ход рассуждения. Но сами авторы TG‑RAG от этого направления отделяют: такие методы, по их оценке, в основном исправляют ошибки реактивно или меняют латентные состояния, а не навязывают явную процедурную логику. TG‑RAG действует проактивно и опирается на структуру: граф процедуры задает траекторию рассуждения с самого начала, а вмешательство происходит на границах логических шагов — до того, как рассуждение успеет уклониться от логики SOP.
Зачем управлять рассуждением модели по ходу генерации?
Методы Controllable Reasoning Steering мотивированы прежде всего стремлением уменьшить негативные и, по существу, неустранимые эффекты под общим названием exposure bias (смещению, свойственному любому авторегрессионному моделированию):
при обучении модель на каждом шаге получает на вход истинные, правильные данные (ground truth); такой режим называют teacher forcing: модель «видит» идеальные примеры и учится предсказывать следующий элемент, не сталкиваясь с последствиями собственных прошлых ошибок;
при генерации модель уже не получает идеальные входные данные: чтобы сгенерировать следующий элемент, она использует свои же предыдущие (возможно неверные) предсказания.
В результате при генерации модель оказывается в условиях, с которыми при таком обучении не сталкивалась: она продолжает собственный, возможно ошибочный, текст. Ранняя ошибка входит в условие генерации всех последующих шагов, поэтому ошибки могут накапливаться.
Что предлагает архитектура TG‑RAG?
TG‑RAG меняет само условие генерации: на границах логических шагов фреймворк прерывает генерацию, извлекает из графа директиву  и вписывает ее в ход рассуждения:
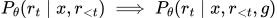 где
 — информация на входе,
 — очередной фрагмент рассуждения,
 — все, что модель написала до него (префикс цепочки рассуждения, сгенерированный к моменту
 ),
 — директива шага из графа процедуры.
Иными словами, на каждом шаге модель опирается не только на собственную историю рассуждения, но и на внешнюю «точку опоры» — директиву, текст которой задан графом, а не моделью.
Концептуально выглядит красиво: а‑ля teacher forcing на инференсе, только «правильный префикс» задается не для содержания, а для скелета формализованной процедуры. Аналогия, конечно, неполная: при teacher forcing (на обучении) модель на каждом шаге продолжает полностью корректный текст из обучающей выборки, а здесь правильна только директива: собственный текст модели между директивами, включая возможные ошибки, остается в префиксе, и какую ветвь графа выбрать, по‑прежнему решает анализ модели. Поэтому TG‑RAG не устраняет exposure bias, а ограничивает его последствия: в каждой точке решения рассуждение возвращается к процедуре, но ошибки в содержании, если они были допущены, остаются.
TG‑RAG: обзор архитектуры
Expert Procedure Graph (EPG): граф экспертной процедуры
Основной принцип архитектуры — отделение процедурной логики от предметных знаний («...the decoupling of procedural logic from domain knowledge...»).
Сегодня экспертизу для агентов принято упаковывать в модульные skills — папки с файлами инструкций и скриптами. Слабость такой упаковки, по мнению авторов, в том, что логика и факты в ней перемешаны: в одном тексте лежат и инструктивная логика («что делать»), и предметные сведения («что при этом знать»). TG‑RAG их разделяет: порядок шагов и условия переходов задает топология графа — его ребра, а в каждом узле хранятся директива шага и контейнер знаний.
Формально EPG — ориентированный ациклический граф  : топология (ребра
 ) кодирует SOP, а предметные знания инкапсулируются в узлах. Каждый узел хранит кортеж
 =
 :
 — директива (Action Directive Guidance): неизменная инструкция шага, которая вписывается в поток рассуждения с помощью рассмотренного ниже механизма прерывания‑генерации (IRG);
 — контейнер знаний (Knowledge Container): по замыслу авторов, он не привязан к конкретному источнику (в оригинале — «agnostic interface»). В контейнере может храниться статичный текст предметной области, а может быть подключен RAG, подтягивающий актуальные данные в момент генерации. Благодаря этому узел передает модели не только «инструкцию», но и «информацию» для ее исполнения, а обновление знаний сводится к замене документов во внешнем RAG‑хранилище без перестройки топологии графа.
Топология графа — «цепочка деревьев» (Chain‑of‑Trees): на макроуровне — последовательность основных аналитических стадий, на микроуровне — дерево решений внутри каждой такой стадии:
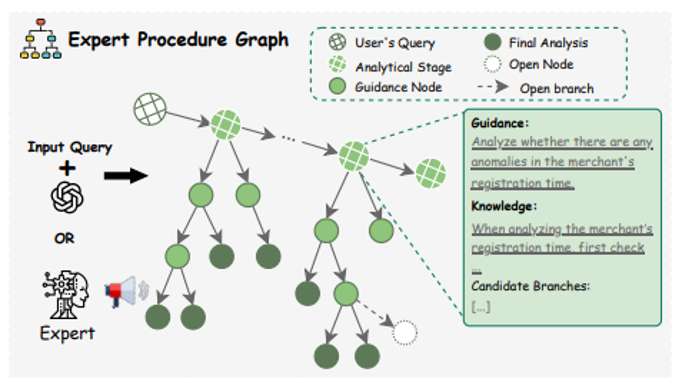
Из такой топологии следует несколько полезных свойств:
изоляция ошибок — неверный выбор ветви в одном поддереве остаётся локальным для конкретного аналитического фрагмента и, по словам авторов, не распространяется на ветви, которые воплощают независимую логику;
фиксированный корень — начальные шаги процедуры пропустить нельзя; топология отсекает типичный для свободной генерации пропуск базовых диагностических шагов;
Open Branch — «теневое ребро» (shadow edge) для нестандартных случаев (см. рис. выше, белый кружок), которых нет в SOP: оно ведёт в открытый узел (Open Node), где модель по специальному промпту сама формулирует директиву следующего шага, временно возвращаясь к собственному рассуждению. По данным авторов такой fallback срабатывает менее чем в 1% шагов рассуждения. По их трактовке, это страховка на редкие аномалии, а не признак неполного покрытия стандартных сценариев, а низкую частоту срабатывания они считают подтверждением качества построения EPG.
Интересна и идея рефлексии в терминальных узлах графа. В конце ключевых траекторий графа стоят терминальные узлы, директивы которых подводят итог и запускают самопроверку. Например, для задачи на медицинском SOP: «Now, let me summarize the above analysis and select a disease…» («Теперь подведу итог анализа и выберу заболевание…») и «At last, i have made a diagnosis, let's reflect on whether the evidence is reliable» («Итак, диагноз поставлен; проверю, надежны ли доказательства»). Когда маршрут доходит до такого узла, механизм IRG, рассмотренный ниже, вписывает его директиву в рассуждение, и модель продолжает текст уже как итог и самопроверку: по замыслу авторов, она сверяет вывод с исходным вопросом и исправляет ошибки маршрутизации, допущенные на предыдущих шагах.
Что представляет из себя такой граф?
В приложении к статье граф показан на примере медицинской задачи как вложенный JSON‑подобный словарь (точнее — nested dictionary, вложенный словарь в Python). Я его немного доработал, удалив пару опечаток и синхронизировав с движком, выложенном в репозитории:
Листинг кода
# Правило из справочника для одного теста
glucose_rule = "If blood glucose is between 0-99 or 126-500 mg/dL: Rule out Pre-Diabetes."

child_tree_1 = {
    "cot_guide": {"knowledge": glucose_rule,
                  "words": "Now, let me check the patient's Blood Glucose Test result, the result shows",
                  "max_words": 75},
    "child_type": "choices",
    "child": [
        {"choice_words": "test result can rule out Pre-Diabetes",
         "cot_guide": {"words": "According to the Blood Glucose Test result and medical knowledge, "
                                "I can rule out Pre-Diabetes.",
                       "max_words": 0}},
        {"choice_words": "test result can not rule out Pre-Diabetes",
         "cot_guide": {"words": "The Blood Glucose Test result can not rule out Pre-Diabetes.",
                       "max_words": 0}},
    ],
}

main_hierarchy = {"child_type": "parallel",   # или "sequential"
                  "child": [child_tree_1]}    # в полном графе – по дереву на каждый тест

# Правила всех тестов (в полном графе – правила каждого дерева)
all_rules = "Medical diagnostic knowledge for reference:\n" + glucose_rule

conclusion_hierarchy = {
    "cot_guide": {"knowledge": all_rules + "\nMake the final diagnosis by the method of elimination: "
                                           "if any test result rules out a disease, exclude it.",
                  "words": "Now, let me summarize the above analysis and select a disease "
                           "from the list of possible diseases for the patient, ",
                  "max_words": 2048},
    "child_type": "sequential",
    "child": [
        {"cot_guide": {"knowledge": all_rules + "\nWhen reflecting, check each test result and "
                                                "whether every disease was excluded correctly.",
                       "words": "At last, I have made a diagnosis, "
                                "let's reflect on whether the evidence is reliable. ",
                       "max_words": 1024}},
    ],
}

Medical_EPG = {"child_type": "sequential",
               "child": [main_hierarchy, conclusion_hierarchy]}
Пояснения:
макроуровень (цепочка стадий) задает тип
sequential: кореньMedical_EPGвыстраивает в цепочкуmain_hierarchyиconclusion_hierarchy; дочерние узлы обрабатываются строго по порядку, и каждый следующий генерируется с учетом текста предыдущих. Деревья проверок внутриmain_hierarchyсвязаны типомparallel: их тексты генерируются независимо, от одного и того же префикса, и затем склеиваются;микроуровень (деревья решений) задает тип
choices: каждое дерево внутриmain_hierarchyразветвляется на варианты исхода, аchoice_wordsслужат условиями на ребрах, по которым роутер выбирает ветвь;узел‑шаг по дереву решений хранит
cot_guide(подсказка для цепочки рассуждения) с полямиwords(директива ),
knowledge(контейнер и
max_words(бюджет шага в словах); у узлов, между которыми выбирает роутер (дочерних узловchoices; в листинге — варианты «test result can rule out…» и «test result can not rule out…»),max_words= 0: текст выбранного узла программа вписывает в рассуждение без вызова модели;узел‑шаг хранит
cot_guide(подсказка для цепочки рассуждения) с полямиwords(директива ),
knowledge(контейнер знаний ) и
max_words(бюджет шага в словах):если у узла есть и
cot_guide, и потомки, сначала выполняется его шаг, затем потомки: так устроеныchild_tree_1иconclusion_hierarchy;у узлов, между которыми выбирает роутер (дочерних узлов
choices; в листинге — варианты «test result can rule out…» и «test result can not rule out…»),max_words= 0: текст выбранного узла программа вписывает в рассуждение без вызова модели;
группирующие узлы (
Medical_EPGиmain_hierarchy)cot_guideне имеют и лишь объединяют дочерние узлы;conclusion_hierarchy— заключительная стадия из двух шагов:собственный шаг узла подводит итог и выбирает диагноз,
дочерний шаг проверяет этот вывод (рефлексия) перед финальным ответом.
В
knowledgeобоих шагов — правила всех тестов и указания, как поставить диагноз методом исключения и как его проверить. Текст после директивы пишет модель.
Как построить такой граф?
По замыслу авторов, граф строится полуавтоматически, в три шага:
Парсинг. Модель рассуждений выступает парсером исходного SOP‑документа: по промпту она выделяет ключевые этапы анализа, проверки условий и итоговые действия.
Топологическое отображение. Найденные сущности отображаются в элементы графа:
Вершины (состояния): процедурные состояния становятся узлами. Парсер извлекает действие, которое нужно выполнить в данном состоянии, из него формируется директива
 , и определяет, какие понятия и данные нужны для контейнера знаний
 ;
Ребра (маршрутизация): условия и пороговые значения, содержащиеся в SOP‑документе, отображаются во взаимоисключающие ребра маршрутизации, соединяющие вершины.
Проверка экспертом (human‑in‑the‑loop). Граф‑кандидат передают эксперту предметной области. Содержание он не пишет, а проверяет только топологию: правильно ли размечены ветвления, не пропущены ли условия на ребрах. Авторы оценивают время на такую проверку примерно в 30 минут.
При такой топологии устаревание знаний — проблема контейнеров  , а не графа в целом: в динамичных доменах, к которым относится и право, достаточно обновить документы во внешнем RAG‑хранилище, и система подтянет актуальные факты в момент генерации без перестройки топологии.
Оговорка для юридического домена: в праве меняются не только знания — новая позиция высшей судебной инстанции может изменить и сам порядок проверок, то есть топологию графа.
О границе применимости пайплайна построения графа EPG
Надежность построения графа авторы объясняют тем, что специализированные документы с описанием процедуры — медицинские протоколы, финансовые регламенты и тому подобное, уже содержат явную условную логику: деревья решений, пороговые проверки («если артериальное давление > 140/90 — …»), чек‑листы. Поэтому, по их словам, это не свободное извлечение знаний, а детерминированное топологическое отображение: LRM‑парсер не придумывает структуру, а переносит в граф уже существующую.
Однако в репозитории этого пайплайна разбора SOP‑документа моделью и образца последующей проверки графа экспертом нет. Для разобранной медицинской задачи граф строится автоматически, а не полуавтоматически: парсер извлекает из заранее подготовленных knowledge_book тройки «тест — заболевание — правило». Далее программа подставляет каждую тройку в фиксированный шаблон дерева с двумя вариантами исхода — «можно исключить» и «нельзя исключить».
Отсюда видно, что в приведенных примерах топологию модель не извлекает из «сырых» документов: структура графа зашита в код, а модель лишь заполняет шаблон. Исходные данные — не «сырые» документы с описанием процедуры, а уже структурированные книги знаний синтетического медицинского бенчмарка KUMO (Lin et al., 2025).
В задачах KUMO цепочка выглядит так: LLM по SOP‑документу генерирует knowledge_book → модель извлекает из нее тройки «тест — заболевание — правило» → программа собирает из них граф по шаблону → модель рассуждает по графу. К сожалению, проверить, как строился граф для финансовой задачи — единственной на реальных данных, — нельзя: ни данные, ни граф не опубликованы.
Тогда граница применимости пайплайна, предложенного авторами — качество исходной формализации: на реальном «шумном» SOP‑документе полуавтоматическое построение графа не продемонстрировано.
Как использовать граф EPG в юридическом домене?
Если с помощью такого пайплайна разворачивать граф для задач, где нет проработанных документов с описанием процессов, процедур и формализации конкретных условий, на выходе получится «шумный» граф, который может не повысить, а снизить качество работы модели.
Так, если исходный документ содержит условие из закона без конкретных критериев или пороговых значений, либо аналитический шаг назван, а его логика не описана, парсер либо ничего не извлечет, либо достроит ветвления сам, и это даст те самые галлюцинации, от которых граф должен был страховать.
Например, в регламенте договорной работы записано: «специалист оценивает существенность возможного нарушения». Но у модели, допустим, нет явных знаний о том, какое нарушение в рамках данного договора считать существенным: «существенное нарушение» (п. 2 ст. 450 ГК РФ) — оценочное понятие, а судебная практика по нему обширна и казуистична.
Таким образом, для доменов и задач без явных SOP построение графа EPG становится узким местом, которое потребует гораздо больше времени, чем «30 минут на класс задач».
Поэтому исходим из того, что для качественного построения графа нужен собственный pipeline под задачу, а ему должны предшествовать описание и формализация процесса (SOP). Готовить и обрабатывать документы и формализовать SOP в большинстве юридических сценариев могут те же «сильные» LRM, но проверять результат — топологию и содержание узлов, должен эксперт‑юрист.
Кстати, Open Branch можно использовать как диагностический инструмент, если считать частоту его срабатывания измеримым индикатором покрытия. В статье «менее 1%» трактуется как подтверждение качества графа. Логично обратить эту логику: при построении графа для нового домена высокая частота срабатываний — сигнал, что ветвления пропущены или исходный документ недоформализован. Отсюда цикл доработки: построить граф → прогнать его на репрезентативной выборке → посмотреть, где и как часто модель уходит в свободную генерацию → дополнить ветвления.
Разберем конкретный юридический пример
Допустим, вас интересует, обязана ли компания уплачивать налог на имущество организаций в отношении данного объекта. Сначала, особенно в пограничных и спорных случаях, нужно выяснить, относится ли объект к недвижимому имуществу: с 1 января 2019 года объектом этого налога признается только недвижимое имущество (п. 1 ст. 374 НК РФ в редакции Федерального закона от 03.08.2018 № 302-ФЗ).
Земельные участки и их части объектами этого налога не являются (пп. 1 п. 4 ст. 374 НК РФ), поэтому, например, замощение является улучшением участка и налогом на имущество не облагается. Ошибка квалификации здесь сразу становится налоговой ошибкой. Поэтому стадия 1 графа — дерево квалификации, а ее результат определяет, по какой ветви пойдет стадия 2:
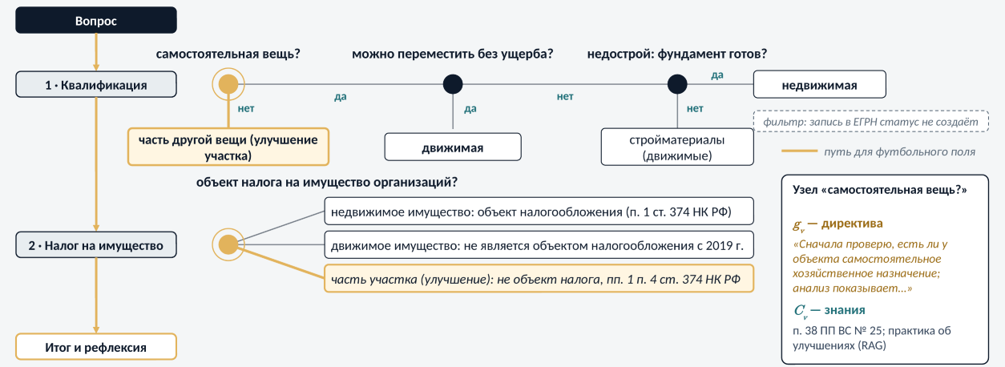
Источниками для построения SOP будут релевантные фрагменты «сырых» документов — законов (ГК РФ, НК РФ), судебных актов и, например, писем Минфина России. На основе SOP, отражающего эту логику, был построен граф EPG.
Механизм IRG: Interrupt‑Retrieve‑Generate
Граф процедуры — это статичный каркас. Чтобы его исполнить, авторы предлагают динамический механизм Interrupt‑Retrieve‑Generate (IRG). Он задает контур управления, зависящий от состояния рассуждения модели (state‑dependent control loop), и согласует генерацию с внешними процедурными ограничениями. Принцип работы такой: непрерывный поток генерации прерывается в дискретные моменты принятия решений, из графа извлекается директива следующего шага и вписывается в рассуждение, корректируя его дальнейшую траекторию:
Для реализации этого механизма система должна точно определять, когда и как прерывать процесс генерации. Это достигается в три этапа (three‑step pipeline):
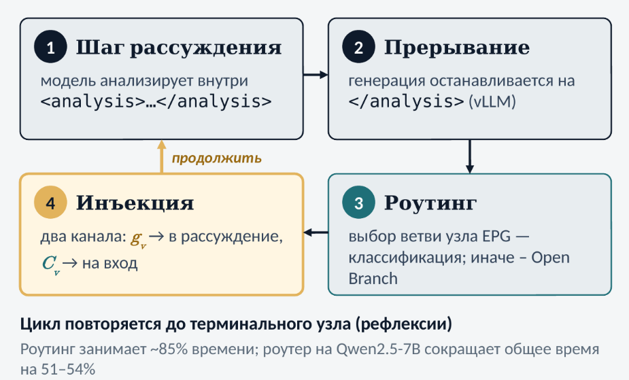
(1) Разметка. Системный промпт требует от модели заключать каждый логический шаг в теги <analysis> и </analysis>. В данном случае это не служебные токены модели, а обычный текст‑маркер: по нему программа узнает границу между шагами.
(2) Прерывание. Движок вывода (vLLM) останавливает генерацию, как только модель выводит закрывающий тег </analysis> (это стоп‑строка) или исчерпан лимит длины шага. «Приостановка» здесь условная: вызов модели просто завершается, а продолжение — это новый вызов с удлиненным текстом.
(3,4) Выбор и инъекция. В таком «приостановленном» состоянии система задействует semantic router (по умолчанию — та же модель) для оценки того, что модель сгенерировала на логическом шаге, относительно вариантов текущего узла графа EPG; далее программа извлекает подходящую процедурную директиву вместе со знаниями узла и внедряет их в контекст — генерация возобновляется. Роутер нужен только на развилках: если ветвь у узла одна, программа просто берет следующий узел по порядку.
Механизм IRG обеспечивается работой трех элементов:
граф процедуры (EPG): что проверять, в каком порядке и с какими знаниями;
LRM с заданными параметрами генерации: она пишет текст рассуждения;
программа‑оркестратор — скрипт, который хранит граф, собирает тексты запросов и вызывает модель. У авторов это thought_guidance.py — довольно «сырой» вариант, заточенный под задачи статьи, прежде всего под бенчмарк KUMO.
Обход графа осуществляется программой, при этом LRM работает с отдельными узлами (графа целиком не видит): на каждом узле программа берет из него директиву и знания, собирает из них запрос и вызывает модель, а модель пишет рассуждение для данного шага и останавливается в заранее заданных точках. Таким образом, каждый шаг рассуждения — отдельный вызов модели.
Раз каждый шаг — отдельный вызов, встает вопрос: откуда модель знает, что сделано на прошлых шагах?
LRM между вызовами ничего не хранит и видит только текст очередного запроса. Поэтому уже написанное рассуждение хранит программа в обычной строковой переменной и целиком вставляет его в каждый следующий запрос, а модель продолжает этот текст как собственный. Таким образом, рассуждение остается под контролем программы, а не модели. Программа вписывает в него директиву или готовый вывод ветви и оставляет на входе знания только текущего узла, а модель не может сама переписать или «забыть» прежние выводы. Кроме того, весь ход рассуждения — обычный текст, который можно сохранить и проверить.
Алгоритм IRG в виде псевдокода, приведенный в статье, я дерзнул немного доработать и дополнить (теперь в нем явно показаны Open Branch, листья графа и финальный вызов модели, которых в исходном Алгоритме нет):
Algorithm 1 (IRG), extended per the authors' code
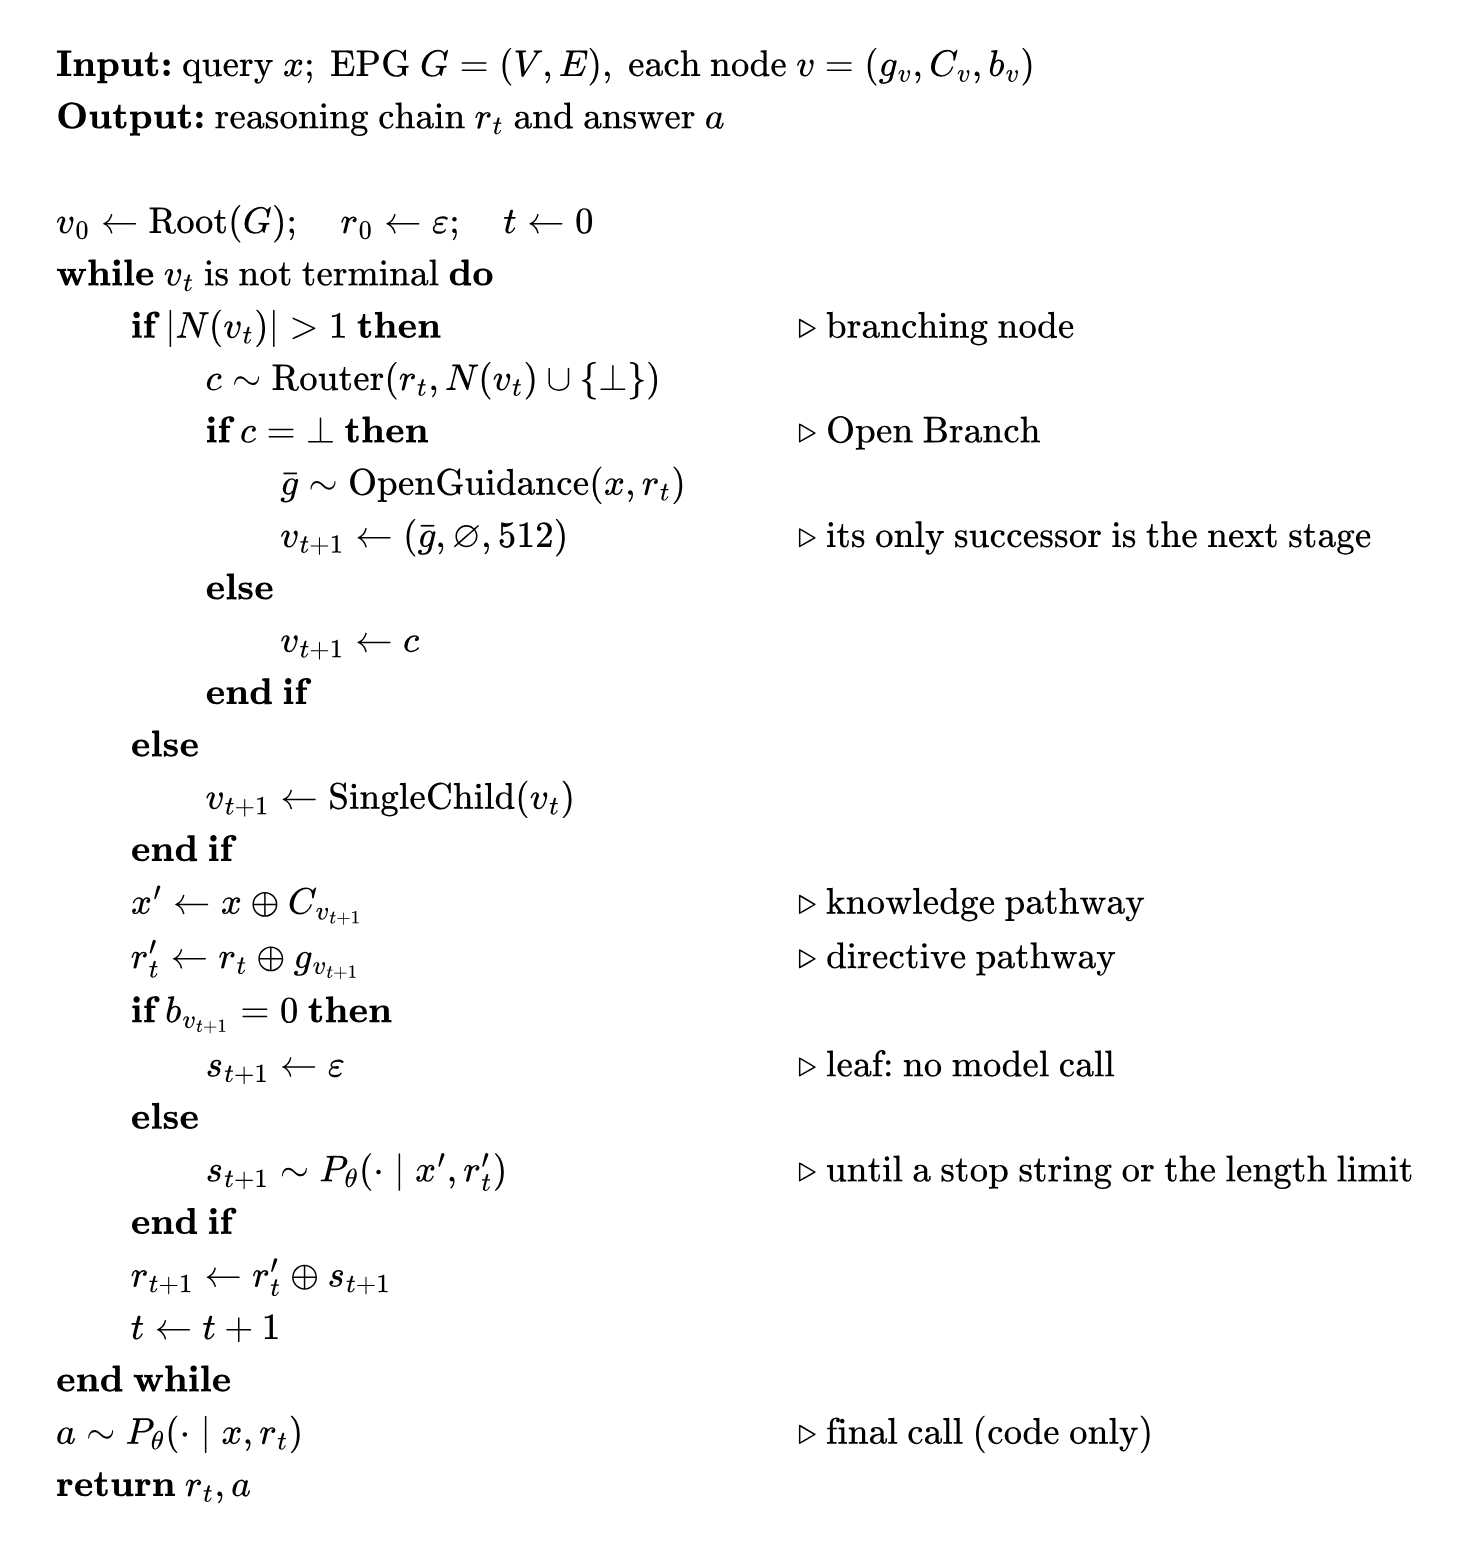
Обозначения:
 — запрос пользователя;
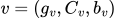 директива, контейнер знаний и бюджет шага в словах (в коде — поля words, knowledge и max_words);
 — корень графа;
 — потомки узла;
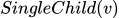 — единственный потомок;
 — рассуждение, накопленное к шагу t;
 — текст, написанный моделью на шаге t;
 и
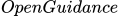 — вызовы той же модели с отдельными системными промптами;
 — конкатенация строк;
~ — выборка из распределения;
 — пустая строка;
 — пустой контейнер знаний (
 );
 — вариант «ни один не подходит».
Один шаг изнутри: двухканальная инъекция (Dual‑Pathway Injection)
После того как следующий узел выбран, его содержимое нужно передать модели так, чтобы управляющий сигнал не растворился в общем контексте. Опираясь на базовый принцип TG‑RAG — разделение процедуры и знаний (decoupling), авторы используют внедрение по двум каналам (Dual‑Pathway Injection).
Компоненты узла идут к модели разными путями:
знания
 как информационный сигнал поступают во вход модели, а
директива
 как управляющий сигнал вписывается прямо в ход рассуждения.
Где и как проходят эти каналы, видно по устройству запроса к чат‑модели. Это одна строка текста из трех частей, которые разделены служебными метками шаблона чата (у Qwen — <|im_start|> с указанием роли):
system— системное сообщение; в IRG здесь формат шагов и лимит их длины;user— сообщение пользователя;assistant— ответ модели: все, что стоит после метки<|im_start|>assistant, модель считает собственными словами и продолжает генерацию.
Обычно часть assistant пуста, и модель начинает ответ с нуля. IRG использует две последние части запроса как два канала: знания узла программа добавляет в сообщение пользователя, а в часть assistant заранее вписывает уже написанное рассуждение и директиву узла. Модель принимает директиву за начало собственного ответа и продолжает его.
Рассмотрим, как это работает, на конкретном примере:
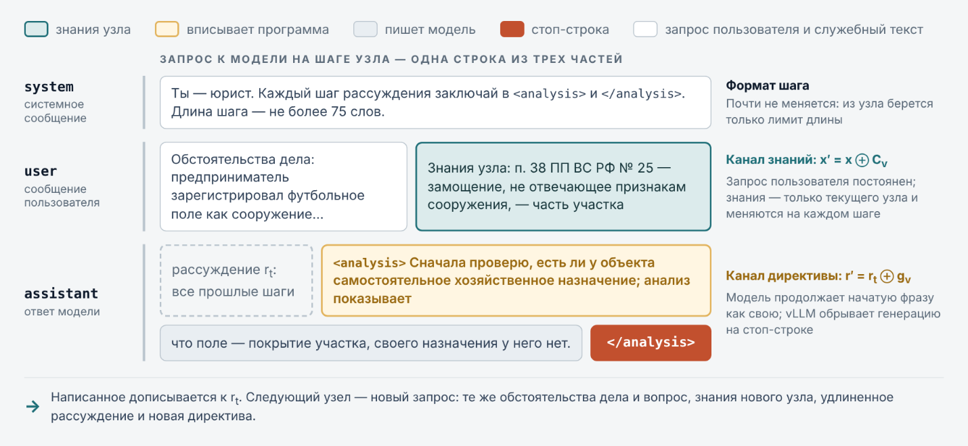
Модель генерирует до </analysis>, программа дописывает сгенерированное к рассуждению, и следующий узел получает новый запрос: те же обстоятельства дела и вопрос, знания нового узла, удлиненное рассуждение и новая директива.
Таким образом знания идут на вход как информационный сигнал, а директива — в рассуждение как управляющий сигнал. Подсказку в промпте модель лишь «рассматривает» («considered»), а вписанную в рассуждение — «исполняет» («executed»). Так устроена двухканальная инъекция (Dual‑Pathway Injection) по смыслу статьи.
Один прогон целиком
На картинке ниже — прогон графа квалификации для объекта имущества — футбольного поля:
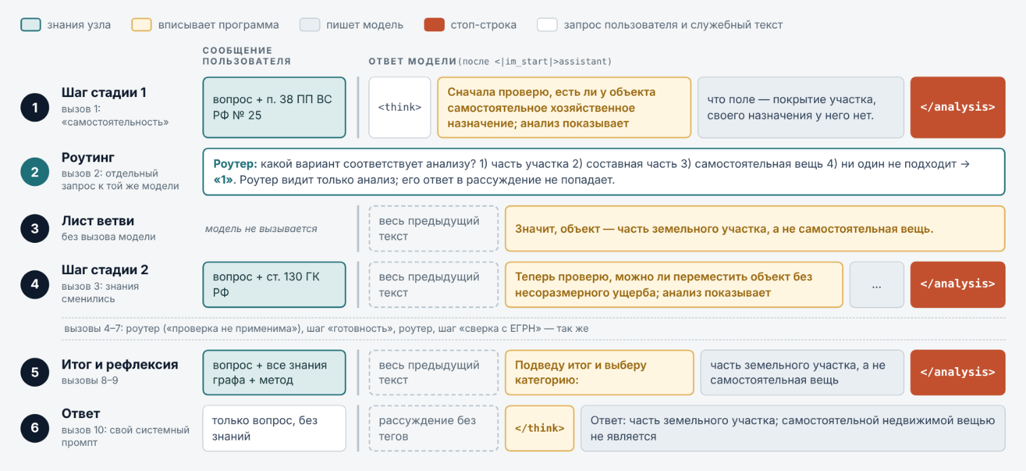
Всего получилось 10 вызовов модели: 6 шагов, 3 запроса к роутеру и финальный ответ. Выводы ветвей (листья) программа вписывает без вызова модели.
Отметим главное: вывод каждой проверки — «часть земельного участка», «проверка не применима», формулирует не модель, а автор графа. Модель лишь выбирает ветвь, читая собственный анализ, а дальше опирается на вписанный вывод как на свой. Поэтому TG‑RAG задает порядок проверок, но не гарантирует правильность ответов на них. К этому мы вернемся в разделе об ограничениях во второй части статьи.
Результаты авторов
Авторы сравнили TG‑RAG с методами без поиска (прямой ответ, Few‑Shot CoT, CoT‑SC, Plan‑and‑Solve), с RAG‑методами (Naive RAG, Self‑RAG) и с RAT‑методами (Retrieval‑Augmented Thought — поиск встроен в само рассуждение: IR‑CoT, RATT):
задачи — оценка риска мошенничества продавцов на закрытых реальных данных, медицинская диагностика и астрономия из синтетического бенчмарка KUMO, а также GSM8K и StrategyQA;
модели — Qwen3-32B, R1-Distill-32B и R1-Distill-14B;
метрика — accuracy (доля верных ответов).
Ниже — средняя accuracy по 5 независимым прогонам:
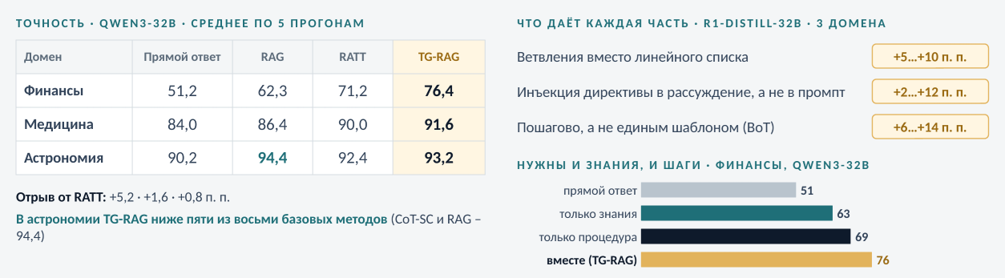
Из этих цифр следуют три промежуточных вывода.
Заметнее всего выигрыш на задаче из реальной практики со сложной экспертной процедурой. Среди экспертных задач TG‑RAG сильнее всего опережает базовые методы в оценке риска мошенничества на Qwen3-32B: +5,2 п.п. к RATT, сильнейшему из них. Это единственная задача на реальных данных.
Каждый механизм фреймворка вносит свой вклад. Это показывают абляции: авторы по очереди заменяют один механизм TG‑RAG более простым вариантом при том же содержимом графа и смотрят, насколько падает точность:
ветвления → линейная цепочка (вместо выбора ветви модель сразу получает инструкции для всех возможных исходов и сама отбирает нужную) — TG‑RAG выигрывает 5–10 п.п.;
директива в рассуждении → директива в промпте: те же шаги подаются не как начало фразы модели, а как инструкция в сообщении пользователя — выигрыш 2–12 п. п.;
пошаговая подача → единый шаблон: всю процедуру вместе со знаниями один раз дают модели в системном промпте — выигрыш 6–14 п.п.
Нужны и знания, и процедура. Чтобы оценить вклад каждого канала, авторы запускали TG‑RAG на Qwen3-32B в двух урезанных вариантах: только со знаниями узлов (без директив) и только с директивами (без знаний). В финансах прямой ответ дает 51%, одни знания — 63%, одна процедура — 69%, оба канала вместе — 76%: каждый канал помогает и сам по себе, а лучший результат дает их сочетание. В медицине прирост скромнее (84 → 86 → 86 → 90%). В астрономии процедура не добавляет ничего ни к прямому ответу (90%), ни к знаниям (92%), поэтому авторы относят ее к доменам, где важнее знания.
Цена за точность — время ответа (latency). TG‑RAG работает примерно втрое дольше прямого ответа (в финансах — 110 с против 35 с), и около 85% времени уходит на выбор ветвей. Причина в том, что роутером служит сама модель рассуждений: даже простую проверку условия она предваряет длинным размышлением. Если поручить выбор ветвей отдельной небольшой модели без режима рассуждения (у авторов — Qwen2.5–7B), общее время сокращается примерно вдвое. Точность выбора при этом, по словам авторов, не страдает, но цифр они не приводят.
Есть ли результаты на юридических задачах?
Пока нет. В первой версии репозитория у авторов был юридический пример — расчет общей суммы, вовлеченной в преступления (например, суммы похищенного), по текстам китайских приговоров. Это задача 3–7 из бенчмарка LawBench. Вскоре пример удалили, в репозитории остались только данные задачи и вариант law в параметрах запуска. В общем, проверить метод на реальных юридических задачах еще предстоит.
Вместо заключения
Если вы работаете в специализированном домене, полагаю, на маршрутах (задачах), отработанных и известных профессионалам, вы наверняка хотели бы обойтись без лишних приключений и получать предсказуемый результат.
Представим, что ваш ИИ‑агент — водитель, а процедура — тот самый отработанный маршрут. Тогда разница между подходами выглядит так:
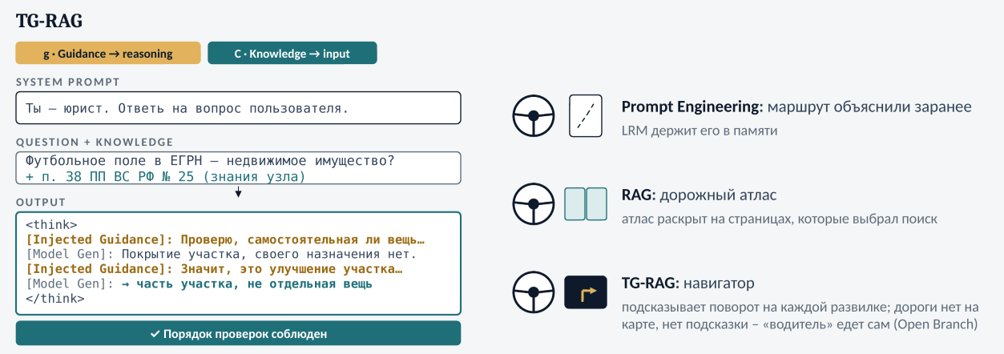
Классический промптинг: маршрут объясняют водителю перед поездкой, и дальше он держит его в памяти. Чем длиннее дорога, тем проще что‑то забыть или перепутать.
RAG: у водителя на коленях дорожный атлас, открытый на страницах, которые подобрал поиск. Дороги видны, но где он сейчас и куда свернуть, водитель решает сам.
TG‑RAG: у водителя навигатор, который ведет по маршруту и подсказывает каждый маневр именно тогда, когда тот нужен. Но GPS у этого навигатора нет: где находится машина, он узнает только со слов водителя. Ошибется водитель — навигатор уверенно поведет его не туда. А если развилки нет на карте, водитель едет сам (Open Branch), пока навигатор не подхватит маршрут на следующем этапе.
Полагаю, при умелой настройке и доработке TG‑RAG может стать для вашего ИИ‑агента отличным навигатором, таким, с которым он не собьется с маршрута даже в самых запутанных задачах.
Главное
Главное — то, с чего мы начали: разделение знаний и процедур — верный вектор. Знания меняются быстро, процедура — медленно; знания приходят как данные, а процедура должна работать как управляющий сигнал. TG‑RAG проводит это разделение на уровне архитектуры, а не промпта. Процедура хранится в графе, топология которого задает аналитические этапы и условия переходов. Исполняется она по собственному каналу: директивы вписываются прямо в рассуждение модели, а знания подаются на вход.
По сути, это и есть процедурный RAG, о необходимости которого шла речь в начале.
Результаты авторов подтверждают, что идея работает. В финансовой задаче — единственной на реальных данных — одна только процедура, без знаний, поднимает точность с 51 до 69%.
Мы полагаем, что в юридическом домене TG‑RAG лучше всего подойдет для задач, где:
Порядок действий (проверок) задан законом, регламентом или сложившейся практикой и не должен зависеть от модели.
Важны прозрачность и прослеживаемость. Путь по графу — какие проверки пройдены и какая ветвь выбрана на каждой развилке — легко записать в журнал, а такой журнал — готовый материал для последующего аудита (в коде авторов журнала пока нет, но добавить его несложно).
Это особенно ценно там, где цена ошибки высока, а решение должно быть объяснимо, например, в судопроизводстве. Принцип прозрачности, объяснимости и контролируемости в Концепции внедрения технологий искусственного интеллекта в судопроизводство, утвержденной Председателем Верховного Суда РФ в сентябре 2026 года, прямо требует: «алгоритмы должны быть понятны, проверяемы и при необходимости аудируемы, каждое взаимодействие с ИИ‑системой должно фиксироваться».
Что дальше? 🚀
Во второй части мы проверим TG‑RAG на практических юридических задачах.Там же разберем ограничения подхода и гипотезы, которые он порождает.
P. S.
Спасибо за внимание! Надеюсь, было интересно, готов ответить на вопросы в комментариях.
Кому интересны темы и вопросы, связанные с Legal AI, RAG, а также другими AI‑инструментами автоматизации юридической деятельности: tg channel.