Вбиваю в поиск: «Без конспекта не могу рассказать билет. Как себя проверить?» В ответ Veynrel показывает «Репетицию устного ответа». Открываю заметку: убрать конспект из поля зрения, попытаться объяснить тему по памяти, потом свериться с текстом и найти пробелы. То, что я искал, уже лежало в папке. Только называлось совсем иначе.
Ради подобных ситуаций я и развиваю Veynrel — бесплатный плагин с открытым исходным кодом для Obsidian. Сейчас он умеет искать заметки по смыслу, находить проблемы в хранилище и помогать с повторением материала. Всё начиналось с нескольких команд для редактирования заметок. До смыслового поиска я добрался намного позже.
Для этой статьи я сделал небольшое учебное хранилище из 16 вымышленных заметок: экзаменационные билеты, задачи и записи о подготовке. Снимки сделаны в настоящем Obsidian 1.13.7 с Veynrel 2.3.1. Мои старые билеты в комплект не входят. Похожим способом я действительно готовился к сессиям.
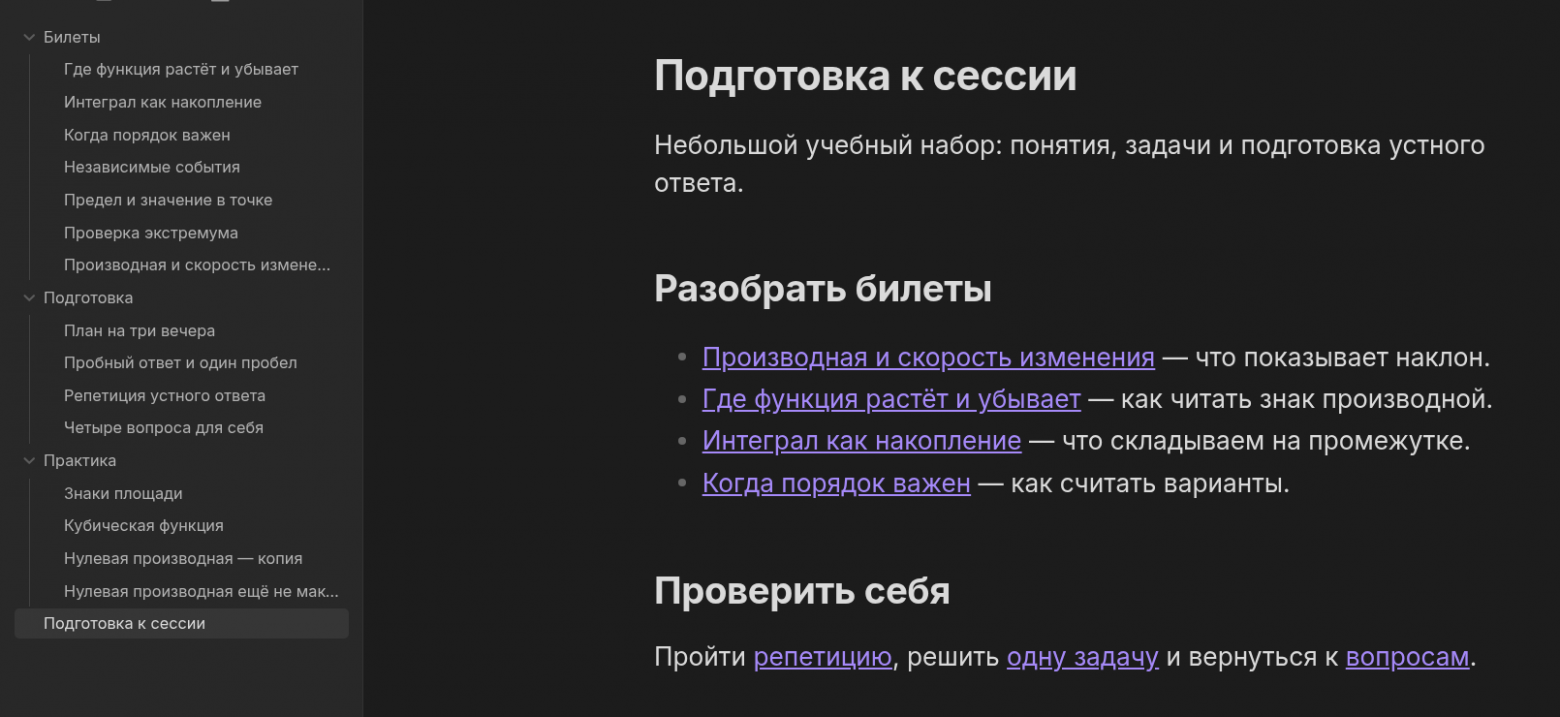
Билеты, задачи и заметки о подготовке. Слева файлы, справа обзор со ссылками на нужные темы.
Сначала меня зацепила иконка
На Obsidian я наткнулся случайно. Где именно скачал, уже не уверен, зато помню, что первым делом понравилась иконка. Открыл приложение и начал расписывать в нём билеты к сессиям. Чаще всего из дополнений я открывал плагин для LaTeX: с ним было удобнее оформлять формулы в экзаменационных ответах. Никакой сложной системы организации жизни у меня тогда не было — предметы, конспекты, вопросы и немного ссылок.
Если с Obsidian ещё не знакомы, его основа довольно простая. Хранилище — папка на вашем компьютере, заметки в ней — обычные Markdown-файлы. Чтобы связать записи, я пишу [[Название заметки]] прямо в тексте. В режиме чтения это обычная ссылка: из билета о производной перехожу к объяснению экстремума, а затем возвращаюсь к задаче.
Через несколько лет мне попалось видео о том, как человек с помощью Obsidian навёл порядок в обучении и повседневных мыслях. Я снова захотел пользоваться приложением. Начал сохранять фрагменты прочитанных статей, иногда целые материалы, записывать собственные идеи. Довольно скоро накопился текст, который хотелось обрабатывать прямо в редакторе, без постоянного копирования в другой чат и обратно.
Попробовал Copilot, познакомился с OpenRouter. Давно хотелось сделать что-нибудь из собственного интереса, поэтому решил написать свой плагин и по ходу разобраться с TypeScript, с которым раньше почти не работал.
Первые версии Veynrel обрабатывали выделенный фрагмент, дописывали ответ в конец заметки и проходились по файлам одной папки. После первой статьи на Хабре и обсуждения под ней начали появляться идеи для проверки хранилища и работы со связями. Несколько раз мне казалось, что функциональность уже закончена. После добавления семантического поиска это ощущение исчезло.
Спросить так, как помнишь
Встроенный поиск помогает, когда я помню точное слово из записи. Спустя время чаще вспоминается содержание, а название файла вылетает из головы. Тогда приходится перебирать конспекты и угадывать, куда сохранил объяснение.
Перед съёмкой я подготовил три вопроса для учебного набора. Первый звучал так: «Без конспекта не могу рассказать билет. Как себя проверить?» Veynrel поставил заметку «Репетиция устного ответа» первой. В выдаче был виден кусочек текста, и я открыл результат прямо оттуда.
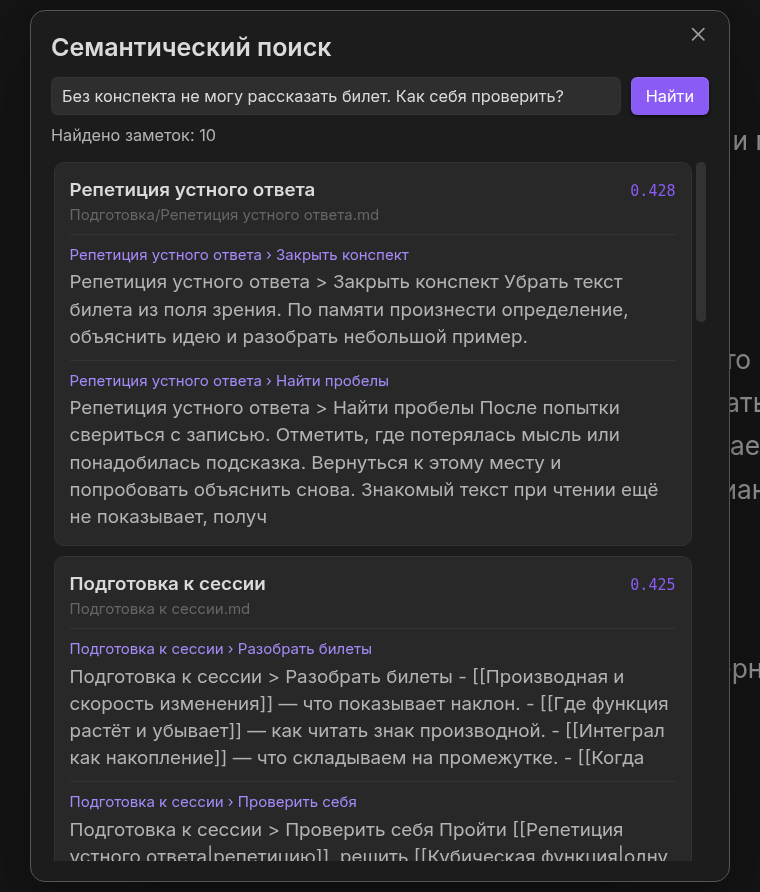
Вопрос своими словами, настоящая выдача. Первая запись — «Репетиция устного ответа».
Посмотреть 21-секундную запись поиска и открытия заметки
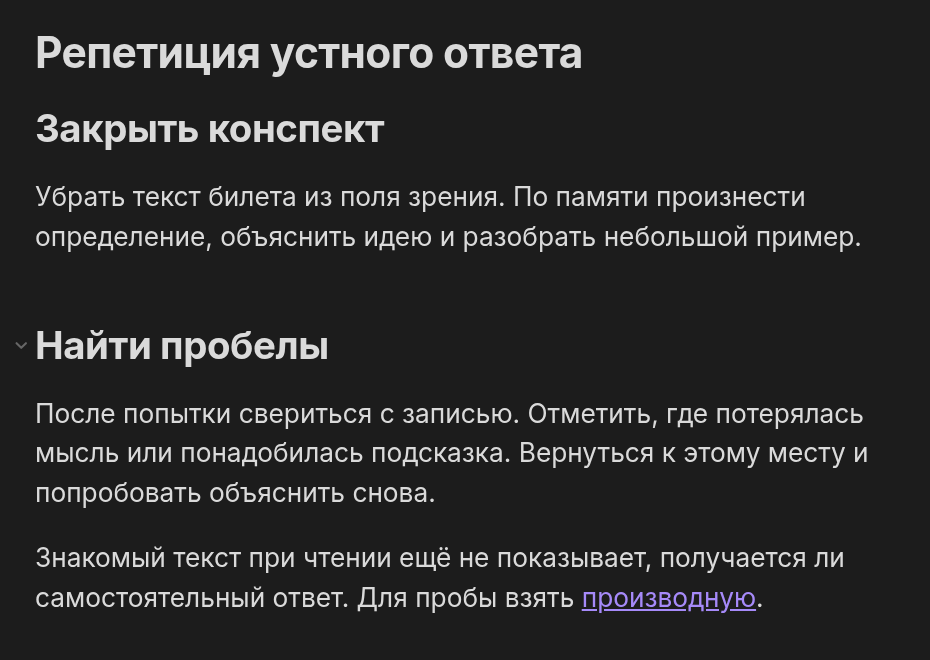
Вот к чему привёл поиск: закрыть текст билета, объяснить тему, затем отметить пробелы. Дальше это обычный файл Obsidian.
Поиск по смыслу сравнивает запрос с содержимым заметок через заранее построенный индекс. Для этого используются эмбеддинги — числовые представления текста. При первом знакомстве я построил индекс учебной папки, ввёл вопрос и открыл подходящий фрагмент из выдачи.
На трёх вопросах получились разные результаты. Для сравнения я открыл встроенную панель Search самого Obsidian и ввёл туда по два содержательных слова из каждого вопроса, без подсказок из найденных ответов.
Я прогнал вопросы на трёх конфигурациях: локальная MiniLM (она в видео выше), BGE-M3 через облако OpenRouter и BGE-M3 локально в Ollama.
Что хотел найти | Встроенный Search | Локальная MiniLM | BGE-M3 OpenRouter | BGE-M3 через Ollama |
|---|---|---|---|---|
Как проверить себя без конспекта? |
| №1 | №1 | №1 |
Где график поднимается и опускается? |
| №4 | №1 | №1 |
Почему перестановка меняет пароль? |
| №1 | №1 | №1 |
В таблице указано место нужной заметки. Встроенный Search требовал оба введённых слова в одном файле; на первом запросе он тоже нашёл нужный конспект.
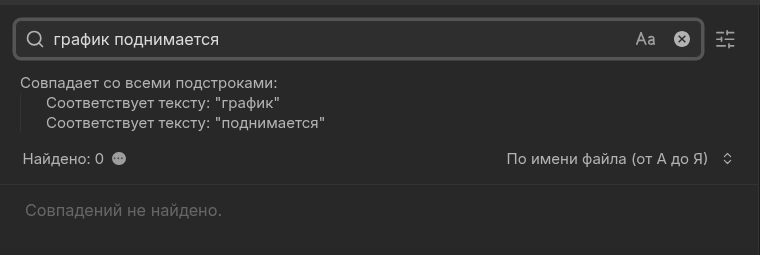
график поднимается: встроенный поиск не нашёл файлов по двум словам одновременно.
У MiniLM перед билетом о росте функции оказались обзор подготовки, репетиция устного ответа и план на три вечера. Ниже — тот же вопрос после построения нового индекса с локальной bge-m3 в Ollama.
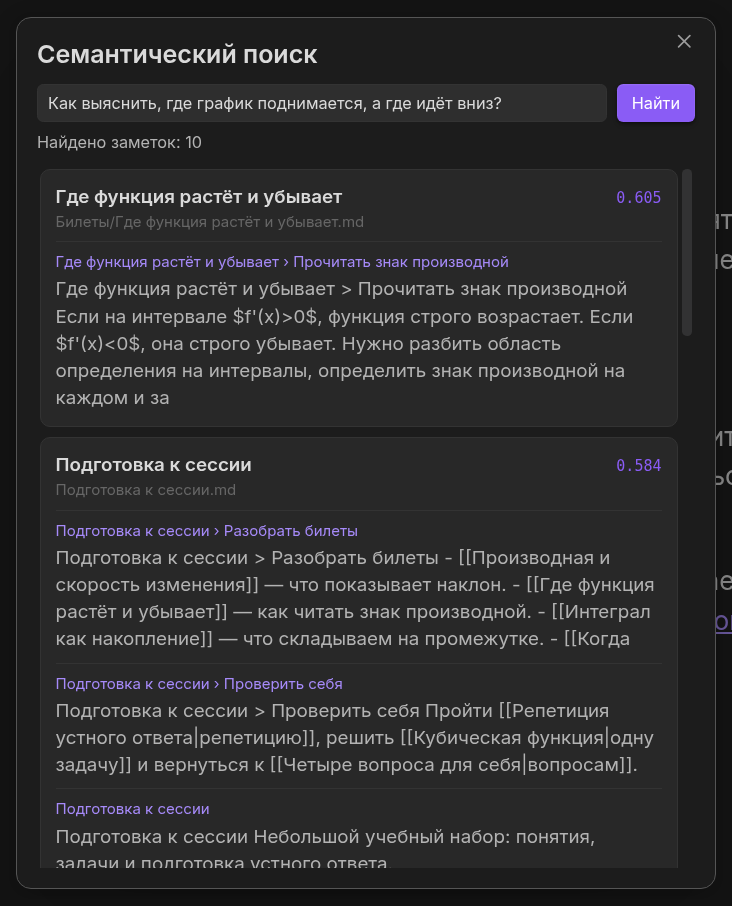
В локальной выдаче первым оказался билет «Где функция растёт и убывает». OpenRouter-ключ и Rerank не использовались.
В третьем случае есть ещё одна деталь. В нужном билете говорится, что положение символов влияет на пароль, но слова «перестановка» в нём вообще нет — даже по основе перестановк. Поэтому ноль у обычного поиска объясняется текстом самой заметки, а не тем, что в запросе стояла другая форма слова.
Здесь всего 16 учебных файлов и три вопроса. Как те же модели справятся с чужим хранилищем, эта проверка не показывает.
Вся облачная серия с построением индекса и кнопкой Rerank обошлась меньше сотой доли цента. Технические детали, включая разные модели и Rerank, спрятал ниже, чтобы не превращать знакомство с плагином в отчёт об API.
Нашёл запись — проверил остальные
После нескольких правок конспектов в них начинают оставаться незавершённые переходы. В одном билете ссылка на объяснение, которое собирался дописать; в другом целая копия старой заметки. Для этой части Veynrel есть Health — локальная проверка ссылок, точных дубликатов и других проблем со структурой файлов.
В учебном наборе я специально оставил два дефекта: ссылку [[Вторая производная]] в билете «Проверка экстремума» без целевого файла и точную копию заметки о нулевой производной. Запустил Health — настоящая проверка нашла оба случая.
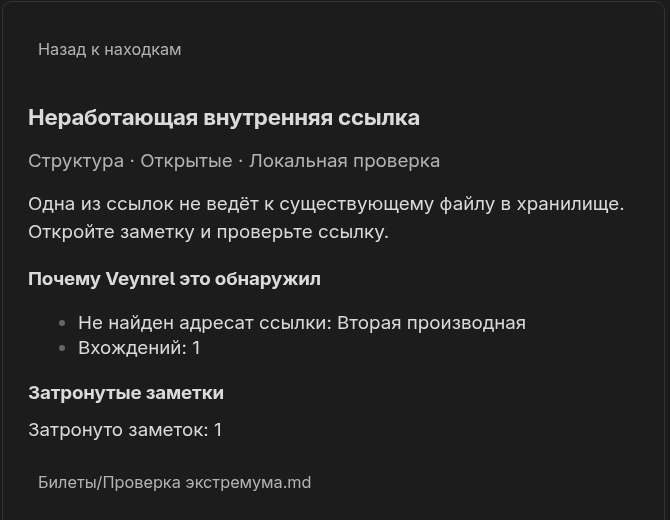
Есть ссылка на «Вторую производную», а самой заметки нет. Видно, из какого билета она ведёт.
Открываю карточку и вижу, что именно нужно поправить. Может быть, дописать объяснение, а может, ссылка осталась от старого плана. Поиск дубликатов тоже не обязан заканчиваться удалением: две похожие записи иногда нужны для разных целей. Сама проверка проходит локально, без языковой модели и API-ключа.
Когда конспект уже прочитал
С билетом ещё одна знакомая неприятность: читаю ответ — всё кажется понятным. Пробую рассказать вслух и внезапно забываю условие или знак. Поэтому в Veynrel есть Recall — карточки для повторения. В Markdown записаны вопрос и ответ, плагин находит их и составляет расписание.
Для демонстрационной папки я использовал четыре заранее подготовленные карточки. На одной вопрос о том, что означает положительная производная. Я раскрыл ответ и после съёмки выбрал «Хорошо». Следующее повторение действительно записалось в данные плагина, остальные карточки не изменились.
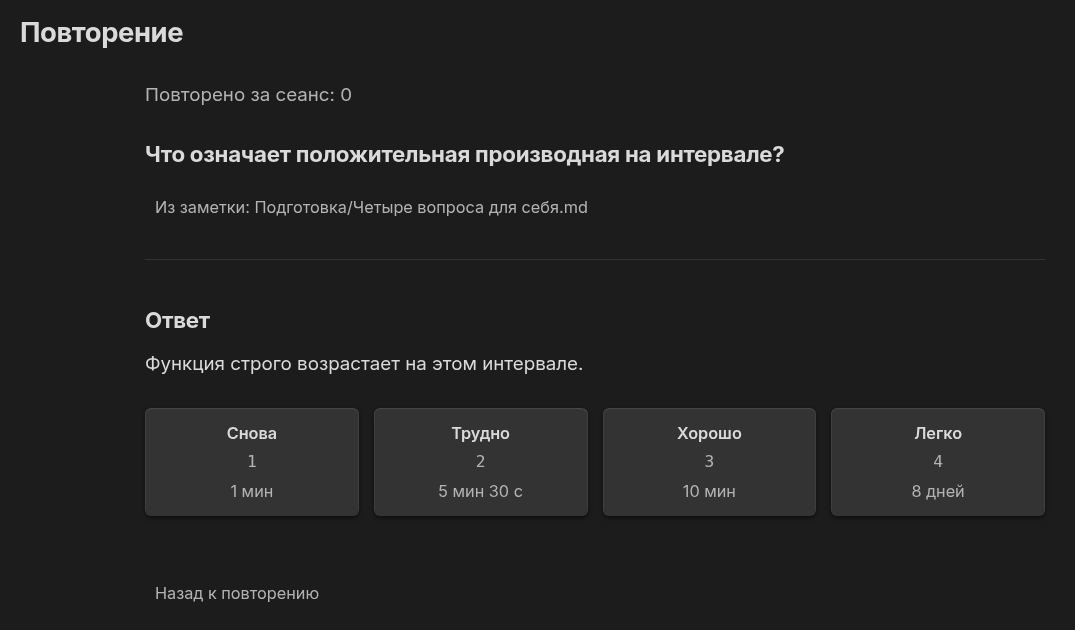
Раскрытый ответ и варианты оценки. Кадр сделан до того, как одна карточка получила «Хорошо».
Если вопрос не вспоминается, возвращаюсь к конспекту и разбираю пример. Короткие вопросы помогают проверить, какие части материала уже получается объяснить по памяти. Recall в этом режиме тоже работает локально.
Что ещё есть в Veynrel
Изначальные команды работы с текстом со временем превратились в Studio. Там сохраняются сценарии обработки: оформить заметку, сделать журнал тренировки или привести длинный текст к понятной структуре. Есть и создание редактируемых схем для Excalidraw. Эти инструменты требуют настроенной модели; результат перед записью просматривается отдельно. Подробно о работе с LLM и её ошибках я уже писал в статье «Как я оформляю тренировки и питание в Obsidian с помощью LLM и что она теряла по дороге».
После появления Studio добавил и Community Library: пользователи делятся своими сценариями обработки.
Обсуждения уже влияли на разработку: в комментариях к первой статье мне предложили подключение через MCP — способ дать AI-агенту доступ к заметкам. Интеграция через Veynrel Companion уже есть в релизе 1.8.0: агент читает синхронизированные копии заметок и предлагает изменения, которые я подтверждаю в Obsidian. В версии 2.3.1 подключение и просмотр предложений находятся в разделе Connect; для работы нужен запущенный сервер Companion.
Для тех, кому нужны подробности: модели, Rerank и цена
В съёмке на MiniLM работала paraphrase-multilingual-MiniLM-L12-v2 через ONNX CPU и OpenAI-совместимый сервер на этом же компьютере. Это был именно локальный сервер, не OpenRouter. В облачной серии проверялась baai/bge-m3 через OpenRouter. Для неё Veynrel построил новый индекс; она поставила три нужных файла на позиции 1 / 1 / 1, а MiniLM — 1 / 4 / 1. Числа близости между моделями напрямую не сравниваются.
У Veynrel есть Rerank — кнопка «Уточнить результаты». На втором запросе через mongodb/rerank-3-lite она изменила порядок 16 кандидатов, но нужный билет уже стоял первым после BGE-M3 и первым остался. В предыдущем бенчмарке на 24 вопросах с ответом метрика nDCG@10 улучшилась в 11 случаях, не изменилась в 11 и ухудшилась в 2. Это другой набор данных и другая проверка.
Шесть платных запросов облачной серии стоили 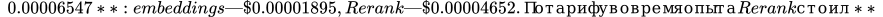 0.02 за миллион входных токенов, а BGE-M3 — $0.01 за миллион входных токенов. Это расход маленького синтетического корпуса; цена большого хранилища будет другой. Тарифы OpenRouter.
В локальной серии на Ollama работали Ollama 0.40.14 и bge-m3:latest в GGUF F16, digest 790764642607…, на CPU. Штатный Ollama-провайдер Veynrel создал отдельный индекс из 19 векторов по 1024 компоненты. Позиции нужных файлов — 1 / 1 / 1, без Rerank. При индексации и поиске заметки не покидали компьютер; облачных запросов в этой серии не было. Локальная сборка и облачная конфигурация не объявляются одинаковыми: ответы OpenRouter не сообщают формат и точность весов, а совпадения трёх рангов для такого вывода мало.
Методика и сырые файлы сохранены в исходном архиве демонстрации. Три вопроса и 16 специально подготовленных заметок не доказывают превосходство одной модели во всех задачах.
Как попробовать
Если Obsidian ещё нет, скачайте его с официального сайта и создайте папку с несколькими заметками по одной теме. Свяжите пару файлов между собой. Veynrel затем устанавливается через Настройки → Сторонние плагины → Обзор. Ищите Veynrel, установите и включите. С локальной проверки Health начать проще всего: она работает без модели.
Для поиска по смыслу есть проверенный локальный вариант без API-ключа:
Установите и запустите Ollama, затем выполните
ollama pull bge-m3. Модель занимает около 1,2 ГБ на диске; до загрузки проверьте свободное место и память.В настройках эмбеддингов Veynrel выберите Ollama, модель
bge-m3и адресhttp://127.0.0.1:11434, без/v1. API-ключ не нужен.Проверьте подключение, постройте новый индекс небольшой папки и задайте вопрос своими словами. Для новой конфигурации нужен свой индекс, даже если прежде использовалась облачная BGE-M3.
Проверенный облачный вариант остаётся отдельной настройкой: OpenRouter и baai/bge-m3. Для него понадобятся ключ, баланс и новый индекс. При таком подключении фрагменты заметок уходят внешнему провайдеру, поэтому для первого опыта лучше взять некритичные записи. Пошаговая документация Veynrel.
На другой папке результаты могут отличаться.
Репозиторий Veynrel · Релиз 2.3.1
На каком месте оказалась нужная заметка при вашем первом поиске?