Множественное тестирование — это проверка нескольких гипотез, при которой отдельные значимые результаты нужно оценивать с учётом всей процедуры поиска.
Привет, Хабр! Мы — Karpov Courses, образовательная платформа для специалистов по данным и IT. Давайте представим ситуацию. Команда протестировала пять экранов оформления заказа. У четырёх p-value меньше 0,05. Можно выбирать, что запускать?
Пока рано: каждое сравнение могло показать случайное улучшение. Порог 0,05 в отдельной проверке не гарантирует такой же риск для всего набора. После поправки из четырёх находок может остаться одна, две или три.
Посчитаем три поправки на одном примере и сформулируем вывод для отчёта. Такой разбор пригодится при проектировании тестов, проверке аналитических выводов и подготовке к собеседованию.
Почему один A/B-тест превращается в несколько проверок
Варианты, метрики и сегменты: откуда берутся множественные сравнения
Один запуск в платформе экспериментов может содержать много статистических проверок. В нашем случае есть контроль A и пять вариантов B–F. Вопрос «какие варианты лучше A?» требует пяти сравнений.
А если нужно сравнить все экраны между собой? Для k групп количество попарных сравнений равно:
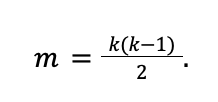
В нашем кейсе шесть групп: 6 × 5 / 2 = 15 пар. Для сравнений только с контролем — m = k − 1 = 5. Считаем проверки, а не группы, и не добавляем пары, которые не нужны для задачи.
В обычном A/B-тесте тоже бывает много проверок: конверсия, выручка, удержание, разрезы по устройствам и регионам. Если успех объявляют по любому значимому результату, все эти возможности влияют на риск ошибки.
Как растёт вероятность ложной тревоги
Ошибка первого рода — отклонение истинной нулевой гипотезы. Например, мы объявляем рост конверсии, хотя новый экран в действительности работает не лучше контроля.
Уровень значимости α = 0,05 ограничивает вероятность этой ошибки в отдельной корректной проверке при истинной нулевой гипотезе. Это не вероятность того, что конкретный найденный эффект ложный.
P-value — вероятность при истинной H₀ и предпосылках модели получить статистику не менее экстремальную, чем наблюдаемая, в направлении альтернативы. Это мера несогласованности данных с H₀, а не вероятность её истинности.
Для начала уберём реальные эффекты: пусть все m нулевых гипотез истинны, проверки независимы и каждая ошибается с вероятностью α. Избежать ошибки в одной проверке можно с вероятностью 1 − α, во всех — (1 − α)^m. Вычтем её из единицы:
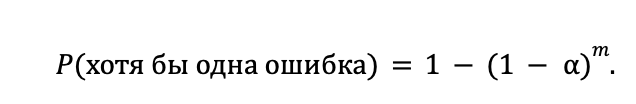
При α = 0,05 получаем:
Число проверок | Расчёт | Вероятность хотя бы одной ложной тревоги |
1 | 1 − 0,95¹ | 5% |
10 | 1 − 0,95¹⁰ | 40,1% |
20 | 1 − 0,95²⁰ | 64,2% |
50 | 1 − 0,95⁵⁰ | 92,3% |
40,1%, 64,2% и 92,3% рассчитаны для независимых проверок истинных H₀. В нашем кейсе общий контроль связывает сравнения: колебания его конверсии влияют на все результаты. Формула не даёт точный риск для этого A/B/n-теста.
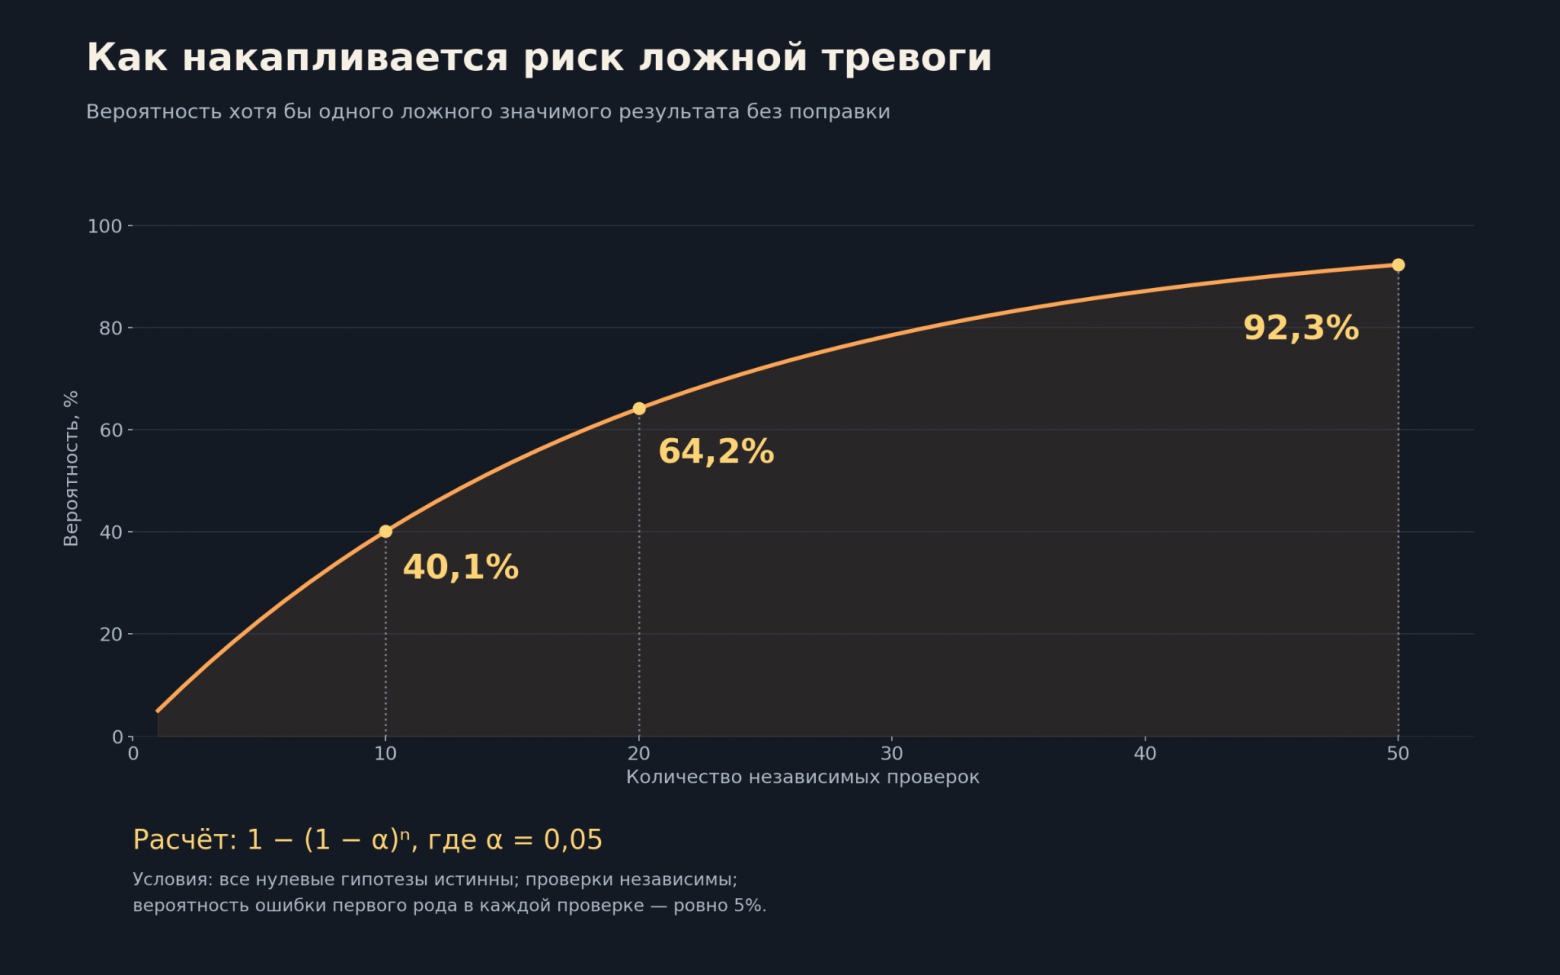
И всё же задача уже видна: нужно контролировать ошибку всей процедуры, а не надеяться на порог 5% в каждом её шаге.
Что контролировать: FWER или FDR
Семейство гипотез: какие проверки учитывать вместе
Семейство гипотез — это набор статистических проверок, для которого контролируют общий риск ошибки. Его определяют заранее, исходя из того, какие результаты будут основанием признать эксперимент успешным.
Пять вариантов экрана сравнивают с контролем по конверсии — получаем семейство из пяти гипотез. Если успех можно объявить по любой из трёх метрик для любого варианта, проверок уже пятнадцать.
Эксперименты могут решать разные задачи, и объединять их в одно семейство не обязательно. Но если затем выбирать из них «лучшие улучшения квартала» по статистической значимости, нужно учитывать риск ложных находок при таком отборе.
Александр Давыдов, преподаватель «Симулятора A/B-тестов», начинает объяснение дизайна с постановки задачи:
«На первом этапе мы должны с вами сформулировать гипотезу. Гипотеза должна быть сформулирована на базе той фичи или того изменения, которое мы с вами делаем в продукте».
Александр — лид аналитики с опытом более девяти лет, включая продуктовую аналитику и руководство командами в Дзене (VK), inDrive, Ситидрайве, Самокате и Мегамаркете.
Обычно выделяют целевую, защитные и вспомогательные метрики. В нашем кейсе по конверсии оцениваем успех, защитными проверяем вред, вспомогательными объясняем поведение пользователей.
Если конверсия не выросла, нельзя объявить основной метрикой добавление в корзину ради его значимости. Неожиданную находку можно исследовать, но нельзя выдавать за запланированное подтверждение.
FWER и FDR: два разных критерия ошибки
Обозначим V число ошибочно отклонённых истинных нулевых гипотез, а R — общее число отклонённых гипотез.
FWER, family-wise error rate, — вероятность хотя бы одного ложного отклонения в семействе:
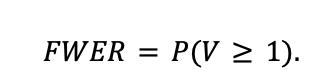
Контроль FWER на уровне 0,05 означает: вероятность допустить хотя бы одну такую ошибку не превышает 5% при выполнении условий процедуры.
FDR, false discovery rate, — математическое ожидание доли ложных отклонений среди всех отклонённых гипотез:
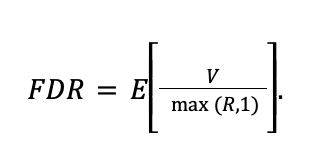
Если отклонений нет, доля равна нулю. FDR 5% не гарантирует максимум 5% ложных результатов в каждом отдельном наборе: ограничено математическое ожидание.
Вопрос | FWER | FDR |
Что ограничиваем | Вероятность хотя бы одной ложной находки | Ожидаемую долю ложных находок среди всех находок |
Когда подход особенно полезен | Даже одна ложная находка может привести к дорогому ошибочному решению | Нужно отобрать набор перспективных гипотез для дальнейшей работы |
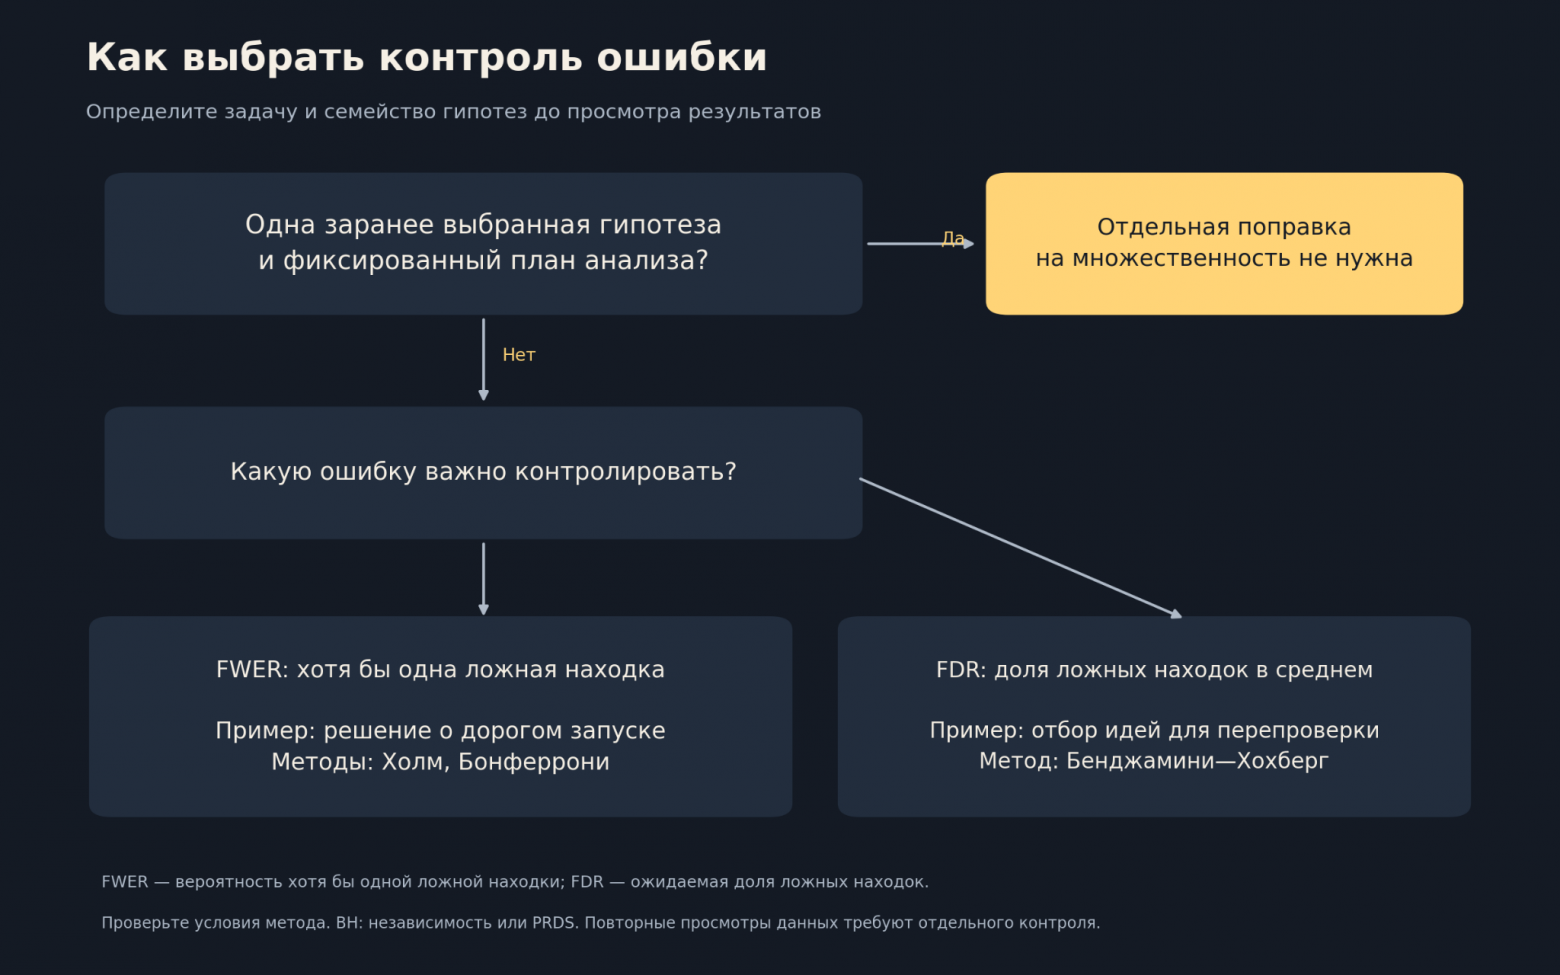
Если ошибка может привести к дорогому и неудачному запуску, лучше контролировать FWER. Если мы пока отбираем перспективные идеи, которые затем проверим в новых экспериментах, можно выбрать FDR. Главное — понимать, чем обернётся ложная находка, а не просто считать гипотезы.
Если реальных эффектов нет, любой значимый результат будет ложной находкой. В таком случае FDR и FWER совпадают: оба показателя равны вероятности получить хотя бы один ложный значимый результат.
Когда нужен контроль множественности, а когда отдельная поправка не требуется
Если вы заранее выбрали одну гипотезу и проверяете её по установленному плану, поправка на множественные сравнения не нужна. Дополнительные графики и описательная статистика сами по себе этого не меняют — пока вы не используете их, чтобы заявить о новых эффектах.
Другая ситуация: команда проверяет несколько метрик, вариантов или сегментов и выбирает те, где нашлась значимость. У случайности появляется больше шансов повлиять на вывод, и это нужно учитывать.
Важно различать проверку заранее сформулированной гипотезы и поиск новых идей в данных. Исследовать неожиданные закономерности полезно, но найденный эффект ещё предстоит подтвердить. Например, в новом эксперименте на независимых данных. Если вывод делают по тем же данным, выбранный метод должен учитывать, как именно искали и отбирали находки.
Некоторые методы уже учитывают множественные сравнения. Если вы получили скорректированные p-value, повторно применять к ним поправку не нужно.
Бонферрони, Холм и Бенджамини—Хохберг на одном примере
Вернёмся к пяти новым экранам B–F и контролю A. Целевая метрика — конверсия в покупку. Для каждого варианта до запуска выбрана односторонняя проверка увеличения конверсии: H₀ — конверсия не выше контрольной, H₁ — выше.
В семействе пять гипотез. Предполагаем корректную рандомизацию и расчёт p-value, анализ в запланированный момент.
Вариант против контроля | Исходный p-value | Значим при пороге 0,05 без поправки? |
B | 0,004 | Да |
C | 0,012 | Да |
D | 0,024 | Да |
E | 0,041 | Да |
F | 0,180 | Нет |
Четыре варианта проходят обычный порог. Теперь зададим α = 0,05 для FWER и q = 0,05 для FDR. Сначала сравним процедуры в учебных целях; в рабочем эксперименте выбор делают до получения этих чисел.
Поправка Бонферрони: единый порог для всех проверок
Начнём с самого простого решения. Метод Бонферрони делит допустимый уровень ошибки α на число проверок m:
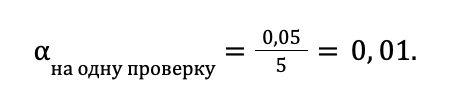
Порог проходит только вариант B: его p-value равен 0,004. Значения 0,012, 0,024 и 0,041 уже недостаточно малы.
Тот же результат можно получить, скорректировав сами p-value:
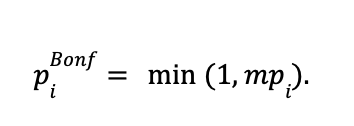
Сравниваем с α = 0,05: для B получаем 0,020, для C — 0,060. Проходит B. Не сравнивайте скорректированные p-value с α/m: это двойная корректировка.
Поправка Бонферрони для множественных сравнений использует границу: вероятность объединения событий не больше суммы их вероятностей. Если вероятность ошибки для каждой истинной H₀ не превышает α/m, риск хотя бы одной ошибки не выше α. Независимость не требуется.
Сработало: вместо четырёх находок осталась одна. Но единый строгий порог может отсеять и реальный эффект. Можно ли сохранить контроль FWER и получить больше мощности?
Метод Холма: последовательная проверка гипотез
Метод Холма—Бонферрони отвечает на этот вопрос последовательностью порогов вместо одного общего.
Сначала сортируем p-value от меньшего к большему. Затем значение с номером i сравниваем с α/(m − i + 1). Если проверка проходит, идём дальше. При первом непройденном пороге останавливаемся: эту и все следующие гипотезы не отклоняем.
Шаг | Вариант | p-value | Порог Холма | Решение |
1 | B | 0,004 | 0,05/5 = 0,0100 | Отклоняем H₀ |
2 | C | 0,012 | 0,05/4 = 0,0125 | Отклоняем H₀ |
3 | D | 0,024 | 0,05/3 ≈ 0,0167 | Не отклоняем H₀, останавливаемся |
4 | E | 0,041 | — | Не отклоняем H₀ |
5 | F | 0,180 | — | Не отклоняем H₀ |
Теперь проходят B и C. Для C порог вырос до 0,0125 — его p-value = 0,012 проходит. На D останавливаемся.
Холм контролирует FWER при произвольной зависимости корректных p-value. При одинаковых семействе и α он отклоняет как минимум все гипотезы, которые отклонил бы Бонферрони. Поэтому для универсального контроля FWER часто выбирают Холма.
Метод Бенджамини—Хохберга: контроль FDR
Теперь изменим постановку: вместо риска хотя бы одной ошибки ограничим ожидаемую долю ложных находок на уровне q = 0,05. Это уже другая гарантия.
Поправка Бенджамини—Хохберга также начинается с сортировки p-value. Для каждого ранга i вычисляем порог iq/m. Затем находим наибольший ранг k, для которого выполняется условие:
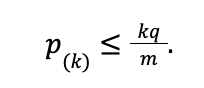
Отклоняем гипотезы с рангами 1–k. В отличие от Холма, нельзя остановиться на первом превышении порога: ищем последний подходящий ранг.
Ранг | Вариант | p-value | Порог iq/m | Условие выполнено? |
1 | B | 0,004 | 0,010 | Да |
2 | C | 0,012 | 0,020 | Да |
3 | D | 0,024 | 0,030 | Да |
4 | E | 0,041 | 0,040 | Нет |
5 | F | 0,180 | 0,050 | Нет |
Последний подходящий ранг — 3: остаются B, C и D. Если бы ни одно значение не прошло свой порог, BH не отклонил бы ни одной гипотезы.
BH гарантирует контроль FDR при независимости или определённой положительной зависимости — PRDS. Одной положительной корреляции недостаточно для подтверждения этого условия.
В учебном примере предполагаем эти условия выполненными; общий контроль сам по себе их не доказывает. Для более общей зависимости существует более строгая процедура Бенджамини—Екутиели.
Какие выводы изменились после поправок
Соберём скорректированные p-value в одной таблице.
Вариант | Без поправки | Бонферрони | Холм | Бенджамини— Хохберг |
B | 0,004 | 0,020 | 0,020 | 0,020 |
C | 0,012 | 0,060 | 0,048 | 0,030 |
D | 0,024 | 0,120 | 0,072 | 0,040 |
E | 0,041 | 0,205 | 0,082 | 0,05125 |
F | 0,180 | 0,900 | 0,180 | 0,180 |
Число отклонённых H₀ | 4 | 1 | 2 | 3 |
Для скорректированных p-value Холма берут накопленный максимум (m − i + 1)p₍ᵢ₎, у BH — накопленный минимум mp₍ᵢ₎/i с конца отсортированного списка. Значения ограничивают единицей и возвращают в исходный порядок.
Мы получили обещанные один, два и три значимых результата. Это не значит, что мы узнали, какие изменения действительно работают. Каждый метод оценивает результаты по своим правилам и контролирует определённый риск ошибки.
Чем строже порог значимости, тем сложнее обнаружить реальный эффект. Так может снизиться мощность теста и вырасти риск ошибки второго рода — пропустить существующее улучшение. Метод Бенджамини—Хохберга часто позволяет найти больше эффектов, но контролирует ожидаемую долю ложных находок, а не вероятность хотя бы одной ошибки. Поэтому переходить к нему только ради значимых результатов нельзя.
Как учитывать множественные проверки в дизайне эксперимента
До запуска: гипотезы, семейство, метод и размер выборки
Контроль в эксперименте начинается с правил, по которым команда будет принимать решение. До запуска полезно зафиксировать:
Продуктовую гипотезу. Что меняем, на кого воздействуем и какого результата ожидаем.
Роли метрик. Какая метрика целевая, какие защищают от нежелательных последствий, какие нужны для исследования.
Семейство гипотез. Какие варианты, метрики и сегменты входят в совместный контроль ошибок.
Процедуру анализа. Критерий, направление проверки, FWER или FDR, метод поправки и допустимый уровень ошибки.
План сбора данных. Размер выборки, длительность, правила промежуточного анализа и остановки.
Поправку учитывают при расчёте выборки. Для пяти сравнений с Бонферрони отдельный порог равен 0,01. Расчёт объёма как для единственного теста с α = 0,05 может не обеспечить нужную мощность после поправки.
Пять сравнений не требуют ровно впятеро больше пользователей: объём зависит от эффекта, дисперсии, трафика и процедуры. Мощность сложного дизайна оценивают симуляцией всего анализа с поправкой, уточнив цель: обнаружить конкретный эффект, хотя бы один или все.
После завершения: пересчёт p-value и интерпретация результатов
Для расчёта можно использовать multipletests из statsmodels. В функцию передаём все исходные p-value выбранного семейства, включая незначимые:
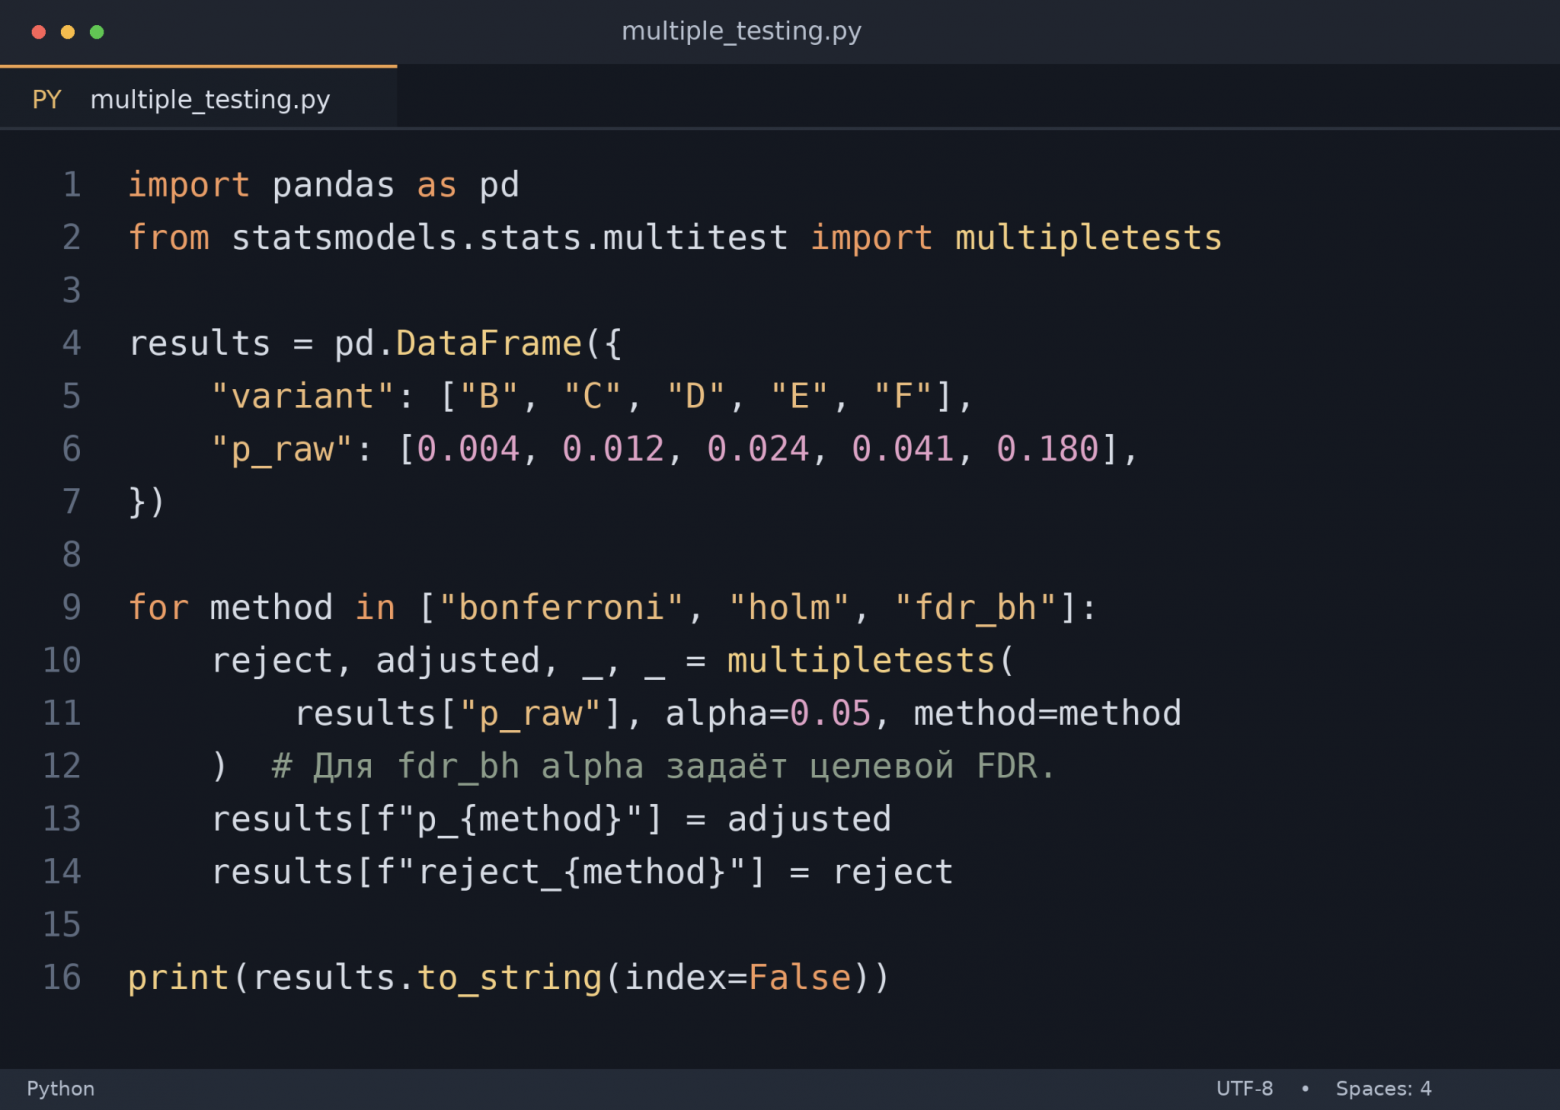
В примере мы применили три метода, чтобы показать разницу между ними. В реальном эксперименте метод выбирают до просмотра результатов. Библиотека лишь выполняет расчёты: определить, какие гипотезы учитывать вместе и подходит ли статистический тест для вашего эксперимента, должен аналитик.
Для совместных выводов по нескольким интервалам нужна одновременная гарантия покрытия: поправка p-value не корректирует интервалы автоматически. Например, для пяти двусторонних интервалов Бонферрони с общим уровнем 95% каждый строят с уровнем 99%.
Что написать в отчёте и какой вариант запускать
Допустим, до старта мы выбрали Холма. Статистический итог можно записать так:
«Проверены пять заранее заданных односторонних гипотез об увеличении конверсии относительно контроля. Применён метод Холма с уровнем FWER 0,05. Для B и C нулевые гипотезы отклонены: скорректированные p-value равны 0,020 и 0,048. Для D, E и F оснований для отклонения недостаточно».
Но запускать B только из-за наименьшего p-value рано. Он не обязательно даёт наибольший или наиболее выгодный эффект. И если B и C лучше контроля, это ещё не доказывает, что B лучше C: для такого утверждения нужно отдельное сравнение в корректном плане анализа.
Укажите в отчёте, насколько изменились метрики, приведите доверительные интервалы, результаты проверки защитных метрик и оценку затрат на внедрение. Если статистически значимого ухудшения не обнаружено, это ещё не значит, что изменение безопасно: данных могло не хватить. Поэтому заранее определите, какое ухудшение допустимо и как вы будете проверять, что оно не превышает эту границу.
Где отработать эти решения на практике
В нашем примере p-value уже были рассчитаны, а семейство гипотез — определено. В работе эти решения предстоит принять самостоятельно: сформулировать задачу, выбрать метрики, спланировать эксперимент и понять, какие выводы позволяют сделать данные.
Пройти этот путь с экспертом можно в нашем «Симуляторе A/B-тестов». Курс недавно обновили: увеличили число уроков с 13 до 16, изменили последовательность обучения и переработали финальный проект.
Александр Давыдов объясняет главное изменение так:
«Теперь мы попробовали пересобрать курс от бизнес-вопроса к инструменту решения этого вопроса».
Всё обучение построено вокруг одного кейса, связанного с выручкой от рекламы. Вы последовательно решаете задачи разных этапов A/B-тестирования: выбираете метрики, рассчитываете выборку, анализируете результаты. В финальном проекте используете написанный ранее код, чтобы собрать полный процесс анализа эксперимента. Так отдельные методы складываются в понятную последовательность действий.
Симулятор подойдёт аналитикам уровня middle, которые готовят и запускают тесты, продактам, которые проверяют аналитические выводы или хотят ускорить эксперименты, и специалистам, готовящимся к собеседованиям с блоком A/B-тестирования. Для обучения нужны базовый Python, SQL и знание основных статистических понятий.
Частые ошибки при множественном тестировании
Применять поправку только к значимым результатам.
Допустим, вы проверили двадцать гипотез, но значимость получили только для трёх. Если скорректировать лишь эти три p-value, остальные попытки найти эффект останутся без учёта. В поправку нужно включить все проверки выбранного семейства, независимо от их результатов.
Выбирать метод, который оставляет больше значимых результатов.
После Бонферрони осталась одна находка, а после BH — три. Это не повод выбирать BH: методы контролируют разные риски ошибок. Сначала определите, какие ошибки важно ограничить в вашей задаче, и выберите метод. Только потом анализируйте результаты.
Считать, что после значимой ANOVA можно сравнивать любые пары без поправки.
ANOVA показывает, что не все средние одинаковы, но не объясняет, какие именно группы различаются. Если затем сравнивать группы попарно, риск ложных находок нужно учитывать отдельно. Для всех пар средних можно использовать метод Тьюки, для сравнений с контролем — Даннетта, если выполнены условия этих методов. Ещё один вариант — применить Холма к корректно рассчитанным p-value выбранных сравнений.
Выдавать эффект, найденный в одном сегменте, за подтверждённый результат.
Если вы перебрали десятки срезов и нашли значимость только в одном, нельзя оценивать его так, будто это была единственная запланированная проверка. Нужно учитывать весь поиск. И ещё: значимый эффект на Android и незначимый на iOS не доказывают, что изменение по-разному влияет на эти платформы. Разницу между эффектами нужно проверить отдельно.
Надеяться, что поправка исправит любые ошибки эксперимента.
Поправка не поможет, если пользователей неправильно распределили по группам или, например, посчитали повторные действия одного человека независимыми наблюдениями. Она также не разрешает каждый день проверять результаты и останавливать тест при первом значимом p-value. Для промежуточных проверок нужен заранее выбранный метод, который учитывает повторные просмотры данных.
Заключение
В начале у нас было четыре p-value меньше 0,05. После Бонферрони осталась одна находка, после Холма — две, после BH — три. Выбирать наиболее приятное число нельзя: сначала определяем допустимый риск, затем применяем соответствующую процедуру.
Бонферрони и Холм контролируют FWER, BH при выполнении условий — FDR. Все они помогают учитывать множественные сравнения, но не исправляют плохой дизайн и не решают, окупится ли изменение.
Хороший итог эксперимента отвечает на три вопроса: какие утверждения поддерживают данные, с какой неопределённостью оценён эффект и почему команда рекомендует конкретное действие.
FAQ
Как посчитать число сравнений в A/B/n-тесте с тремя группами?
Если A — контроль, а B и C — варианты, для сравнений A–B и A–C получаем m = 2. Порог Бонферрони при α = 0,05 равен 0,025. Если в семейство также входит B–C, получаем m = 3 и порог примерно 0,0167. Дополнительные метрики и сегменты могут увеличить число проверок — это зависит от запланированных выводов.
Нужно ли учитывать в одном семействе все эксперименты компании?
Не автоматически: самостоятельные вопросы могут иметь отдельные семейства. Если нужна гарантия для всего потока находок компании, локальных поправок внутри тестов недостаточно — необходим контроль на уровне потока.
Что делать, если после поправки значимых результатов не осталось?
Зафиксировать недостаточность данных для отклонения гипотез при выбранной процедуре. Проверить качество данных, размер эффекта, интервалы и чувствительность дизайна. Отсутствие значимости не доказывает отсутствие эффекта. Можно спланировать новый эксперимент, но нельзя просто продолжать набор до желаемого p-value без корректного правила остановки.