Некоторые верят, что достаточно быстренько запустить Claude, подкинуть ему промпт, и готово. Так и есть, пока решение не нужно развивать, поддерживать или делать командным. Вот тут уже так не подкинешь: мой опыт показывает, что всё не так просто.
Сам я из разработки баз данных, фронтенд не писал. Но осенью 2025 года взялся сделать сайт с помощью ИИ, и поначалу результат меня не устраивал. Мы с моделью проговаривали, что делать и как, но модель где-то на ходу понимала не так и делала не то, что запланировано. В декабре появилась первая версия пайплайна с ролями архитектора, планировщика, кодера и ревьюера. Запускал их вручную. В январе добавилась роль менеджера, и запуск стал автоматическим. С тех пор пайплайн развивается.
С чего всё началось
Сайт хотелось сделать не абстрактный, а практически полезный: CRM для знакомых, которые занимаются прокатом машин и обучением вождению. Стек выбирал между TypeScript с нагрузкой на фронт и Python Django, который собирает странички на сервере. Django показался проще: Python хотя бы читаемый и понятнее для меня. Думал заодно изучить Python, но до этого не дошло. После исследований с Gemini, по-моему, тогда ещё 2.5 Pro, я взял Django. Позже в той же CRM появилось второе направление — для аэроклубов.
Опыт работы с моделями был в формате чатов. Начинал я с бизнес-требований (BRD) и описания архитектуры, которые потом и стали постановками для реализации. Писал их сначала в Gemini и увидел, что у меня он плохо справлялся с документами: неправильно делал изменения, что-то перезатирал. Я начал смотреть другие оболочки и в течение месяца попробовал топовые консольные агенты. Codex CLI понравился тем, что сразу без проблем всё делает и попутно учит командам. Ripgrep, например, я узнал от него. Знания между чатами переносил вручную. Сжатие контекста тогда работало хуже, приходилось делать выжимки, куда-то их записывать и переносить в новый тред.
Четыре круга рефакторинга
В ноябре я делал общие ресурсы для машин, инструкторов и площадок. Формы Django у них похожие, механики одинаковые, и хотелось, чтобы код был максимально переиспользуемый. Пошёл на рефакторинг.
Codex отчитался, что всё сделал. Открываю, смотрю, а там всё то же самое. Немножко поменялись имена, где-то что-то схлопнулось. Вместо того чтобы переделать кардинально, мы с моделью топтались на месте. Провели ревью, посмотрели: нет, не изменилось. Заново запустил процесс в других чатах, и со второго раза практически ничего не изменилось. Четыре круга закончились тем, что я просто плюнул. Понял, что промптирование по кускам и даже перенос знаний между чатами не работает так, как мне нужно. Модель что-то делает, а что именно сделано, я понимаю только в конце.
Немного забегая вперёд: у истории с формами получилось продолжение, когда я начал оптимизировать процессы внутри пайплайна. Искал формат документа, чтобы изменения в формах инструкторов, техники и площадок шли одинаково, а не вразнобой. Документ разросся, появились отдельные документы с API, с методами фронта и бэкенда. Позже, в феврале, я применил golden paths. Это короткие рецепты: для типовой формы открой вот эти 3–5 документов, в них уже описано состояние системы. Их предложила роль архитектора, когда разбирала статью OpenAI о harness engineering. Проблем, по ощущениям, стало меньше. Формы к единому коду так и не свёл. Довёл их до понятного уровня одинаковости, и на этом мой перфекционизм был прекращён и забит.
Назначение ролевого пайплайна
После четырёх кругов я понял, что мне нужен пайплайн, который бы за меня контролировал состояние задачи. Но так, чтобы я заранее понимал, что он собирается делать и как понимает задачу. Нужна была декомпозиция, проверка каждого шага и валидация другими моделями: каждый шаг сам я проверить не могу. Так и родилась вся эта структура. В пайплайне работу можно разбить на отдельные участки: сначала подумать, как сделать, потом понять, что будем менять, потом сделать и проверить. Для повышения качества проверить ещё и другой моделью. В конце сделать вывод, что сделали и что проверили, соответствует ли это постановке, и занести в Git.
Сейчас через пайплайн у меня идут только те изменения, после которых должен остаться след. Например, в Tooling. В этом проекте развивается мой внутренний пайплайн. Переработка ядра там обязательно идёт через пайплайн, потому что потом её пакетами раздают в зависимые репозитории, и изменение ссылается на внутренний координирующий артефакт.
Как появились роли
Роли появились естественным образом из набора консольных врапперов для Codex CLI, Claude Code и GLM в Claude Code. Новые решения я уносил прорабатывать в Codex с моделями GPT-5. Они строили верхнеуровневую архитектуру, что делать и как. Но переделать формы с ними так и не получилось. Тогда начал перепроверять их решения в Claude моделями Sonnet и Opus. Иногда просил набросать черновик кода, чтобы Codex, которому я потом относил работу, лучше понимал, что от него ждут, какого объёма и где менять. В то время считалось, что Sonnet отлично пишет код, а Codex с моделями GPT вдумчиво рассуждает. Отсюда и разделение.
Ревьюером была GLM в Claude: так я укладывался в лимиты подписок. Промпт ревьюера сначала сформулировал Sonnet, потом я дополнил его в Codex. Для первичной проверки GLM хватало. Замечания ревью я возвращал в Codex, а в конце ещё раз отдавал работу Codex в роли архитектора, чтобы понять, всё ли в порядке после блокеров, которые нашла GLM.
Так сложились четыре роли: архитектор, планировщик, кодер и ревьюер. Планировщик появился, когда я спросил, есть ли подходящая роль между архитектором и кодером. Он планирует изменения в коде и определяет набор файлов, которые надо поменять. Все роли работают с единым артефактом. Это координирующий артефакт (КА), он же план. За него отвечает архитектор, а у остальных ролей свои артефакты: черновик кода и список файлов у планировщика, изменения у кодера, отчёт ревью у ревьюеров.
Сначала работа строилась так, что я дёргал открытые консоли и говорил, что проверить и что сделать по задаче. Потом обернул роли в shell-хелперы и попросил, чтобы каждая роль в конце сама писала, кого звать следующим. Копировал ответ и запускал указанную роль. Из этого потом выросла система статусов в плане.
Для увеличения производительности я освоил новый для меня тогда подход git worktree и попробовал вести разработку параллельно сразу в пяти рабочих деревьях. Это как раз и вызвало коллапс моего внимания. Ждать и переключаться вручную стало тяжело, поэтому я перенёс эту работу на почти механическую роль, менеджера. Простым скриптом его делать не стал. Хотел контролировать общую работу, спрашивать у менеджера, на каком мы статусе, и управлять процессом не только промптами ролей.
Сейчас ролей пять: архитектор, планировщик, кодер, ревьюер и менеджер. Ревьюер делится на два по зонам ответственности, чтобы качественнее проводить проверку и глубже погружаться в контекст. Поверх этого в какой-то момент работу разделяли даже по моделям. Две линии работали на разных версиях GPT, и каждая тяготела к своему виду ревью. Сейчас модели стали универсальными, поэтому пока обе линии работают на одной модели, GPT-6.1 Sol в режиме Ultra. Проверка другой моделью сейчас в целом происходит не в пайплайне, а вне его.
Координирующий артефакт
У координирующего артефакта больше смысла, чем передача чата. Его задача в том, чтобы все роли читали и видели задачу одинаково. Роль дописывает артефакт при разборе задачи, в работе и при самопроверке. Так она подтверждает, что понимает, что делает. Артефакт служит единой точкой синхронизации всей работы. Ведёт его роль архитектора, свои разделы дописывают планировщик, кодер и ревьюер, а менеджер только читает его и передаёт работу дальше. Новому разработчику я бы объяснил так: это место, где команда обменивается статусами и складывает ответы по задаче.
Сложился он исторически. Оболочек агентов было несколько: Codex, где-то Gemini CLI, Claude с разными моделями. Переносить статус между ними вручную было хлопотно, приходилось метаться туда-сюда. Мне нужно было, чтобы между сжатиями контекста выживала сама задача. Писал промпты, которые сбрасывали контекст в файл, чтобы потом продолжить с ним работу. Подтверждение пришло позже: рынок принял такие подходы в виде SDD-фреймворков (spec-driven development), например Spec Kit, OpenSpec, BMAD и Kiro.
Заставить роли перечитывать артефакт оказалось отдельной задачей. Роли полагались на свою память о том, что в плане. Однажды роль архитектора заявила, что сейчас должен работать планировщик, хотя планировщик уже отработал и задачу пора было отдавать кодеру или возвращать архитектору. Роль, архитектор или планировщик, отказалась работать, сославшись на то, что в документе ничего не изменилось. Статус в шапке плана тогда уже был, но роль его не пересчитывала. Тогда я ввёл хелпер: роль спрашивает статус у него и не придумывает сама. Так статус перестал выдумываться, а роль стала хоть как-то читать план, в который сгружаются все сведения.
Одна задача: от плана до скриншота
Целью было сделать автономный ролевой пайплайн, который может контролировать задачу на всех этапах её реализации. Мне остаются два момента: подать задачу на вход и проверить, что получилось на выходе. На входе модель пишет блок о том, как она поняла задачу, и я его периодически читаю. На выходе проверяю готовую функциональность и артефакты в Git: скриншоты и результаты тестов по сценариям из плана. Ну и состояние очереди: закончилась — надо накидывать новую.
Покажу на одной задаче из CRM для аэроклубов: запись самолёта, инструктора и курсанта по времени. Постановку с картинками, а точнее, даже видео, готовил аналитик вместе с действующим пилотом. Я разобрал видео вне пайплайна и нарезал планы для реализации функциональности. Дальше только контролировал, как задача выполняется, по скриншотам в Git.
Шапка плана. Статус, кто его ставит, а ниже ссылки на источники правды, в том числе на golden paths:
# Plan: Air — time booking workplace flow

**Date:** 2026-03-26 01:40
**Priority:** P0
**Status:** Done

**Handoff statuses (кто ставит):**
- `Ready for Planner` — Architect
- `Ready for Coder` — Planner
- `Ready for Review` — Coder
- `Ready for Arch review` — Reviewer
- `Done` — Architect

**Context links (source of truth):**
- BRD: `docs/brd.md`
- Active golden path: `docs/htmx_form/golden_path.md`
- Calendar golden path: `docs/guides/calendar_ui_golden_path.md`
- Code draft(s): `docs/code_drafts/260326_0140_air_time_booking_workplace_flow__code_draft.md`
…
Самопроверка роли, или второе мнение, тоже пишется в план. Её делает та же модель и именно в том же треде, чтобы контекст был прогретый. Это бывает полезно. Например, перед тем как передать задачу планировщику, роль архитектора на самопроверке нашла у себя два дефекта и исправила их.
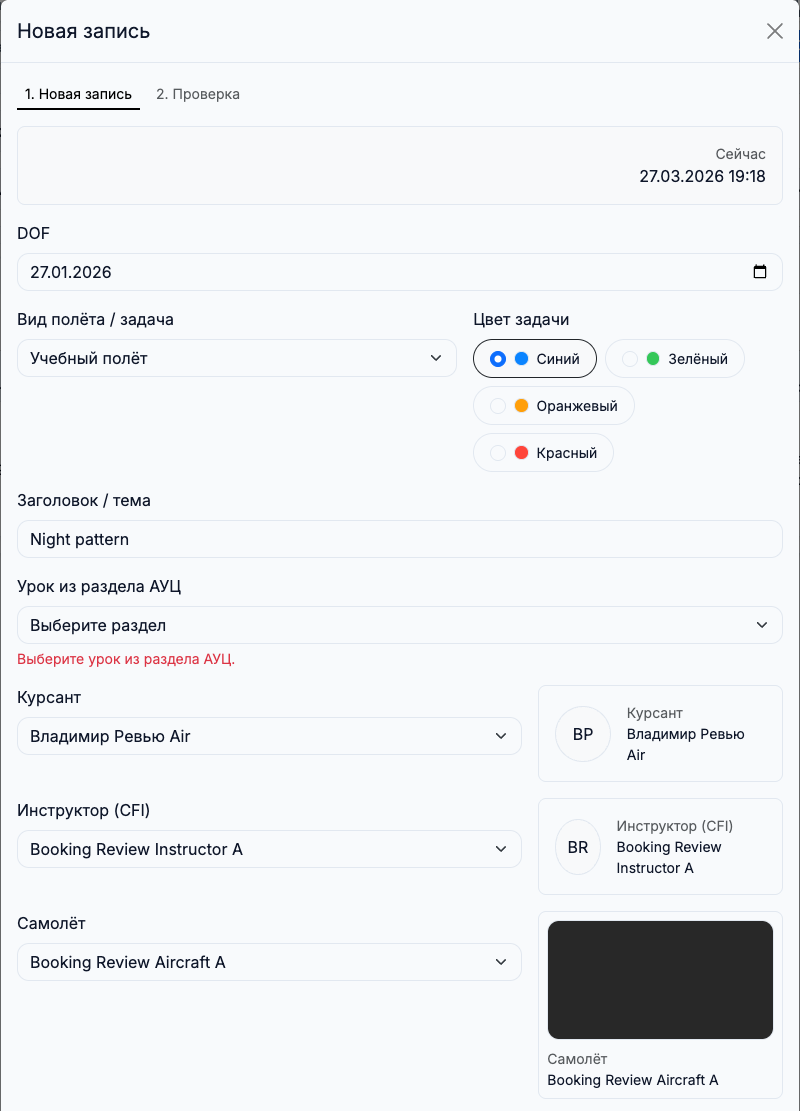
Координирующий артефакт нужен, чтобы собрать общую картину по задаче. Поэтому роли пишут свой статус в конец файла, и при переходе хода любая роль может проанализировать текущее состояние. Так планировщик увидел, что для поля «Урок из раздела АУЦ» (АУЦ — авиационный учебный центр) нет места в модели данных, и задал архитектору вопрос с пометкой «блокер». Архитектор ответил, после чего кодер приступил к работе без вопросов:
### Planner Q&A
- [2026-03-27 13:40 MSK] Q1 (to=Architect, blocker): `0140` now fixes two distinct
  first-wave inputs — `Заголовок / тема` and conditional `Урок из раздела АУЦ` — but …
  only one free-text carrier …
- [2026-03-27 13:45 MSK] (Architect, id=Q1, status=closed) CLOSED: … `Заголовок / тема`
  maps to `Booking.air_title`; conditional `Урок из раздела АУЦ` maps to
  `Booking.air_auc_lesson_label` …

### Coder Q&A
- [2026-03-27 14:07 MSK] NO QUESTIONS (sanity check passed: executable child plan,
  code draft linked, … AC/tests/commands are runnable)
Затем ревьюер дважды возвращал форму кодеру: сначала из-за языка и состава полей, потом из-за оставшегося лишнего выбора площадки. Во второй раз тест уже закрепил эту ошибку и проходил. За внутренними возвратами между ролями я не следил и в них не вмешивался. Роли коммуницировали сами.
В третий раз ревьюер прогнал проверки, снял скриншоты по сценарию из плана и сверил каждый скриншот с планом:
# Code review — 260326_0140_air_time_booking_workplace_flow
**Status:** ✅ OK

## Команды / evidence
- plan_lint.py docs/plans/260326_0140_air_time_booking_workplace_flow.md → OK
- manage.py makemigrations --check --dry-run → No changes detected
- make doc-lint → doc-lint: OK
- make test-air TESTS="apps.bookings.tests.test_services …" → OK (119 tests)
- make test-car TESTS="apps.bookings.tests.test_views …" → OK (67 tests)

## Визуальные доказательства
- air_02: same-modal invalid rerender preserves `Урок из раздела АУЦ`, entered title,
  selected client/instructor/aircraft, and preview placement.
Вот этот кадр (данные демонстрационные). Форму отправили без урока из раздела АУЦ, о котором спрашивал планировщик. Окно не закрылось, показало ошибку и сохранило заголовок, курсанта, инструктора и самолёт.
Дальше архитектор открывает все шесть скриншотов, сверяет их с планом и решает, принимать ли задачу. В первый раз он не принял, потому что набор файлов в плане не совпал с тем, что подготовили к коммиту: три файла не входили в объявленный набор, и задача вернулась кодеру. После исправления архитектор её принял. С такой конструкцией моя задача контроля упростилась: смотрю, сходятся ли план, ревью, тесты и скриншоты.
Как пайплайн прокачивает себя сам
Идея развития пайплайна реализовалась постепенно. Сначала я после каждого плана оставлял треды ролей открытыми и продолжал в них следующие планы, чтобы треды накопили историю. Пока они были актуальными, я спрашивал, что бы они предложили доделать и чем помочь по задаче или по процессу. Это были ручные промпты: спрашивал, собирал ответы, и так копились изменения. Потом это автоматизировал. В основном режиме после каждого плана роли делают docs closeout, то есть подсказывают, что по задаче ещё доделать и как улучшить процесс, чтобы не буксовать. Предложения собираются в реестры, а дальше их проверяет триаж: нужно ли это делать и в каком виде. Сначала эксперимент, потом внедрение.
В начале года я активно контролировал состояние пайплайна. После каждой задачи и проверки после слияния запускал закреплённые треды в Codex. Они смотрели, что принесли коммиты, что и как поменяли, искали аномалии. Вместе с ними докапывался до кейсов, которые что-нибудь давали.
Я погружался в новую для меня среду, читал новости и примерял чужие механики к пайплайну. Новое, что где-то увидел, по-прежнему приношу сам. С рынка приносил идеи по поиску, например QMD. Это открытый поиск по markdown-файлам. Сравнили и решили, что QMD не нужен, хватит полнотекстового поиска на SQLite.
Doc gardening я взял из статьи OpenAI о harness engineering. Это процесс, который поддерживает документацию актуальной. Как раз искал, как называется такой процесс, взял его как вариант, попробовал, и получилось.
Где нужен мой контроль
Признак, что процесс может буксовать, — лимит итераций. После 12 итераций на одном плане роль менеджера делает остановку. Итерация — это шаг менеджера: вызов роли вместе с самопроверкой. В случае аномалии я запускаю отдельный тред в Codex и разбираюсь, не ушли ли мы в сторону, не требуется ли сузить скоп и что сейчас вообще происходит. Если надо, сужаю рамки задачи или прошу разбить её на отдельные планы. Обычно на такой разбор у меня уходит до часа.
Иногда за несколько итераций упрощения плана не получается дойти до намеченной цели. Тогда я прибегаю к помощи других моделей, например Opus 5.5. Дополнительно я часто валидирую планы моделью GLM через интеграции MCP и ACP.
Бывает, что у пайплайна есть чёткая постановка, работа сделана, а направление неверное. Тогда разбираюсь, что попало в постановку и откуда это родилось. Так было с предложениями ролей в самом Tooling. Я долго это крутил и накрутил лишнего: роли отдавали предложения менеджеру, а менеджер вызывал хелпер от имени роли и записывал то, что она предлагала. Решил упростить конструкцию: роли должны вызывать хелпер сами, напрямую, без менеджера.
Или ещё пример. Летом я замечал, что GPT-5.6 Sol усложнял конструкции. Основное время уходило не на решение задачи, а на доказательство выдуманных, очень теоретических кейсов, которые потом не получалось ни воспроизвести, ни доказать в полной мере. Часто это приводило к тому, что излишне строился «чугунный мост, висящий в воздухе». Например, модель в Codex хотела сделать надстройки и изоляцию при работе с Git и его API. По задаче это не требовалось, но Codex очень хотел чистого доказательства.
Тогда я вмешался в работу: начал контролировать, какие решения принимаются, требовать упрощения и поиска альтернатив. Например, задавал допущение, что не нужно доказывать, будто где-то обломился прокси. То есть вводил намеренные упрощения, разбираясь, во что мы фактически упираемся. Картина сдвинулась, появились просветы, и задачу получилось довести. Так делаю и сейчас.
Без присмотра я оставлял пайплайн на неделю, когда планы нарезаны. Заводил 7–10 планов, и, если всё работало штатно, они закрывались. Потом на проверке после слияния смотрел коммиты и скриншоты доработок в CRM и документацию в Tooling. На месяц не оставлял ни разу.
Что получилось
CRM сделана в двух направлениях: для аэроклубов и для проката машин. Функционал в оформлении и ведении у них немного разный, его определяет ключ запуска, но сервис единый. Реализован жизненный цикл работы менеджера, клиента, инструктора и техники.
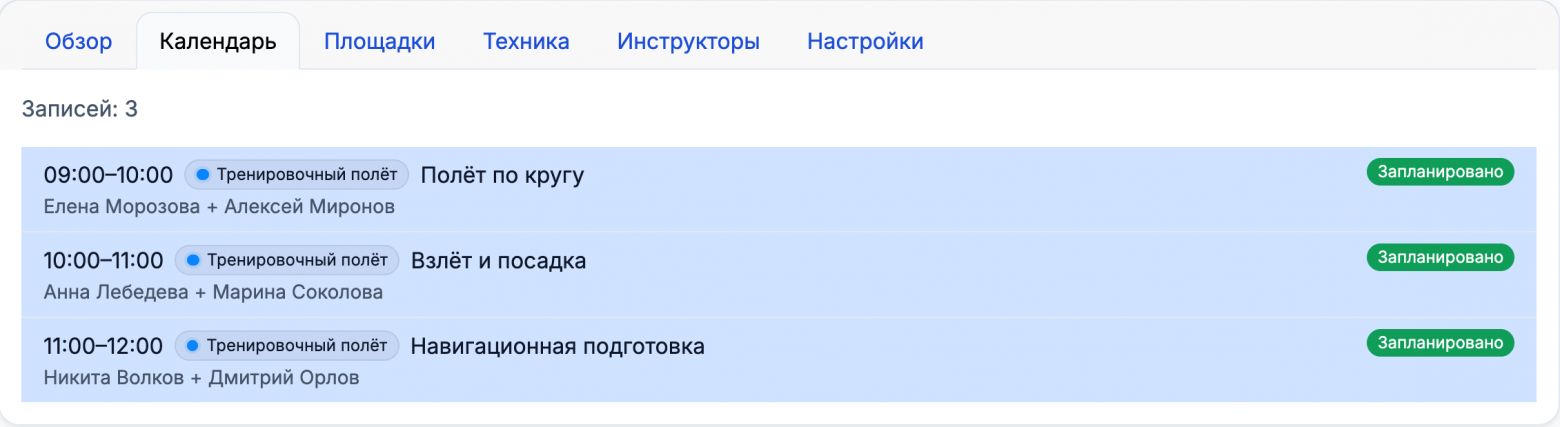
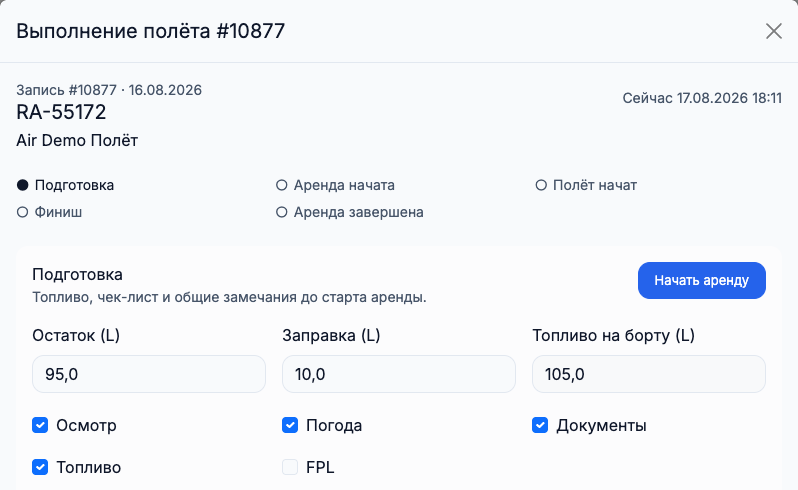
Пример функциональности, которая реализована и доступна на стенде: менеджер выбирает интервал в календаре площадок и создаёт запись, а система проверяет, хватает ли площадки, самолёта и инструктора. У инструктора в кабинете документы со сроками — удостоверение, медсертификат, страховка — и свой лётный день. Перед полётом он готовит борт, отмечает топливо и документы, дальше фиксирует аренду, начало и конец полёта с показаниями часов. После полёта у клиента в лётной книжке появляется запись с часами и комментарием инструктора, а у борта ведётся свой учёт часов. Telegram-бот присылает инструктору сводку на день и пишет менеджерам о новых записях.
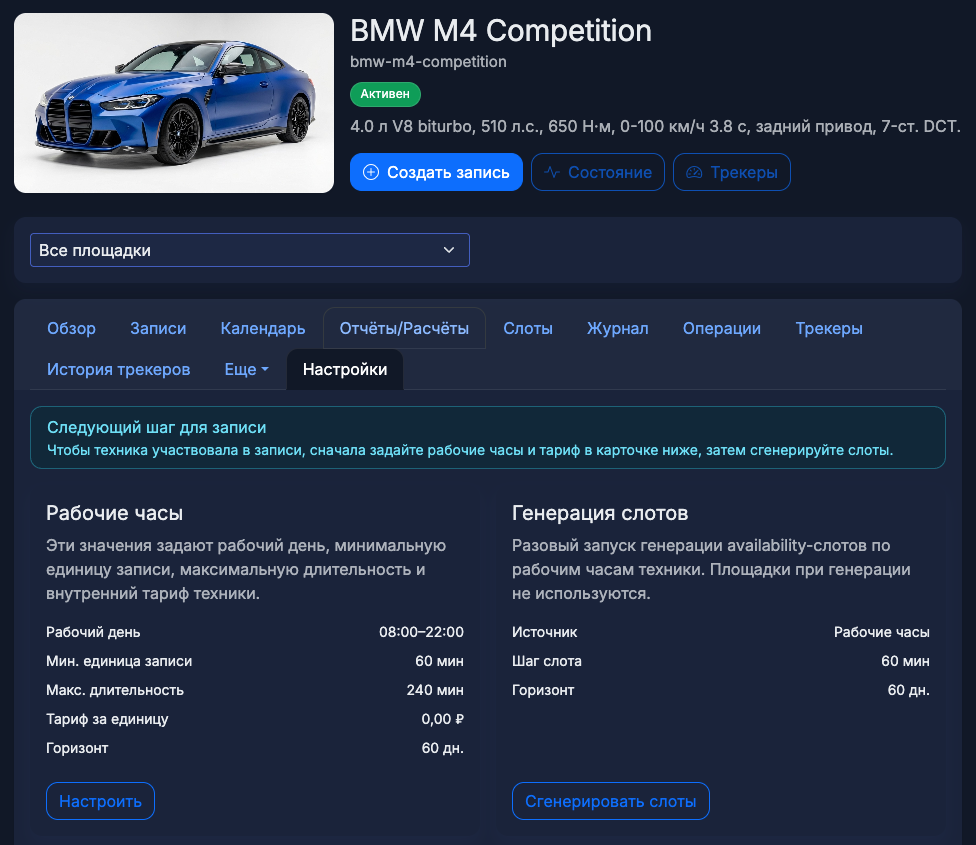
BRD пока реализован не полностью, есть ещё части для доработки. Предстоит сделать так, чтобы клиент сам выбирал время и планировал полёт через Telegram-бот или на сайте, если ему удобнее с компьютера, а инструкторы сами выставляли, когда и где готовы провести занятие. Ещё нужно считать время инструктора для расчётов с аэродромом: услуги оплачивает аэродром.
Для масштаба: в CRM сейчас около четырёхсот планов, в Tooling — больше восьмисот. Пайплайн замедляет работу там, где нужно поменять документацию: такое может идти несколько часов, потому что все роли согласовываются. Поэтому часть изменений документации я делаю вне пайплайна. Один из самых ценных плюсов: Tooling стал экспериментальной площадкой. На нём я попробовал механики, которые затем использовал в пайплайнах на основной работе.
Сколько это стоит
Я сам стартовал с подписок за 20 долларов на моделях GPT, Opus и GLM. Одиночке для старта их вполне должно хватить. Летом я понял, что всё дорожает, а китайские модели продвигаются вперёд, и захотел перевести разработку на локальные модели. Обновил MacBook и взял чуть больше памяти, чтобы попробовать Gemma, Qwen и GLM. Мелкие модели пока не такие умные, чтобы им что-то доверять, а большие в квантованном виде занимают всю память. Зато оказалось, что на нём удобно запускать много Codex параллельно.
Сейчас у меня годовая подписка GLM на максимальном тарифе, и её лимиты заканчиваются первыми. Ещё есть две личные подписки Codex Pro и подписка Claude Ultra. Это нужно потому, что параллельно веду много проектов и перепроверяю результаты разными моделями. Подписки я оплачиваю сам и частично использую их в основной работе: сейчас она как раз про создание пайплайнов. Это мой сетап, так мне спокойнее, так строю свою работу.
Когда нужен пайплайн
Большую часть простых или нестандартных задач можно и нужно решать, подкинув промптик в Claude или Codex. А пайплайн выходит на сцену, когда нужна штатная, стабильная, прогнозируемая и контролируемая разработка. Поэтому одним промптом в чате я делаю вспомогательную аналитику или разбираюсь с нештатными и новыми ситуациями. Проверить, как прошла новая механика. Исследовать, нужен ли мне QMD, хранить ли JSON внутри MD-файла или просто MD. Сравнить системы ведения задач.
Если сравнивать скиллы с пайплайном, то, как мне видится, скиллы больше подходят для описания работы с чётко определённой функциональностью, программой или утилитой. Возможно, я не прав. Я использую их для технических задач, которые не нужно каждый раз объяснять: у них есть шаблон, понятные механики и набор хелперов. Например, скилл создаёт черновик плана и ставит задачу в очередь. Ни один скилл у меня не перерос в пайплайн: я к этому подходил осознанно с момента появления скиллов. Скилл может проверять скилл, но это уже конструкция, которая должна передавать между шагами контекст или, наоборот, не передавать.
Ускорение и иллюзия здесь идут рядом. На обычном промпте кажется, что быстрее, но быстрее только до определённого уровня. С пайплайном то же самое: когда он выстроен, кажется, что всё быстро, но тоже до определённого уровня.
Нужно быстро поправить — хватит промпта.
Мелкие правки: поправить три строчки документации, настроить CI, поменять тест — зачем тут пайплайн? Это просто ресурсы убивать.
Работа повторяемая или небольшая, укладывается в рамки, у неё есть шаблон и набор хелперов — это скилл.
Работа большая: не хватает контекста модели, нужна восстанавливаемость, хочется её перепроверять — пора к пайплайну.
Пайплайн нужен там, где важны согласованность и учёт по процессу.
Для меня пайплайн — это возможность сделать то, что я сам бы не сделал в силу каких-то ограничений. Не хватает знаний и навыков, а бывает, что и времени: самому некогда этим заниматься. Пайплайн даёт свободу. Загрузил его, занялся работой. Вернулся — раз, и всё готово.