

Чтобы записать песню собственным голосом, необязательно уметь профессионально петь или покупать студийное оборудование. Современные нейросети позволяют использовать голосовую запись как основу для цифрового вокала, придумывать мелодии по описанию и собирать музыкальные композиции практически с нуля.
Самое интересное – возможность сохранить индивидуальное звучание. Вместо неизвестного виртуального исполнителя в песне может появиться голос, похожий на ваш: со знакомым тембром, особенностями произношения и характерной манерой подачи. Для этого применяется технология клонирования голоса, которая работает совместно с инструментами музыкальной генерации. Например, генератор музыки ИИ позволяет создавать композиции по текстовому запросу, выбирать жанры и экспериментировать со своим вокалом из загруженного голосового образца.
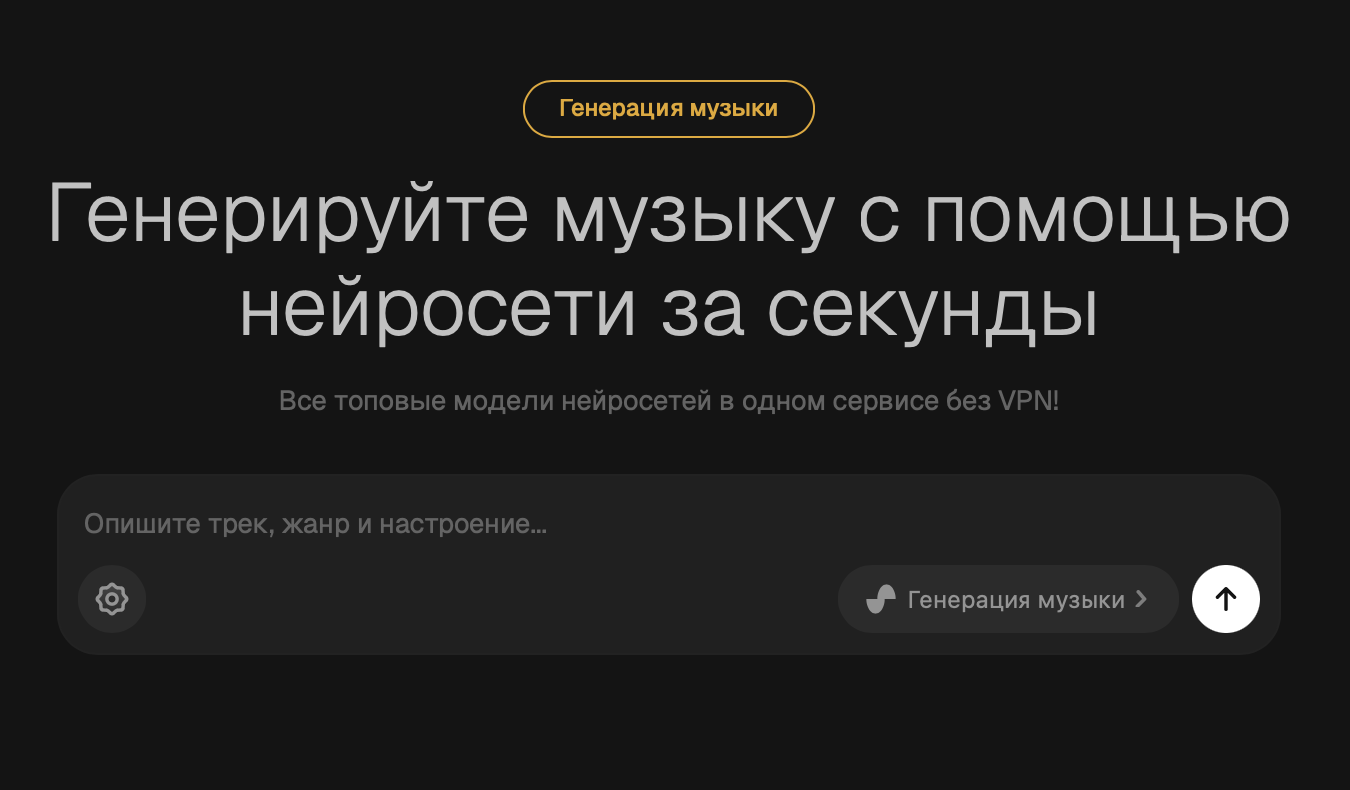
Разберемся, как создать песню своим голосом через нейросеть, какие инструменты для этого подходят и как правильно подготовить запись, чтобы итоговая композиция звучала естественно.
Клонирование голоса в нейросети: как ИИ учится петь вашим тембром
Клонирование голоса – технология, которая позволяет искусственному интеллекту воспроизводить особенности звучания определенного человека. Вместо обычного выбора между готовыми мужскими и женскими голосами пользователь загружает собственную запись, а нейросеть формирует персональную голосовую модель.
При обработке аудио алгоритмы анализируют характерные признаки речи или пения. Среди них – тембр, высота звучания, артикуляция, интонационные особенности и другие акустические характеристики. Полученный голосовой профиль можно использовать в поддерживаемой нейросети для генерации музыки. Например, система получает текст и произносит его голосом, похожим на голос человека из исходной записи.
Чем персональный ИИ-вокал отличается от обычного генератора песен
Стандартный музыкальный генератор создает композицию с виртуальным исполнителем. Пользователь определяет жанр, настроение и слова, после чего получает готовую мелодию с подходящим синтетическим голосом.
При персональной генерации появляется дополнительный источник – запись конкретного человека. Нейросеть использует ее для формирования вокального исполнения с индивидуальными характеристиками.
На практике существуют три способа работы:
Генерация с персональным голосовым профилем. Пользователь добавляет свой голос непосредственно в музыкальный сервис, после чего выбирает его для новой песни.
Преобразование готового вокала. Сначала создается песня с обычным ИИ-певцом, затем вокальная партия обрабатывается совместимой моделью преобразования голоса.
Использование аудиореференса. Нейросеть анализирует предоставленную запись и ориентируется на ее звучание при генерации нового музыкального материала.
Первый способ наиболее удобен для начинающих. Второй дает больше возможностей для обработки существующих композиций, а третий подходит для творческих экспериментов, хотя не всегда обеспечивает точное сходство голоса. С помощью нейросети для создания музыки можно подготовить музыкальную основу практически для любого из этих вариантов. Главное – заранее понять, умеет ли выбранный сервис использовать ваш голос при создании вокала.
Какие песни можно записать с помощью собственного ИИ-голоса
Персональный вокал открывает больше возможностей, чем простая генерация случайных музыкальных треков. Пользователь может самостоятельно придумать историю, выбрать манеру исполнения и превратить обычные слова в музыкальное произведение.
Например, можно создать песню-посвящение, записать шуточный рэп о друзьях, подготовить музыкальное поздравление или исполнить собственный текст в непривычном жанре. Интересный вариант – попробовать несколько музыкальных образов. Один и тот же голос может звучать в спокойной акустической композиции, электронной поп-музыке или мелодичном хип-хопе.
Можно ли использовать только запись обычной речи
Это зависит от технологии. Некоторые системы создают голосовую модель по разговорному аудио, но такие инструменты преимущественно предназначены для синтеза речи. Музыкальные модели с персональным вокалом нередко лучше работают с образцами пения. В них уже присутствуют музыкальные переходы, протяжные гласные и изменения высоты звука, которые полезны для формирования певческого голоса.
Поэтому для задачи создать песню ИИ со своим голосом бесплатно разумно подготовить несколько небольших записей. Одну – с естественной речью, вторую – с простым вокальным исполнением без инструментов. Дальше необходимо выбрать совместимый инструмент и определить, какой формат исходного аудио он принимает.
Как выбрать нейросеть для персональной генерации вокала
Не стоит оценивать музыкальные сервисы исключительно по качеству демонстрационных песен. Для персонального проекта гораздо важнее наличие подходящего способа работы с собственным голосом.
Обратите внимание на четыре возможности: загрузку аудио, создание голосового профиля, использование собственного текста и управление музыкальной аранжировкой. Также полезно проверить, можно ли редактировать готовые композиции и сохранять результаты для дальнейшей обработки.
Если нужно создать музыку онлайн бесплатно, заранее изучите условия доступа. Некоторые платформы предлагают бесплатные генерации, но персональные голосовые функции могут быть доступны только в отдельных режимах или тарифах.
ТОП-5 ИИ-сервисов для создания песни своим голосом
Suno AI нейросеть – музыкальный генератор с функцией Voices, позволяющей использовать собственный голосовой профиль при создании новых песен.
Минимакс нейросеть – платформа с инструментами MiniMax Music для генерации композиций и отдельными моделями клонирования голоса.
Ace Step – музыкальная ИИ-модель для работы с текстом, аудиореференсами, вокальными партиями и настройкой музыкального звучания.
WaveSpeedAI – платформа для запуска аудиомоделей, включая клонирование голоса и подготовку голосовых идентификаторов.
Google Lyria 3.5 – модель генерации музыки с реалистичным ИИ вокалом, подробным управлением стилем и возможностью создания музыкальных композиций по описанию.
Каждый инструмент решает свою часть задачи. Suno удобен для непосредственной генерации песни персональным голосом, MiniMax и WaveSpeedAI интересны инструментами клонирования, Ace Step предлагает больше контроля над звуком, а Google Lyria 3.5 подходит для разработки музыкальной основы.
1. Suno AI – создание полноценной песни с персональным голосовым профилем
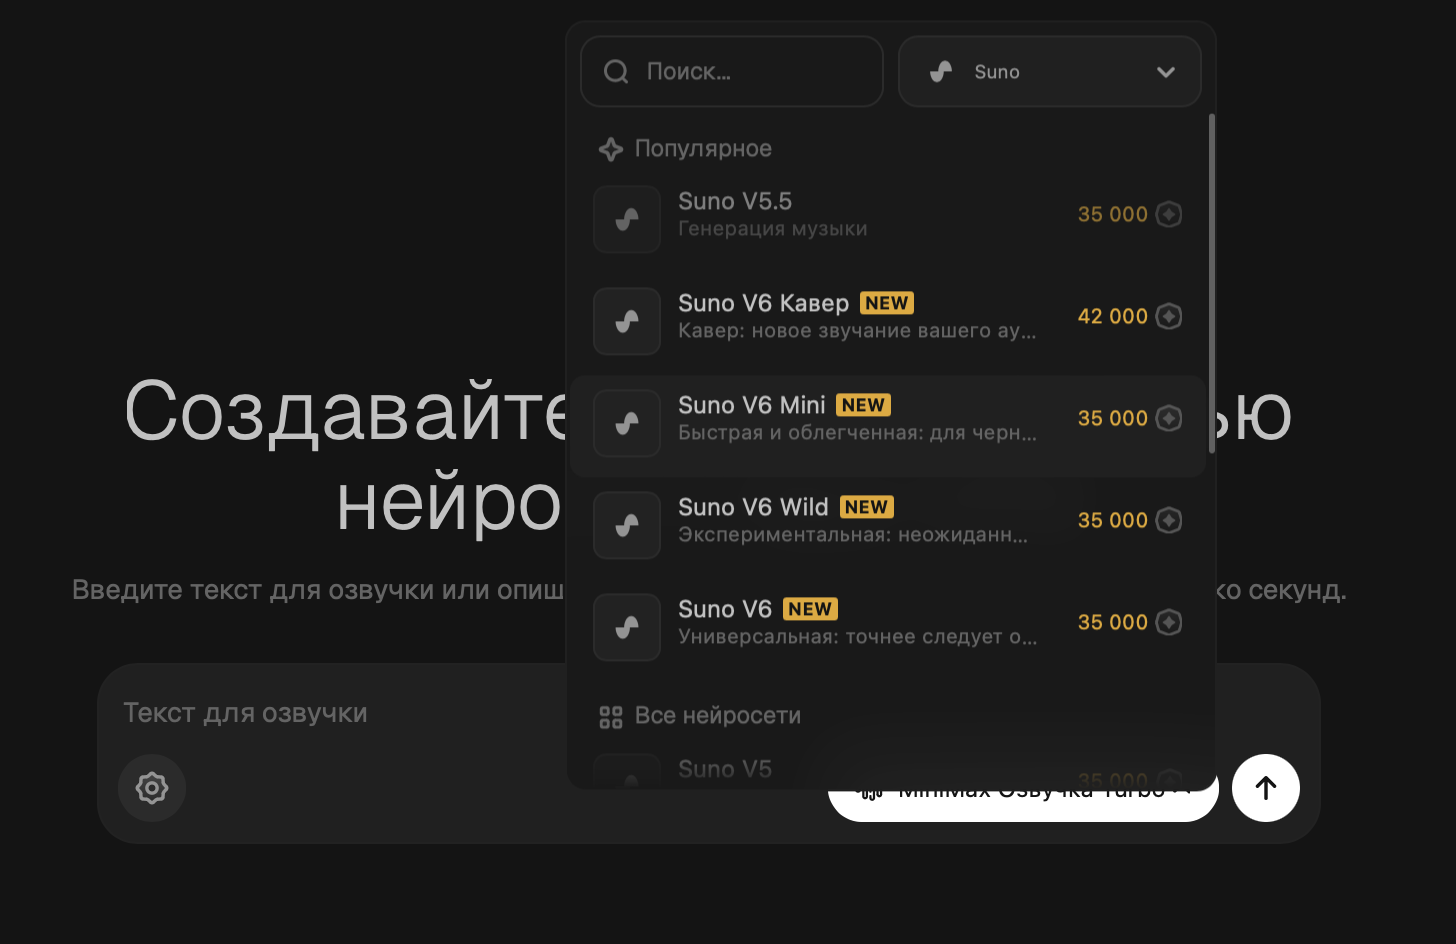
Suno AI нейросеть позволяет генерировать песни с готовой мелодией, инструментальным сопровождением и вокалом. Главная особенность для рассматриваемой задачи – функция Voices, с помощью которой пользователь может добавить собственный голос и использовать его при создании музыки.
Такой подход удобен, поскольку не нужно отдельно подбирать музыкальный генератор и искать совместимую систему преобразования голоса. Пользователь работает в одном интерфейсе: добавляет голосовой образец, составляет текст, описывает музыкальное направление и получает готовую композицию.
Почему Suno подходит для персонального вокала
Функция Voices предназначена именно для переноса характеристик собственного голоса в новые музыкальные произведения. Она отличается от обычных настроек вокального стиля, где пользователь выбирает лишь приблизительное звучание исполнителя.
При добавлении голоса Suno предлагает загрузить существующий аудиофайл, записать новый образец или использовать подходящую композицию из собственной библиотеки.
Для наиболее точного результата желательно использовать чистую запись пения. Если файл содержит музыкальное сопровождение, сервис может попытаться отделить вокальную дорожку автоматически.
Как настроить песню в Suno
После создания голосового профиля откройте форму генерации и выберите сохраненный голос. Затем добавьте слова песни, укажите название и музыкальный стиль.
Пример запроса:
«Мелодичный городской поп о ночной поездке по пустым улицам. Ровный ритм 108 BPM, мягкая электрогитара, глубокий бас и легкие электронные ударные. Выбранный персональный голос, уверенная подача в куплетах, более свободное исполнение в припеве. Никаких дополнительных вокалистов. Финал с коротким гитарным проигрышем».
Такое описание не требует сложных музыкальных терминов, но задает достаточно конкретную структуру.
Для каких проектов лучше использовать Suno
Сервис хорошо подходит для личных композиций, поздравлений, музыкальных роликов и экспериментов с разными жанрами. Особенно удобно, что один голосовой профиль можно применять к новым песням без повторной записи каждого музыкального текста.
2. MiniMax AI – два направления работы с музыкой и голосом
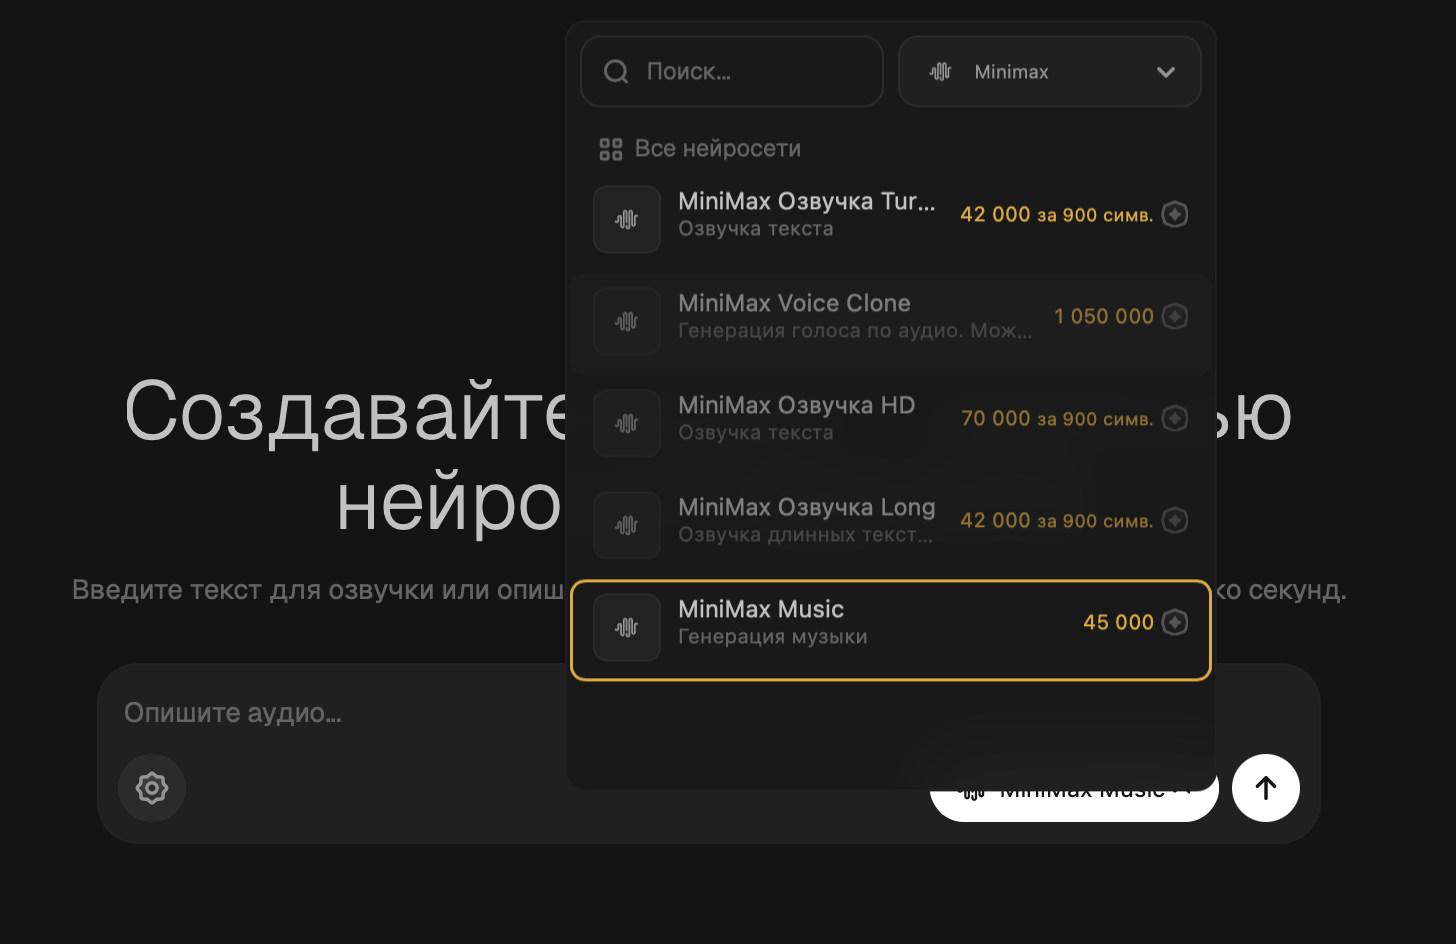
Минимакс нейросеть предлагает отдельные инструменты для генерации музыки и синтеза голоса. Это позволяет пользователю работать над несколькими составляющими композиции: музыкальной структурой, текстом и персональным тембром.
Для создания песен используется MiniMax Music, а за клонирование речи отвечают голосовые модели MiniMax Speech. Такое разделение дает больше возможностей для экспериментов, но требует понимать, как взаимодействуют разные инструменты.
Чем интересен MiniMax для музыкальных проектов
MiniMax Music способен генерировать композиции по текстовому описанию. Пользователь задает музыкальный стиль, добавляет слова и определяет характер будущей песни.
Для управления структурой можно использовать обозначения Intro, Verse, Chorus и другие элементы. После них удобно размещать комментарии о музыкальной подаче и инструментальном сопровождении. Например, для первого куплета можно выбрать минимальное количество инструментов, а в припеве добавить более выразительный ритм.
Отдельный инструмент Voice Cloning позволяет создать голосовую модель по короткому образцу. В некоторых реализациях достаточно примерно десяти секунд качественной речи.
Как использовать MiniMax на практике
Начните с создания персонального голосового образца через модель для клонирования. Затем перейдите к музыкальной части – подготовьте текст песни, придумайте тему и описание. Загрузите ваш голосовой Voice ID в модель с генерацией музыки и создайте несколько вариантов аранжировки.
Для музыкальной генерации подойдет следующий промпт:
«Ритмичная инди-рок-композиция о решении начать все заново. Темп 112 BPM, живая ударная установка, бас-гитара и две электрогитары. Первый куплет сдержанный, второй более уверенный. В припеве широкая мелодия без экстремально высоких нот. Завершение на короткой инструментальной фразе».
Кому подойдет MiniMax
MiniMax интересен пользователям, которым нужны не только готовые песни, но и отдельные аудиоинструменты, которые помогают последовательно собрать песню со своим голосом. ИИ подойдет для подготовки музыкальных заставок, авторских треков и голосовых проектов. При этом точное воспроизведение собственного певческого голоса потребует совместимого музыкального решения, а не только речевого клона.
3. Ace Step – музыкальные эксперименты с голосовыми образцами
Ace Step представляет собой семейство моделей для генерации музыкального аудио. Особенность проекта – возможность управлять не только текстовым описанием, но и дополнительными музыкальными параметрами. Модель поддерживает работу с готовыми композициями, создание новых музыкальных вариантов и использование аудиореференсов. Для пользователей, которым важны индивидуальные характеристики вокала, интересны возможности Voice Cloning, Reference Audio и дополнительной адаптации модели.
Почему Ace Step полезен для создания персонального звучания
В отличие от простого генератора, где пользователь вводит несколько слов и получает готовый трек, ACE-Step позволяет глубже работать с исходными материалами. В ACE-Step 1.5 предусмотрены инструменты генерации музыки, редактирования фрагментов, создания кавер-версий, разделения аудиодорожек и адаптации модели через LoRA.
С помощью Reference Audio можно направлять генерацию, используя характеристики существующей записи. При этом важно понимать, что аудиореференс и точное клонирование певческого голоса не всегда равнозначны. Одна запись может влиять на музыкальную манеру и тембр, но не гарантирует полного сохранения индивидуальности исполнителя.
Как работать с ACE-Step
Для начала откройте доступный интерфейс модели и выберите создание новой композиции. В поле описания укажите музыкальное направление, а в Lyrics добавьте собственные слова. Если используется режим с поддержкой аудиореференса, загрузите подходящую запись. Лучше выбирать пример, где хорошо слышны именно те характеристики, которые нужно перенести в будущую композицию.
В качестве запроса можно использовать следующий шаблон:
«Медленный соул с теплым электрическим пианино, басом и мягкими живыми барабанами. Темп 78 BPM. Пространство для выразительного сольного вокала, спокойные куплеты и более эмоциональный припев. Использовать акустические особенности предоставленного референса. Без хора и плотных синтезаторных слоев».
После генерации сравните результат с исходным образцом. Если сходство недостаточное, измените настройки влияния референса или подготовьте другой материал.
Какие настройки особенно полезны
Для работы с ACE-Step можно использовать описание музыкального стиля, текст песни, референсное аудио и желаемую длительность. В расширенных реализациях доступны дополнительные параметры генерации, которые влияют на разнообразие и предсказуемость результата.
4. WaveSpeed AI – подготовка цифровой версии собственного голоса
WaveSpeed AI – платформа с доступом к различным ИИ-моделям, включая инструменты синтеза и клонирования речи. Для персональных аудиопроектов интересна модель MiniMax Voice Clone, которая позволяет создавать голосовую копию по короткой записи. После обработки система формирует идентификатор голоса, который можно использовать при работе с совместимыми речевыми моделями.
Что получает пользователь после клонирования
Основной результат – персональный голосовой профиль для дальнейшего синтеза речи. Он сохраняет характерные особенности исходного звучания и позволяет генерировать новые речевые фрагменты. Например, пользователь может проверить, как цифровая копия произносит разные предложения, меняет интонацию и воспроизводит особенности русского языка.
Для музыкальных проектов это полезный подготовительный этап, но не готовое решение для создания полноценного певческого исполнения. Голосовые идентификаторы WaveSpeedAI предназначены для поддерживаемых моделей синтеза речи и не являются универсальными файлами, которые можно загрузить в любой генератор песен.
Как клонировать голос через WaveSpeedAI
Откройте модель Voice Clone и загрузите короткий аудиофайл. Для MiniMax Voice Clone на платформе рекомендуется использовать чистый речевой образец продолжительностью примерно 5–20 секунд. Затем задайте уникальный идентификатор голоса в поле Custom Voice ID. Он понадобится для последующего обращения к созданной модели.
Если запись содержит небольшие фоновые помехи, можно использовать Noise Reduction. Для выравнивания громкости предусмотрена Volume Normalization. После обработки проверьте результат с помощью тестового текста. Лучше проверять несколько фраз с разными согласными и гласными, чтобы заметить возможные искажения.
Как использовать результат для песни
Самостоятельно созданный речевой профиль не превращает WaveSpeedAI в полноценную нейросеть для создания песен. Чтобы получить музыкальный вокал, понадобится совместимый инструмент, умеющий использовать созданную голосовую модель при пении или преобразовании вокальной дорожки, например Mimimax Music.
Поэтому WaveSpeedAI подходит тем, кто хочет сначала получить качественную цифровую копию речи, а затем строить на ее основе дополнительные аудиопроекты. Также нужно учитывать, что отдельные операции клонирования и синтеза речи могут быть платными.
5. Google Lyria 3.5 – создание музыкального сопровождения и вокальных композиций
Google Lyria 3.5 – нейросеть для генерации музыки, разработанная Google DeepMind. Она предназначена для создания музыкальных композиций по текстовым инструкциям и отличается возможностью подробно описывать желаемое звучание. Lyria 3.5 особенно интересна пользователям, которые хотят прорабатывать музыкальные идеи, подбирать стиль и экспериментировать с общей атмосферой трека.
Какие возможности Lyria 3.5 полезны для песен
Модель позволяет управлять музыкальным жанром, инструментальным составом, эмоциональной подачей и характером вокального исполнения. Можно создавать короткие музыкальные фрагменты или более продолжительные композиции длительностью до трех минут в поддерживаемых режимах.
Отдельное внимание уделяется выразительности ИИ вокала и соблюдению музыкальной структуры. Это полезно при создании песен с несколькими куплетами, развитием аранжировки и полноценным припевом. Однако Lyria 3.5 не следует рассматривать как подтвержденный инструмент прямого клонирования собственного голоса. Ее основная задача – музыкальная генерация, а не создание персонального голосового профиля пользователя.
Как применить Lyria в персональном музыкальном проекте
Один из вариантов – сначала создать подходящую инструментальную композицию, а затем использовать ее для работы с собственным голосом через совместимые инструменты. Например, можно попросить Lyria подготовить легкую электронную аранжировку с четкой структурой и пространством для вокала.
Пример запроса:
«Инструментальная композиция в жанре современного синти-попа. Темп 116 BPM, плотная басовая линия, электронные ударные и воздушные клавишные. Начало с короткой мелодии, затем ритмичный куплет, более насыщенный припев и спокойный инструментальный переход. Оставить достаточно пространства для добавления сольного вокала. Без сгенерированного пения».
Такой подход позволяет отдельно контролировать музыкальную основу и вокальную часть. Если же требуется готовая композиция с виртуальным исполнителем, можно попросить Lyria создать песню с подходящим ИИ вокалом.
Кому подойдет Google Lyria 3.5
Модель полезна тем, кто хочет сначала разработать музыкальную концепцию и получить качественную основу для будущего трека. Также она подходит для создания музыкальных заставок, оригинальных мелодий, фоновых композиций и песен с синтетическими исполнителями. Для точного воспроизведения персонального голоса потребуется дополнительный совместимый инструмент.
Генерация цифрового контента через ИИ: возможности нейросетей Ranvik для фото, текстов, видео и музыки
Нейросеть для создания реалистичных фото и иллюстраций помогает воплощать визуальные идеи без ручной отрисовки каждого элемента. Пользователь описывает нужный сюжет, расположение объектов и оформление картинки, после чего искусственный интеллект создает изображение или вносит изменения в исходную фотографию.
ИИ-помощник для работы с текстовым контентом ускоряет подготовку публикаций различной сложности. С его помощью удобно разрабатывать структуру статей, придумывать заголовки, писать рекламные тексты, составлять деловую переписку и улучшать уже подготовленные материалы.
Генератор видео на основе текста и фотографий позволяет создавать визуальные сцены по заранее составленным инструкциям. Нейросеть учитывает описание персонажей, их взаимодействие с окружением, направление движения и особенности съемки, чтобы сформировать последовательность кадров.
Ranvik – онлайн-платформа для генерации материалов с ИИ предлагает инструменты для решения различных творческих и рабочих задач. В сервисе можно комбинировать текстовые, графические, видео- и аудиоформаты, подготавливая материалы для рекламы, социальных сетей и других цифровых площадок.
Нейросеть для написания музыки по текстовому описанию помогает создавать композиции с определенным характером звучания. Для получения подходящего результата достаточно сформулировать пожелания к стилю, скорости воспроизведения, инструментальной основе и эмоциональному настрою трека.
Создание анимации из обычной фотографии через ИИ позволяет придать неподвижному изображению ощущение движения. Искусственный интеллект может оживлять портреты, анимировать природные явления и добавлять динамику отдельным объектам, сохраняя общую композицию исходного кадра.
Генерация голосовой озвучки из текста нейросетью подходит для подготовки аудиоверсий статей, обучающих материалов и видеосценариев. Система преобразует письменную информацию в речь, используя выбранный голос и предусмотренные настройки звучания.
Готовые текстовые запросы для генерации фото через ИИ дают возможность изучить разные подходы к созданию визуального контента. В примерах подробно раскрываются особенности художественных стилей, расположения объектов, освещения, цветовой палитры и детализации изображений.
Библиотека промптов для создания видеороликов нейросетью помогает формировать более точные инструкции для ИИ-генераторов. Пользователи могут использовать готовые идеи, адаптируя описание событий, визуальных эффектов, движения камеры и композиции видеосцены.
Как получить качественный образец голоса для нейросети
Даже хорошая технология клонирования не сможет полностью компенсировать неудачную исходную запись. Если голос заглушен музыкой, искажен эффектами или записан с сильным эхом, нейросети будет сложнее выделить его индивидуальные особенности. Поэтому перед загрузкой стоит проверить качество материала.
Выберите подходящее помещение
Лучше записываться в небольшой комнате с мягкой мебелью, шторами и другими поверхностями, которые уменьшают отражение звука. Пустые помещения с голыми стенами часто дают заметное эхо. Оно попадает в голосовой образец и может повлиять на звучание синтезированного голоса. Поставьте телефон на устойчивую поверхность или держите его неподвижно. Во время записи не закрывайте микрофон рукой и не меняйте расстояние до него.
Запишите голос в естественном диапазоне
Для речевой модели важен привычный тембр. Не пытайтесь специально сделать голос более низким, высоким или хриплым. Если планируется создание певческого профиля, используйте простую мелодию, которую можете исполнить без напряжения.
Хороший прием – записать несколько небольших музыкальных фраз с разной эмоциональной окраской. Например, спокойную часть, чуть более энергичную и короткую фразу с протяжной гласной. При этом не стоит объединять все варианты в один файл, если выбранный инструмент требует однородную запись.
Уберите лишнюю обработку
Для обучения голосовой модели лучше подходит запись без реверберации, автотюна и агрессивного шумоподавления. Автоматические улучшения аудио иногда делают звучание приятнее, но одновременно изменяют индивидуальные особенности голоса. Если исходник сильно зашумлен, сначала попробуйте перезаписать материал. Это часто эффективнее последующей обработки.
Как загрузить свой голос и правильно сохранить профиль
После подготовки аудио важно не просто отправить файл в нейросеть для генерации музыки, но и проверить, что система использует нужный образец. В зависимости от сервиса пользователь может загрузить файл через интерфейс, записать голос непосредственно в браузере или передать ссылку на аудио.
Какие параметры проверить перед загрузкой
Убедитесь, что файл соответствует поддерживаемому формату. Часто используются WAV, MP3 и M4A, однако точные требования отличаются между моделями.
Затем проверьте длительность записи. Не нужно искусственно растягивать короткий образец тишиной, чтобы выполнить формальное ограничение. Если платформа предлагает выбрать лучший фрагмент аудио, отдавайте предпочтение участку без пауз, случайных звуков и резких изменений громкости.
Почему нужно протестировать голос до генерации песни
Пробный синтез позволяет заранее выявить проблемы с клонированием. Например, тембр может получиться слишком приглушенным, произношение – нечетким, а интонация – недостаточно естественной. Если тестовый голос уже заметно отличается от оригинала, нет смысла сразу создавать длинную композицию.
Попробуйте другой исходный материал или настройку модели. После получения убедительного образца переходите к музыкальной генерации. Это особенно важно, когда генерация музыки нейросетью выполняется отдельно от клонирования. Чем качественнее подготовлен голос, тем меньше сложностей возникает при дальнейшей работе.
Как описать будущую песню, чтобы ИИ правильно понял задачу
Музыкальный запрос лучше строить как краткое техническое задание. Вместо абстрактного пожелания «сделай очень красивую песню» нужно указать, какие элементы должны появиться в композиции. В первую очередь определите основной жанр. Затем добавьте музыкальный темп, инструменты и описание вокальной манеры. После этого можно обозначить структуру: сколько должно быть куплетов, нужен ли инструментальный проигрыш и каким должен получиться финал.
Какие сведения включить в промпт
Удобно использовать такую последовательность:
Жанр – поп, рок, инди, электронная музыка, рэп или другое направление.
Темп – спокойный, умеренный, быстрый либо конкретное значение BPM.
Инструменты – гитара, фортепиано, бас, ударные, синтезаторы.
Вокал – выбранный персональный голос, желаемая манера исполнения и комфортный диапазон.
Композиция – последовательность музыкальных частей и характер переходов.
Настроение – эмоциональная окраска, которую должна передавать песня.
Если сервис поддерживает персональные голоса, не забудьте выбрать профиль непосредственно в настройках. Одна текстовая просьба «используй мой голос» не активирует клонирование автоматически. Для дополнительных идей можно использовать промпты для музыки и аудио ИИ. Готовые музыкальные запросы удобно перерабатывать под собственную тему, текст и выбранный жанр.
Готовые промпты для генерации песни своим голосом
Следующие промты рассчитаны на разные музыкальные задачи. Их можно использовать в генераторах с поддержкой текстовых инструкций, а настройки персонального голоса выбирать отдельно.
Промпт для мелодичной рок-песни
«Создай современную рок-композицию о [тема песни]. Темп 118 BPM, плотная ритм-гитара, мелодичные гитарные вставки, живые ударные. Куплеты сдержанные, припев мощный, но без крика. Использовать выбранный голосовой профиль, сохранить узнаваемый тембр и четкое произношение русского текста. В конце короткое гитарное соло».
Промпт для спокойного R&B
«Музыкальная композиция в стиле современного R&B о [событие]. Темп 84 BPM, мягкие электронные ударные, глубокий бас, атмосферные клавишные. Основной вокал персональный, без дополнительных исполнителей. Плавное исполнение, небольшие паузы между фразами, спокойный куплет и выразительный припев. Текст: [добавить слова]».
Промпт для юмористического трека
«Создай веселую песню о [смешная ситуация]. Жанр – танцевальный поп с элементами фанка. Подвижный ритм, бас-гитара, короткие духовые акценты и яркие ударные. Использовать выбранный персональный голос. Куплеты с разговорной подачей, припев простой и повторяющийся. Выделить ключевую фразу [фраза]».
Промпт для песни в стиле ретро
«Атмосферная песня с музыкальным характером 1980-х годов. Темп 102 BPM, аналоговые синтезаторы, электронные барабаны, мягкая басовая линия. Использовать мой голосовой профиль. Вокал спокойный, немного мечтательный, без сильной реверберации. Начало инструментальное, затем два куплета и запоминающийся припев. Тема: [тема песни]».
Промпт для короткого музыкального ролика
«Создай короткий музыкальный трек продолжительностью около 40 секунд в жанре [жанр]. Вступление не длиннее трех секунд. Использовать выбранный персональный голос, четкая ритмичная подача, простой припев с фразой [основная фраза]. Аранжировка энергичная, без долгого инструментального финала. Слова: [текст]».
Все примеры можно менять под собственные задачи. Если модель поддерживает отдельные поля для слов и музыкального стиля, текст песни лучше размещать отдельно от описания звучания.
Как сохранить естественное звучание голоса в готовой композиции
Одна из главных сложностей персонального ИИ-вокала – потеря узнаваемости при сложном музыкальном исполнении. Например, модель может правильно передать тембр в спокойном куплете, но сильно изменить его в эмоциональном припеве. Причина заключается в том, что голосовые характеристики меняются вместе с высотой нот, громкостью и характером вокальной подачи.
Не требуйте сложного вокала сразу
Для первого теста лучше избегать экстремально высоких нот, продолжительных вокальных украшений и резких переходов между регистрами. Выбирайте диапазон, близкий к естественному звучанию исходного образца. Если нейросеть для создания песен позволяет описать вокальную манеру, можно добавить пожелание сохранить естественную артикуляцию и умеренную эмоциональность.
Контролируйте количество голосовых слоев
Некоторые генераторы автоматически добавляют гармонии, дублированный вокал и фоновые голоса. Такая обработка может сделать музыку насыщеннее, но одновременно уменьшить узнаваемость персонального тембра. Для первых вариантов лучше использовать один основной голос без хора и дополнительных вокалистов. После этого можно создавать более сложную аранжировку.
Проверяйте высокие и тихие фрагменты
Особое внимание уделяйте концам музыкальных строк, протяжным гласным и переходам между нотами. Иногда именно там появляются цифровые искажения, неестественное дыхание или резкие изменения тембра. При наличии редактора отдельных фрагментов попробуйте изменить проблемную часть, не затрагивая остальную композицию.
Можно ли бесплатно создать песню с собственным голосом
Бесплатная музыкальная генерация и бесплатное клонирование голоса – не всегда одна и та же функция. Некоторые сервисы позволяют создавать композиции без оплаты, но ограничивают персональные голосовые профили. Другие предоставляют пробные возможности или требуют оплату за отдельные операции обработки аудио.
Если цель – создать песню своим голосом бесплатно, стоит сначала проверить именно функцию персонального вокала, а не только наличие бесплатной кнопки музыкальной генерации.
Как расходовать бесплатные генерации разумно
Начните с короткого тестового трека. Не создавайте сразу длинную композицию с несколькими куплетами и сложными инструментальными переходами. Сначала проверьте, правильно ли работает персональный голос. Затем выберите подходящий музыкальный стиль и только после этого переходите к полноценной песне. Такой порядок особенно полезен, если количество генераций ограничено.
После удачного теста можно создать музыку через нейросеть в другом жанре и постепенно собрать несколько вариантов одной музыкальной идеи.
Частые ошибки при создании песен своим голосом
При работе с персональным ИИ-вокалом проблемы часто связаны не с самой технологией, а с неподходящими исходными настройками.
Ошибка | Что происходит | Как исправить |
Загружена запись с музыкой | Нейросеть хуже выделяет особенности голоса | Использовать чистый вокал или речь |
Выбран слишком высокий диапазон | Персональный тембр теряет узнаваемость | Упростить мелодию и снизить вокальную нагрузку |
В промпте слишком много жанров | Композиция становится непредсказуемой | Оставить одно основное направление |
Используется только речевой клон | Получается озвучка вместо пения | Выбрать модель с поддержкой музыкального вокала |
Текст содержит длинные строки | Нарушается ритм и ухудшается произношение | Сократить фразы и упростить структуру |
Слишком много фоновых голосов | Основной тембр трудно различить | Убрать хоровые слои и дополнительные партии |
Полезно исправлять по одной проблеме за раз. Например, если голос кажется неестественным, сначала измените вокальную манеру, а не всю музыкальную концепцию. Так проще понять, какие настройки действительно влияют на качество.
Часто задаваемые вопросы
Можно ли создать песню своим голосом, если есть только запись разговора?
Да, но результат зависит от модели. Некоторые инструменты создают голосовые профили на основе речи, однако не все способны использовать их для пения. Если сервис ориентирован на персональный музыкальный вокал, лучше подготовить отдельный образец с простым исполнением мелодии.
Можно ли сделать несколько песен с одним голосовым профилем?
Да, если сервис поддерживает сохранение и повторное использование персонального голоса. Например, в Suno можно выбирать ранее созданный профиль для новых композиций. Это удобно при работе над несколькими песнями в разных жанрах без постоянной загрузки нового образца.
Как заставить нейросеть правильно произносить русские слова?
Используйте простые строки с понятным ритмом, избегайте сложных сокращений и проверяйте ударения в именах. Если определенное слово постоянно произносится неправильно, попробуйте перестроить фразу или заменить его синонимом. Также желательно выбирать модель, поддерживающую русский язык.
Можно ли использовать песню со своим ИИ-голосом для коммерции?
Возможность коммерческого использования зависит от условий выбранной платформы, тарифа и прав на исходные материалы. Собственный голос не отменяет ограничений на чужие тексты, мелодии и фонограммы. Перед публикацией на стриминговых площадках необходимо проверить лицензию на созданную композицию и правила сервиса.
Заключение
Нейросеть для создания песен своим голосом позволяет превратить обычную аудиозапись в основу персонального музыкального проекта. Для этого нужно подобрать подходящую технологию клонирования, подготовить качественный голосовой образец, выбрать музыкальный жанр и правильно настроить генерацию. Suno подходит для непосредственной работы с персональным вокалом, MiniMax и WaveSpeedAI предлагают инструменты клонирования речи, Ace Step дает больше возможностей для музыкальных экспериментов, а Google Lyria 3.5 помогает создавать музыкальные композиции и инструментальные основы.
Лучший способ получить убедительный результат – сначала проверить голос на коротком музыкальном фрагменте, а затем постепенно усложнять песню. Такой подход позволяет сохранить узнаваемость тембра, избежать лишних генераций и создать трек, в котором персональный голос действительно становится главным элементом композиции.