

Gemini — нейросеть, которая в одном запросе может рассуждать обо всём сразу. Загрузите ей запись совещания и спросите, на какой минуте обсуждали бюджет, или отправьте фото чека вместе с таблицей расходов и попросите найти расхождение. Приложение Gemini превысило миллиард пользователей в месяц, но в России оно официально недоступно, а подписка Google AI Pro не оплачивается российскими картами.
Работать с моделями Gemini из России можно в SpeShu.AI: Gemini 3.1 Pro и Gemini 3.5 Flash доступны в одном окне с ChatGPT, Claude и ещё 300+ моделями, оплата в рублях по факту использования. Ниже — как Gemini «видит» изображения и видео, какие модели есть в ноябре 2026 года, что он умеет с каждым типом данных и где его возможности заканчиваются.
Нейросеть, которая работает с Gemini из России: как получить доступ
Напрямую Gemini из России недоступен: приложение и подписку оформить нельзя, а API-доступ через Google AI Studio не включает Россию в список регионов. «Режим ИИ» в поиске Google на базе Gemini у российских пользователей появился ещё в год назад, но это поисковый режим, а не полноценный чат с файлами и историей.
В SpeShu.AI модели Gemini работают через официальный API:
Gemini 3.1 Pro — для сложного анализа, длинных документов и рассуждений.
Gemini 3.5 Flash — для быстрых и недорогих запросов.
Оплата по токенам через СБП, без подписки и зарубежной карты.
Те же модели доступны через API с единым ключом и совместимостью с форматом OpenAI, компании получают закрывающие документы в рублях.
В том же окне — ChatGPT, Claude, DeepSeek, генераторы изображений и видео: один запрос можно отправить нескольким моделям и сравнить ответы.
Что значит «мультимодальная» нейросеть
Ранние чат-боты работали только с текстом. Чтобы «понять» картинку, к ним прикручивали отдельную модель распознавания, которая превращала изображение в описание, и языковая модель работала уже с этим описанием. Детали терялись на стыке.
Gemini с первой версии обучали как мультимодальную модель: текст, изображения, аудио и видео превращаются в токены одного пространства и обрабатываются вместе. Поэтому модель может сопоставить то, что сказано в аудио, с тем, что видно в кадре, и с тем, что написано в приложенном документе.
Как Gemini «смотрит» видео
По документации Gemini API, видео обрабатывается так:
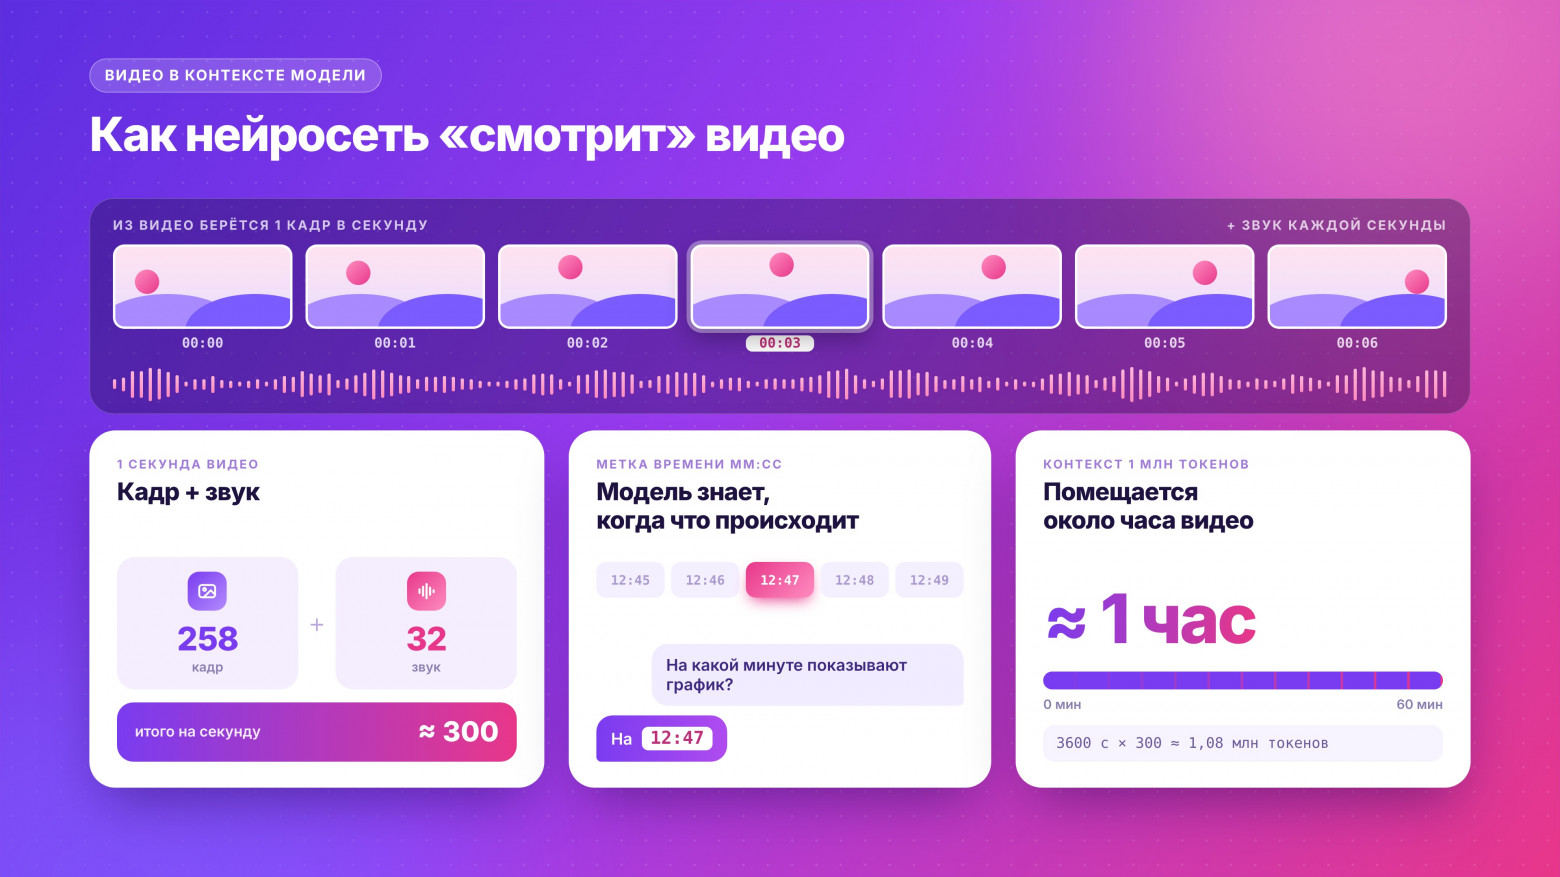
Из этого следует ограничение: событие короче секунды модель может пропустить. Для анализа совещания, лекции или интервью это не проблема, для разбора быстрой спортивной сцены — уже да.
Что Gemini умеет с каждым типом данных
Промпты ниже на английском: модели понимают его точнее, а строка «Answer in Russian» гарантирует ответ на русском.
Текст и документы
Длинный контекст позволяет загрузить договор на сотню страниц, несколько отчётов сразу или выгрузку переписки и задавать вопросы по всему массиву.
Answer only based on the attached documents. Compare the payment terms, deadlines and penalties in these two contracts. Show the differences in a table and mark the clauses that are riskier for the buyer. If something is not specified, say so. Answer in Russian.
Фотографии и сканы
Gemini распознаёт текст на фото, читает рукописные заметки, разбирает графики и схемы, описывает, что изображено.
Here is a photo of a whiteboard after a planning meeting. Transcribe all text, reconstruct the diagram as a structured list, and highlight the action items with owners if they are visible. Answer in Russian.
Таблицы и графики
Модель может прочитать таблицу со скриншота или фото и сопоставить её с другими данными.
Here are a photo of a receipt and a spreadsheet of expenses for the same week. Find the receipt items that are missing from the spreadsheet or have different amounts. Answer in Russian.
Если таблицу нужно собрать с нуля, пригодится разбор, как создать таблицу с помощью нейросети.
Аудио
Расшифровка, краткое содержание, поиск момента в записи, разделение по говорящим.
Transcribe this meeting recording, label the speakers as Speaker 1, Speaker 2 and so on, then write a summary with decisions and tasks. Add timestamps for each decision. Answer in Russian.
Видео
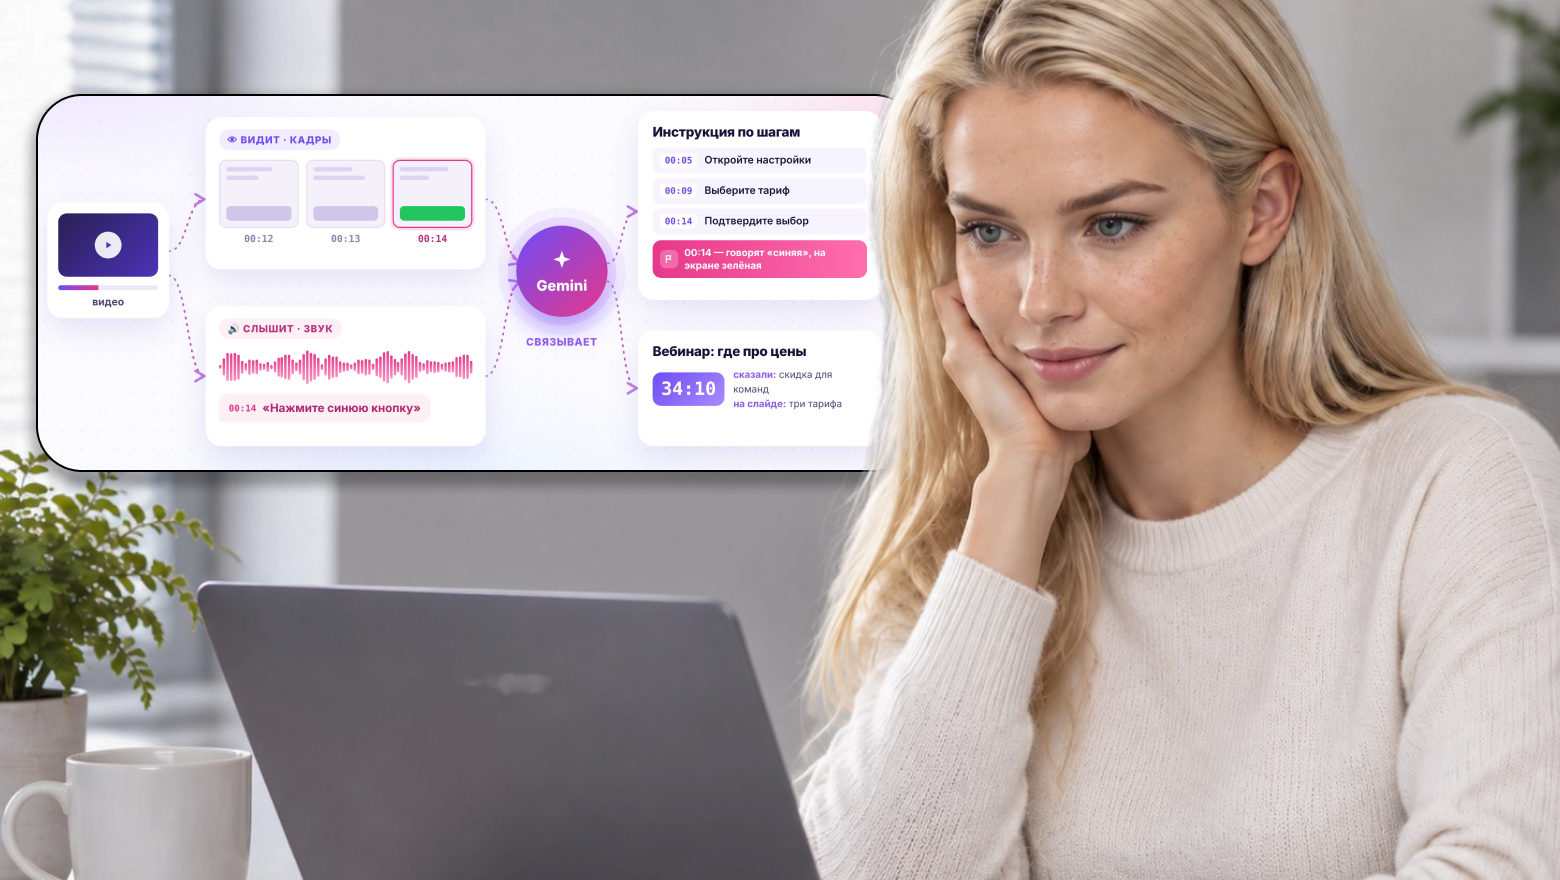
Самая сильная сторона Gemini: модель одновременно видит кадры и слышит звук, поэтому может связать сказанное с показанным.
Watch this product demo video. Create a step-by-step guide based on what is shown on screen, with timestamps for each step. Point out moments where the speaker says something that does not match what is shown. Answer in Russian.
Here is a recording of a webinar. Find the moment where pricing is discussed, give the timestamp and summarize what was said and what was shown on the slides. Answer in Russian.
Несколько типов сразу
Главное отличие мультимодальной модели — она работает с разными типами данных в одном запросе.
Here are a video of a warehouse walkthrough, a photo of the inventory list and a spreadsheet with stock records. Find items that appear in the video but are missing or have a different quantity in the spreadsheet. Answer in Russian.
Gemini, ChatGPT и Claude: в чём разница
Все три семейства моделей мультимодальны, но сильные стороны у них разные.
Gemini выделяется работой с видео и аудио и длинным контекстом: можно загрузить час записи или сотни страниц документов в один запрос.
ChatGPT удобен для анализа данных с выполнением кода: загружает таблицу, пишет и запускает расчёты, строит графики.
Claude сильнее в письме и аккуратной работе с длинными текстами, хорошо держит стиль и структуру ответа.
На практике модели удобно комбинировать: Gemini разбирает запись совещания и вытаскивает факты, Claude превращает их в аккуратный протокол или письмо.
Ограничения, о которых стоит знать
Быстрые события. При выборке в один кадр в секунду модель может пропустить короткое действие или мелькнувший на экране текст.
Ошибки в фактах. Как любая языковая модель, Gemini может уверенно ошибаться, особенно в цифрах и датах. Тест компании Oumi для New York Times показал точность «Обзоров от ИИ» в поиске около 91%, при этом больше половины верных ответов ссылались на источники, которые их не подтверждали.
Длинный контекст не гарантирует внимания. Загрузить можно много, но на очень длинных входах модель может упустить деталь из середины. Для важных выводов просите указывать, где именно в документе или видео найдено подтверждение.
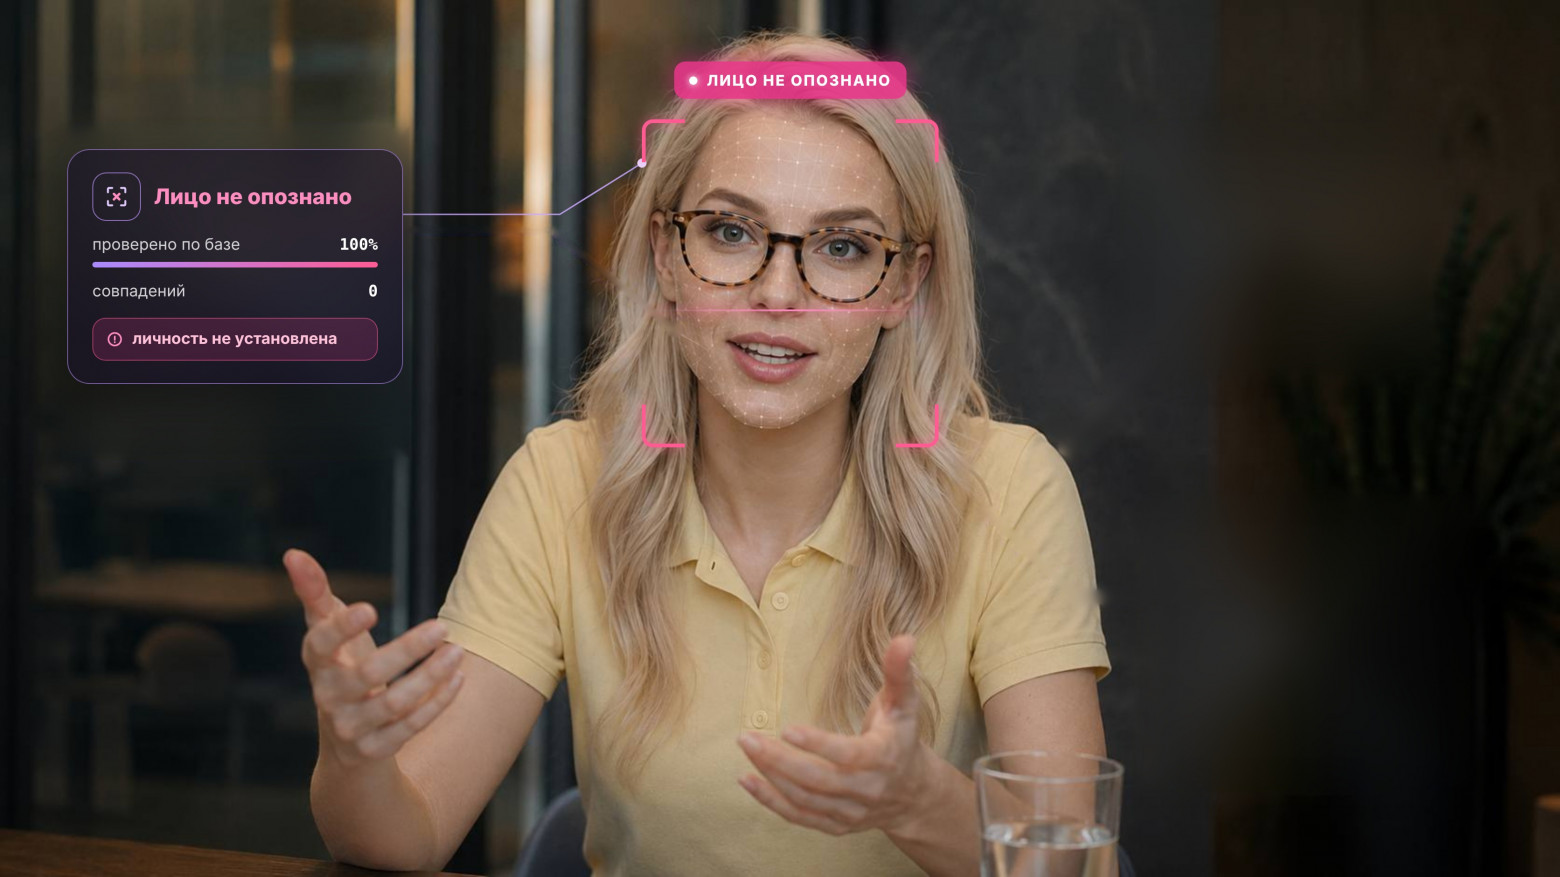
Распознавание людей. Gemini описывает людей на фото и видео, но не определяет, кто конкретно изображён. Для задач, где нужна идентификация личности, модель не подходит.
Персональные данные. Записи совещаний, фото документов и видео с людьми содержат персональные данные. Для компании загрузка их в зарубежную модель — вопрос закона № 152-ФЗ, такие материалы стоит обезличивать или согласовывать с юристом.
Частые ошибки
Спрашивать «что на видео?»
Общий вопрос даёт общий ответ. Конкретная задача — найти момент, составить инструкцию, сравнить сказанное с показанным — даёт полезный результат.
Не просить метки времени
Без меток времени ответ по часовому видео нельзя проверить. Просите указывать минуту для каждого вывода.
Загружать видео с быстрыми событиями
Модель видит один кадр в секунду. Для разбора быстрых действий она не подходит.
Доверять цифрам без проверки
Числа, распознанные с фото или услышанные в аудио, стоит сверять с исходником, особенно для финансовых документов.
Использовать дорогую модель для простых задач
Для расшифровки или простого описания хватит Gemini 3.5 Flash. Gemini 3.1 Pro нужен для сложного анализа.
Загружать материалы с персональными данными как есть
Записи совещаний и фото документов стоит обезличивать перед загрузкой.
Частые вопросы
Какая нейросеть понимает видео?
Gemini умеет анализировать видео вместе со звуком: модель берёт один кадр в секунду, слышит аудиодорожку и привязывает ответы к меткам времени. В контекст на миллион токенов помещается около часа видео.
Работает ли Gemini в России?
Приложение Gemini и подписка Google AI Pro в России официально недоступны. «Режим ИИ» в поиске Google работает, но это поисковый режим. Модели Gemini можно использовать через агрегаторы, которые подключаются к ним по API и принимают оплату в рублях.
Чем Gemini 3.1 Pro отличается от Gemini 3.5 Flash?
3.1 Pro рассчитана на сложный анализ, рассуждения и длинные документы. 3.5 Flash быстрее и дешевле и подходит для простых и массовых задач: расшифровки, описания, классификации.
Может ли Gemini распознать человека на фото?
Модель описывает людей на изображении, но не определяет, кто конкретно изображён.
Сколько видео можно загрузить в Gemini?
По документации Gemini API, в контекст на миллион токенов помещается около часа видео: каждая секунда занимает около 300 токенов с учётом звука.
Заключение
Gemini — нейросеть, которая понимает текст, фото, аудио и видео в одном запросе: она видит кадры, слышит звук, читает документы и связывает всё это между собой. Самые сильные сценарии — разбор записей совещаний и вебинаров с метками времени, сопоставление фото и таблиц, анализ сотен страниц документов за раз. Ограничения тоже понятны: один кадр в секунду, ошибки в фактах и необходимость проверять цифры.
Работать с Gemini 3.1 Pro, Gemini 3.5 Flash, ChatGPT, Claude и ещё 300+ моделями из России с оплатой в рублях можно в SpeShu.AI. По промокоду HABRSPESHUAI действует бонус 15% к сумме пополнения.