
Что осталось за кадром в прошлый раз?
В статье «О вузовских ИИ‑детекторах: что они могут, а чего нет. Неочевидные результаты собственного тестирования» [https://habr.com/ru/articles/1101184/] я сделала вывод о том, что актуальные версии Думейта, Антиплагиата и GPTZero позволяют корректно определить автора текста, и предложила для этого более эффективный подход, основанный на оценке доли человеческого текста вместо доли ИИ. Однако на том этапе тестирования я использовала только исходные/первичные тексты, которые либо не подвергались никакой доработке (мои собственные тексты и их сгенерированные «близнецы»), либо тексты с неизвестным происхождением и детектированным смешанным авторством. Между тем в настоящее время остается все меньше и меньше студенческих работ, в написании которых ИИ не поучаствовал тем или иным способом - в качестве поисковика, генератора, переводчика или редактора. Работы ИИ-детекторам все прибавляется, а вместе с ней растет и количество претензий к оценкам детекторов, которые высказываются уже не только нерадивыми студентами, но и отличниками. Утверждается, в частности, что даже полностью человеческий текст детекторы могут оценивать как написанный с существенным участием ИИ. Особенно поразительна история студентки Кемеровского университета Ангелины, которая «вынуждена была 13 раз переписывать диплом», пока Антиплагиат не оценил его как авторский. К сожалению, все такие утверждения, как правило, голословны - очень бы хотелось проверить реальные случаи и понять, в чем именно может быть причина ложноположительных оценок ИИ.
Для удовлетворения этого любопытства я провела следующий этап тестирования сервисов Думейт и GPTZero (к сожалению, стоимость полноценного тестирования Антиплагиата превышает мои финансовые возможности).
Цель тестирования.
· понять, какие из способов ИИ-доработки текстов с разным происхождением способен обнаружить ИИ-детектор,
· оценить возможный количественный «выигрыш» или «проигрыш» в ИИ-доле/ИИ-вероятности при применении разных способов доработки,
· понять, есть ли способ обмануть ИИ-детектор с помощью ИИ-чата.
Объекты. На этот раз я специально подготовила выдержки из текстов примерно одинакового размера (11 - 12 тыс. символов с пробелами), который позволяет получить оценки детекторов с высокой надежностью.
Тестировались 5 текстов: 1) текст, написанный мной в 2021 г. для заявки на получение гранта Фонда содействия инновациям, направление – биотехнологии, локальные очистные сооружения (ЛОС); 2) текст, сгенерированный чатом Claude (Anthropic) по той же тематике на основе моего технического задания с сохранением терминологии, применяемых технологий и объема (LOS); а также три текста, написанных студенткой филологического факультета одного из региональных университетов Б-вой в разное время:
3) курсовая 2024 г., 4) курсовая 2025 г. и 5) ВКР 2026 г. Эти три работы, предоставленные мне научным руководителем студентки для настоящего тестирования, представляют особенный интерес, поскольку написаны одним и тем же человеком с сохранением особенностей его стилистики и ритмики.
Способы ИИ-доработки текстов. Чаще всего в открытой печати предлагаются две технологии, якобы помогающие снизить уровень ИИ-оценок, на них я и остановилась в рамках этого этапа:
1. ИИ-редактирование исходника с помощью специально разработанных промптов, благодаря которым из текста удаляются различные признаки ИИ-генерации при сохранении содержания. Разные варианты промптов можете посмотреть, например, здесь habr.com/ru/companies/kemp_ai/articles/1039690, habr.com/ru/publications/839468, habr.com/ru/companies/cloud_ru/articles/1031552. Основные правила написания подобных промптов очевидны: изменение ритма изложения (чередование предложений разной длины), изменение синтаксической структуры и пунктуации, замена стандартных терминов на менее употребляемые синонимичные конструкции. Не могу не отметить, что помимо этих принципов разные авторы «методичек по борьбе с ИИ» предлагают также намеренно вводить в текст опечатки и пробелы. Особенно интересным мне показался «универсальный» промпт, предлагаемый в статье «Промпт для генерации текста без ИИ следа» [ https://habr.com/ru/companies/kemp_ai/articles/1039690/], поскольку при написании самой статьи этот след остался - 58% AI по оценке GPTZero. Сапожник без сапог?
При тестировании возможностей ИИ-редактирования я, в частности, применяла следующий промпт (А):
· Отредактируй текст, сохраняя его смысл, научный стиль, факты, цитаты и ссылки.
· Сделай ритм изложения менее равномерным. Чередуй короткие, средние и длинные предложения, иногда резко меняй их длину.
· Перестраивай порядок слов и частей предложений, используй разные синтаксические конструкции. Избегай однотипных начал, повторяющихся связок и слишком гладких переходов.
· Допускай менее привычные, но естественные для русского научного языка формулировки. Не вводи искусственно редкие слова и не добавляй новых утверждений.
· Сохрани приблизительный объём текста и заголовки.
2. ИИ-переводы текста. В ходе тестирования использовались переводы с русского языка на английский (RU-EN), с английского на русский (EN-RU, для текста, сгенерированного на английском языке) и двойные переводы RU-EN-RU, при этом в промптах указывалась необходимость максимально точного перевода без изменения содержания и внесения новых смыслов. Двойной перевод русского на английский и обратно считается в сообществе одним из наиболее эффективных методов снижения ИИ-оценок [ t-j.ru/can-you-trick-anitplagiat, avtor24.ru/articles/sovety_studentam/kak_projti_antiplagiat_diploma, zaochnik.ru/blog/13-dejstvennyx-sposobov-obojti-antiplagiat-i-3-prichiny-etogo-ne-delat], впрочем, серьезных обоснований этому я не нашла.
Переводы текстов выполнялись с помощью чата Claude, редактура - с помощью чат-бота ChatGPT. Детектирование выполнялось сервисами Думейт (версия не указана) и GPTZero (AI Detection Model 4.1m), отдельные прогоны проверялись на Антиплагиате (версия 1.8.2 от 06.11.2026). Все прогоны выполнены 5-9 ноября актуальными версиями детекторов.
Результаты тестирования и мои комментарии представлены ниже отдельными таблицами по каждому типу текстов. Напоминаю, что ИИ-показатели разных детекторов имеют разный смысл и не позволяют провести корректное сравнение между ними.
Тестирование текстов, написанных человеком.
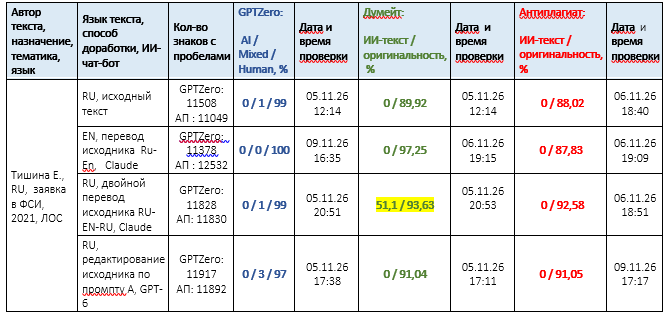
Результаты проверок вузовскими ИИ-детекторами «доработанного» человеческого текста подтверждают мой вывод о наибольшей устойчивости таких текстов к любым способам его доработки.
Антиплагиат и GPTZero оценивают даже доработанный разными способами текст как написанный человеком с абсолютной уверенностью – 0 % ИИ. Однако Думейт неожиданно для меня показал ложноположительный результат 51,1 % по ИИ-доле после двойного перевода человеческого текста на английский и обратно. Этот факт заставил меня искать причину такого результата, мне удалось ее найти и «удалить», после чего Думейт показал кратно более низкие значения ИИ, близкие к 0% и свидетельствующие об авторстве человека.
Причина ложноположительных по ИИ-доле оценок, получаемых этим российским детектором, нетривиальна, что заставляет меня посвятить ей отдельный материал.
Вывод 1: не используйте ИИ-сервисы для «совершенствования» написанного вами текста - это может привести к ложноположительным оценкам ИИ-присутствия. Пусть недостаточно гладким останется текст, зато у вас не будет проблем при вузовской проверке!
Тестирование текстов, сгенерированных машиной.
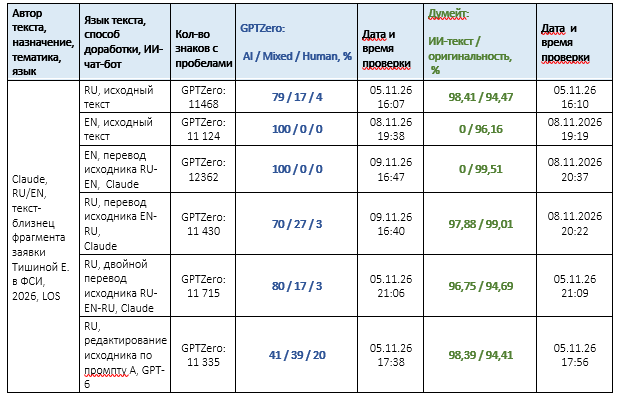
Результаты проверок русскоязычным Думейтом исходного текста, сгенерированного на русском языке, а также всех текстов на русском языке, предварительно подвергшихся «доработке» (перевода английского исходника на русский, двойной перевод русского исходника) абсолютно адекватны, т.е. текст продолжает оцениваться как генерация: снижение показателя ИИ от максимума составляет менее 2 %. А вот оценить генерацию на английском тексте Думейт не может, выдавая ложноотрицательный результат 0% ИИ. Это свидетельствует о его пока еще слабой компетентности в детектировании английских текстов.
Что касается проверок на англоязычном GPTZero, то он демонстрирует полную корректность выводов для текстов на английском языке - 100% ИИ, и более низкое соответствие вероятности ИИ реальному уровню генерации на русских текстах. Вместе с тем, вывод детектора относительно происхождения текста остается верным и в этом случае. Отмечу здесь, что самое большое снижение ИИ-вероятности наблюдается при редактировании сгенерированного текста по промпту А – почти вдвое от исходника, на 38%.
Таким образом, никакие из тестируемых здесь способов «доработки» не помогают превратить ИИ-генерацию в текст человека.
Вывод 2: не пытайтесь превратить сгенерированный текст в человеческий с помощью ИИ-редактирования и промптов. Снижение уровня ИИ-доли по Думейту для всех исследованных способов доработки составило менее 3 процентов.
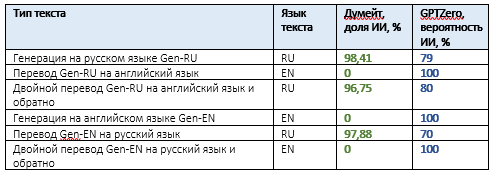
Вывод 3: Каждый вузовский детектор показывает наибольшую чувствительность к текстам на «родном» языке. Совет экзаменаторам для случая, когда студент хочет писать и защищать диплом на английском языке – проверяйте его на GPTZero.
В качестве иллюстрации этого вывода привожу маленькую симметричную таблицу (Таблица 3), показывающую, насколько русский и английский детекторы чувствительны к машинным текстам на «родном» и «чужом» языках.
Тестирование реальных/смешанных текстов.
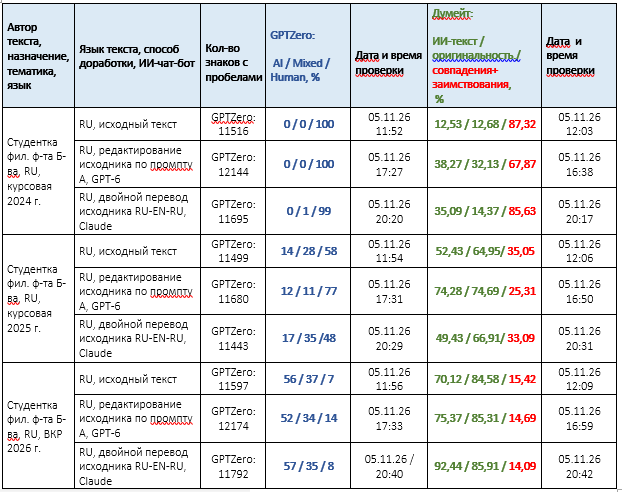
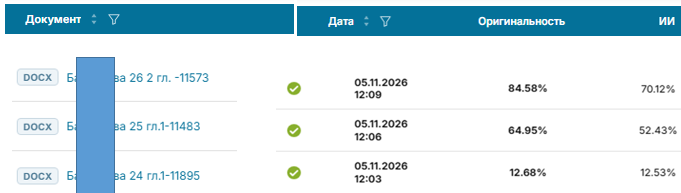
Оценки, представленные выше, имеют особую ценность, поскольку здесь испытывались 3 текста, написанных в разное время одним и тем же человеком. В этом случае, скорее всего, стилистика и лексика текстов, а также ритмика изложения во всех текстах должны быть близкими. Таблица показывает, насколько увеличился объем использования студенткой ИИ-текстов в течение последних трех лет - от 0% до 56% по оценке GPTZero и от 12,5 до 70% - по Думейту.
Мне неизвестно, применяла ли студентка ИИ-сервисы в том или ином качестве для каждой из этих работ, но известно от научного руководителя, что она отличница и защитила все три работы на «5». Эта информация заставила меня сомневаться в реальности оценки в 70% ИИ, сделанной при проверке Думейтом ВКР 2026 г. И мне удалось доказать ошибочность этой оценки, обнаружив простой способ существенно снизить ИИ-долю в этой работе, не меняя содержания. Об этом способе я подробно расскажу позже в материале, посвященном изучению причин ложноположительных результатов российских ИИ-детекторов.
Таким образом, редактирование по промпту с целью снижения ИИ и двойной перевод вашего текста не помогут решить проблему, а лишь усугубят ее. Для всех трех текстов «доработка» увеличила долю ИИ-текста, обнаруженную Думейтом, на 5-25 %, кроме одного случая, когда уменьшение ИИ-доли составило 3 %.
Главный вывод: не пытайтесь сделать текст более человеческим с помощью машины. Пройти ИИ-детектор без замечаний могут лишь честно выполненные и написанные самостоятельно работы.
ПИШИТЕ САМИ!

