


VLM уже неплохо читают текст с картинок. Почему тогда миллионы карточек товаров в день у нас проходят через пайплайн из семи этапов, а не через одну модель?
Привет! Мы — DS-команда «Платформа модерации» в RWB. Мы делаем ML-инструменты, которые помогают модерации проверять визуальный контент на площадке. Один из наших ключевых проектов — OCR: распознавание текста на фотографиях карточек товаров, видеокадрах и других изображениях, которые встречаются в приложениях RWB.
В этой статье мы втроём — Дмитрий Колесников (Team Lead команды), Константин Сулоев (Tech Lead проекта OCR) и Николай Ладыкин (Senior ML-инженер) — расскажем, как устроен наш OCR-пайплайн, из каких моделей и этапов он состоит и почему в продакшене Wildberries он выглядит именно так, а не как одна большая end-to-end-модель или универсальная VLM.
Что будет в статье
С каким контентом работает OCR в модерации и какие требования к нему предъявляет продакшен.
Почему идея «одна модель на всё» так привлекательна и где она ломается на эксплуатации.
Основные причины, почему пайплайн должен быть многоступенчатым, и как постепенно формируется порядок операций в угоду требованиям проекта.
Как пайплайн маршрутизирует запросы и масштабируется в проде.
Спойлер: VLM у нас тоже есть. Просто работает она не там, где её обычно ожидают увидеть.
Немного о масштабах
Каждый день через модерацию Wildberries проходит больше 35 млн карточек товаров. Через модель распознавания текста проходит около 400 млн изображений. Больше 90% этого потока — именно фотографии карточек товаров.
При таких объёмах мало, чтобы решение хорошо работало на отдельных примерах. Оно должно держать весь поток и вести себя предсказуемо.
Зачем модерации текст с картинок
Текст, который мы извлекаем из изображения, — это вход для дальнейших проверок. В нём модерация ищет:
контактные данные;
запрещённые слова;
запрещённые препараты в составе;
другие нарушения правил площадки.
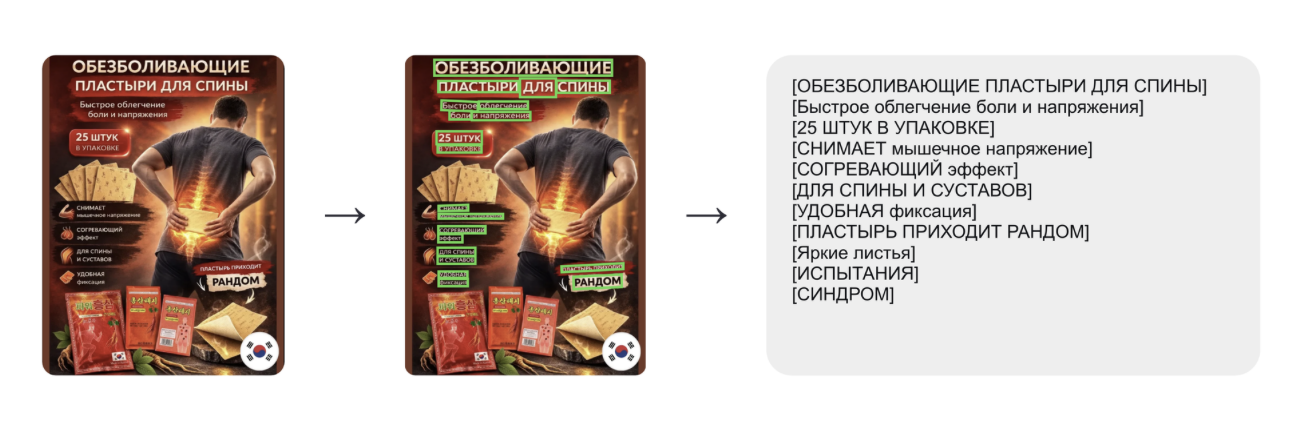
Карточки товаров очень разнородны. На них встречаются разные языки и письменности, яркие цвета и пёстрый фон. Сам текст может идти по диагонали, по дуге, быть изогнутым или вертикальным — когда символы стоят друг над другом.
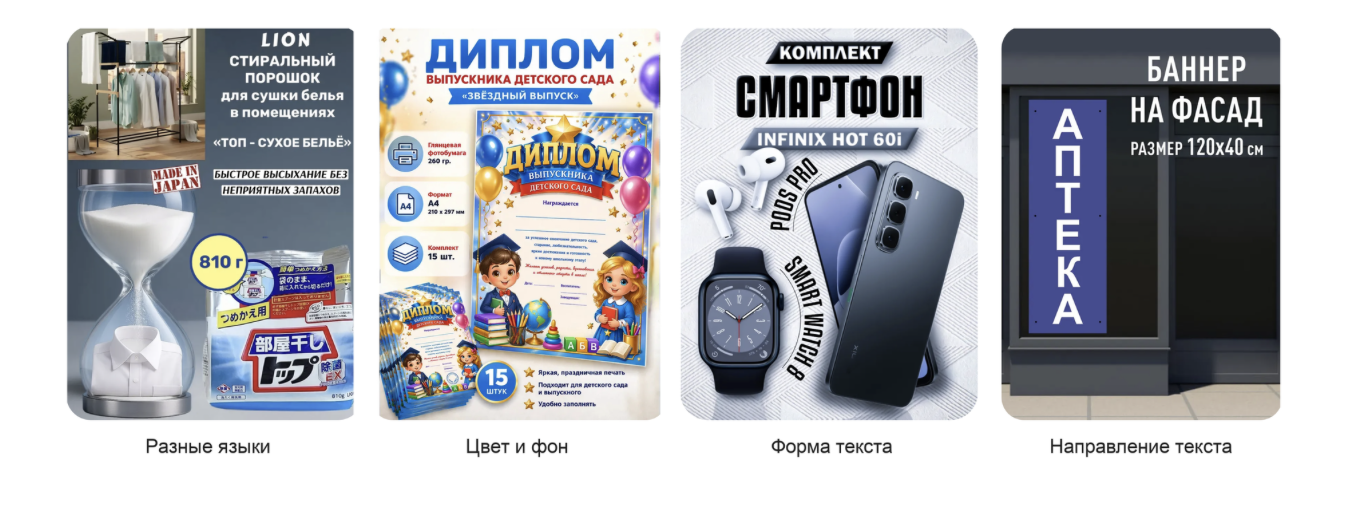
Отдельная сложность — мультиязычность. На одной карточке одновременно могут быть разные языки и письменности. Компания работает уже больше чем в 10 странах, и их число растёт. Значит, нужно поддерживать локальные языки и корректно читать зарубежный текст.
Требования к распознаванию текста
Исходя из всего этого, от OCR нам нужно довольно многого:
Много языков без потерь в качестве.
Координаты текста, а не только сами строки.
Предсказуемая скорость на потоке.
Приемлемая стоимость решения.
Быстрое развитие: добавлять новый функционал, не ломая старый.
Отладка по этапам: возможность точечно находить и исправлять ошибки.
Плохая работа хотя бы одного из этих пунктов приводит к некачественному входу для модерации и, как следствие, к репутационным рискам компании.
Тренд: одна модель на всё
Индустрия сейчас очень любит универсальные модели: почти всё переезжает на трансформеры. Логика понятная — зачем держать связку из нескольких моделей, если одна умеет всё?
Под «одной моделью» не обязательно понимается огромная VLM на много миллиардов параметров. Есть и специализированные end-to-end OCR-архитектуры — например, GLM-OCR, у которой меньше миллиарда параметров. Такие модели компактнее и по скорости иногда ближе к классическому пайплайну.
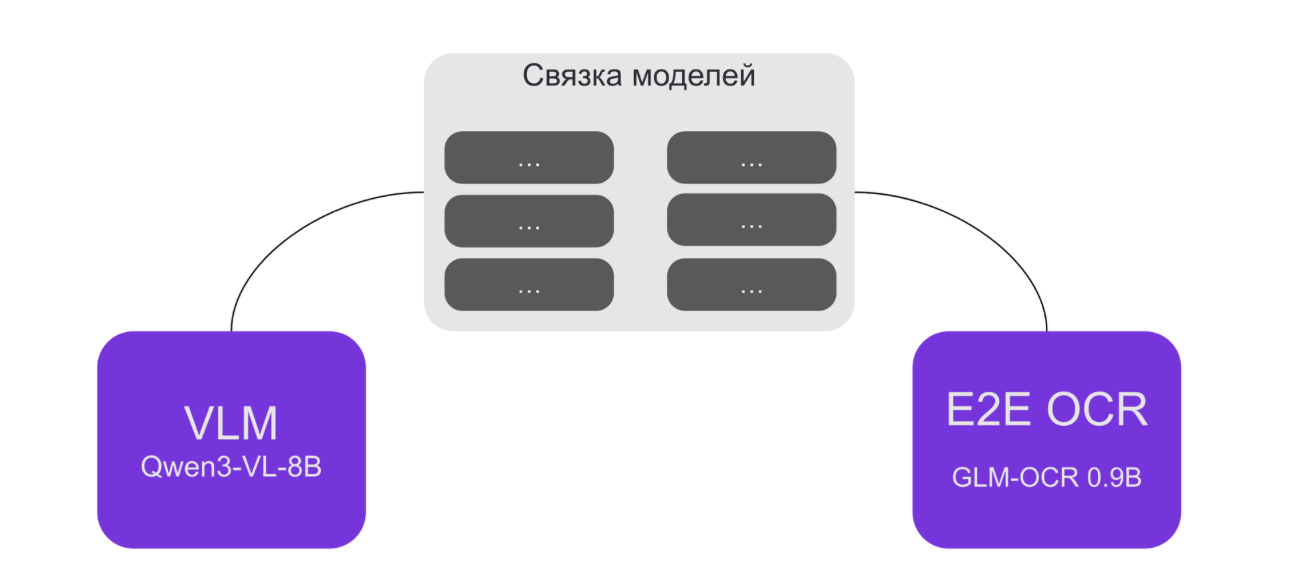
Разберём обоих кандидатов на роль «одной модели».
Роль большой VLM
Возьмём большую VLM — например, Qwen3-VL. Она принимает изображение на вход и отдаёт текст на выходе.
На нашем потоке такой вариант сразу упирается в память и скорость принятия решения. При этом символы модель распознаёт хорошо, поэтому мы используем её для оценки и валидации качества пайплайна. Она запускается параллельно на очень маленькой доле потока — чтобы измерять метрики, валидировать качество пайплайна и находить корнеркейсы для их дальнейшего устранения. То есть это не замена основному OCR, а вспомогательный контур на доли процента трафика.
Итог: VLM на всём потоке — нет, VLM для валидации пайплайна — да.
Роль end-to-end OCR
Следующий кандидат — специализированная end-to-end OCR-модель. Её можно дообучить под наш домен и заметно упростить систему: картинка на входе, текст на выходе. На бумаге всё выглядит отлично:
проще;
универсальнее;
меньше компонентов.
По скорости такой вариант не отпадает сразу, как большая VLM. Вопрос в другом: получится ли так же точечно развивать и чинить систему, как пайплайн?
Где красивая гипотеза ломается при эксплуатации
Демо и прод — разные вещи. Нам важно не показать лучшую метрику на одном тесте, а стабильно давать модерации результат, которому можно доверять. Дальше покажем, на каких конкретных продакшен-ограничениях end-to-end-подход упирается в потолок.
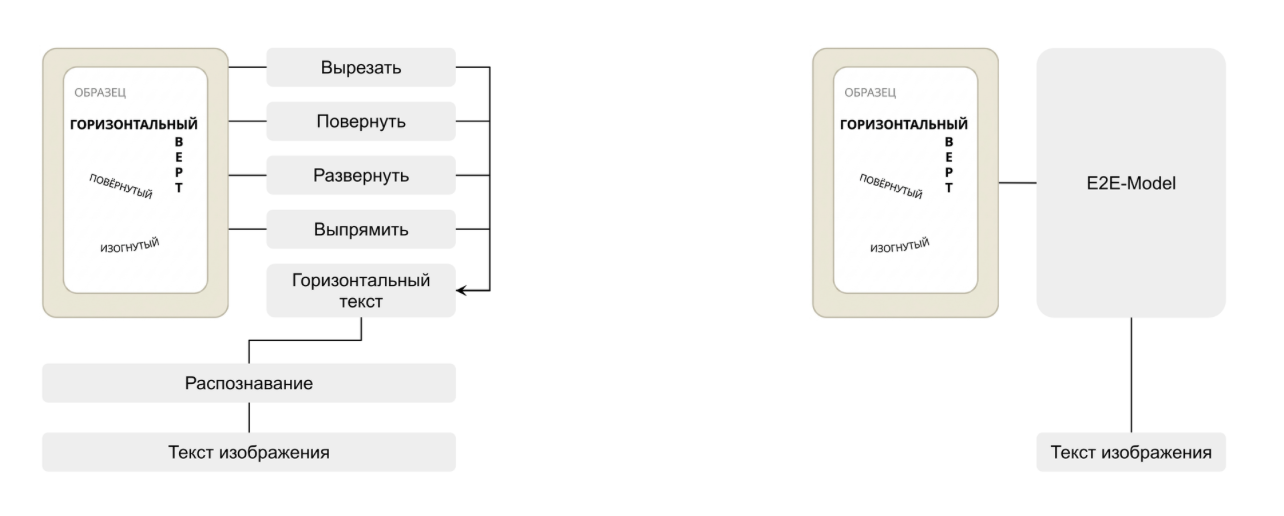
Отправная точка — классическая схема, по которой устроены EasyOCR, PaddleOCR и многие другие открытые решения: предобработка, детекция текста, распознавание символов и постобработка.
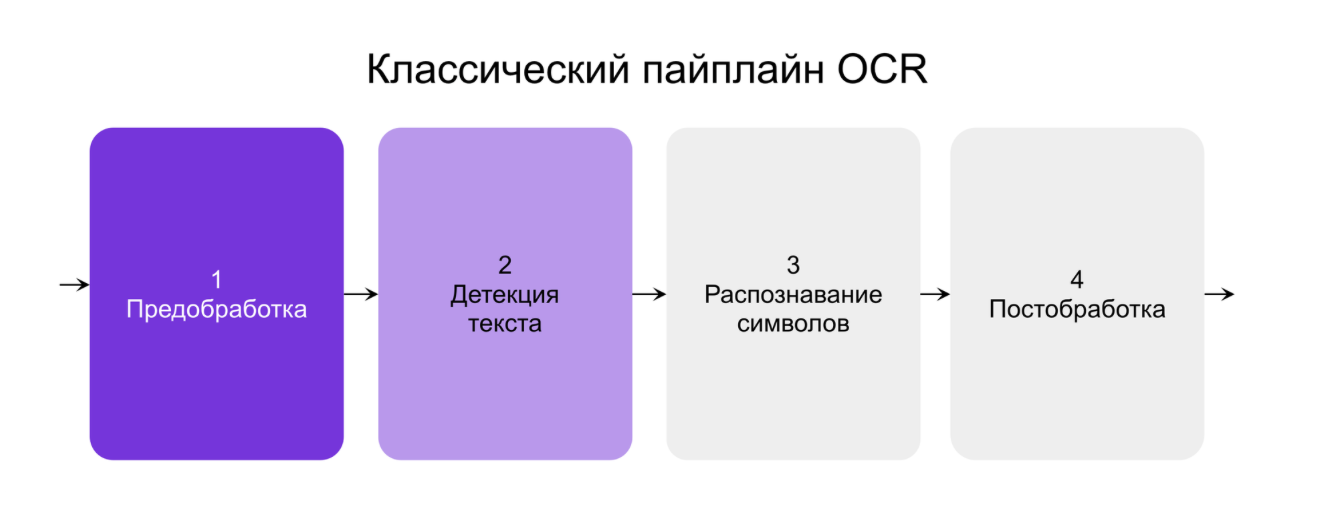
Наша система устроена сложнее: к базовой схеме добавились сегментация с выпрямлением текста, маршрутизация по письменностям и построение порядка чтения. Будем добавлять эти блоки по одному — по мере того как сталкиваемся с ограничениями продакшена.
Фактор 1: геометрия текста
Текст на карточках — далеко не только ровная горизонтальная строка. Он бывает повёрнут, идёт по диагонали, выгибается дугой или лежит на упаковке сложной формы.
Это не редкие исключения, которые можно просто отбросить. Такой текст нужно стабильно нормализовать и только потом распознавать. Иначе геометрическая ошибка уйдёт в модерацию уже в виде готового текста.
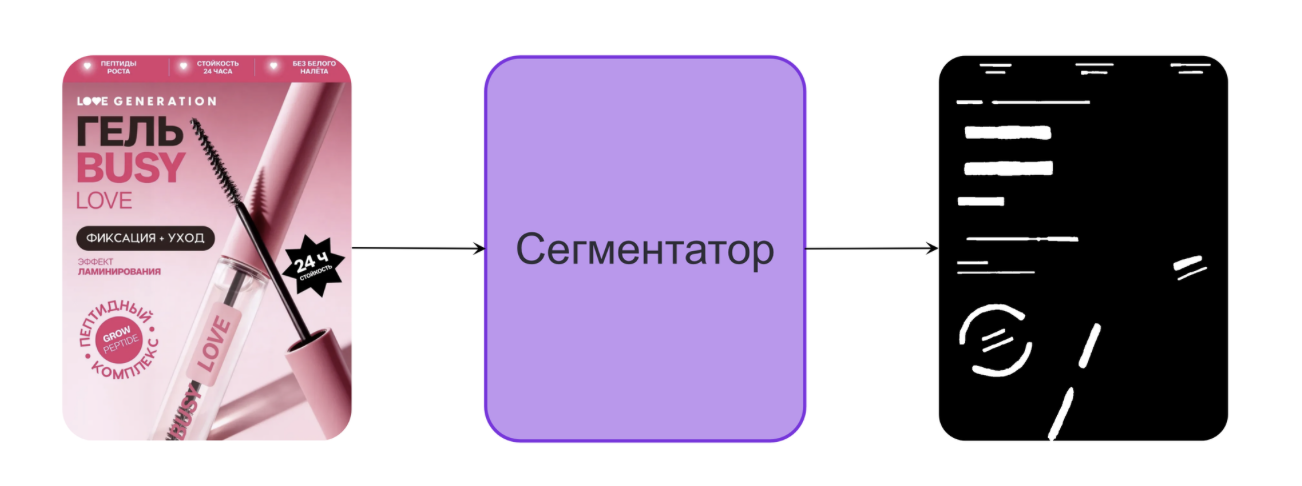
Почему нужен сегментатор
Обычного детектора здесь недостаточно: прямоугольная рамка не всегда описывает форму текста. Поэтому нам нужен сегментатор — он даёт контур и маску текста. По форме контура мы понимаем, к какому типу относится кроп и какую обработку к нему применить.
Получается цепочка: маска → тип кейса → обработка.
Четыре типа обработки
Мы выделяем четыре типа контуров, и для каждого есть свой постпроцессинг:
горизонтальный текст достаточно вырезать;
наклонённый или диагональный — довернуть;
вертикальный — развернуть в горизонтальную строку;
искривлённый — выпрямить по контуру.
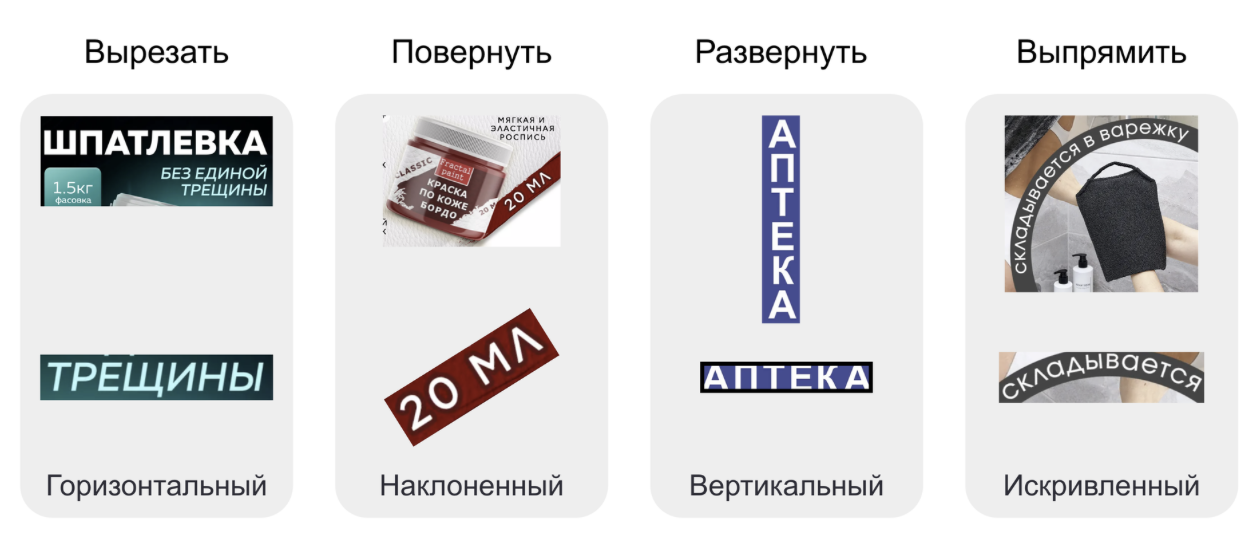
Сначала мы определяем тип кропа, затем применяем нужное преобразование и только после этого отдаём нормализованный кроп в OCR.
У VLM те же шаги — найти текст, понять его форму, нормализовать ориентацию — происходят неявно, внутри одной модели. Проверить каждый из них отдельно нельзя: есть только итоговый ответ.
Выпрямление искривлённого текста
Самый сложный случай — искривлённый текст: обычного поворота здесь уже недостаточно.
Мы берём текстовый кроп, оцениваем его среднюю линию и строим по ней TPS-преобразование (thin plate spline). Количество опорных точек адаптивное — оно зависит от длины и формы текста. За счёт этого можно аккуратно выпрямить даже сложную геометрию и получить на выходе прямой кроп, который стабильно распознаётся.
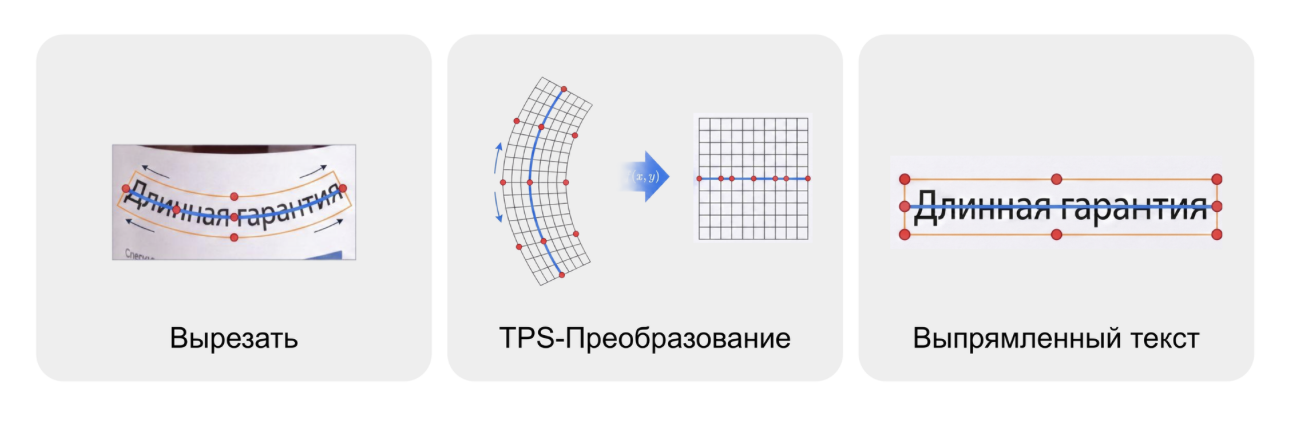
Сложную геометрию мы решаем до распознавания, а не оставляем целиком на откуп модели.
Пайплайн растёт
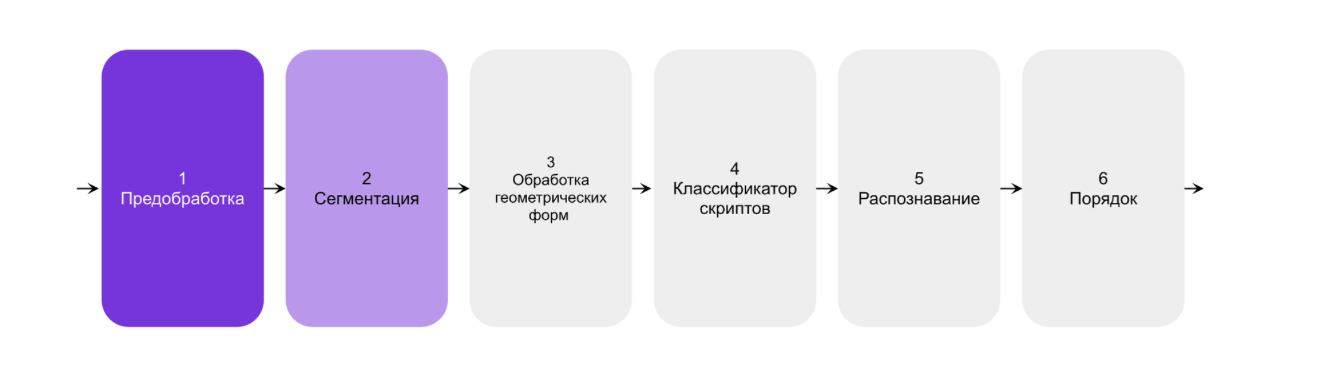
Первый кусок пайплайна собран: в нём появились предобработка, сегментация и обработка геометрических форм.
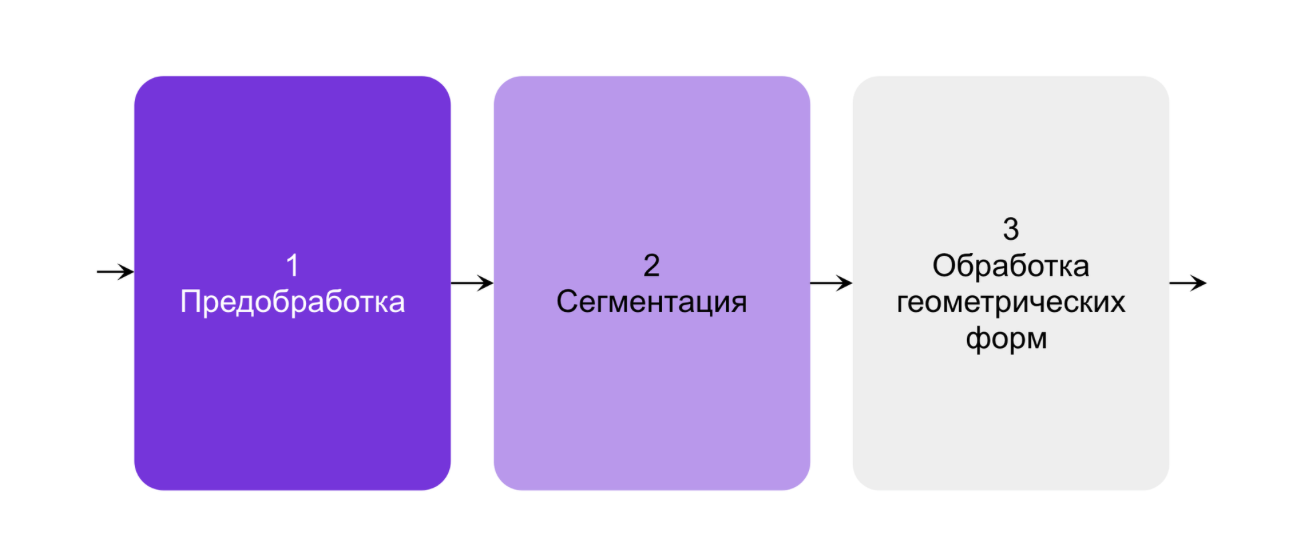
Если, например, плохо читается текст на дуге, мы исправляем TPS-преобразование и заново проверяем только этот тип кропов. Модели распознавания и обработку остальных типов текста перекатывать не нужно.
Фактор 2: языки
Сейчас мы распознаём больше десяти языков. Распределены они очень неравномерно: на русский приходится около 80% трафика, остальные языки заметно меньше.
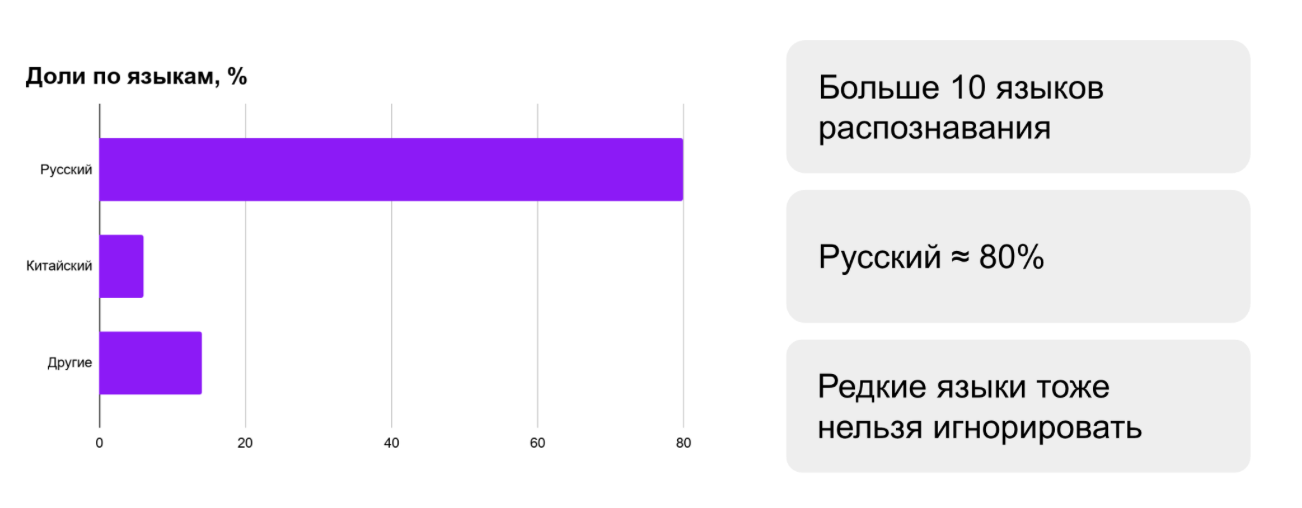
Но редкие языки всё равно нельзя игнорировать — карточки на них тоже должны проходить модерацию.
Смешанный текст на одной карточке
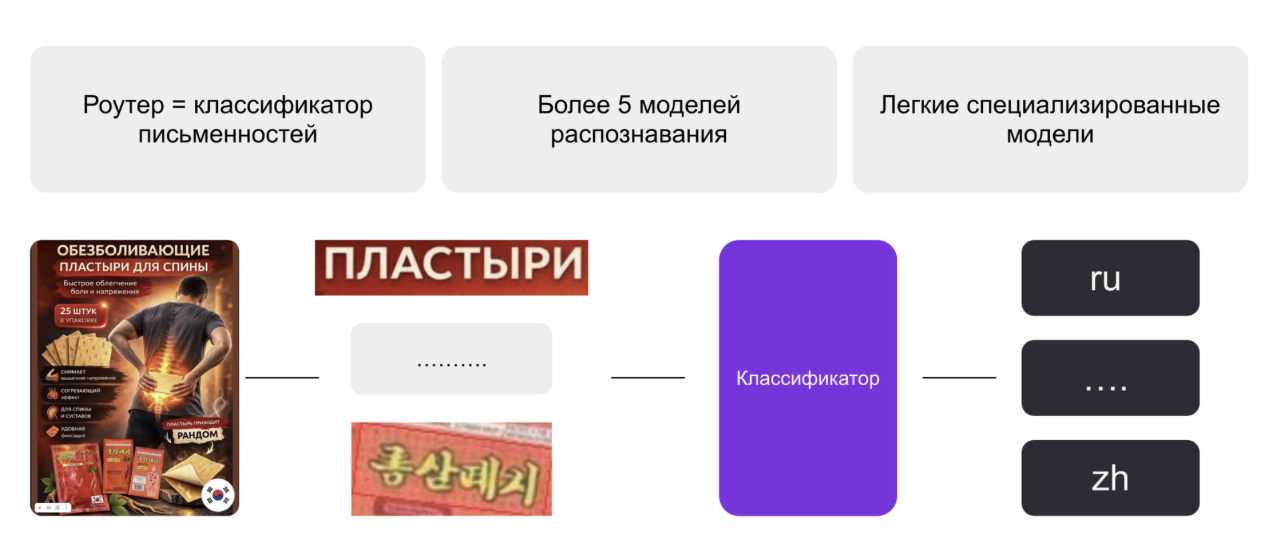
На одной карточке могут соседствовать, например, русский и корейский текст. Для системы возникает конкретный вопрос: какой моделью распознавания читать каждый кроп и как не перепутать письменность?
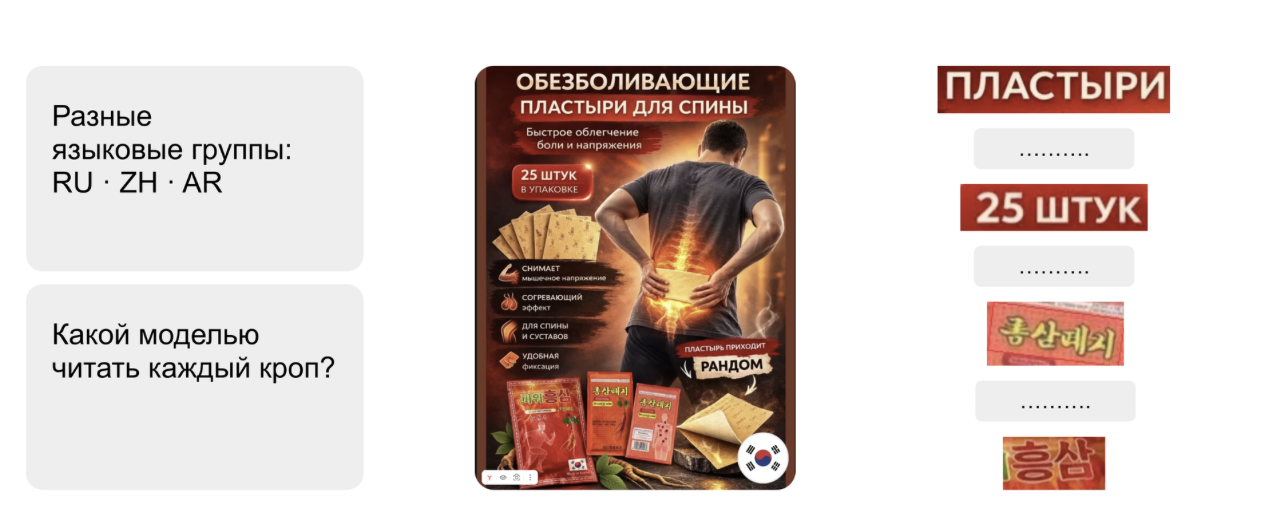
Универсальная модель обещает разобраться с этим сама. Вопрос в том, насколько безопасно полагаться на такое поведение, когда добавляются новые языки.
Риск одной модели: падение качества
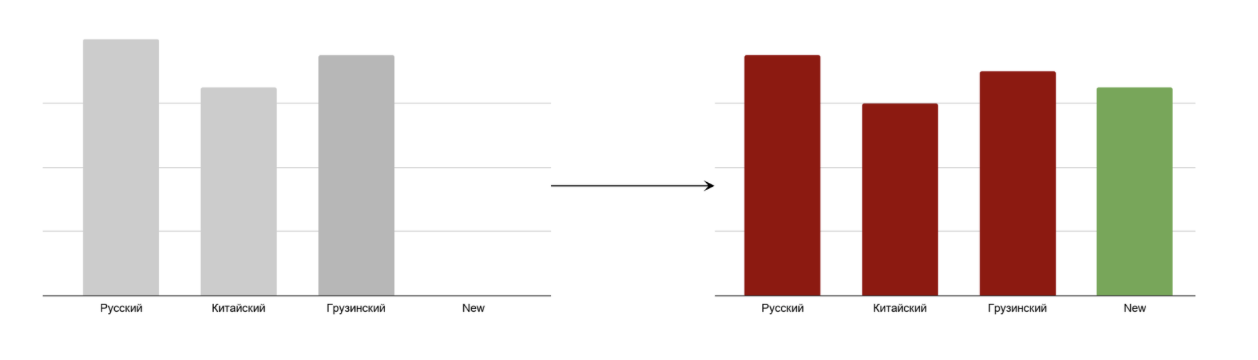
При дообучении на данных нового языка качество на уже поддерживаемых языках может проседать — в том числе на русском. А русский составляет основную долю трафика.
Средняя метрика может почти не показать такую деградацию: редкий язык слабо влияет на общий результат. Но на проде она всё равно превращается в большое количество ошибок.
Есть техники, которые снижают этот эффект, — например, подмешивание данных уже поддерживаемых языков при дообучении или отдельные адаптеры. Но гарантии изоляции они не дают: перед каждым релизом всё равно приходится заново проверять качество на всех языках.
Почему нужен классификатор письменности
В модульном пайплайне изменение можно изолировать в одной языковой ветке. Для этого появляется маршрутизация по моделям распознавания (рекогнайзерам): перед ними работает классификатор письменности, который для каждого кропа выбирает нужную ветку. Сам текст классификатор не распознаёт — его задача правильно выбрать маршрут.
Сейчас у нас больше пяти таких веток. Схожие языки при необходимости объединяются в одну ветку по языковым группам — так система не раздувается до огромного количества моделей.
В VLM новый язык встраивается в общий механизм распознавания: меняются общие веса, а значит, потенциально и качество на языках, которые уже работали. В пайплайне для нового языка готовится отдельная модель со своим набором проверок, и её ошибки затрагивают только кропы, которые классификатор направил в эту ветку.
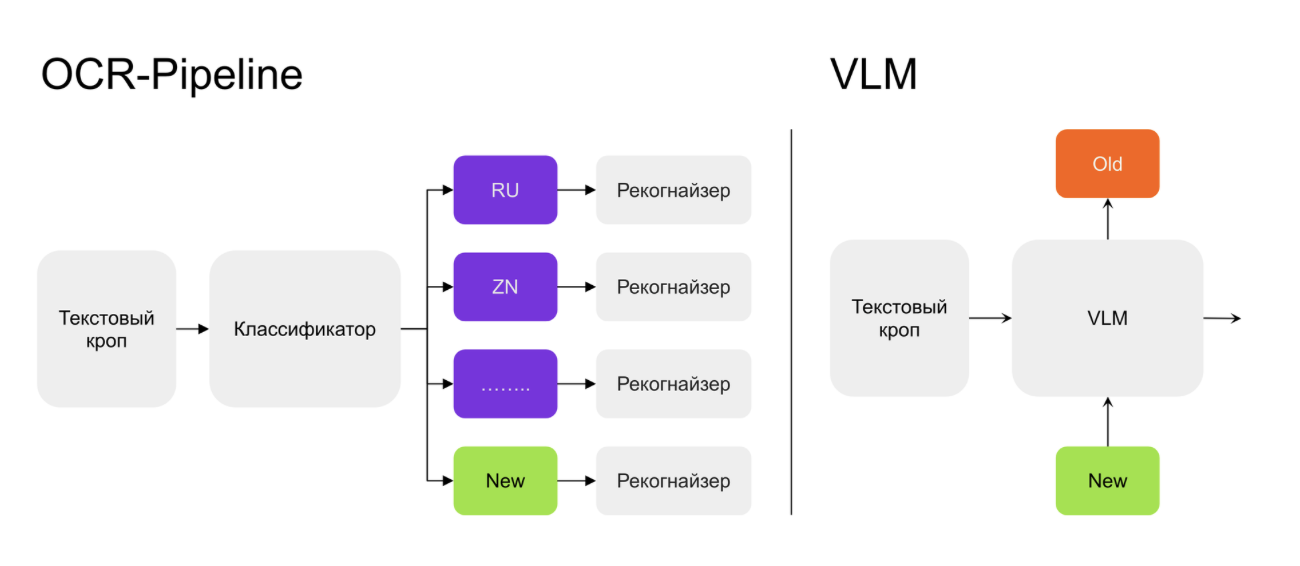
Выигрыш: новый язык без перекатки всего
На практике новый язык получает отдельный рекогнайзер, свой golden dataset, валидацию и отдельную выкатку.
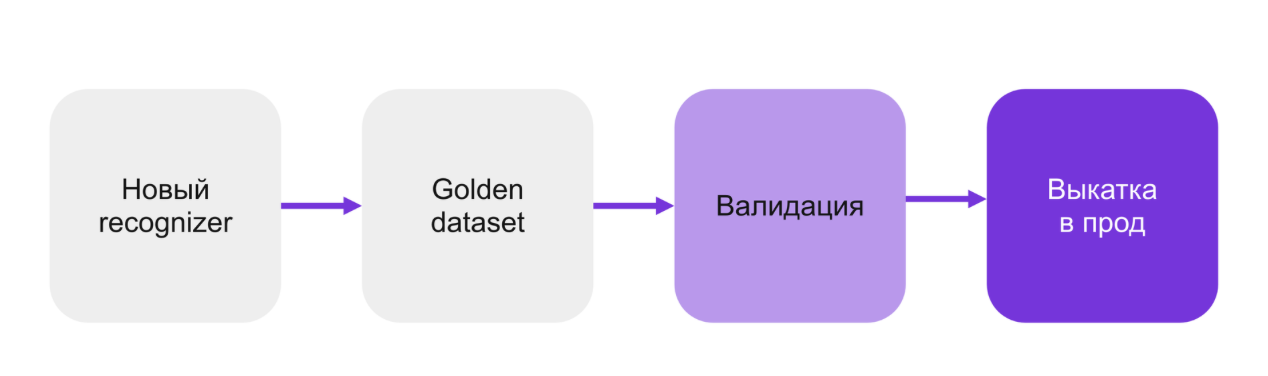
Веса русской модели при этом не меняются. Перед релизом не нужно доказывать, что обучение на новом языке случайно не ухудшило основной русский поток. Зона риска ограничена новой веткой и тем трафиком, который маршрутизатор направляет именно в неё.
Отдельно стоит оговорить случай близких языков с пересекающимися символами или общей письменностью, которые классификатор может путать. Здесь не обязательно заводить отдельную ветку на каждый язык. Если различие между языками неустойчиво, а ошибка маршрутизации дороже, чем небольшая потеря качества, языки можно объединить в одну группу. Маршрутизатор в таком случае выбирает не конкретный язык, а группу.
Пайплайн растёт: классификатор и модели распознавания
В пайплайне появляются классификатор письменности и сами модели распознавания.
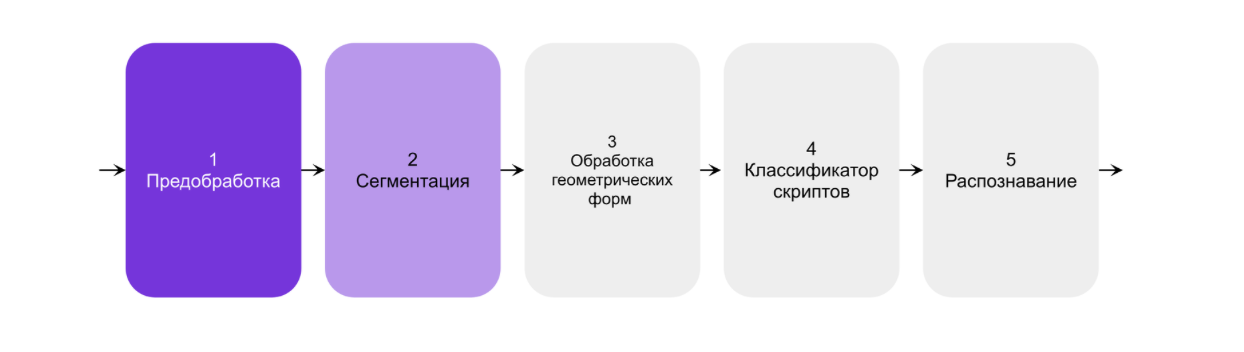
Классификатор выбирает маршрут для каждого кропа. Кропы, отправленные в одну языковую ветку, можно объединить в батч и обработать параллельно. Поэтому вычислительные ресурсы распределяются по реальному трафику: востребованная русская ветка получает больше вычислительных ресурсов, а редким языкам столько инстансов не нужно.
Время обработки в пайплайне тоже зависит от количества текста: чем больше текста на карточке, тем больше кропов. Но кропы распознаются батчами параллельно, а end-to-end-модель генерирует весь текст последовательно, токен за токеном.
Фактор 3: порядок чтения
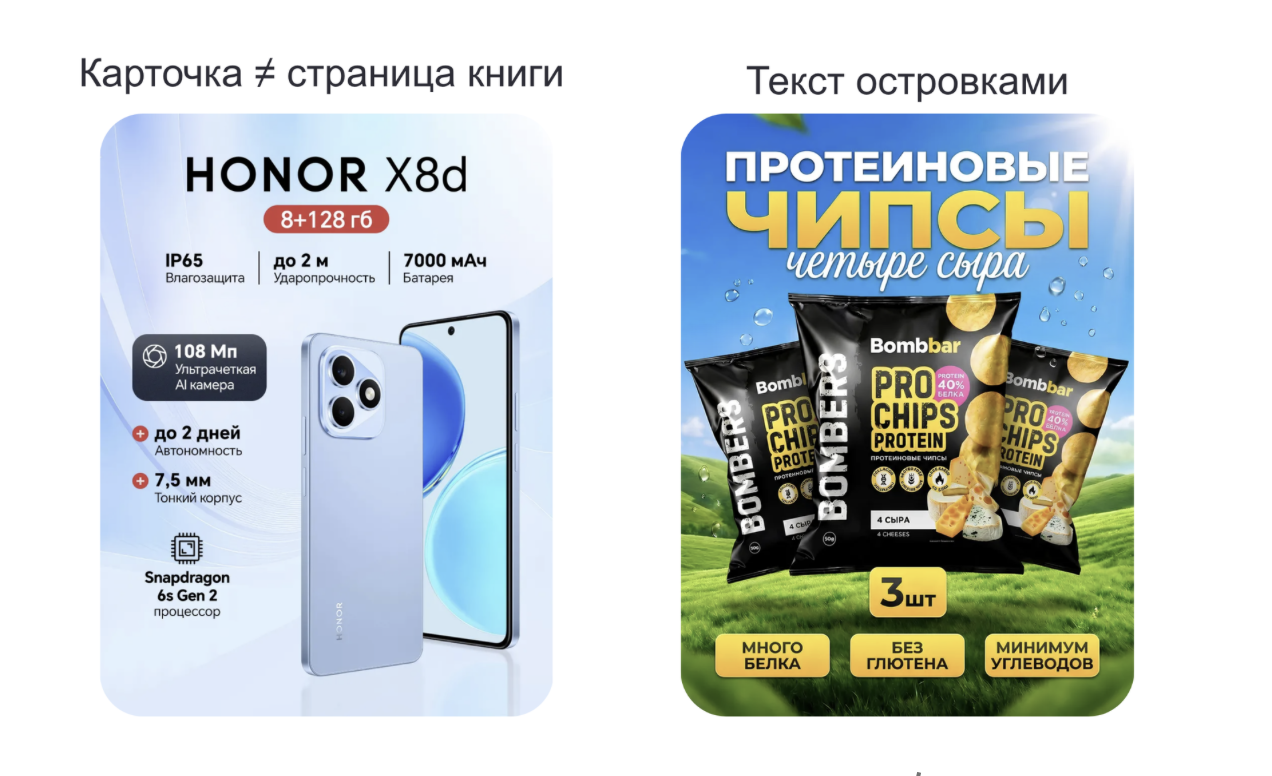
Карточка товара — это не страница книги. Текст на ней расположен островками: блоками, плашками, маркетинговыми бейджами. Если просто читать сверху вниз и слева направо, получится бессмысленный набор слов.
Наивный порядок и кластеры
Наивный порядок даёт кашу: «3шт, МНОГО, БЕЗ, МИНИМУМ, БЕЛКА, ГЛЮТЕНА, УГЛЕВОДОВ». А после группировки близких текстовых областей появляется осмысленный текст: «3шт / МНОГО БЕЛКА / БЕЗ ГЛЮТЕНА / МИНИМУМ УГЛЕВОДОВ».
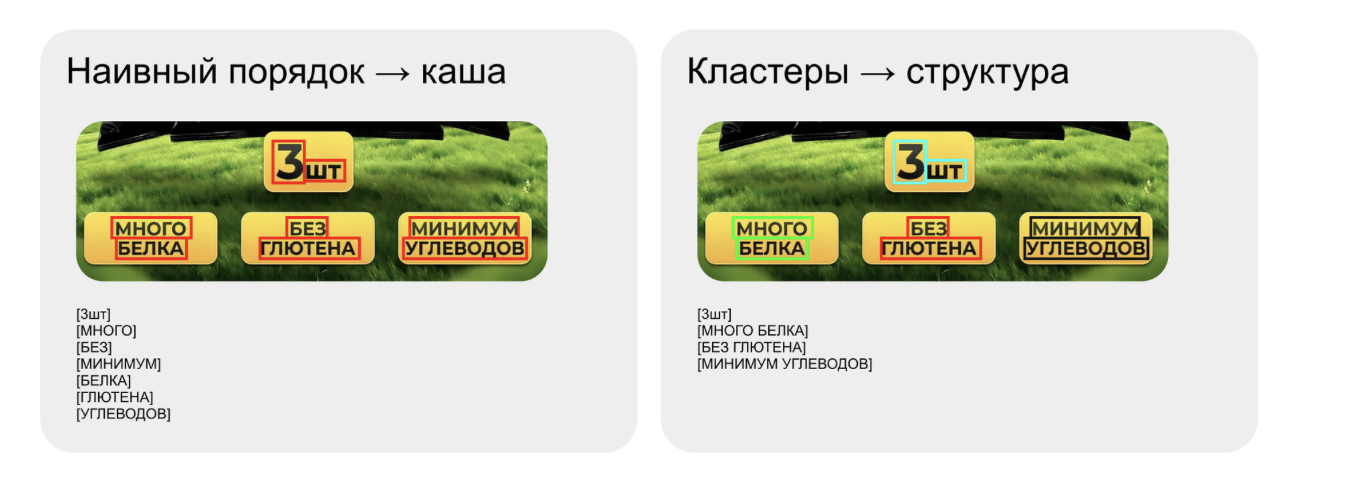
Нам важно не только распознать символы, но и правильно собрать из них текст. Иначе модерация получит бессмысленную последовательность, хотя каждый символ распознан верно.
Порядок чтения: сравнение с VLM
В нашем пайплайне кластеризация и построение порядка чтения — отдельный алгоритм с понятными правилами, которые можно отлаживать и менять. В VLM порядок формируется внутри генерации: на простом изображении это выглядит хорошо, но при большом количестве текстовых областей может рассыпаться.
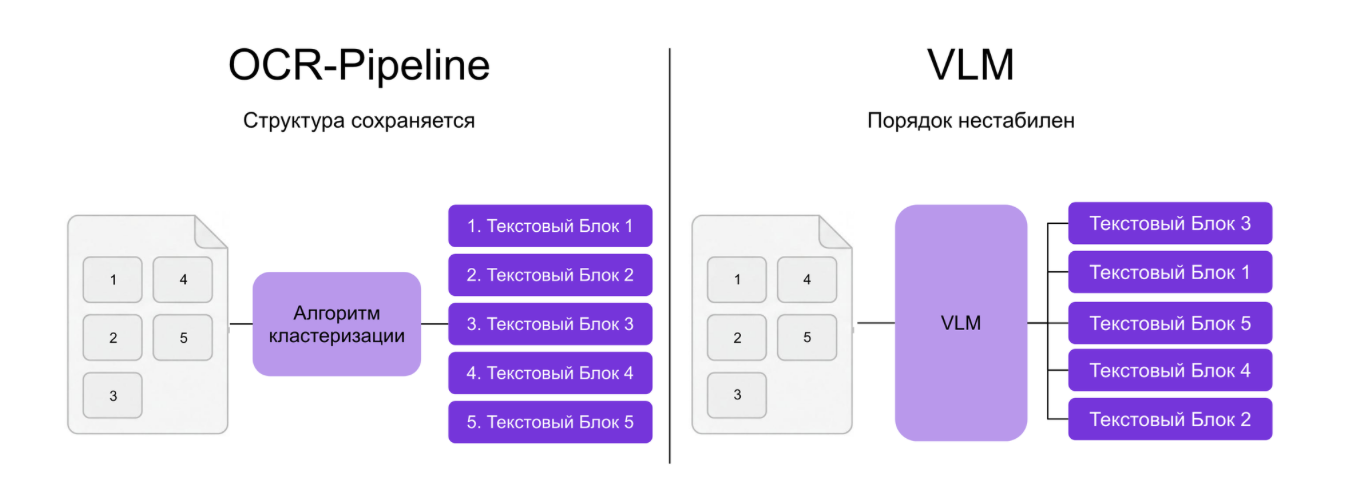
Пайплайн растёт: кластеризация
К пайплайну добавляются кластеризация и построение порядка чтения. На этом этапе уже распознанные боксы объединяются в смысловые группы и выстраиваются в последовательность.
Это ещё один отдельный рычаг улучшения. Если текст прочитан правильно, но блоки собраны в неверном порядке, значит, ошибка в алгоритме кластеризации — исправлять или переобучать рекогнайзеры не нужно.
Фактор 4: нужны не только буквы
Следующий фактор — сам выход системы. Одной строки с распознанными символами недостаточно: нужны координаты текстовых областей, чтобы при необходимости обработать конкретную область на изображении. Отдельный пример — задачи локализации текстового бокса. Иногда нужно не просто знать, какой текст есть на изображении, но и понимать, где именно он расположен. Например, если на фото нужно скрыть персональные данные (ФИО, телефон, адрес и т.п.), недостаточно распознать текст — нужно найти его координаты, чтобы закрыть или замазать соответствующий фрагмент. Важно понимать не только, что написано, но и где именно это написано.
Боксы и просто текст
Текст без локализации — слабое доказательство. По координатам можно понять источник сигнала: это текст на самом товаре или маркетинговая плашка. Поэтому для модерации бокс — такая же часть контракта системы, как и сам текст.
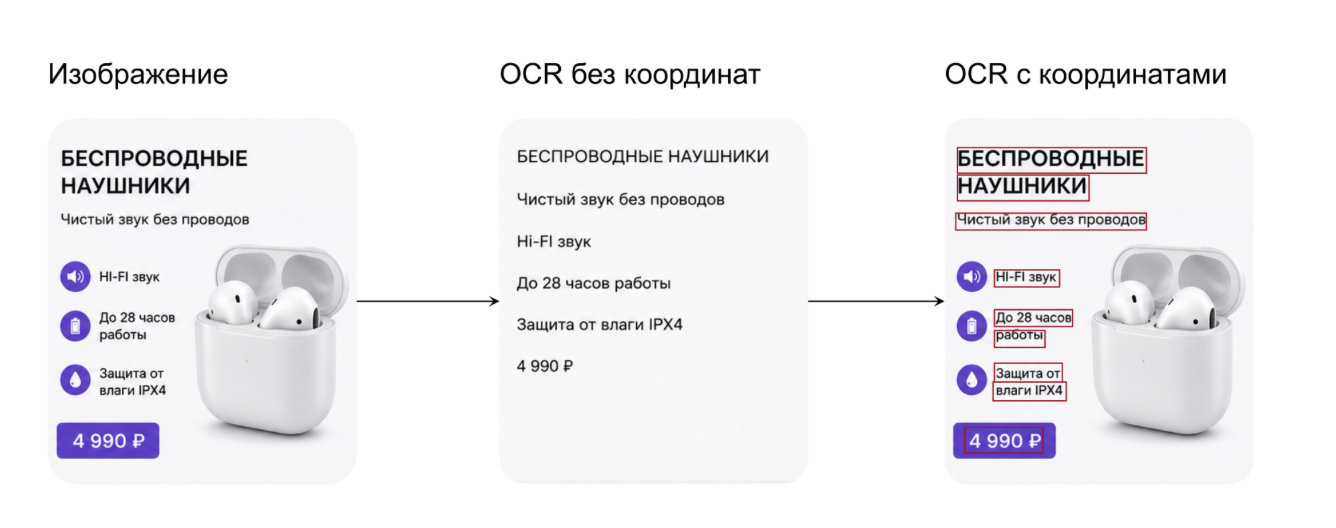
Слабость большой модели по геометрии
Большие мультимодальные модели хорошо генерируют текст, но со стабильной геометрией всё сложнее. Боксы могут быть неточными, «плавать» от запроса к запросу или выглядеть уверенно, хотя фактически быть выдуманными. А на нестабильные координаты нельзя опираться как на доказательство при решении о бане карточки товара.
В пайплайне координаты — результат отдельного этапа детекции и сегментации. У VLM бокс генерируется вместе с ответом, и с ростом количества объектов локализация становится менее стабильной: по нашим проверкам, на изображениях с более чем двадцатью боксами ошибки уже очевидны. Текст модель ещё может назвать правильно, но её геометрии как точному сигналу доверять нельзя.
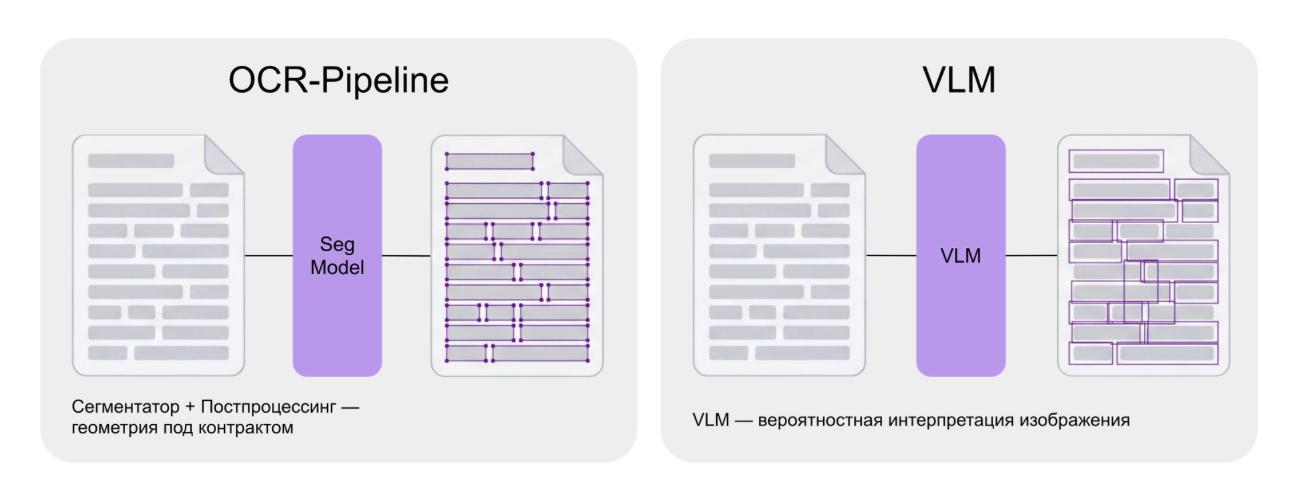
Пайплайн растёт: выходной контракт
В результате пайплайн возвращает не просто строку. Для каждого кропа на выходе есть:
распознанный текст;
координаты;
уверенность модели;
информация о том, какой рекогнайзер его обработал.
Последний пункт важен для языков с общей письменностью. Например, французский, испанский и немецкий используют латиницу, и по одним символам не всегда понятно, какой это язык.
Формат выхода стабилен, а уверенность модели можно использовать для аналитики. Такой контракт позволяет проследить происхождение результата: найти исходный бокс, увидеть его координаты и проверить, какой рекогнайзер сформировал текст, поступивший в модерацию.
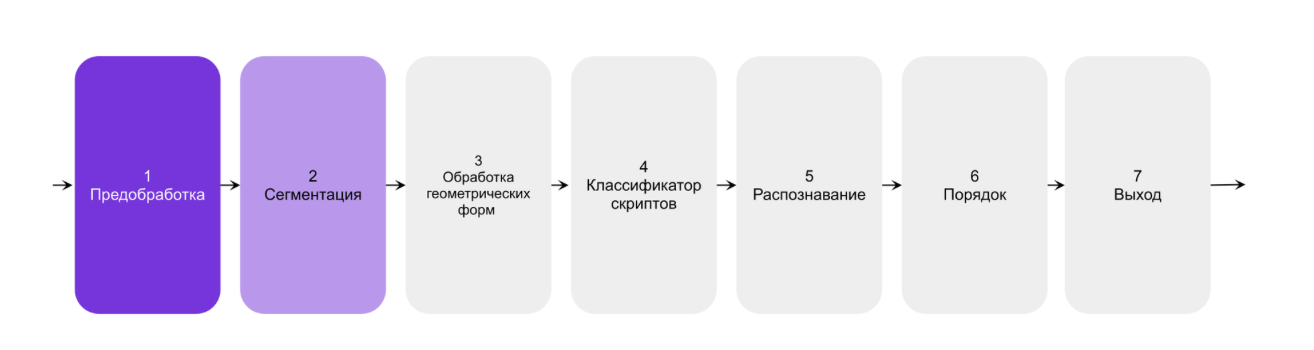
Полная цепочка теперь выглядит так: предобработка → сегментация → обработка геометрии → классификация письменности → распознавание → кластеризация и порядок чтения → выход. Каждый блок в ней появился из конкретного ограничения продакшена.
Фактор 5: точечные правки — что объединяет все предыдущие
Все предыдущие факторы сводятся к одному свойству — возможности вносить точечные правки.
Если в пайплайне что-то читается неправильно, ошибку можно найти по этапам. Возьмём искривлённый текст: последовательно проверяем маску сегментатора, результат выпрямления и ответ рекогнайзера — и видим, где именно появилась ошибка. Дальше чиним только этот этап — TPS-преобразование, одну языковую ветку или алгоритм кластеризации — и перепроверяем только затронутый трафик.
У end-to-end-модели такого разделения нет. Неверный текст на выходе есть, а где сломалось — в поиске текста, в геометрии, в распознавании или в порядке чтения — понять нельзя. Модель работает как чёрный ящик, и исправление обычно означает дообучение всей модели с перепроверкой всего, что уже работало.
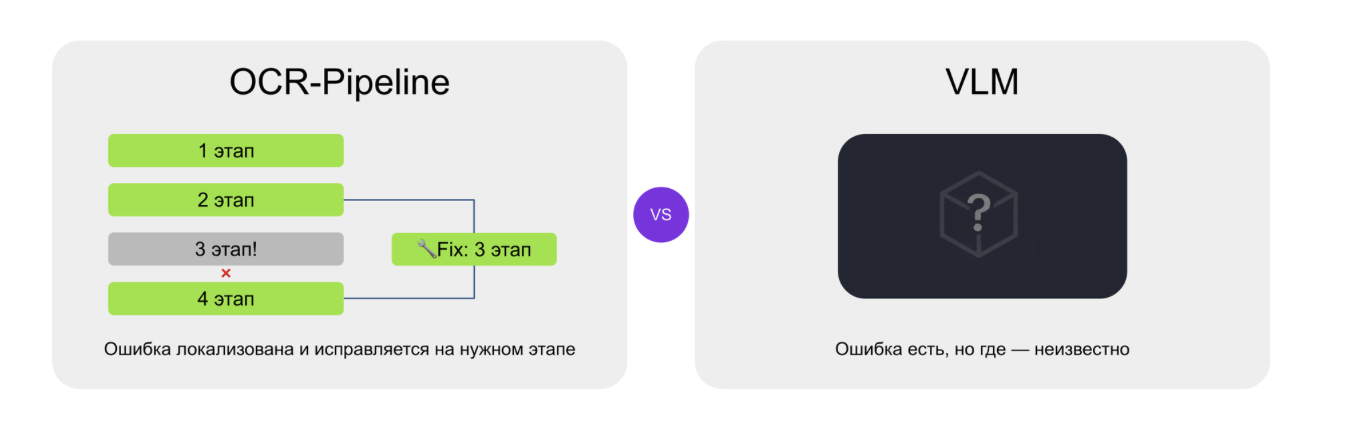
А что с компактными end-to-end OCR-моделями
В начале статьи у нас было два кандидата на роль «одной модели». Большая VLM отпала сразу — из-за памяти и задержки. Компактная end-to-end OCR-модель быстрее, но все пять факторов относятся и к ней: поиск текста, нормализация и распознавание скрыты внутри одной сети, новый язык меняет общие веса, а боксы и порядок чтения генерируются вместе с текстом. Меньший размер снимает часть вопросов к стоимости, но не даёт управляемости, которая нужна модерации.
Как пайплайн устроен в проде
Маршрутизация
Запросы собирает агрегатор. Он делает препроцессинг и отправляет кропы в нужные модели. Каждая модель работает как отдельный сервис инференса. Агрегатор знает, какой ветке предназначен кроп, а затем собирает результаты обратно в единый ответ: кластеризует и объединяет их.
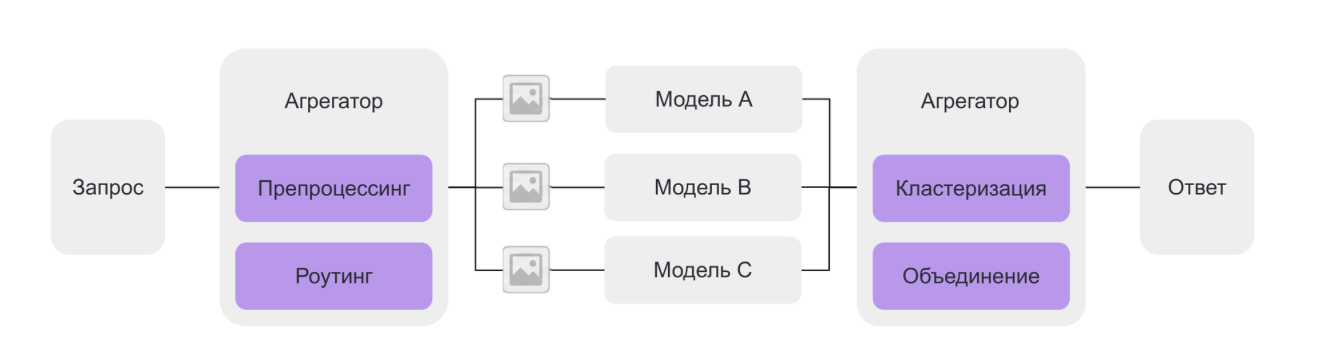
Что даёт такая схема:
Децентрализация. Общая обработка изображения отделена от моделей распознавания. Ветку можно обновить или заменить, не трогая остальные части системы.
Инстансы по нагрузке. Количество инстансов каждой модели определяется её реальным трафиком.
Гибкое масштабирование. Узкое место расширяется точечно.
Два подхода к масштабированию
В модульном пайплайне русская модель вызывается чаще, поэтому для неё можно поднять больше инстансов. Редкий язык получает меньше трафика, и его ветка остаётся компактной. Если узким местом становится одна модель — например, сегментатор, — масштабируем только её.
Одна универсальная VLM тоже масштабируется горизонтально, но единица масштабирования у неё — вся модель. При росте нагрузки приходится добавлять целиком ещё один тяжёлый инстанс, даже если дополнительная мощность нужна только для части запросов.
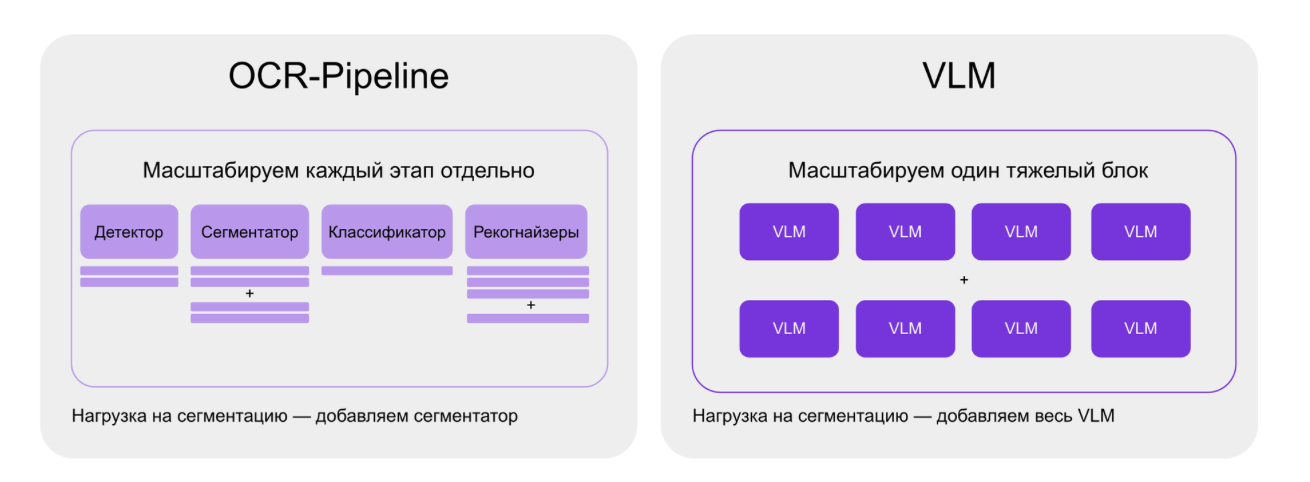
Разница не в том, масштабируется ли VLM вообще, а в гранулярности.
Пять факторов в одной таблице
Фактор | OCR-пайплайн | Одна end-to-end модель (VLM или компактная e2e OCR) |
|---|---|---|
Языки | Изменения изолированы в отдельной языковой ветке | Новый язык меняет общие веса и может ухудшить уже работающие языки |
Координаты | Отдельный этап детекции и сегментации, часть выходного контракта | Боксы генерируются вместе с ответом и нестабильны на плотных изображениях |
Отладка | Ошибка ищется в конкретном этапе | Чёрный ящик: ошибка есть, но где — неизвестно |
Задержка и стоимость | Лёгкие специализированные модели, кропы батчуются по языковым веткам | Текст генерируется токен за токеном; большой VLM вдобавок нужно много памяти |
Выкатка и масштабирование | Обновляем и масштабируем одну ветку | Перекатываем и масштабируем модель целиком |
Подведём итоги
Если коротко: в продакшене с большим потоком пайплайн из нескольких моделей оказывается надёжнее одной универсальной модели.
Бенчмарк ≠ лучший production OCR. Хорошая метрика на тесте не гарантирует стабильного поведения на реальном потоке.
Классический пайплайн до сих пор актуален. Он может выглядеть старым подходом, но каждый его этап можно контролировать и развивать отдельно.
Одна end-to-end-модель не даёт нам нужного сочетания качества, надёжности, производительности и управляемости.
End-to-end удобна для небольших объёмов и сканов документов. Для небольшого проекта одна модель часто проще и быстрее во внедрении.
Большая модель — дополнительный слой, а не замена пайплайна. По сути, у нас гибрид: пайплайн обрабатывает весь поток, а VLM используется для оценки и валидации качества. Заменить ею весь пайплайн в нашем случае не получается.
А как распознаёте текст вы? Пробовали заменить пайплайн одной моделью или, наоборот, вернулись к связке моделей? Делитесь опытом в комментариях — с радостью обсудим.
Больше про машинное обучение — в telegram-канале RWB делает ML. Подписывайтесь!


