Ведущие программисты холдинга на 10 000+ человек дежурили на первой линии поддержки, то есть самые дорогие сотрудники ИТ-службы работали диспетчерами. О таком публично говорят редко, а цифры и результаты внедрения ITSM, вскрывая все болячки, рассказывают еще реже. Мне попались на глаза два доклада, где об этом рассказали честно и с цифрами. В статье разберу, как проходили проекты внедрения Service Desk, что компании изменили в процессах, ролях и договоренностях с бизнесом и какой результат получили.
С чего начинали
Обе истории внедрения прозвучали на Бизнес-форуме 1С:ERP 2025. Компании я называть не буду. Кому интересно, кто главные герои, тот найдет в конце статьи записи докладов, там звучат реальные названия и имена. Моя задача не прорекламировать компании, а на их примерах показать, чего можно добиться, если правильно внедрить практики управления ИТ.
Обе компании крупные, и производство у них не останавливается. Первая, холдинг на 10 000+ человек, выпускает продукцию круглые сутки. Вторая, агрохолдинг, работает в четырех регионах и сама ведет всю цепочку от поля до прилавка. ИТ-поддержка к началу проектов за таким бизнесом не успевала.
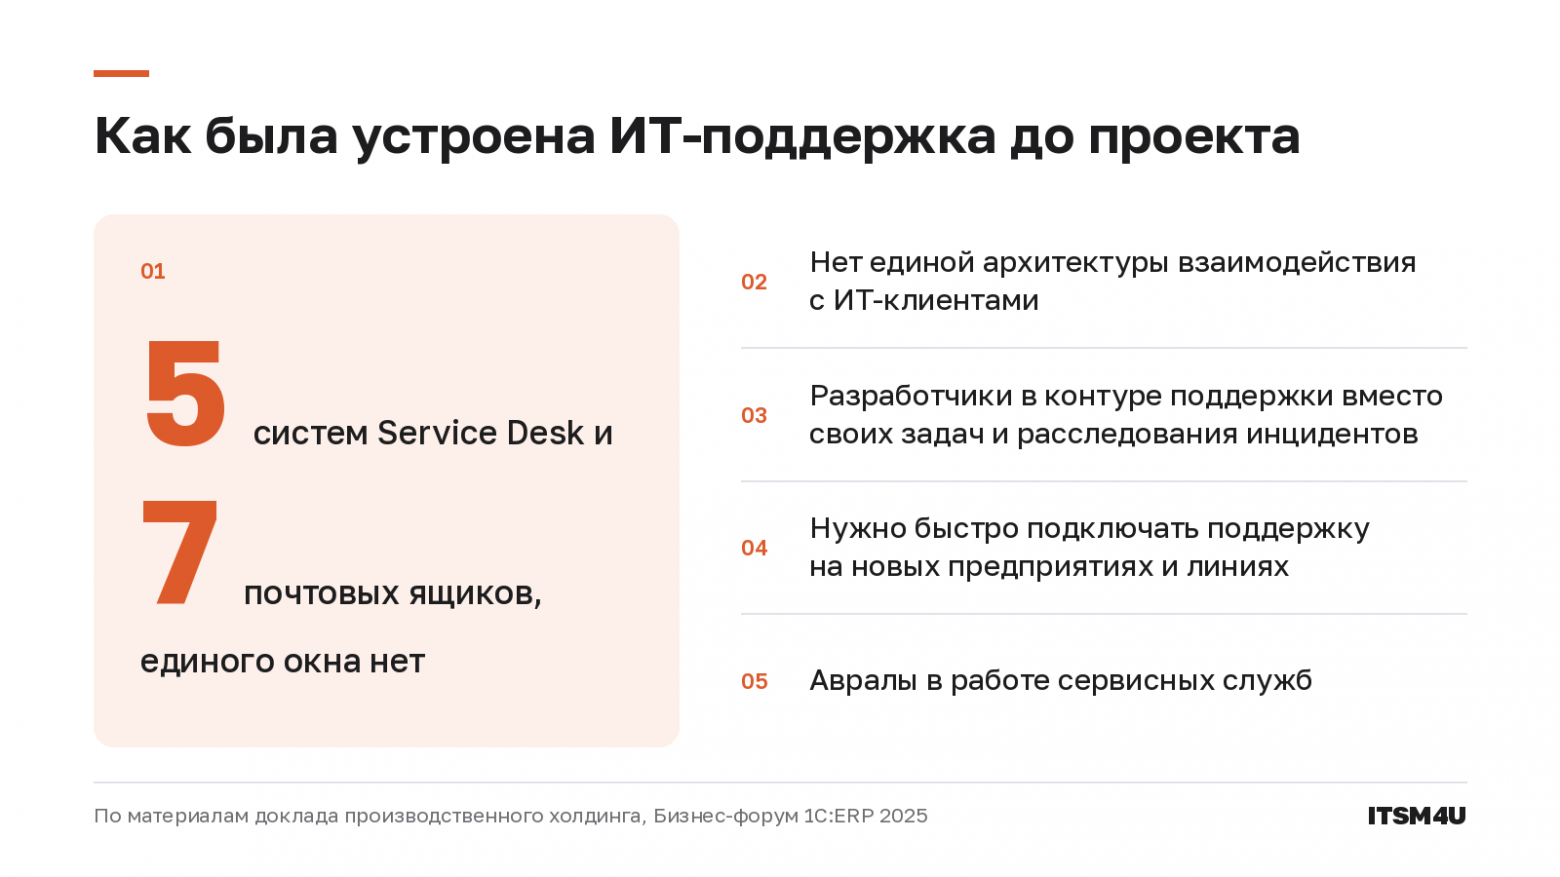
Производственный холдинг. У холдинга 15 площадок в Москве и области, Твери и Петербурге, 10 000+ сотрудников, из них около 2500 активных пользователей ИТ, 1700+ т продукции в сутки, 31 000 торговых точек, выручка 7+ млрд ₽ в месяц. Первый час простоя систем может обойтись холдингу примерно в 7 млн ₽. Дальше потери растут не по часам, а скачком. Если простой продлится два часа, сорвется график отгрузок, и убытки могут дойти до 250 млн ₽, причем без учета штрафов за сорванные поставки. Единого окна для обращений не было. Заявки шли через 5 систем Service Desk и 7 почтовых ящиков, ведущие программисты и архитекторы по очереди дежурили на первой линии, а сервисные службы жили в авралах.
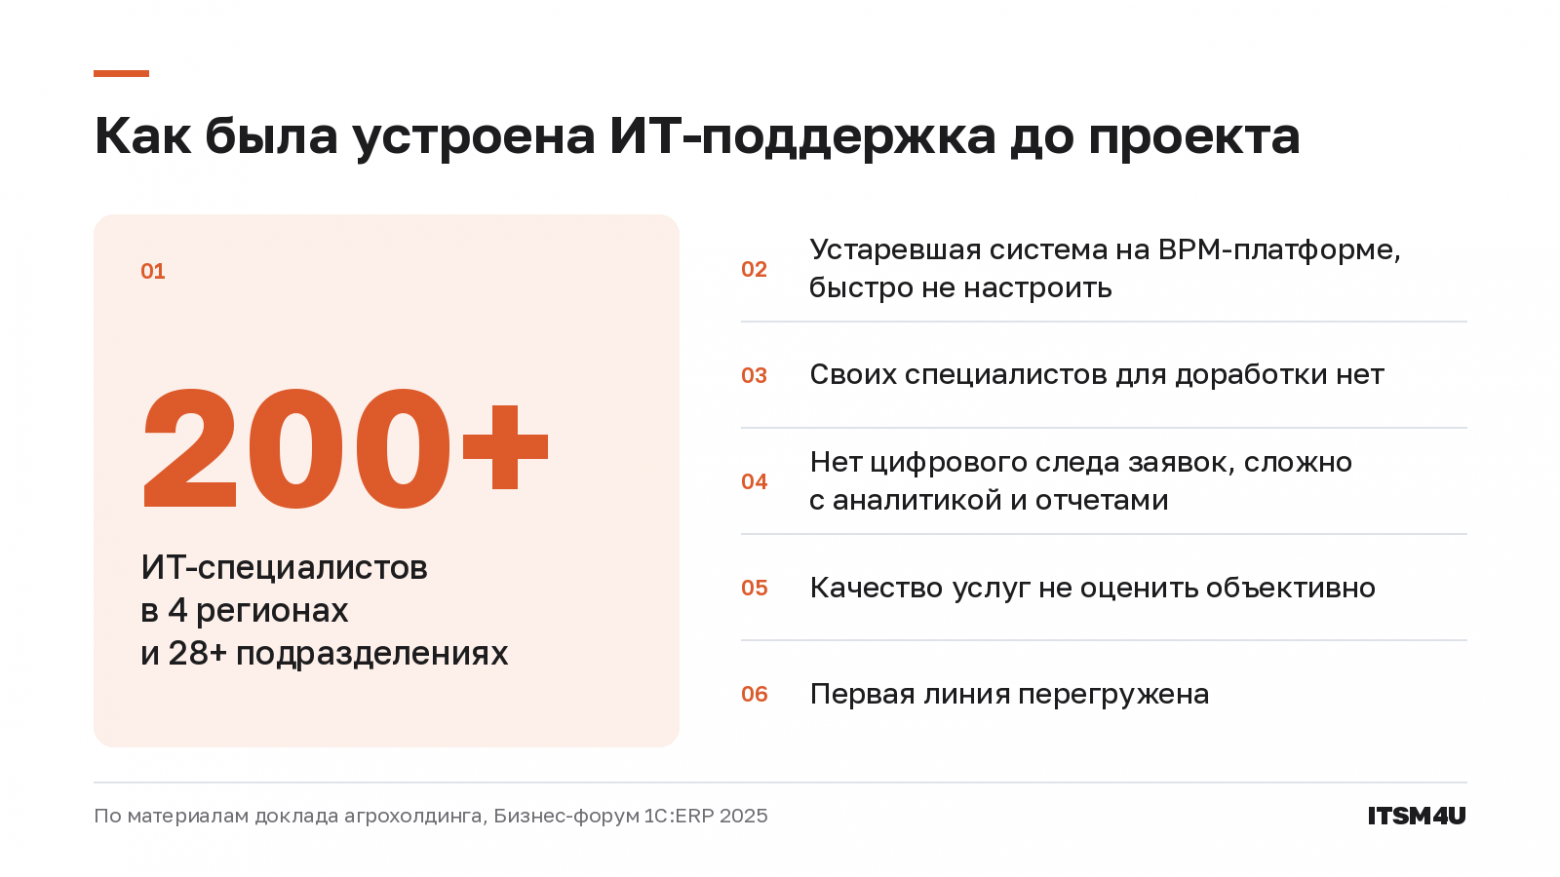
Агрохолдинг. В агрохолдинге около 13 000 сотрудников в четырех регионах, 4 птицефабрики, 6 молочных производств, 4 свинокомплекса и 2 мясокомбината. ИТ ведет собственная ИТ-компания агрохолдинга. Ее служба из 200+ специалистов и 28+ подразделений жила на устаревшей системе на BPM-платформе, которую нельзя было быстро настроить, а своих людей для доработки не было. Сами ИТ-шники говорили, что были «как сапожник без сапог».
Ниже привожу семь выводов, и каждый раскладываю на три слоя: что сделали в кейсе, что говорят лучшие практики ITSM и что взять себе.
Сначала единое окно и каталог, потом все остальное
Что сделали. В производственном холдинге обращения шли через 5 систем Service Desk и 7 почтовых ящиков. В первую волну взяли управление обращениями как единую точку входа и каталог услуг, чтобы пользователь понимал, куда обращаться и как сформулировать запрос. Управление ИТ-активами и инфраструктурой оставили на следующий этап.
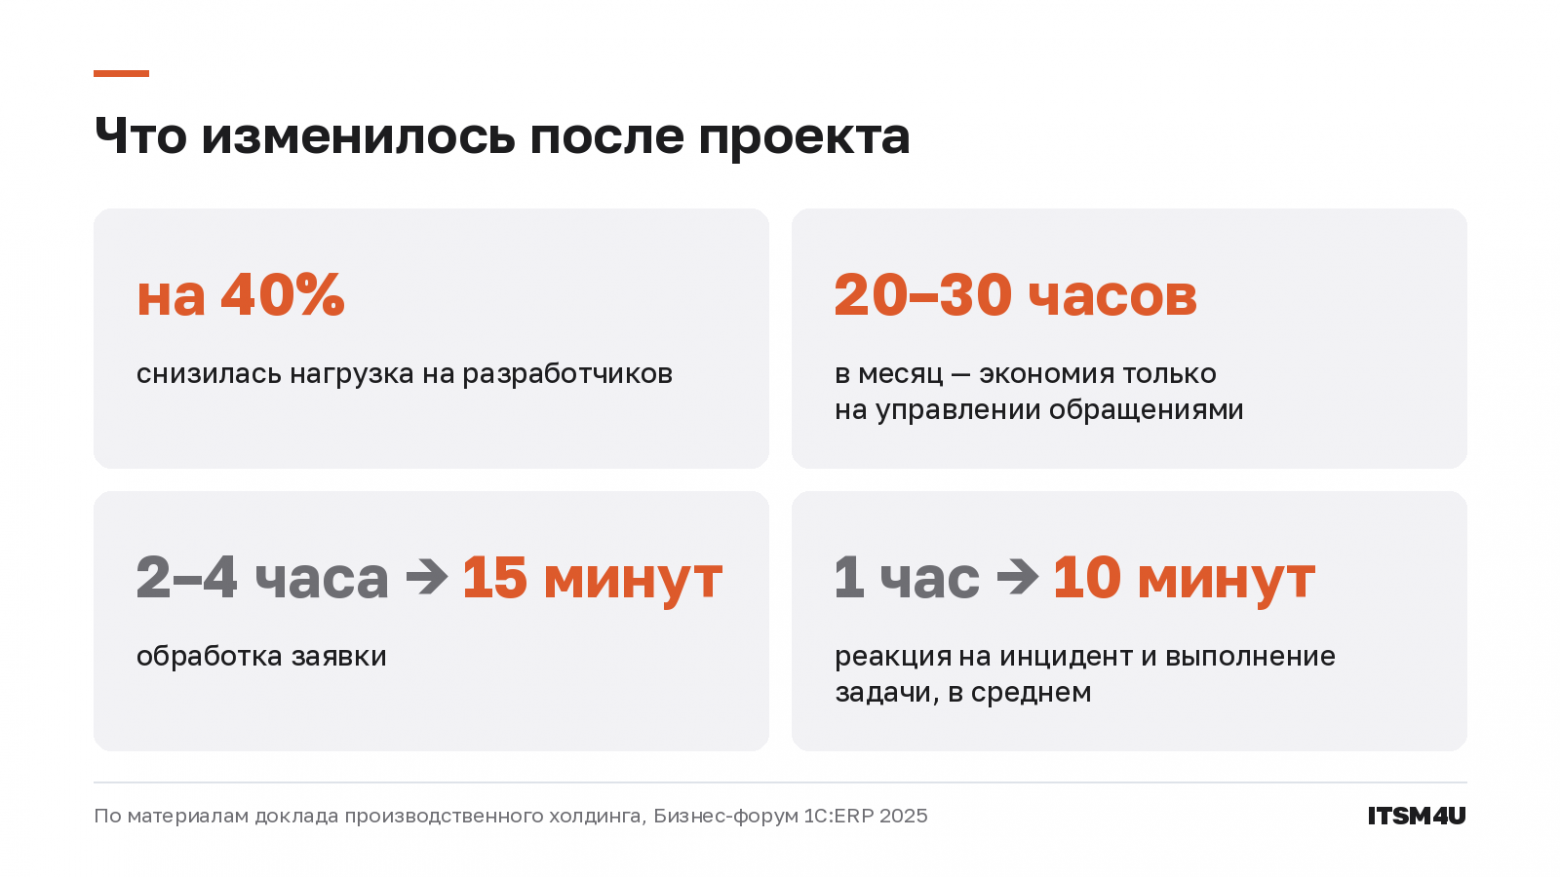
Лишь на управлении обращениями холдинг экономил 20–30 часов в месяц. В докладе прозвучали и другие цифры. Только у руководителей время на выяснение, где заявка и что с ней происходит, сократилось минимум на 30 часов в месяц, а если считать сотрудников всех уровней, набирается больше сотни часов. В холдинге считают, что уже за счет этой экономии система окупилась за полгода эксплуатации.
В агрохолдинге каталог услуг и управление обращениями настроили за месяц. Единое окно здесь началось не с портала. На момент доклада 55% обращений приходили по электронной почте, 44% по телефону и 1% лично, а веб-портал там еще только внедряли вместе с вендором. Мне показалось важным, что единому окну не обязательно быть порталом с первого дня.
Что говорят лучшие практики ITSM. Руководство ITIL по управлению каталогом услуг (Service Catalogue Management) видит в каталоге единый источник согласованной информации обо всех услугах. Пользователь работает с каталогом запросов, своим представлением каталога, а исполнение запросов ведет практика управления запросами на обслуживание (Service Request Management). Руководство предупреждает, что изолированные каталоги в разных системах увеличивают хаос, и пять Service Desk в холдинге, по-моему, выглядят ровно так.
Минимум данных об услуге включает название, описание, статус, владельца и целевую аудиторию. Ошибку в пользовательском каталоге обрабатывают как инцидент, а полноту меряют числом услуг, которые оказывают, но в каталог не внесли. Простой каталог лучше, чем подробный, но неактуальный.
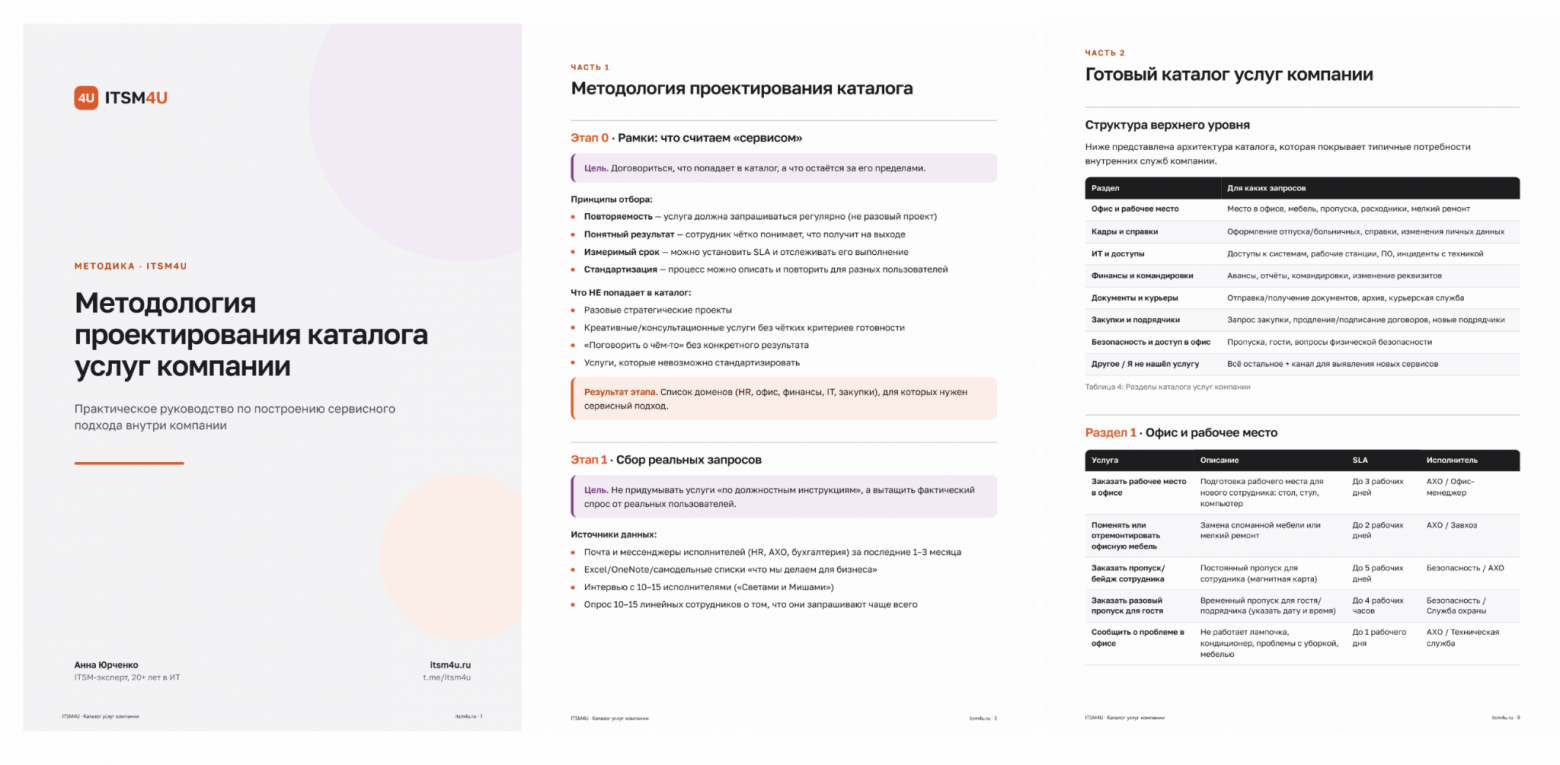
Что взять себе. Я бы начала с инвентаризации всех точек входа, включая личные почтовые ящики и мессенджеры инженеров. Затем выгрузила бы обращения за два-три месяца и собрала из 20 самых частых типов обращений первый каталог запросов с теми пятью полями. Через месяц стоит проверить, какая доля обращений не легла ни в одну услугу.
В свое время я проектировала методику каталога услуг для бэк-офиса и готова ею поделиться. В ней пошаговый подход от сбора реальных запросов до пилота, готовый шаблон каталога на 40+ услуг, примеры карточек с SLA и чек-листы. Скачать методику проектирования каталога услуг.
Разработчик на первой линии — самый дорогой диспетчер
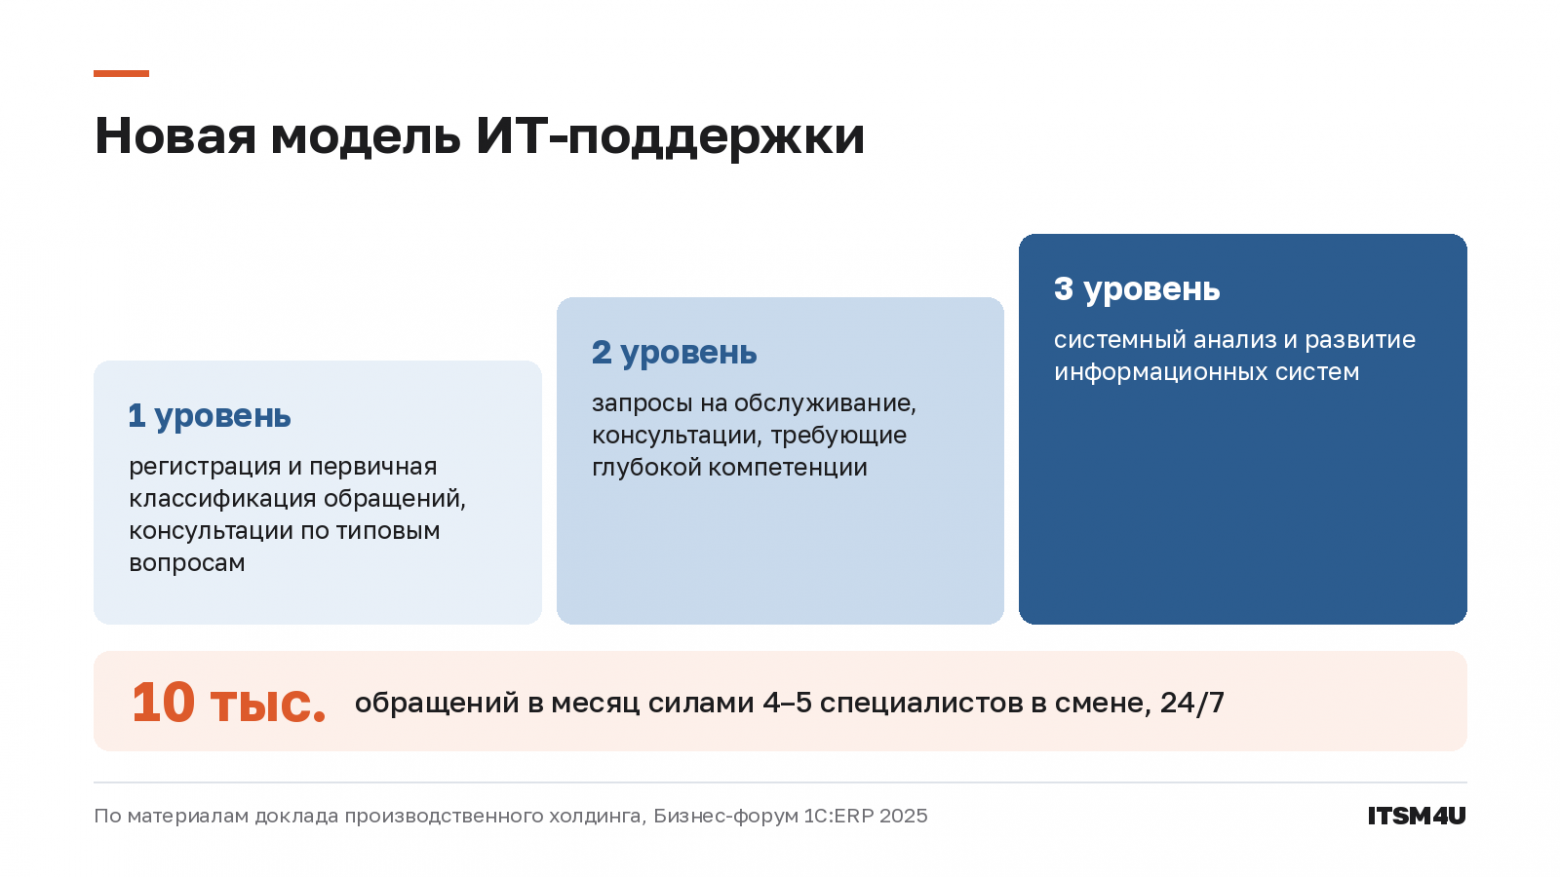
Что сделали. Дежурства ведущих программистов и архитекторов производственного холдинга на первой линии оборачивались большими расходами, отгулами, недоступностью людей, перекрытием подрядчиками и выгоранием. Холдинг перешел к трем уровням поддержки. Первый регистрирует и классифицирует обращения, а еще консультирует по типовым вопросам. Второй выполняет запросы на обслуживание и ведет сложные консультации, третий занимается системным анализом и развитием систем.
В новой модели до 10 000 обращений в месяц круглосуточно обрабатывают 4–5 специалистов в смене. Первую и вторую линию там сформировали на сэкономленные деньги. Нагрузка на разработчиков снизилась на 40%, и в холдинге прикинули, что это более 800 часов.
В агрохолдинге та же логика. Первая линия работает единой техподдержкой 24/7, а разработчики, свои и внешние, подключаются только на третьей. Раз внешние подрядчики сидят внутри линий, правила для них нужны общие со своими, об этом раздел про SLA.
Что говорят лучшие практики ITSM. Согласно руководству ITIL по службе поддержки (Service Desk), иерархия линий экономит дорогие ресурсы, потому что запрос решается на самом низком возможном уровне. Классическую модель линий ITIL сохраняет, но допускает и плоскую команду, которая работает роем (swarming). Слабое место роя в масштабируемости. При 10 000 обращений в месяц обязательно выделение линий поддержки.
Если контакт службы трудно найти, пользователи идут к специалистам напрямую. А опытный инженер на первой линии быстро помогает, но теряет мотивацию от рутины, у него не остается времени заниматься устранением корневых причин. Такие перекосы видны по классическим метрикам:
Доля обращений, решенных при первом контакте (FCR, first contact resolution). Падение не всегда плохо, иногда управление проблемами просто убрало легкие повторяющиеся обращения.
Среднее время эскалации. Рост значит, что люди не понимают, кому передавать обращение.
Стоимость обращения, то есть затраты на службу, деленные на число обращений. Точнее считать по типам обращений.
Что взять себе. В течение месяца ведите журнал работ и фиксируйте время, которое разработчики и архитекторы тратят на обращения, потом умножьте на ставку. Получится готовый расчет для разговора о бюджете первой линии. Потом введите расчет FCR и времени эскалации и следите за динамикой.
Цена часа простоя задает скорость реакции
Что сделали. Для производственного холдинга простой измеряется в деньгах, час простоя оценивают примерно в 7 млн ₽, и эта цифра объясняет, почему скорость реакции здесь не вопрос отчета. Время реакции на инциденты и выполнения задач в среднем сократилось с часа до 10 минут. В холдинге это объясняют исключением дублей, единым информационным полем и тем, что первую и вторую линии выделили в отдельные функции.
Про главные результаты докладчик из холдинга начал с шутки: «Наверное, самый главный результат — это нас до сих пор не уволили». А если серьезно, среди главных результатов в холдинге называют системное решение инцидентов и анализ их причин, а базой для анализа стало управление конфигурациями.
Что говорят лучшие практики ITSM. Приоритет инцидента в ITIL считают как влияние × срочность, и число затронутых пользователей не единственный критерий. На производстве 24/7 остановленная линия выпуска весит больше сотни мелких сбоев в офисе, поэтому стоимость простоя законно входит в оценку влияния. Скорость реакции ITIL предлагает отслеживать такими метриками:
Время от возникновения инцидента до обнаружения и от обнаружения до взятия в работу.
Число переназначений и доля ожидания в общем времени.
Доля инцидентов, решенных раньше, чем о них сообщили пользователи.
Если цена инцидента считается в деньгах, отчет должен быть честным, но его могут «испортить» следующие моменты:
Категория «прочее» собирает большинство записей и съедает аналитику.
Статус ожидания останавливает отсчет SLA, и в нем соблазнительно прятать просроченные инциденты.
Переоткрытие растягивает срок: закрытый за день и переоткрытый через неделю на два дня инцидент.
Что взять себе. Вместе с финансистом посчитать стоимость часа простоя для трех-пяти ключевых систем и вписать ее в матрицу влияния. Тогда приоритет перестает быть спором о том, кто громче звонит.
SLA как правила игры, в том числе для подрядчиков
Что сделали. В список главных результатов производственного холдинга вошли и единые правила для подрядчиков за счет SLA. Контур проекта при этом вышел за пределы ИТ: в него включили административно-хозяйственный отдел, службу главных инженеров и бухгалтерию, а в перспективе стояли АСУ ТП и все направления, где есть уровень обслуживания.
В агрохолдинге за месяц настроили все необходимые SLA, но сколько их и с какими целями, мне неизвестно. До проекта качество услуг там нельзя было оценить объективно, а значит, нельзя было и ответить, исполняет ли ИТ обязательства перед заказчиками.
Что говорят лучшие практики ITSM. Управление уровнем услуг (Service Level Management) в ITIL нужно, чтобы задать ясные бизнес-ориентированные цели и отслеживать услуги по ним. Главный риск называется «эффектом арбуза». Снаружи метрики зеленые, внутри восприятие пользователя красное, поэтому метрики сочетают с опросами и обзорами услуг. Gartner в руководстве по SLA писал, что SLA проваливаются, когда их строят на том, что легко измерить, а не на том, что нужно, и, по моему опыту, эта ошибка встречается до сих пор.
Отсюда советы держать метрик минимум, однозначно определять формулы и даже «рабочий день», задавать цель коридором с минимальным уровнем.
Что взять себе. Для каждого подрядчика я бы завела одну страницу с метрикой, формулой, источником данных, интервалом и последствиями выхода за коридор. Раз в квартал рядом с отчетом по SLA коротко опрашивать пользователей.
KPI с первого дня, иначе разговор с бизнесом идет на ощущениях
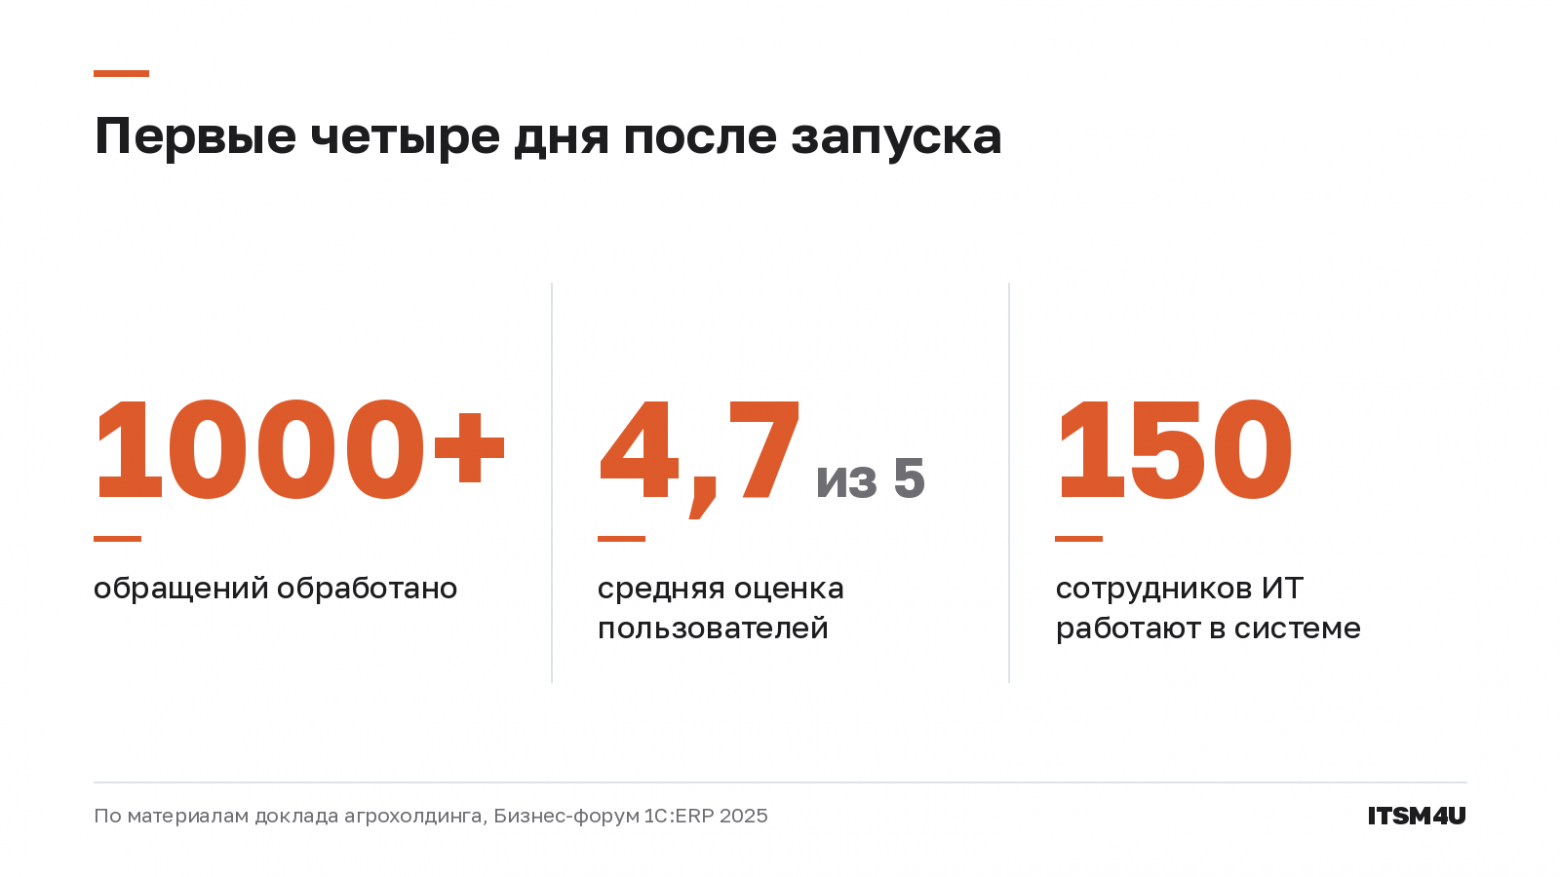
Что сделали. В агрохолдинге данные считают главным аргументом, а KPI советую ставить на старте, чтобы говорить с бизнесом. Лидеров ИТ-функций там учат работать с данными и цифрами, а не с ощущениями. За первые четыре дня обработали 1000+ обращений, средняя оценка пользователей составила 4,7 из 5. В системе работали 150 сотрудников разных подразделений, и, как я поняла, это ИТ-специалисты, которые оказывают услуги, а не все пользователи компании.
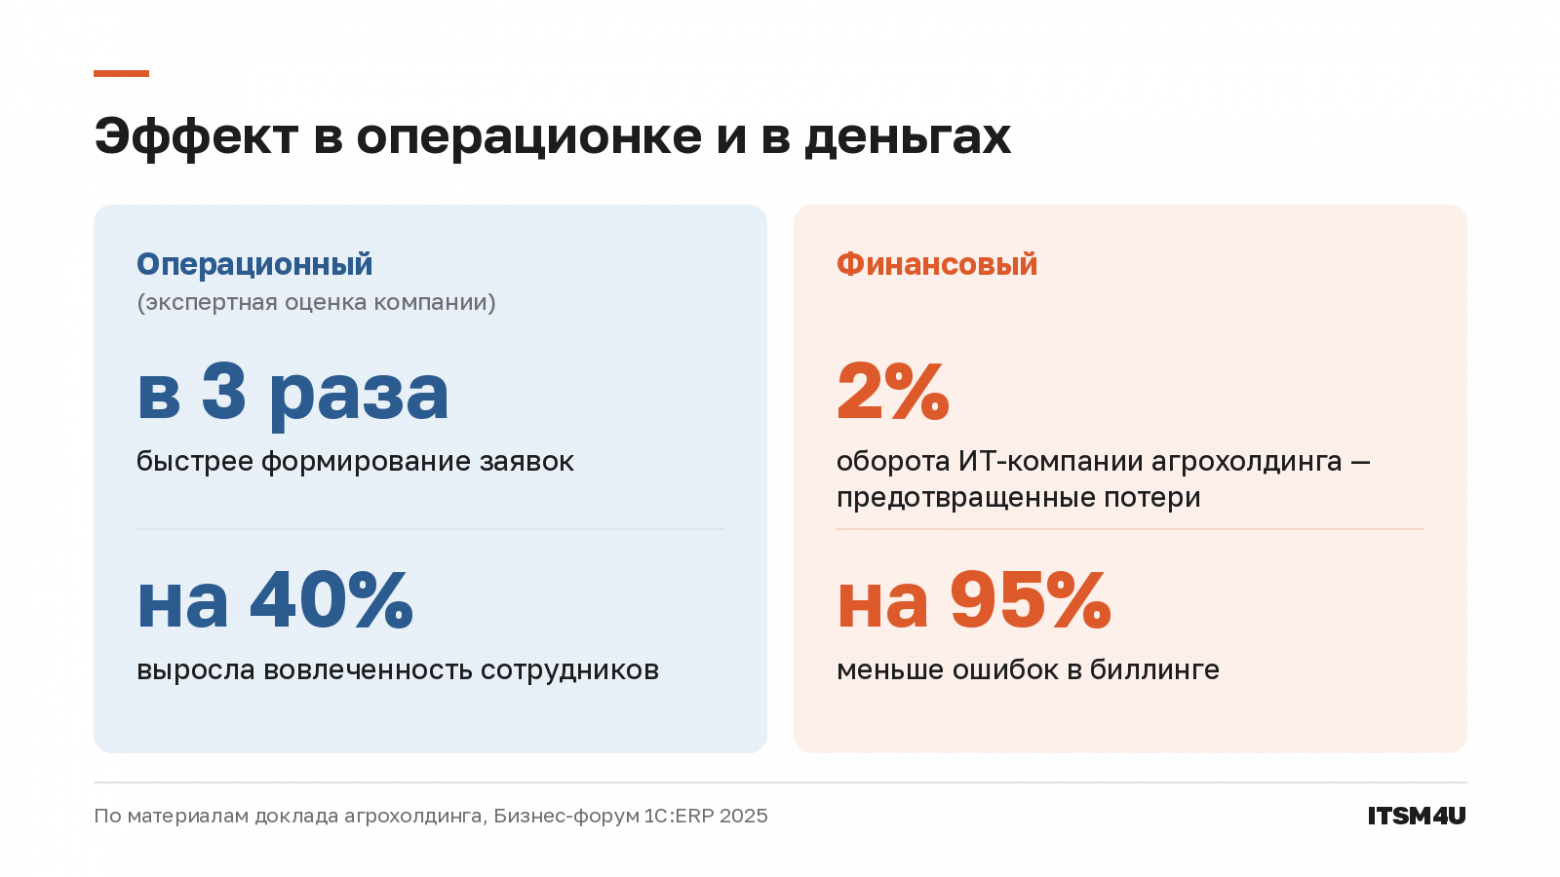
Эффекты в агрохолдинге по экспертной оценке: время формирования заявок сократилось в три раза, вовлеченность персонала выросла на 40%. Предотвращенные потери составили 2% оборота ИТ-компании агрохолдинга (а не всего агрохолдинга), ошибок в биллинге стало на 95% меньше.
Что говорят лучшие практики ITSM. Брукс в «Метриках для управления ИТ-услугами» требует запускать процессные метрики одновременно с процессом, иначе люди продолжают делать все как раньше. По-моему, это главная причина, почему купленная система часто ничего не меняет. Идеального набора не бывает, а точку отсчета (benchmark) получают замерами за два-три периода.
Лучшие практики рекомендуют, чтобы метрик было мало. Обновлять метрику стоит так же часто, как по ней принимают решения.
Среди ошибок источники называют личные KPI на сокращение числа звонков (они бьют по удовлетворенности и даже по времени решения, если проблему не решили по-настоящему) и метрики для поиска виновных, которые команда отвергает. У Брукса в книге приведен случай из британского здравоохранения. Списки ожидания на операции сократили, а пациенты ждали столько же, потому что появился неофициальный список ожидания до входа в основной. Для каждого KPI ITIL Practitioner спрашивает, какое хорошее и какое плохое поведение он поощрит.
Что взять себе. На первый месяц я бы взяла шесть метрик.
Поток обращений по каналам.
Доля обращений, решенных в срок, по приоритетам.
Время восстановления (Time to restore, аналог MTTR, mean time to restore, то есть среднего времени восстановления) для критичных услуг.
FCR.
Оценка пользователя после закрытия обращения.
Число переназначений.
Два-три месяца набор не менять, это и будет точка отсчета.
Быстро получается на типовой коробке и с тем, кто знает продукт
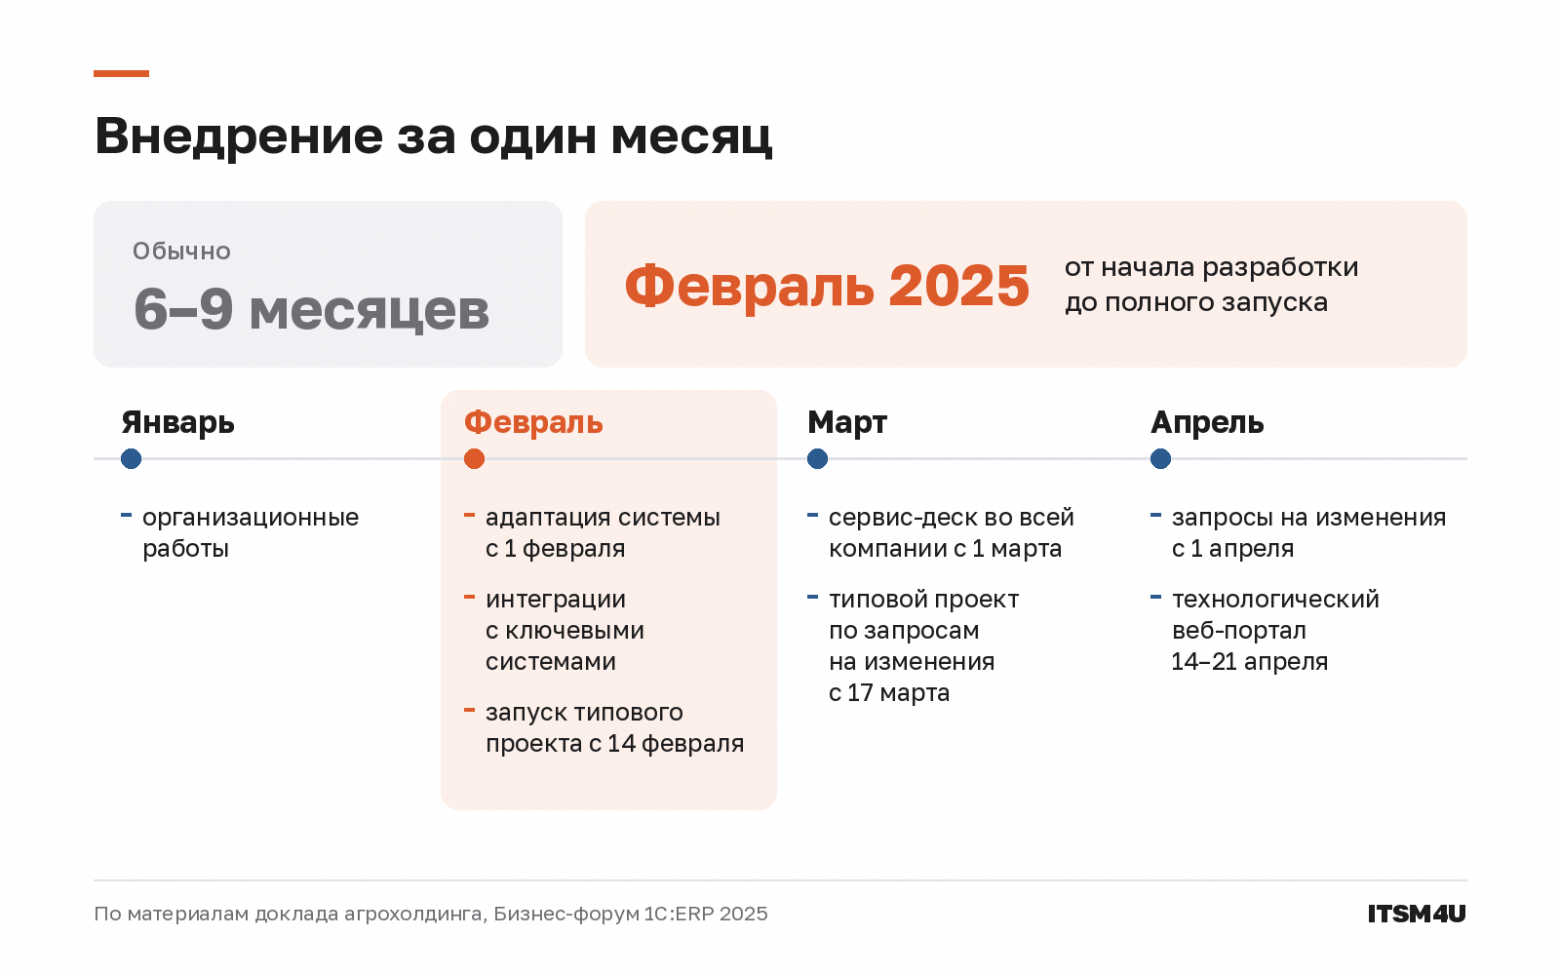
Что сделали. В агрохолдинге выбирали систему около года по пяти критериям, среди них быстрая настройка, свои специалисты, соответствие ITIL и интеграция с существующими системами. Думаю, этот год не потеря времени. Команда глубоко изучала и сравнивала продукты и только потом пошла во внедрение. Само внедрение заняло месяц против обычных, по оценке самой компании, 6–9 месяцев, а еще месяц ушел на организационные работы. На третий месяц проекта поддержка уже работала во всей компании, а еще через месяц запустили запросы на изменения (ЗНИ).
За месяц взяли типовую коробку и подогнали ее под свои процессы, а прочие доработки отложили. Помогло и то, что на стороне заказчика создали собственный центр компетенций со своим архитектором.
Производственный холдинг внедрил систему примерно за два месяца и советует брать у вендора экспертизу, методологию и авторский надзор, потому что многие задачи решаются методологией, а не доработками, и это время, сэкономленное на костылях. По-моему, это та же роль, что у архитектора агрохолдинга, только снаружи. Кто-то должен знать продукт настолько, чтобы сказать «это решаем методологией, а не доработкой».
Что говорят лучшие практики ITSM. Сначала цели, потребители информации и функциональность, затем структура и только в конце выбор средства реализации. Также важно вовремя остановиться, потому что полезный результат за разумные деньги приходит гораздо раньше совершенства. В ITIL это руководящий принцип «продвигайтесь итеративно с обратной связью» (Progress iteratively with feedback).
Что взять себе. До выбора системы выписать интеграции, без которых не прожить первый месяц. Поставить в проект своего архитектора с правом сказать «это решаем регламентом, а не кодом». Договориться, что доработки начинаются после месяца работы на типовой конфигурации.
80% успеха — не софт
Что сделали. В агрохолдинге уверены, что успех ИТ-проекта на 80% зависит от единомышленников, а не от софта. Инициатива там шла от лидеров ИТ-функций, а не сверху, и агрохолдинг советует вовлекать союзников в бизнесе. Из истории производственного холдинга я бы подсветила три мысли, которые прозвучали: в ходе внедрения важно делать ретроспективу проекта, проводить еженедельные встречи по обратной связи бизнеса и вовлекать руководителей подразделений.
Методология вендора помогла ускорить проект, но не заменила перемен в самой компании, главный двигатель здесь культура.
«Изменения, они в первую очередь не есть результат внедрения какой-то методологии или программного продукта. В первую очередь это смена парадигмы, это смена культуры, это смена подходов»
— Владимир Д., директор управления программных разработок производственного холдинга
Что говорят лучшие практики ITSM. В ITIL это практика постоянного улучшения (Continual Improvement), а ретроспектива — ее рабочая форма. Руководство по инцидентам требует, чтобы команда, которая разбирает сбой, не боялась наказания, если ее идея не сработала. Для ретроспективы проекта правило то же. Методика CERT (Университет Карнеги-Меллон) для команд реагирования на инциденты безопасности предлагает показатель, который подходит для любой ретроспективы: долю внедренных рекомендаций по итогам разборов.
Что взять себе. Раз в месяц ретроспектива с вопросом «что не работает у нас» и счетчиком внедренных решений. Раз в неделю короткая встреча с руководителями подразделений. Союзников я бы искала среди тех, кто сам страдает от авралов.
Конфигурации и активы как следующий шаг
Следующим шагом оба проекта выбрали одну зону, конфигурации и активы. В производственном холдинге управление конфигурациями уже работало, а управление ИТ-активами и инфраструктурой еще внедряли. В агрохолдинге в планах до конца 2025 года стояли база данных конфигураций (CMDB) и запросы на изменения (первую версию запустили в апреле), а рядом веб-портал и мобильное приложение.
ITIL делит эту зону на управление конфигурациями услуг (Service Configuration Management) и управление ИТ-активами (IT Asset Management). Сервер в CMDB живет как узел со связями, а в реестре активов как деньги и контракт.
Практики дают пять советов.
Начинать с решений, которые будут приниматься на основе данных, и каждое расширение CMDB проверять вопросом, сколько стоит поддерживать эти данные.
Пилотировать узко, например на одной площадке и одном классе компонентов.
Наполнять CMDB автоматически и обновлять через процесс изменений.
Сверять реестр активов с бухгалтерией.
Не строить CMDB ради CMDB и не стартовать с грязных данных, потому что «нет более верного пути к провалу, чем путь, начинающийся с неверных данных».
Что получилось в итоге
Если свести обе истории в одну картинку, она выглядит так.
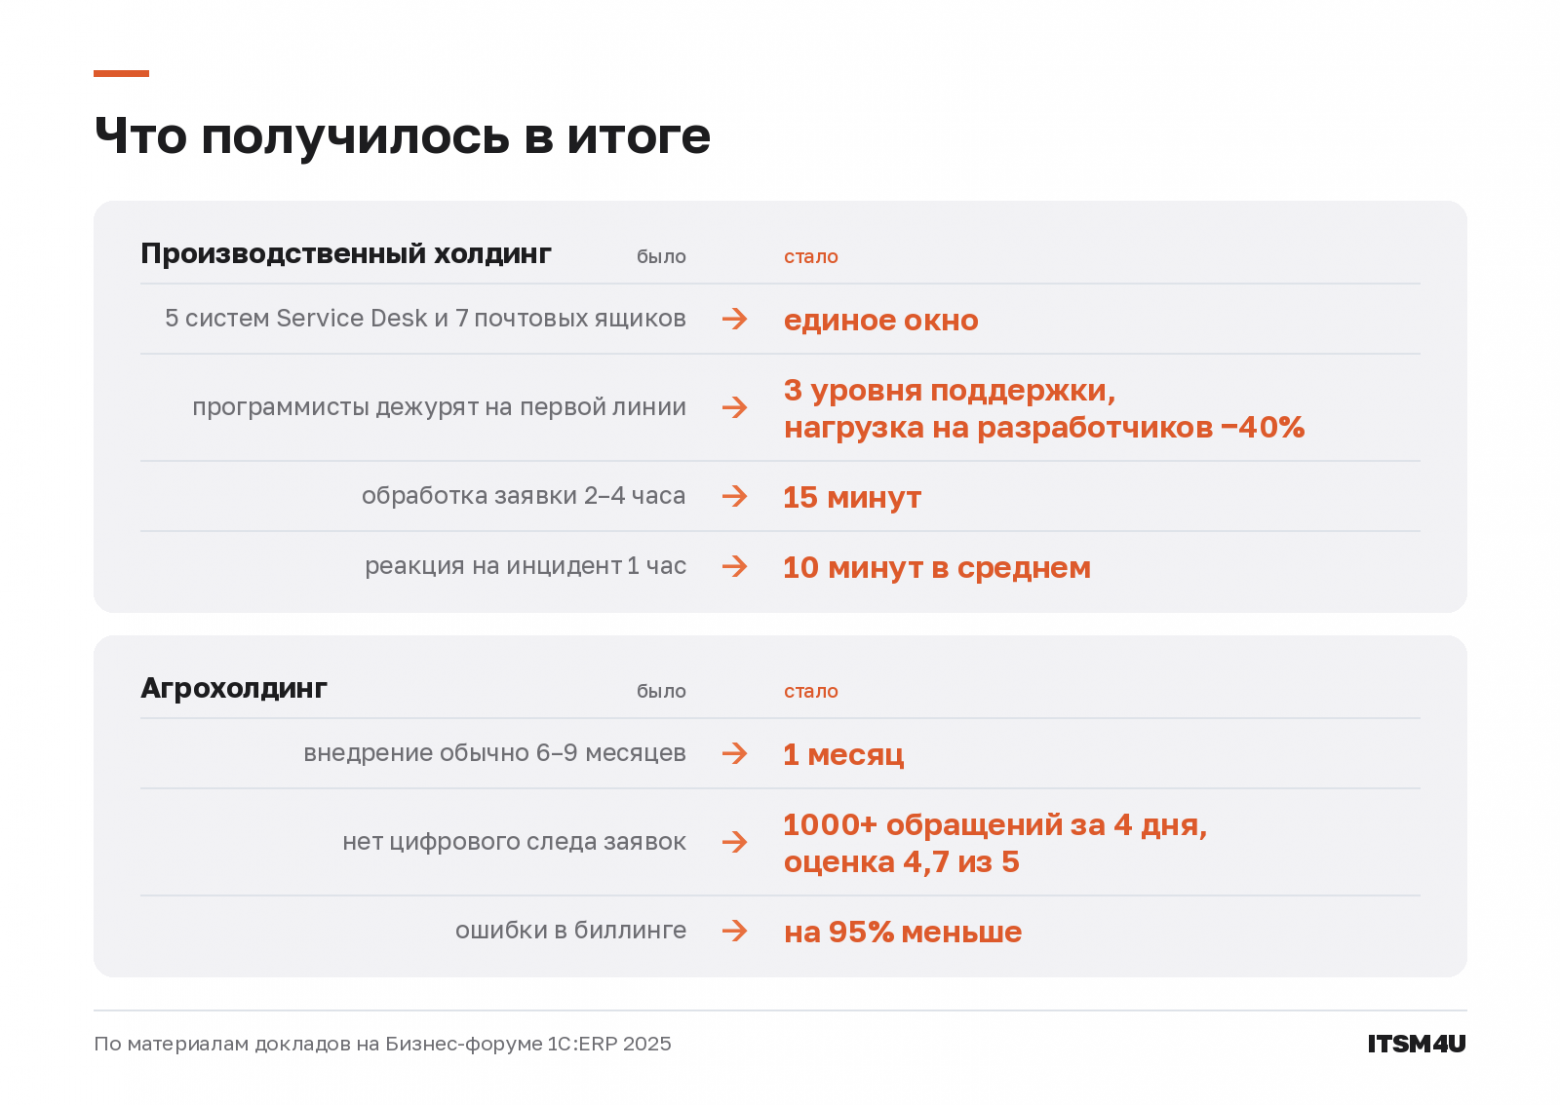
Это по-настоящему сильные результаты. Запустить новую поддержку за один-два месяца, не останавливая производство, и сразу получить цифры, которые не стыдно показать на большом форуме, дорогого стоит. И заслуга здесь не одного героя, а команды. Это руководители, которые смогли договориться между собой и с бизнесом, специалисты, которые приняли новые правила работы, и вендор, который в холдинге вел авторский надзор.
Чек-лист, с чего начать у себя
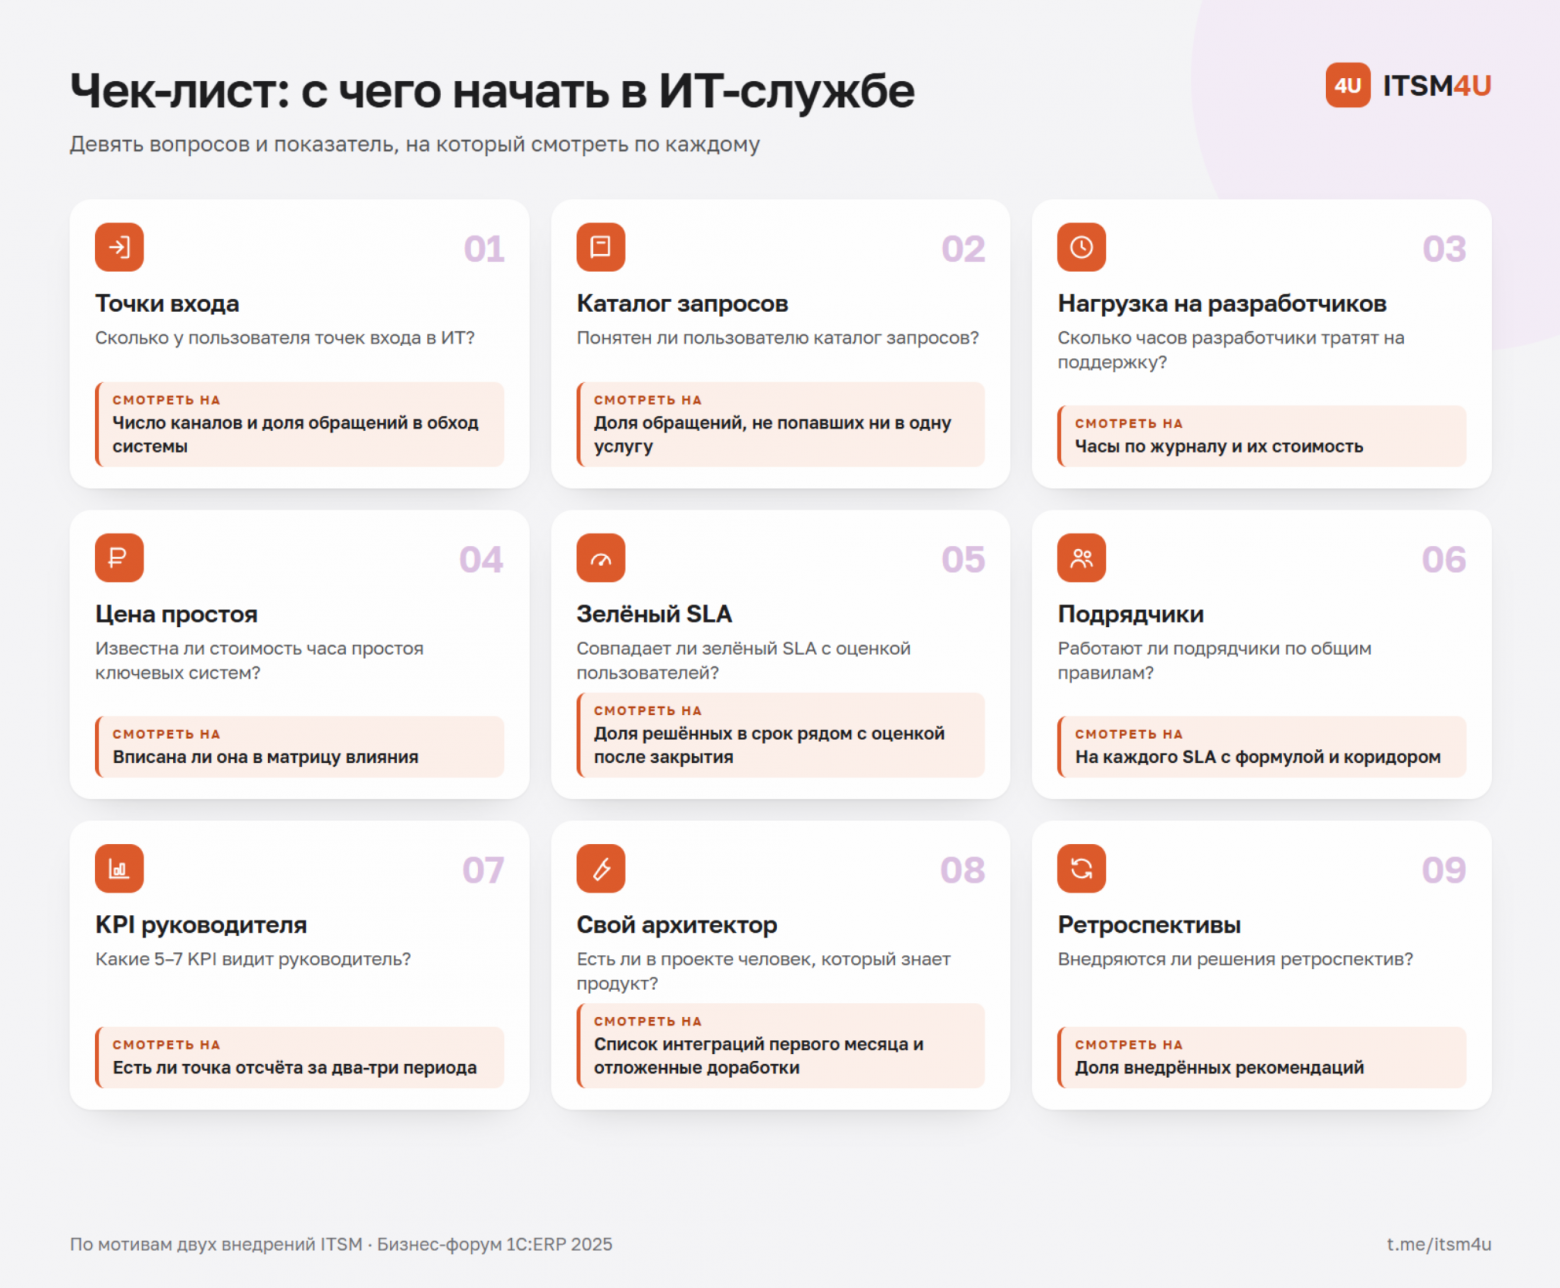
Девять вопросов к своей ИТ-службе, и к каждому указано, на какой показатель смотреть.
Материал бережно подготовлен:
Анна Юрченко, ITSM-эксперт, 20+ лет в ИТ
В Telegram-канале ITSM4U: Управление без иллюзий делюсь практиками управления ИТ, раскрываю темы, которые волнуют ИТ-руководителей, нахожу кейсы и разбираю инструменты и подходы, которые делают ИТ драйвером бизнеса. Пишу про личный бренд в digital.
Мне повезло участвовать в создании и развитии служб сервис деск в крупных операторах связи, системных интеграторах и банках, и я готова делится опытом, всегда мне можете написать @itsm_lady и я с удовольствием расскажу.
Где ИТ-руководителю можно обсудить эти темы
Если хочется сверить свою практику с чужой, в ближайшие недели похожие вопросы разбирают на нескольких эфирах и вебинарах.
20 ноября. В эфире «ИИ в ОЦО: фундамент или лоскутное внедрение» SimpleOne и клуб общих центров обслуживания обсуждают, как встраивать ИИ в сервисные процессы целиком, а не точечно.
2 декабря. На вебинаре «Управление активами с SimpleOne: от эксплуатации к стратегии» SimpleOne и ITGLOBAL.COM разбирают учет ИТ-активов и планирование бюджета ИТ. Это продолжение темы CMDB и активов из раздела о конфигурациях.
15 декабря. На вебинаре Деснол «Как выжать из ITSM-системы максимум» на опыте «КВАЗАР» и «585 Золотой» разбирают, что делать, если ITSM-система есть, но ее возможностей мало или ими не пользуются.
Как участник клуба ИТ-директоров «я-ИТ-ы» не могу не рассказать, что в декабре планируется встреча ИТ-руководителей, где можно обсудить эти и многие другие вопросы вживую. Присоединяйтесь, пока не поздно, к «Цифровой разморозке» 4–6 декабря.
Что полезно знать после внедрения
Внедрение и сопровождение обычно делают разные команды. Систему помогает внедрять вендор, а дальше кто-то должен годами держать в рабочем состоянии инфраструктуру и сам Service Desk. Как раз этим занимаются мои коллеги из ALP ITSM и делятся своим опытом на Хабр. Если вы сейчас выбираете такого подрядчика, у них есть разбор «Как проверить ИТ-аутсорсера перед подписанием договора» с вопросами, которые стоит задать ему заранее.
Источники
Истории внедрения прозвучали на Бизнес-форуме 1С:ERP 2025, все цифры кейсов взяты из записей докладов БКХ «Коломенский» и агрохолдинга «КОМОС ГРУПП».
Книги и руководства, на которые я опиралась в разделах о лучших практиках:
AXELOS. Руководства по практикам ITIL: Service Catalogue Management, Service Desk, Incident Management, Service Level Management, Measurement and Reporting.
Питер Брукс. «Метрики для управления ИТ-услугами».
Gartner. A Guide to Successful SLA Development and Management.