Когда тебя считают «главным по базам данных», вопросов от коллег всегда хватает. Но за последние восемь месяцев они заметно изменились. Однотипные вопросы исчезли, никто больше не спрашивает, как обойтись без хранения данных в базе, а код, который мне приносят на ревью, стал заметно аккуратнее.
А потом этим летом мне попалась схема БД, в которой предлагалось удалить сразу двенадцать индексов одной таблицы. Тогда я и начал подозревать, что ИИ‑агенты для программирования создают слишком много индексов. Следующая схема только укрепила мои подозрения.
Проще всего было бы списать всё на ИИ‑халтуру (или слоп). Но большинство этих изменений выглядели вполне грамотно. Поэтому я собрал тестовую обвязку (harness) и решил всё измерить.
Я загрузил в PostgreSQL 30 схем БД, сгенерированных моделями, и проверил 838 индексов в двенадцати из них. Результаты меня удивили. Лишь для десяти индексов я не смог найти ни одного требования, которое оправдывало бы их существование. Остальные были спроектированы грамотно.
Все четыре модели уверенно работали с индексами GIN и GiST, создавали частичные индексы с разумными условиями отбора и правильно выбирали порядок столбцов в составных ключах для мультитенантных систем. В целом качество SQL, который генерируют агенты, стало заметно выше, чем год назад.
Цена ещё одного индекса
Индексы полезны, пока их не становится слишком много на одной таблице, в которую постоянно идут записи. На таблицах с небольшой нагрузкой разницы можно вообще не заметить. Но если таблица активно изменяется, каждый дополнительный индекс увеличивает затраты на операции записи.
В одной из схем для системы поддержки модель создала целых шестнадцать индексов на таблице tickets. Шесть из них включали столбец last_activity_at, который обновляется каждый раз, когда сотрудник поддержки работает с заявкой. По сравнению с моим базовым вариантом, написанным вручную и содержащим семь индексов, сгенерированная схема создавала в 1,8 раза больше записей в WAL, увеличивала время каждого обновления в 1,9 раза и примерно настолько же замедляла VACUUM.
При этом все шестнадцать индексов нельзя назвать бессмысленными. Запросы на чтение с ними выполняются быстро.
Проблема в другом: ИИ‑агенты создают индексы под каждый запрос по отдельности, не учитывая общую нагрузку на запись.
Вот что на самом деле происходит на диске при изменении такой строки:
Про HOT‑обновления (Heap‑Only Tuple) можно забыть. Если изменяемый столбец участвует хотя бы в одном индексе, механизм HOT уже не работает. PostgreSQL не может оставить новую версию строки в пределах исходной страницы данных размером 8 КБ, не обновляя ссылки в индексах.
В каждый индекс таблицы, условию
WHEREкоторого соответствует новая версия строки, приходится добавлять новую запись. И речь не только об индексе, включающем изменённый столбец.Каждая такая вставка в индекс создаёт дополнительные записи в WAL.
Очистка мёртвых версий строк тоже усложняется. Старая версия строки остаётся в табличной области данных (heap), пока её не удалит VACUUM. Но для очистки ссылок на неё VACUUM приходится обходить все вторичные индексы. Чем больше индексов, тем дольше длится очистка, даже если изменились всего три строки.
Мне так и не удалось отделить затраты на VACUUM от влияния объёма WAL: эти два фактора постоянно накладывались друг на друга. Поэтому приведённые ниже цифры по VACUUM стоит воспринимать как ориентир, показывающий общую тенденцию, а не как точную оценку влияния.
Как проводился эксперимент
Для проверки я придумал шесть вымышленных SaaS‑продуктов:
Сервис поддержки с общим ящиком для обращений
Система записи на занятия в фитнес‑клубах
Инструмент продуктовой аналитики
Приложение для маркетплейса
Система управления ветеринарной клиникой
Система управления грузоперевозками
Никаких заранее заданных названий таблиц, подсказок по столбцам или ограничений на структуру БД. Единственное условие — использовать PostgreSQL. О том, что кто‑то потом будет считать индексы, тоже ни слова.
Первые четыре спецификации я написал сам, лишь немного отредактировав их с помощью LLM.
Последние две составила независимая модель по моему краткому описанию задачи. Одна из шести спецификаций получилась менее подробной, чем остальные, и это заметно по результатам. Я решил оставить её как есть. Если бы я начал её дорабатывать, на повторный запуск неизбежно повлияло бы всё, что я уже узнал при анализе результатов.
Каждую спецификацию получали новые экземпляры моделей, без шаблонов схем БД и подсказок по индексам. Задача была простой: спроектировать схему PostgreSQL, написать SQL‑запросы и не задавать уточняющих вопросов.
Схемы создавали четыре модели от трёх разработчиков. Чтобы сосредоточиться на базах данных, а не устраивать соревнование моделей, я обозначил их как Model A, Model B, Model C и Model D. Названия и любые признаки, по которым можно было бы определить конкретную модель, я убрал.
В 26 из 30 запусков в конце промпта была дополнительная строка: make it production‑ready («сделай готовым к продакшену»). Именно так люди обычно и формулируют запросы к ИИ‑агентам для программирования, поэтому я решил её оставить. Позже я отдельно повторил запуски моделей B и D без этой строки, чтобы проверить её влияние.
Всего я провёл 30 запусков и загрузил полученные схемы в PostgreSQL 18.6. Все метрики собраны из pg_index и pg_stat_* на работающей базе данных. Схемы, спецификации, тестовые обвязки, исходные CSV‑файлы и файл с предварительно зарегистрированным планом эксперимента доступны на github.com/boringSQL/vibe‑coded‑indexes.
Индексы скапливаются на одной таблице
Средняя плотность индексов на сводном слайде выглядит вполне приемлемо. Но есть нюанс: важно, на каких именно таблицах они создаются. Каждый агент сосредотачивает индексы на одной таблице, в которую приходится больше всего операций записи. В системе поддержки это tickets, в фитнес‑приложении — class_occurrence, в системе грузоперевозок — loads.
Приложение | Таблица с наибольшим числом индексов | Создано индексов |
|---|---|---|
Система поддержки (7 запусков) |
| 10–16 |
Фитнес (3 запуска) |
| 6–10 |
Аналитика (3 запуска) |
| 5–8 |
Маркетплейс (7 запусков) |
| 8–11 |
Ветеринарная клиника (6 запусков) |
| 5–11 |
Грузоперевозки (4 запуска) |
| 7–15 |
Числа приблизительные: в паре запусков встречались частично пересекающиеся частичные индексы, и я не был до конца уверен, как правильно их учитывать.
Именно в этих таблицах каждое приложение хранит основные данные. Модели разбирают требования по отдельным функциям: под каждое условие фильтрации или сортировки создают очередной индекс, даже не проверяя, какие индексы уже существуют.
Любопытно, что ни одна модель не стала автоматически индексировать все внешние ключи. Скорее наоборот, индексов для них оказалось недостаточно. Частичные индексы, индексы по выражениям, GIN, GiST, INCLUDE, составные индексы с идентификатором арендатора в начале — с точки зрения синтаксиса всё было в порядке.
Вот как это выглядит на примере одной таблицы. Пятнадцать индексов, шестнадцатый — первичный ключ.
Индекс | Столбцы ключа | Какие строки включены в индекс |
|---|---|---|
| workspace_id, last_activity_at | Статус соответствует одному из состояний открытой заявки |
| workspace_id, status, last_activity_at | Статус соответствует одному из состояний открытой заявки |
| workspace_id, assignee_id, last_activity_at | Статус соответствует одному из состояний открытой заявки |
| workspace_id, team_id, last_activity_at | Задана команда, статус соответствует одному из состояний открытой заявки |
| workspace_id, priority, last_activity_at | assignee_id IS NULL, статус соответствует одному из состояний открытой заявки |
| workspace_id, organization_id, last_activity_at | Задана организация |
| workspace_id, first_response_due_at | Нет ответа, статус не «решена» и не «закрыта» |
| workspace_id, resolution_due_at | solved_at IS NULL, задан срок решения |
| workspace_id, solved_at | solved_at IS NOT NULL |
| workspace_id, requester_id, created_at | Все строки |
| workspace_id, created_at | Все строки |
| subject | Все строки |
| workspace_id, subject_tsv | Все строки |
| workspace_id, number | Все строки, уникальный индекс |
| workspace_id, id | Все строки, уникальный индекс |
Столбцы status и last_activity_at меняются при каждом ответе, назначении исполнителя, закрытии и повторном открытии заявки. Девять индексов либо включают один из этих столбцов в ключ, либо используют его в условии отбора. Поэтому любое такое обновление исключает возможность HOT‑обновления.
При закрытии заявки в tickets_solved_idx добавляется новая запись, а в четырёх частичных индексах очереди открытых заявок остаются мёртвые записи, которые затем придётся очищать через VACUUM.
В приложении для аналитики на таблице events накопилось сопоставимое количество индексов, но подобных затрат практически нет. Причина проста: существующие строки там никогда не обновляются, данные только добавляются. Для таких таблиц дополнительные индексы обходятся почти бесплатно.
И ведь каждый индекс из списка выше по отдельности спокойно прошёл бы код‑ревью. Точно так же, как если бы весь код писали и проверяли вручную. Проблема возникает, когда все эти индексы начинают работать вместе.
Во что обходятся шестнадцать индексов
Я провёл синтетический бенчмарк на таблице tickets с миллионом строк. Нагрузка имитировала типичную работу службы поддержки: примерно 60% операций приходилось на ответы клиентов, 25% — на изменение статуса заявки и 15% — на переназначение исполнителя.
Тесты выполнялись на PostgreSQL 18.6 с fillfactor=90. Чтобы расположение строк оставалось предсказуемым, я отключил autovacuum. Объём WAL измерял с помощью EXPLAIN (ANALYZE, BUFFERS, WAL), усредняя результаты трёх запусков.
Набор индексов | Вторичных индексов | Размер индексов до | Объём WAL | Время обновления | Размер индексов после | VACUUM |
|---|---|---|---|---|---|---|
Базовый вариант, написанный вручную | 7 | 176 МиБ | 436,0 МиБ | 4 850 мс | 230 МиБ | 264 мс |
helpdesk‑run3 | 9 | 173 МиБ | 426,2 МиБ | 4 377 мс | 227 МиБ | 236 мс |
helpdesk‑run2 | 15 | 221 МиБ | 647,8 МиБ | 8 599 мс | 324 МиБ | 394 мс |
helpdesk‑run1 | 15 | 259 МиБ | 776,8 МиБ | 9 013 мс | 361 МиБ | 436 мс |
Все тесты запускались в непривилегированном контейнере на моём ноутбуке. Объём WAL при повторных запусках практически не менялся: расхождение не превышало 0,3 МиБ. А вот время выполнения колебалось в пределах 9%. Поэтому главный результат здесь — устойчивое относительное увеличение показателей в 1,8 и 1,9 раза.
Обратите внимание на третий запуск. В нём девять индексов, но объём WAL оказался даже немного меньше, чем в моём базовом варианте с семью индексами. И обновления выполнялись быстрее. Почему?
Дело в строгих условиях отбора частичных индексов. У трёх из них были достаточно ограничивающие условия WHERE, под которые почти не попадали обновляемые строки:
CREATE INDEX tickets_unassigned_urgent_idx ON tickets (workspace_id, priority, created_at)
  WHERE assignee_kind IS NULL
    AND status <> ALL (ARRAY['solved','closed']);
В моём базовом варианте, написанном вручную, индексы были шире и не имели условий отбора, из‑за чего PostgreSQL чаще приходилось записывать полные страницы данных.
Другими словами, объём WAL зависит не столько от количества индексов, сколько от занимаемого ими места и числа изменённых страниц. Но когда модели создают по пятнадцать индексов, как во втором и первом запусках, совокупные издержки становятся заметными: в 1,8 раза больше WAL, вдвое выше задержка, в 1,6 раза больше места на диске и на 65% дольше работает VACUUM. И всё это при одних и тех же 200 000 обновлений.
Причём WAL не остаётся только на основном сервере. Всё, что в него записывается, передаётся по сети каждой реплике, а затем попадает в архив резервных копий. Так что за лишний объём приходится расплачиваться трижды.
Дополнительные 1,75 КБ на одно обновление кажутся мелочью. Но при 100 обновлениях в секунду это уже 15 ГБ лишнего WAL в сутки, причём всего для одной таблицы. Конечно, я не могу утверждать, что ваша самая загруженная таблица получает столько же операций. Здесь важен сам масштаб роста.
Во втором запуске я полчаса пытался понять, почему показатели так сильно скачут. В конце концов выяснилось, что ограничение памяти в Docker Desktop мешало PostgreSQL нормально сбрасывать данные на диск в фоновом режиме. После изменения лимита разброс результатов вернулся к нормальному уровню.
Но эти индексы действительно работают
На четырёх из девяти запросов, которые я измерял, helpdesk‑run1 оказался быстрее в 23–46 раз. Фильтрация по команде ускорилась с 0,76 до 0,02 мс, фильтрация по организации — с 1,20 до 0,03 мс. При этом среднее время планирования запросов выросло с 0,30 до 0,44 мс.
Вот результаты всех девяти запросов, рассчитанные по средним значениям без округления:
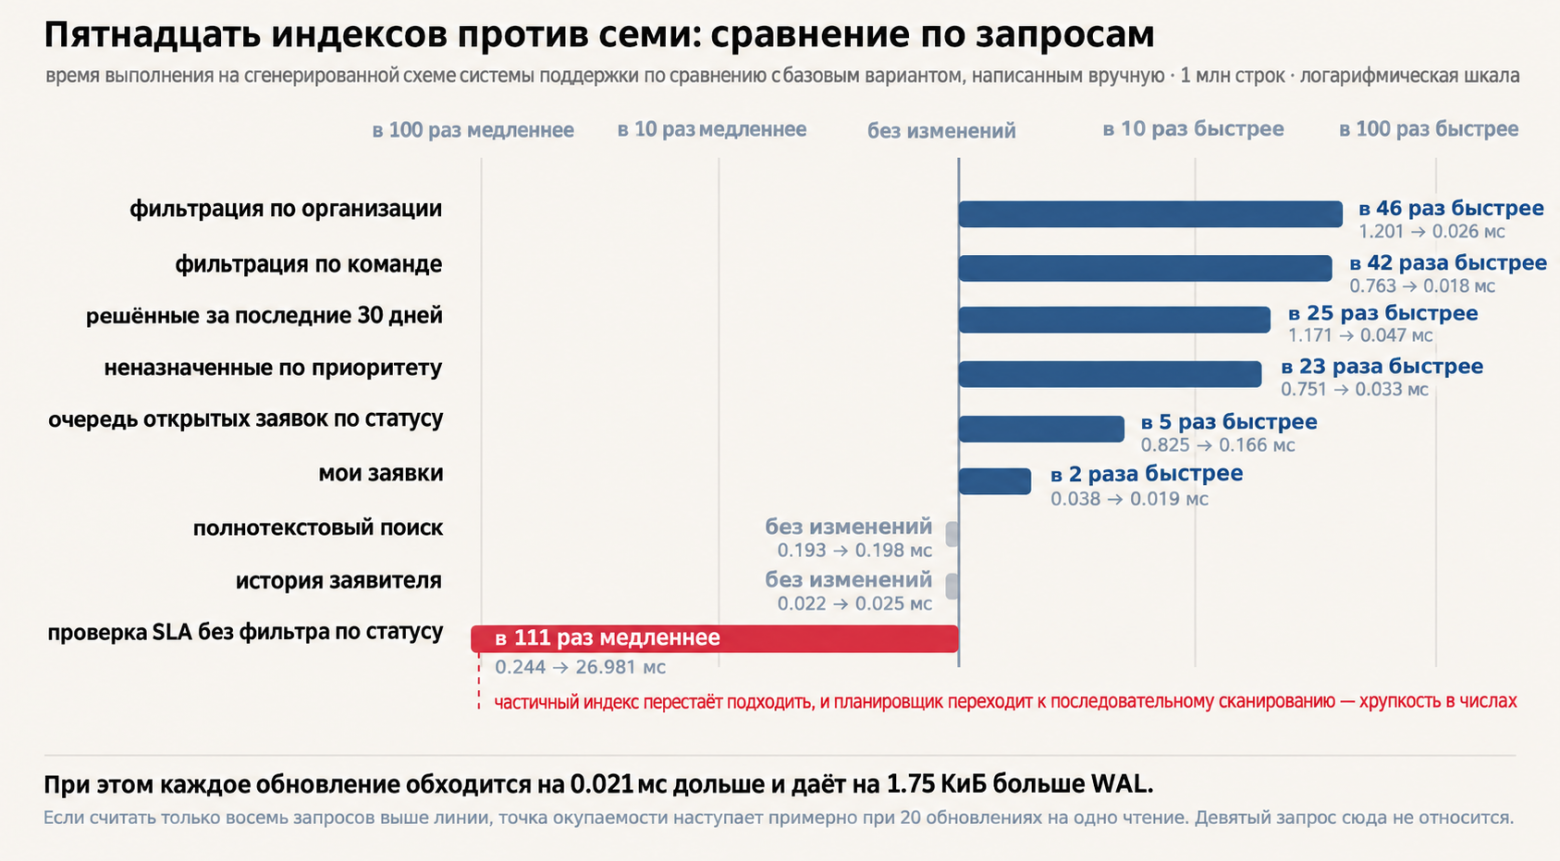
Восемь из девяти запросов работают так, как и ожидалось. А вот девятый, проверяющий соблюдение SLA, на сгенерированной схеме выполняется в 111 раз медленнее. При этом индекс, созданный специально для него, на первый взгляд выглядит правильно:
CREATE INDEX tickets_first_response_due_idx ON tickets (workspace_id, first_response_due_at)
  WHERE first_response_at IS NULL
    AND first_response_due_at IS NOT NULL
    AND status <> ALL (ARRAY['solved','closed']);
Если ограничить запрос одним рабочим пространством и указать все условия отбора, PostgreSQL прочитает всего 8 буферов. Но стоит убрать условие по статусу, и индекс вообще перестаёт использоваться: вместо него выполняется последовательное сканирование с чтением 43 727 буферов.
Если оставить условие по статусу, но проверять заявки сразу во всех рабочих пространствах, PostgreSQL всё‑таки использует индекс. И становится только хуже: 43 699 буферов, а выполнение занимает больше времени, чем последовательное сканирование, которое он заменил.
В моём базовом варианте индекс по first_response_due_at не содержит идентификатора арендатора в начале ключа, поэтому для той же проверки достаточно прочитать 102 буфера. Проверка SLA по своей природе охватывает данные всех арендаторов. И хотя для остальных запросов этой таблицы workspace_id в начале составного индекса вполне оправдан, здесь он только мешает.
Когда дополнительные индексы окупаются
Если исключить запрос проверки SLA, то helpdesk‑run1 экономит в среднем 0,554 мс на каждом выполнении остальных восьми запросов. Но дополнительные затраты на планирование съедают 0,146 мс этого выигрыша: чем больше индексов, тем больше вариантов планировщику приходится оценивать для неподготовленных запросов. В итоге чистая экономия составляет 0,408 мс на одно чтение.
Теперь посмотрим на запись. Разница во времени обновления составляет (9 013 − 4 850) мс ÷ 200 000, то есть дополнительные 0,021 мс на одно обновление.
Если сопоставить выигрыш при чтении с потерями при записи, то схема с пятнадцатью индексами оказывается выгоднее по процессорному времени, пока на каждую операцию чтения приходится меньше двадцати обновлений. Для системы поддержки такое соотношение вполне реально: сотрудники постоянно обновляют свои очереди заявок, а изменения поступают пачками между этими обновлениями. Удержаться ниже двадцати обновлений на одно чтение не так уж сложно.
Если учитывать только процессорное время, придраться здесь не к чему.
Но затраты на процессор — далеко не вся цена. Такой расчёт не учитывает дополнительные 15 ГБ WAL, которые ежедневно передаются репликам и попадают в резервные копии. Кроме того, он предполагает, что характер нагрузки остаётся неизменным. Стоит выпустить новую функцию, которая массово обновляет записи в tickets, и расчёты уже будут другими. При этом индексы в схеме БД редко пересматривают вслед за изменением нагрузки на запись.
На каком столбце построен индекс
Столбец last_activity_at входит в ключ шести из шестнадцати индексов. И то, что индексы построены именно на нём, обходится дороже, чем само их количество. Чтобы проверить это, я создал небольшую тестовую таблицу.
В обоих случаях было по шесть вторичных индексов, выполнялся один и тот же запрос UPDATE ... SET last_seen_at = now() для 300 000 строк.
Единственное отличие — в одном случае один из шести индексов включал обновляемый столбец, а в другом нет.
Обновляемый столбец | HOT‑обновлений | Доля HOT | Время обновления |
|---|---|---|---|
Не индексируется | 138 468 | 46,2% | 2 743 мс |
Индексируется | 0 | 0,0% | 3 979 мс |
Количество индексов и рабочая нагрузка не меняются. Меняется только то, на каком столбце построен один из индексов. Стоит добавить в него обновляемый столбец, как HOT‑обновления полностью исчезают, а время выполнения увеличивается на 45%. Выделить влияние именно этого фактора можно только на синтетической таблице, где все остальные условия остаются неизменными.
Поэтому к индексу (workspace_id, status, last_activity_at DESC) стоит присмотреться внимательнее. Для очереди заявок он выглядит вполне разумно. Скорее всего, вы бы и сами создали такой индекс. Но из‑за него любое изменение заявки исключает HOT‑обновление. Приходится добавлять новые записи во все индексы, условиям отбора которых по‑прежнему соответствует обновлённая строка, вплоть до всех шестнадцати. А старая версия строки остаётся ждать последующей очистки через VACUUM.
Впрочем, мой базовый вариант заслуживает такой же проверки. Во всех четырёх наборах индексов, участвовавших в прямом сравнении, доля HOT‑обновлений составляла 0%. В том числе и в моём варианте с семью индексами, написанном вручную.
Индекс для очереди заявок по времени последней активности кажется настолько очевидным решением, что я тоже его добавил. Так что HOT‑обновления не работали ни в одном случае.
Разница в том, что сгенерированным схемам при каждой записи приходится поддерживать в актуальном состоянии ещё восемь индексов.
Проверить это на работающей базе можно таким запросом:
SELECT s.relname, s.n_tup_upd, s.n_tup_hot_upd,
  round(100.0 * s.n_tup_hot_upd / NULLIF(s.n_tup_upd, 0), 1) AS hot_pct,
  (SELECT count(*) FROM pg_index i WHERE i.indrelid = s.relid) AS indexes
FROM pg_stat_user_tables s
WHERE s.n_tup_upd > 10000
ORDER BY hot_pct;
Низкое значение hot_pct у таблицы с высокой интенсивностью изменений — повод проверить, какие индексы включают столбцы, затрагиваемые вашими запросами UPDATE.
Что индексы вытесняют из кеша
Если HOT‑обновления уже невозможны, каждый дополнительный вторичный индекс увеличивает объём WAL примерно на 26 МиБ при тех же 200 000 обновлений. Это среднее значение, полученное по двенадцати индексам. Фиксированной цены здесь нет: дополнительные затраты составляли от 18 до 46 МиБ на индекс в зависимости от того, сколько записей полных образов страниц потребовалось в конкретном случае. И платить эту цену приходится при каждой последующей операции записи.
Но влияние на кеш оказалось ещё серьёзнее. Приведённые выше тесты выполнялись с shared_buffers=512MB, и памяти хватало с запасом. Когда я уменьшил shared_buffers до 128 МБ и повторил тесты с холодным кешем, картина резко изменилась:
Набор индексов | Блоков прочитано с диска | Индексы в кеше, МиБ | Табличные данные в кеше, МиБ |
|---|---|---|---|
Базовый вариант (7) | 53 089 | 92,6 | 35,2 |
helpdesk‑run1 (15) | 357 022 | 118,7 | 9,2 |
Количество физических операций чтения выросло в 6,7 раза. Причина хорошо видна по распределению буферов: дополнительные страницы индексов тоже нужно где‑то хранить, и они вытесняют из кеша страницы таблицы.
При том же объёме кеша в 128 МиБ количество закешированных табличных данных сократилось с 35 до 9 МиБ, а объём страниц индексов в кеше, наоборот, вырос. При этом разница во времени обновления увеличилась с 1,9 до 2,1 раза.
При shared_buffers=512MB ничего подобного не происходило: всё помещалось в память. Поэтому результаты теста со 128 МБ не стоит воспринимать как прогноз для вашего сервера. Это лишь наглядная демонстрация того, как страницы индексов вытесняют табличные данные из кеша, когда места на всё уже не хватает.
Никто не удаляет двенадцатый индекс
Вторая половина проблемы проявляется в следующем коммите. Я дал шести новым экземплярам моделей таблицу tickets с шестнадцатью индексами и обычную задачу по добавлению функциональности. По три экземпляра от двух разработчиков, причём один из них вообще не участвовал в предыдущих тридцати запусках. Задачи были простыми: добавить фильтрацию списка заявок по тегам или очередь «Ожидает ответа клиента». В промпте не было ни требований к производительности, ни упоминаний существующих индексов.
Ни в одном запуске модель не предложила удалить лишние индексы. Пять из шести добавили новый индекс, причём каждый раз на изменяемом столбце с условием отбора, которое тоже зависело от изменяемых данных.
CREATE INDEX CONCURRENTLY tickets_waiting_on_customer_idx
  ON tickets (workspace_id, COALESCE(last_customer_message_at, created_at))
  WHERE status = 'pending';
В двух запусках модели разных разработчиков независимо друг от друга создали совершенно одинаковый индекс, вплоть до COALESCE и условия отбора. При этом все шесть моделей вынесли теги в отдельную таблицу связей, а не стали хранить их в столбце‑массиве таблицы tickets. То есть ни одна не увеличила размер строки, которая часто обновляется.
Только одна модель объяснила своё решение. Она отказалась от массива, поскольку изменение тегов в таком столбце нарушало бы работу HOT‑обновлений. А затем всё равно добавила частичный индекс с условием status = 'pending', который точно так же мешает HOT‑обновлениям. Для одного столбца модель заметила риск, а для другого — пропустила.
В одном из запусков модель решила ту же задачу с помощью представления, использующего существующие индексы, и не стала ничего добавлять. Это и был правильный вариант.
Хочется верить, что на код‑ревью я бы одобрил решение с представлением. Хотя, учитывая, что схема БД вообще не изменилась, не уверен, что заглянул бы дальше списка файлов.
В первой версии этого теста я представил счётчики использования индексов так, будто статистика была собрана за шесть недель работы в продакшене. На самом деле данные были синтетическими, сгенерированными всего за несколько минут до проверки.
Одна из моделей, выступавшая в роли ревьюера, усомнилась в достоверности исходных данных: границы циклов в генераторе точно совпадали с количеством сканирований, а у девяти индексов значения last_idx_scan совпадали вплоть до микросекунды. Модель оказалась права, и я повторил тест, честно указав происхождение данных.
Затем я представил ту же таблицу, но уже в контексте анализа производительности: «Задержка записи постепенно растёт, VACUUM с каждой неделей работает всё дольше». Никакой статистики я не приложил.
Все четыре запуска выявили проблему. Модели обнаружили, что last_activity_at входит в шесть индексов, сделали вывод, что ни одно обновление этой таблицы не может быть HOT‑обновлением, и предложили удалить индексы, даже не увидев ни одного плана запроса.
При этом каждая модель запросила данные из pg_stat_user_indexes, прежде чем что‑либо удалять. Когда им предоставили счётчики, рекомендации стали ещё точнее.
«Сделай готовым к продакшену» — это тоже решение, влияющее на схему БД
Вернёмся к фразе make it production‑ready («сделай готовым к продакшену»), которой заканчивались промпты во всех восемнадцати запусках моделей B и D. Я повторно запустил эти две модели со спецификациями ветеринарной системы и системы грузоперевозок, но убрал эту фразу. Осталась только инструкция: «Прочитай этот файл и создай схему БД».
Условия | Ветеринарная система, индексов на таблицу | Грузоперевозки, индексов на таблицу |
|---|---|---|
Модели B/D, с дополнительной инструкцией | 1,77–1,93 | 2,33–3,14 |
Только спецификация | 1,33–1,59 (B/D) | 2,17–2,46 (B) |
Модель A, только спецификация | 1,05–1,06 | Не запускалась |
Модель C, только спецификация | 0,55 | 0,96 |
Из‑за одной этой фразы количество индексов увеличивается примерно на пятую часть: на 20% в ветеринарной системе и на 17% в системе грузоперевозок. Всего три слова в конце промпта, которые никто не воспринимает как решение по проектированию БД, а они меняют затраты на запись в самой загруженной таблице приложения.
Оба варианта имеют право на существование. Дополнительная инструкция отражает то, что люди действительно пишут ИИ‑агентам, поэтому результаты с ней ближе к реальной практике. А спецификация без дополнений позволяет корректнее сравнивать сами модели.
Различия между моделями никуда не исчезают, хотя и становятся меньше. Если использовать только спецификацию, модели B/D создают в 1,4 раза больше индексов, чем модель A, вместо прежних 1,8 раза. По сравнению с моделью C разрыв остаётся большим: в 2,7 раза для ветеринарной системы и в 2,4 раза для грузоперевозок. Примерно треть этого разрыва объясняется формулировкой промпта, остальное — особенностями самих моделей.
Та же закономерность прослеживается на всех семи таблицах с высокой интенсивностью изменений. На таблицах ветеринарной системы модели B/D создавали от 16 до 20 необязательных индексов, модель A — от 8 до 10, а модель C — всего 5.
Но различия между разработчиками моделей проявлялись не во всём. Ни одна модель не стала автоматически создавать индексы для всех внешних ключей, независимо от общей плотности индексов. Избыточность тоже не зависела напрямую от их количества: два запуска с наибольшим числом избыточных индексов оказались примерно в середине по плотности, а в схеме с самой высокой плотностью из 163 индексов избыточным был только один.
При этом самая компактная схема системы грузоперевозок содержала четыре частичных уникальных индекса на таблице load_assignments, каждый с условием по status. Эти индексы обеспечивают корректность данных, поэтому удалять их нельзя. Но HOT‑обновлениям они мешают точно так же, как и необязательные индексы.
Есть две оговорки относительно сравнения промптов. Разработчик модели A также подготовил две спецификации, использованные в этом тесте, а для модели C был проведён всего один запуск на каждое приложение. Модели прочитали файл с предварительно зарегистрированным планом эксперимента и увидели, что участвуют в исследовании индексов. Повторный запуск проводился уже в чистом каталоге с нейтральными именами файлов.
Восемнадцать из тридцати схем были созданы моделями одного разработчика. Поэтому такая плотность индексов — особенность конкретной модели, а не всех моделей в целом. Между моделями она различается втрое, а формулировка промпта дополнительно влияет на результат. Но затраты на запись возникают независимо от того, кто спроектировал схему.
Как проверить нагрузку на запись в продакшене
Всё это не значит, что нужно стремиться к минимальному количеству индексов. На таблицах с преобладанием операций чтения, где данные редко меняются, дополнительные индексы практически ничего не стоят. Если выбор стоит между отчётом, который строится 40 секунд, и ещё одним индексом на таблице, куда данные только добавляются, смело создавайте индекс.
Настоящая проблема начинается, когда на таблицах с высокой интенсивностью записи один за другим появляются новые индексы. При воспроизведении нагрузки системы поддержки выяснилось, что всего два индекса обслуживали 90% всех поисковых запросов.
При этом два больших индекса GIN по теме заявки занимали 130 МиБ на диске и требовали обслуживания при каждой вставке и каждом изменении темы. Но в тестах с обычными рабочими сценариями к ним не было ни одного обращения.
На работающей базе данных, прежде чем что‑либо менять, проверьте статистику в pg_stat_user_indexes:
SELECT s.relname, s.indexrelname,
  pg_size_pretty(pg_relation_size(s.indexrelid)) AS size,
  i.indisunique AS uniq,
  s.idx_scan, s.last_idx_scan
FROM pg_stat_user_indexes s
JOIN pg_index i ON i.indexrelid = s.indexrelid
WHERE NOT i.indisprimary AND s.idx_scan = 0
ORDER BY pg_relation_size(s.indexrelid) DESC;
Если вы пользуетесь dryrun, команда detect kind=unused_indexes позволяет выполнить аналогичную проверку по снимку схемы БД, без подключения к работающей базе. Так что проверять индексы можно сразу при внесении изменений, а не после их применения. Используются те же счётчики, поэтому и ограничения у такого подхода те же.
Прежде чем удалять индексы, внимательно изучите результаты. Счётчики могут сбрасываться при перезапусках, реплики могут использовать индексы, которые не нужны основному серверу, а уникальные индексы обеспечивают целостность данных.
Например, в моём тесте tickets_subject_fts_idx показал ноль сканирований просто потому, что запросы сначала фильтровали данные по workspace_id, оставляя 500 строк из миллиона. Поэтому PostgreSQL вообще обходился без полнотекстового поиска. Ноль сканирований в одном бенчмарке ещё не повод удалять индекс.
Если хотите оценить, насколько хорошо ориентируетесь в администрировании PostgreSQL, пройдите вступительный тест экспертного уровня.
Чтобы находить узкие места PostgreSQL и эффективно работать с нагруженными базами, важно разбираться в производительности и архитектуре СУБД. На курсе «Администрирование PostgreSQL. Экспертный уровень» вы научитесь оптимизировать запросы, настраивать отказоустойчивые кластеры и автоматизировать администрирование. Преподаватели курса скоро проведут бесплатные демо-уроки, присоединяйтесь:
23 ноября, 20:00. «Журнал, который нельзя тихо переписать: hash‑chain и дерево Меркла в PostgreSQL». Записаться
17 декабря, 20:00. «PostgreSQL как база для AI‑приложений: действительно ли нужна отдельная векторная БД?». Записаться