Можно ли улучшить прогноз криминальных инцидентов, дополнив их историю характеристиками городской среды? На открытых данных Лимы строим ежедневные оценки риска для 2 120 ячеек H3. В подходе, вдохновлённом Risk Terrain Modeling (RTM), кодируем POI, застройку и уличную сеть как потенциальные пространственные факторы риска. Сравниваем градиентный бустинг с историческими бейзлайнами по доле инцидентов следующего дня, попавших в 5% ячеек с наибольшим прогнозируемым риском.
Исследование полностью основано на открытых данных. Данные о зарегистрированных криминальных инцидентах в Лиме публикуются МВД Перу (SIDPOL) как публичный слой ArcGIS, а характеристики городской среды получены из OpenStreetMap. Данные доступны для независимого воспроизведения анализа — от исходных записей до карт риска.
1. Завтрашняя карта ещё пуста
Три карты одной территории: слева — зарегистрированные инциденты за 28 дней до 27.10.2026, в центре — прогноз модели EWM-30 на следующий день, справа — фактическое распределение инцидентов.
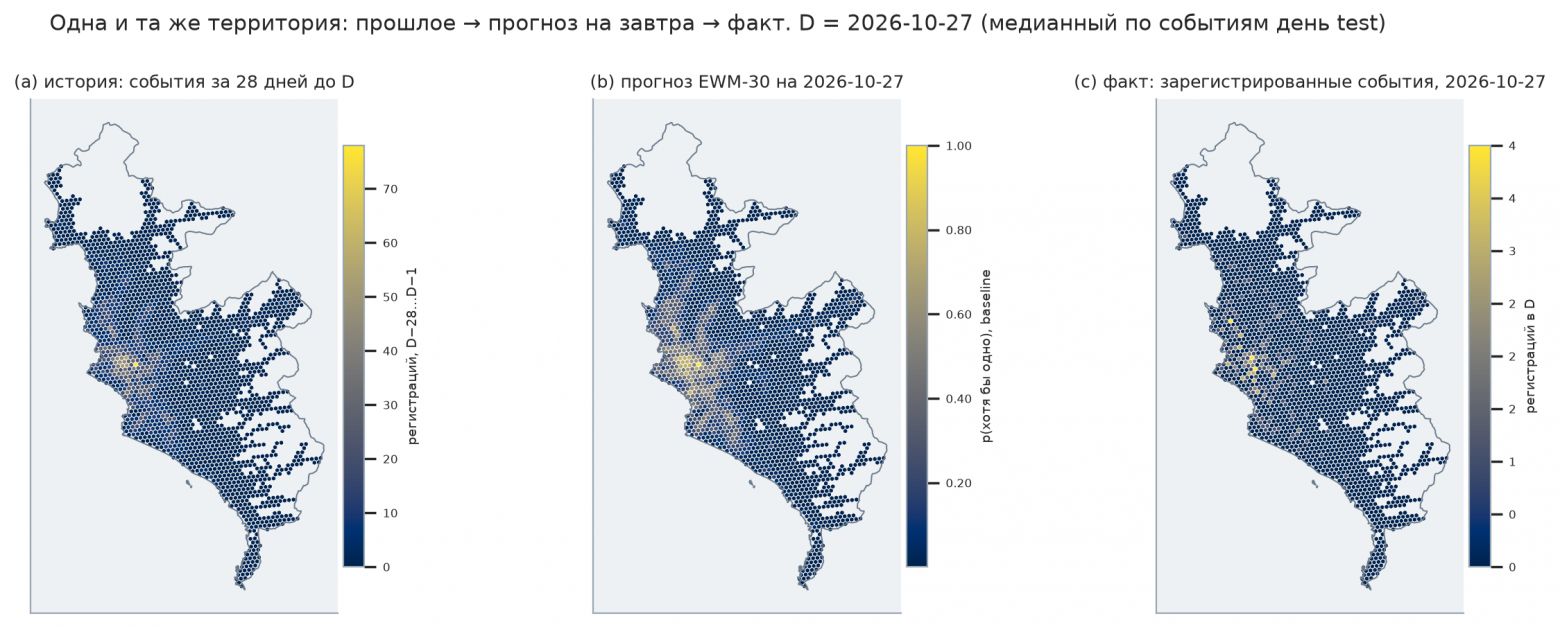
Мы оцениваем риск на уровне ячеек, а не точные координаты инцидентов. Под инцидентом далее понимается зарегистрированное полицией событие с известной координатой. Данные отражают как криминальную активность, так и обращаемость населения и практики регистрации. Для иллюстрации выбран день тестовой выборки с медианным числом инцидентов; правило выбора зафиксировано до просмотра прогнозов.
2. Что прогнозируем: гексагоны и пять каналов
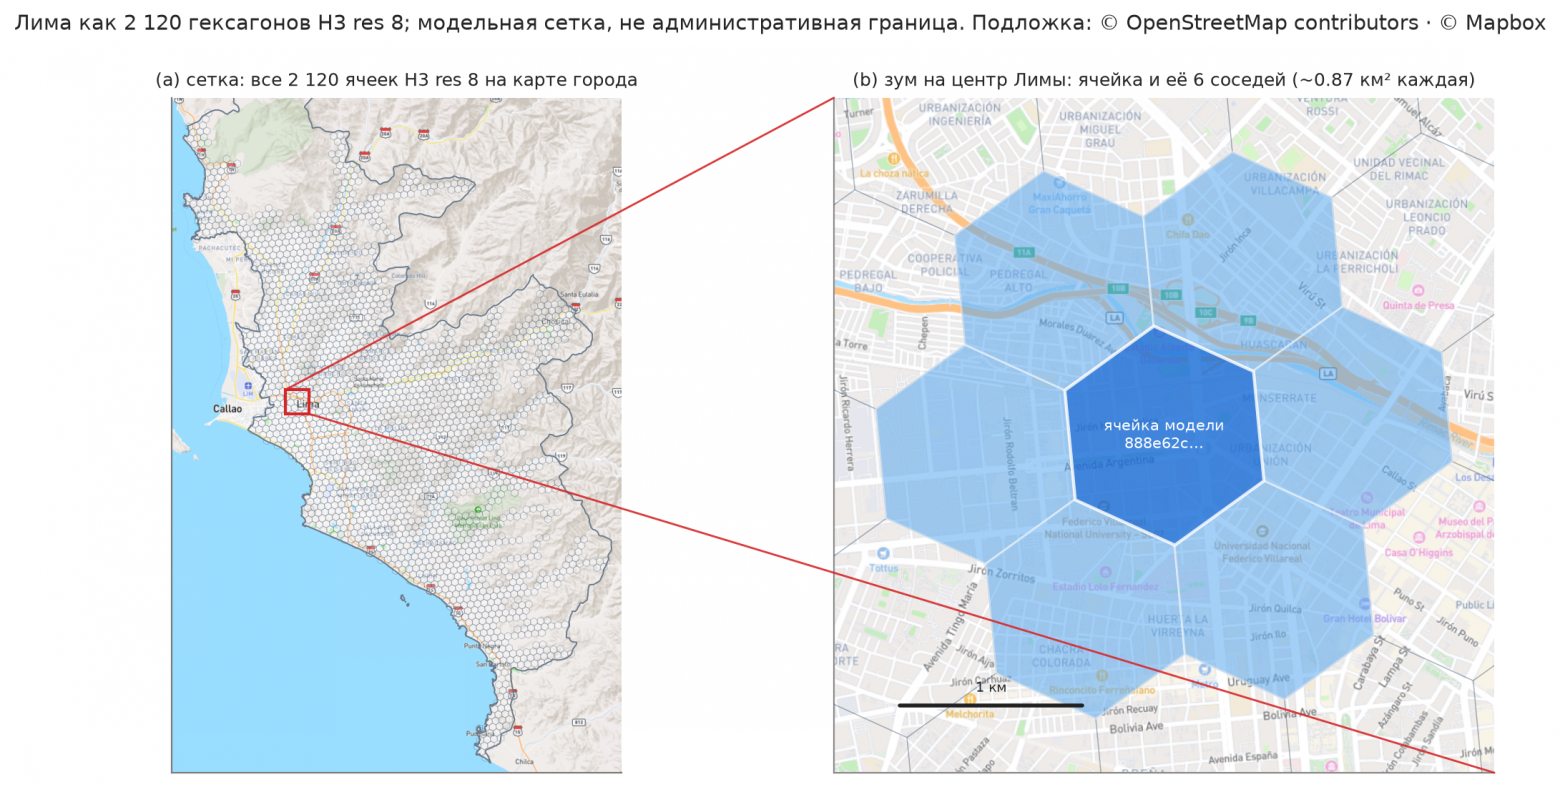
Сетка — 2 120 ячеек H3 res 8 (~0,87 км²); это модельное покрытие, не административная Лима. Прогноз строится ежедневно: входные данные — число инцидентов за D−28…D−1, выход — вероятность регистрации инцидента в каждой ячейке в день D.
Пять каналов по виду преступления:
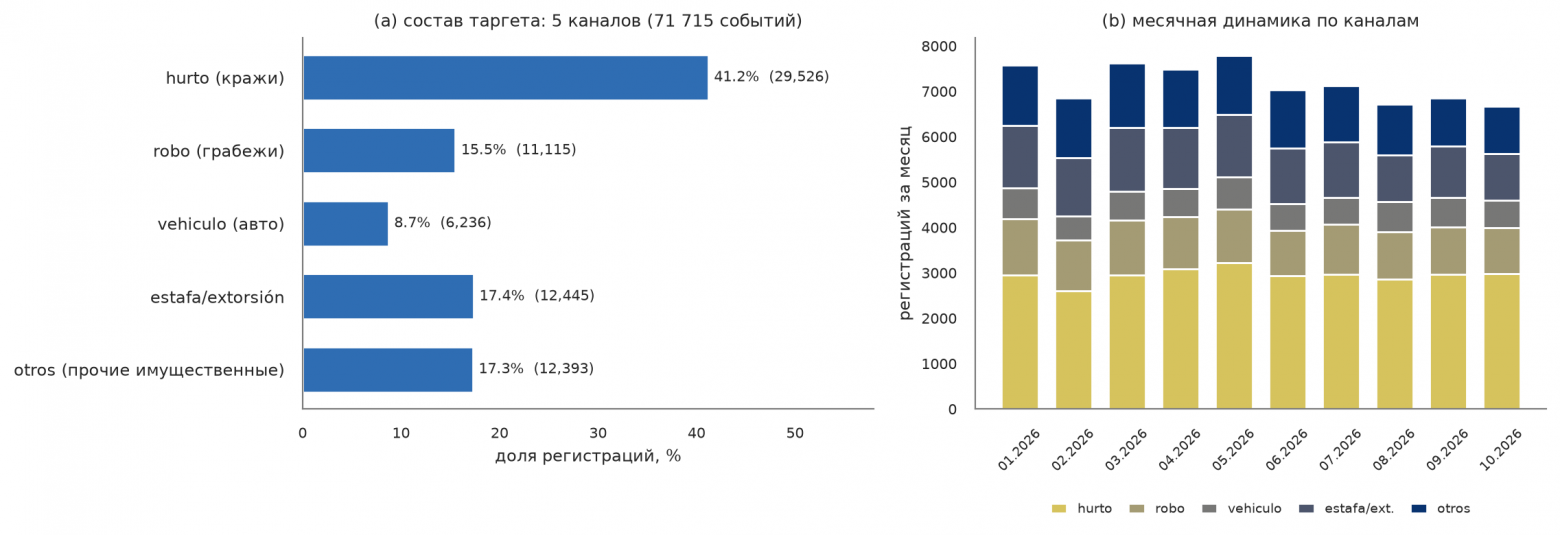
Кражи (hurto) составляют 41% из 71 715 инцидентов в панели данных; далее следуют грабежи, угон автомобилей, мошенничество с вымогательством и «прочие». Мошенничество и вымогательство выделены в отдельный канал: они часто происходят по телефону или онлайн, а координата может соответствовать адресу заявителя. Семейное насилие (44 831 заявление) исключено по условиям задачи как отдельный процесс с другой географией. Исходный набор содержит 117 050 очищенных записей SIDPOL за 2026 год; из него исключены указанные заявления и 504 инцидента вне сетки. У ~30% заявлений нет координаты (доля зависит от района), а часть записей имеет совпадающие координаты у полицейских участков. Поправочные веса не применяются: все показатели относятся к зарегистрированным инцидентам с известной координатой. Характеристики городской среды получены из снимка OSM от 11.11.2026.
3. Почему «горячие точки вчера» ≠ «завтра»
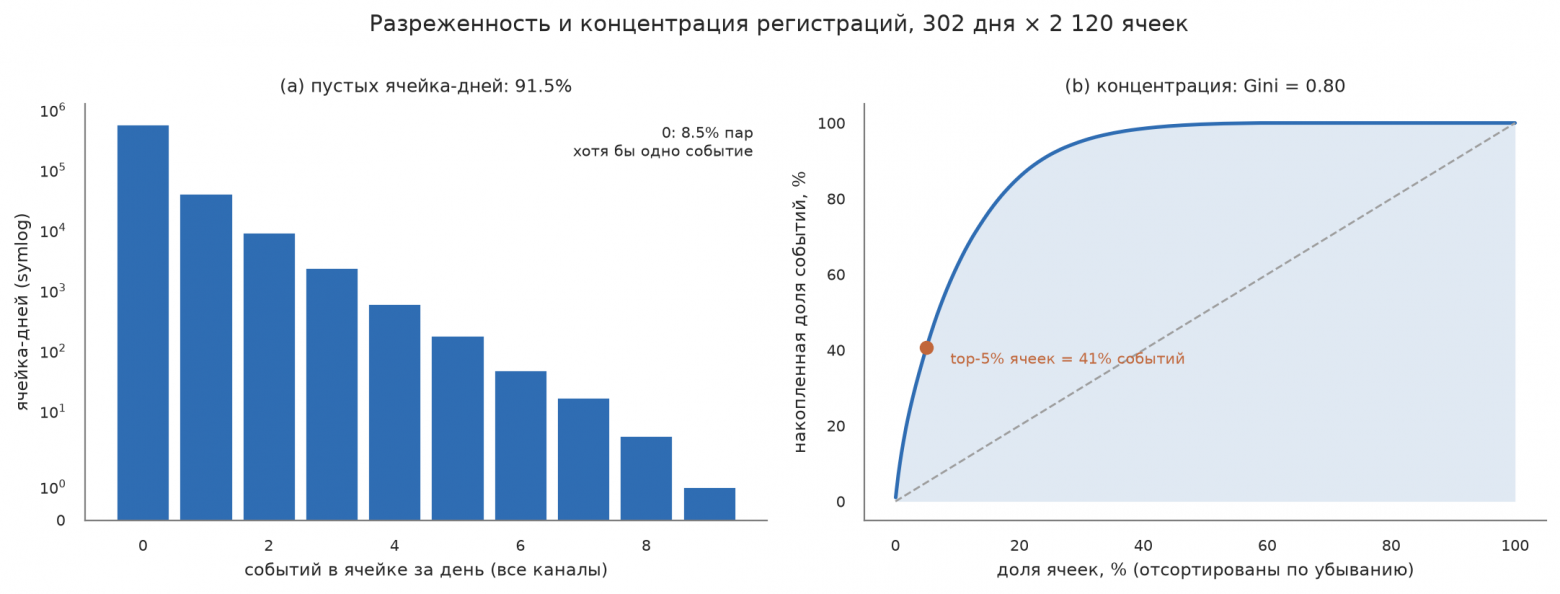
В 91,5% пар «ячейка × день» нет инцидентов; за год они зарегистрированы только в 1 234 ячейках из 2 120. Инциденты выраженно сконцентрированы в пространстве: топ-5% ячеек (106 ячеек) охватывают 41% инцидентов за год, коэффициент Джини равен 0,80. Это обосновывает оценку моделей по охвату инцидентов на 5% территории.
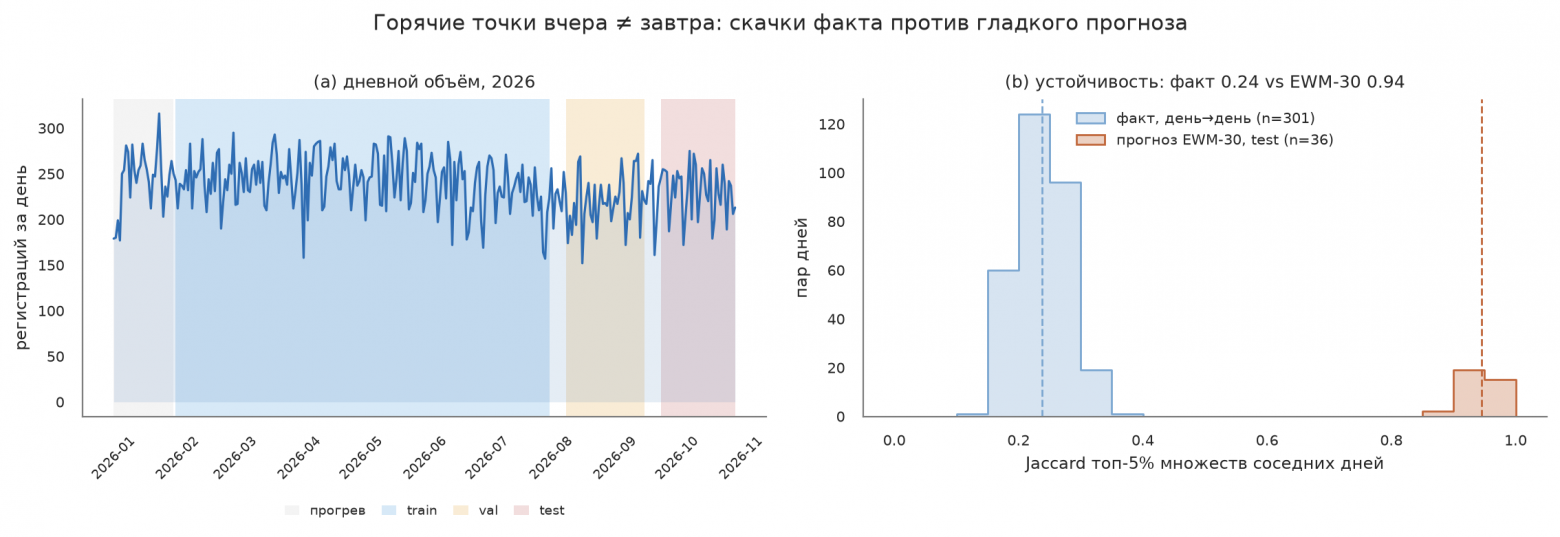
Однако состав ячеек с наибольшим числом инцидентов меняется от дня к дню: индекс Жаккара для топ-5% между соседними днями равен 0,24 у фактических данных и 0,94 у сглаженного прогноза EWM-30. Устойчивая пространственная концентрация сочетается с высокой изменчивостью на суточном горизонте — именно её модели пытаются предсказать. Дневное число инцидентов относительно стабильно (~238 в день). Сезонность на периоде из 302 дней не моделируется; недельный ритм, праздники и дни выплаты зарплат учитываются календарными признаками. В течение суток после инцидента поступает лишь ~68% заявлений, которые будут зарегистрированы впоследствии. Эта задержка ограничивает доступность данных за день D−1 при построении оперативного прогноза.
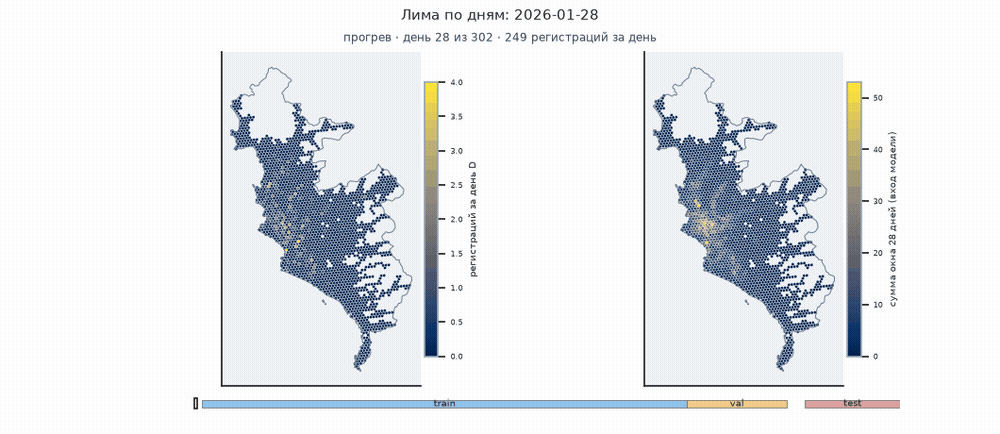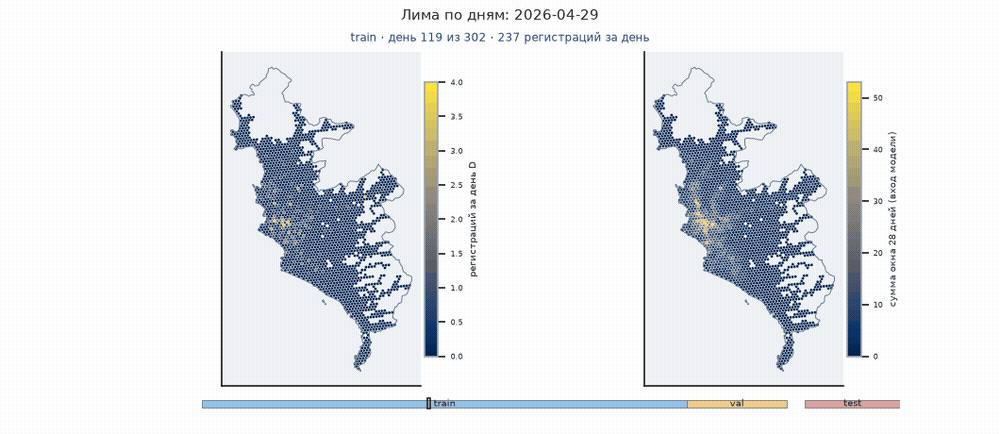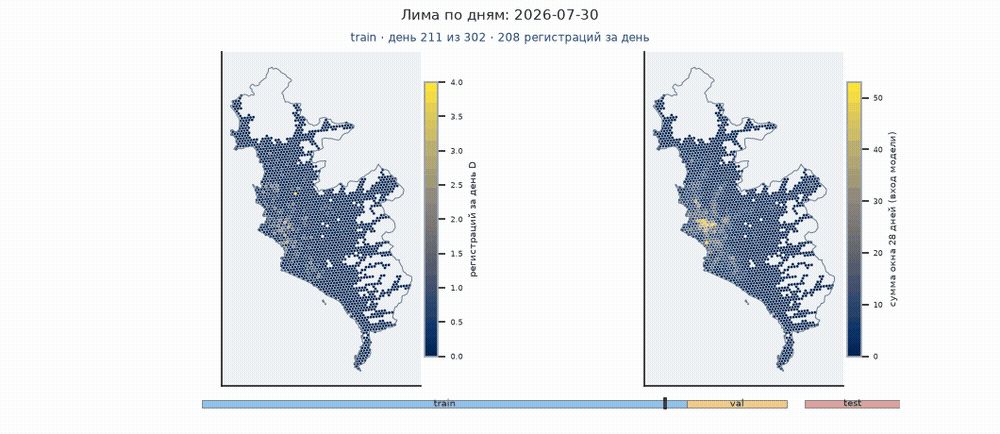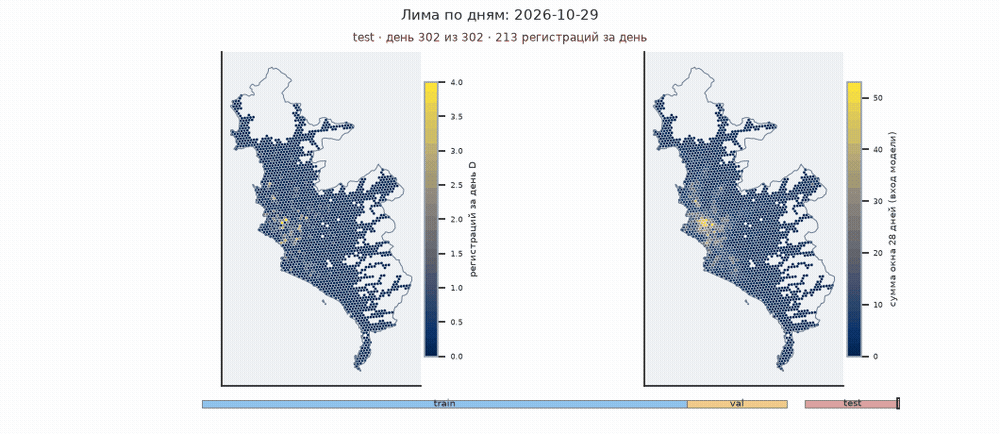
Анимация показывает ежедневное распределение инцидентов слева и скользящее 28-дневное окно, используемое моделью, справа. Фиксированная шкала позволяет сравнивать кадры.
4. Честный эксперимент
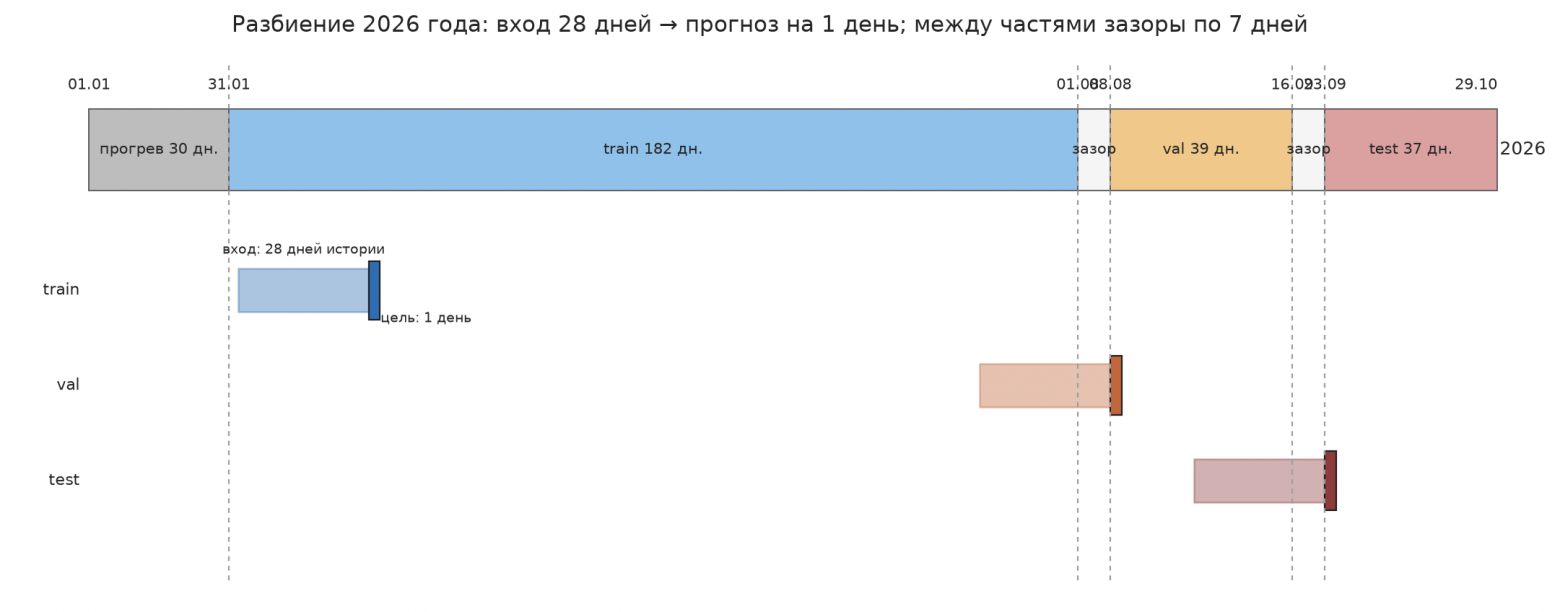
Исследование охватывает 302 дня 2026 года. Первые 30 дней используются для формирования исторических признаков. Далее данные разделены на три последовательных периода:
Обучающая выборка: 31 января — 31 июля, 182 дня.
Валидационная выборка: 8 августа — 15 сентября, 39 дней.
Тестовая выборка: 23 сентября — 29 октября, 37 дней.
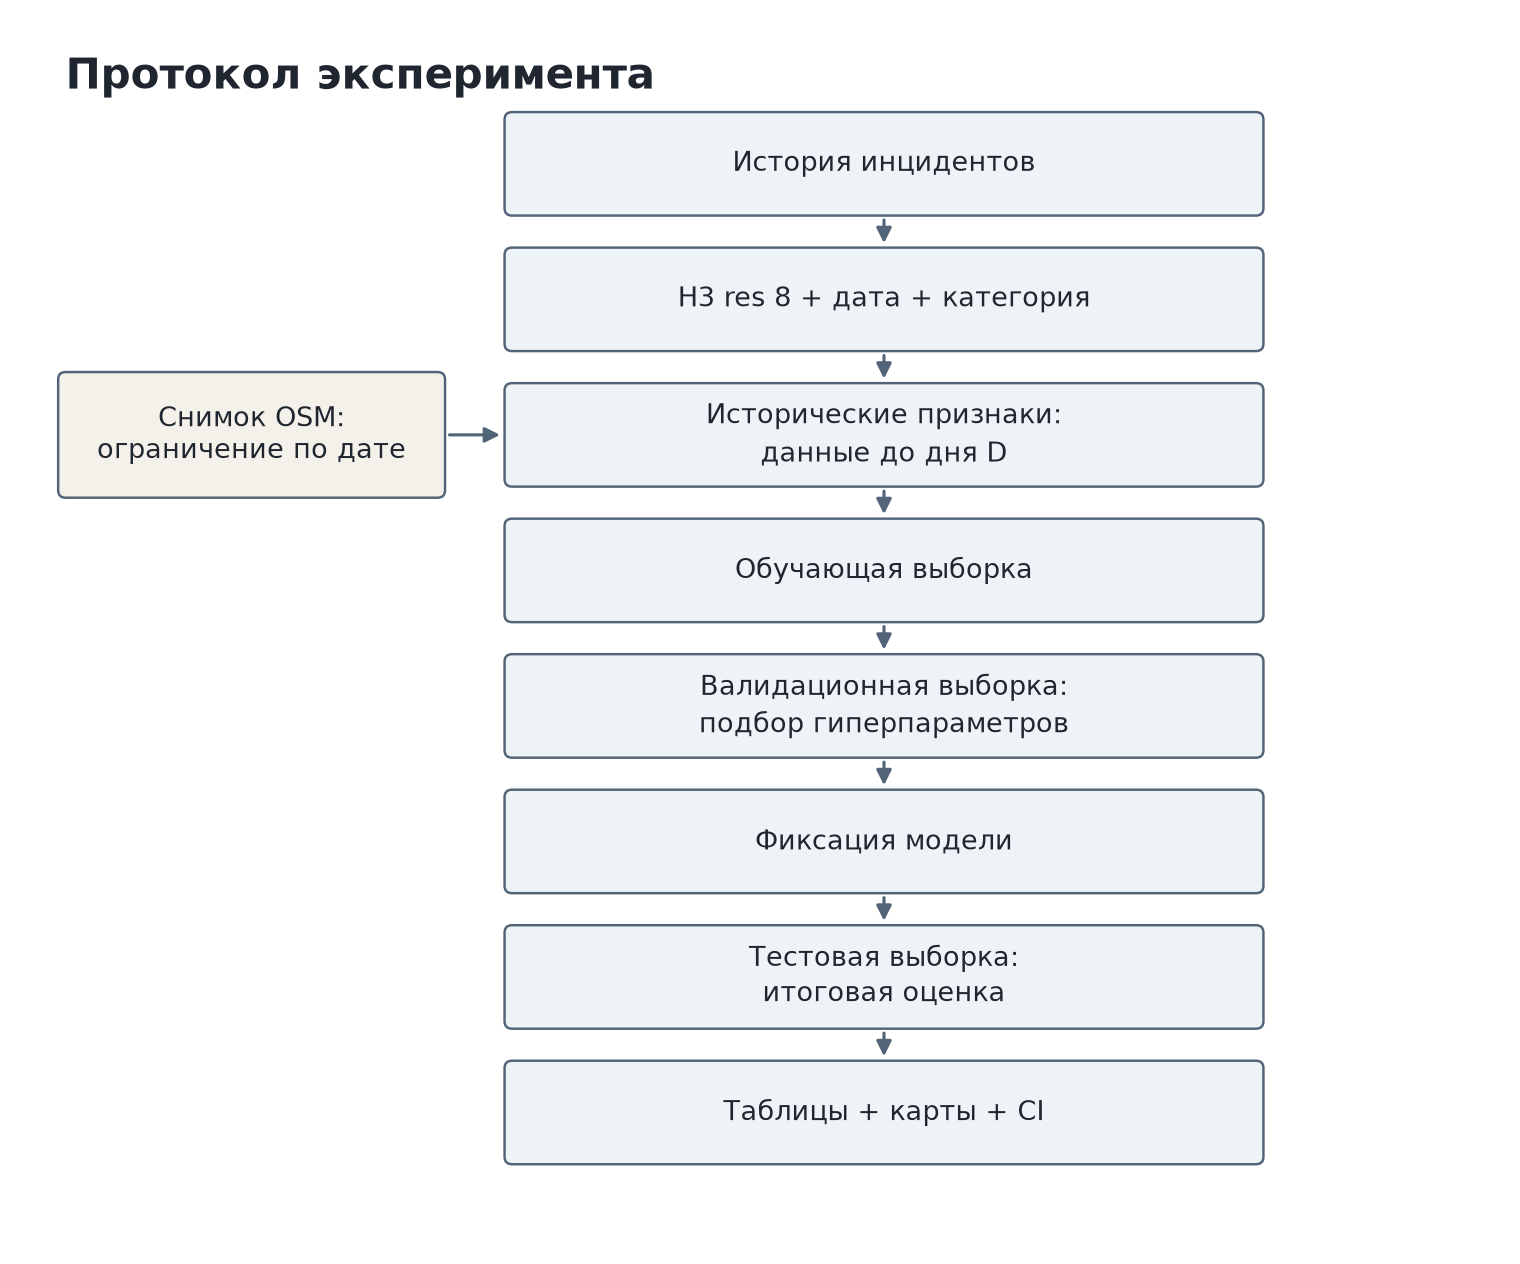
Между периодами целевых дат оставлены семидневные интервалы. Они разделяют выборки по времени, но не устраняют пересечение исторических окон длиной 28 и 90 дней. Для прогноза на день D используются только инциденты из дней до D; история может включать наблюдения из предыдущего периода. Валидационная выборка используется для подбора гиперпараметров. Тестовая выборка зафиксирована и используется только для итоговой оценки. Все модели оцениваются одним кодом: с одинаковыми значениями top-k, единым детерминированным правилом разрешения равных оценок и общим набором метрик.
5. Простые бейзлайны для сравнения
Исторические бейзлайны без обучения предиктивной модели: фиксированная карта, обновляемая карта, день недели и EWM с полураспадом 7 и 30 дней. Для преобразования их оценок в вероятности используется обучаемая калибровка на валидационной выборке. Дополнительно оценивается исходная версия LightGBM (далее — legacy LightGBM), обученная на дневных признаках.
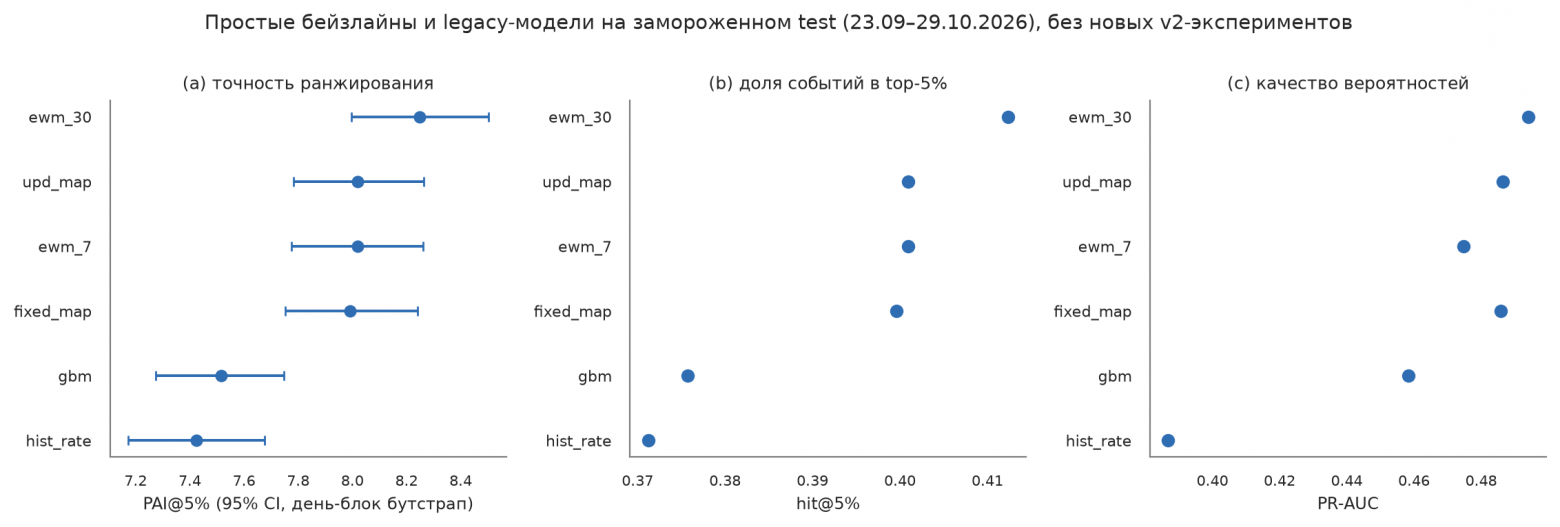
EWM-30 (exponentially weighted mean, полураспад 30 дней) — историческая оценка, не требующая обучения предиктивной модели: для каждой ячейки рассчитывается взвешенная сумма ежедневных инцидентов, где инциденты N дней назад имеют вес 0,977ᴺ. Каждые 30 дней вес наблюдения уменьшается вдвое, поэтому недавние инциденты сильнее влияют на оценку. Результат преобразуется в вероятность с помощью изотонической калибровки, обученной на валидационной выборке. Само обновление исторической оценки задаётся формулой и не требует обучения; это не означает отсутствия обучаемого этапа во всём процессе получения вероятностей.
Лучший простой бейзлайн — EWM-30: PAI@5% = 8,25 [8,00–8,50], hit@5% = 41,2%. Фиксированная карта — 7,99, день недели — 7,42, legacy LightGBM — 7,52. Скорость адаптации EWM определяется полураспадом: 7 дней повышают чувствительность к шуму (8,02), фиксированная карта не учитывает изменения во времени. Полураспад 30 дней позволяет учитывать медленный дрейф (+0,26 [0,14, 0,37] против фиксированной карты, CI не содержит нуля).
Этот результат ещё не определяет возможности бустинга: legacy LightGBM не использовал календарные и городские признаки или остаточную постановку. Эти дополнения проверяются в серии экспериментов v2.
6. Признаки для LightGBM
Используются три семейства признаков:
Временные: лаги 1/7/28/90 дней с масками доступности, скользящие агрегаты, EWM-7/30.
Календарные: день недели, праздники и дни выплаты зарплат.
Городские: POI, морфология застройки и уличная сеть.
Маски доступности позволяют отличать отсутствие истории от отсутствия инцидентов. Если для ячейки недоступен лаг 90 дней, его нельзя интерпретировать как нулевую активность. Доступность истории кодируется отдельными флагами и числом дней с первого и последнего инцидента. Все агрегаты рассчитываются только по дням до D.
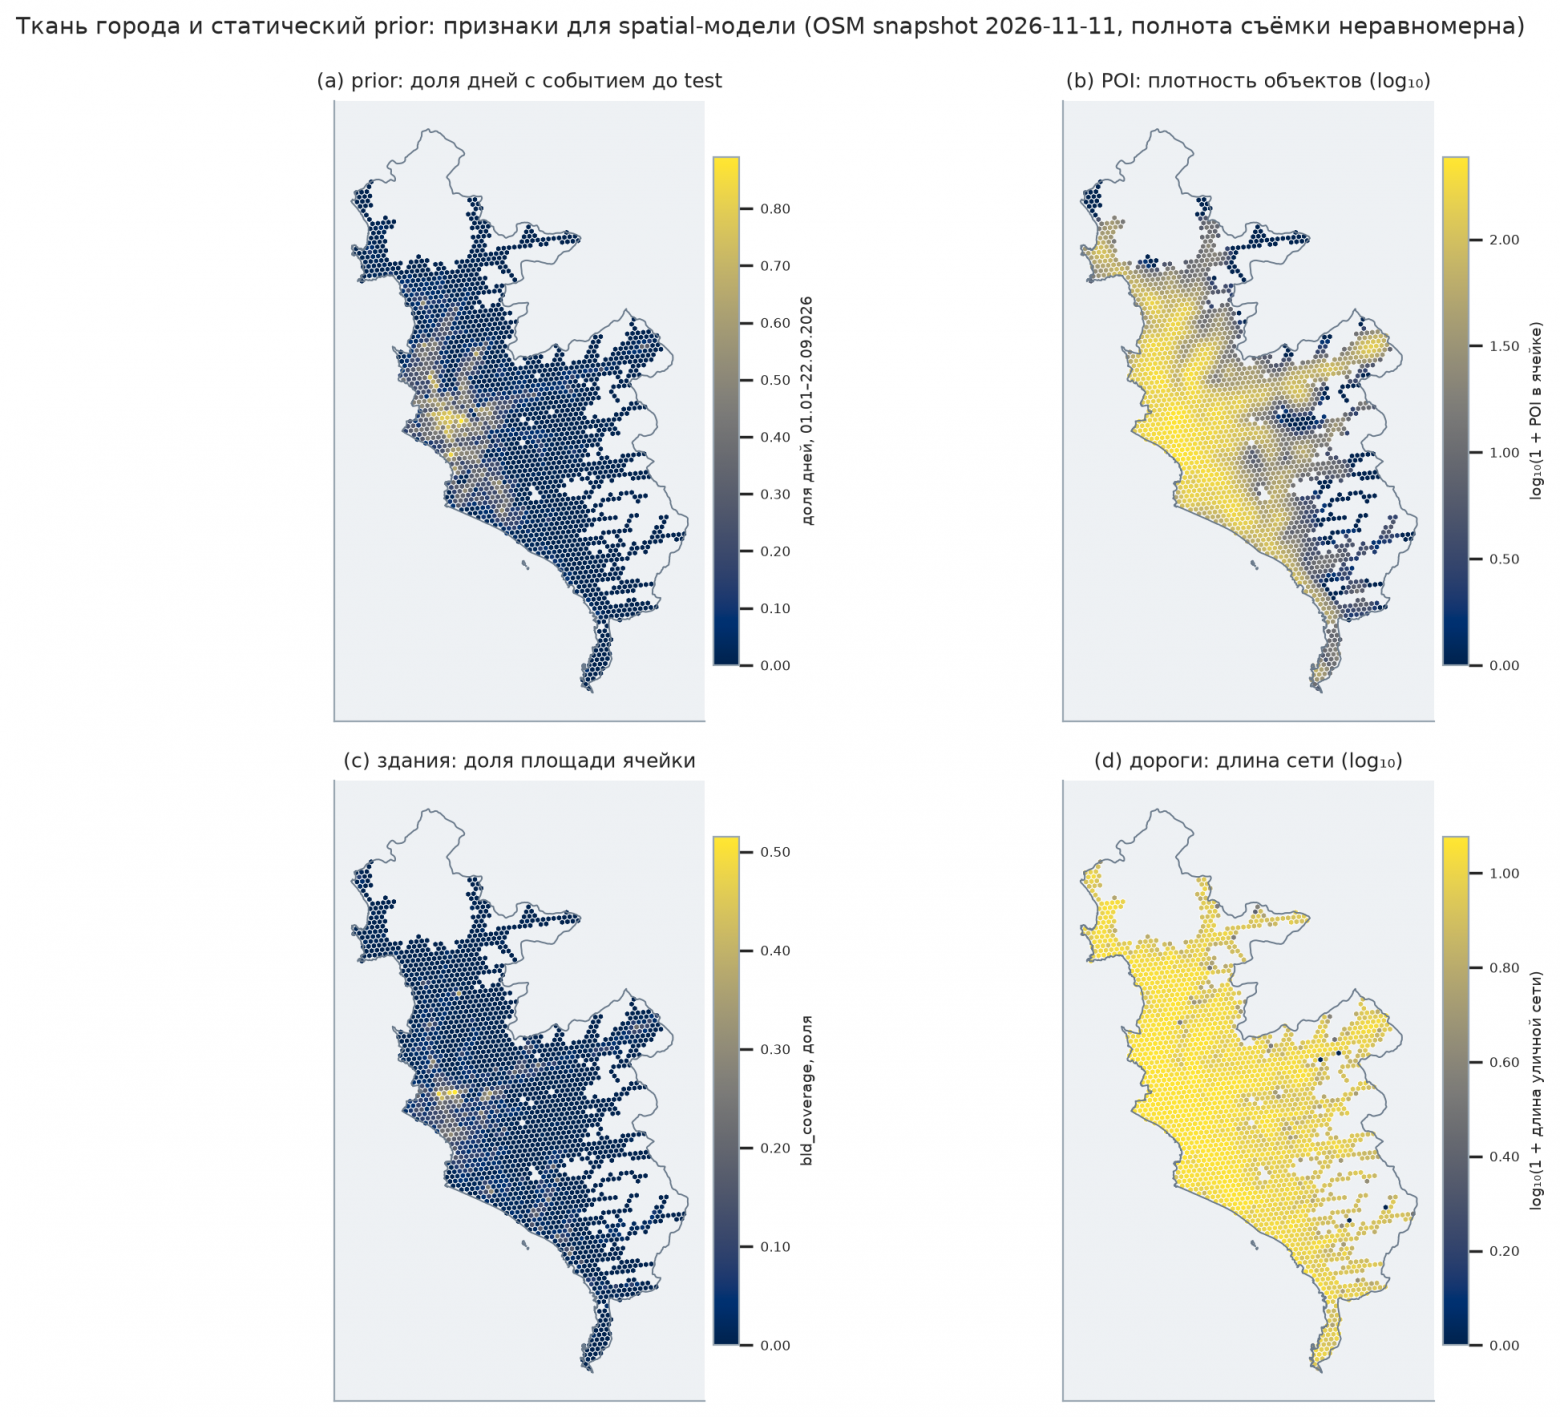
Дата снимка OSM — отдельное ограничение эксперимента. Доступный снимок от 11.11.2026 новее тестового периода, завершившегося 29.10.2026. Код v2 загружает подготовленные городские признаки без проверки даты их источника; использование исторического снимка, доступного до прогнозируемых дат, в материалах эксперимента не подтверждено. Поэтому результаты моделей с городскими признаками нельзя считать полностью проверенными на отсутствие временной утечки из OSM. Для такой проверки требуется воспроизвести признаки по историческому снимку и повторить оценку. Здания и дороги описывают среду, но не являются доказанными причинами криминальной активности. Полнота OSM неравномерна: ячейка без объектов OSM может соответствовать парку, рынку или недостаточно картированной территории.
7. Три гипотезы
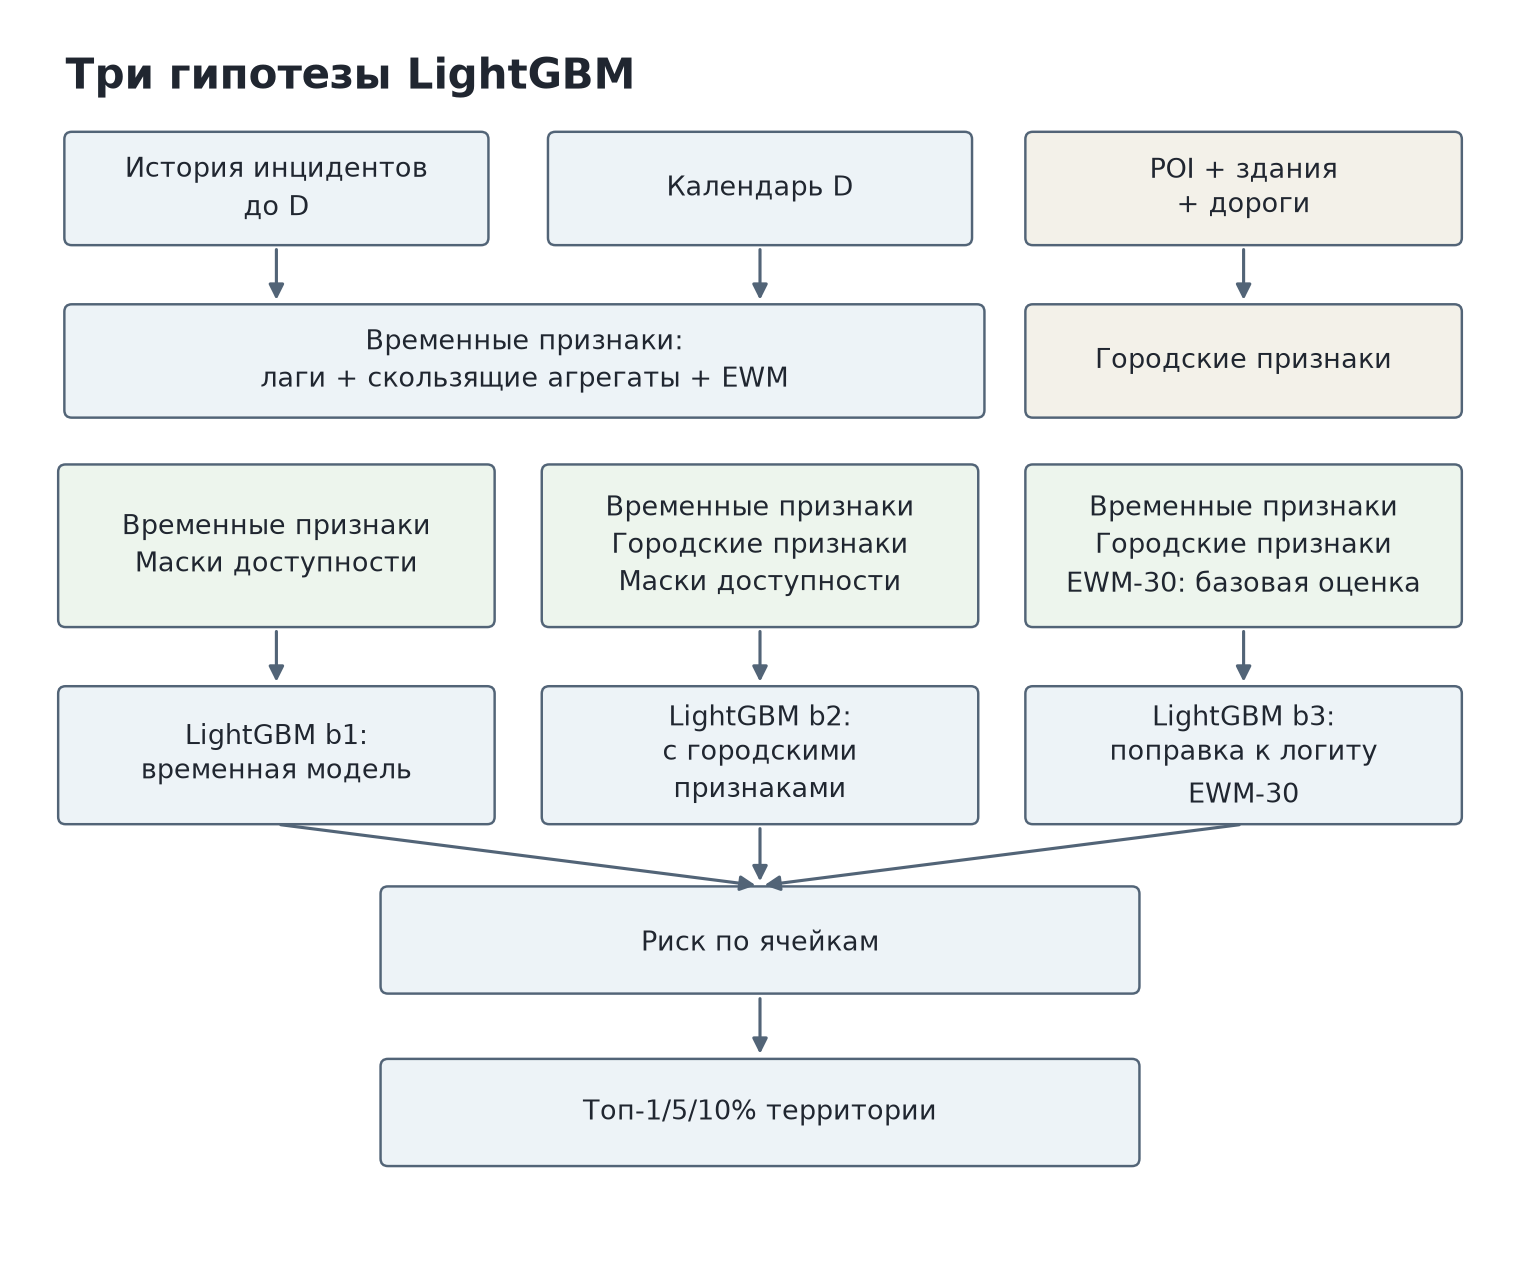
b1 — временная модель: превзойдёт ли модель с историей инцидентов и календарём EWM-30?
b2 — модель с городскими признаками: улучшат ли POI, здания и дороги результат относительно b1?
b3 — модель с поправкой к EWM-30: сможет ли бустинг улучшить логит базовой оценки EWM-30 (далее — prior), сохранив её качество?
В третьей модели бустинг обучает поправку к логиту EWM-30:
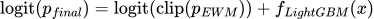 .
Это постановка с базовым логитом (base-margin), а не регрессия на остаток. При нулевой поправке модель должна воспроизводить EWM-30. Для 511 ячеек со скрытой историей оценку p_EWM нельзя пересчитать по недоступным прошлым данным.
8. Что означает PAI@5% = 8,25
Модель ранжирует 2 120 ячеек; hit@5% — доля инцидентов дня, попавших в топ-5% (106 ячеек), с учётом числа инцидентов в каждой ячейке. PAI@5% = hit@5%/0,05 = 8,25. Это коэффициент концентрации, а не «вероятность возрастает в 8 раз»: при равномерном разбросе PAI = 1.
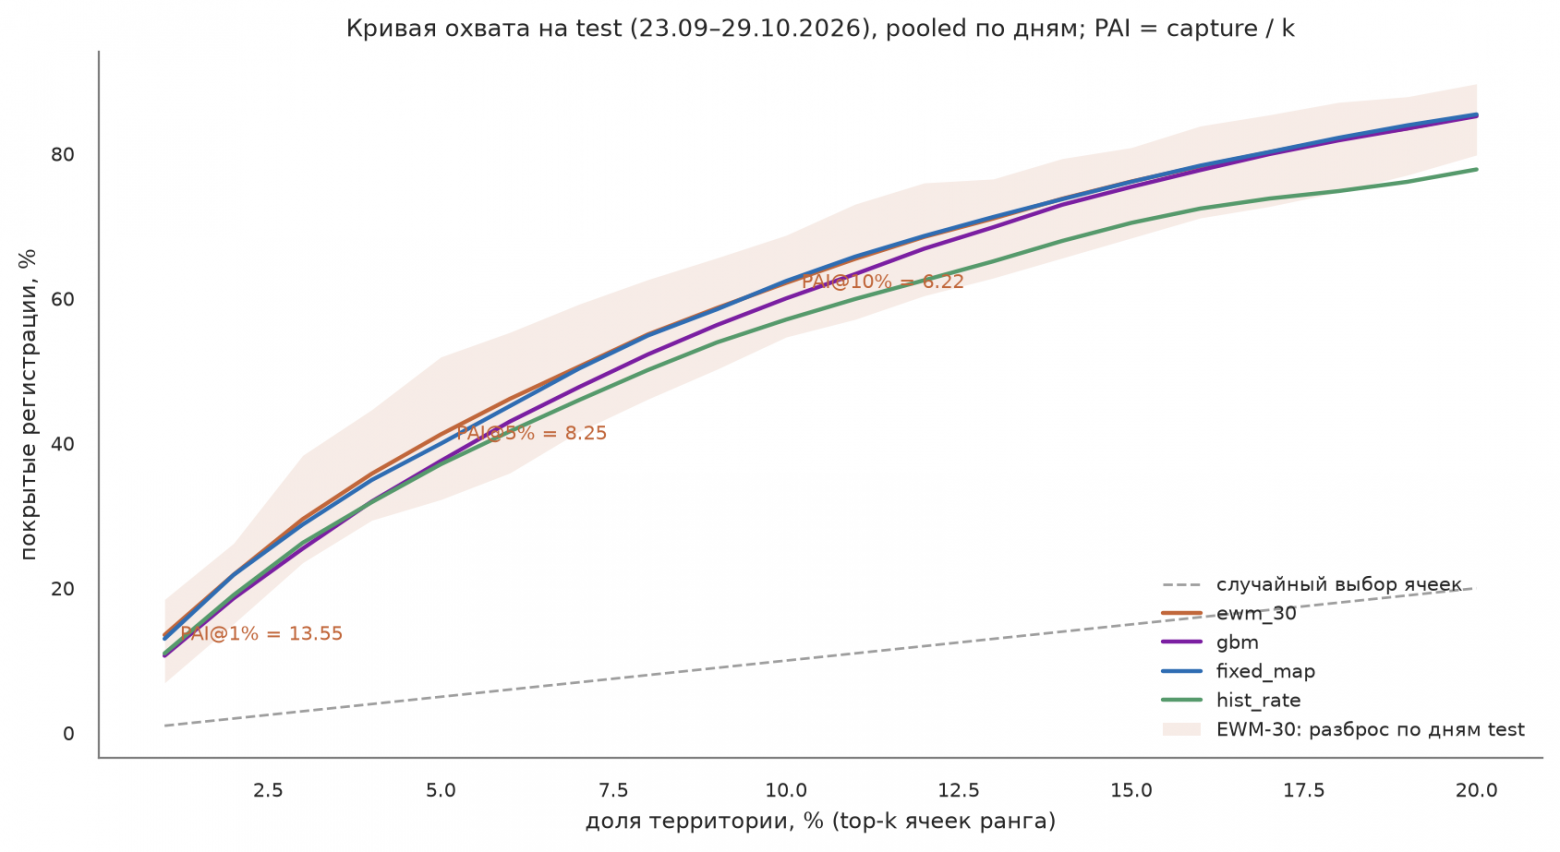
Качество ранжирования и точность вероятностей оцениваются отдельно: у EWM-30 Brier 0,055, ECE 0,4%, ROC-AUC 0,92, PR-AUC 0,49 против случайного уровня 0,084 при доле положительных наблюдений 8,4%. Изотоническая калибровка выполнена на валидационной выборке. Сравнения — только парные на одних днях, неопределённость — дневной блочный бутстрап (10 000, 95% CI):
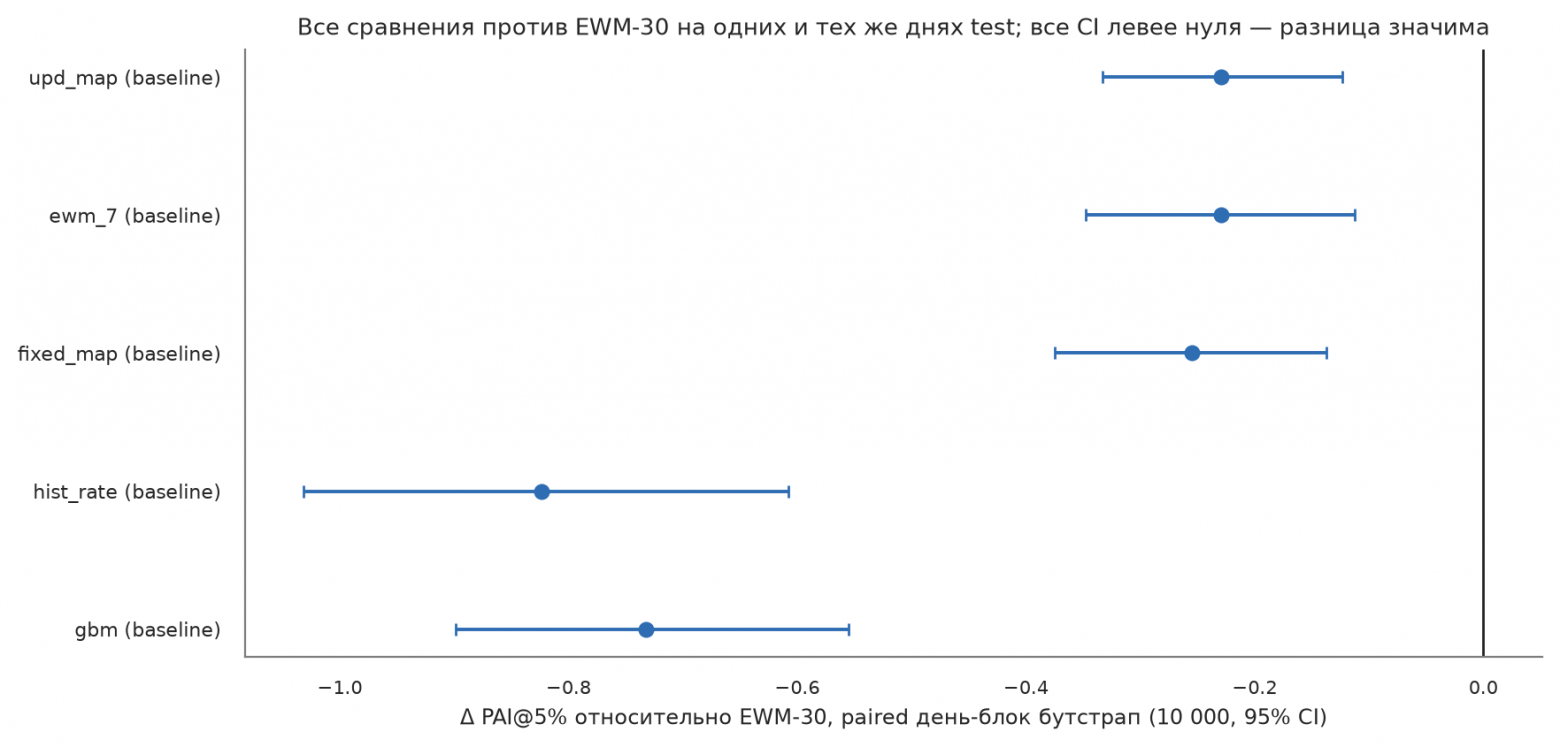
EWM-30 статистически значимо превосходит остальные простые бейзлайны и legacy LightGBM. На рисунке разность определена как PAI@5% сравниваемой модели минус PAI@5% EWM-30: все 95%-ные CI целиком левее нуля, что указывает на преимущество EWM-30. Среднее PAI по запускам с разными случайными инициализациями (сидами) и PAI усреднённого прогноза различаются из-за нелинейности top-k. Расхождение объяснено в аудите оценки; статья использует только прошедший аудит процесс расчёта.
9. Результаты: сильный prior побеждает
Результат соответствует одному из заранее зафиксированных сценариев: EWM-30 значимо выиграла у бустинга во всех девяти парных сравнениях (3 версии × 3 сида, каждый CI целиком левее нуля).
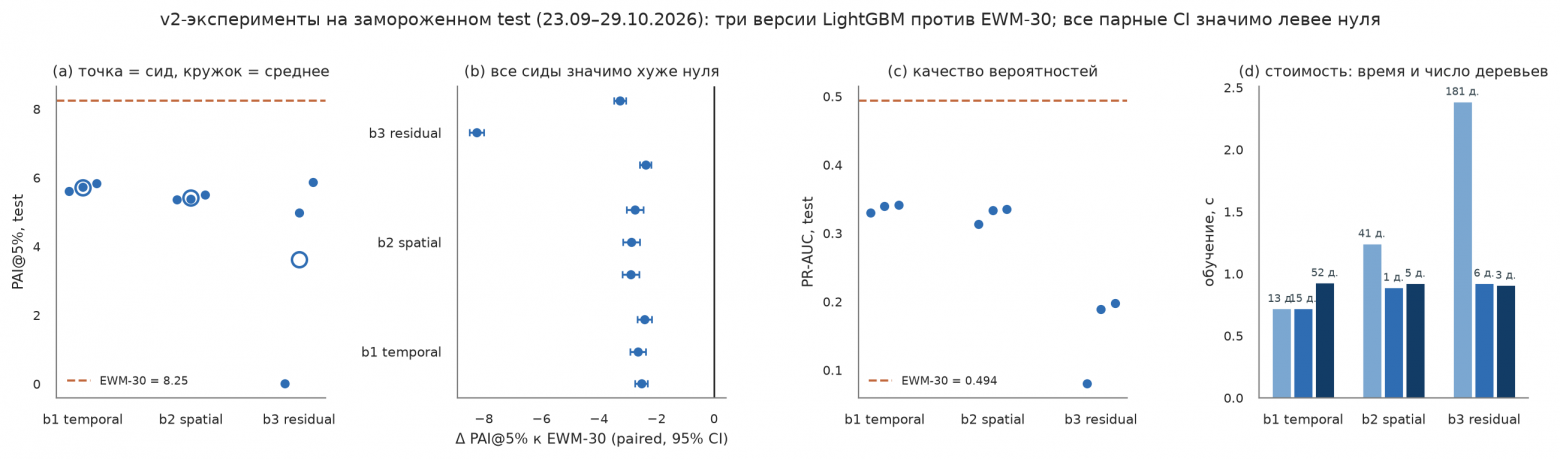
b1 (временная модель): PAI@5% 5,60–5,84 по трём сидам, парная разность −2,4…−2,6;
b2 (модель с городскими признаками): 5,36–5,51 — городские признаки не улучшили временную модель, а чуть ухудшили ранжирование;
b3 (модель с поправкой к EWM-30): нестабильна. Лучший запуск даёт 5,87, худший — 0,007; калибровка существенно ухудшается: Brier 0,47–0,82 против 0,055 у EWM-30. Обучение поправки к сильному prior в этой конфигурации ухудшает и ранжирование, и точность вероятностей.
Из результатов следуют три вывода. Первый: сильный простой prior — не «точка отсчёта для улучшения», а верхняя граница доступной предсказуемости при этом сигнале; b3 показал, что попытка улучшить его без аккуратной регуляризации ухудшает результат. Второй: добавление городских признаков в постановке полного прогноза не работает — их возможная роль в cold start остаётся вопросом §10 и не относится к результатам на полной тестовой выборке. Третий: отставание бустинга при результате legacy LightGBM 7,52 означает, что дело не в библиотеке, а в структуре сигнала: скользящее среднее почти исчерпывает то, что предсказуемо на завтра по ячейкам. Стоимость всех трёх версий — секунды обучения (0,7–2,4 с на сид); основная сложность заключается в корректной оценке, а не в вычислениях.
Главный итог: на вопрос «можно ли обойтись без обучения предиктивной модели, сохранив обучаемую калибровку вероятностей» эксперимент отвечает «да» — по крайней мере до тех пор, пока более сложная модель не использует сигнал, недоступный скользящему среднему. Далее рассмотрим ошибки лучшего простого бейзлайна в дни тестовой выборки с максимальным и минимальным PAI. Правило выбора дней зафиксировано до просмотра карт.
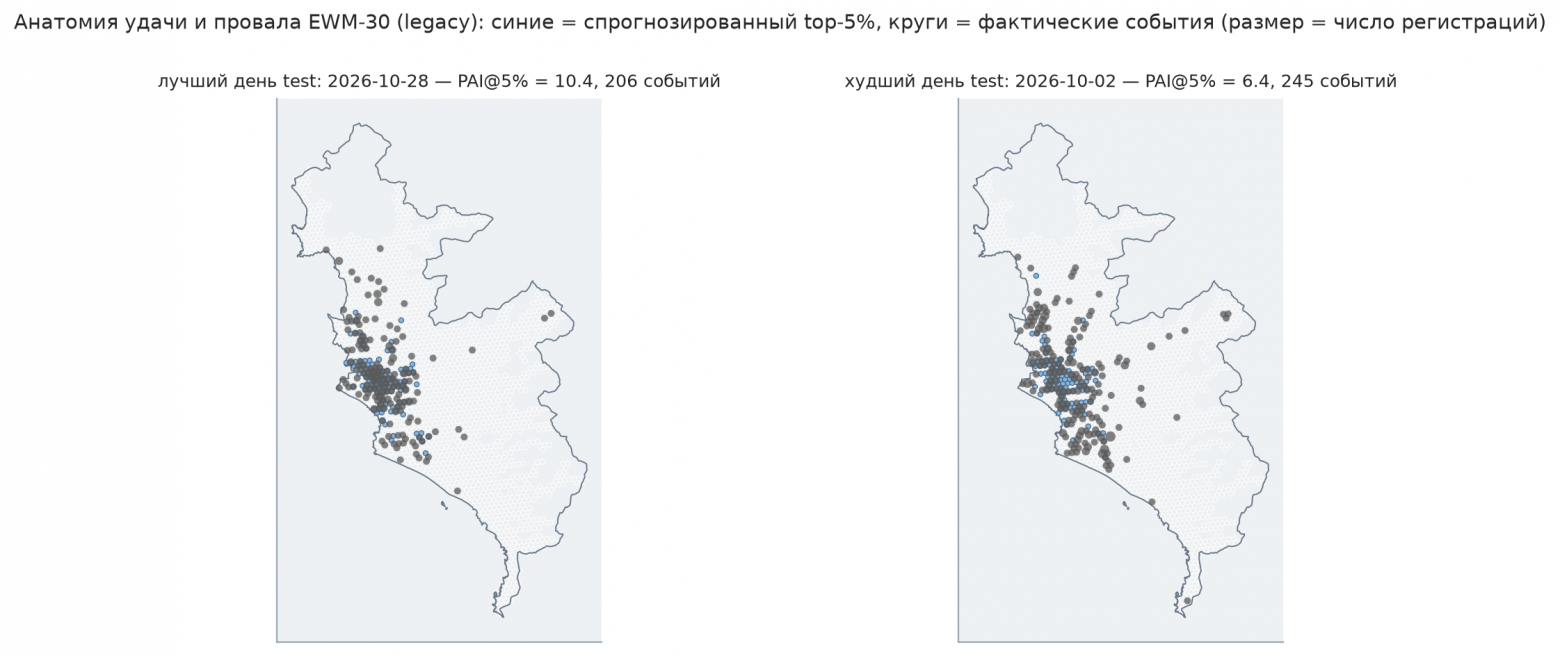
В день с максимальным результатом (28.10.2026) EWM-30 достигает PAI 10,4, с минимальным (02.10.2026) — 6,4. Снижение качества связано с инцидентами в ячейках с обычно низкой активностью: на карте они отмечены кружками за пределами синей зоны топ-5%. Эти отклонения бустинг пытался объяснить с помощью признаков, но не смог.
10. Анонс: DNN-эксперименты
В рассмотренных конфигурациях бустинг уступил EWM-30. В серии экспериментов v2 также представлены нейросетевые модели. Их первые результаты на той же зафиксированной тестовой выборке отличаются: если разность бустинга относительно EWM-30 составляла −2,4 PAI@5% или ниже, то нейросети с поправкой к EWM-30 достигают близких к нему результатов. У лучшего варианта разность составляет −0,03…−0,06 PAI@5%, и его CI включает ноль. Проверка тождественности (сеть, состоящая только из prior) воспроизводит бейзлайн до сотых. Простая MLP без временной и пространственной структуры, напротив, чуть хуже. Результаты мотивируют дальнейшую проверку временной и пространственной структуры.
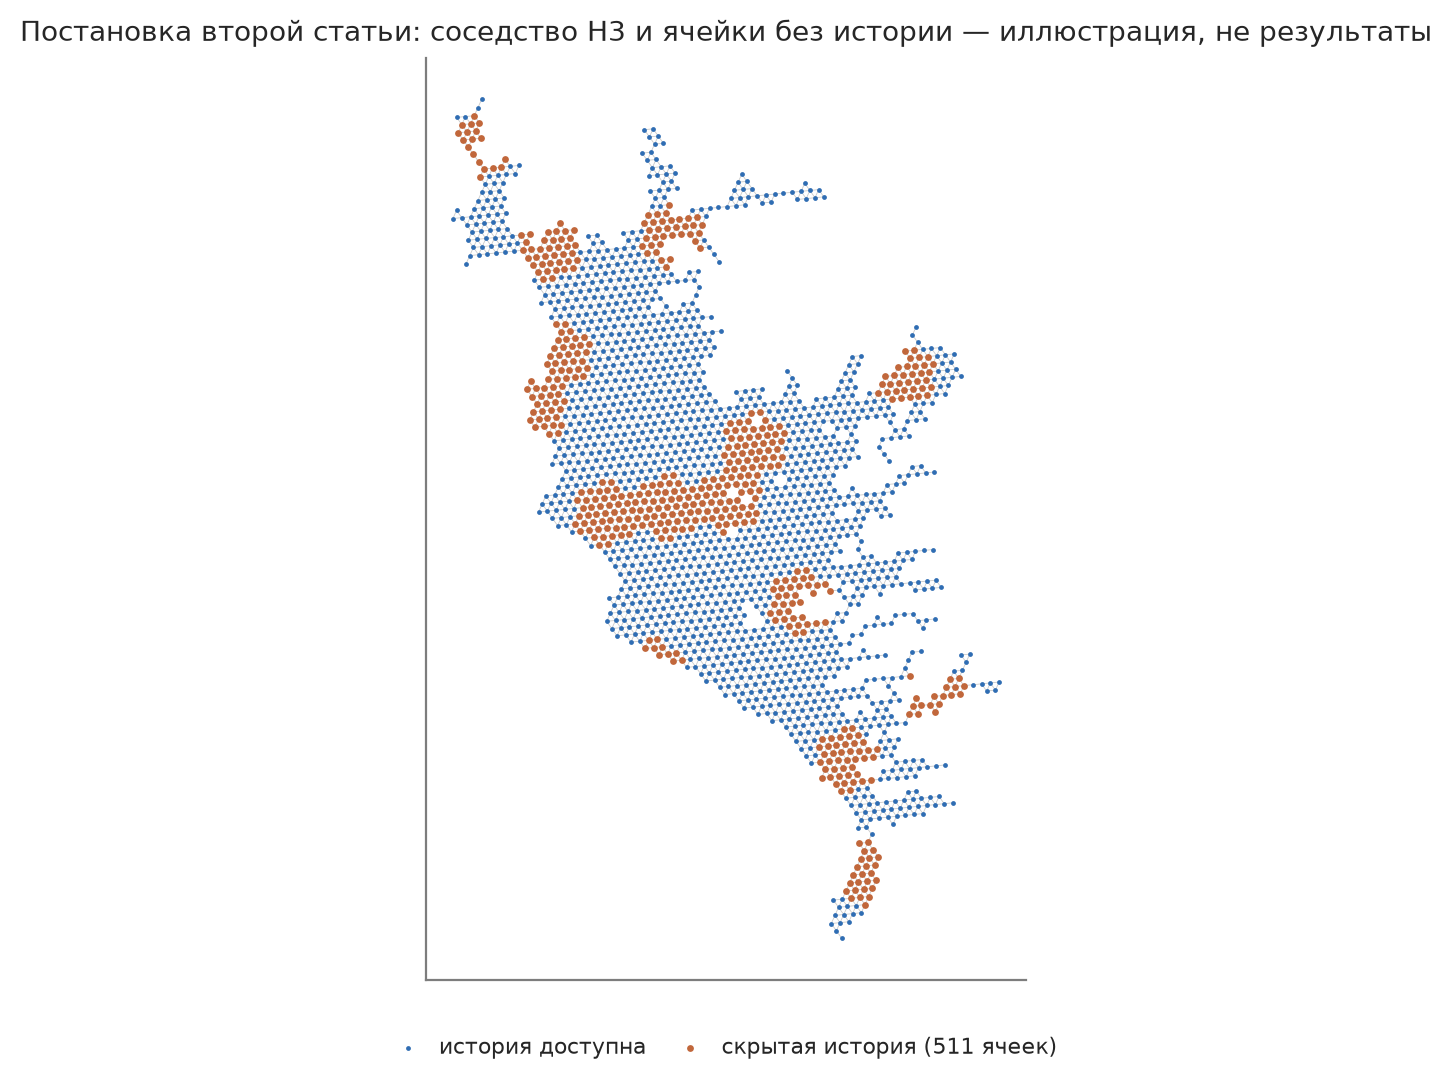
Во второй статье будут рассмотрены следующие вопросы на тех же данных, той же зафиксированной тестовой выборке и с теми же парными CI:
графы: соседство H3, дорожная сеть, графы похожести районов — перенос сигнала между ячейками, которого нет у табличных признаков;
cold start: 511 ячеек со скрытой историей — POI/urban-эмбеддинги, гейты и self-supervised предобучение против статического GBM (PAI@5% = 6,91);
калибровка end-to-end: урок b3 — улучшать логит сильного prior нужно с регуляризацией и контролем Brier, иначе ухудшаются и ранжирование, и точность вероятностей;
предел простого: если и графы не дадут значимой Δ против EWM-30 — это тоже результат: значит, «завтрашняя» география ячеек почти исчерпана вчерашним счётчиком.
Результаты первой статьи показывают, насколько конкурентоспособным может быть простой бейзлайн. Преимущество более сложных моделей не гарантировано. Если в этих данных сохраняется дополнительный сигнал сверх скользящего среднего, его источник — структура времени, города и графа.
Воспроизводимость
Идентификаторы моделей в материалах эксперимента:
b1 — временная модель:
v2_b1_lightgbm_temporal.b2 — модель с городскими признаками:
v2_b2_lightgbm_spatial.b3 — модель с поправкой к EWM-30:
v2_b3_lightgbm_residual.
Аудит расчёта метрик: results/stshn_v2/evaluation_audit.md.
Этическая рамка
Картографируется риск зарегистрированных инцидентов, не «криминальность людей». Данные чувствительны к обращаемости, плотности населения и практикам регистрации; пустая ячейка — не обязательно безопасное место. Публикуются только агрегированные ячейки H3 без сырых координат; результат — не инструмент автоматических санкций или идентификации людей.