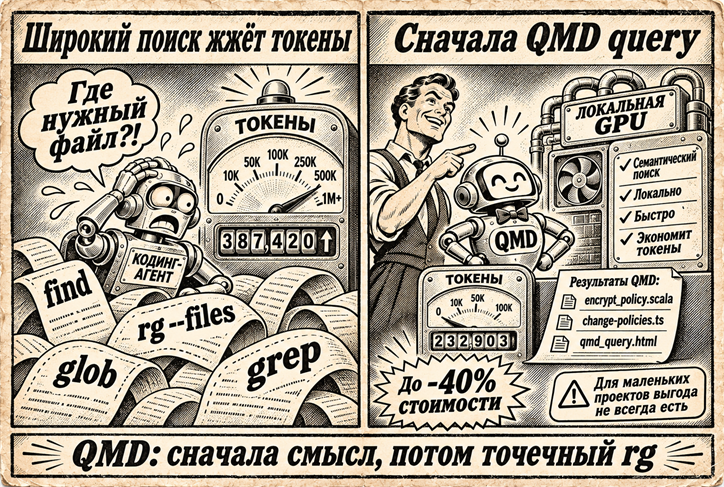
Я заметил что кодинг агенты перед выполнением задачи запускают "find, rg --files, glob" для поиска файлов и нужных классов и модулей. Потом поиск по содержимому файлов через "rg, grep". И на это сжигается много токенов. И я решил проверить можно ли сэкономить на токенах используя семантический поиск вместо всего выше перечисленного. Если локальный GPU простаивает, почему бы тогда на нем семантический поиск не гонять.
Сам я работаю в компании связанной с безопасностью. И в одном из моих проектов я использую семантический поиск чувствительных документов. И тут мне знакомый присылает ссылку на OpenSource проект который тоже занимается этой задачей. Проект называется "QMD - Query Markup Documents". Работает из командной строки, извлекает текст из всех форматов документов и создает индекс. Поддерживает он несколько вариантов поиска:
# Search across everything
qmd search "project timeline"           # Fast keyword search
qmd vsearch "how to deploy"             # Semantic search
qmd query "quarterly planning process"  # Hybrid + reranking (best quality)
Нас интересует последний вариант. Чтобы он работал требуется 3 вещи:
embeddinggemma-300M-Q8_0 Vector embeddings (default) ~300MB
qwen3-reranker-0.6b-q8_0 Re-ranking ~640MB
qmd-query-expansion-1.7B-q4_k_m Query expansion (fine-tuned) ~1.1GB
Первая модель используется для индекса чтобы вычислить смысловые вектора кусков текста. Вторая используется чтобы сравнить то что было найдено насколько оно близко по смыслу с поисковым запросом. Ну а третья чтобы нагенерить несколько поисковых запросов из исходного запроса чтобы поиск был шире.
Сначала надо добавить свои исходники в qmd (это пример для минималистичный проект где сервер на Rust а фронтенд на Angular):
qmd collection add . \
  --name PROJECT1 \
  --mask "src/**/*.rs,\
frontend/src/**/*.{ts,html,scss},\
README.md,\
frontend/README.md,\
Cargo.toml,\
frontend/package.json,\
frontend/angular.json,\
frontend/tsconfig*.json,\
frontend/proxy.conf.json"
Можно руками не делать этого - покажите пример этого своему кодинг агенту и скажите сделай также только для текущей репы - он сам догадается что в индекс добавить какие папки, расширения - что исключить и тд.
Теперь запустим индексацию (ее надо перезапускать периодически когда у вас кодовая база меняется):
qmd update && qmd embed -c PROJECT1
Чтобы сдружить кодинг агента с этой qmd ему нужно в AGENTS.md добавить следующее:
# QMD — Efficient Code Discovery

**Цель:** минимизировать стоимость токенов и время поиска кода без ущерба корректности.

## Выбор инструмента

- Известен путь → читай файл напрямую.
- Известен идентификатор, ошибка или строка → `rg` / LSP.
- Известно только поведение → `qmd query`.
- Код найден → изучай необходимые участки через стандартные инструменты.
- Информации достаточно → выполняй задачу.

**QMD заменяет первоначальный широкий поиск, а не добавляет новый этап.**

## Семантический поиск

Используй существующую коллекцию проекта.

"""
qmd query "DESCRIPTION" -c PROJECT1 -n 15 --files \
  | grep -E '\.(EXT1|EXT2|EXT3)$' \
  | cut -d, -f3- \
  | sed 's|^qmd://[^/]*/||' \
  | head -n 10
"""

- Один конкретный запрос, предпочтительно с английскими техническими терминами.
- Выбирай расширения по проекту, включая конфигурационные при необходимости.
- Читай сначала 3–5 наиболее релевантных файлов, только нужные участки.
- Если реализация не найдена — уточни запрос, при необходимости увеличь `-n` до 60, затем используй `rg` / LSP.
- После обнаружения реализации прекрати семантический поиск.

## Экономия токенов

- Не сканируй весь репозиторий перед QMD.
- Не повторяй поиски без причины и не открывай все результаты.
- Не исследуй несвязанный код и зависимости.
- Не составляй подробных планов и отчётов о поиске.
- Не пересказывай прочитанный код.
- Как только информации достаточно — вноси изменения и проверяй результат.

**Приоритет: корректность → стоимость токенов → время.**
Тестировал я вот на таком вот репозитории где 1231 исходный файл на Java/Scala/Angular:
C:\Users\igumn\jcm-server>qmd collection list
jcm-server (qmd://jcm-server/)
  Pattern:  server/src/**/*.scala,server/src/**/*.java,server/src/**/*.xml,server/src/**/*.properties,server/src/**/*.js,server/src/**/*.ts,server/src/**/*.css,server/src/**/*.html,server/src/**/*.tmpl,server/src/**/*.txt,server/src/**/*.md,server/pom.xml,server/Dockerfile,server/*.md,server/README.txt,web/src/**/*.ts,web/src/**/*.html,web/src/**/*.scss,web/src/**/*.css,web/package.json,web/angular.json,web/tsconfig*.json,web/karma.conf.js,web/README.md,!server/src/main/resources/templates/**,!server/src/main/resources/messages*,!server/src/main/resources/messages*/**,!web/src/assets/lang/**
  Files:    1231
  Updated:  1h ago
Промпт: "Добавь в полиси шифрования дисков флаг антиквантовое шифрование - по умолчанию оно выключено - т.е. оно должно в редактировании полиси задаваться в веб-интерфейсе - сохраняться в БД и передаваться на агента как полиси шифрования через REST-эндпоинт"
Сравнение стоимости
По тем же тарифам GPT-5.3-Codex: Input $1,75, Cached $0,175, Output $14 за 1 млн токенов.
Метрика | С QMD | Без QMD | Разница |
|---|---|---|---|
Input | 65 006 | 101 501 | -35,96% |
Cached input | 317 568 | 1 191 808 | -73,35% |
Output | 13 859 | 16 348 | -15,23% |
Reasoning | 9 607 | 11 260 | -14,68% |
Стоимость | $0,3634 | $0,6151 | -40,92% |
Теперь QMD экономит 40,92% стоимости!
Особенно заметно снижение cached input: почти в 4 раза.
Промпт: "Добавь в полиси стирания поле "dry" - нужно его редактировать в веб-интерфейсе и сохранять в БД - также передавать через /rest эндпоинт на агент который занимается стиранием - по умолчанию значение false"
Расчёт по прежним тарифам GPT-5.3-Codex: Input $1,75, Cached $0,175, Output $14 за миллион токенов.
Сравнение
Метрика | QMD | Без QMD | Разница |
|---|---|---|---|
Input | 77 167 | 98 042 | −21,29% |
Cached input | 936 832 | 854 912 | +9,58% |
Output | 17 322 | 16 259 | +6,54% |
Reasoning | 8 835 | 10 264 | −13,92% |
Стоимость | $0,5415 | $0,5488 | −1,33% |
Здесь QMD оказался дешевле на 1,33%. Экономия есть, но небольшая.
Вывод: QMD сократил обычные входные токены на 21,3% и reasoning на 13,9%, но увеличение cached input и output почти полностью съело экономию.
В общем разброс экономии от 40% стоимости до 1%. По-моему неплохой результат. Надо конечно выборку побольше делать. Но я уже спать хочу. Пишите в комментариях кто больше выборку сделал и какие результаты.
PS
Рекомендую проверять не попадает ли хлам в ваш индекс. Попробуйте сами запустить смысловой запрос. Я один раз прошляпил скомпилированные .js файлы и большие lang-файлы - они сильно засоряли результат семантического поиска. Вот пример, как запустить руками поиск:
C:\Users\igumn\jcm-server>qmd query "disk encryption policy editing form persisted setting sent to endpoint for agent" -c jcm-server -n 15 --files
Expanding query... (3.0s)
├─ disk encryption policy editing form persisted setting sent to endpoint for agent
├─ lex: disk encryption configuration
├─ lex: disk encryption policy
├─ vec: disk encryption configuration
├─ vec: disk encryption policy
└─ hyde: The topic of disk encryption policy editing form persisted setting se...
Searching 6 queries...
Embedding 4 queries... (1.5s)
Reranking 40 chunks... (3.3s)
#d70022,1.00,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/domain/common/bcvolume/EncryptPolicy.scala
#732b09,0.63,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/service/ajax/common/EncryptSettingsManager.scala
#e66494,0.63,qmd://jcm-server/web/src/app/modules/management/components/company/dialogs/add-or-update-policies/add-or-update-policies.component.html
#413c5e,0.62,qmd://jcm-server/web/src/app/modules/management/components/group/dialogs/change-policie/change-policies.component.html
#413c5e,0.62,qmd://jcm-server/web/src/app/modules/management/components/computer/dialogs/change-policie/change-policies.component.html
#758b4d,0.62,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/service/mcp/McpFacade.scala
#4e8973,0.62,qmd://jcm-server/web/src/app/modules/management/components/group/dialogs/change-policie/change-policies.component.ts
#bef78e,0.62,qmd://jcm-server/web/src/app/modules/management/components/computer/dialogs/change-policie/change-policies.component.ts
#4fcd1c,0.61,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/service/mcp/McpToolbox.scala
PPS
Пробовал на маленьком проекте из 27 файлов. Наоборот вышло +60% стоимости. Решение оказалось избыточное. В общем пользуйте только на больших кодовых базах.