PostgreSQL — одна из самых распространенных СУБД с открытым исходным кодом. За многие годы развития вокруг неё собралось сильное сообщество разработчиков. Как следствие существует немало проектов на этой СУБД. Вместе с потребностями бизнеса растут обслуживающие их базы данных и наступает момент, когда работать на одном кластере становится затруднительно. Тогда приходится расширять систему. Есть много способов сделать это: кэши, очереди, балансировка нагрузки между мастером и репликой, и так далее. В данной статье мы расскажем о горизонтальном масштабировании PostgreSQL на базе шардинга: какие есть трудности у этого подхода и как мы побороли.
Когда может понадобится шардинг?
PostgreSQL можно использовать для разнообразных нагрузок. Однако рано или поздно наступает момент, когда пользователей становится много, а размер таблиц — слишком большим. Есть ряд проблем, с которыми вы неизбежно столкнётесь.
Первым делом вы, скорее всего, упретесь в лимит подключений. С одной стороны, увеличить его нетрудно: это потребует лишь перезагрузки сервера. Давайте подумаем, что будет происходить дальше, когда с увеличением числа клиентов увеличится и нагрузка на СУБД.
Команды UPDATE и DELETE не удаляют данные с диска сами по себе. В PostgreSQL реализован метод MVCC, согласно которому у каждой строки может быть несколько версий. Это один из способов реализовать ACID в рамках стандарта и повысить пропускную способность системы. Читающий запрос не будет заблокирован пишущим, а просто увидит актуальную для своей транзакции версию строки. После фиксации пишущей транзакции (commit) предыдущая версия строки отмечается специальным флагом как устаревшая и будет удалена с диска позже. Это делает специальный процесс под названием VACUUM.
VACUUM накапливает определённую долю «мертвых» версий строк (tuple), после чего начинает их удалять. Для больших таблиц процесс очистки затягивается, так как на одну таблицу приходится только один vacuum worker.
Партиционирование поможет распараллелить эту работу, но RAM и CPU остаются общими для всех частей таблицы. Также оно бессильно, если большое количество строк заблокировано какой-либо длинной транзакцией (типа OLAP), ведь пока эти строки используются ею, пусть и читающей, они не помечены как устаревшие, следовательно, не очищаются. При этом счётчик транзакций продолжает увеличиваться, а он не является безграничным и может переполняться.
В PostgreSQL есть механизм заморозки, который предотвращает такие ситуации, но за ним надо следить, в противном случае случится переполнение (wrap around). Процесс увеличения размера таблиц из-за большого количества устаревших версий строк в системе называется распуханием (bloating, bloat). Увеличение объёма таблиц приводит к бОльшим затратам времени на их обход, что замедляет выполнение запросов.
Другой распространённый тип нагрузки — маленькие, точечные, частые (типа OLTP) запросы. Они могут провоцировать частое обновления буферного кэша, и, как следствие, активное чтение и запись на диск. Кроме того, для каждого клиентского подключения PostgreSQL инициирует системный вызов fork(), порождающий новый процесс в операционной системе, что считается дорогим.
Нельзя обойти стороной и вопрос резервного копирования, которое может быть продолжительным процессом. Даже если используемая для этого утилита поддерживает параллельную работу, пропускная способность диска ограничена в любом случае.
Кажется, что апгрейд железа, партиционирование, перенаправление части читающих запросов на реплику и использование пулера могут решить эти проблемы. Однако и у таких решений есть предел для роста, так как латать дыры в производительности железом рано или поздно станетит дорого, партиционированние таблиц не решает проблему медленных бэкапов, не облегчает нагрузку на диск и оперативную память. Реплика, если она синхронная, может удерживать старые версии строк на мастере, а если она является асинхронной, то приложение, записавшее данные на мастер, может не обнаружить их, если следующий же читающий запрос будет переадресован на реплику. Пулер способен сгладить некоторые проблемы, связанные с обслуживанием новых подключений, однако он сам по себе не уменьшит количество запросов, которое зависит от внешних факторов.
Что такое шардинг?
Поговорим о подходе, когда данные раскладываются на разные БД по заранее выбранному принципу (время добавления, географический принцип или просто равномерно). Метод горизонтального маштабирования СУБД, при котором данные физически хранятся на разных серверах и связаны в некоторую систему, называется шардингом. Каждый отдельный мастер может состоять в системе как сам по себе (но это приведёт к недоступности данных при его сбое), так и с репликой.
Посмотрим, как этот подход к горизонтальному маштабированию решает проблемы, указанные выше: большие таблицы разделены на части и распределены по кластеру, их очистка происходит быстрее, при этом для каждого мастера выделены свои RAM, CPU и диск; запросы можно выполнять на разных узлах кластера в зависимости от локализации данных; пул коннектов для подключения каждого сервера распределённой системы индивидуален; каждый бэкап выполняется на своём сервере. Если распределённый кластер приближается к некоторому пределу по производительности, то можно просто добавить сервер в систему, не изобретая принципиально новых подходов.
У шардирования есть разные подходы. Условно их можно разделить на шардирование на уровне СУБД и на уровне клиента (или клиентского приложения).
При первом подходе СУБД обладает информацией о распределении данных, их видимости и способна оперировать ею при планировании запросов. При этом запрос может как целиком выполняться на одном узле, вытягивая данные на целевой, так и агрегировать результаты с разных «рабочих» узлов. Это поведение зависит от реализации конкретной распределённой СУБД.
При втором подходе сведениями о данных обладает приложение. Оно решает, из какого сервера их тянуть и как оптимизировать кроссшардовые запросы.
Давайте рассмотрим, какой метод мы выбрали в Postgres Pro Shardman, проблемы, с которыми мы столкнулись, и их решения.
Postgres Pro Shardman
Postgres Professional — российский вендор СУБД и других продуктов для работы с данными. Компания существует с 2015 года и внесла большой вклад в развитие оригинального PostgreSQL. Продукты Postgres Pro ориентированы на компании с объёмными СУБД, высокой нагрузкой и строгими требованиями к безопасности. Postgres Pro Shardman разрабатывается c 2020 года. На тот момент уже существовали другие форки, которые так или иначе поддерживали технологию шардинга, однако не было продукта, который удовлетворял следующим требованиям:
нужно предоставить пользователям простой способ увеличить производительность путём добавления узлов без остановки сервера;
ориентация на OLTP-нагрузку;
все узлы мастера равнозначные, доступ к кластеру осуществляется через любой из них;
должна быть реализована отказоустойчивость, чтобы выход из строя одного сервера не приводил к обрушению всего кластера;
строгие гарантии согласованности операций в кластере: для конечного пользователя база должна выглядеть как находящаяся на одиночном сервере с поддержкой ACID-транзакций.
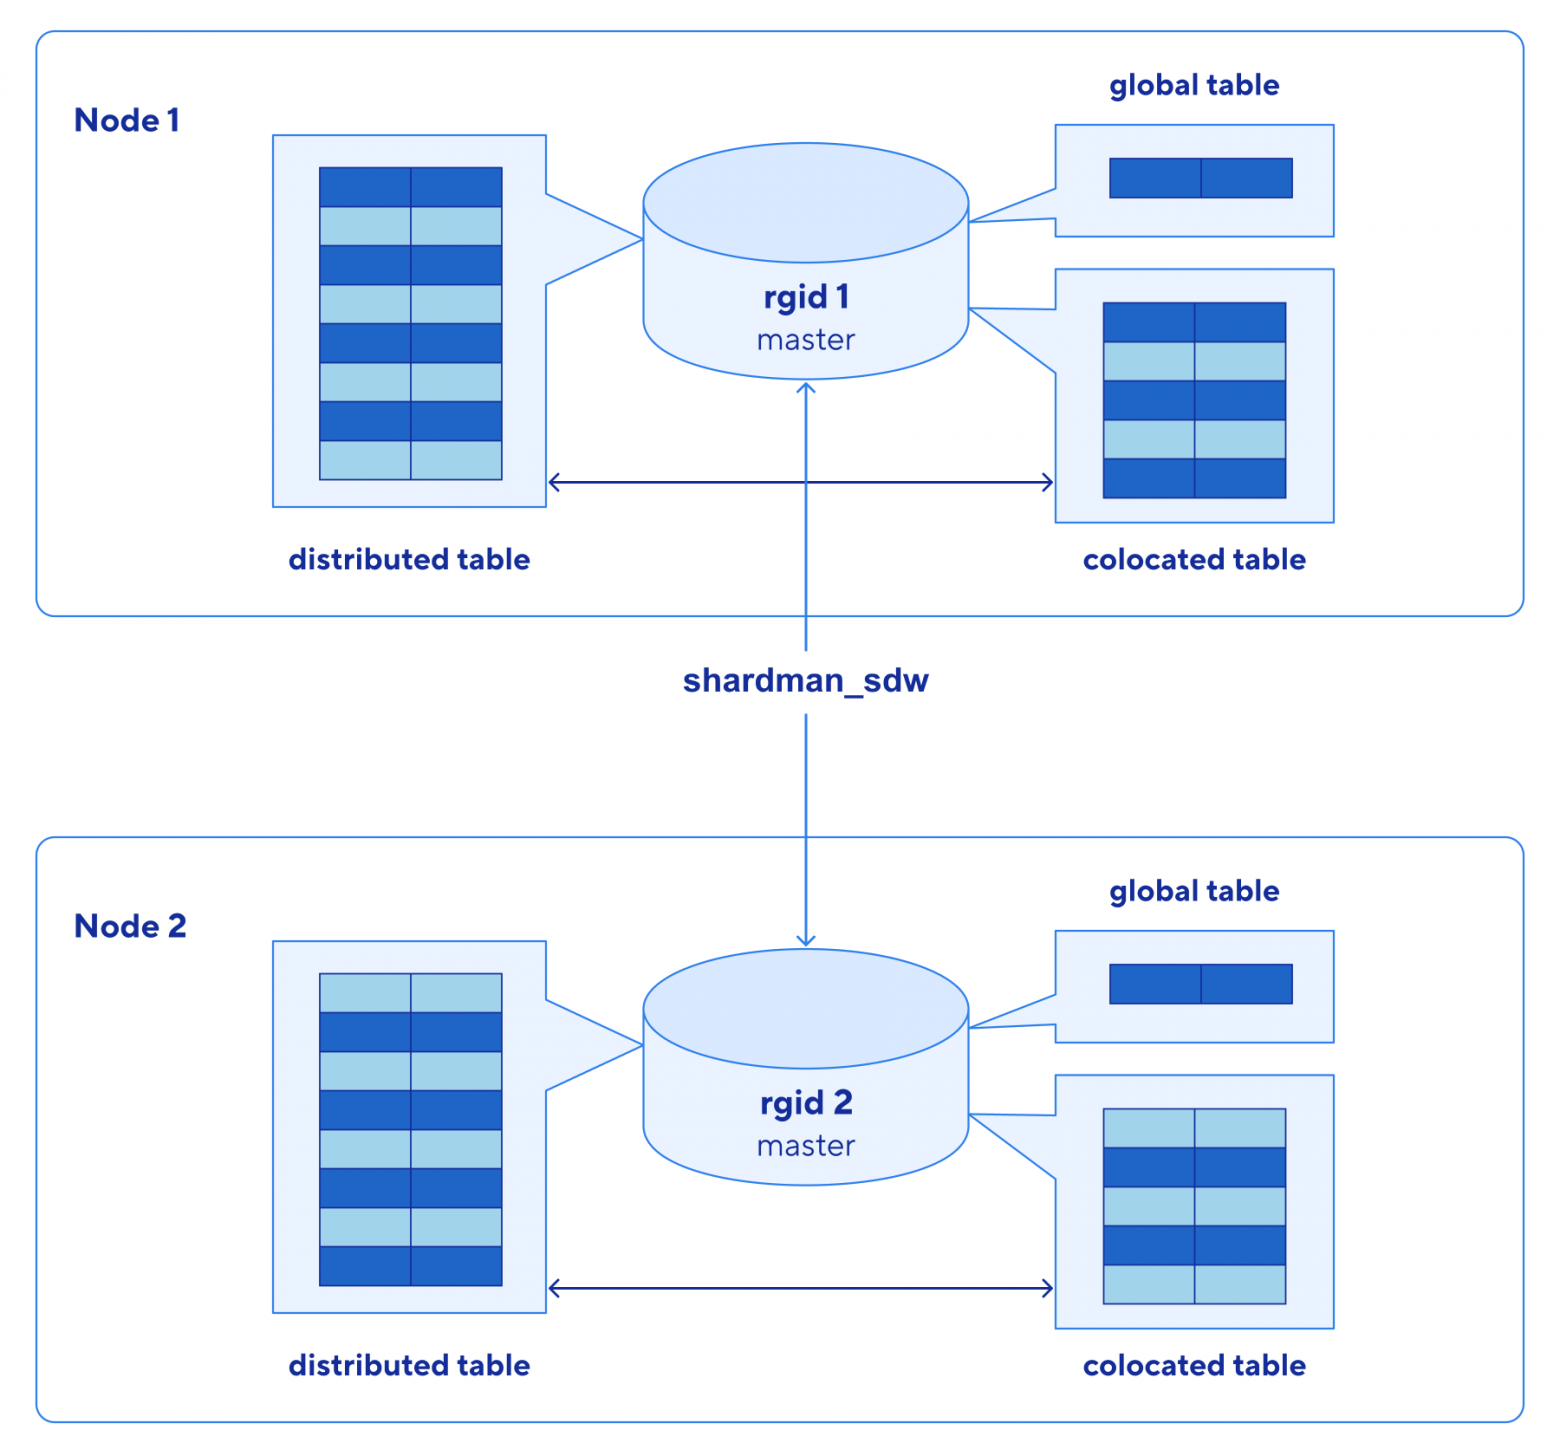
В основе шардирования в Postgres Pro Shardman лежит связка из партиционированных таблиц и shardman_fdw (foreign data wrapper), основанного на базе postgres_fdw, но существенно переработанного. Части таблиц располагаются на разных узлах. Само разделение происходит по хэшу ключа партиционирования, что в теории должно обеспечивать равномерное распределение узлов. Число секций распределённой таблицы подбирается в зависимости от количества узлов в целевой архитектуре распределённого кластера.
В Shardman вместо понятия ключа партиционирования таблиц, распределённых по всей системе, используется термин «ключ шардирования». Если есть соответствие между значениями ключа двух таблиц, то их можно уложить так, чтобы строки с одинаковым значением попали на один сервер. Данный подход к размещению секций называется колоцированнием (co-locate, см distributed table и colocated table на схеме ниже). Если данные меняются редко, можно использовать реплицируемые (глобальные, global table на схеме) таблицы, отличающиеся от секционированных тем, что их содержимое синхронно на всех узлах.
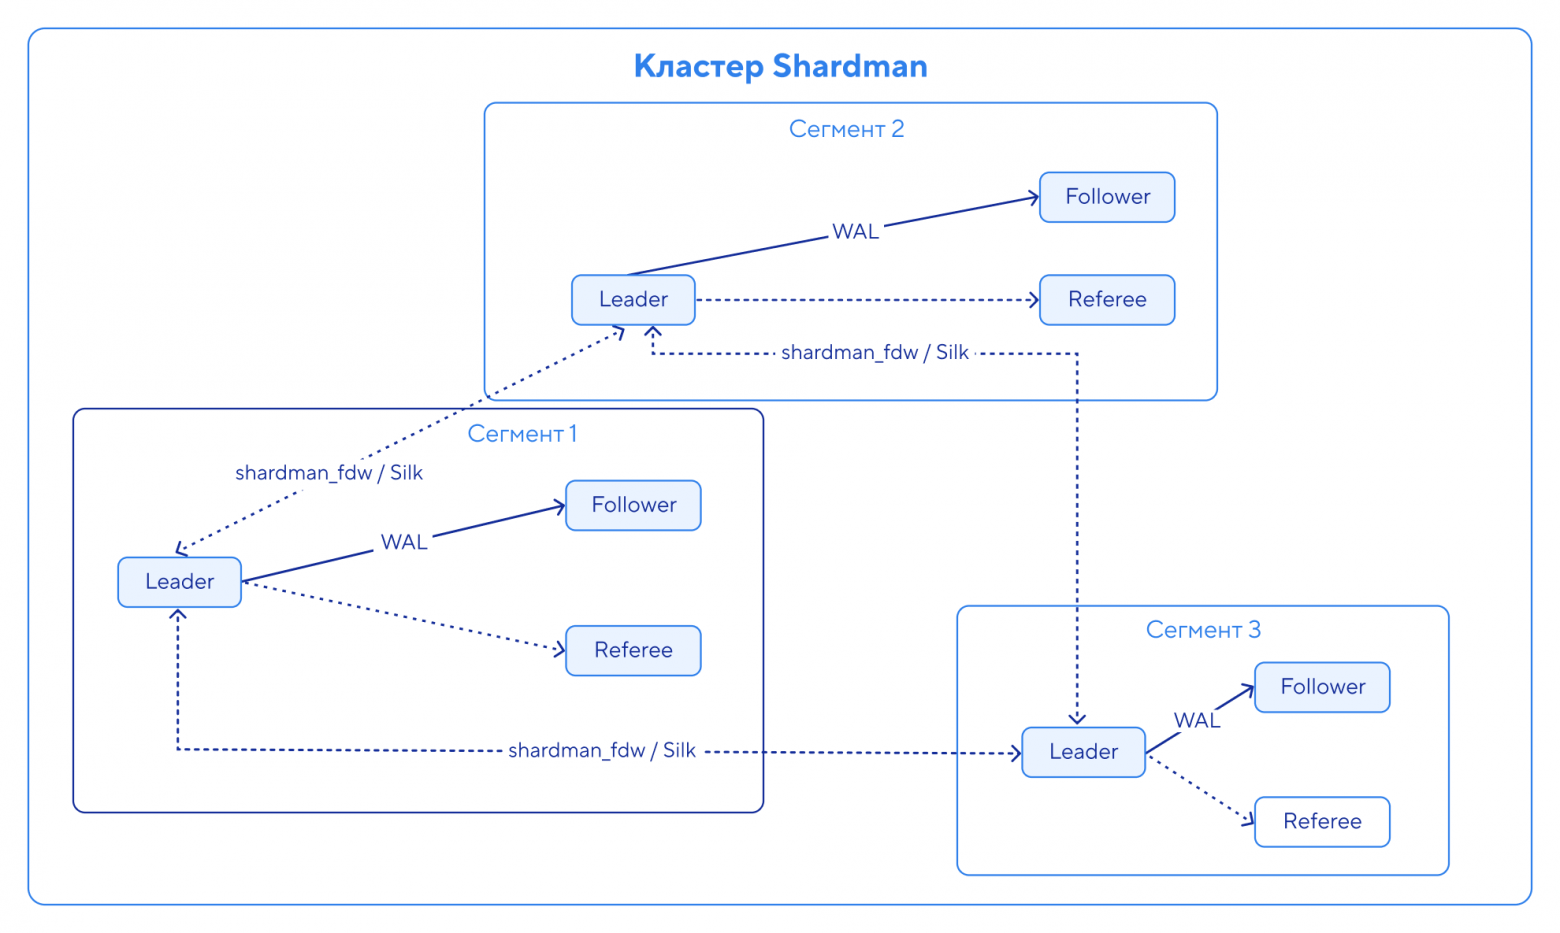
Каждый отдельный шард находится под управлением Postgres Pro BiHA (Build in High Availability), отказоустойчивого кластерного ПО. У этого решения много преимуществ по сравнению с аналогами: оно не требует распределённого DS (data storage); если ваши БД довольно большие (а в случае шардирования вокруг каждого мастера потребуется выстраивать подобную инфраструктуру), то для кворума не придётся поднимать определенное количество реплик, для этой цели существует специальный компонент BiHA — Referee. Напомним, что кворум нужен для того, чтобы избежать split brain — ситуации, когда в системе, состоящей из мастера и нескольких реплик, при сбое сети отказоустойчивый кластер разделяется на две изоированные подсети, в каждой из которых избирается свой отдельный мастер, и с течением времени на них расходятся данные. Но основное преимущество этого решения в том, что оно встроено и не требует дополнительной настройки, как pgpool, stolon, patrony. Далее мы будем придерживаться следующей терминологии:
Сегмент — логическая единица размещения данных. С точки зрения пользователя это точка входа в кластер: подключившись к любому сегменту, пользователь получает доступ ко всему кластеру. Каждый сегмент хранит часть шардированных данных и обрабатывает запросы к ней независимо от других, они равноправны и взаимодействуют между собой.
Репликационная группа — физическая реализация сегмента. Это набор узлов (инстансов PostgreSQL), объединённых в BiHA-кластер: один лидер, один или несколько фолловеров и рефери. Каждой репликационной группе соответствует свой уникальный rgid. Размещение узлов репгруппы может быть произвольным. На схеме ниже все компоненты репликационной группы собраны в квадрат.
Поднимаемся на уровень выше. Для управления репгруппами были разработаны утилиты, которые реализуют функции по управлению распределённым кластером из интерфейса командной строки. Используя утилиты администратор может получить актуальную информацию о компонентах, изменить конфигурацию сервера, сделать согласованную резервную копию или добавить новый сегмент или реплику/рефери в репгруппу. Утилиты обладают актуальной информацией о состоянии кластера и также способны проводить диагностику, которая производится как на уровне всего распределённого кластера, так и на уровне определённого мастера. Все ведущие сервера шардов связаны между собой специальным транспортом (изображён пунктирной линией на схеме), который обеспечивает быстрый обмен данными при выполнении распределённых запросов.
Отдельно хочется упомянуть решение по резервному копированию Postgres Pro Backup Enterprise, которое было разработано в Posrgres Prosessional. Оно работает быстрее стандартного pg_basebackup. Сам Pro Backup управляется утилитами, так что пользователь может даже и не заметить его. Однако есть ряд полезных функций, о которых стоит помнить: поддержка s3, возможность создавать согласованные инкрементальные резервные копии, объединять их и валидировать. Также есть поддержка временных линий и PITR восстановления.
Теперь, когда мы обсудили архитектуру PostgresPro Shardman поговорим о проблемах, с которыми мы столкнулись и о том, как мы их решили.
Кроссшардовые запросы
Если данные, нужные одному запросу, расположены на разных узлах, то приходится тянуть их (сырые или обработанные, агрегированные) на один из сегментов и там обрабатывать, что порождает целый ряд трудностей.
Проблема интерконнекта. Если использовать для транспорта fdw, то для каждого подключения к сегменту с целью забрать необходимый фрагмент данных требуется свой backend, а это дорогой системный вызов fork() и занятый слот клиента. При этом, возможно, придётся подключаться ко всем узлам. Если в системе N узлов и M параллельных пользователей, то потребуется до M × N клиентских подключений. Такая конфигурация в кластере может приводить к большому числу внутрикластерных подключений и процессов, а также неэффективному использованию сетевого канала и процессора.
Статистика. Её необходимо агрегировать с каждого мастера на всём кластере.
Планировщик. Требуется, чтобы вычисления производились рядом с данными, а объём, передаваемый по сети, был минимален. Такое планирование требует существенных доработок как ядра так и fdw.
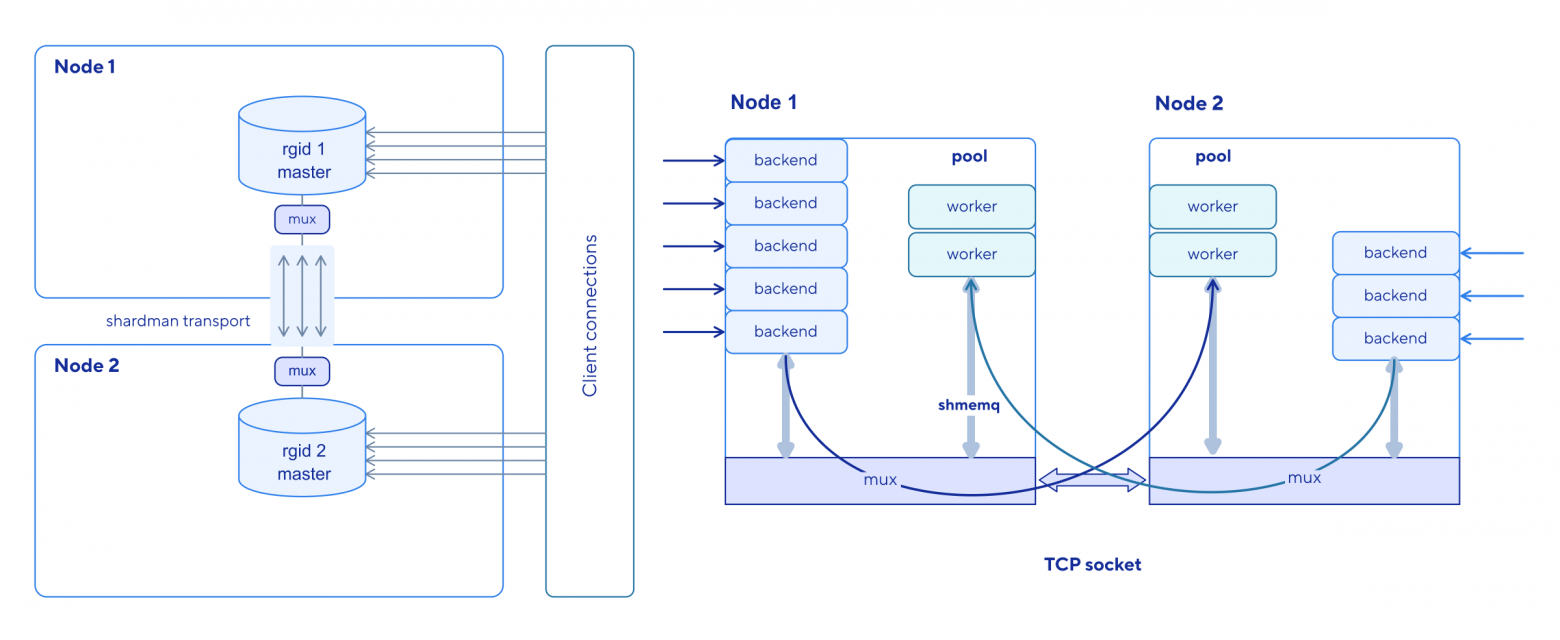
Для решения проблемы интерконнекта была разработана специальная подсистема, которая включает мультиплексирующий транспорт и новую модель выполнения удалённых запросов на фиксированном числе процессов-обработчиков (Shardman InterLinK, Silk). На каждом шарде работает специальный роутер запросов (silkroad, mux на схеме), к которому обращаются локальные бэкенды СУБД PostgreSQL через разделяемую память, если им нужно отправить запрос на другие шарды. Процессы‑мультиплексоры разных шардов связаны друг с другом одним подключением. Как только мультиплексор другого шарда получает запрос, то передаёт его одному из обработчиков (silkworm, worker на схеме) через разделяемую память. Такая схема позволила значительно сократить количество используемых соединений. В общем случае формула для расчёта числа подключений в кластере выглядит как N × (N – 1) + M, где N — количество шардов, а M — количество внешних клиентских подключений. Вместе с сокращением числа подключений и процессов был оптимизирован сетевой протокол. Shardman_fdw при этом выступает в качестве интерфейса для Silk. Сейчас этот транспорт обслуживает только читающие транзакции.
Для многих типов запросов были разработаны оптимизации, подробного описания которых вполне хватило бы на ещё одну статью, так что пройдёмся здесь по ним кратко. Оптимизированы различные типы join, планировщик может проталкивать целые подзапросы на удалённый сервер (pushdown). Если данные из какой-либо секции не используются, то ненужные части таблицы отбрасываются (распределенный partition prunning), а если запрос можно выполнить локально, то Shardman переадресует его непосредственно на нужный мастер (fast path). Статистика собирается со всего кластера.
Рассмотрим пример. Здесь и далее будем работать на кластере, состоящем из трёх сегментов. Тройка — это оптимальное число, чтобы примеры были наглядными, но не слишком громоздкими, самих узлов в кластере может быть значительно больше. Для создания глобальных и секционированных таблиц выделен специальный синтаксис. Через предложение WITH указывается свойство global, если таблица планруется глобальной и distributed_by = 'field', если таблица предполагается секционированной. Для секционированных таблиц можно также указать num_parts — количество партиций (лучше задать побольше, так как этот параметр статичен, но мы возьмем три, чтобы планы было проще читать) и colocate_with — колоцированную таблицу. В нашем игрушечном банке номера карт будут генерироваться последовательно. Для этого есть специальный распределённый sequence, который ведёт себя аналогично sequence в обычных СУБД, с поправкой на то, что для каждого сегмента выделяется свой собственный пул значений, поэтому в рамках всего кластера они будут уникальными.
CREATE TABLE account (
    id   serial8 PRIMARY KEY,
    name text
) WITH (
    global
);

CREATE SEQUENCE cards_num_gen
    MINVALUE 1020444400000000
    WITH (global);

CREATE TABLE cards (
    card_id         bigint DEFAULT nextval('cards_num_gen') PRIMARY KEY,
    cvv             int,
    expiration_date date,
    account_id      bigint REFERENCES account (id)
) WITH (
    distributed_by = 'card_id',
    num_parts = 3
);

CREATE TABLE transactions (
    transaction_id   serial8,
    card_id          bigint REFERENCES cards (card_id),
    transaction_time time,
    detail           text
) WITH (
    distributed_by = 'card_id',
    colocate_with = 'cards',
    num_parts = 3
);
Как уже говорилось ранее, в Shardman нет узла координатора для всего кластера, так что запрос можно выполнять с любого сегмента. Понятие координатора рассматривается относительно тракзакции: координатором транзакции назначается тот узел, с которого она была инициирована клиентским приложением.
Рассмотрим несколько запросов. Первый — выписка по пользователю.
EXPLAIN (REMOTE, COSTS OFF)
SELECT *
FROM transactions
JOIN cards
    ON transactions.card_id = cards.card_id
JOIN account
    ON account.id = cards.account_id
WHERE name = 'User_3';
По плану видно, как колокация помогает при распределённом запросе. Он распадается на несколько аналогичных, каждый из которых можно выполнить на удалённых узлах и далее агрегировать промежуточные результаты на координаторе. Отношения без префикса fdw (cards_0, transactions_0) в плане есть не что иное, как локальные секции секционированной таблицы, с префиксом — удалённые.
Узлы плана Foreign Scan помечены как асинхронные (Async). Это означает, что узел Append не выполняет нижестоящие операции последовательно, а переключается между ними по мере получения результатов какой-либо из нижестоящих операций. Все данные с удалённых секций вытягивать не надо, фильтры where, limit, некоторые типы агрегатов могу пробрасываться и выполняться удалённо, уменьшая тем самым межсетевой трафик.
Append
  -> Hash Join
       Hash Cond: (cards_1.account_id = account.id)
       -> Hash Join
            Hash Cond: (transactions_1.card_id = cards_1.card_id)
            -> Seq Scan on transactions_0 transactions_1
            -> Hash
                 -> Seq Scan on cards_0 cards_1
       -> Hash
            -> Seq Scan on account
                 Filter: (name = 'User_3'::text)
  -> Async Foreign Scan
       Relations: ((transactions_1_fdw transactions_2) INNER JOIN (cards_1_fdw cards_2)) INNER JOIN (account)
       Foreign EXPLAIN: Hash Join
         Hash Cond: (r7.card_id = r10.card_id)
         -> Seq Scan on transactions_1 r7
         -> Hash
              -> Hash Join
                   Hash Cond: (r10.account_id = r4.id)
                   -> Seq Scan on cards_1 r10
                   -> Hash
                        -> Seq Scan on account r4
                             Filter: (name = 'User_3'::text)
  -> Async Foreign Scan
       Relations: ((transactions_2_fdw transactions_3) INNER JOIN (cards_2_fdw cards_3)) INNER JOIN (account)

(26 строк)
Следующий пример — выписка по карте за определённое время. Все необходимые данные локализованы на одном удалённом узле, поэтому можно полностью выполнить запрос на нём, а потом передать результат координатору. В таких случаях работает fast_path (отмечен в плане как Custom Scan (FastPath)).
EXPLAIN (REMOTE, COSTS OFF)
SELECT *
FROM transactions
WHERE transaction_time > '10:00'::time
  AND transaction_time < '14:00'::time
  AND card_id = '1020444400000060';
План выполнения:
Custom Scan (Fast Path)
  Foreign EXPLAIN: Seq Scan on transactions_1 transactions
    Filter: ((transaction_time > '10:00:00'::time without time zone)
         AND (transaction_time < '14:00:00'::time without time zone)
         AND (card_id = '1020444400000060'::bigint))

(4 строки)
Если локализовать запрос не удалось, то отработает распределенный partition pruning, который отсечёт все ненужные секции. Это можно видеть в плане по числу листьев в узле append.
EXPLAIN
SELECT *
FROM transactions
JOIN cards
    ON transactions.card_id = cards.card_id
WHERE transaction_time > '10:00'::time
  AND transaction_time < '14:00'::time
  AND cards.card_id = 1020444400000060
   OR cards.card_id = 1020444400000080;
План выполнения:
Append
  -> Seq Scan on transactions_0 transactions_1
       Filter: (((transaction_time > '10:00:00'::time without time zone)
             AND (transaction_time < '14:00:00'::time without time zone)
             AND (card_id = '1020444400000060'::bigint))
             OR (card_id = '1020444400000080'::bigint))
  -> Async Foreign Scan on transactions_1_fdw transactions_2
       Foreign EXPLAIN: Seq Scan on transactions_1
         Filter: (((transaction_time > '10:00:00'::time without time zone)
               AND (transaction_time < '14:00:00'::time without time zone)
               AND (card_id = '1020444400000060'::bigint))
               OR (card_id = '1020444400000080'::bigint))

(7 строк)
Распределённые транзакции и CSN
В реляционных СУБД, к которым относится PostgreSQL, выполняется строгая изоляция транзакций, но только в рамках одной БД. Следовательно, для набора команд, меняющих и читающих данные на разных узлах,
по смыслу в транзакцию, нет никаких гарантий: без дополнительных мер (таких как двухфазный коммит) атомарности не будет, снимки данных на разных узлах не обладают информацией друг о друге, поэтому изоляции в общем виде нет.
В Postgres Pro Shardman в качестве распределённого аналога снимка PostgreSQL используется 64-битный счётчик CSN (commit sequence number), который является производным значением от времени, и в некотором приближении его можно считать временем старта транзакции. Назовём CSN, определяющий снимок транзакции, snapshot CSN. При коммите текущее значение этого счётчика назначается в соответствии с локальным идентификатором транзакции (xid). Видимость определяется следующим образом: транзакция видит все данные, у которых значение CSN для создавшей их транзакции (xmin) меньше snapshot CSN, а значение CSN, удалившей(xmax) их, не задано или больше snapshot CSN.
Однако есть нюанс, связанный с тем, что часы на разных узлах могут идти по-разному, а распределённый коммит не фиксируется одновременно на всех сегментах. Поэтому для реализации атомарности и изоляции необходим специальный протокол, учитывающий эти временные особенности.
Вернёмся к трёхсегментному кластеру из предыдущего примера. Пусть на второй сегмент пришёл клиентский запрос, результатом которого должно стать изменение данных во всех сегментах кластера. В начале координатор назначает транзакции snapshot CSN, который потом используется для проверки видимости в рамках распределённого кластера. В ходе выполнения клиентского запроса с координатора отправляются запросы на изменение данных в двух других сегментах. Эти запросы инициируют локальные транзакции, которым независимо присваиваются локальные идентификаторы (xid). При успешном завершении распределённой транзакции необходимо согласованно вычислить CSN — единый в рамках кластера номер, который присваивается локальным транзакциям.
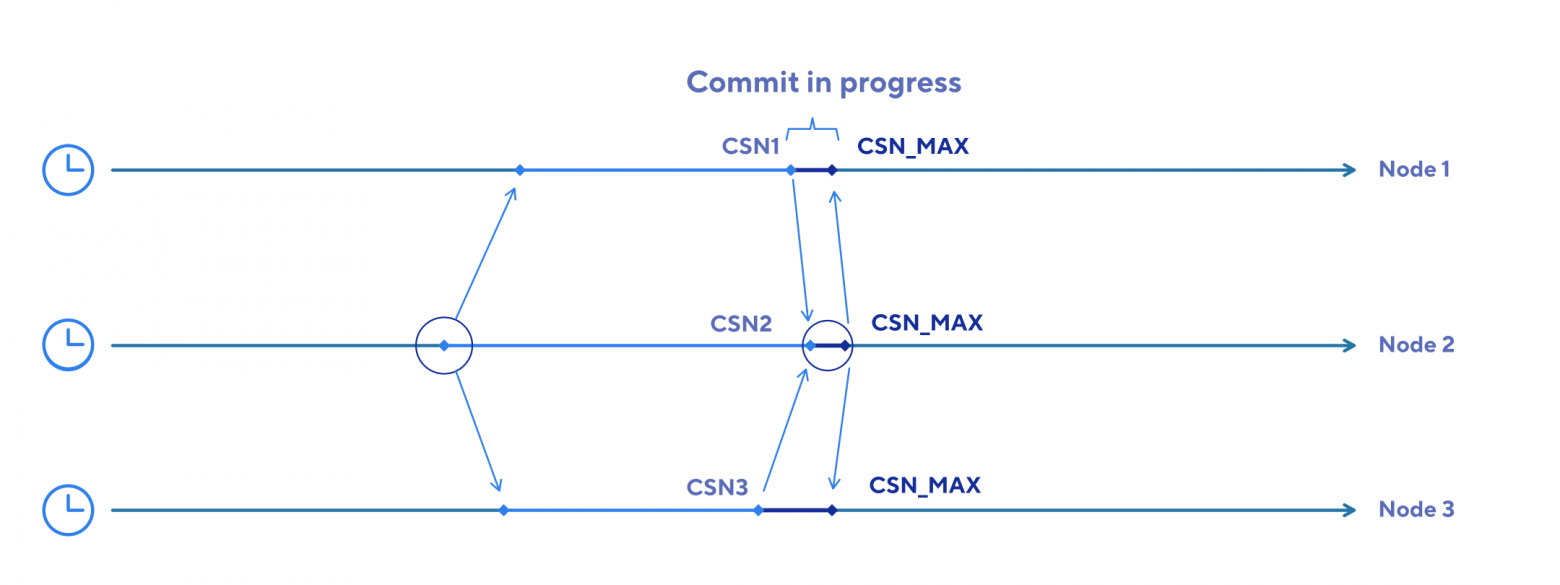
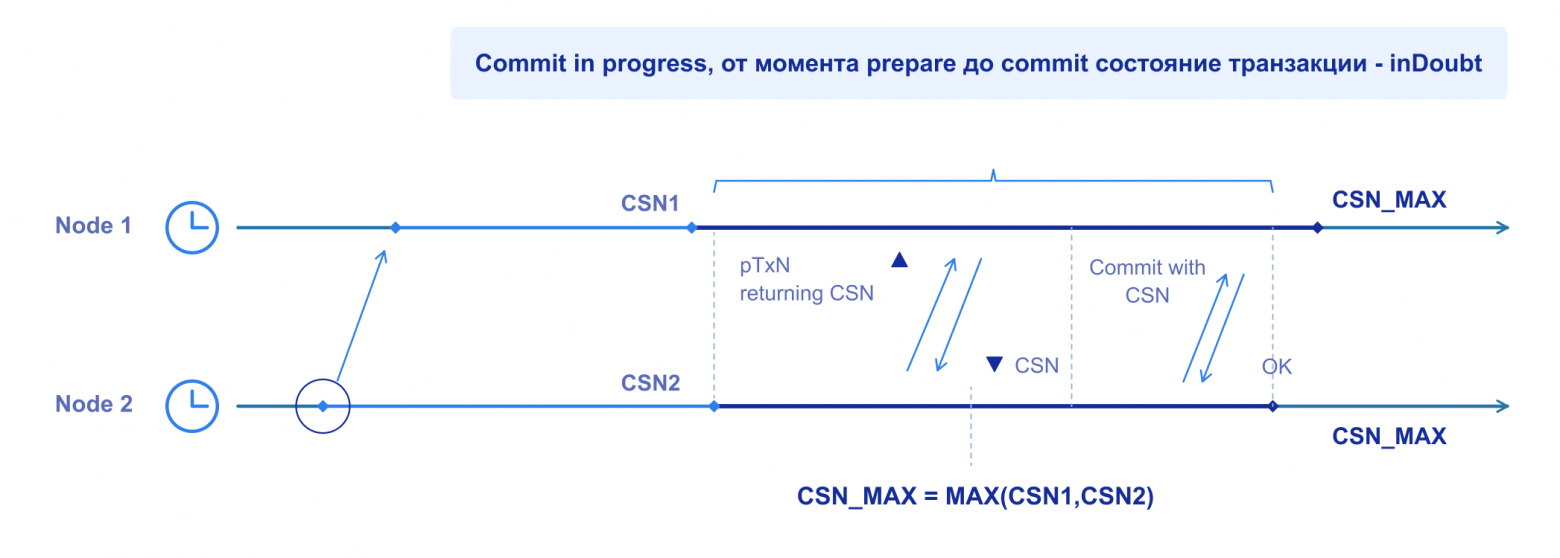
Рассмотрим подробнее момент, обозначенный на схеме выше как Commit in progress, на примере взаимодействия двух узлов.
Распределённый запрос через fdw‑подключение меняет данные на первом узле и у себя, а дальше делает двухфазный коммит, необходимый для обеспечения атомарности изменений. На первой фазе посылается специальное сообщение prepare, в ответ на которое ожидается статус выполнения операции. В Shardman в ответ на prepare дополнительно генерируется и возвращается текущий CSN участника. Координатор, если меняет данные локально, также генерирует CSN. После выполнения prepare и генерации локального CSN транзакция переводится в InDoubt-состояние. Затем координатор, в нашем случае второй узел, сравнивает полученные CSN со своим, выбирает максимальный и фиксирует транзакцию с этим номером у себя и на остальных узлах. Во второй фазе уже вместе с сообщением commit prepared передаётся значение максимального CSN на все узлы и происходит фиксация распределённой транзакции.
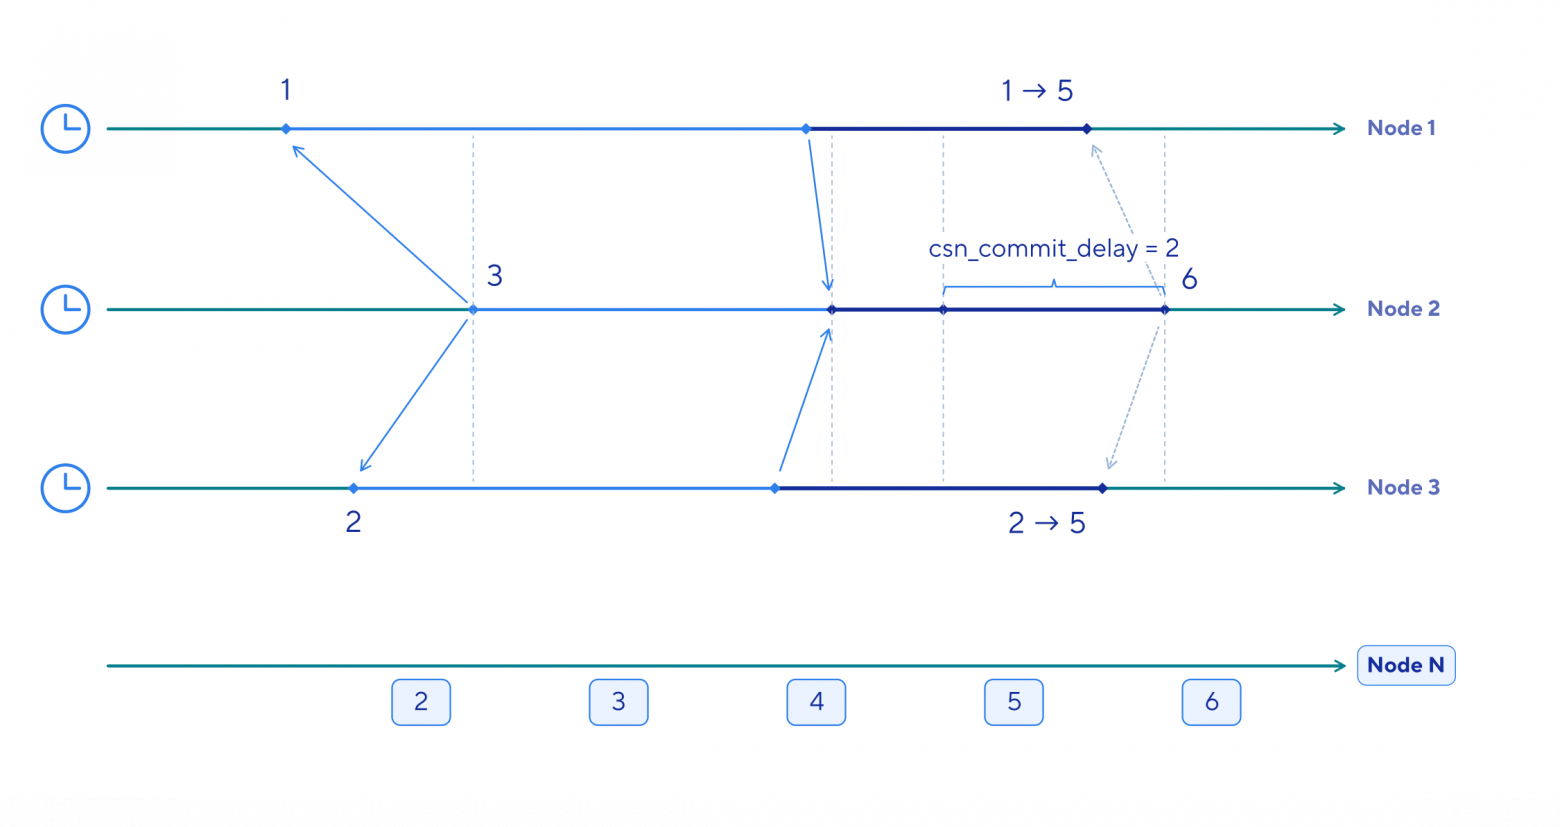
Механизм CSN помогает нам избежать аномалии СУБД, но есть случаи, которые портят пользовательский опыт, но никак не классифицируются в стандарте SQL. Рассмотрим простой пример: клиент подключился к одному из узлов, у которого часы идут впереди относительно других, зафиксировал на нём транзакцию, а потом успел подключиться к другому с отстающими часами и не увидел только что внесённые данные (так как snapshot CSN транзакции получился меньше CSN, соответствующего xmin транзакции, добавившей новые записи). Эта аномалия называется stale reads и встречается в распределённых системах.
Для того, чтобы исключить её был введён параметр csn_commit_delay: транзакции на других узлах будут ждать указанное число в наносекундах. Спустя этот временной промежуток время на локальных часах должно догнать то, что было на координаторе, и проблем с видимостью не будет. Конечно, стоит стремиться к тому, чтобы расхождение часов было минимальным, ведь csn_commit_delay искусственно замедляет выполнение. В примере ниже мы ждём, что первый и второй сегменты дойдут до момента времени 5, чтобы транзакция, запущенная в момент 3 и закончившаяся в момент 4 на втором сегменте, для всех других гарантированно оказалась в прошлом.
Все эти инструменты позволяют нам реализовать в Shardman следующие аналоги уровней изоляции.
Для транзакции типа repeatable read мы дожидаемся разрешения всех Indoubt-транзакций, данные из которых нам потребуются в текущей и дополнительно на узлах дожидаемся, когда локальное время догонит время начала транзакции на координаторе.
Для реализации read commited всё также необходимо дожидаться разрешения всех Indoubt, чтобы не было «грязного» чтения. Для исключения несогласованного чтения (например, когда в транзакции происходит чтение данных с разных сегментов в разных запросах, а между ними успевает зафиксироваться изменяющая те же данные транзакция) необходимо использовать общий в рамках распределенного кластера снимок для каждой инструкции.
Монитор
Во время любой из промежуточных стадий двухфазного коммита может возникнуть сбой по множеству случайных внешних причин (например, сетевые проблемы или отключение питания узла кластера). Специальный процесс СУБД — монитор — работает на каждом сегменте и периодически проверяет статус подготовленных на нём транзакций. При возникновении аварии на координаторе транзакции либо на одном из участников монитор доведёт дело до конца, как только аварийный узел восстановится.
Кроме разрешения статуса распределённых транзакций монитор выявляет распределённые дедлоки и синхронизирует самый старый CSN в кластере, на который какая‑либо транзакция может запросить данные. Последнее необходимо для работы очистки отношений БД (vacuum).
Constraints и foreign keys
Проверка ограничений целостности, уникальности, первичного и внешнего ключа для распределённых данных задача трудозатратная. Для ускорения всех этих проверок в Shardman действуют определённые ограничения на схему данных: все уникальные поля и первичный ключ должны входить в ключ секционирования (а он может быть составной). Таким образом, при нарушении уникальности во время процесса вставки строка попадёт на сегмент, где уже расположена другая с таким же значением первичного (или уникального) ключа, и проверка выполнится локально, что обеспечивает скорость как на обычной СУБД. С ограничениями FK дело обстоит сложнее: для их соблюдения необходимо, чтобы одна из двух распределённых таблиц была глобальной или чтобы они были колоцированными, тогда проверку также можно будет выполнить локально.
Согласованность объектов
Если шардирование строится поверх независимых, отдельно стоящих СУБД, то в такой распределённой системе отсутствуют «сквозные» глобальные объекты. Из-за этого синхронизация таких атрибутов, как права доступа, схемы данных и метаданных, не гарантирована. Задача не так проста, как может показаться на первый взгляд. Любые изменения — будь то права пользователей, типы данных или составные элементы таблиц (индексы, внешние ключи, констрейнты) — должны применяться на всех узлах строго синхронно. В противном случае неизбежны дрифт схемы данных (schema drift) и рассинхронизация конфигураций. Наравне с этим существуют и те объекты, которые должны быть уникальны в рамках кластера, например глобальные последовательности, о которых рассказывалось выше.
Для этого в Shardman есть система управляемых объектов. «Управляемый» в названии означает, что СУБД отслеживает все изменения и рассылает их на остальные узлы. Однако есть важное ограничение: все управляемые объекты могут зависеть только от управляемых или базовых (built-in) объектов. В то же время локальные объекты могут зависеть как от локальных, так и от управляемых. Согласованность атрибутов последних отслеживается дополнительно при кластерных операциях, таких как добавление и удаление узлов, но об этом далее. К управляемым объектам относятся, например, секционированные и реплицируемые таблицы, глобальные последовательности. Также в эту систему включены пользовательские типы, функции, операторы, роли и другие объекты СУБД.
Добавление и удаление репликационных групп
Для добавления нового узла необходимо, чтобы на сервере был запущен специальный демон shardmand. После этого Shardman utils сами поднимают кластер postgres на указанном сервере, инициализируют на нём базу и переносят все необходимые глобальные объекты и партиции секционированных таблиц. На следующем шаге запускается процесс переноса данных (rebalance). После добавления нового мастера осуществляется простейшая диагностика состояния кластера. Аналогичные действия выполняются и при удалении узлов. Если процесс прервался из-за ошибки или по команде администратора, есть специальная команда cleanup, которая вернет распределённый кластер в рабочее состояние. Несмотря на то, что операция не требует от администратора особых усилий, она является тяжёлой, что следует учитывать при планировании работ по добавлению сегментов.
Резервные копии
Снять валидную резервную копию, одновременно запустив basebackup на всех сегментах, не удастся: на момент снятия резервной копии одна и та же распределённая транзакция может находиться в разных состояниях на разных узлах (например, быть закоммиченной на одном и ещё коммититься на другом), следовательно, при восстановлении состояние кластера может быть неконсистентным. Технология восстановления на момент времени (PITR) здесь бесполезна, так как у изолированных СУБД нет сквозной синхронизации журналов предзаписи (WAL) по единой шкале времени, да и единого времени также нет.
Для создания согласованных резервных копий в Postgres Pro Shardman используется механизм CSN. Реализована функция создания так называемой точки синхронизации (syncpoint), которая внутри каждого сегмента выводит текущий CSN и соответствующую ему позицию LSN. С использованием полученного LSN выполняется резервная копия. Поддерживается также и PITR-восстановление. Реализовано оно следующим образом: пользователь задаёт частоту создания точек синхронизации, а при указании времени при восстановлении ищется ближайшая такая точка.
Заключение
В заключении хотелось бы поделиться планами команды Postgres Pro Shardman на ближайший год. На данный момент мультиплексор работает только с читающими запросами, для пишущих всё ещё используется FDW и связка из полноценных клиентских сессий на каждый запрос. Планируется сделать поддержку пишущих запросов. Также не решена в общем виде проблема кроссшардовых соединений не по ключу секционирования, сейчас некоторые из них работают медленно. В данный момент мы работаем над так называемым shuffle join, который позволит значительно ускорить подобные запросы. Система управления и контроля глобальных объектов также пока что не реализована для всех сущностей СУБД. Оставшиеся объекты планируется реализовать по мере возможности. Уверен, в следующем году мы порадуем новыми интересными решениями не самых простых задач для потребностей бизнеса.