Привет, я Света Морозова — лид в одной из DS-команд Авито. Мы развиваем уровень сервиса: это показатель качества работы продавцов. Для этого ищем нарушения — например, когда продавец пишет в объявлении одну цену, а в переписке называет другую — и помогаем пользователям скорректировать поведение с помощью продуктовых механик. Над этим вместе работают аналитики, продакты, DS и разработчики.
В работе часто возникают вопросы, которые хочется быстро проверить на данных. Например, на уровень сервиса влияет скорость ответов в чатах — отвечать желательно в течение 3 суток. И вот мы хотим выяснить: если изменить этот порог, скольких продавцов это затронет и как оценить влияние на бизнес?
Такие относительно простые и разовые задачи могли бы решать сами продакты и DS. В Авито есть фокус на self-service аналитику: мы верим, что специалист должен разбираться и в смежных дисциплинах, особенно с помощью ИИ.
Но по многим вопросам всё равно нужна помощь аналитика, например:
по каким формулам сейчас считаем параметры;
как выбрать источники данных;
какие есть ограничения для расчёта.
Всё это увеличивает time-to-market даже небольшого исследования.
В статью расскажу, как мы решили эту проблему: создали возможность для коллег проводить мини-исследования, разгрузили аналитиков и в целом ускорили проверку гипотез.
Будет полезно DS-лидам и инженерам, у которых есть похожие трудности.
Содержание
Потребность: перейти от локальных ИИ-агентов к командной базе знаний
Решение: заменить выгрузку Confluence на доменную базу знаний
Документации оказалось недостаточно: разделили домен между носителями знаний
Проблема: аналитик превратился в точку ожидания
Коллеги часто приходят с важными ad hoc-вопросами, на которые ответы нужны в моменте. По отдельности они выглядят как небольшие задачи для аналитика. Но вместе дают постоянный поток, который отнимает много времени.
За ресурс аналитиков начинают конкурировать два типа работы:
1️⃣ Срочные ad hoc-запросы, без которых команда не может принять ближайшее решение.
2️⃣ Большие аналитические исследования: они не срочные, но определяют развитие продукта на квартал, полгода или даже больше. В них нужно долго погружаться, последовательно проверять разные гипотезы и готовить содержательный результат.
Уместить оба потока в доступный ресурс аналитиков мы не могли, да и не хотели.
Поэтому одна из ключевых целей решения, про которое я расскажу — не «заменить аналитика», а скорее закрыть две задачи одновременно:
✅ Освободить команду аналитики от ad hoc-запросов — за счёт подготовки инструментария для качественного и быстрого проведения самостоятельных мини-исследований;
✅ Вернуть возможность проводить сложные, глубокие исследования, до которых часто не доходят руки.
Для этого нужно было сделать так, чтобы коллеги могли использовать накопленные аналитиками знания.
Потребность: перейти от локальных ИИ-агентов к командной базе знаний
К этому моменту многие коллеги уже пробовали решать аналитические задачи с помощью агентов, подключённых к внутренним инструментам.
При этом каждый сам собирал контекст: объяснял агенту, какие источники использовать, как рассчитываются метрики и какие ограничения учитывать. Ошибки тоже сохраняли локально: у каждого постепенно появлялся собственный список «граблей».
Мы решили объединить эти наработки в общую доменную базу знаний для команды и её агентов. Так проверенное объяснение или исправление ошибки можно переиспользовать в следующих задачах.
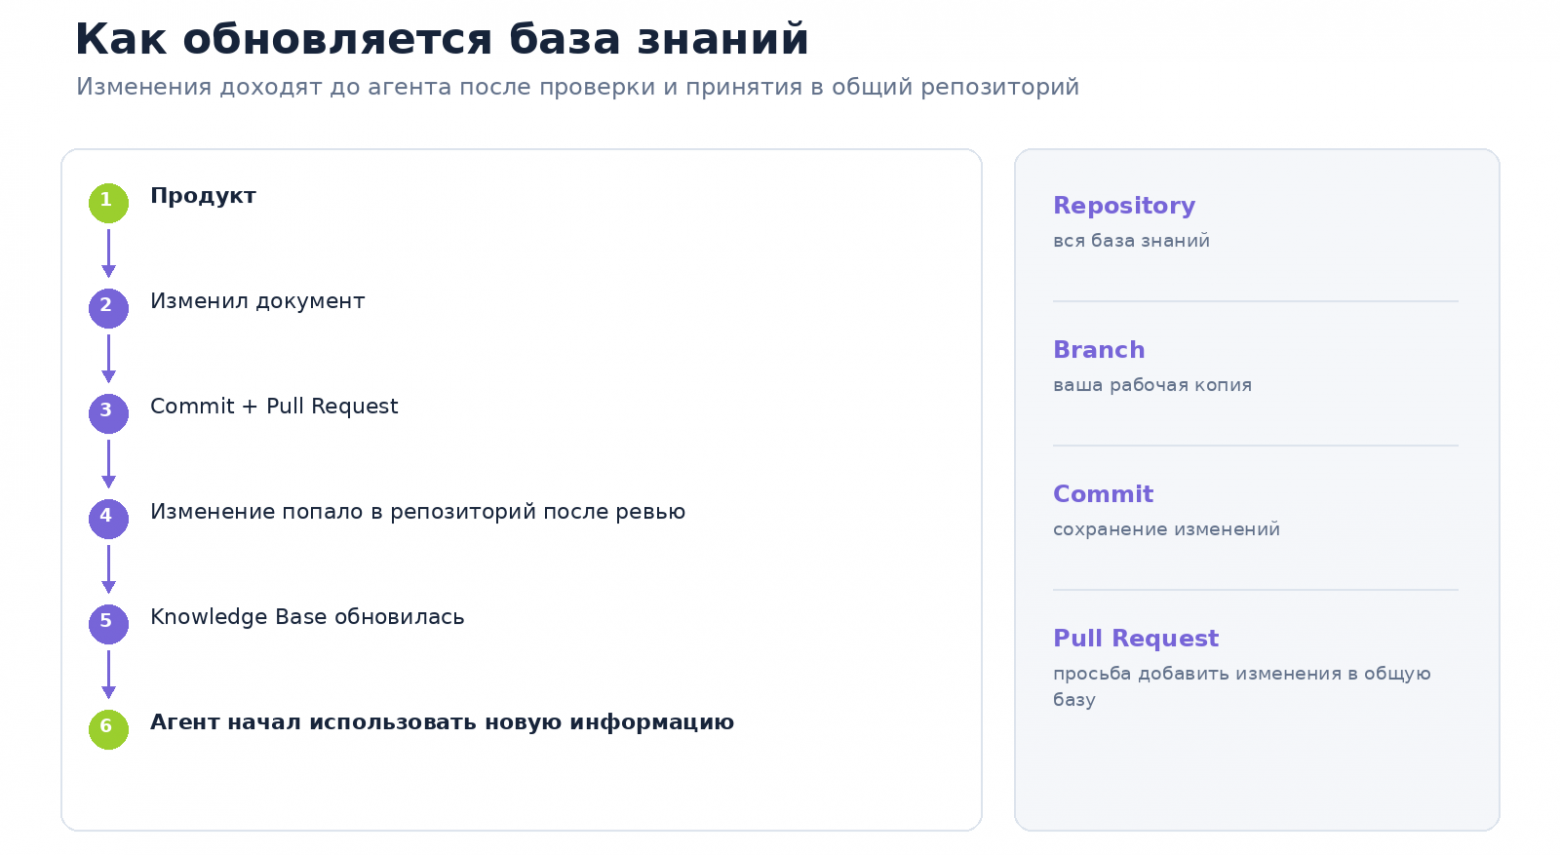
💡 Базу задумали как совместное рабочее пространство: любой участник команды может предложить дополнение, а перед включением в общую версию его проверяет коллега с нужной экспертизой.
Решение: заменить выгрузку Confluence на доменную базу знаний
В начале у нас не было готовой архитектуры или детального плана, как строить Knowledge Base. Мы просто предполагали: команда накопила много полезной информации — нужно сделать её доступной агенту и посмотреть, насколько лучше он начнёт справляться с нашими задачами. Поэтому первую версию собрали максимально быстро.
Версия 1. Переложили накопленные знания из Confluence в Markdown
Основным источником документации команды был Confluence, поэтому мы решили отталкиваться от него:
Найти релевантные страницы.
Вручную отфильтровать лишние материалы.
С помощью агента перевести содержимое в Markdown.
Добавить Markdown-файлы в доступный агенту контекст.
Проверить базу на реальных вопросах команды.
Это был довольно сырой подход: вместе с полезными знаниями мы перенесли в базу и все типичные проблемы внутренней документации:
Многие документы устарели, между ними не было понятной связи, а владельцы страниц потерялись.
Часть нужных знаний лежала в production-системах: например, актуальные пороги «прокрашивания», при которых у пользователей меняется репутационный статус.
Другие проблемы.
⚡ Но эта версия позволила не застрять на этапе проектирования идеальной системы, а быстро получить рабочий прототип и перейти к экспериментам.
Версия 2. Провели ревизию того, что команда действительно знает
Когда мы начали использовать базу, стало заметно, что содержимое Confluence не полностью отражает текущее положение дел. Для человека, который давно в команде, это не создаёт серьёзных проблем. Он знает, что старое название теперь означает новую витрину, помнит, какой отчёт перестали поддерживать, и понимает, где искать актуальные данные.
Но для ИИ-агента всё иначе. Поэтому на втором этапе встала задача не просто добавить больше документов, а провести ревизию накопленных знаний.
Для каждого блока нужно было определить:
что осталось актуальным, а что устарело полностью;
что сохранило смысл, но сменило название или расположение;
какие новые источники заменили прежние;
какие процессы больше не используются;
какой вариант считать основным сейчас.
📗 Так Knowledge Base начала превращаться из копии Confluence в отдельное, актуальное представление предметной области — именно для работы агента.
Документации оказалось недостаточно: разделили домен между носителями знаний
В процессе ревизии нашлась ещё одна проблема: заметная часть важных знаний вообще не была зафиксирована в Confluence или в других документах.
В повседневной работе команды это работало: если возникал вопрос, можно было обратиться к нужному коллеге. Но агент не мог воспользоваться знаниями, которые были только в головах людей.
💡 Мы поняли, что наполнить базу только существующими документами недостаточно. Нужно с нуля формализовать часть командной экспертизы. Но это не должно быть отдельной технической инициативой, а должно стать общей задачей кросс-функциональной команды.
Поэтому мы распределили области базы знаний между участниками команды в соответствии с их экспертизой. Каждый отвечал не просто за перенос существующей документации, а за описание того, как соответствующая часть системы устроена на самом деле.
Например, я как DS-lead взяла на себя контекст, связанный с ML:
какие модели и скоринги использует команда;
где модели живут и как результаты скоринга используются в продукте дальше;
как часто переобучаются и где посмотреть их текущее качество;
какие особенности нужно учитывать при интерпретации результатов.
Аналитики описали работу с данными и метриками:
из каких источников получать данные;
какие витрины использовать для разных типов исследований;
как рассчитывать целевую метрику;
что означают её отдельные компоненты;
какие фильтры и ограничения важно учитывать.
Участники продуктовой команды добавили:
механики и пользовательские сценарии;
бизнес-логику и смысл различных направлений работы.
Что вошло в базу знаний
Первая версия дала нам скорость и позволила проверить саму идею. Во второй вместо архива накопленной документации мы начали строить актуальную модель предметной области, которую могли использовать сотрудники и их AI-агенты.
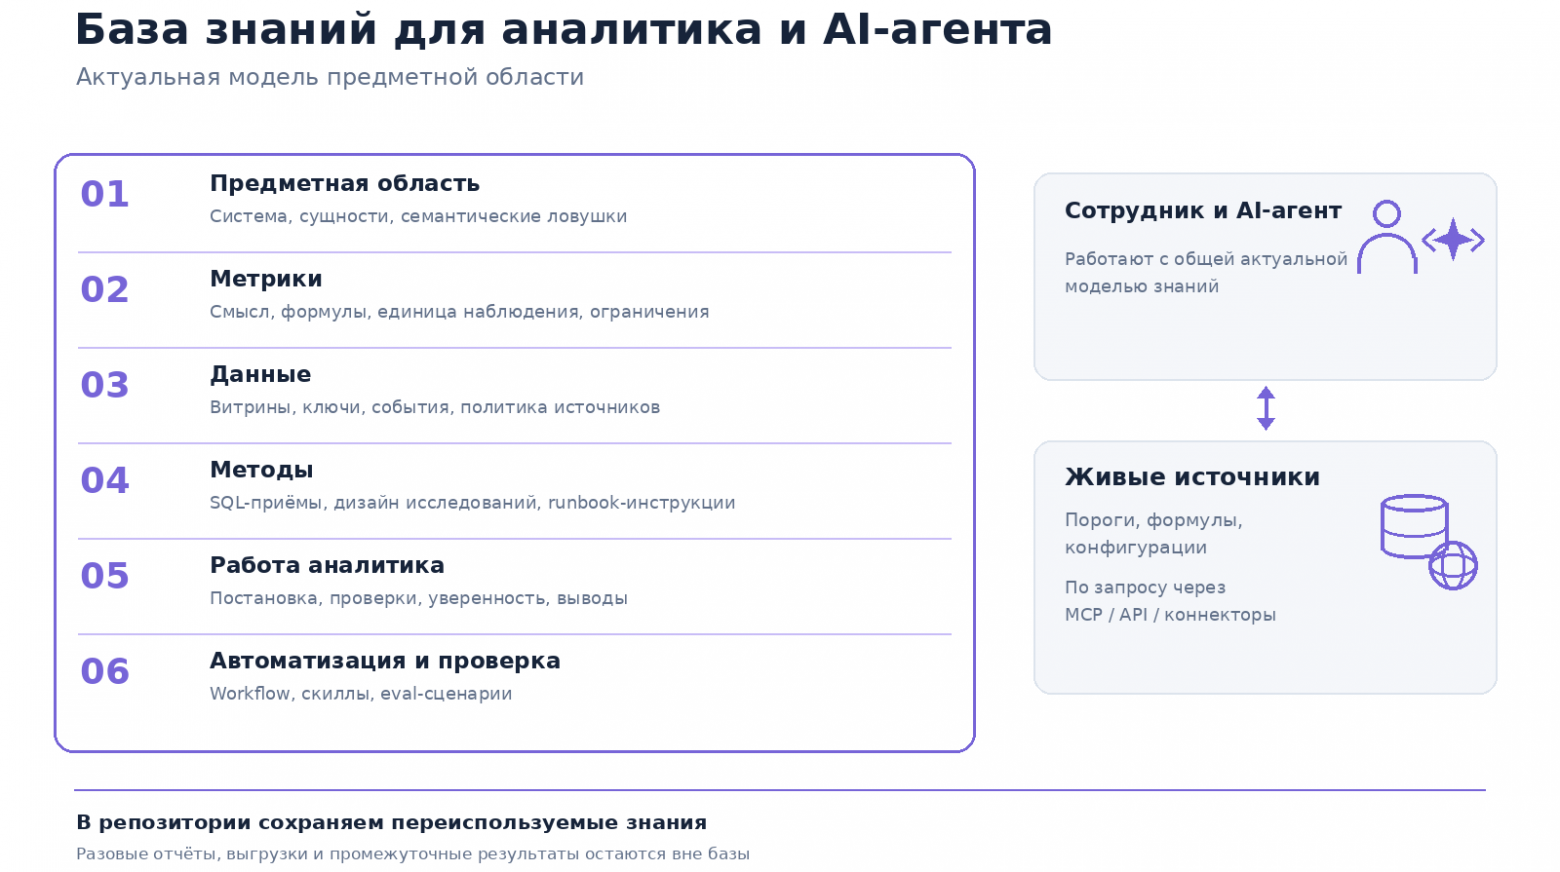
В финальном виде базу знаний мы разделили на несколько слоёв.
Карта домена
Сначала описали саму репутационную систему:
какие сигналы в неё поступают;
как скорятся коммуникации;
как результаты превращаются в параметры репутации, цвет продавца, последующие поощрения или ограничения.
Отдельно зафиксировали основные сущности и уровни агрегации: пользователь, листер, объявление, коммуникация, жалоба, нарушение, репутационная фича, задача на разметку.
Это важно, потому что даже похожие метрики могут считаться на принципиально разных объектах. Например, «пользователь», «листер» и «объявление» нельзя бездумно подменять друг другом: один пользователь может одновременно быть листером в разных категориях, а часть метрик вообще считается на уровне объявлений.
Глоссарий и семантические ловушки
В отдельном документе мы собрали пары понятий, которые выглядят похожими, но отвечают на разные вопросы.
Например:
продуктовая полнота системы не равна recall отдельной ML-модели;
отсутствие красной репутации не означает, что продавец хороший;
одна и та же метрика может использовать разные определения «плохого продавца» в разных вертикалях;
скользящее окно за 30 дней нельзя интерпретировать как календарный месяц.
Такие ошибки особенно опасны: SQL-запрос может быть синтаксически корректным, но отвечать не на тот вопрос.
Карточки метрик
Для основных метрик сделали отдельные карточки. В каждой зафиксированы:
продуктовый смысл метрики;
формула;
числитель и знаменатель;
единица наблюдения;
охваченные и исключённые сегменты;
источники данных;
доступные разрезы;
обязательные sanity-checks;
ограничения интерпретации;
известные разрывы временного ряда;
ссылки на живые дашборды и запросы.
Мы намеренно разделили описание метрики и описание системы. Документ о метрике отвечает на вопрос «как измеряем», а документ о пайплайне — «как это работает». Благодаря этому агент не смешивает устройство ML-скоринга, формулу репутации и способ измерения их качества.
Карта данных
Следующий слой — документация по наиболее востребованным витринам:
назначение таблицы;
гранулярность строки;
ключевые поля;
партиции;
типичные фильтры;
корректные способы соединения;
известные проблемы и лаги данных.
Отдельно описали преобразование внешних и внутренних идентификаторов для пользователей, объявлений, чатов и звонков. Это один из тех участков, где запрос часто успешно выполняется, но возвращает неполную или смещённую выборку из-за неправильного ключа соединения.
Ещё в репозитории есть карта clickstream-событий и политика выбора DWH-источников. Для устаревших или проблемных витрин указали разрешённые замены. Если агент встречает незнакомую таблицу, он должен сначала проверить её семантику, гранулярность, актуальность партиций и наличие более свежего аналога — и только потом писать основной запрос.
Переиспользуемые SQL-паттерны и технические грабли
Мы сохранили не случайные запросы из отдельных исследований, а повторяемые приёмы:
дедупликацию событий оконными функциями;
привязку фактов к временным окнам;
работу со скользящими периодами;
парсинг JSON и полуструктурированных payload;
мэппинг идентификаторов;
создание и проверку промежуточных таблиц.
Рядом находится список практических проблем Redash и Trino: лаги ETL, различия между физическими таблицами и Redash-датасетами, особенности параметров запросов, ошибки типов, ограничения по памяти и случаи, когда свежий день ещё нельзя интерпретировать.
Методики типовых исследований
В базу вошли не результаты конкретных проверок гипотез, а их воспроизводимый дизайн.
Например, для исследования качества разметки фиксируются:
единица анализа;
правила построения сравниваемых групп;
минимальный объём выборки;
необходимые контрольные разрезы;
работа с доверительными интервалами;
риски survivor bias и левого цензурирования;
требования к формулировке результата.
Это позволяет повторить исследование на новом периоде или в другом проекте, не принимая старые цифры за актуальную истину.
Для типовых инцидентов появились runbook-инструкции. Например, при резком изменении метрики агент сначала проверяет полноту партиций и лаг ETL, затем изменение знаменателя, состава сегментов, методологии и источников — и только после этого строит продуктовые гипотезы.
Правила аналитического мышления
Часть базы знаний описывает не данные, а ожидаемое поведение аналитика. Перед расчётом агент должен проверить, на тот ли вопрос мы отвечаем и какое решение будет принято по результату.
Содержательный вывод должен включать не только число, но и:
сравнение с бейзлайном;
динамику;
возможную причину;
уровень уверенности;
ограничения;
следующий шаг.
Отдельно зафиксирован лексикон уверенности: когда допустимо писать «данные показывают», когда только «похоже», а когда правильный ответ — «данных недостаточно».
В базу также вошли аналитические антипаттерны: вывод по одному дню, сравнение периодов разной сезонности, игнорирование NULL, использование count(*) без понимания гранулярности, причинный вывод из корреляции и перенос результата одного сегмента на всю систему.
Workflow, специализированные навыки и проверки
Репозиторий задаёт полный жизненный цикл аналитической задачи: от уточнения постановки и согласования плана до разведки данных, основных расчётов, документирования и проверки результата.
Для повторяемых сценариев знания оформили в специализированные скиллы агента:
оценка влияния изменений репутационной формулы;
поиск нарушений, не покрытых нашим пайплайном;
диагностика качества разметки;
аудит регламентов;
работа с историей нарушений;
обработка алертов на качество данных.
Наконец, мы добавили eval-сценарии. Агент получает обычную пользовательскую постановку, а тест проверяет, выбрал ли он правильные источники данных и упомянул ли обязательные факты. Ожидаемый ответ при этом скрыт от самого агента.
Чего намеренно не добавили
Мы не стали превращать репозиторий в архив всех проведённых исследований.
❌ Не попадают
исторические аналитические отчёты целиком;
результаты разовых проверок гипотез;
длинные нарративы конкретных расследований;
локальные промежуточные таблицы и выгрузки;
копии информации, у которой уже есть внешний источник истины.
✅ Остаются в базе
После завершения задачи переносим только то, что оказалось долгоживущим и переиспользуемым:
новое определение;
обнаруженная семантическая ловушка;
устойчивый SQL-паттерн;
типовой дизайн исследования или исторический разрыв данных, который продолжает влиять на сравнения.
Так мы уменьшаем шум в контексте, не даём устаревшим цифрам превращаться в «истину» и избегаем конфликтующих версий одного вывода.
Ещё мы не дублируем данные, которые можно получить из актуального источника: текущие пороги, формулы и конфигурации сервисов. Агент запрашивает их по необходимости через MCP, API или коннекторы к документам.
Такие значения часто меняются, а хранение копии в репозитории создало бы второй источник истины и потребовало синхронного обновления в двух местах. В базе знаний остаётся инструкция, где и как получить актуальное значение, но не само значение.
Как организовали работу
Разделили её так:
Роль | Вклад |
Аналитики | Метрики, источники данных, проверка расчётов |
DS | LLM-пайплайн, retrieval, инструкции, оценка качества моделей |
Продакты | Типовые вопросы, пользовательские сценарии, требования к форме ответа |
Подключили нетехнических участников
Мы решили хранить нашу базу знаний в Bitbucket, потому что это даёт всё необходимое:
единое место хранения контекста для агента;
версионирование базы знаний;
возможность работы нескольких людей параллельно в отдельных ветках;
внесение изменений через аппрувы ревьюеров;
может быть, что-то ещё.
Научили пользоваться базой всю команду
Для этого я написали подробную документацию по установке репозитория и провела воркшоп — наглядно показала, как добавлять изменения:
с помощью встроенных UI-инструментов Bitbucket;
с помощью Git-команд внутри редактора кода или терминала;
с помощью самого агента — этот способ оказался самым подходящим.
Мы провели аналогии — это стало отправной точкой для кратного роста числа пользователей и контрибьюторов.
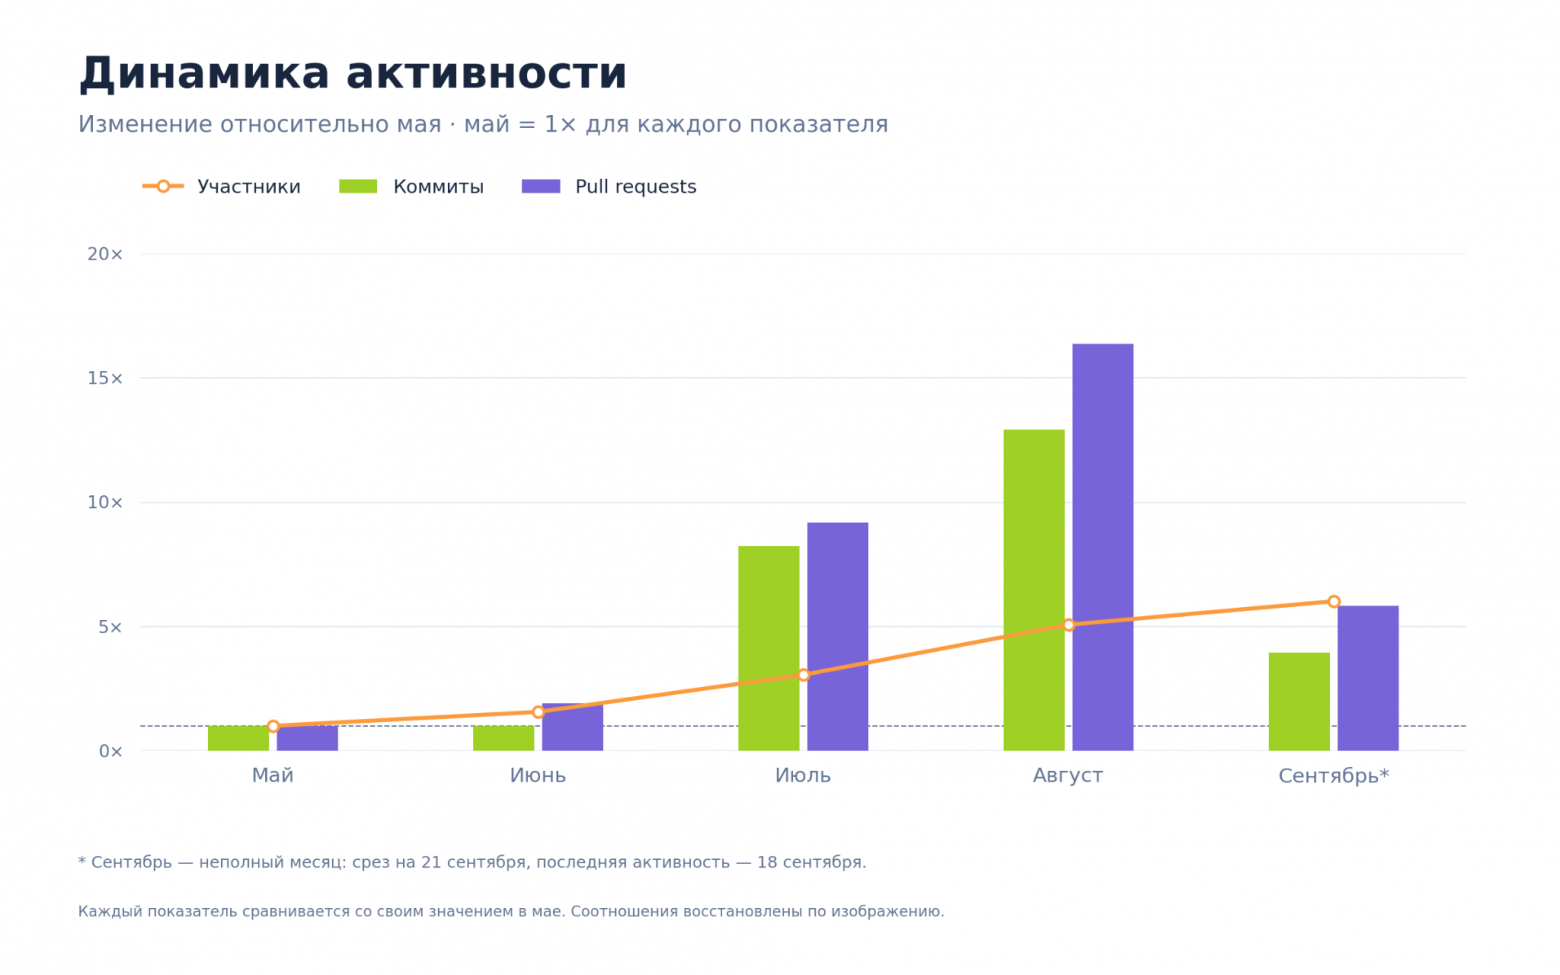
Что сделали за пять месяцев
Ниже показан помесячный вклад в репозиторий: виден бурный рост в июле и августе, когда мы начали активно пользоваться базой знаний и и привлекать участников команды к ownership’у.
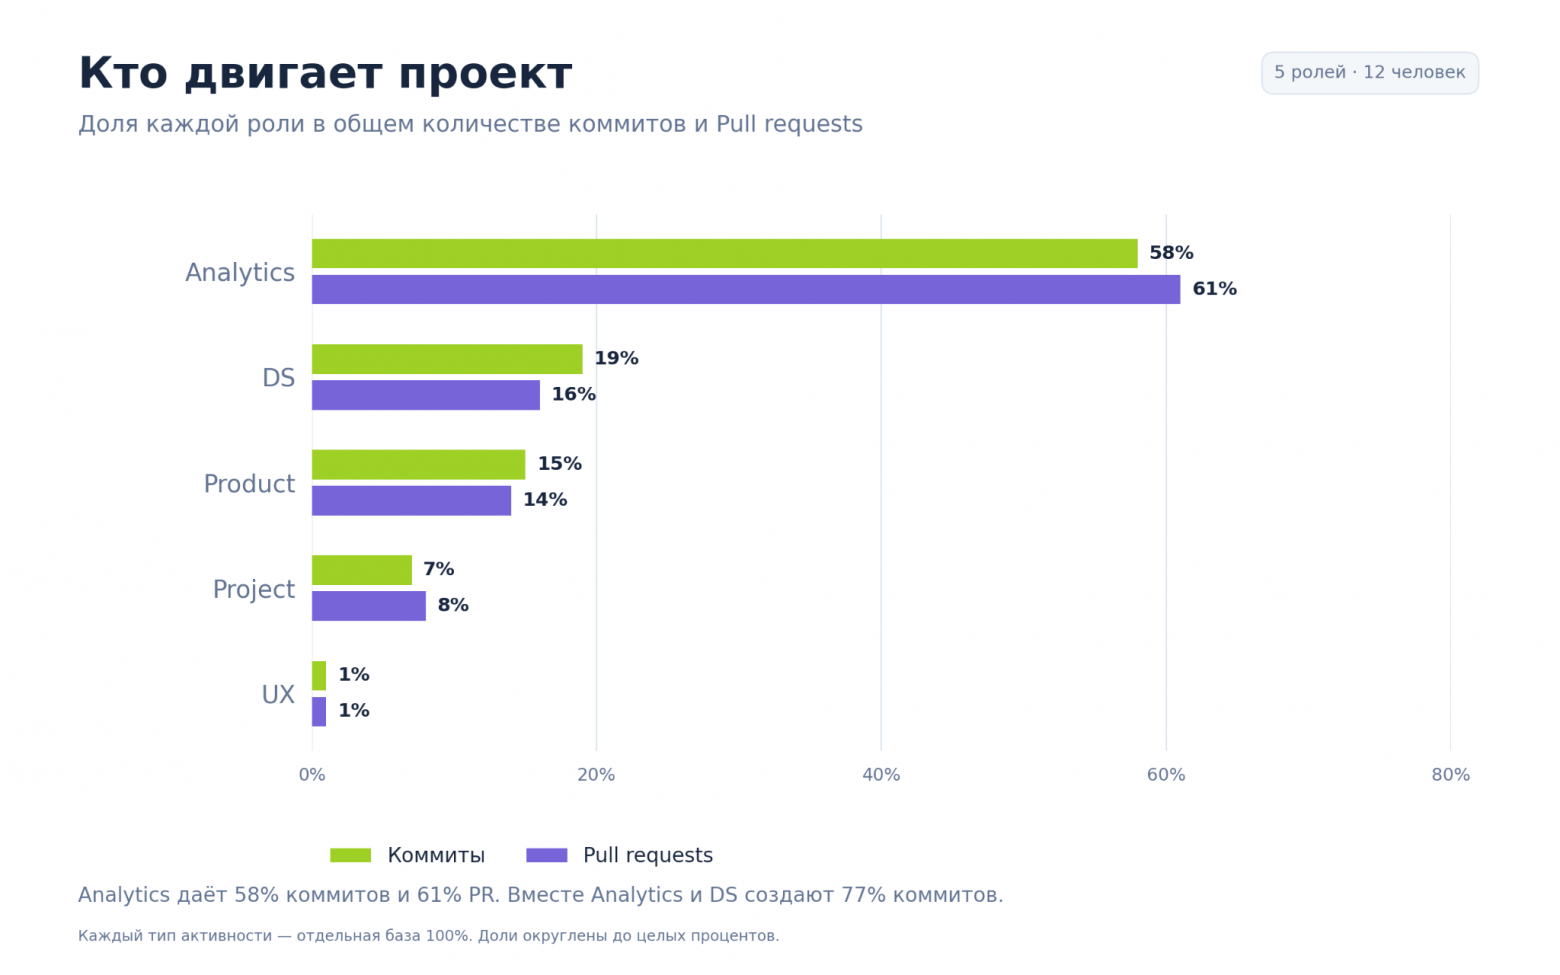
Во-первых, мы действительно вовлекли всю команду в наполнение репозитория — в первую очередь аналитиков, но другие функции тоже внесли свой вклад.
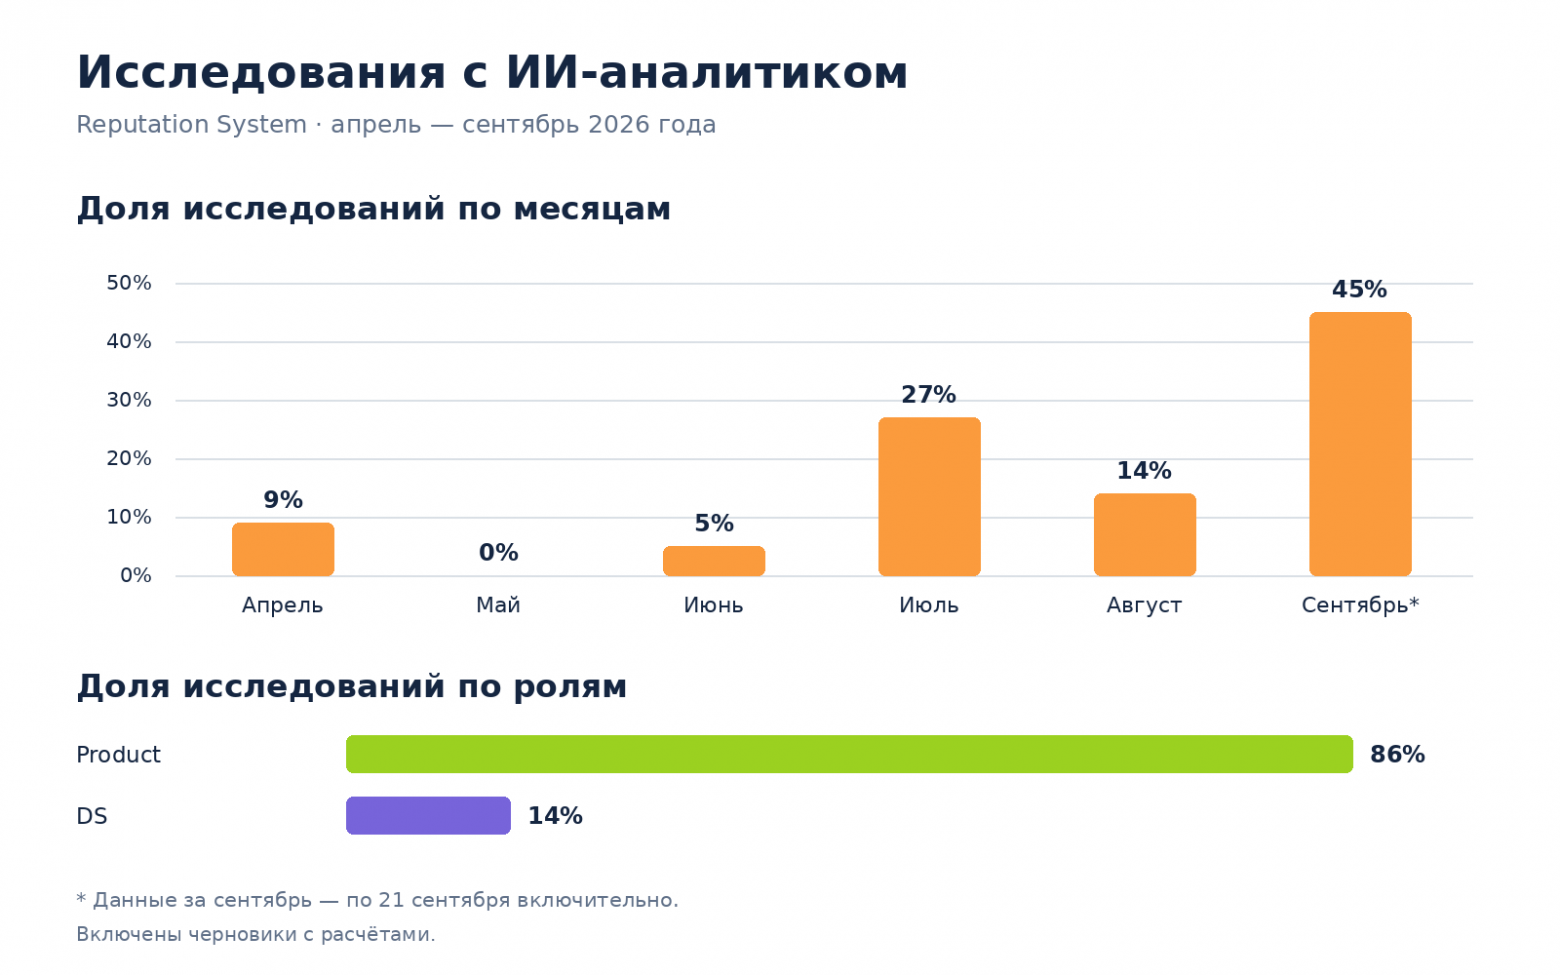
Во-вторых, мы действительно переложили часть работы аналитиков на других участников команды. На слайде только то, что отложилось в Confluence как большие ad hoc-исследования:
Что нам дала общая база знаний
Проделанная работа помогла нам собрать и согласовать контекст, который раньше распределялся между документацией, личными наработками и опытом коллег. Пришлось уточнить определения, проверить актуальность источников и описать правила, которые эксперты прежде держали в голове. Теперь командные знания могут использовать люди и ИИ-агенты.
Коллеги пользуются базой для исследований, а участники разных функций дополняют её своей экспертизой. Количество исследований и изменений в репозитории показывает востребованность подхода. Чтобы оценить, насколько он разгружает аналитиков, нужно учитывать время на получение проверенного ответа, исправления и поддержку самой базы.
Что с изначальной проблемой
Напомню, зачем мы это всё затеяли: за аналитический ресурс боролись срочные-и-важные и долгие-и-стратегические исследования. Могу сказать, что тут есть изменения.
Доля Research-задач в аналитике — считали через объём задач с типом Research от задач с любым типом — за последние несколько месяцев также выросла:
Период 2026 года | Доля Research-задач |
Январь–март | 36% |
Апрель–июнь | 40% |
Июль | 50% |
Август | 100% |
Сентябрь, с 1-го по 21-е | 67% |
Работа, на которую у аналитиков появилось время
Например, систематическое исследование репутационных нарушений, которые пропускает система.
Аналитик связала выбор проблемных сегментов, сбор и суммаризацию пропущенных нарушений, разбор по регламенту и оценку потенциального влияния на метрики. Так удалось исследовать причины пропусков в трёх направлениях: цене в Товарах и Недвижимости и качестве в Авто.
Разбор помог отделить реальные нарушения от тех, где недостаточно доказательств, сформировать кластеры и приоритезировать их для внедрения новых решений.
Что осталось за рамками метрик
По нашим ощущениям, мы стали быстрее проверять гипотезы и принимать решения — отдельно этот эффект мы не измеряли, да и не было такой задачи.
Появился и общий азарт: осваивать новые инструменты, находить ответы на свои вопросы и доводить идеи до реализации. Это субъективное наблюдение, но для нас важный результат: команда почувствовала больше самостоятельности и увлеклась тем, что теперь может сделать.
Советы, если хотите повторить наш опыт
Начните с реальных вопросов. Собрать небольшой объём знаний под несколько частых задач и проверить его в работе. Ошибки агента помогут определить, чего не хватает.
Подключите носителей экспертизы. Аналитики, DS и продакты знают разные части системы. Важно договориться, кто проверяет и обновляет каждую из них.
Сделайте участие простым. Инструкция и совместный разбор помогают начать пользоваться базой, а внесение изменений через агента снижает порог для нетехнических коллег.
Проверяйте результат целиком. Важно, чтобы расчёты были корректными, выводы — обоснованными, а сам инструмент — полезным для решений. Для сложных вопросов заранее определите, на каком этапе подключать аналитика.
Теперь мы хотим закрепить этот способ работы: пополнять базу по итогам исследований, поддерживать её актуальность и проверять, действительно ли самостоятельная работа коллег высвобождает время экспертов для более глубоких задач.
В канале «Доска AI-объявлений» пишем о жизни, работе, о том, чем вдохновляемся и как развиваемся — заглядывайте.