Исследователи предложили способ сжать большую языковую модель почти вдвое и сохранить около 85% ее качества, не тратя ресурсы на обучение с полного нуля. Полученная модель на 2,27 млрд параметров прошла дистилляцию всего на 22 млрд токенов, но в среднем уже обходит Qwen3-1.7B, которую учили на 36 трлн токенов (то есть на объеме данных в 1 600 раз больше).
Метод назвали Concertina, от англ. «концертина» — вид небольшой гармошки, а не чего-то «конкретного». Способ подробно описали в статье «Folding Language Models into Themselves». Готовые веса уже выложены на Hugging Face под свободной лицензией Apache 2.0.
Что значит «свернуть» модель
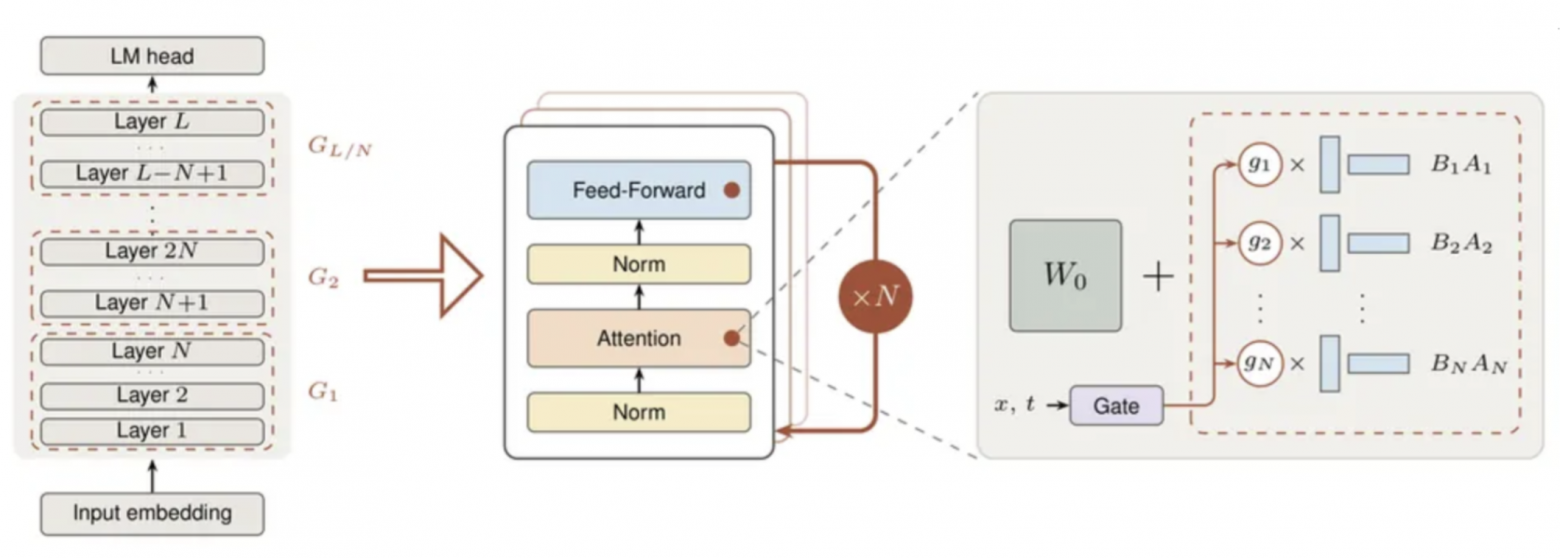
Обычно при сжатии нейросетей лишние слои просто выкидывают, но от этого модель «глупеет», так как теряет глубину рассуждений. Авторы Concertina пошли другим путем и буквально сложили соседние слои Qwen3-4B попарно, как меха гармошки.
Каждая пара соседних слоев Qwen3-4B заменяется одним общим блоком, который выполняется дважды. Общие линейные матрицы берутся из первого слоя пары. Второй проход получает поправку ранга 64, которую инициализируют усеченным SVD разности двух исходных слоев, а поток поправки масштабирует гейт для каждого токена. Нормализации RMSNorm у каждого прохода свои. После сборки студента дистиллируют из той же Qwen3-4B, потеряв при этом 43% параметров: 2,27B против 4,02B.
Сравнение с ближайшими альтернативами
Данные взяты из таблицы в пересказе карточки модели.
Qwen3-4B (учитель) | Qwen3-1.7B | Concertina-2.27B | |
Параметры | 4,02B | 1,72B | 2,27B |
Токены обучения | 36T | 36T | 22B (дистилляция) |
base-7 (среднее) | 0,630 | 0,562 | 0,580 |
MMLU | 0,671 | 0,557 | 0,556 |
MMLU-Redux | 0,720 | 0,591 | 0,587 |
MMLU-Pro | 0,404 | 0,297 | 0,301 |
GPQA | 0,379 | 0,293 | 0,308 |
BBH | 0,505 | 0,363 | 0,400 |
GSM8K | 0,879 | 0,710 | 0,788 |
MATH | 0,566 | 0,460 | 0,498 |
Чтобы было проще ориентироваться в метриках: base-7 — это средний балл по семи базовым тестам на здравый смысл и понимание контекста, Redux и Pro — исправленная и усложненная версии бенчмарка MMLU, GPQA проверяет научные знания уровня аспирантуры, BBH — сложную логику, а GSM8K и MATH — математику.
Concertina выигрывает у Qwen3-1.7B по base-7, Pro, GPQA, BBH, GSM8K и MATH, а на MMLU (0,556 против 0,557) и Redux (0,587 против 0,591) уступает с минимальным отрывом. Учителя она не догоняет ни на одном тесте. По моему расчету из таблицы, средняя доля качества учителя равна 84%, как и заверяют авторы. Задачи на рассуждения держатся лучше всего, около 90% у base-7 и GSM8K, а знания и сложные вопросы теряют больше, Pro и BBH ближе к 75–80%.
Что экономится, а что нет
Вес в bf16 уменьшается с 8,0 до 4,5 ГБ. Эффективная глубина остается 36 слоев (18 уникальных блоков по два прохода), и KV-кэш такой же, как у Qwen3-4B. Вычислений на токен, вероятно, примерно столько же, потому что каждый общий блок исполняется дважды.
Замеров скорости и пропускной способности в карточке нет. Для устройств, где упираются в память весов, выигрыш виден сразу. Для серверного инференса, где решают скорость и кэш, его пока подтвердить нечем.
Как проверить
Код в репозитории короткий: функции fold_model и distill_loss, самотест на CPU. Лицензия Apache 2.0, как у исходной Qwen3-4B. В репозитории два коммита и единственный чекпоинт, других конфигураций (другой размер группы, другой ранг) нет.
Стоит проверить метод на модели другого семейства и измерить реальную скорость. Если она не вырастет, Concertina останется способом сделать модель компактнее исключительно по памяти, но не по скорости.
А как вам сама идея рекуррентного «сворачивания» слоев? Кто-нибудь уже успел прогнать чекпоинт у себя и замерить реальный tokens/sec на GPU по сравнению с обычной Qwen3-4B? Делитесь результатами в комментариях.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.