Неочевидный момент — на мини‑компьютерах можно отдать практически всю оперативную память для интегрированного GPU, что позволяет запускать LLM типа 26B/27B, без необходимости покупать дорогостоящие видеокарты. В статье покажу, как это сделать, какие LLM работают и оценю их эффективность.
Объект тестирования
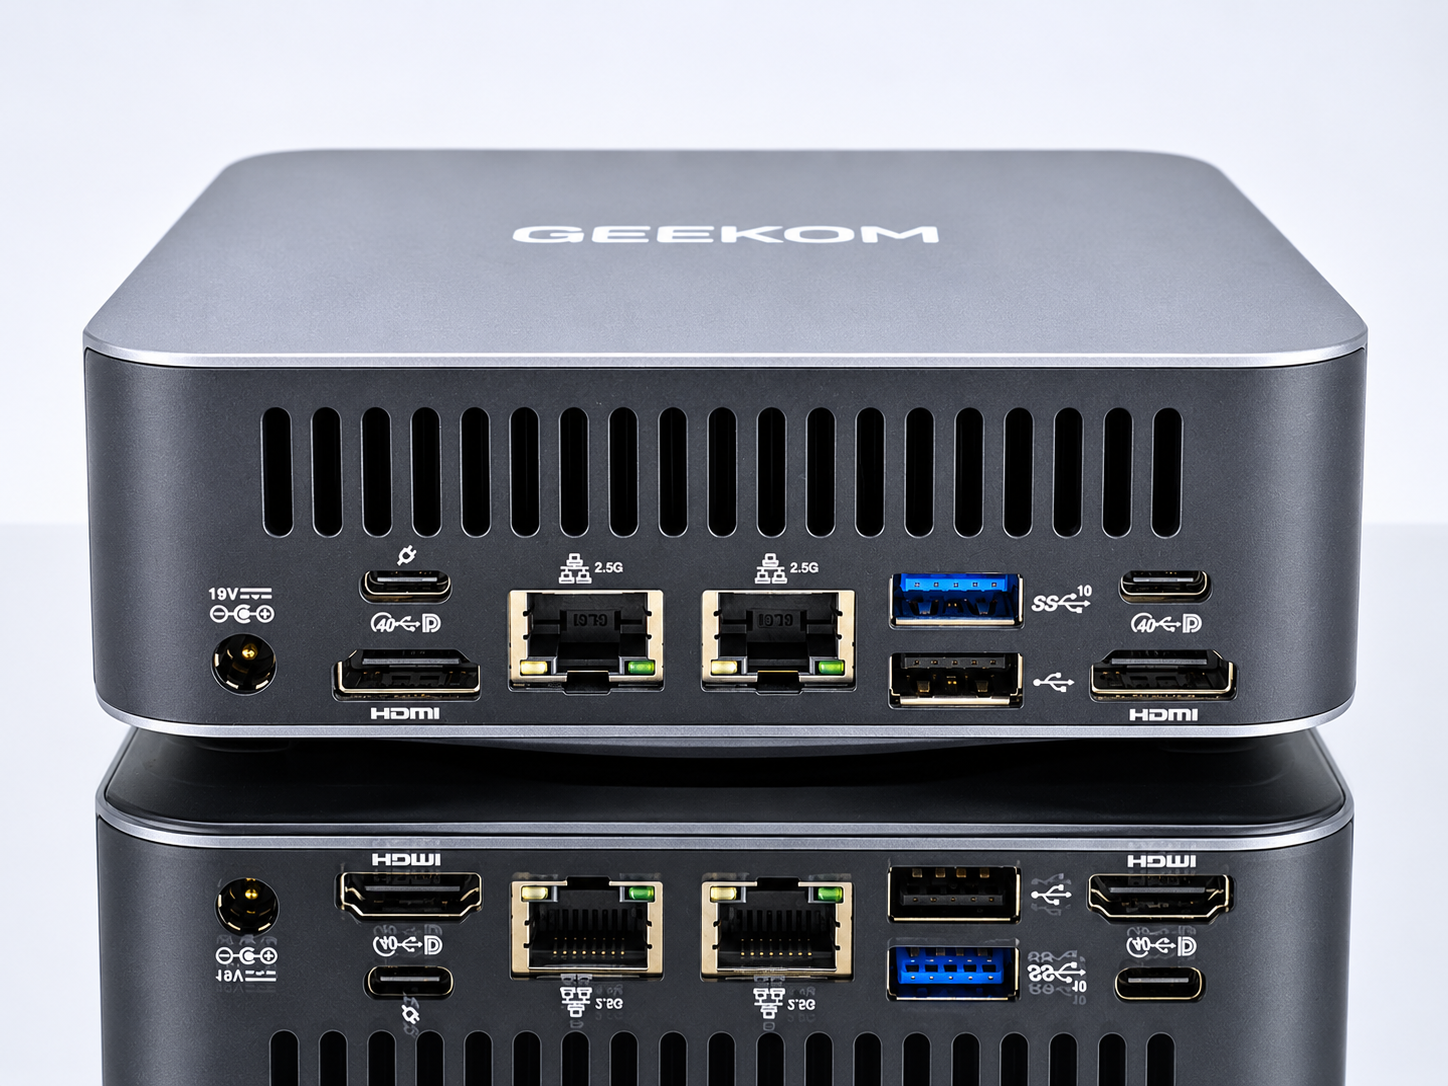
Продолжаю тестировать локальные нейросети в OpenSCAD, FreeCAD, Blender и SolidCraft. Цель — получить относительно недорогую и рабочую домашнюю связку. Для очередного теста взял мини компьютер GEEKOM GT1 Mega, у которого 32 ГБ ОЗУ, и в память помещаются модели в три‑четыре раза крупнее, чем я пробовал до этого (7B/8B на видеокарте с 8 ГБ VRAM).
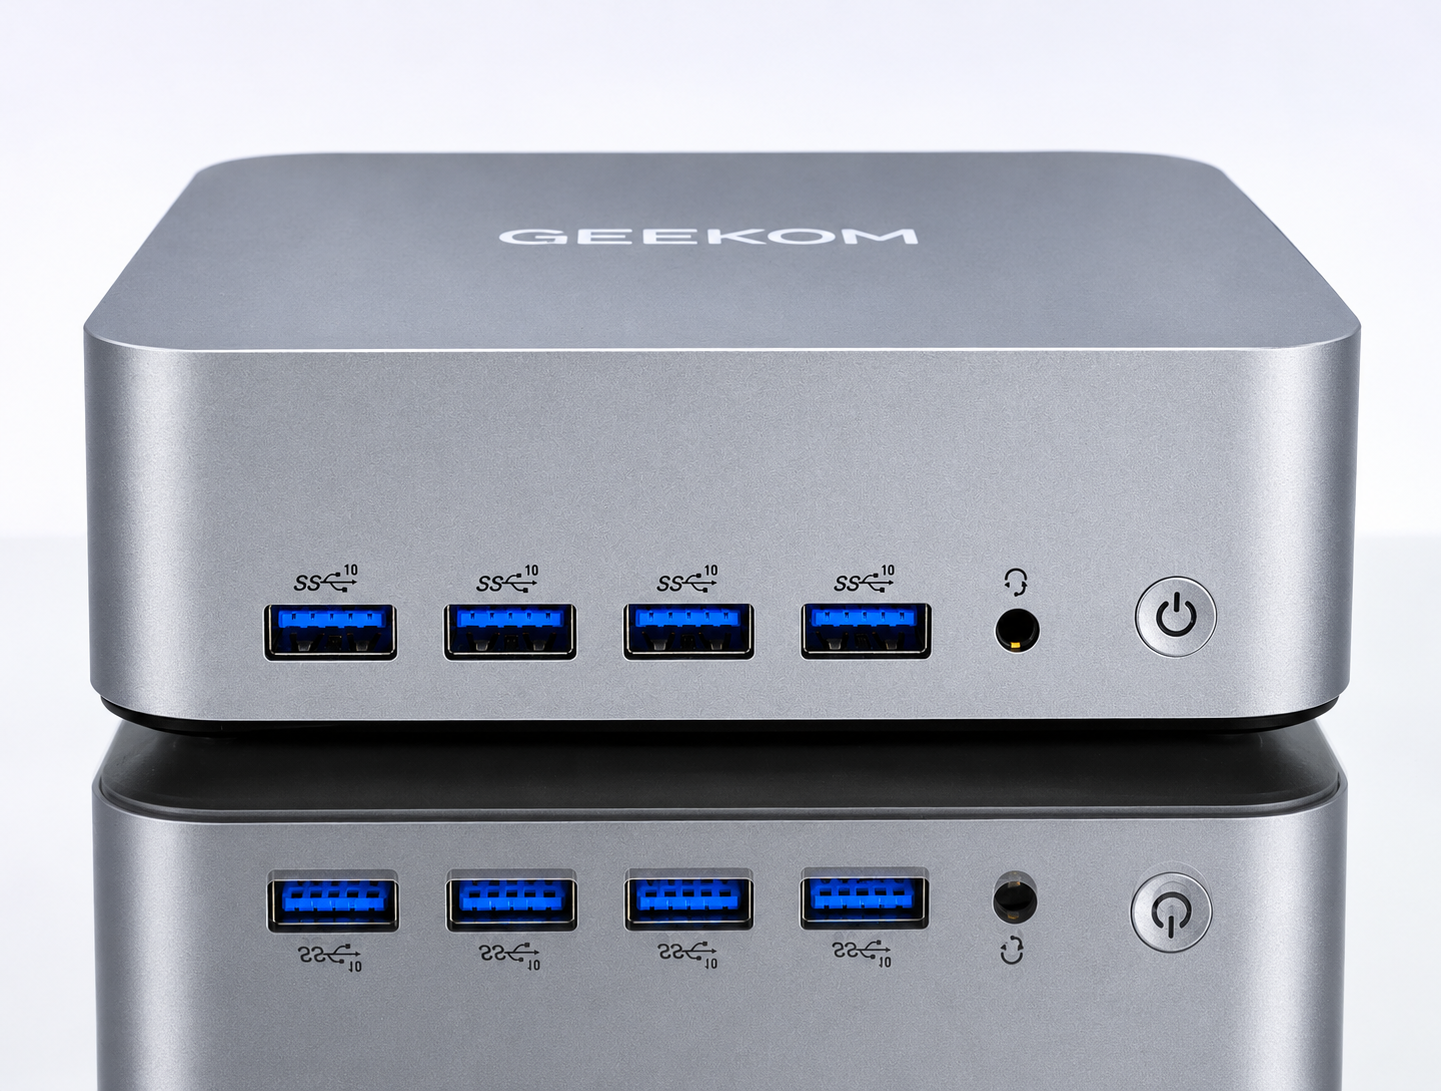
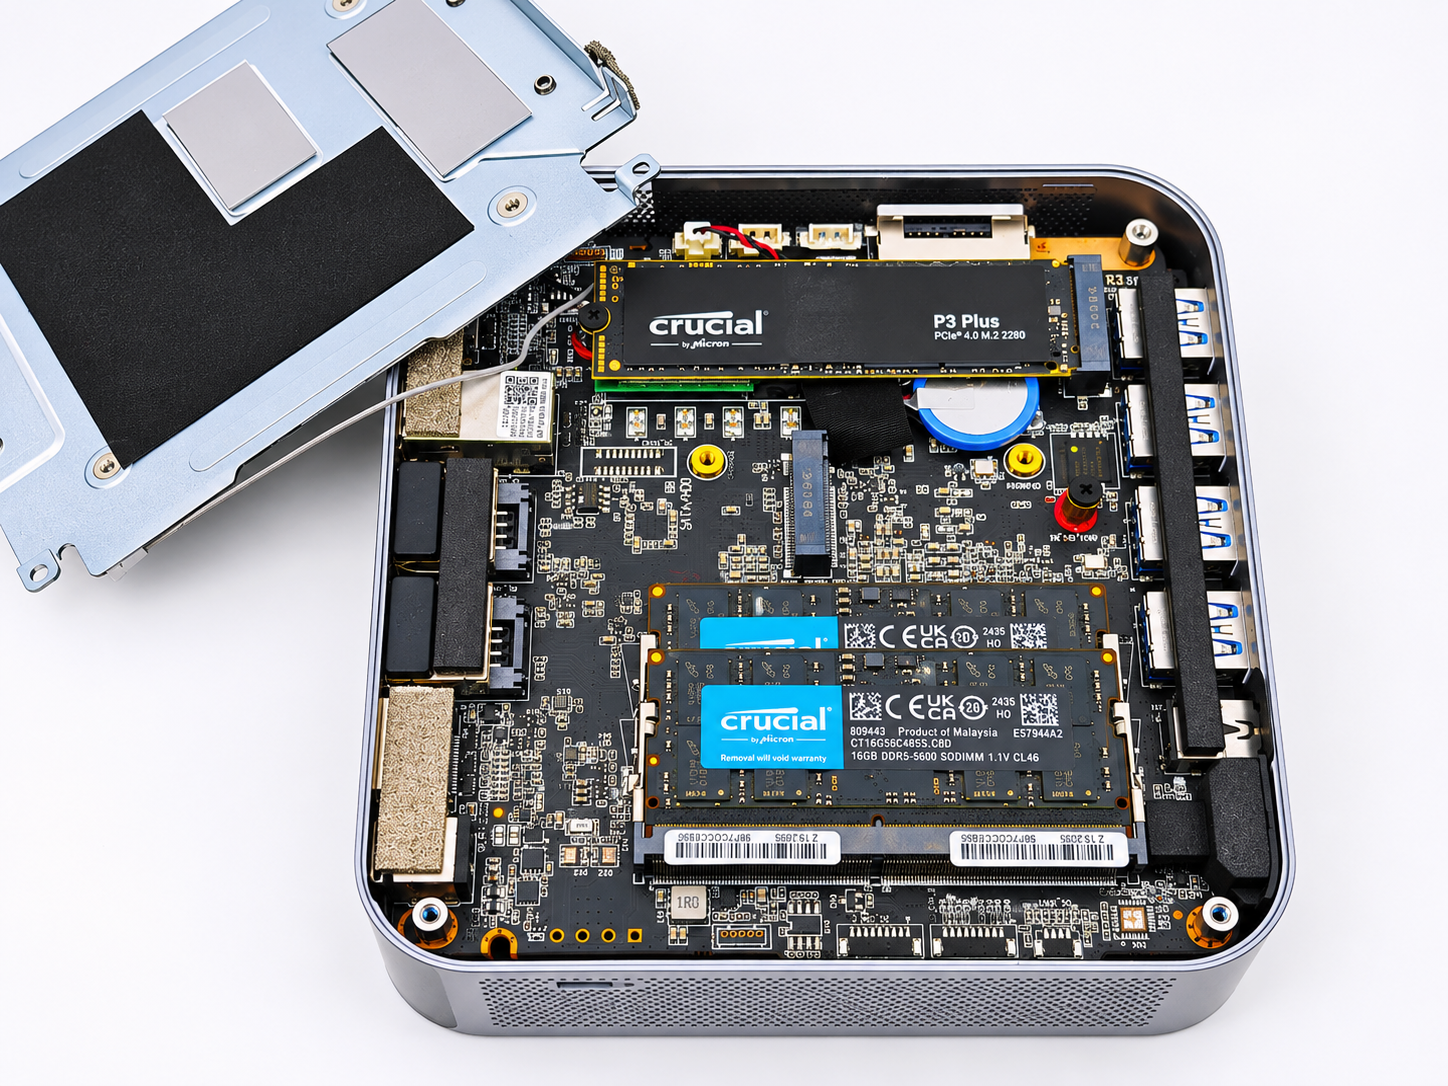
Чем интересен этот компьютер — маленький, тихий (действительно тихий, особенно если сравнивать с десктопами с дискретными GPU), с умеренным потреблением электроэнергии, с умеренным нагревом. В нём установлен процессор Intel Core Ultra 9 185H (16 ядер, 22 потока, максимальная частота 5,1 ГГц), встроенная видеокарта Intel Arc Graphics (8 ядер Xe), которая поддерживает аппаратную трассировку лучей и имеет выделенный NPU (блок нейронных вычислений). В комплектации с 32 ГБ двухканальной памяти DDR5-5600. Все это обеспечивает приличную аппаратную базу для локальных задач AI и работы с креативным контентом. В принципе, можно установить и 64 Гб памяти, но это потребует замену сразу двух модулей DDR5.
Shared GPU Memory Override
Часто сталкиваюсь с тем, что при запуске моделей практически «впритык» по объему памяти, Ollama падает с ошибкой нехватки памяти. Встроенная графика Arc своей памяти не имеет и берёт часть общей оперативной памяти. По умолчанию Windows разрешает ей около половины ОЗУ — ранее на компьютере с 32 ГБ Ollama видела 18 ГБ.
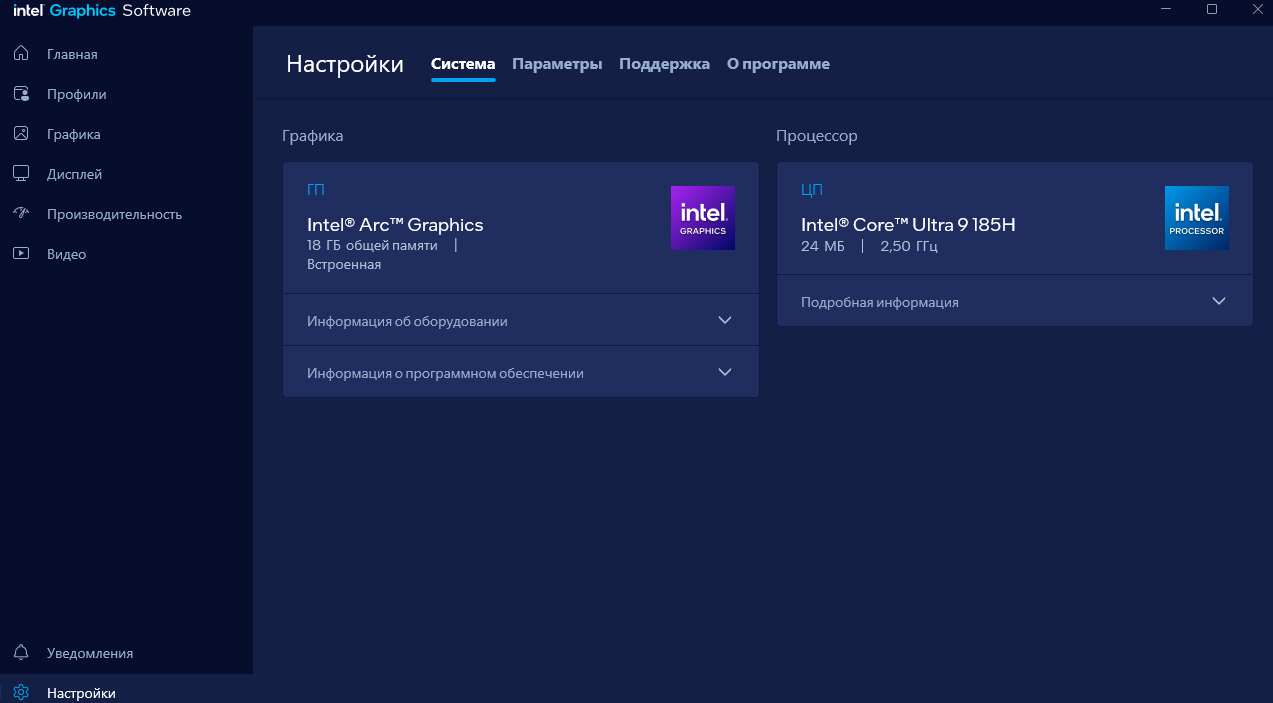
У процессоров Intel Core Ultra со встроенной Arc этот предел виртуальной VRAM меняется в программе Intel Graphics Software, в разделе Настройки — Система — Параметр Shared GPU Memory Override («переопределение общей памяти графики»). Отдаем необходимое количество ОЗУ для работы с iGPU. В данном случае я отдаю более 80% всей памяти — 26 Гб (можно перераспределить и больше). Этот объем определяю исходя из требований большинства LLM типа 26B/27B. После изменения нужна перезагрузка.
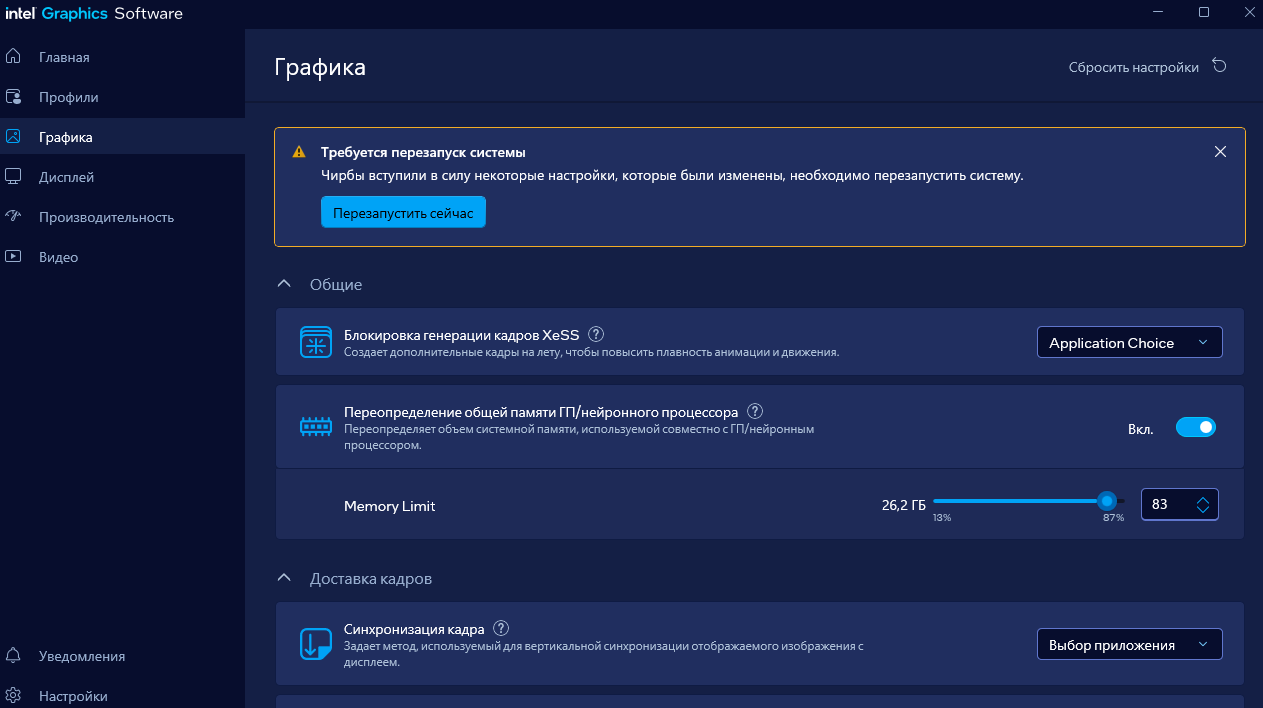
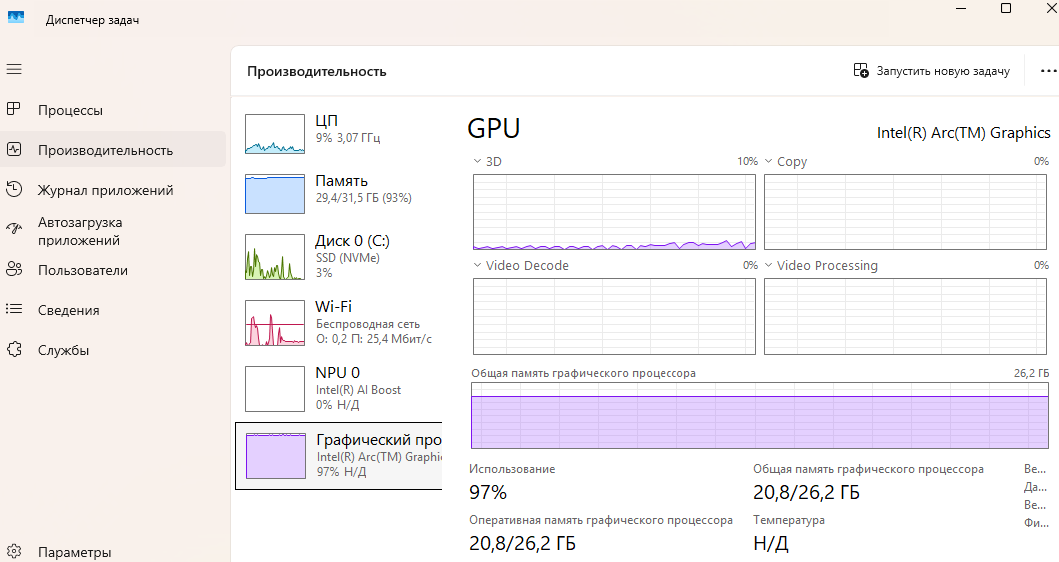
Фактически, этим ползунком я передвинул свой мини‑ПК практически на уровень видеокарт с 24 ГБ VRAM. Конечно, быстрее работать от этого он не стал. А вот с запуском LLM стало сильно легче. Gemma с окном контекста 24 576 токенов занимает в графике около 16–17 ГБ, Tiel‑Coder — около 17–18 ГБ, так что запас есть. Windows и остальным программам остаётся 5–6 ГБ. Тестам этого хватило: OpenSCAD, Blender, SolidCraft и компилятор arduino‑cli работали параллельно с моделью без проблем. Вот так это выглядит в диспетчере задач — при загруженной в памяти LLM востребовано 20 ГБ ОЗУ из 26 Гб, доступных для iGPU.
Тестирование
Я выбрал несколько моделей, которые могут более или менее комфортно работать с такими ресурсами и памятью. Речь идет про Gemma 4 26B‑A4B, Tiel‑Coder 35B‑A3B, GPT‑OSS 20B и Qwen3-Coder 30B‑A3B.
Начну с Gemma 4 26B‑A4B — это модель Google DeepMind. В названии два числа: всего в ней 25,2 миллиарда параметров, но на каждый токен работает около 4 миллиардов («A4B» — active 4B). Так устроены MoE‑модели: внутри много «экспертов», и на каждом шаге включаются только нужные. Памяти она требует как большая модель, а считает почти как маленькая. В Ollama: gemma4:26b, квантизация Q4_K_M, 18 ГБ на диске. Понимает картинки, умеет вызывать инструменты и рассуждать. Модуль для картинок (mmproj, 0,9 ГБ) Ollama скачивает сам. Установка простая:
ollama pull gemma4:26b
Tiel‑Coder 35B‑A3B — сторонняя сборка на Hugging Face (npario/Tiel‑Coder-35B‑A3B‑GGUF, лицензия MIT). Это доработанная под программирование модель Ornith-1.5 35B‑A3B на архитектуре Qwen 3.5 MoE: 34,7 миллиарда параметров, около 3 миллиардов активных. Я взял вариант UD‑IQ4_XS (17,7 ГБ) — по размеру он ближе всего к Gemma, будет интереснее сравнивать. Ставится вот такой командой:
ollama pull hf.co/npario/Tiel-Coder-35B-A3B-GGUF:UD-IQ4_XS
В процессе тестирования добавил GPT‑OSS 20B (открытая модель OpenAI в родном формате MXFP4) и Qwen3-Coder 30B‑A3B (специализированная модель Alibaba для кода, квантование IQ4_NL). Все это также будет интересно сравнить.
| Gemma 4 26B‑A4B | Tiel‑Coder 35B‑A3B | GPT‑OSS 20B | Qwen3-Coder 30B‑A3B |
Параметров всего / активных | 25,2 млрд / ~4 млрд | 34,7 млрд / ~3 млрд | 20,9 млрд / ~3,6 млрд | 30,5 млрд / ~3,3 млрд |
Формат | Q4_K_M | UD‑IQ4_XS | MXFP4 | IQ4_NL |
Файл | 18 ГБ | 18 ГБ | 13 ГБ | 17 ГБ |
Картинки | да | да | нет | нет |
Рассуждения | выключены | выключены | минимум (low) | нет |
Загрузка на GPU | 26 с | 31 с | 21 с | 28 с |
Эти модели также ставятся одной командой каждая:
ollama pull gpt-oss:20b
ollama pull hf.co/unsloth/Qwen3-Coder-30B-A3B-Instruct-GGUF:IQ4_NL
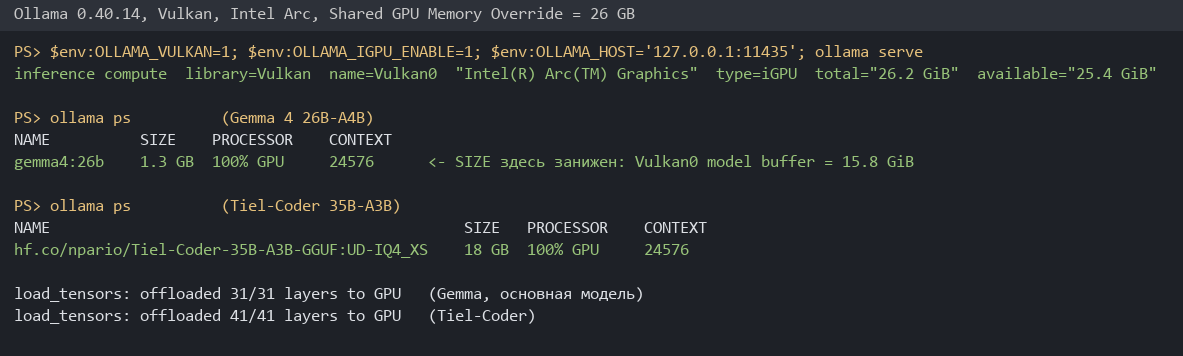
При настройке нужно указать переменные OLLAMA_VULKAN=1 и OLLAMA_IGPU_ENABLE=1, чтобы Ollama смогла запускать LLM на встроенной графике.
set OLLAMA_VULKAN=1
set OLLAMA_IGPU_ENABLE=1
set OLLAMA_HOST=127.0.0.1:11435
ollama serve
После перезагрузки Ollama сообщила, что графике доступно 26,2 ГБ. Модели загрузились полностью, все слои на графике: в ollama ps — «100% GPU».
Как я считал токены, время и энергию
Токены — из ответа Ollama: на каждой попытке prompt_eval_count (вход) и eval_count (выход), затем сумма по всем попыткам задания. Время — от начала задания до результата, включая запуск CAD‑программы и компилятора.
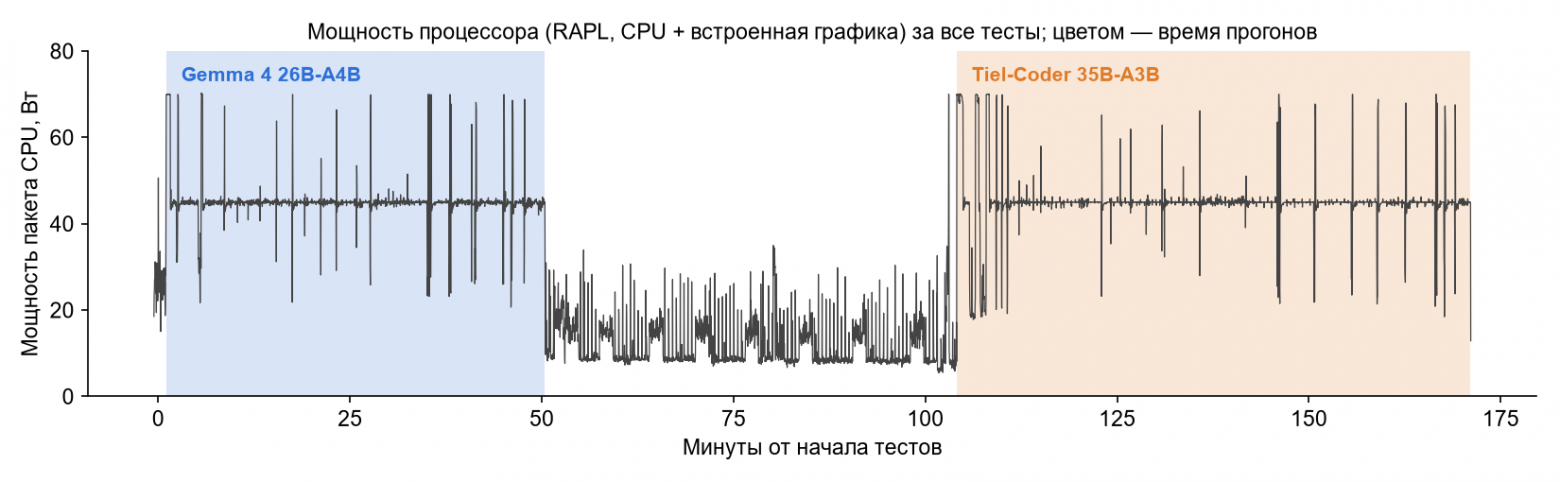
Энергию я мерил по счётчикам процессора. Windows отдаёт данные Intel RAPL через счётчики производительности «Energy Meter»: мощность всего процессорного пакета (ядра, встроенная графика, контроллер памяти). Скрипт записывал её раз в 1,7 секунды, потом я интегрировал мощность по времени каждого задания. Это не мощность от розетки: в неё не входят модули памяти, SSD, вентилятор и потери блока питания. Для мини‑ПК это примерно ещё 20–30% сверху.
| Gemma, CPU | Gemma, GPU | Tiel‑Coder, CPU | Tiel‑Coder, GPU |
Генерация, токенов/с | 15,8 | 19,1 (+21%) | 12,2 | 16,9 (+39%) |
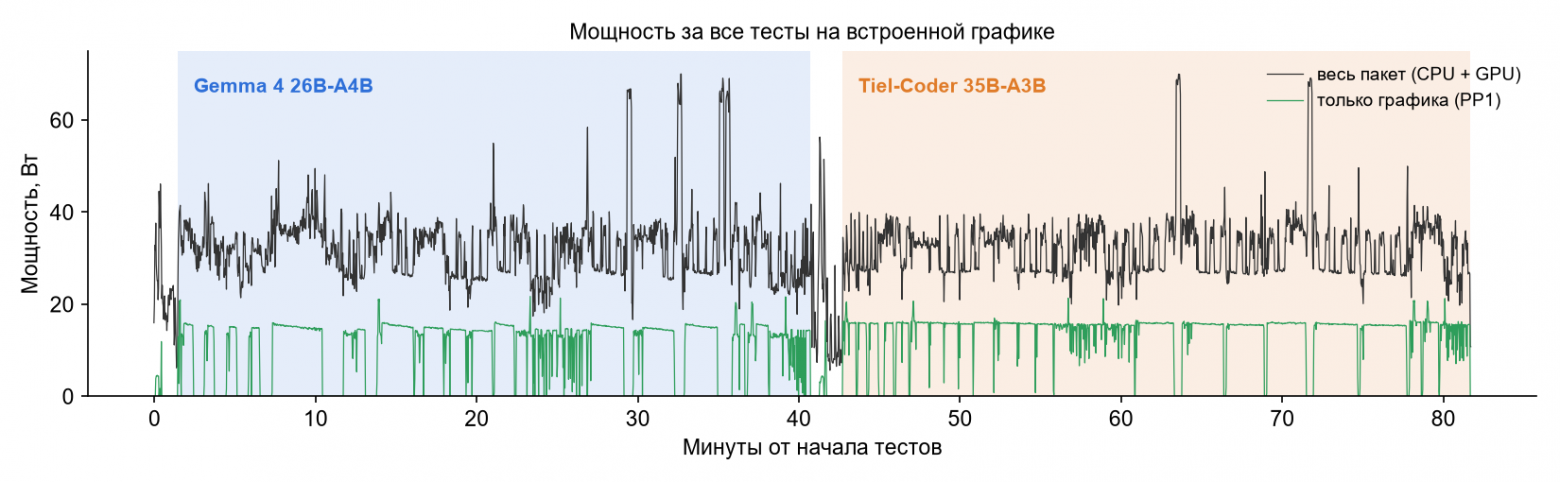
Средняя мощность пакета | 45,2 Вт | 32,6 Вт | 45,0 Вт | 32,1 Вт |
из них графика | 0 Вт | ≈ 11 Вт | 0 Вт | ≈ 14 Вт |
Энергия на 1000 токенов ответа | 1,20 Вт·ч | 0,87 Вт·ч (−28%) | 1,28 Вт·ч | 0,74 Вт·ч (−42%) |
Энергия всех 11 прогонов | 29,8 Вт·ч | 21,3 Вт·ч | 43,0 Вт·ч | 20,9 Вт·ч |
Время всех 11 прогонов | 40 мин | 39 мин | 57 мин | 39 мин |
Загрузка модели | 23 с | 26 с | 25 с | 31 с |
Что показали счётчики:
В простое пакет потребляет около 8,5 Вт.
Под нагрузкой — ровно 45 Вт: это долговременный лимит мощности процессора. Короткие пики до 70 Вт появляются при загрузке модели и в начале каждого ответа.
Встроенная графика всё это время спит (0 Вт), что подтверждает работу только на процессоре (на скриншоте пример работы на CPU).
Задания и референсные картинки
Использую вот такие задания для оценки генерации:
Шестерня для Pip‑Boy в OpenSCAD и во FreeCAD: 24 зуба, модуль 1 мм, толщина 5 мм, отверстие 5 мм с лыской (D‑профиль), четыре облегчающих отверстия 4 мм на радиусе 7 мм. Ожидаемый размер 26 × 26 × 5 мм.
Ручка‑крутилка в Blender: диаметр 22 мм, высота 14 мм, 18 рёбер накатки, фаска сверху, риска‑указатель, глухое отверстие 6 мм под вал.
Корпус под плату ESP32-C3 в SolidCraft через MCP: коробка 60 × 36 × 22 мм, открытая сверху, стенки и дно 2 мм; сохранить проект, экспортировать STEP и STL.
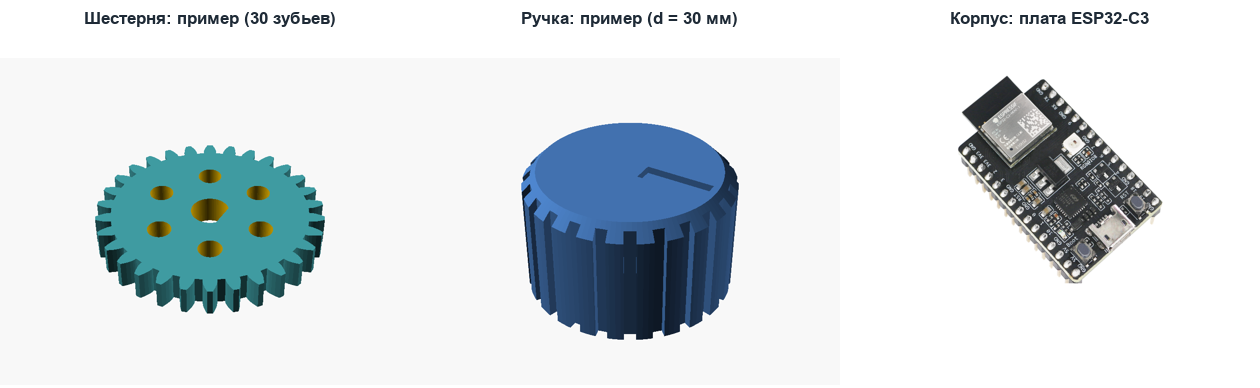
К каждому CAD‑заданию модель сразу получает картинку. Для шестерни и ручки это не готовый ответ, а похожая деталь другого размера: шестерня на 30 зубьев с шестью отверстиями и ручка диаметром 30 мм. Для корпуса — фото самой платы ESP32-C3. Идея в том, что модель видит, что именно от неё хотят, а размеры считает сама по заданию.
Тесты шли двумя группами:
Без шаблонов — только задание и картинка, каждое задание дважды. Это сложный тест: в таком режиме LLM не справилась ни разу, так что я не стану учитывать его результаты в итоге.
С шаблонами — подсказки‑образцы (рефренсы), например, изображение шестерни на 30 зубьев кодом, ручка кодом, цепочка вызовов SolidCraft для коробки другого размера. Использовал, чтобы сравнить скорость и расход токенов на одинаковой задаче.
По сути, первая часть тестов не так интересна, так как без рефренсов шанс получить корректный ответ сильно снижается. Всё гонял один скрипт bench2.py: отправлял задание в Ollama, вырезал код, запускал OpenSCAD, FreeCAD, Blender или arduino‑cli, при ошибке возвращал её текст модели. Для SolidCraft — используется агент через MCP.
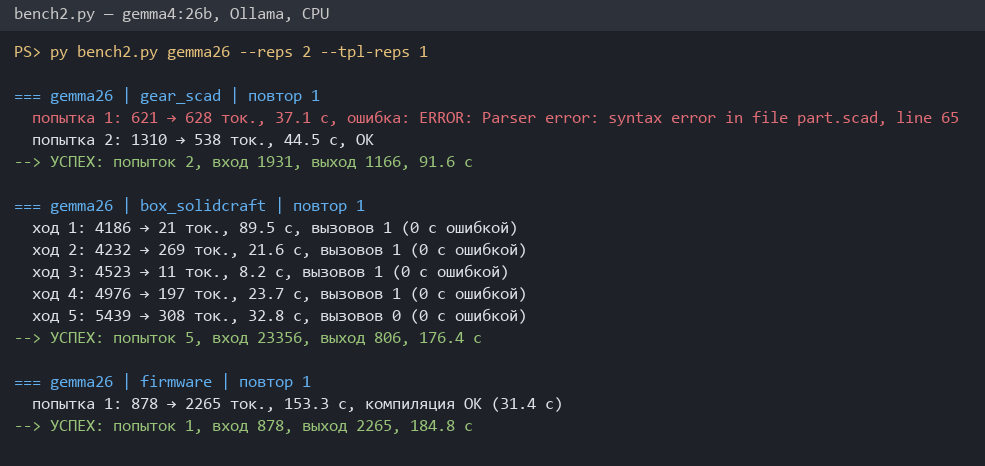
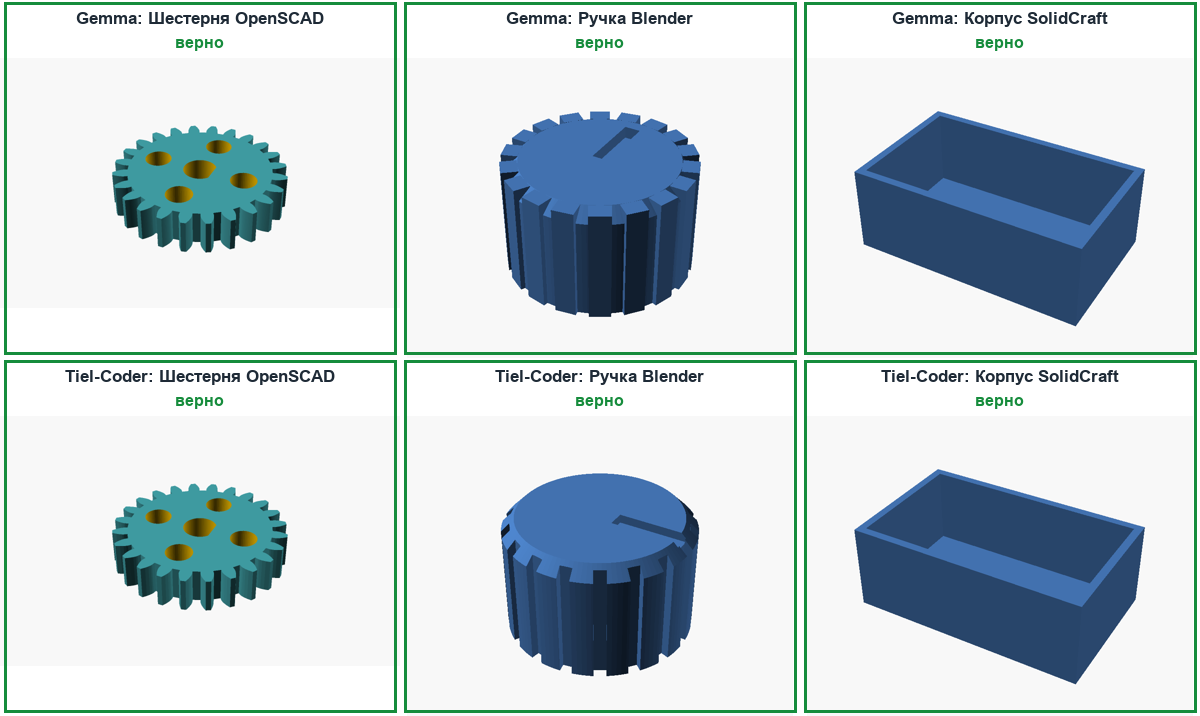
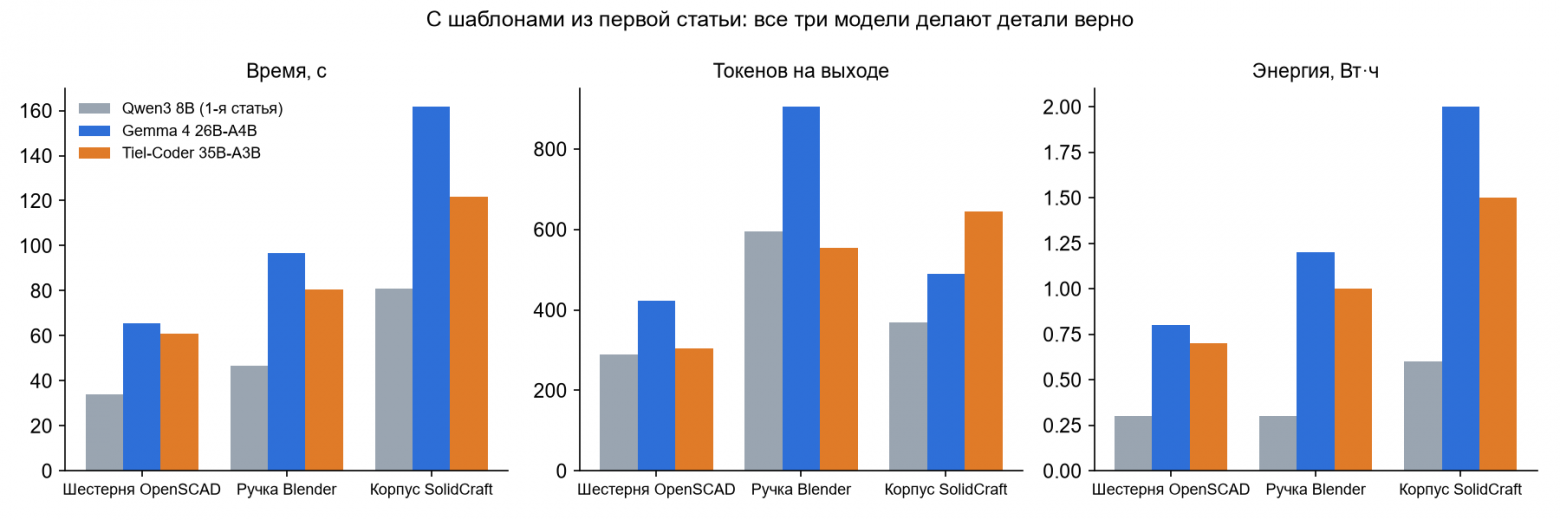
С подсказками (рефренсами) модели сделали все три детали верно и с первой попытки. Но интересный момент — они не сделали это быстрее 8B‑моделей. Сравниваю модели попарно.
Задание | Модель | Время, с | Вход, ток. | Выход, ток. | Энергия, Вт·ч |
Шестерня OpenSCAD | Qwen3 8B | 34 | 760 | 289 | 0,26 (оценка) |
| Gemma 26B | 65 | 1 091 | 423 | 0,8 |
| Tiel‑Coder 35B | 61 | 1 564 | 304 | 0,7 |
Ручка Blender | Qwen3 8B | 47 | 935 | 595 | 0,35 (оценка) |
| Gemma 26B | 97 | 1 363 | 905 | 1,2 |
| Tiel‑Coder 35B | 81 | 1 759 | 555 | 1,0 |
Корпус SolidCraft | Qwen3 8B | 81 | 28 663 | 369 | 0,6 (оценка) |
| Gemma 26B | 162 | 34 717 | 489 | 2,0 |
| Tiel‑Coder 35B | 122 | 47 324 | 644 | 1,5 |
Скорость генерации у всех примерно одинаковая, около 15 токенов/с (упирается в ресурсы мини‑ПК), а большие модели пишут длиннее: больше комментариев, больше проверок. Кроме того, картинка добавляет 300–500 токенов на входе, а процессор читает промпт заметно медленнее, чем встроенная графика. Когда задача уже разжёвана шаблоном, ум большой модели не нужен, и она просто дороже в плане ресурсов.
| Gemma 4 26B‑A4B | Tiel‑Coder 35B‑A3B |
Прогонов (без шаблонов + с шаблонами) | 10 + 3 | 10 + 3 |
Входных токенов | 125 493 | 296 370 |
Выходных токенов | 32 130 | 40 467 |
Время всех прогонов | 49 мин | 67 мин |
Генерация, токенов/с | 15,7 | 12,3 |
Средняя мощность пакета | 45 Вт | 45 Вт |
Энергия пакета, Вт·ч | 37,2 | 50,2 |
Из них без шаблонов | 33,2 Вт·ч на 10 прогонов | 46,9 Вт·ч на 10 прогонов |
Стоимость при 6,5 ₽ за кВт·ч | 0,24 ₽ | 0,33 ₽ |
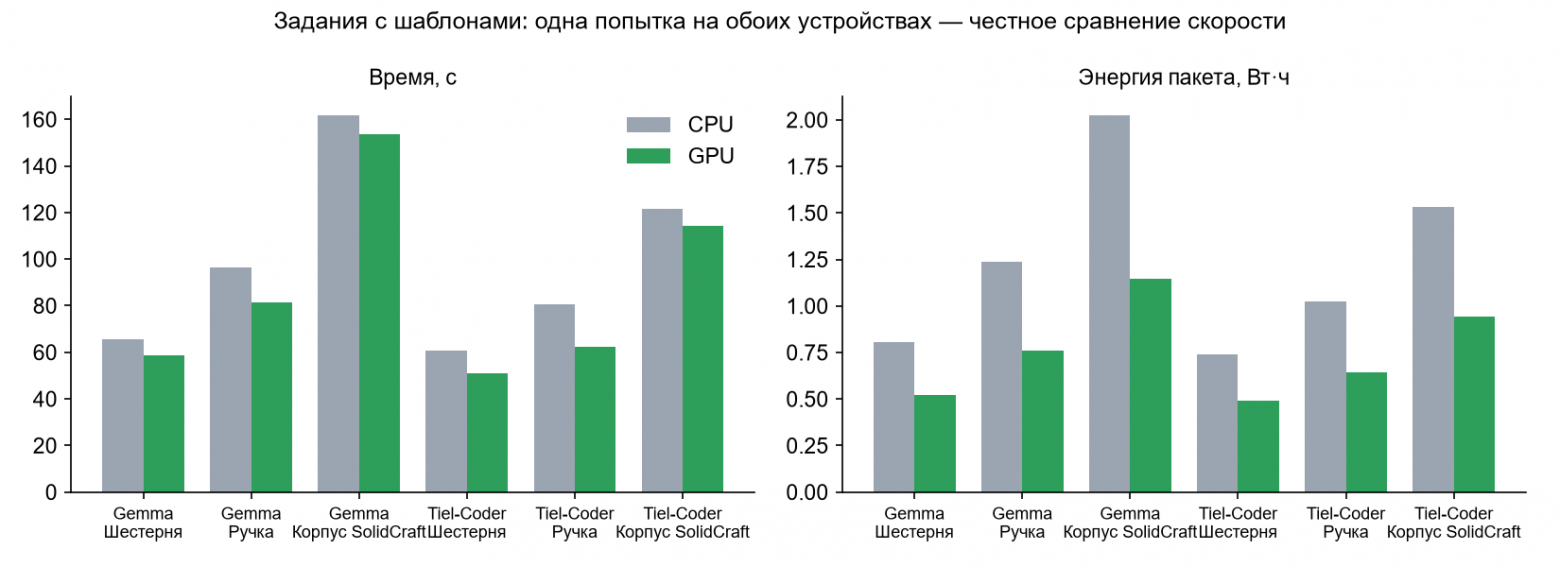
Энергия одного прогона без шаблона — от 1,8 Вт·ч (шестерня, корпус) у Gemma и до 9,3 Вт·ч у Tiel‑Coder. Если добавить потребление остального компьютера, все 26 прогонов обошлись примерно в 0,11 кВт·ч — меньше рубля. Tiel‑Coder потратила в 2,4 раза больше входных токенов, чем Gemma. Почти всё ушло на неудачи: каждая новая попытка отправляет модели весь предыдущий диалог. В SolidCraft она делала по 13 ходов там, где Gemma обходилась пятью. На встроенной графике генерация быстрее на 21% у Gemma и на 39% у Tiel‑Coder. Средняя мощность процессорного пакета падает с 45 до 32–33 Вт. Энергия на 1000 токенов ответа снижается на 28% и 42%. Качество деталей от устройства не зависит: разброс между двумя повторами одного задания больше, чем разница CPU и GPU.
Вторая пара сравнений. Обе модели GPT‑OSS 20B и Qwen3-Coder 30B‑A3B решают с первой попытки.
Задание (с шаблоном) | Модель | CPU | GPU | Энергия CPU → GPU |
Шестерня OpenSCAD | Gemma 26B | 65 с | 58 с | 0,80 → 0,52 Вт·ч |
| Tiel‑Coder 35B | 61 с | 51 с | 0,74 → 0,49 Вт·ч |
Ручка Blender | Gemma 26B | 97 с | 81 с | 1,24 → 0,76 Вт·ч |
| Tiel‑Coder 35B | 81 с | 62 с | 1,03 → 0,65 Вт·ч |
Корпус SolidCraft | Gemma 26B | 162 с | 154 с | 2,02 → 1,15 Вт·ч |
| Tiel‑Coder 35B | 122 с | 114 с | 1,53 → 0,94 Вт·ч |
В SolidCraft выигрыш по времени меньше всего (5–7%). Там модель пишет мало, а в основном читает длинный промпт: описания 13 инструментов и историю вызовов, 30–60 тысяч токенов за задание. Часть времени уходит на саму SolidCraft. Точно разделить, что из этого ускорилось, а что нет, по моим замерам нельзя. Энергию графика экономит и здесь — около 40%.
Результаты сравнительного теста
С подсказками‑образцами из первой статьи все четыре модели сделали все три детали верно и с первой попытки. Здесь сравнение самое честное — задача одна и та же.
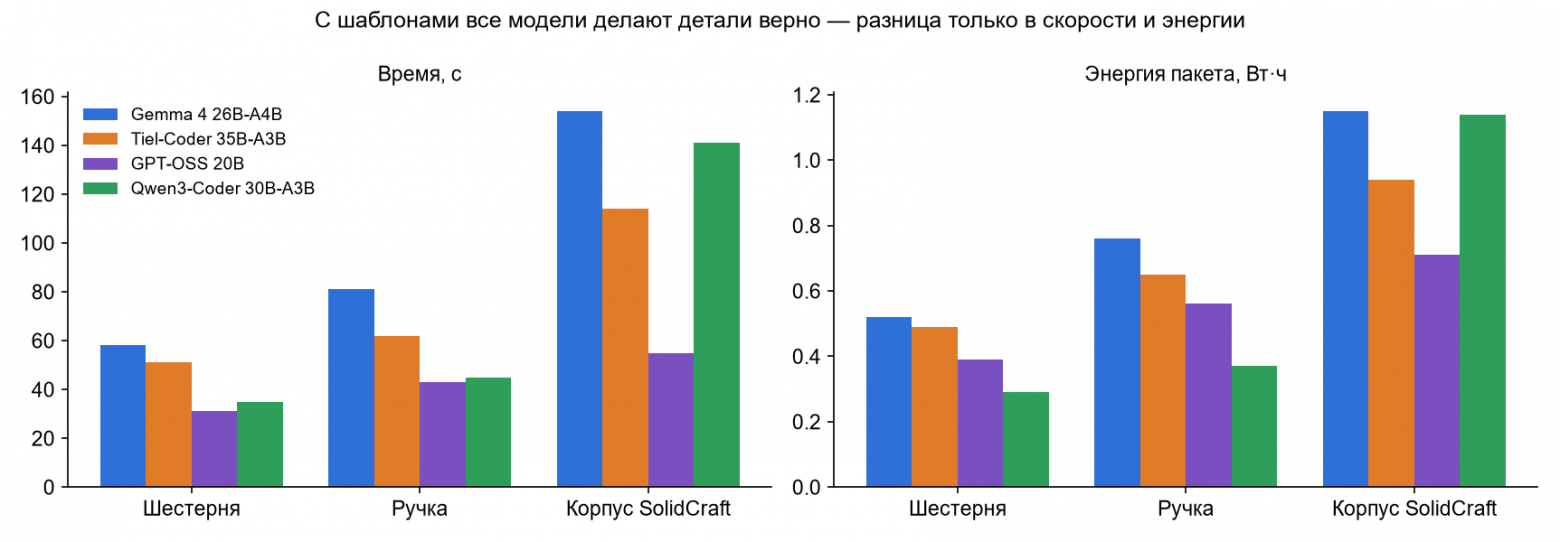
GPT‑OSS и Qwen3-Coder пишут по шаблону короче и без лишних комментариев, поэтому заканчивают вдвое быстрее Gemma. В SolidCraft GPT‑OSS вообще лучшая: 55 секунд против 114–154 у остальных. Если задача уже разжёвана шаблоном, эти две модели выгоднее.
Задание (с шаблоном) | Gemma 4 26B | Tiel‑Coder 35B | GPT‑OSS 20B | Qwen3-Coder 30B |
Шестерня OpenSCAD | 58 с / 0,52 Вт·ч | 51 с / 0,49 Вт·ч | 31 с / 0,39 Вт·ч | 35 с / 0,29 Вт·ч |
Ручка Blender | 81 с / 0,76 Вт·ч | 62 с / 0,65 Вт·ч | 43 с / 0,56 Вт·ч | 45 с / 0,37 Вт·ч |
Корпус SolidCraft | 154 с / 1,15 Вт·ч | 114 с / 0,94 Вт·ч | 55 с / 0,71 Вт·ч | 141 с / 1,14 Вт·ч |
Какую модель выбрать для этого или подобного мини‑ПК
Итог:
Основная модель — Gemma 4 26B‑A4B. Единственная из четырёх, которая хоть что‑то делает в CAD без шаблона и пишет компилируемые прошивки. Самая быстрая на этой графике, понимает картинки и умеет работать с MCP.
Вторая модель для прошивок и кода — GPT‑OSS 20B. Лучше всех доводит код до компиляции по ошибкам и быстрее всех работает по шаблону. Минус — на встроенной Arc она нагружает и процессор: 44 Вт вместо 29–33.
Qwen3-Coder 30B‑A3B — только с шаблонами. Самая экономная, но без примера в CAD и прошивке не справилась ни разу.
Tiel‑Coder 35B‑A3B можно удалять. Ни в одной категории она не первая.
Критерий | Лучшая модель |
Скорость генерации | Gemma 4 26B — 19,1 токена/с |
Экономия энергии | Qwen3-Coder 30B — 0,61 Вт·ч на 1000 токенов |
CAD без шаблона | Gemma 4 26B — 4 из 6 деталей хотя бы частично |
Прошивка ESP32 без шаблона | Gemma 4 26B и GPT‑OSS 20B — 2 из 2 |
Исправление ошибок по тексту компилятора | GPT‑OSS 20B |
Работа по готовому шаблону | GPT‑OSS 20B (быстрее всех), Qwen3-Coder (экономнее всех) |
Картинки в задании | только Gemma 4 и Tiel‑Coder |
Несколько замечаний по результатам тестов:
Если у вас Core Ultra со встроенной Arc и 32 ГБ памяти — поднимите Shared GPU Memory Override до 24–26 ГБ. Это единственное, что нужно, чтобы модели на 17–18 ГБ работали на графике.
Встроенная графика быстрее процессора на 20–40% в генерации и тратит на 28–42% меньше энергии на тот же объём текста. Пакет работает на 32 Вт вместо 45.
В MCP‑агенте SolidCraft, где модель в основном читает длинный промпт, выигрыш по времени всего 5–7%, по энергии — около 40%. Если честно, именно SolidCraft мне понравился для генерации моделей (корпуса и подобное) с помощью LLM, а не FreeCAD/OpenSCAD.
Основные ошибки моделей одинаковы на CPU и на GPU. Лечатся они примерами и точными формулировками в задании, а не железом. Если контекст получается длинный — то не нужно отправлять всю информацию при очередном этапе (оправьте только нужную информацию для устранения ошибок, без раздувания контекста). Большие задачи дробите на законченные части.
Для создания CAD‑моделей на 32 ГБ начните с gemma4:26b. Она понимает картинки, умеет MCP и без шаблона решает часть задач, которые 8B не по силам. Используйте рефренсы (шаблоны и примеры) — с ними любая модель делает деталь верно с первой попытки. Добавляйте в задание контрольную величину: объём коробки, центр масс, число зубьев. Тогда модель может проверить себя сама.
Еще один неочевидный вывод — для простых задач с коротким контекстом и с рефренсом компактная 8B‑модель может оказаться выгоднее.
Если держать только одну модель на ПК, то имеет смысл выбрать Gemma 4 26B‑A4B. Она самая быстрая (19 токенов/с) и единственная из четырёх иногда справляется с CAD‑заданием без шаблона, и она понимает картинки (для рефренсов). Если место на диске позволяет — Gemma для «подумать и сделать с нуля» и GPT‑OSS для быстрых задач по шаблону и доводки кода. Qwen3-Coder — самая экономная, но без шаблона не справилась ни с одним заданием.