Китайская платформа доставки Meituan открыла веса мультимодальной MoE-модели LongCat-2.5 примерно на 1,6 трлн параметров, из которых около 48 млрд активны на токен, под свободной лицензией MIT. Главный интерес: модель обучалась без западных ускорителей, а в официальном руководстве по запуску нет ни одной инструкции под видеокарты NVIDIA. Веса уже лежат в репозитории Hugging Face.
Сравнение
Таблица ниже собрана по данным технического отчета Meituan — это собственные замеры разработчиков.
Тест | LongCat-2.5 | DeepSeek-V4.1-Flash | Модель Sol от OpenAI | Opus 5 |
Terminal Bench v2.1 | 88,4 | 90,6 | 88,8 | 89,1 |
DeepSWE | 64,6 | 74,2 | 72,7 | нет данных |
Terminal Bench v4.0 | 38,5 | нет данных | 37,3 | 53,9 |
Лидерство у LongCat-2.5 только в тесте BrowseComp (91,9 балла) — это бенчмарк на глубокий поиск информации в интернете, где модель сама гуглит, открывает страницы и собирает сложные факты. Но этот результат получен в закрытой среде самой Meituan, а в таких тестах итоговый балл сильно зависит от того, какой поисковый движок прикрутили к нейросети.
Зато интересен скачок на DeepSWE (с 9,7 у прошлой LongCat-2.0 до 64,6) — это тест на полноценную разработку, где модель должна сама разобраться в чужом репозитории, найти причину бага и написать рабочий патч. В свежем техническом отчете разработчики пояснили, как добились такого роста: модель дообучали на реальных пул-реквестах с GitHub в полностью изолированных контейнерах. Чтобы нейросеть не «читерила» и не подглядывала готовые ответы, ей отключали интернет, вычищали историю коммитов и кэш, а за чистотой решения следила отдельная проверяющая LLM.
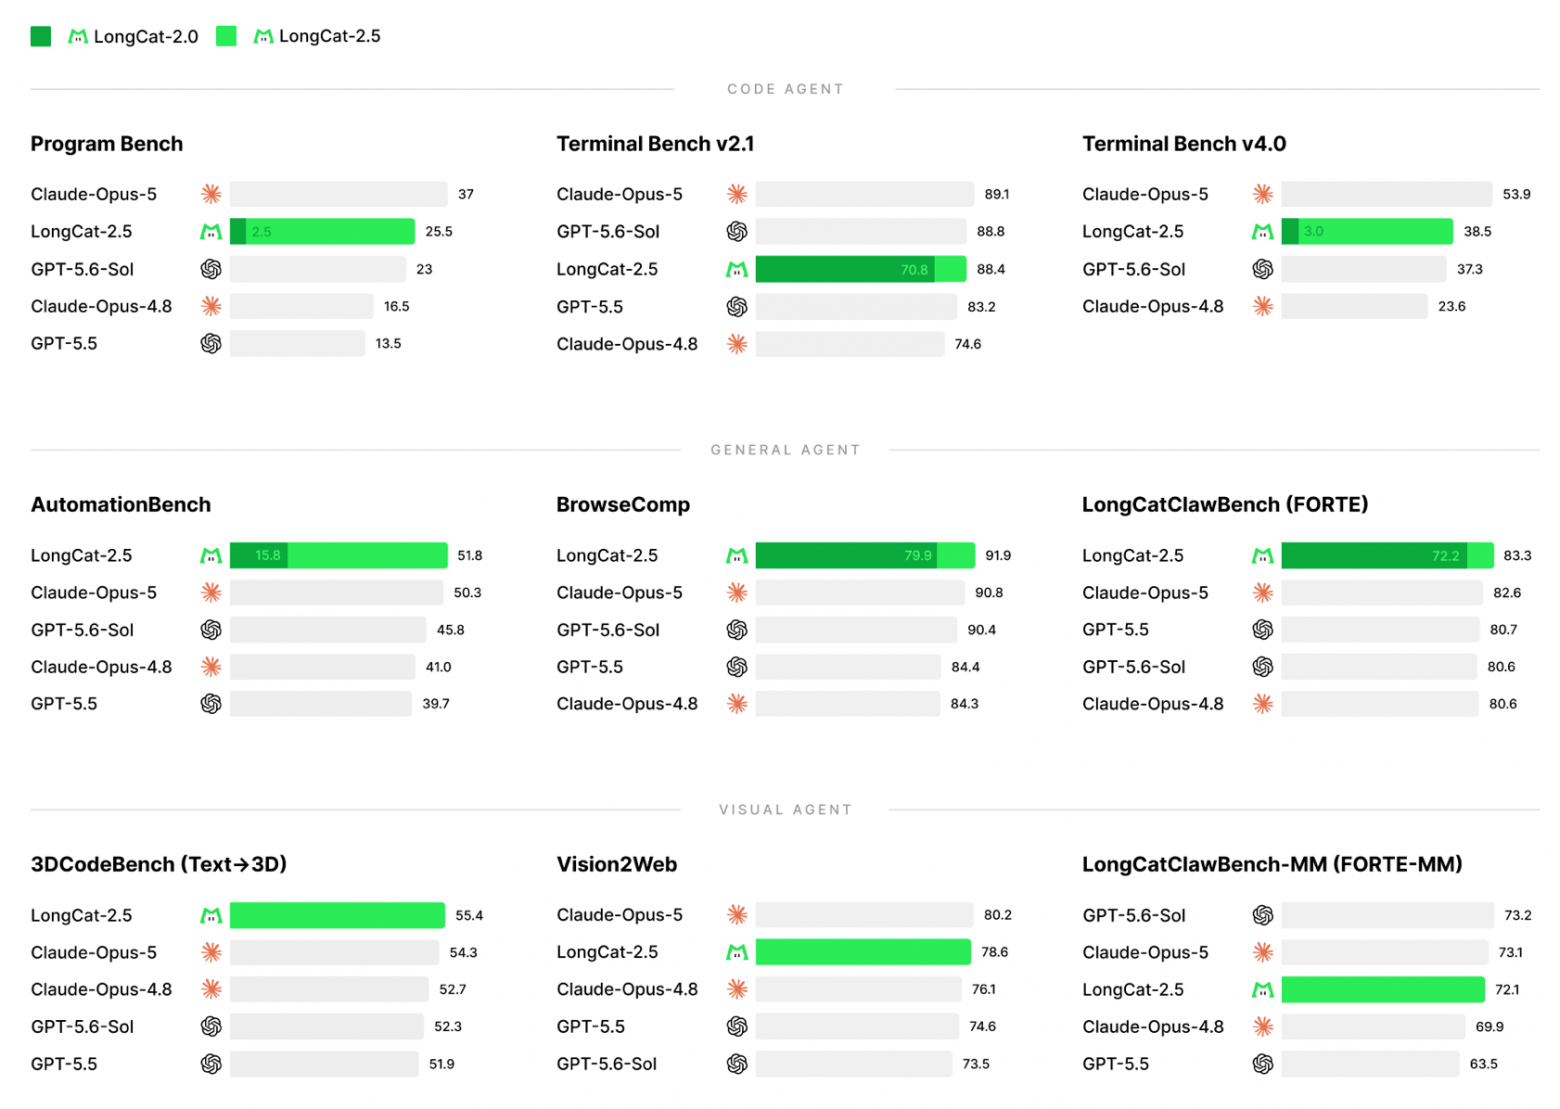
Тем не менее в этой задаче модель все равно уступает DeepSeek и OpenAI на 8–10 пунктов. А в Terminal Bench v4.0 — тесте на умение самостоятельно работать в командной строке Linux (настраивать окружение, деплоить, чинить конфиги) — до Opus не хватает 15 пунктов.
Можно ли запустить это у себя
Чтобы запустить это у себя, Meituan описывает кластер из 194 ускорителей Huawei Ascend серии Atlas A2: два заняты обработкой изображений, 64 — prefill и 128 — decode.
Гайд лежит в ветке longcat-2.5-npu репозитория SGLang-FluentLLM, требований к GPU NVIDIA и объему видеопамяти в официальной карточке нет. Для тех, кто работает вне Китая, это значит, что модель доступна через API либо придется ждать портирования архитектуры в стандартные ветки vLLM и SGLang под CUDA.
Квантованная версия W4A4 с четырехбитными весами экспертов и активациями, по данным Meituan, ускоряет обработку промпта на 43,3% и генерацию на 42,77% против восьмибитного варианта при сохранении точности. Контекст через API заявлен до миллиона токенов, генерация ответа — до 128 000.
Впрочем, уже заметили неприятный нюанс в мультимодальной части. Через API модель принимает видеофайлы исключительно по публичной URL-ссылке, поэтому напрямую скормить ей закрытый скринкаст с багом без костылей не выйдет.
Сколько стоит
Через API поддерживаются стандартные форматы OpenAI и Anthropic, модель без проблем подключается к Claude Code и Codex. Цена в рекламный период демпинговая — около 0,27 € за миллион входных токенов и 1,07 € за миллион выходных, но срок акции ограничен. Для сравнения, Qwen4-Max от Alibaba, вышедшая в понедельник, по данным TheNextWeb стоит 1,50 $ и 4,50 $ за миллион входных и выходных токенов при закрытых весах.
Что осталось неясным
Размер модели в карточке и в метаданных Hugging Face все еще указан по-разному (1,6 и 1,8 трлн параметров) — авторы это расхождение так и не объяснили, вероятно, дело в разном подсчете вспомогательных визуальных модулей. Также пока нет реальных замеров от сообщества по деградации качества на максимальном контексте в 1 млн токенов.
У открытых весов появился сильный кодовый вариант под MIT с копеечным API на старте. Проверять его стоит исключительно на собственных репозиториях — замеры BrowseComp здесь плохой ориентир.
Как думаете, станет ли связка больших китайских MoE-моделей и кластеров на Huawei Ascend реальной альтернативой Nvidia вне Китая, или без поддержки CUDA такие релизы останутся историей исключительно для внутреннего рынка? Обсудим в комментариях.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.