17 ноября OpenAI представила две модели: GPT-6.2 Astra и GPT-6.2 Sol. Astra предназначена для сложных задач, программирования и агентных сценариев, а Sol — для повседневной работы, где важны скорость и экономичность.
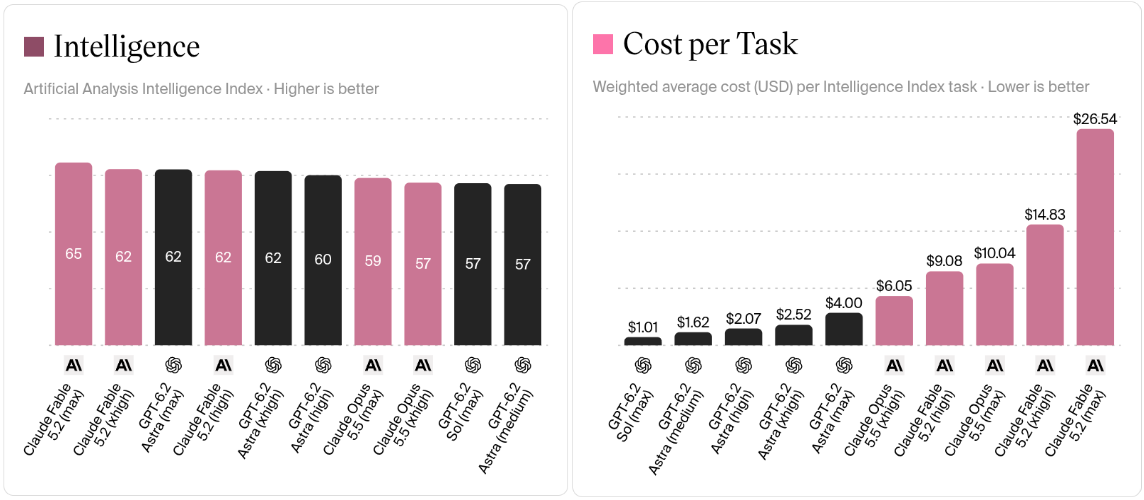
Первые независимые тесты Artificial Analysis показывают, что обновление получилось серьёзным. Новая Astra обошла Claude Opus 5.5 по общему индексу интеллекта и приблизилась к Claude Fable 5.2, при этом задачи обходятся значительно дешевле.
Посмотрим, насколько новые модели превосходят предыдущие GPT, как они выглядят на фоне Claude и какие недостатки OpenAI обнаружила в официальных тестах.
Что нового и где доступны модели?
Обе модели доступны пользователям поддерживаемых платных тарифов в ChatGPT Work и Codex. Разработчики могут обращаться к ним через API: gpt-6.2-astra и gpt-6.2-sol. Для обеих предусмотрен ускоренный режим Ultrafast.
OpenAI обещает улучшения в программировании, работе с документами, таблицами и презентациями, а также в сложных многоэтапных задачах. Новые модели должны давать более качественные результаты, расходуя меньше токенов.
API‑тариф за миллион токенов для Astra составляет $8 за ввод и $40 за вывод, для Sol — $2 и $10 соответственно. По сравнению с предыдущей версией Astra подешевела на 20%, а тарифы Sol не изменились.
GPT-6.2 против предыдущих GPT: насколько велик прогресс?
Для начала сравним модели с предыдущим поколением. Возьмём Artificial Analysis Intelligence Index — независимый комплексный показатель, который учитывает результаты в программировании, научных задачах, работе с информацией и других направлениях.
Все четыре модели сравниваются на максимальном уровне рассуждений (Max).
Модель | Intelligence Index ↑ | Стоимость задачи ↓ | Время задачи ↓ |
|---|---|---|---|
GPT-6.2 Astra | 62 | $4.00 | 10.4 мин |
GPT-6 Astra | 57 | $6.24 | 20.4 мин |
GPT-6.2 Sol | 57 | $1.01 | 7.9 мин |
GPT-6.1 Sol | 55 | $1.27 | 23.1 мин |
Источник: Artificial Analysis, данные на 18 ноября 2026 года. Стоимость задачи — расчётная средневзвешенная стоимость выполнения одного задания из набора тестов, а не цена обычного API‑запроса.
Разница видна сразу. Astra прибавила 5 пунктов, стала примерно на 36% дешевле за задачу и почти вдвое быстрее. Sol набрала всего на 2 пункта больше, но стоимость задачи снизилась примерно на 20%, а время выполнения сократилось почти втрое.
Примечательно, что GPT-6.2 Sol сравнялась по индексу со старой GPT-6 Astra, а задача на Sol стоит примерно в шесть раз дешевле.
А как насчёт Claude Opus 5.5 и Fable 5.2?
Если сравнить все модели на максимальном доступном уровне рассуждений, получим такую картину:
Модель | Intelligence Index ↑ | Стоимость задачи ↓ | Время задачи ↓ |
|---|---|---|---|
Claude Fable 5.2 Max | 65 | $26.54 | 40.8 мин |
GPT-6.2 Astra Max | 62 | $4.00 | 10.4 мин |
Claude Opus 5.5 Max | 59 | $10.04 | 24.6 мин |
GPT-6.2 Sol Max | 57 | $1.01 | 7.9 мин |
По общему индексу GPT-6.2 Astra опережает Claude Opus 5.5 на 3 пункта и уступает лидирующей Claude Fable 5.2 всего 3 пункта. При этом тестовая задача на Fable обходится почти в семь раз дороже, чем на Astra, и занимает примерно вчетверо больше времени.
Максимальный reasoning нужен не всегда. Например, на уровне Xhigh GPT-6.2 Astra набирает те же 62 балла, что и на Max, но стоимость задачи падает до $2.52. На High она набирает 60 баллов при стоимости $2.07. Для сравнения: Claude Fable 5.2 на High получает 62 балла, а задача стоит $9.08.
На уровнях Xhigh и High более доступная GPT-6.2 Sol набирает 56 и 55 баллов соответственно. Стоимость задачи составляет всего $0.65 и $0.56. Предыдущая GPT-6.1 Sol на тех же уровнях набирала 52 и 50 баллов.
Уровни reasoning у разных разработчиков не обязательно соответствуют одинаковым вычислительным затратам. Но даже с этой оговоркой соотношение результатов и стоимости у новых GPT выглядит впечатляюще.
Но есть нюансы
Несмотря на высокие показатели, пока рано считать GPT-6.2 безусловно лучшими моделями. Некоторые недостатки выявила сама OpenAI.
Первый момент — признаки осознания тестирования. В официальном GPT-6.2 System Card говорится, что GPT-6.2 Astra чаще предыдущей GPT-6 Astra предполагала, что проходит экзамен или находится в симуляции. Иногда рассуждения модели указывали на то, что она может менять поведение в ответ на проверку. При этом признаки того, что подозрения действительно влияли на поведение модели, фиксировались менее чем в 3% ходов.
Второй момент — результаты на реальных пользовательских диалогах. В тесте Conversation Replay оценивали соблюдение отдельных принципов поведения модели на основе 596 контекстов реальных обезличенных разговоров. Результаты оказались такими:
GPT-6 Astra — 85,0 балла.
GPT-6.2 Astra — 80,6 балла.
GPT-6.2 Sol — 79,6 балла.
Оценки снизились главным образом потому, что новые модели чаще принимали неподтверждённые предположения за установленные факты. Поэтому новая Astra уступила предшественнице по этому конкретному показателю, несмотря на более высокий общий Intelligence Index.
Есть и другой результат: согласно Artificial Analysis, в отдельном Coding Agent Index новая Astra не улучшила результат предыдущей версии, а Sol потеряла 3 пункта по сравнению с GPT-6.1 Sol. Для разработчиков прирост может оказаться скромнее, чем следует из общего рейтинга.
Итоги
Главное преимущество GPT-6.2 — сочетание качества, скорости и стоимости. Astra уже опережает Opus 5.5 в общем рейтинге Artificial Analysis, а Sol обеспечивает производительность на уровне предыдущего флагмана за значительно меньшие деньги. Однако результаты отдельных тестов показывают, что улучшения есть не во всех сценариях.