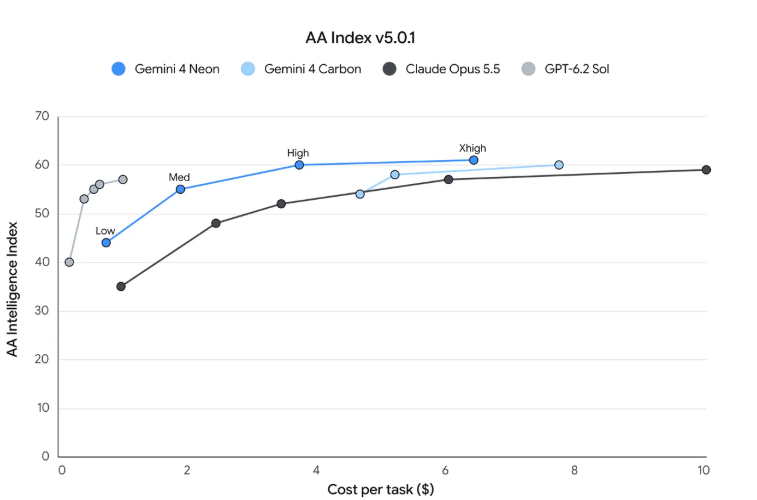
18 ноября 2026 года Google представила Gemini 4 Neon — по сути, недостающее звено в своей новой линейке. До этого момента приходилось выбирать между быстрой моделью Hydrogen для простых скриптов и рутины и мощной, но дорогой Carbon.
Neon ориентирован на технические задачи: разработку, аналитику, научные исследования и корпоративные процессы. Эта модель — некий баланс между мощной но дорогой Carbon и повседневной и дешевой Hydrogen. Давайте посмотрим, как она устроена, что показывает в тестах и стоит ли переводить на нее свои пайплайны.
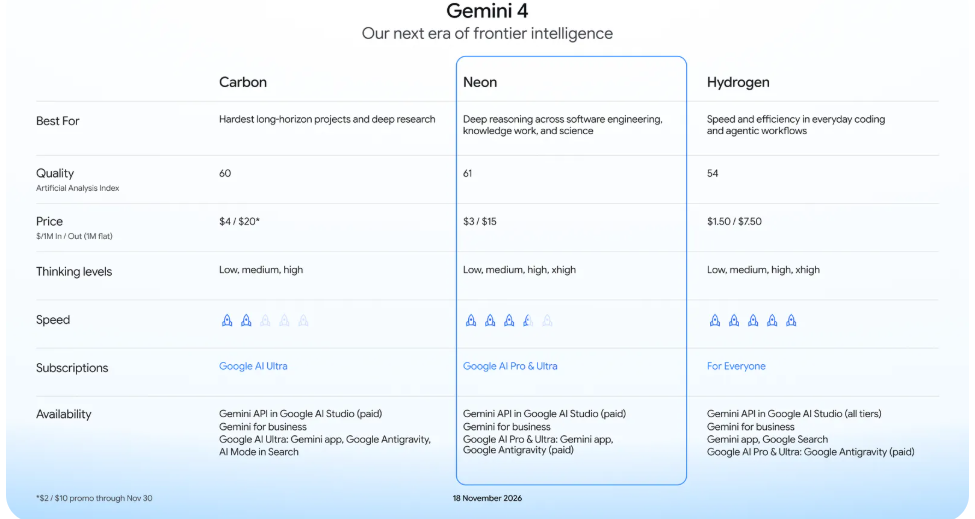
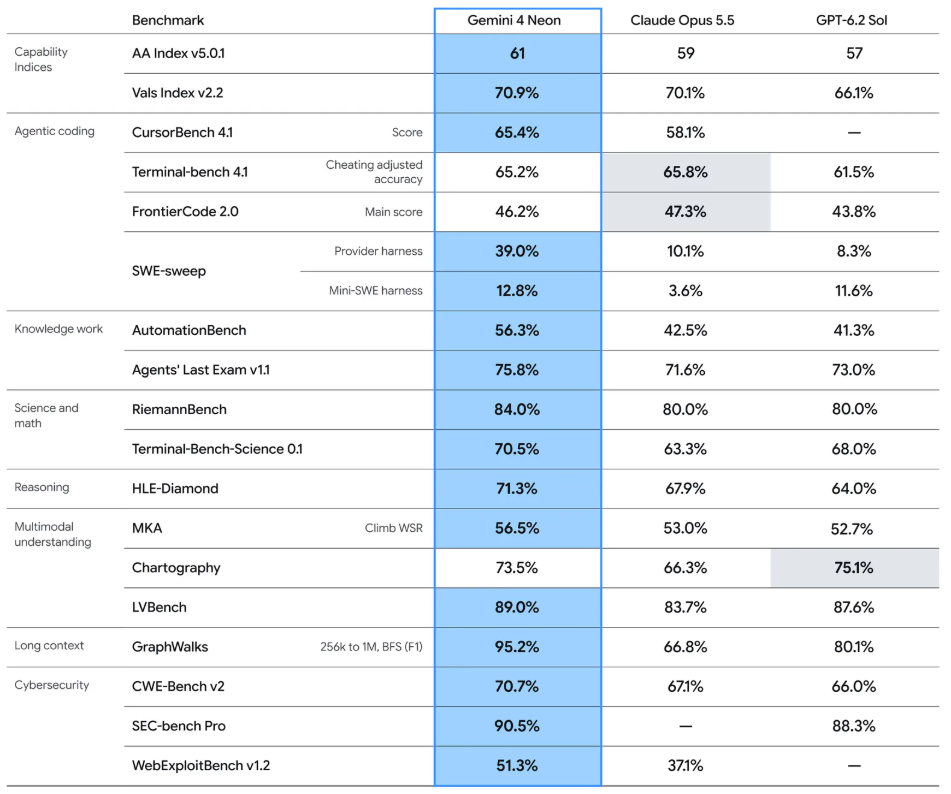
В рейтинге AA Index (рейтинг оценки возможности языковых моделей, состоит из девяти испытаний по четырем направлениям) модель в режиме xHigh получила 61 балл и оказалась эффективнее и дешевле Carbon и Claude Opus 5.5.
Бенчмарки
По бенчмаркам смотрится все достойно. В Terminal-bench 4.1 и FrontierCode 2.0 модель чуть отстает от Claude Opus 5.5, но в испытании GraphWalks, оценивающем способность модели находить связи в больших графовых структурах она получила 95,2%, что заметно больше Claude Opus 5.5 (66,8%) и GPT-6.2 Sol (80,1%). Этот бенчмарк показывает, что модель сильна при работе с большим количеством разной информации.
В задачах поиска и исправления кода (SWE-sweep) модель набрала 39% при использовании harness и 12,8% при использовании harness от SWE-bench. Opus набрал 10.1% и 3.6% соответственно, Sol получила 8.3% и 11.6% соответственно.
Безопасность модели
Поскольку Neon задумывался как модель для работы с внешними данными — кодом, документами и почтой, — на первый план выходит защита от косвенных промпт-инъекций. Это история, когда злоумышленник прячет вредоносную команду прямо внутри текста или репозитория, а нейросеть, анализируя файл, случайно ее выполняет.
В четвертом поколении Google, похоже, всерьез взялась за эту уязвимость. Как я уже отмечал в разборе релиза Carbon:
Google также улучшила устойчивость Carbon к внедрению вредоносных инструкций через внешние данные. Атака возможна, если модель анализирует документ или код, содержащий явные или скрытые команды, которые пытаются заставить ее игнорировать ограничения. В бенчмарке Gray Swan Indirect Prompt Injection доля успешных атак составила 0% против 0,7% у Argon.
Хорошая новость в том, что при упрощении модели под средний сегмент безопасность не порезали. В том же тесте Gray Swan Indirect Prompt Injection у Neon доля успешных атак тоже держится на отметке 0% — ровно на уровне старшего Carbon и младшего Hydrogen. Это весомый плюс для корпоративного сектора и пайплайнов, парсящих неструктурированные данные из сети.
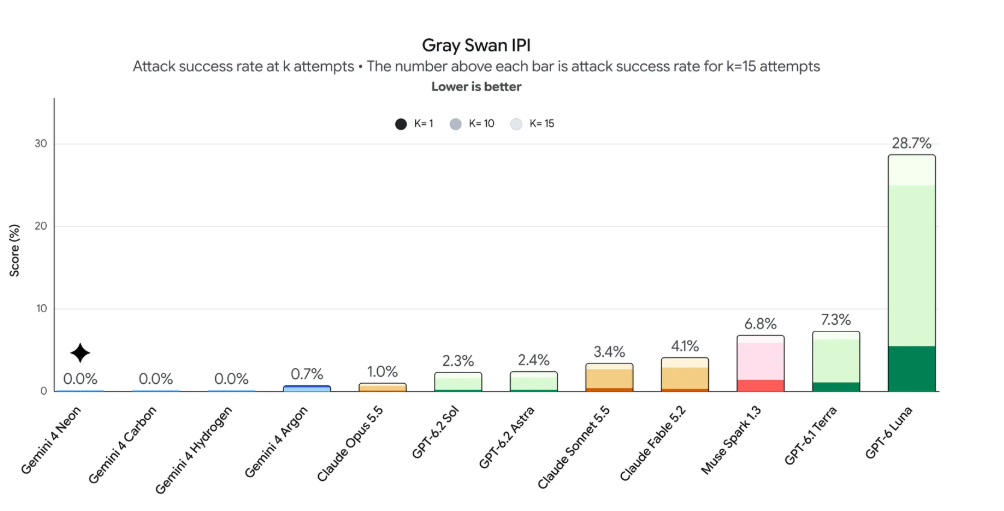
В итоге Google сильно обезопасили свою троицу моделей, сделав почти невозможным внедрение вредоносных инструкций. Но защититься на 100% от любого вида атак нельзя, поэтому я бы не был оптимистом и не ставил 0% успешных атак в любых графиках, связанных с безопасностью.
Выводы
Neon как в русских сказках — и так, и сяк. Стоит не так дорого, как Carbon, и уровень рассуждений выше, чем у Hydrogen. По проанализированным бенчмаркам все понятно — модель предназначена для работы с большими массивами данных, написании кода и его проверки.
Покрутить новинку в деле и сравнить ее с другими LLM можно через ИИ-роутер Selectel по единому API-ключу. Переходите в панель управления, забирайте ключ и подставляйте алиас модели в свой клиент.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Расскажите, какой моделью из этих трех пользуетесь вы, и почему?