Раньше качественный дашборд по командам из Jira аналитик собирал порядка месяца. Теперь сборка зашита в скиллы ИИ-агента, данные обновляются сами, и борд для новой команды я собираю максимум за час.
Немного контекста. Я был CTO, в инженерном блоке было больше 50 человек. Сейчас руковожу платформой на 2000 финансовых операций в секунду. Борды команд мне нужны каждый спринт, а ждать месяц на каждый новый борд я не готов.
Ниже — как это устроено, что видно на таком борде и где агент ошибается. Последнее, по-моему, самое полезное.
Куда уходил месяц
Свёрстать страницу с графиками несложно. Время съедают данные и их проверка. Вот на чём я сам спотыкался.
Причина переноса спрятана в комментариях. Задача уехала в следующий спринт, а почему — видно только из переписки под ней. Чтобы понять картину по спринту, кто-то садился и вычитывал комментарии руками.
Выгрузка молча теряет строки. Постраничная выгрузка из Jira отдала заметно меньше задач, чем было на самом деле. Ошибки не было, просто часть строк не доехала.
Неправильный периметр. Один раз периметр команды задали неправильно, и объём работы вышел в разы меньше настоящего. На графике это выглядело правдоподобно.
BI про спринт ничего не знает. Я как-то разбирал большой BI-дашборд по разработке. Графиков много, а метрик спринта среди них нет.
Каждая такая ошибка тихая. Борд выглядит уверенно, а цифры на нём неверные. Поэтому месяц аналитика — это в основном сверка.
Как устроено сейчас
Источники только на чтение
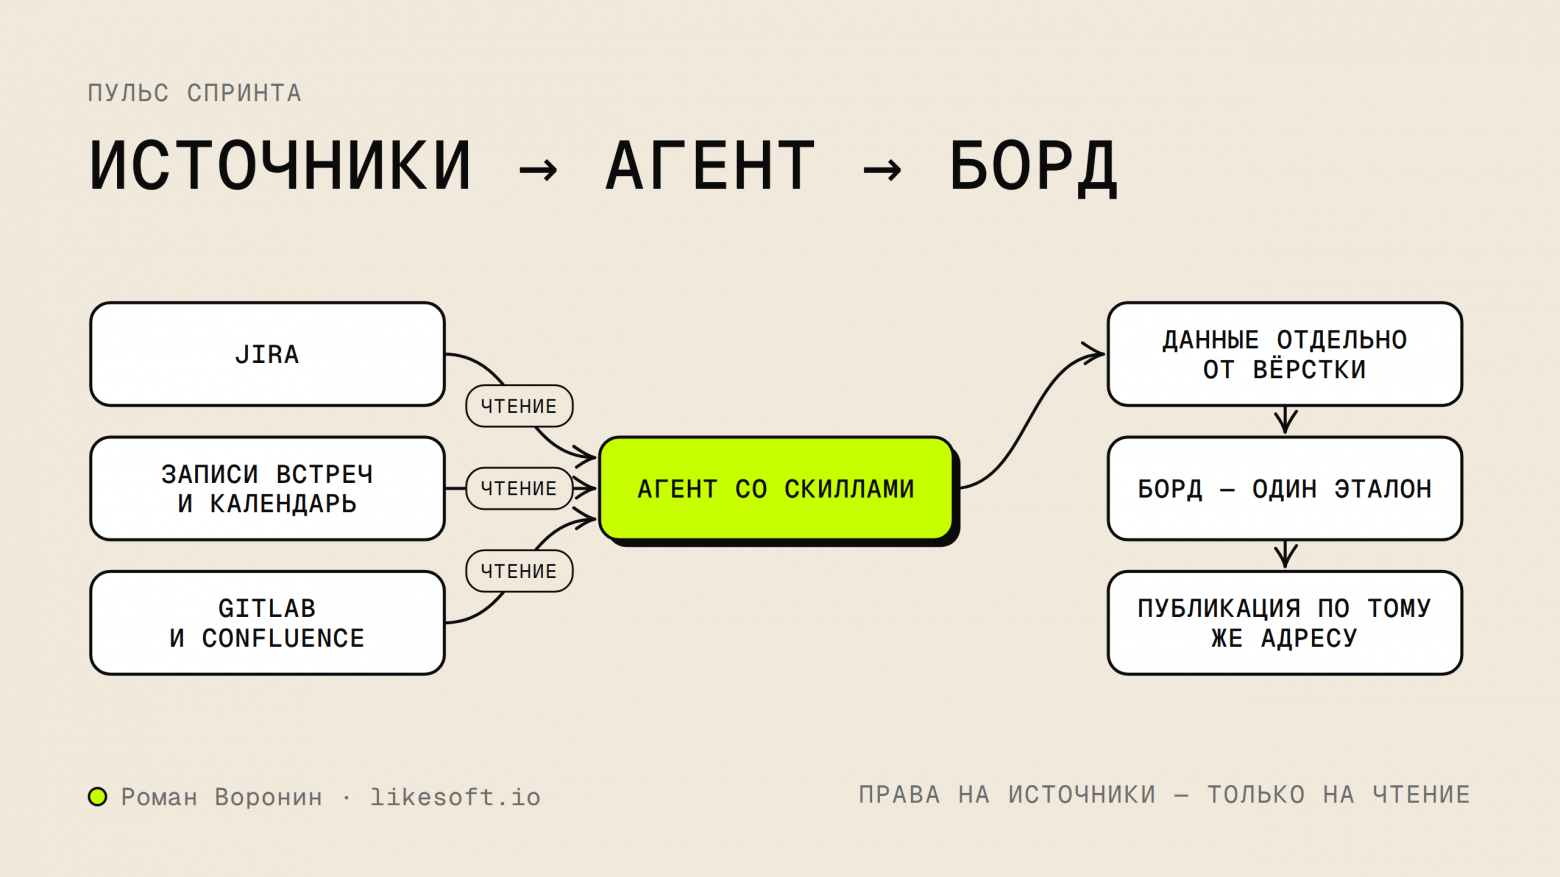
Агент читает Jira, записи встреч, календарь, GitLab и Confluence. Права везде только на чтение. Борд сам отчитывается, что агент ничего не записал. Для меня это обязательное условие: агент, который может поменять статус задачи или закрыть MR, на борд не нужен.
Один эталон, данные отдельно
Борд — это один эталонный HTML-файл. Данные лежат в нём отдельным JSON-блоком. Каждый спринт агент меняет только данные и публикует борд по тому же адресу. Вёрстку он не трогает.
Это решение выросло из ошибок, о которых ниже. Пока вёрстка и цифры живут в одном месте, агент может «поправить» число прямо в тексте страницы, и оно разойдётся с остальными.
Скиллы вместо аналитика
Скилл — это инструкция и скрипты для агента: откуда брать данные, как считать каждую метрику, какой шаблон заполнять и что проверить перед публикацией. Всё, что раньше держал в голове аналитик, записано один раз.
Для новой команды я задаю её периметр, проверяю первый прогон, и борд готов. Отсюда и час.
Квартальный разбор и прогноз бэклога устроены так же. Их пересчитывают скрипты по выгрузке Jira, а не человек в таблице.
Что видно на борде
Я собирал борд под вопросы, которые сам задаю на ревью спринта. Большей части этих метрик в типичном BI нет.
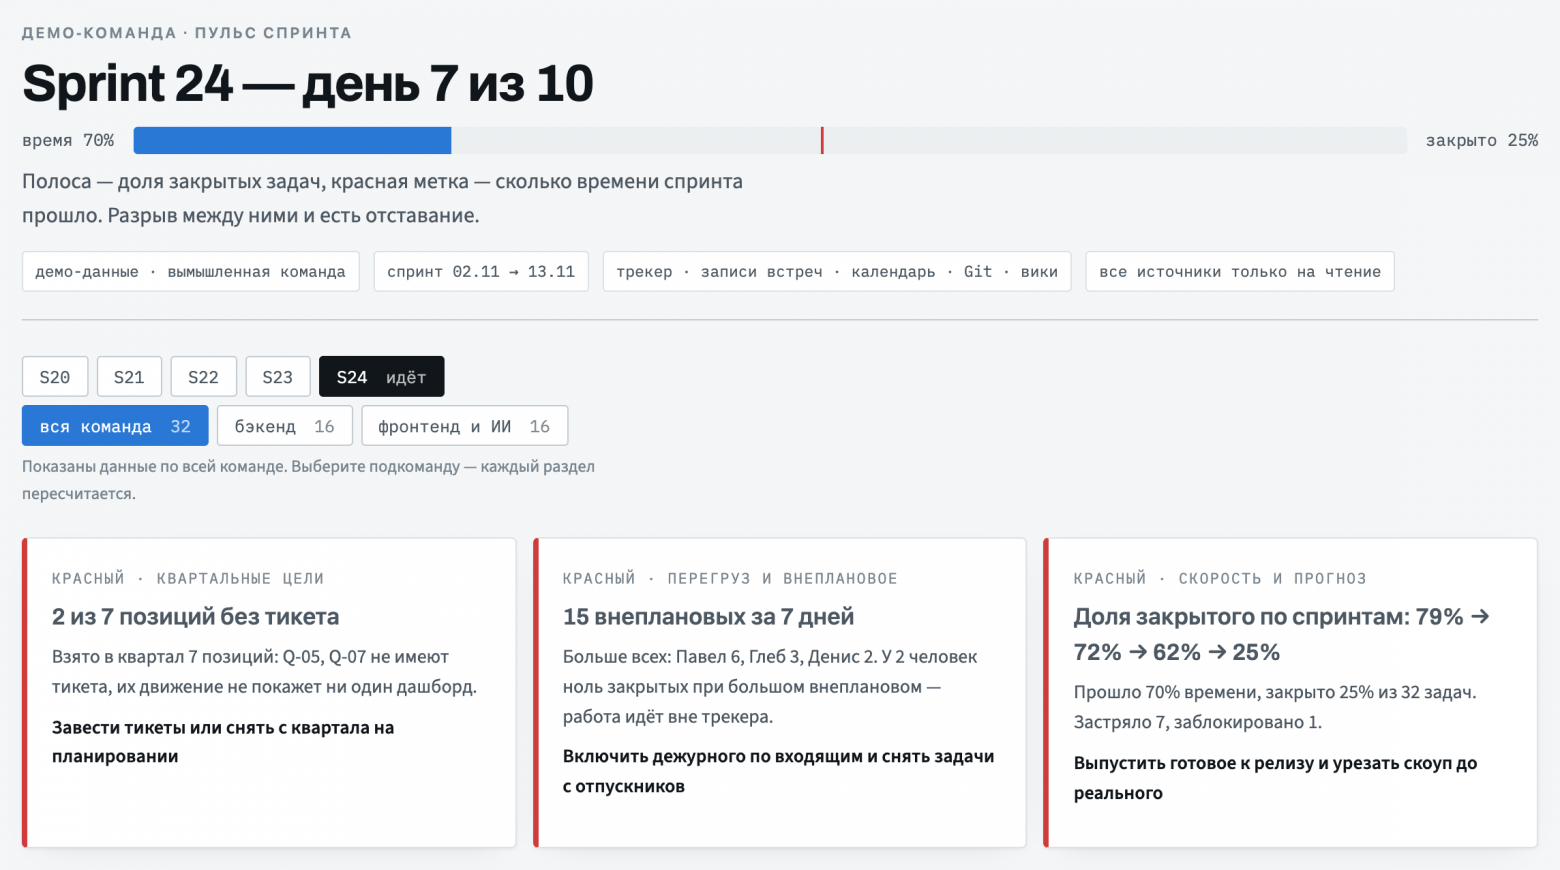
Шапка борда: сколько закрыто против прошедшего времени спринта и светофор.
Это мой эталонный борд на демо-данных: команда, задачи и цифры вымышлены, вёрстка и метрики те же, что в рабочем.
Сколько закрыто против того, сколько прошло времени спринта. Самый ранний сигнал: если половина спринта позади, а закрыта малая доля, это видно задолго до демо.
Тренд за последние спринты. Один плохой спринт ничего не значит, серия — значит.
Throughput и WIP на человека. Сколько задач команда реально доводит до конца и сколько держит в работе одновременно.
Глубина переноса. Сколько спринтов подряд задача переезжает из спринта в спринт.
Закрытие «штампом». Доля задач, закрытых в последний день спринта. Если её много, задачи закрывают ради отчёта, и burnup врёт.
Burnup, вехи и риски. Обычная картина спринта, только собранная автоматически.
Внеплановые задачи. Агент собирает их из записей встреч: о срочном договорились на созвоне, мимо планирования.
Застрявшие задачи. Те, что давно не двигаются по статусам.
Открытые MR без ревьюера. Код написан, но его никто не смотрит.
Расхождения документов с трекером. В Confluence написано одно, в Jira другое.
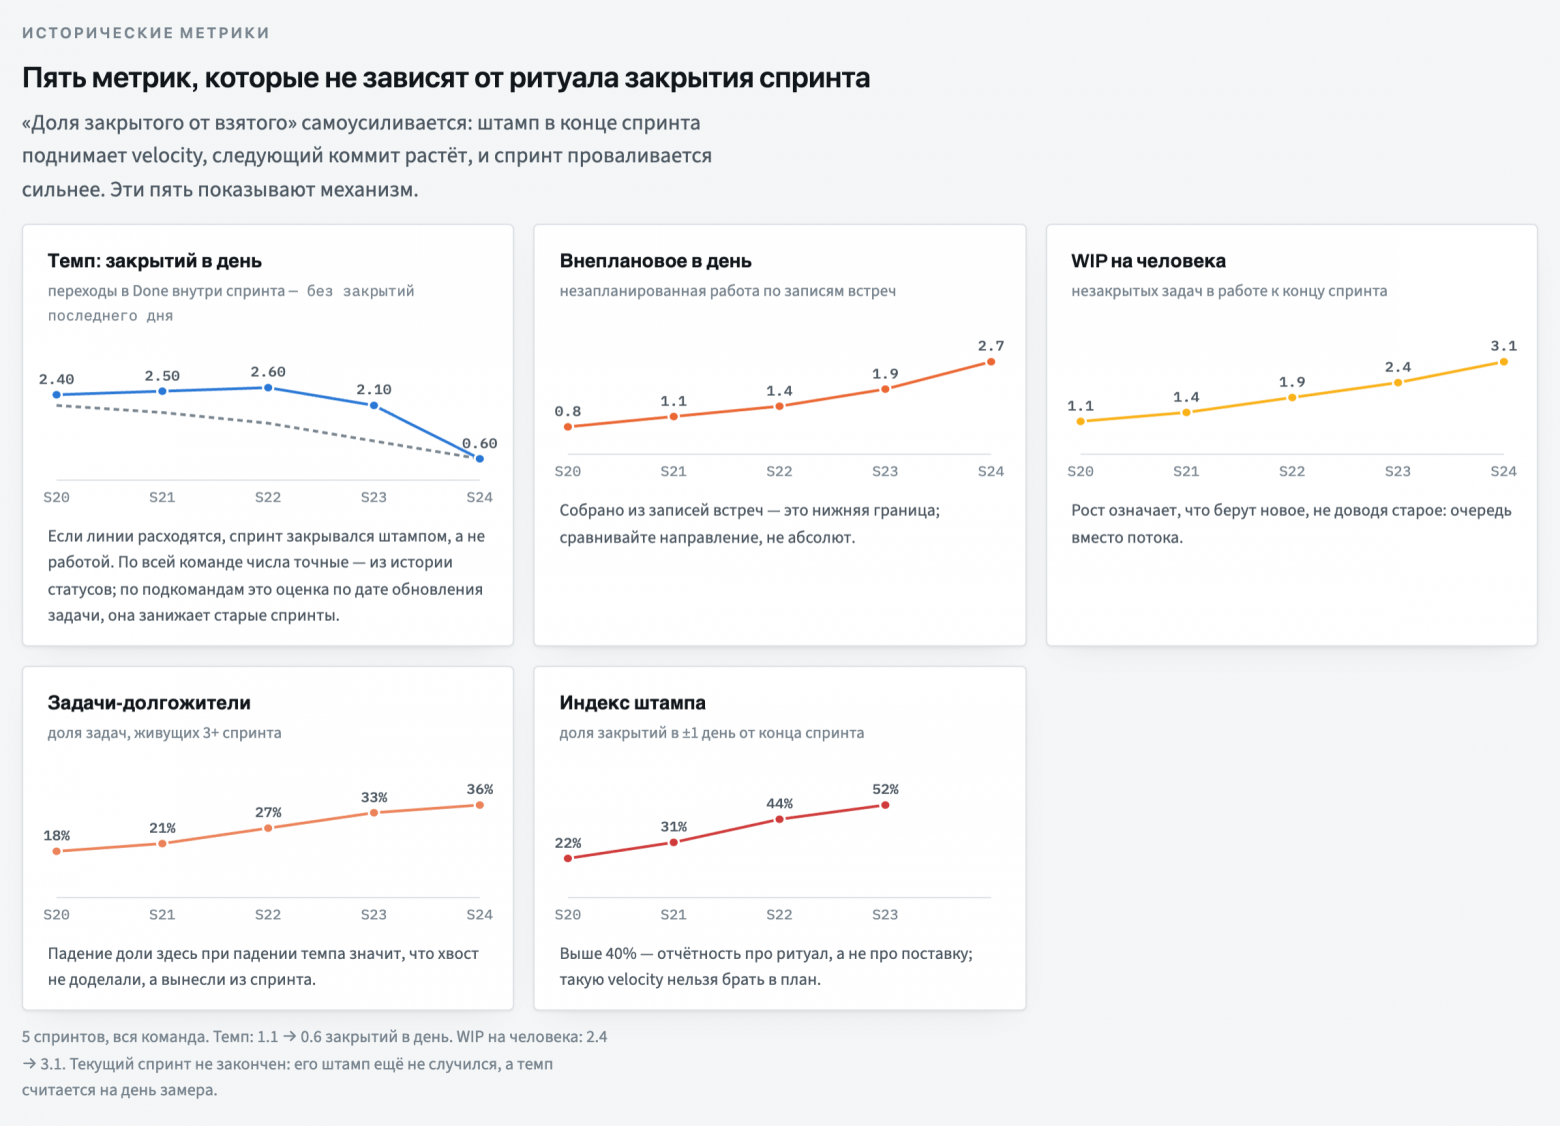
Метрики по спринтам: темп, внеплановое в день, WIP на человека, долгожители, индекс штампа.
Внеплановые задачи и расхождения с документами BI не покажет в принципе: для них нужны записи встреч и тексты документов, а не только таблица задач.
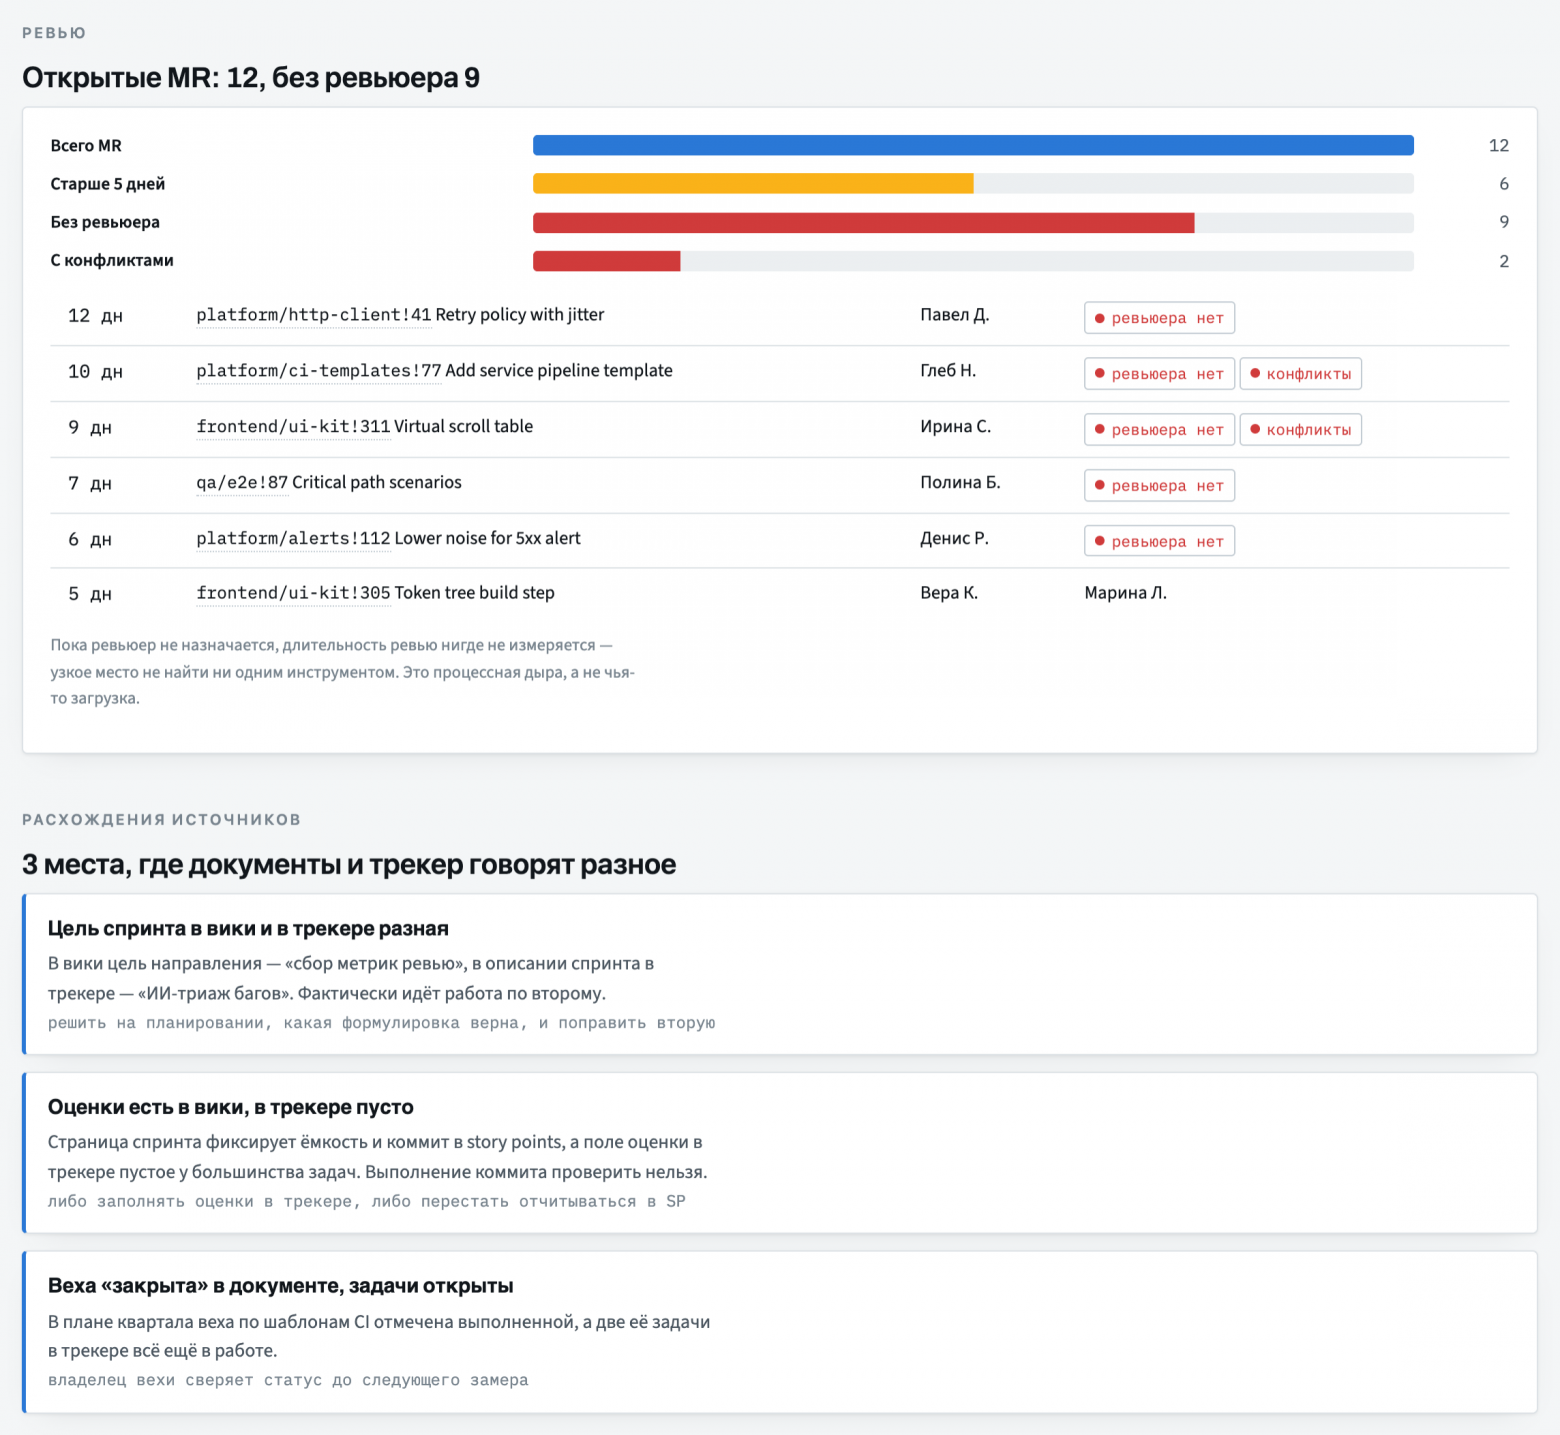
Открытые MR без ревьюера и места, где вики и трекер расходятся.
Где агент ошибается
Ошибается, и регулярно. Два примера из моих бордов.
Открытые MR без ревьюера в двух срезах оказались посчитаны по-разному. Каждый срез по отдельности выглядел нормально. Расхождение было видно, только когда я положил их рядом.
Второй случай мельче, но показательный: день спринта в шапке борда разошёлся с днём спринта в данных. Если читатель заметит такую мелочь, он перестанет верить и остальным цифрам.
Отсюда два правила.
Данные отдельно от вёрстки. Любое число на борде берётся из JSON-блока. Если число написано в HTML руками, это ошибка, даже если сейчас оно совпадает.
Сверка срезов. Если одна и та же метрика считается в двух местах, перед публикацией их сравнивают. Расходятся — борд не публикуется, пока не найдена причина.
Агент не устаёт, но и не сомневается в своих цифрах. Сомневаться приходится мне, и правила выше — способ делать это дёшево.
Если хотите повторить
Начните с прав только на чтение. Пусть агент физически не может ничего поменять в трекере и репозиториях.
Сделайте один эталонный борд руками и вычитайте его. Дальше агент заполняет только данные.
Сверяйте число задач в выгрузке с числом в самой Jira. Постраничная выгрузка теряет строки молча.
Запишите периметр команды явно: какие проекты и доски входят. Ошибка периметра на графике не видна.
Добавьте в борд то, чего нет в трекере: записи встреч и документы. Самое интересное обычно там.
Борд команды перестал быть проектом. Теперь его можно завести на каждую команду и обновлять каждый спринт без отдельного человека. Время, которое уходило на сборку, уходит на разговор о том, что с этими цифрами делать.
Какие метрики спринта вы смотрите сами и каких не хватает в вашем BI? Интересно сравнить.