Наша задача — по истории зарегистрированных преступлений предсказать, в каких частях города на следующий день произойдёт больше событий. Город разбиваем на районы или гексы — ячейки географической сетки H3, преимущественно шестиугольные, — а время на дни. Для каждой территории модель получает прошлые наблюдения и выдаёт прогнозный балл. Затем по этим баллам выбираем территории при заданном пространственном бюджете — доле площади или числа ячеек и проверяем, какая доля событий следующего дня в них попала. Отдельно оцениваем точность прогнозируемого количества: хорошо ранжировать территории и точно предсказывать числа — разные задачи.
Концептуальная иллюстрация городского графа, созданная с помощью ImageGen. Геометрия и связи условные.
Начать можно без нейросети. Для каждой территории заведём счётчик: каждый день немного уменьшаем накопленное значение и прибавляем число событий за прошедший день. Это экспоненциальное сглаживание EWM-30. События вчерашнего дня влияют сильнее давних, а через 30 дней их вес уменьшается вдвое. Старые наблюдения не отбрасываются резко: число 30 означает период полураспада, а не длину окна.
Такой бейзлайн сочетает устойчивую карту горячих точек с реакцией на недавнюю активность. Ему не нужны граф, сведения об объектах городской среды (POI, points of interest: магазинах, школах, остановках) или обучение весов. Поэтому содержательный вопрос для более сложной модели — какую дополнительную информацию она извлекает сверх этой взвешенной истории? Помогает ли порядок дней, история разных категорий, обмен с соседями или информация о городской среде и поездках?
Мы проверяли эти гипотезы на Лиме и Чикаго: от GRU — рекуррентной сети, последовательно обновляющей память по дням, — и TCN, сети со свёртками вдоль временной оси, до графовых моделей, обменивающихся информацией между территориями. Результаты зависели от постановки: выигрыш при выборе районов не обязательно сохранялся на гексах, а улучшение категориального прогноза не всегда улучшало общий. Ниже разберём не только итоговые метрики, но и контрольные сравнения, позволяющие понять источник прибавки.
Это обзор проведённых экспериментов, включая отрицательные результаты и ошибки реализации. Сначала разделим задачи и правила оценки, затем пройдём по архитектурным гипотезам: что добавляли к истории, с чем сравнивали и какой вывод действительно поддерживают данные.
1. Три постановки вместо одной таблицы победителей
Во всех треках прогноз относится к зарегистрированным событиям следующего дня, но обучающие задачи и пространственные единицы различаются.
Чтобы оценить прогноз, каждый день выбираем территории с наибольшими прогнозными баллами, ориентируясь на заданный бюджет — например, 5% площади города. Затем считаем, какая доля фактически зарегистрированных событий попала в этот выбор. Это hit rate, или доля захваченных событий.
PAI (Prediction Accuracy Index) показывает, насколько события сконцентрированы в выбранной территории по сравнению со средним по всей оцениваемой области:
PAI = доля событий в выбранной территории / доля выбранной территории
Например, если в выбранных 5% площади оказалось 20% событий, то PAI = 0,20 / 0,05 = 4. Концентрация событий там в четыре раза выше средней. PAI = 1 означает захват, пропорциональный площади; больше единицы — повышенную концентрацию. Это не процент правильных прогнозов и не вероятность преступления.
Обозначение PAI@5% указывает на целевой бюджет выбора. Чем выше показатель, тем больше событий удаётся захватить на единицу выбранной территории. При этом важны и сам захват, и фактическая площадь: высокий PAI не обязательно означает большее абсолютное число попаданий, если модели выбрали разные площади.
В протоколах прогноза количества MAE (mean absolute error) — средняя абсолютная ошибка числа событий на территорию и день. Например, для прогнозов 2 и 5 при фактических значениях 1 и 3 она равна (1 + 2) / 2 = 1,5. В бинарных задачах Лимы ошибки вероятностей имеют другой смысл и не сравниваются с count-MAE Чикаго. Таким образом, модель может хорошо выбирать территории и плохо оценивать масштаб событий. Ниже это окажется одним из главных различий между результатами.
Протокол | Пространство и период | Обучающая цель | Основная оценка |
|---|---|---|---|
Лима | 2 120 ячеек H3 разрешения 8; 302 дня 2026 года | Метки 0/1 по пяти категориям и отдельный общий выход | Захват числа событий в верхних 5% ячеек |
Чикаго, районы | 77 статистических районов (community areas); 2023/2024/2025 | Число событий, иногда с категориальными выходами | Выбор целых районов по бюджету площади |
Чикаго, H3 | 2 848 ячеек H3 разрешения 9; те же годы | Число событий в гексе либо по категориям | Территориальный PAI и MAE на фиксированной сетке |
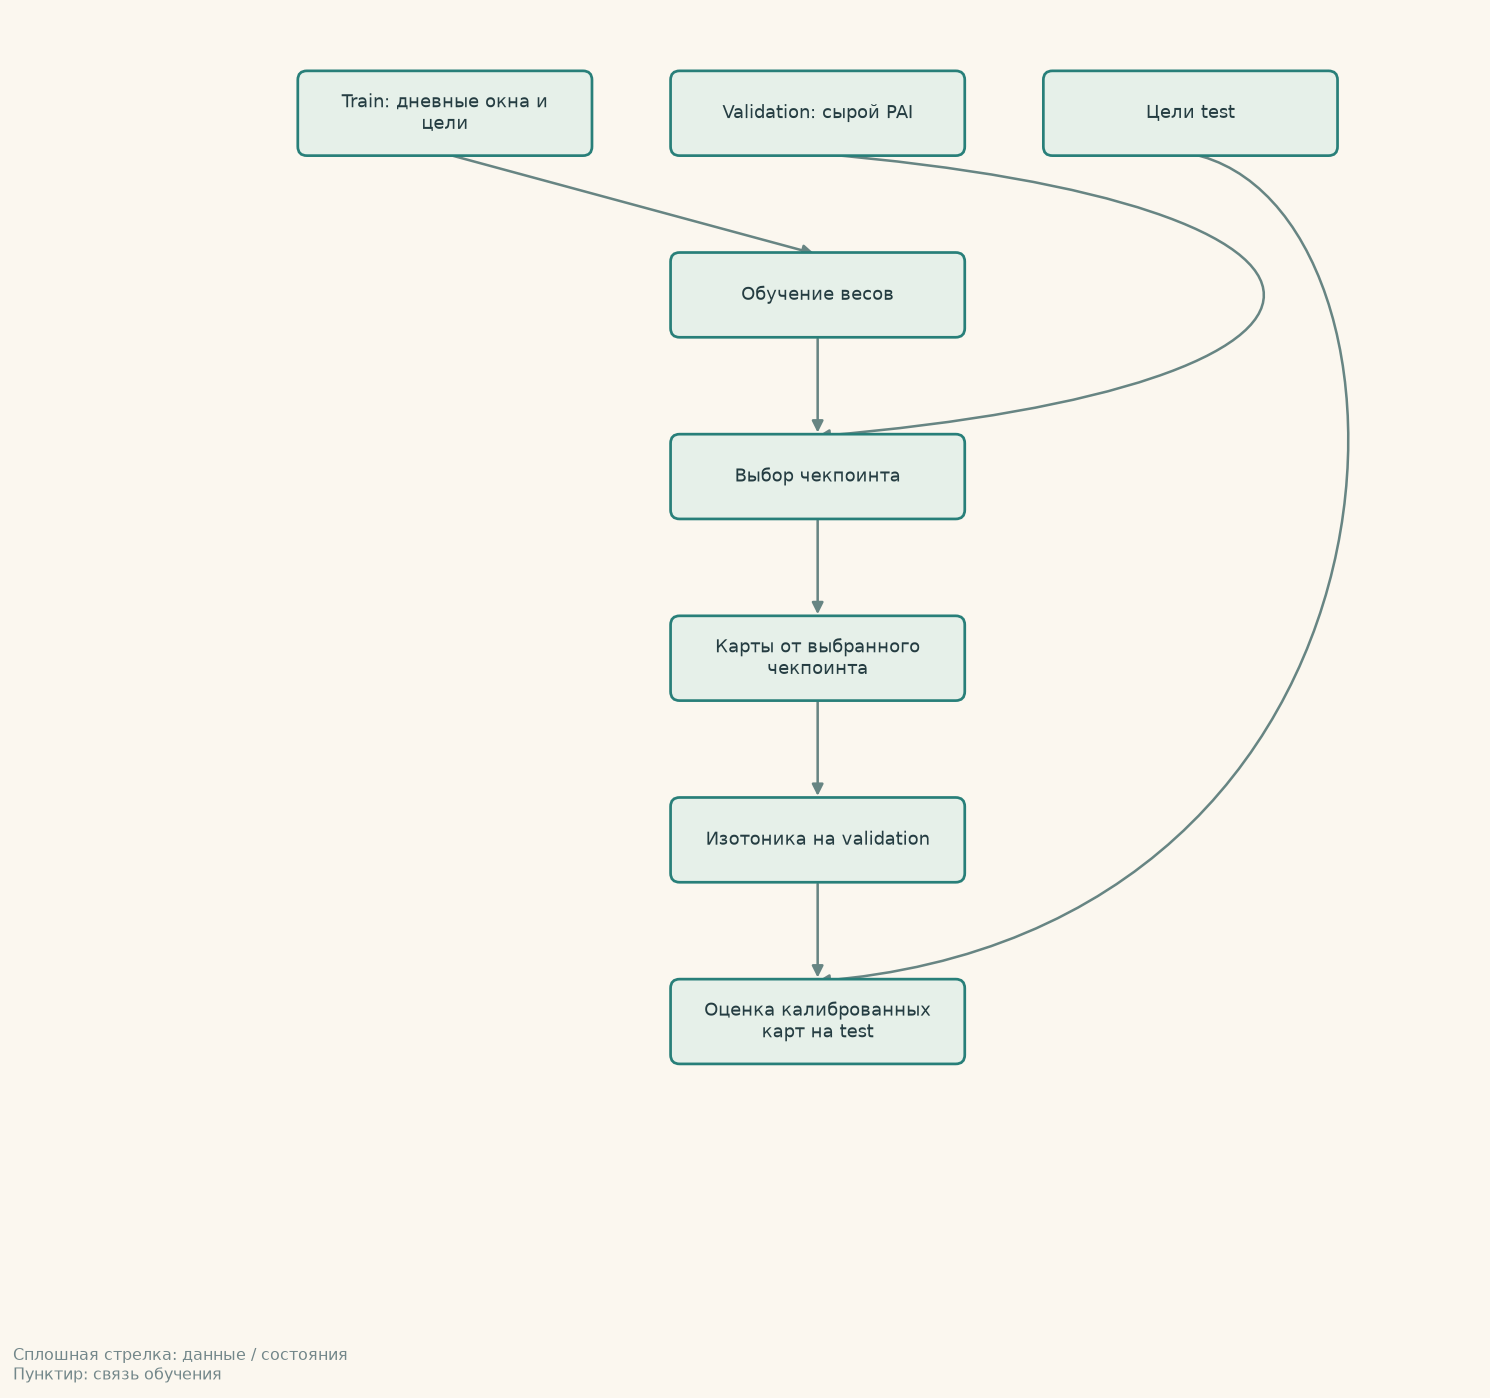
Train — обучающая часть, на которой подбираются веса модели; validation (Val в таблицах) — отдельный период для выбора настроек и лучшего сохранённого состояния; test — последующий период итоговой оценки. В Чикаго это соответственно 2023, 2024 и 2025 годы. Чикагский тестовый период уже просматривался в предыдущих сериях, поэтому остаётся разведочным: результат на нём не заменяет проверку на новом, ещё не использованном периоде. Лимский основной тест — 37 дней, с 23 сентября по 29 октября; часть исторических серий дополнена отдельными временными и географическими проверками.
Каждый прогноз строится из прошлой истории: L28 означает последние 28 дней, [t−28,t) — от дня t−28 включительно до дня t, не включая сам прогнозируемый день. Из прошлого берутся и динамические рёбра мобильности. Однако дата события не равна дате публикации записи. Без отдельного аудита задержек эти эксперименты оценивают ретроспективный прогноз, не готовый онлайн-сервис.
В таблицах ниже hit@5% обозначает долю событий, захваченных при целевом бюджете 5%. Реализация самого бюджета различается между протоколами. В Лиме выбираются 106 из 2 120 ячеек, с номинальным знаменателем 0,05. В районном Чикаго используются неодинаковые полигоны: стандартный алгоритм может превысить 5% площади при добавлении последнего целого района. В чикагском H3-протоколе площадь также входит в процедуру расчёта метрики (evaluator). Поэтому PAI Лимы, районов и гексов Чикаго напрямую не сравниваем.
Как читать сравнения. Seed (сид) — число, задающее начальное состояние генератора случайных чисел; им обозначают соответствующий запуск. Разные сиды меняют инициализацию и другие случайные операции. Ансамбль усредняет прогнозные баллы нескольких запусков до выбора территорий. Среднее готовых метрик по сидам — другая операция; в таблицах отмечено, какая используется.
Запись Δ = +0,10 [−0,02; +0,22] означает разность метрик «модель минус контроль» и её 95%-й доверительный интервал. Здесь интервалы получают парным bootstrap: многократно выбирают с возвращением одни и те же дни или блоки дней для обеих моделей и пересчитывают разность. Если интервал включает ноль, преимущество не установлено этим сравнением; это не доказательство равенства. Такой интервал относится к данным и выбранным прогнозам, а не ко всем будущим периодам или случайным инициализациям.
Разрешение H3 задаёт размер ячеек: у уровня 9 ячейки мельче, чем у уровня 8. Номер уровня не является количеством районов. В Лиме и Чикаго также различаются правила отбора ячеек, поэтому даже одинаковая форма сетки не делает выборки сопоставимыми.
2. Что именно мы добавляли к истории
В графе узел соответствует территории, а ребро задаёт, откуда модель может получить информацию. Физическое ребро соединяет соседей; обучаемое определяется параметрами сети. Гиперребро объединяет сразу группу узлов и позволяет обмениваться общим представлением. Ни один из этих типов связей сам по себе не означает причинного влияния.
Представление, или embedding, — числовой вектор, которым сеть описывает территорию или категорию. Encoder (энкодер) превращает входы в такие векторы, backbone — основная обрабатывающая часть модели, head (голова) — выходной блок, выдающий прогноз. MLP — многослойная полносвязная сеть. Attention — обучаемое взвешивание входных представлений; оно не служит готовым объяснением причин результата.
Дополнительный контекст включает OpenStreetMap (OSM) и мобильность. OD, origin–destination, — число опубликованных поездок между районами старта и назначения. Rideshare здесь означает опубликованные агрегаты поездок сервисов заказа автомобилей, а не совместные поездки нескольких пассажиров.
Теперь сгруппируем модели по проверяемой гипотезе.
Группа | Реализованные варианты | Предполагаемый дополнительный сигнал |
|---|---|---|
Временные модели | GRU, TCN, MLP и обучаемые поправки к EWM | Порядок, недавние изменения и нелинейные сочетания истории |
Пространственно-временные графы | DCRNN, STGCN, Graph WaveNet, MTGNN, CrimeForecaster; пилот GraphSAGE | Физические соседи, диффузия или обучаемые связи между территориями |
Категории и гиперграфы | ST-SHN, HAGEN, ST-HSL, MiST, DeepCrime, multichannel GRU | История типов событий, смешивание каналов и дальние пространственные зависимости |
Региональные представления | HAFusion, AutoST, GraphST, CooKIE | Совместный контекст POI и мобильности, предобучение и объединение источников |
Иерархический контекст | Гексы ↔ районы, районные taxi/rideshare, OD-варианты | Дополнительная информация более крупного пространственного уровня |
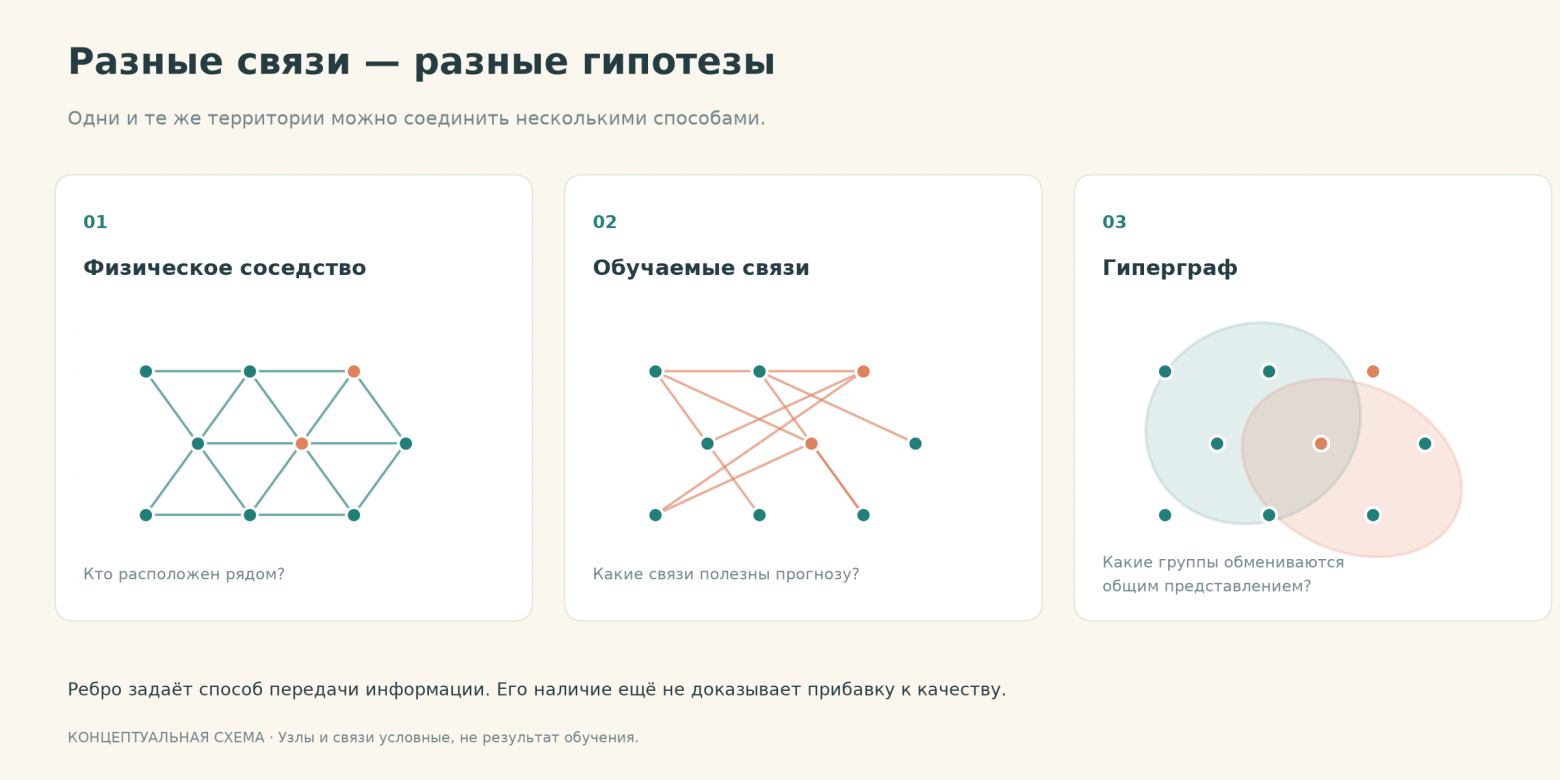
Одинаковые условные узлы, разные способы обмена информацией. Цвета и связи не показывают результаты обучения.
Это наши адаптации, а не воспроизведение всех опубликованных экспериментов. Районные модели переведены на общий next-day count-контракт, некоторые авторские декодеры и источники данных отсутствуют. У AutoST/GraphST используются дневные адаптации представлений с общим downstream GRU. Лимский a0_paper — sketch ST-SHN, несмотря на имя. Совпадение размеров массивов не устанавливает соответствие авторской реализации; важны нормировка, остаточные (residual) пути, передающие исходное представление в обход блока, функция ошибки обучения (loss) и область оценки.
Схемы по исходным статьям: DCRNN · STGCN · Graph WaveNet · MTGNN · CrimeForecaster · HAGEN · ST-SHN · ST-HSL · MiST · DeepCrime · HAFusion · AutoST · GraphST · CooKIE
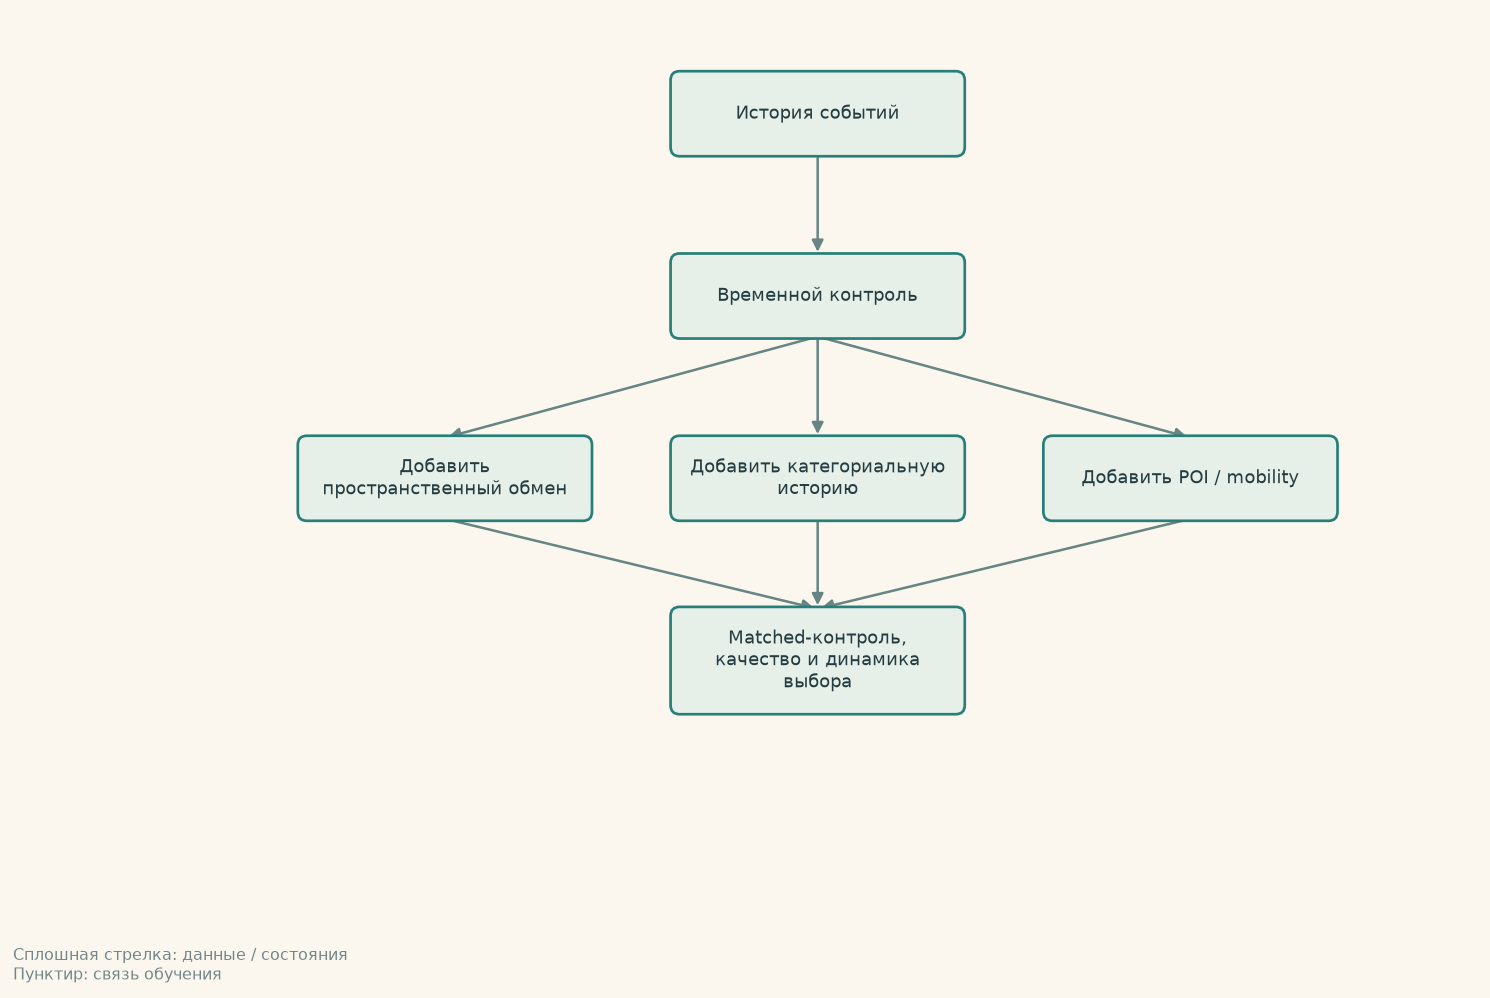
Абляция — контролируемое отключение или изменение компонента. При переобучении модель заново учится с изменённой структурой; при вмешательстве на инференсе, то есть во время расчёта прогноза, меняют уже готовое решение без обновления весов. Matched-контроль сохраняет сопоставимые данные, backbone, бюджет и условия обучения, меняя проверяемую часть. Эти два вида экспериментов отвечают на разные вопросы и не заменяют друг друга.
3. Лима: одной сложной сети было недостаточно
Лимский тензор содержит 71 715 событий после исключения violencia_familiar и записей вне итоговой сетки. Окно — 28 дней; пять каналов соответствуют группам hurto (кражи), robo (грабежи/разбой), vehiculo (преступления, связанные с транспортными средствами), estafa_extorsion (мошенничество/вымогательство), otros (остальные включённые категории). Отдельная голова any прогнозирует наличие хотя бы одного события из этих групп. Обучающая метка равна 0 или 1, но при оценке захвата каждое зарегистрированное событие считается отдельно.
Начали со ST-SHN: категориальных векторов, обмена по H3-графу, гиперграфа и временных обновлений. Подробности операций важны для воспроизведения и разобраны в приложении A. В основном сравнении наш sketch — упрощённый вариант авторской конструкции — не установил преимущество над EWM-30. В вариантах с offset дополнительно вводится prior: сглаженная историческая частота положительных дней ячейки до начала входного окна, добавленная к сетевому прогнозу в шкале логарифма шансов (log-odds). Подробная формула приведена в приложении A.
Историческая оценка на полном тесте Лимы | PAI@5% |
|---|---|
EWM-30 | 8,248 |
ST-SHN sketch, | 8,170 |
Sketch с историческим prior, | 8,130 |
Offset и все OSM-ветки, | 8,080 |
Для сетей здесь среднее метрик трёх отдельно калиброванных сидов. Калибровка преобразует выходной балл в вероятность по validation-наблюдениям. Это не PAI ансамбля средних прогнозов. Источник: исторический отчёт.
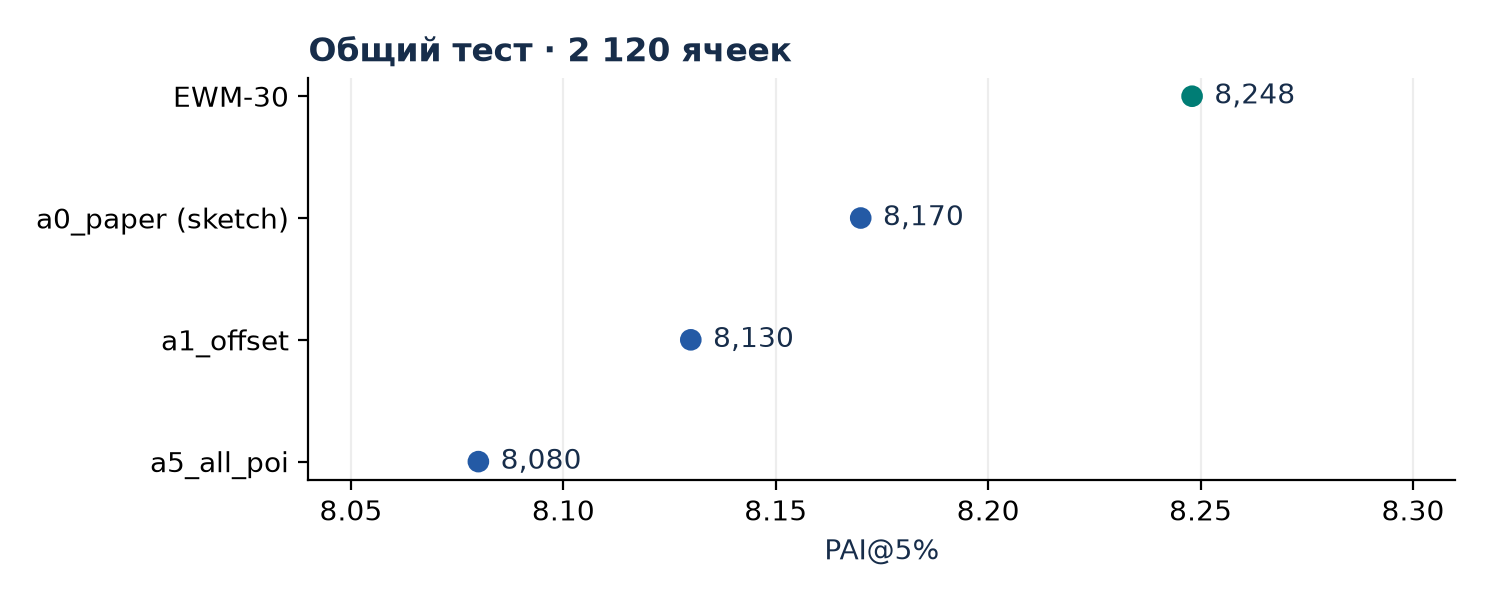
EWM-30 обновляет один счётчик на ячейку: s[t] = 2^(−1/30)·s[t−1] + count[t−1]. Число 30 — полураспад, не обрезка окна. Доступна вся предыстория внутри панели; у sketch явно подаются 28 дней. Это сильный практический контроль, но не уравнивание архитектур по длине входа.
Дальнейшая серия не ограничилась ST-SHN. В Lima v2 проверили MLP, residual TCN, STGCN, residual ST-SHN, дорожные и обучаемые графы, объединение графовых представлений, а также static/dual/gated-модели для скрытой истории. На полном тесте ни одна из этих архитектур не установила статистически значимое преимущество над EWM-30. Предобъявленный контраст residual TCN против EWM дал −0,052 [−0,142; +0,038].
В Phase 2 добавились near-repeat модели: они проверяют, помогает ли близость к недавним событиям по времени и расстоянию. Расстояние измерялось напрямую или по сети дорог; также проверили нейросетевой вариант, перенос в скрытые ячейки и дополнительные графовые модели. Для исходного протокола на полной оцениваемой сетке (full) интервалы near-repeat вариантов против EWM также включили ноль: −0,012 [−0,083; +0,055]. Фолд — отдельное разбиение данных для проверки устойчивости по времени или географии. Перечень таких проверок и ограничения доступны в отчёте; эту исходную оценку нельзя представлять итогом по всем фолдам сразу.
В режиме masked-history, то есть со скрытой собственной историей части ячеек, положение менялось. В первой серии при скрытой истории 511 ячеек прямые OSM-признаки подняли точечный PAI с 4,05 до 7,11, а все OSM-ветки вместе — до 7,26. В v2 вариант с обучаемым переключением между источниками по доступности истории (availability gate) получил положительный предобъявленный контраст против static GBM: +0,781 [+0,554; +0,999]. Это другая область оценки, не победа над EWM там, где доступна собственная история. Метрики и оценки ансамблей разных Lima-серий нужно читать с аудитом и согласованием baseline.
Скрытые ячейки исключаются из расчёта обучающей ошибки (train-loss), но остаются частью графа; их validation-метки участвуют в выборе и калибровке моделей. Поэтому корректнее говорить о прогнозе при скрытой локальной истории, а не о строгом переносе в совершенно неизвестную территорию. OSM при этом включает не только POI, но и дороги, здания и землепользование.
Историческая инференс-диагностика ST-SHN дала ещё один урок. Подмена собственного окна снижала PAI сильнее, чем перестановка дней; перестановка offset между ячейками вызывала большое падение. Но точные variant/seed/hash её checkpoint не подтверждены, а отключение гиперграфа и обычных рёбер проводилось без переобучения. Это свидетельство чувствительности отдельного решения, не установленный вклад каждого блока в качество обученной архитектуры. Подробности и ограничения — в приложении D.
4. Районы Чикаго: победа над EWM ещё не доказывает пользу графа
На районных данных получили другую картину. При L28 ансамбль GRU набрал 2,447 PAI, TCN — 2,416, EWM-30 — 2,076. Парный прирост GRU относительно EWM — +0,371 [+0,345; +0,397].
Но MAE у GRU была 7,30 против 2,43 у EWM; у TCN — 88,61. Улучшилось территориальное ранжирование, а не точность числа событий. К тому же GRU выбирала один и тот же набор районов все 365 тестовых дней. Поэтому сама архитектура с временным энкодером и положительный PAI-контраст ещё не доказывают пользу ежедневной динамики.
Физические и обучаемые связи
Районная модель | Test PAI@5% | Что показал контроль |
|---|---|---|
GRU | 2,447 | Общая базовая линия |
DCRNN, финал | 2,447 | Выбор территорий совпал с GRU каждый день |
STGCN, финал | 2,447 | То же |
MTGNN, выбранный финал | 2,447 | Выбран вариант без mix-hop — смешивания информации от узлов на разных расстояниях по графу: это не доказательство пользы графового блока |
CrimeForecaster, финал | 2,447 | Выбор территорий совпал с GRU |
Финалы — средние сырые прогнозы трёх сидов, один районный протокол. Источник: Stage B.
Здесь равенство сильнее совпадения округлённых метрик: одинаковы дневные наборы выбранных районов. Однако полный порядок всех районов и ошибки количества могли различаться. Отсутствие эффекта на этом top-бюджете нельзя превращать в утверждение о бесполезности пространственных зависимостей вообще.
Graph WaveNet потребовала отдельного расследования. В первом операторе свёртки независимое суммирование признаков и весов подменяло передачу сообщений общей городской суммой. Старые прогоны исключили из архитектурных выводов. После исправления лучший по validation среди пяти проверенных конфигураций вариант только с обучаемыми связями (adaptive-only) дал 2,435 на test против GRU 2,447; интервал разности включил ноль. Другая конфигурация дала 2,530, но выбирать её по уже просмотренному test нельзя. Исправленный скрининг.
Категории: выше метрика, сложнее объяснение
SSL (self-supervised learning) — обучение по вспомогательной задаче, сформированной из самих данных, а не только по меткам будущих событий. Interaction head — выходная голова, совместно использующая представление территории и категории. Crime-only означает, что используются только входы, связанные с преступлениями.
Адаптация: прогноз числа событий по районам | Val PAI@5% | Test PAI@5% | Статус |
|---|---|---|---|
HAGEN, fixed backbone + interaction head | 2,577 | 2,652 | Ансамбль трёх сидов |
ST-HSL, только локальный encoder | 2,572 | 2,588 | Seed 0 |
ST-HSL, hypergraph + SSL | 2,006 | 2,056 | Seed 0 |
ST-SHN, paper-config адаптация | 1,972 | 2,057 | Seed 0 |
ST-SHN без межкатегориального attention | 2,178 | 2,268 | Seed 0 |
MiST с attention | 1,448 | 1,421 | Seed 0 |
DeepCrime crime-only, полная конфигурация | 2,113 | 2,293 | Seed 0; validation выбрала вариант без attention |
Источники: Stage C, DeepCrime. Строки seed 0 не являются трёхсидовыми финалами; DeepCrime не получает отсутствующие авторские 311-источники.
HAGEN подняла PAI на +0,205 [+0,176; +0,234] относительно GRU. Но похожий результат давала и прежняя аддитивная голова без полноценного взаимодействия контекста и категории. После исправления головы выигрыш сохранился. При этом внутри каждой модели её выбранный набор районов не менялся по дням; наборы разных моделей не следует считать одинаковыми. Сам рост метрики воспроизведён; механизм не установлен.
У ST-HSL лучшей оказалась локальная конфигурация без гиперграфа и SSL. Это аргумент проверять усложнения по отдельности, а не приписывать качество всей опубликованной конструкции. У ST-SHN категориальная macro-MAE — невзвешенное среднее MAE отдельных категорий — около 0,282 была близка к EWM 0,284, несмотря на более слабое ранжирование по общему числу событий (total). Опять расходятся задачи калибровки и выбора территорий.
У DeepCrime полная конфигурация выиграла у своего no-attention варианта на test, но проиграла ему на validation. Без устойчивого отбора и повторов это не подтверждение пользы attention. Название блока не заменяет предобъявленное сравнение.
5. Представления районов: улучшение карты не равно улучшению динамики
Следующий вопрос — помогут ли представления городской среды, построенные по POI и мобильности. В дневных адаптациях AutoST, GraphST и CooKIE замороженный контекст подавался в общую GRU для конечного прогноза (downstream predictor). Прямой matched-контроль получал нули вместо контекстных признаков при той же размерности входа; прежняя full-input GRU была внешним ориентиром с другим составом входов.
Здесь fixed означает фиксированную, а learned — обучаемую структуру; cross-view — обмен между представлениями разных источников. Shared и unique обозначают общую и специфичную для источника информацию, concatenation — простое объединение векторов.
Представление районов | Val PAI@5% | Test PAI@5% | Контроль механизма |
|---|---|---|---|
AutoST, fixed | 2,753 | 2,848 | Выше learned-варианта |
AutoST, learned | 2,708 | 2,773 | Обучаемая структура не улучшила fixed |
GraphST, full | 2,753 | 2,847 | Удаление cross-view блока не изменило PAI |
CooKIE, shared + unique | 2,320 | 2,377 | Ниже простой конкатенации |
CooKIE, concatenation | 2,418 | 2,471 | Более простой способ объединения оказался сильнее |
Один seed, дневные адаптации, не полные воспроизведения авторских экспериментов. Источник: Stage D aggregate.
В сравнении с внешней GRU 2,447 прибавка AutoST fixed составила +0,401 [+0,382; +0,420]. Но у него самый часто повторяющийся набор районов выбирался 363 дня из 365, у GraphST full — все 365. Сеть стала лучше выбирать устойчивую пространственную карту. Доказательства более точной ежедневной динамики из этих чисел не следует.
В пилоте HAFusion attentive fusion не установила преимущество по PAI над конкатенацией. Таким образом, дополнительный контекст иногда давал выигрыш, но из этого не следовала польза именно обучаемых связей, cross-view обмена или сложного объединения представлений.
Отдельно проверили само правило выбора территорий. При переходе GRU от стандартного набора с превышением площади к решению задачи рюкзака (knapsack): выбору сочетания целых районов с наибольшим ожидаемым числом попаданий при жёстком пределе 5% PAI изменился с 2,447 до 2,638, без новой информации и обучения. Для HAGEN — с 2,652 до 2,687. Это изменение evaluator, не новая архитектура; такие числа нельзя смешивать со standard-результатами. При этом hit GRU снизился с 0,1555 до 0,1305: выросла концентрация попаданий на меньшей площади, а не их абсолютный захват.
6. Гексы Чикаго: где эффект удалось отделить лучше
Районная агрегация скрывает внутритерриториальные различия. Для H3 зафиксировали 2 848 гексов res9 с не менее чем 30 train-событиями за 2023 год. Нельзя менять состав этой сетки после просмотра следующих лет. В выбранную сетку за три года попало около 89,23% геопривязанных событий; результаты относятся к ней, не ко всему городу без исключений.
Физические соседи против локального прогноза
Здесь сравнивали отдельно обученные варианты одного семейства: реальные H3-рёбра, self-only (каждый узел обрабатывает только себя) и rewired (переставленные связи с сохранением степеней — числа соседей каждого узла).
H3-модель, seed 0 | Test PAI@5%: обмен между узлами | Test PAI@5%: self-only |
|---|---|---|
STGCN | 3,623 | 3,633 |
Graph WaveNet fixed | 3,642 | 3,668 |
CrimeForecaster | 3,659 | 3,706 |
Graph WaveNet adaptive: learned против self | 3,644 | 3,651 |
MTGNN: learned против self | 3,680 | 3,682 |
Источники: H1, H1b. Последние две строки используют обученную матрицу связей, а не физическое соседство H3. Все test-оценки разведочные.
Устойчивой прибавки от пространственного обмена не получили. Полный исторический EWM-30 на той же сетке давал 3,758, но имел больше истории, чем модели L28. Поэтому важны два сравнения: способность практического прогнозатора обойти сильный EWM и вклад графа относительно собственного self-only контроля. Одно не заменяет другое.
Категориальная история дала самостоятельный сигнал
Более убедительный положительный результат появился без графа. Сравнили две GRU с одинаковой категориальной головой: одна видит только total-историю, другая дополнительно получает историю типов. Основная метрика — macro PAI@5%: сначала для каждой из 15 именованных категорий отдельно выбирают территории и считают PAI, затем берут невзвешенное среднее этих 15 оценок. Объединённый other — канал остальных типов, не прошедших train-порог покрытия, — исключён. Редкая и частая категории имеют одинаковый вес; это не PAI единого общего прогноза.
Вход и модель | Val macro PAI@5% | Test macro PAI@5% |
|---|---|---|
Категориальный EWM-30 L28 | 3,365 | 3,465 |
Категориальная GRU, только total-история, seed 0 | 3,575 | 3,520 |
Та же GRU с историей категорий, seed 0 | 4,060 | 4,077 |
На test прирост категориальной истории против matched total-history GRU составил +0,557 [+0,521; +0,595]. Повторы с seed 1 и 2 дали соответственно +0,548 и +0,578, с положительными дневными интервалами. Это устойчивость к трём инициализациям, не доверительный интервал по распределению сидов. Скрининг, повторы.
Польза категориального входа не равна пользе межкатегориального графа. При последующем добавлении фиксированного H3-смешивания реальный граф превзошёл rewired, но не установил преимущество над self-only: validation-разность −0,016 [−0,046; +0,013]. Значит, случайный обмен мог мешать, а локальный прогноз оставался достаточным контролем. Графовая абляция.
Наконец, macro-выигрыш не переносится на total автоматически. В исходном скрининге сумма категориальных прогнозов дала total PAI 3,643, прямая total-GRU — 3,674. Для разных задач могут быть нужны разные головы и критерии отбора.
7. POI, районы и поездки: дополнительный вход ещё должен доказать пользу
Таблица Crimes задаёт прогнозируемую величину (target) и её историю. OSM описывает среду. Taxi/rideshare дают прошлые потоки и интенсивность поездок; это не метки преступлений внутри поездки. У каждого источника своё разрешение.
Для H3 локальные POI проверили при одном backbone и одинаковых статических слотах: изменение validation PAI +0,004 [−0,007; +0,016] не установило выигрыш. Замороженный районный HAFusion-контекст также не обошёл нулевой и переставленный контроли. POI, районный контекст.
Районные поездки подключили через явные связи гекс ↔ район, а OD сохранили между районными узлами. Это допустимая иерархия данных: районный поток не превращается в наблюдаемые поездки между конкретными гексами.
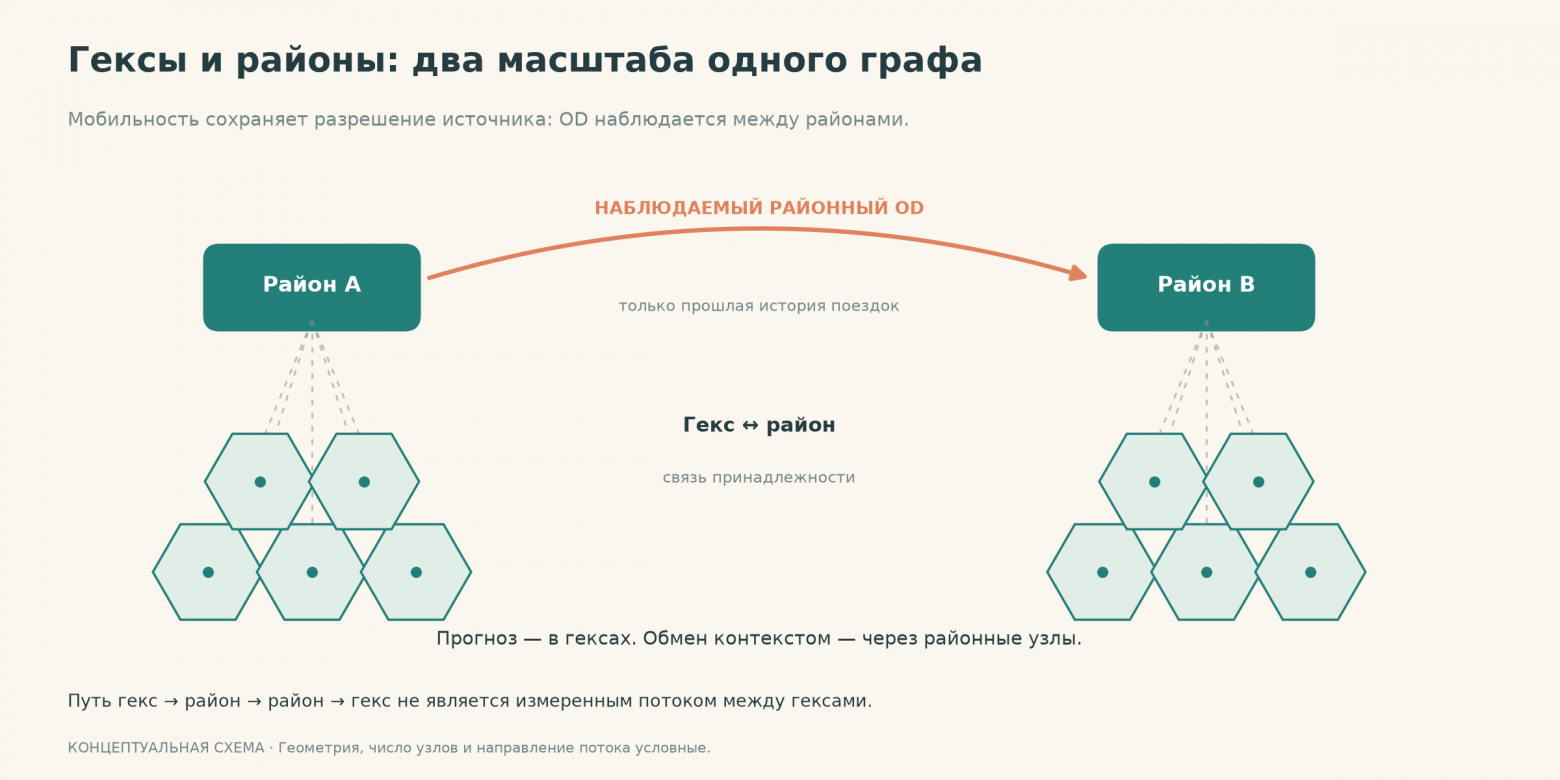
Районный поток передаёт контекст для прогноза в гексах. Он не задаёт наблюдаемые поездки между конкретными гексами; схема не использует реальные географические данные.
В taxi-серии сравнили локальный прогноз, районный обмен, признаки поездок и их сочетание. Эффект такси поверх районного обмена на первом сиде был положительным на validation, но знак не сохранился на обоих повторах. Последующие варианты направленного OD, отдельных каналов входящих и исходящих потоков (inbound/outbound), временных весов и attention не прошли validation-критерии продолжения. Положительные test-контрасты отдельных вариантов не основание отбирать их после просмотра теста. OD-направление, OD-attention.
Из этого не следует, что поездки не связаны с преступностью. Проверен более узкий вопрос: дают ли опубликованные районные агрегаты дополнительный прогнозный сигнал при доступной локальной истории, заданном агрегировании сообщений (pooling) и выбранных периодах. Неизвестная задержка публикации также ограничивает эксплуатационную интерпретацию.
8. Сеть как поправка к EWM
Ещё один путь — не требовать от GRU заново восстанавливать устойчивую карту частот, а дать ей сильный EWM-прогноз и учить небольшую поправку.
В H3-серии residual-модели приблизились к полному EWM значительно лучше прямых GRU. В эксперименте с event-history GRU-поправка L28 с обучаемыми весами позиций окна (lag-weighted) дала validation-прирост +0,019…+0,022 PAI по трём сидам, с положительной нижней границей дневного 95% интервала у каждого. На test её PAI был 3,767–3,773 против EWM 3,758; положительный интервал сохранился только у одного сида.
Attention поверх той же истории не установила преимущество над более простой lag-weighted поправкой. Вариант с вдвое уменьшенной attention-поправкой имел небольшие положительные test-интервалы во всех трёх сидах, но не доказал преимущество над исходной attention-моделью. Это осторожный кандидат для нового периода, а не подтверждение механизма attention.
Все эти поправки получали одинаковые районные taxi-признаки, но не OD-сообщения. Следовательно, их сравнение с EWM выделяет эффект всего дополнительного прогнозатора, не вклад такси. MAE на test часто оставалась немного хуже EWM.
Увеличение истории поправки до 56/112 дней или добавление старых недельных агрегатов также не прошло validation-критерий улучшения относительно L28. В этой серии расширение окна не подтвердило преимущество над поправкой L28; это не общий вывод о бесполезности длинной истории. History capacity, residual history.
9. Инфраструктура и вычислительный бюджет
Тяжёлые серии запускали на прерываемой виртуальной машине (preemptible VM) Nebius с одной NVIDIA H100 80 GB HBM3. В конфигурации проекта — 16 vCPU и 200 GB RAM. Локальная машина использовалась для подготовки кода, проверок и разбора результатов. Код и зафиксированные неизменяемые версии данных (pinned snapshots) переносились на VM, а завершённые результаты скачивались в отдельные неизменяемые каталоги запусков. Конфигурация и жизненный цикл экземпляров зафиксированы в cloud_setup.log; модель GPU также записана в логе H100-очереди.
По одному сохранённому логу вычислений на GPU через CUDA ST-SHN набирается около 9,4 часа только записанных эпох. Полный расход H100-часов по всем экспериментам из доступного архива не восстановлен.
Что удалось измерить | Значение | Что означает |
|---|---|---|
Эпохи ST-SHN с подтверждённым | 446 | Частичный архив лимской серии |
Сумма таймеров этих эпох | 33 954 секунды, или 9,43 часа | Реальное прошедшее время эпох, включая предусмотренные таймером стадии; округлено до секунд |
Общее время занятости H100 и оплаченная аренда | Не установлено | Нужны usage/billing и история состояний VM |
Для остальных архитектур есть отдельные сохранённые таймеры:
Серия | Суммарный записанный wall time | Что учтено |
|---|---|---|
Lima v2 | 1,541 часа | MLP, TCN, STGCN, residual ST-SHN, static/dual/gated и другие варианты; alias/reuse исключены |
Lima Phase 2 | 0,301 часа | Сохранённые kernel/neural-прогоны, фолды и абляции с |
Чикаго, районные модели | 0,566 часа | 114 уникальных завершённых удалённых run с таймером в логах |
Чикаго, H3 | 1,802 часа | Сохранённые |
Это суммы длительностей запусков, а не дополнительная оценка оплаченной аренды H100. Wall time — реальное прошедшее время процесса; оно включает ожидание и работу других устройств в пределах таймера. Для части файлов устройство не записано; таймер обучения не всегда включает inference, а параллельные процессы могут пересекаться. Поэтому эти строки не складываются с 9,43 часа в якобы точный общий бюджет GPU. Подробная разбивка по семействам и исходным файлам — таймеры остальных архитектур.
Все приведённые строки имеют неполное покрытие. В частности, они не дают полного учёта отдельных стадий оценки, развёртывания среды, передачи данных, простоя, незавершённых и потерянных при вытеснении запусков. Дополнительная таблица расширяет учёт за пределы исходного ST-SHN-лога, но не восстанавливает весь срок аренды. Сумма таймеров не измеряет время при 100% GPU utilization. Удалённые логи могут быть копиями или продолжениями одних запусков; алиасы моделей тоже нельзя считать отдельной затратой. Поэтому складывать все встреченные длительности или считать время от первого появления VM до последнего сообщения было бы неверно. Методика, разбивка по вариантам и hash исходного лога — в аудите вычислительного времени.
Инфраструктура влияла и на достоверность эксперимента. В одной из чикагских ST-SHN-серий процесс оставался живым, но расчёт упирался в CPU: графовые тензоры, а затем входы predict не переносились на устройство модели. После исправления проверяли фактическую загрузку GPU; сам факт наличия H100 не доказывал, что обучение её использует. Для attention-моделей оценку разбивали на небольшие батчи дней, чтобы не держать весь validation/test проход в памяти одновременно.
Preemptible VM могла потерять процесс и диск, поэтому checkpoints и завершённые варианты регулярно скачивались локально. Время подготовки, отладки и повторов — реальная часть стоимости исследования. Но для сравнения вычислительной эффективности архитектур нужен отдельный бенчмарк на одной машине, с одинаковыми батчами и составом измеряемых стадий; частичный журнал расходов его не заменяет.
10. Что дали все эти архитектуры
Проверяемая идея | Что подтверждено в проведённом протоколе | Что не установлено |
|---|---|---|
Временной прогнозатор | Районные GRU/TCN улучшили PAI относительно EWM | Что выигрыш обусловлен ежедневной динамикой, а не постоянной картой |
Физические/обучаемые графы | Получены валидные matched-сравнения и исправлена ошибка GWNet | Устойчивая польза обмена сверх собственных локальных контролей |
Категориальная история | H3 macro-выигрыш повторился на трёх сидах | Автоматическое улучшение total и польза графа поверх категорий |
Городские представления | Дневные AutoST/GraphST-адаптации улучшили районный выбор | Что это преимущество конкретного механизма или ежедневной динамики |
OSM при скрытой истории | Статический контекст полезен в Lima masked-history | Универсальный перенос на невидимую территорию |
Районные поездки и OD | Проверены явная иерархия и разные способы сообщений | Устойчивый дополнительный выигрыш на validation и по сидам |
Поправка к EWM | Небольшой положительный validation-сигнал в H3 | Устойчивость на новом периоде и отдельный вклад attention/такси |
Это результаты адаптаций при ограниченном бюджете поиска. В большинстве чикагских screening-серий один seed, для выбранных вариантов — три; несколько положительных результатов имеют отдельные повторы. Дневной bootstrap оценивает неопределённость при заданных прогнозах, не разброс от переобучения или переноса в другой город. В поздних H3-сериях используются семидневные блоки; исторический аудит Лимы и ранние районные сравнения ресэмплируют отдельные дни. Интервалы из разных протоколов не взаимозаменяемы; многочисленные разведочные проверки не создают независимого подтверждения сами по себе.
Ноль в данных означает отсутствие зарегистрированной записи, а не доказанную безопасность. Непубликуемые OD-пары не становятся наблюдаемыми нулями. Ретроспективный снимок OSM не гарантирует, что те же объекты существовали на дату каждого прогноза. Эти ограничения сохраняются у любой архитектуры.
Практический порядок работы получился таким: сильная локальная история → точно сформулированный дополнительный сигнал → matched-контроль → проверка качества количества и динамики выбора → подтверждение на новом периоде. Для воспроизведения нужны pinned-данные, evaluator, checkpoint и прогнозы по сидам, а не только финальная таблица.
Смысл этой серии не в том, что простая модель всегда лучше сложной. Категориальная история и региональные представления действительно дали полезные результаты в своих протоколах. Но назвать архитектуру победителем проще, чем показать, какая её часть принесла сигнал. Именно это различие определяет следующий эксперимент.
Приложения: технические детали и схемы архитектур
В приложениях A–D сохранены устройство sketch, отличия авторского порта, обучение и аудит исторических чисел лимской ST-SHN. Это подробный пример одной архитектуры. Приложение E охватывает авторские схемы всех рассмотренных семейств и отдельно отмечает отличия наших адаптеров. Для источников новых разделов см. фактчек.
Перед техническими деталями уточним обозначения. B — число примеров в батче, T — длина истории, R — число регионов, C — число категорий, d — размер скрытого вектора. Logit — выход до преобразования в вероятность, sigmoid переводит его в диапазон 0–1; log-odds — обратная запись вероятности как логарифма отношения шансов. Checkpoint — сохранённое состояние модели; checkpointing блоков — другой приём: пересчёт промежуточных активаций для экономии памяти. Трансдуктивный протокол допускает использование всех узлов и их признаков без использования тестовых целевых меток при обучении; это не строгий перенос на новые узлы.
В Mermaid-схемах encoder кодирует вход, decoder выдаёт выходную последовательность, GLU — блок с обучаемым затвором, регулирующим поток признаков, DCGRU — GRU с диффузионным обменом по графу. Skip/residual-пути обходят часть преобразований. Scheduled sampling при обучении меняет долю истинных и предсказанных предыдущих значений, подаваемых decoder. Эти определения описывают блоки публикаций; наличие блока в схеме не означает, что он полностью перенесён в наш адаптер.
A.1. Операции sketch
Дальше речь о ветке без authors=True в model.py. Пусть B — число примеров, T=28, R=2120, C=5, d=16. Нормализованное число событий в каждый день умножается на обучаемый вектор своей категории. [B,T,R,C] превращается в [B,T,R,C,d]. Постоянный вектор категории общий для всех дней и ячеек, но масштабируется их входными значениями. Для вариантов с POI на этом шаге можно прибавить проекцию статических признаков ячейки; у a0_paper этой ветки нет.
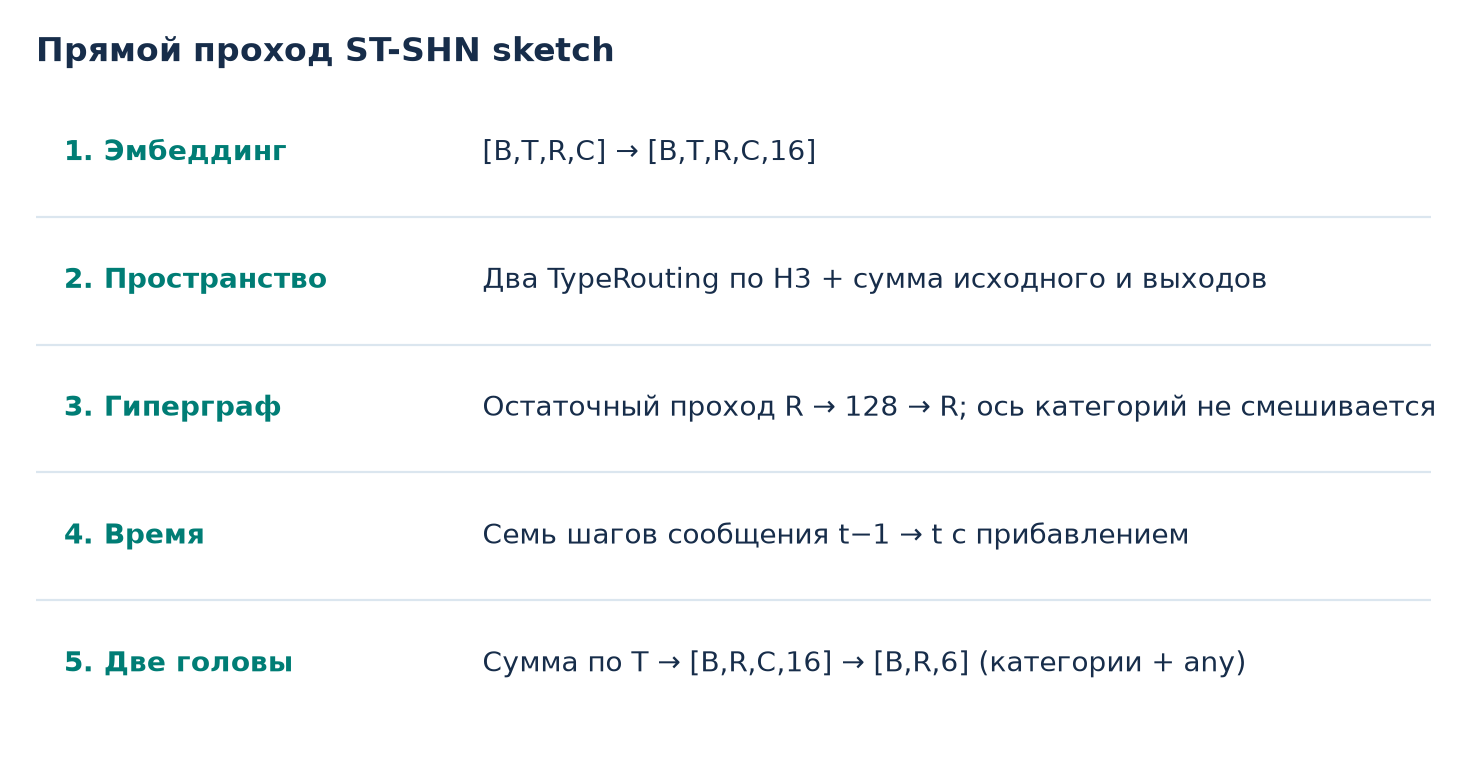
Пространственный роутинг. На ориентированном ребре j → i вектор каждой категории принимающей ячейки задаёт запрос, а категории источника дают ключи и значения. Attention идёт по категориям источника на данном ребре, не по всему городу и не по соседям сразу. В конфигурации четыре головы, по четыре компоненты в каждой. После attention сообщение умножается на вес ребра, затем вклады суммируются по принимающей ячейке. Рёбра H3 имеют симметричную нормировку D⁻¹ᐟ² A D⁻¹ᐟ², в граф добавлены self-loops. Sketch выполняет два пространственных слоя и суммирует исходное представление и выходы обоих слоёв. Даже до гиперграфа это оставляет пути, которые не требуют менять ячейку.
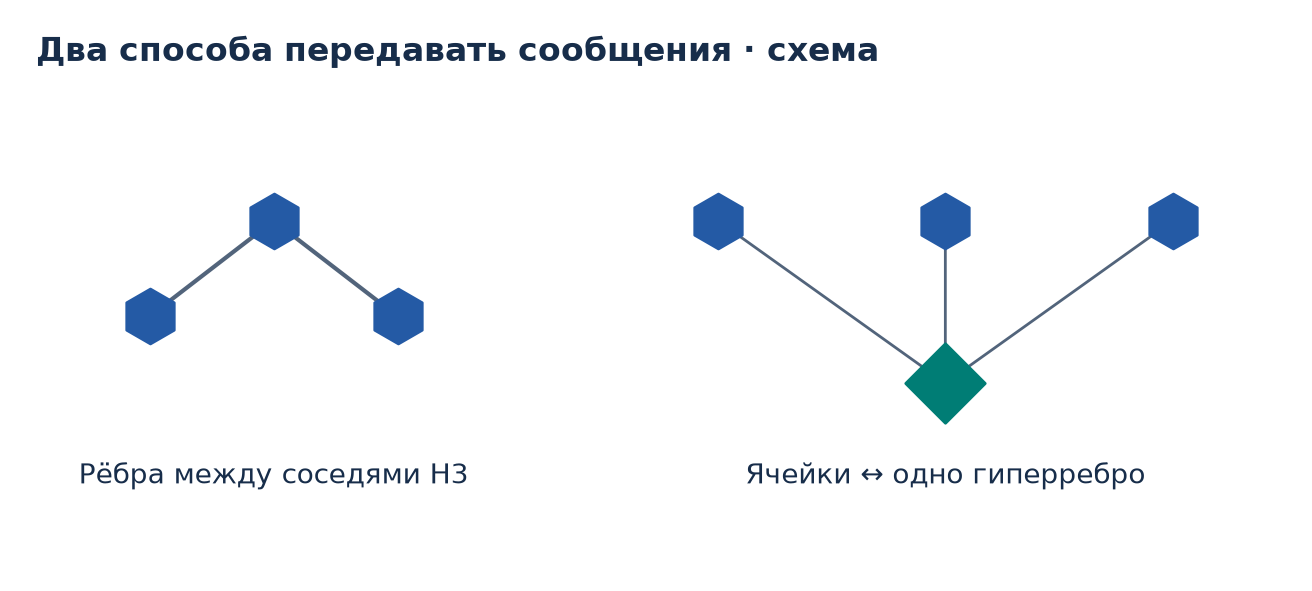
Гиперграф. У него другая ось смешивания: веса принадлежности Ψ имеют форму [128,R]. Сеть собирает состояния регионов в состояния гиперрёбер [B,T,128,C,d], затем возвращает их в [B,T,R,C,d]. В sketch используется abs(Ψ) с отдельной нормировкой для двух направлений, LeakyReLU и остаточное сложение с исходным состоянием. Благодаря этому в обмене могут участвовать не только соседние ячейки. При этом Ψ связывает именно регионы; путать её с матрицей межкатегориального attention не стоит. Категории смешиваются в TypeRouting, а при умножениях на Ψ их ось сохраняется. Схема выше показывает концепцию, не выученные связи Лимы.
Временные обновления. Семь слоёв снова используют TypeRouting и тот же граф H3, но запрос берётся из позиции t, а ключи и значения — из t−1. Первая позиция окна остаётся прежней, к остальным прибавляется новое сообщение. Это не attention между произвольными днями: каждый слой продвигает сообщения на один шаг. После стека модель суммирует состояния за все 28 дней. Благодаря остаточным путям и сумме даже без надёжно выученного порядка сеть может извлекать признаки из состава окна. Какая часть выигрыша обязана порядку — эмпирический вопрос, а не свойство диаграммы.
Выход. Из [B,R,C,d] получаются пять категориальных логитов, по одному для каждого канала. Логит any вычисляется отдельной линейной головой над склеенными C×d компонентами ячейки. Это не сумма вероятностей категорий и не формула вероятности объединения независимых событий. Для пространственного ранжирования используется именно эта шестая голова. У вариантов с offset перед сигмоидой к каждому логиту прибавляется свой обучаемый коэффициент, умноженный на исторический логит ячейки.
Цена такой реализации определяется не только количеством параметров. На M ориентированных рёбрах категориальный attention обрабатывает C×C пар на день и ребро; объём арифметики в attention на одном слое имеет порядок B·T·M·C²·d, не считая проекций и накопления сообщений. Плотный проход через Ψ в обе стороны масштабируется с произведением числа ячеек и гиперрёбер. Поэтому маленькое d ещё не означает небольшой пик памяти. В коде используется checkpointing блоков при обучении, а для валидации и теста дни проходят небольшими батчами. Это инженерные свойства реализации, а не замеры скорости разных моделей.
Для исторического offset используются положительные дни до начала входного окна. Если таких дней n, из них m положительных, а train-частота соответствующей цели равна p_train, сглаженный prior равен (m + 30·p_train)/(n + 30). После ограничения диапазона его переводят в log-odds и добавляют к сетевому логиту с обучаемым коэффициентом. Это частота положительных дней, не сглаживание числа событий; перестановка offset меняет его привязку, сохраняя сами значения.
A.2. Отличия от авторской реализации
Оригинальная ST-SHN Xia и соавторов (IJCAI 2021) описывает архитектуру и авторский эксперимент. a0_paper, несмотря на имя, реализует рабочий набросок из архивного плана. a0_authors — перенос ключевых операций, сверенных с авторским кодом. Это faithful port на уровне проверенных блоков, а не воспроизведение всей авторской выборки, геометрии и evaluation. Итоговый сопоставимый test score a0_authors для Лимы в историческом отчёте не подтверждён.
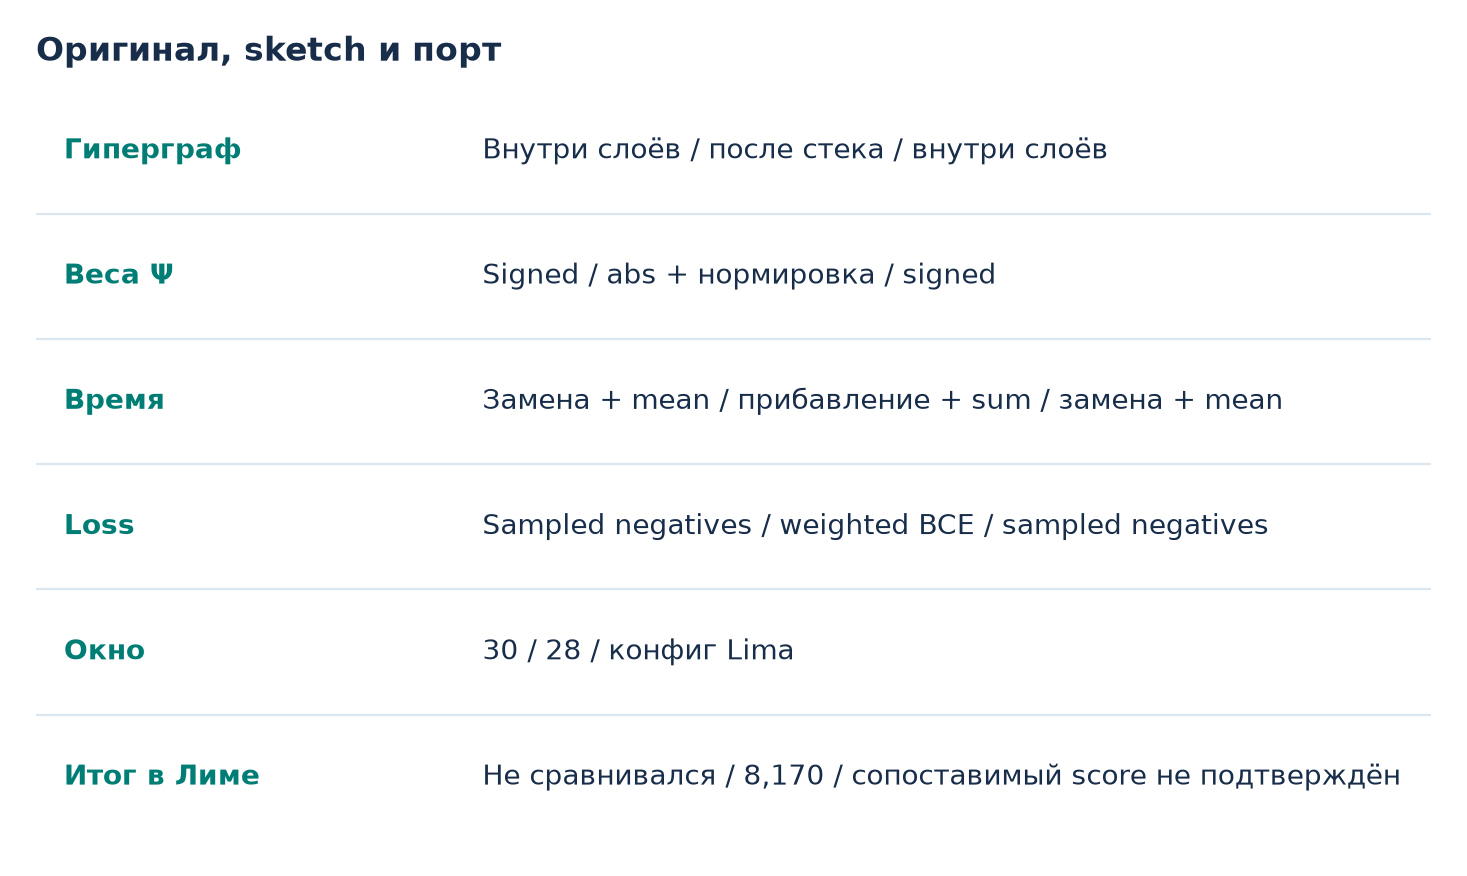
Узел | Оригинальный код |
|
|
|---|---|---|---|
Пространственный стек | Гиперграф внутри каждого слоя, с residual | Один residual-гиперграф после суммирования стека | Гиперграф внутри каждого слоя |
| Signed веса без нормировки степеней |
| Signed веса без нормировки степеней |
Временной шаг | Замена позиций | Прибавление сообщения; сумма по времени | Замена позиций; агрегация слоёв с делением и среднее по времени |
Loss | Положительные и до четырёх sampled negatives на положительный пример внутри категории | Weighted BCE на всех доступных ячейках | Sampled loss вместо |
История и данные | 30 дней, глобальный z-score; авторская сетка и фильтр оценочных ячеек | 28 дней, z-score по каналам, H3 | Тот же локальный загрузчик и окно по конфигу, не автоматический переход на 30 дней |
Каждое отличие меняет условия сравнения. Повторный проход через гиперграф позволяет глобальному сообщению снова смешаться с локальными признаками; signed-веса допускают отрицательные вклады, невозможные у неотрицательных коэффициентов принадлежности sketch. Замена временного состояния и прибавление сообщения дают разные короткие пути от входа к выходу. Негативный sampling и weighted BCE по полной сетке по-разному распределяют градиент, даже если обе процедуры повышают роль редкого класса. Ни одна из этих гипотез не объясняет конкретную потерю PAI без контролируемого сравнения, где изменён только соответствующий блок.
Отсюда практическое правило воспроизведения: проверять не только названия слоёв, но и оси нормировки, место residual, порядок редукций, генерацию targets и область метрики. Можно получить корректный tensor shape, рабочий backward и разумную кривую, но сравнивать другую модель на другой задаче. И наоборот, не стоит списывать результаты адаптации только потому, что она не точный порт: они показывают, как вели себя вполне конкретные механизмы на этом наборе данных.
B. Временной протокол и обучение
Индексы ниже нулевые, интервалы полуоткрытые. Даты сверены по дневному индексу и day_splits.
Назначение | Индексы целевых дней | Даты включительно | Дней |
|---|---|---|---|
Train |
| 31 января — 31 июля 2026 | 182 |
Validation |
| 8 августа — 15 сентября 2026 | 39 |
Test |
| 23 сентября — 29 октября 2026 | 37 |
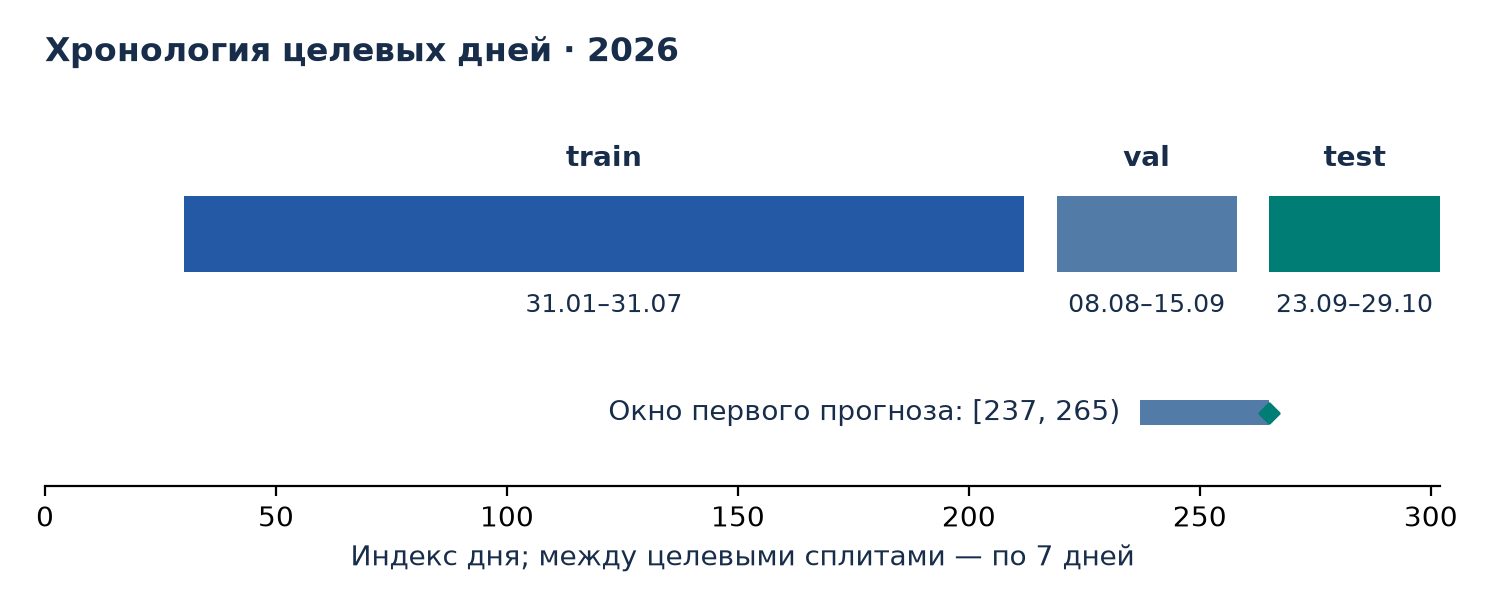
Между целевыми диапазонами по семь дней, но это gap для целей, а не запрет читать все записи из gap. Например, первый тестовый прогноз использует 26 августа — 22 сентября: окно пересекает даты validation и последний gap, но не содержит 23 сентября. По мере продвижения по тесту ранее наблюдавшиеся дни теста тоже могут попасть во вход будущих прогнозов. Это rolling next-day evaluation, не прогноз сразу на 37 дней и не подгонка весов на тестовых целях. Нормировочные статистики по каналам считаются на днях до конца train, включая начальную историю, а pos_weight и глобальный prior offset — по train-целям. Статика стандартизуется по всей фиксированной сетке без временных меток и целей. Этот трансдуктивный выбор существенен для интерпретации пространственного holdout.
У any в train положительны около 8,66% пар «день × ячейка», у vehiculo — около 0,93%. При такой разреженности высокая accuracy легко получается прогнозом одних нулей. Для sketch используется BCEWithLogitsLoss с отдельным весом положительного класса min(50, (1−p)/p) для каждого выхода. Отрицательные ячейки при этом не отсэмплируются: loss считается по всем доступным ячейкам и выходам. В masked-history обучении скрытые ячейки исключены из loss и из расчёта pos_weight. Loss отвечает за классификацию присутствия, тогда как критерий выбора модели поощряет попадания событий с учётом их количества. Эти цели связаны, но не тождественны.
Дни внутри train перемешиваются на каждой эпохе. Это порядок оптимизационных шагов: внутри окна хронология остаётся нетронутой. По конфигу и циклу обучения, один шаг берёт один целевой день, оптимизатор — AdamW с начальным lr=0.001 и weight_decay=0.0001, норма градиента ограничивается единицей, learning rate умножается на 0.96 после эпохи. Лимит по умолчанию — 40 эпох, patience — шесть. Чекпоинт выбирается по сырому validation PAI@5% для any. Текущий снапшот для продолжения хранит другое состояние, чем лучший checkpoint для инференса; подмена одного другим меняет эксперимент.
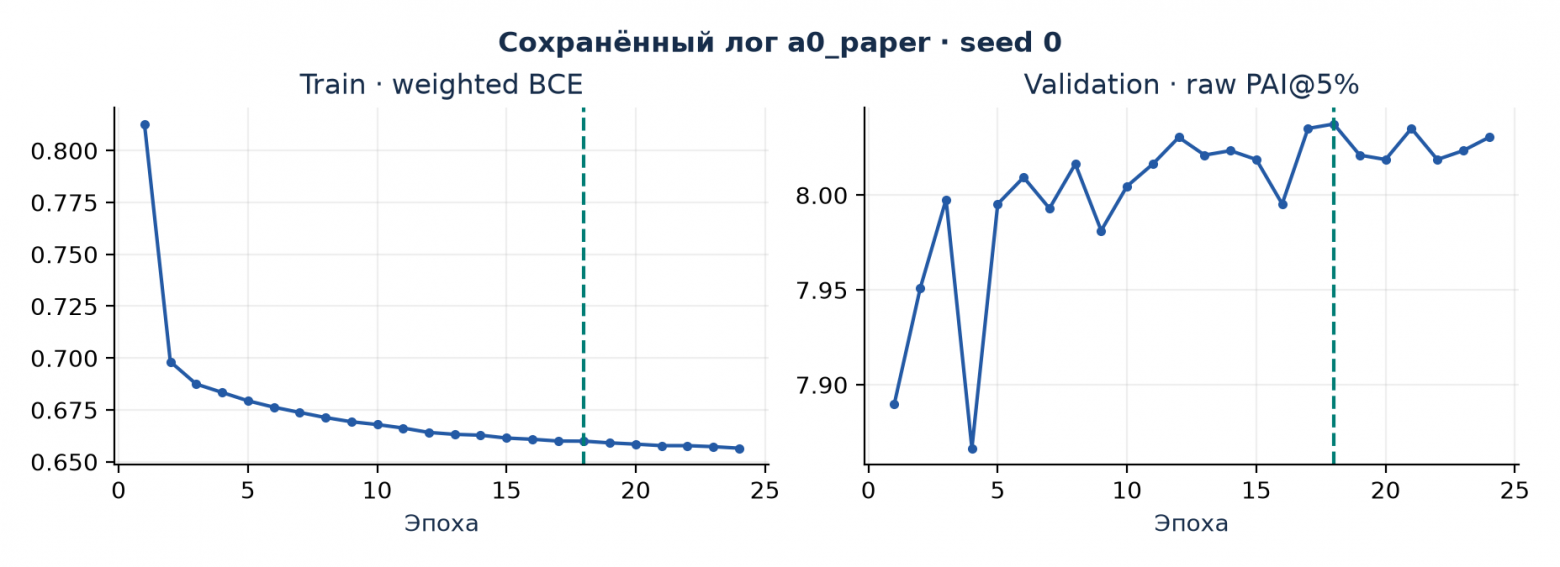
На графике — один лог a0_paper, seed 0, для которого максимум validation совпал со значением в сохранённом чекпоинте. Номера эпох показаны с единицы. Loss и PAI не обязаны двигаться вместе: loss видит все выходы и все доступные ячейки, а PAI зависит только от состава верхней части ранжирования any. Тестовая кривая здесь не нужна: на тесте оценивается уже выбранный чекпоинт.
После выбора весов сеть выдаёт карты sigmoid(logit) по всем ячейкам. Для каждого выхода и сида изотоническое преобразование оценивается на validation, затем применяется к тестовым прогнозам. Оно монотонно, но может образовывать плато. В коде добавлен малый член 10⁻⁶·score для сохранения порядка, однако округление в float32 не гарантирует, что все различия переживут преобразование. При равном итоговом балле стабильная сортировка отдаёт преимущество меньшему индексу ячейки. Для top-k это часть определения метрики, а не безразличная деталь форматирования.
C. Почему −0,078 не равно −0,023
В таблице мы отдельно калибруем каждый сид, строим его top‑5% и берём среднее трёх PAI. В парном анализе сначала усредняем сырые прогнозы трёх сидов, строим одну карту в день и сравниваем её с сохранённой откалиброванной картой EWM-30. Усреднить баллы, а потом отобрать 106 ячеек — не то же самое, что сначала выбрать три набора по 106 ячеек, оценить их, а потом усреднить результаты. Для a0_paper на сырых прогнозах mean(PAI по сидам) = 8,1797, а PAI(mean прогнозов) = 8,2241. Дополнительное различие даёт калиброванное ранжирование.
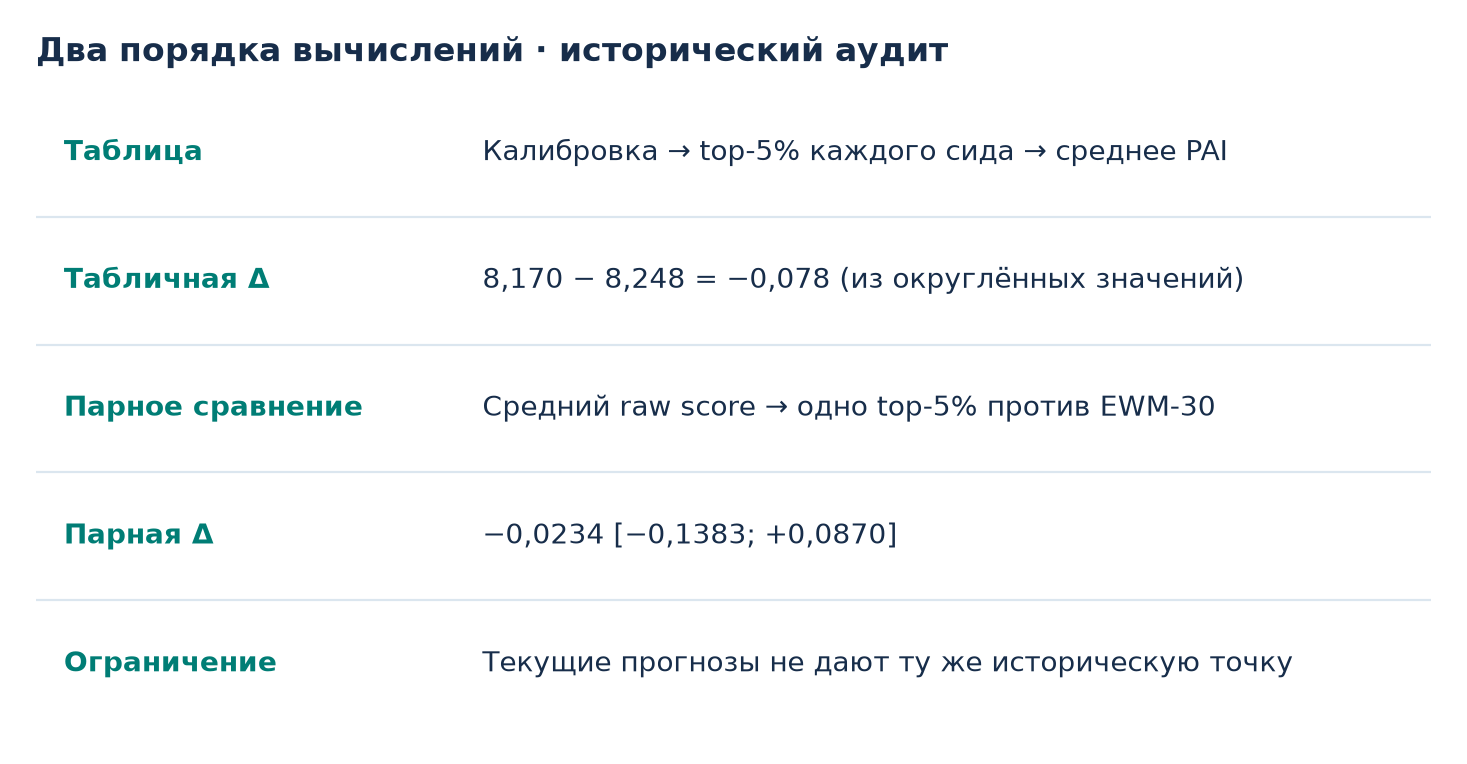
Аудит воспроизвёл −0,0234 [−0,1383; +0,0870]. Для каждого из 10 000 повторов evaluator берёт одни и те же дни с возвращением для обеих моделей: весь дневной срез сохраняется, но это не многодневные блоки. В каждом повторе суммируются попадания и события, затем считается разность PAI. Интервал описывает выбранный ансамбль и ресэмплинг дней при таком методе; он не включает разброс от новых инициализаций и не гарантирует учёт последовательной зависимости между днями. Интервал пересекает ноль: надёжного преимущества в этом сравнении нет. Вешать его на −0,078 или объявлять модели эквивалентными было бы ошибкой. Проверка a0_paper против a1_offset в аудите полезна как контроль: на одинаковых сырых записях средняя разность и разность средних совпали, +0,0390; после смены способа агрегации парная оценка стала +0,1123.
Есть и отдельная проблема с версиями файлов. По текущим массивам в рабочем архиве, на тех же 37 днях и с тем же evaluator, ансамбль a0_paper даёт 8,2054 вместо 8,2241 из исторического аудита. Сохранённый EWM-30 даёт 8,2475, а парная разность текущего среза — −0,0421 [−0,1603; +0,0683]. Интервал также пересекает ноль, но это не воспроизведение исторического значения. Точная причина расхождения версий прогнозов не установлена. Поэтому мы не подставляем текущие посуточные ряды в иллюстрацию исторического сравнения и не заменяем ими цифры отчёта.
D. Что осталось от исторической инференс-диагностики
В таблице trained-model ablations исторического отчёта контроль равен 8,189. Variant, seed и hash исходного checkpoint не подтверждены; поэтому не приписываем таблицу автоматически a0_paper или a1_offset. Веса после вмешательств не переобучались.
Вмешательство | PAI@5% | Падение clean − perturbed, 95% ДИ |
|---|---|---|
Clean | 8,189 | контроль |
Перестановка дней | 8,184 | +0,005 [−0,039; +0,046] |
Только self-loops | 8,124 | +0,066 [−0,040; +0,167] |
Обнуление гиперграфа | 8,217 | −0,028 [−0,124; +0,068] |
Нулевой нормализованный вход | 7,988 | +0,201 [+0,074; +0,322] |
Окно другой ячейки | 7,674 | +0,515 [+0,330; +0,699] |
Offset другой ячейки | 3,453 | +4,736 [+4,464; +5,008] |
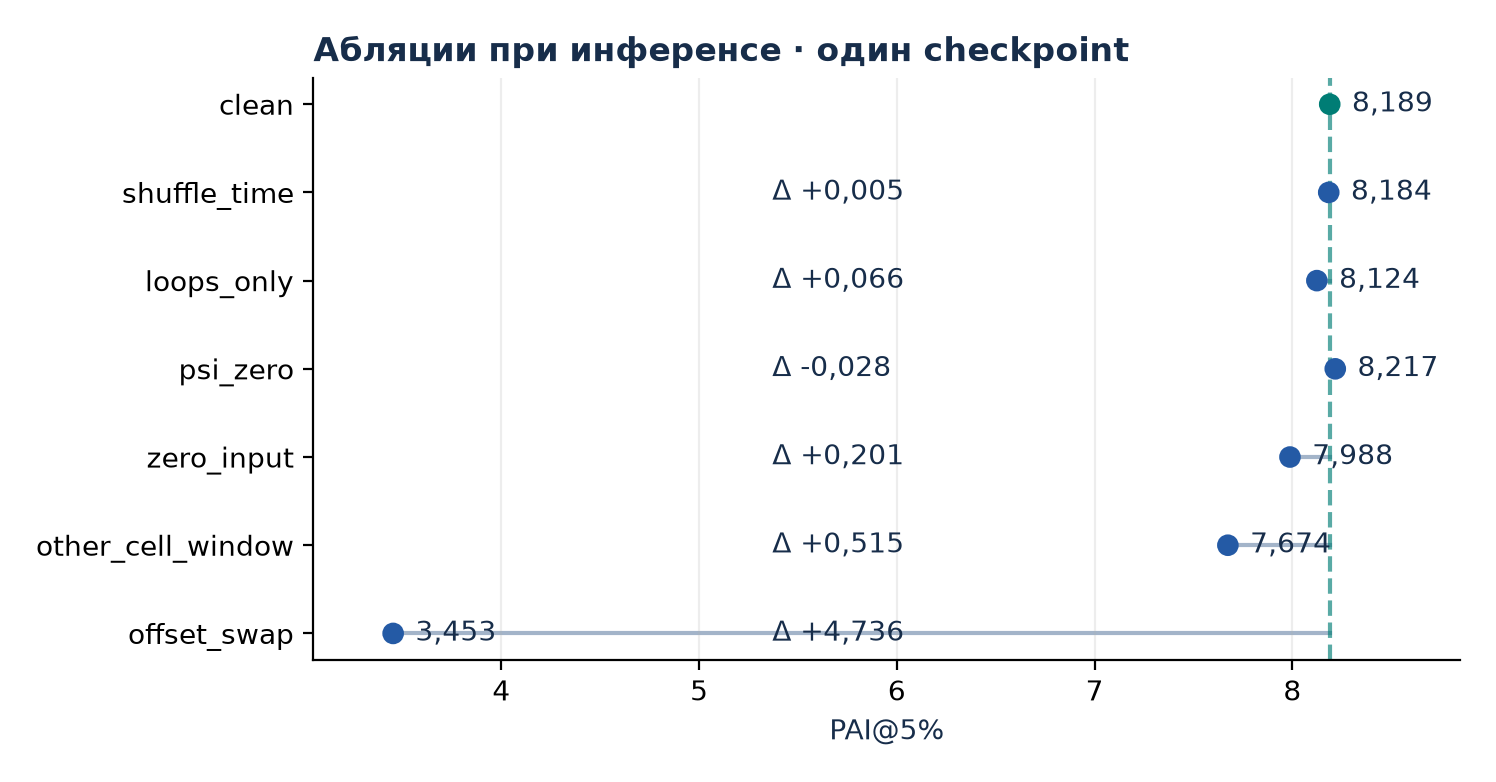
Ноль после нормировки — заглушка около train-среднего, не отсутствие событий. Перестановка offset нарушает соответствие prior ячейке; её вред нельзя считать выигрышем от добавления prior к переобученному контролю. Отключение обычных рёбер оставляет гиперграф, обнуление гиперграфа — обычные рёбра. Для ранговой стабильности нужны per-cell прогнозы после каждого вмешательства, которых в подтверждённом историческом наборе нет.
E. Архитектуры по исходным статьям
Схемы ниже — упрощённая реконструкция потока блоков по первичным статьям из docs/md/. Они не являются схемами всех наших адаптеров. Под каждой явно указано отклонение реализации. Сплошные стрелки обозначают поток признаков или состояний, пунктирные — дополнительную связь обучения/ограничения. Для residual, skip и вспомогательных loss показаны только существенные для объяснения пути; число слоёв и формы тензоров зависят от конфигурации и не заданы этой схемой.
DCRNN
Источник: Li_et_al_2018_DCRNN_Diffusion_Convolutional_Recurrent_Neural_Network, §2: diffusion convolution, sequence-to-sequence forecasting.
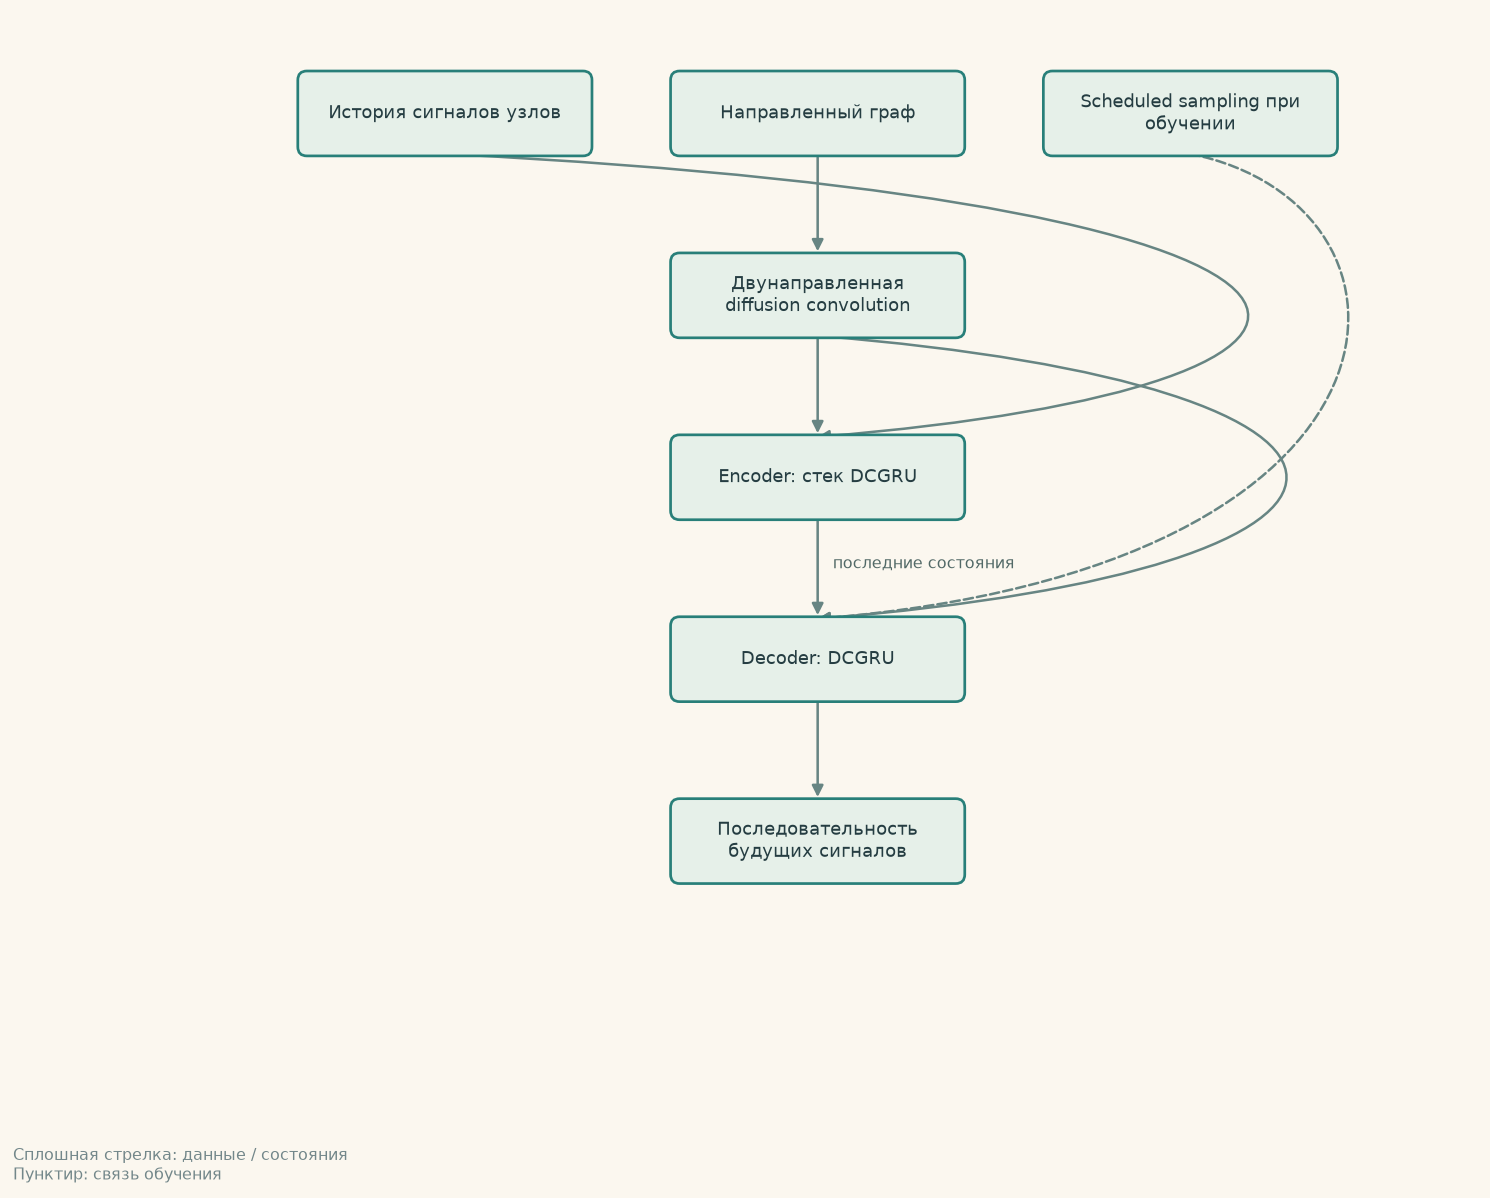
Наша адаптация. В нашем районном адаптере — next-day count и общая голова; авторский многошаговый декодер со scheduled sampling не воспроизводится.
STGCN
Источник: Yu_Yin_Zhu_2018_STGCN_Spatio-Temporal_Graph_Convolutional_Networks, §3: temporal gated convolution, graph convolution, ST-convolutional block.
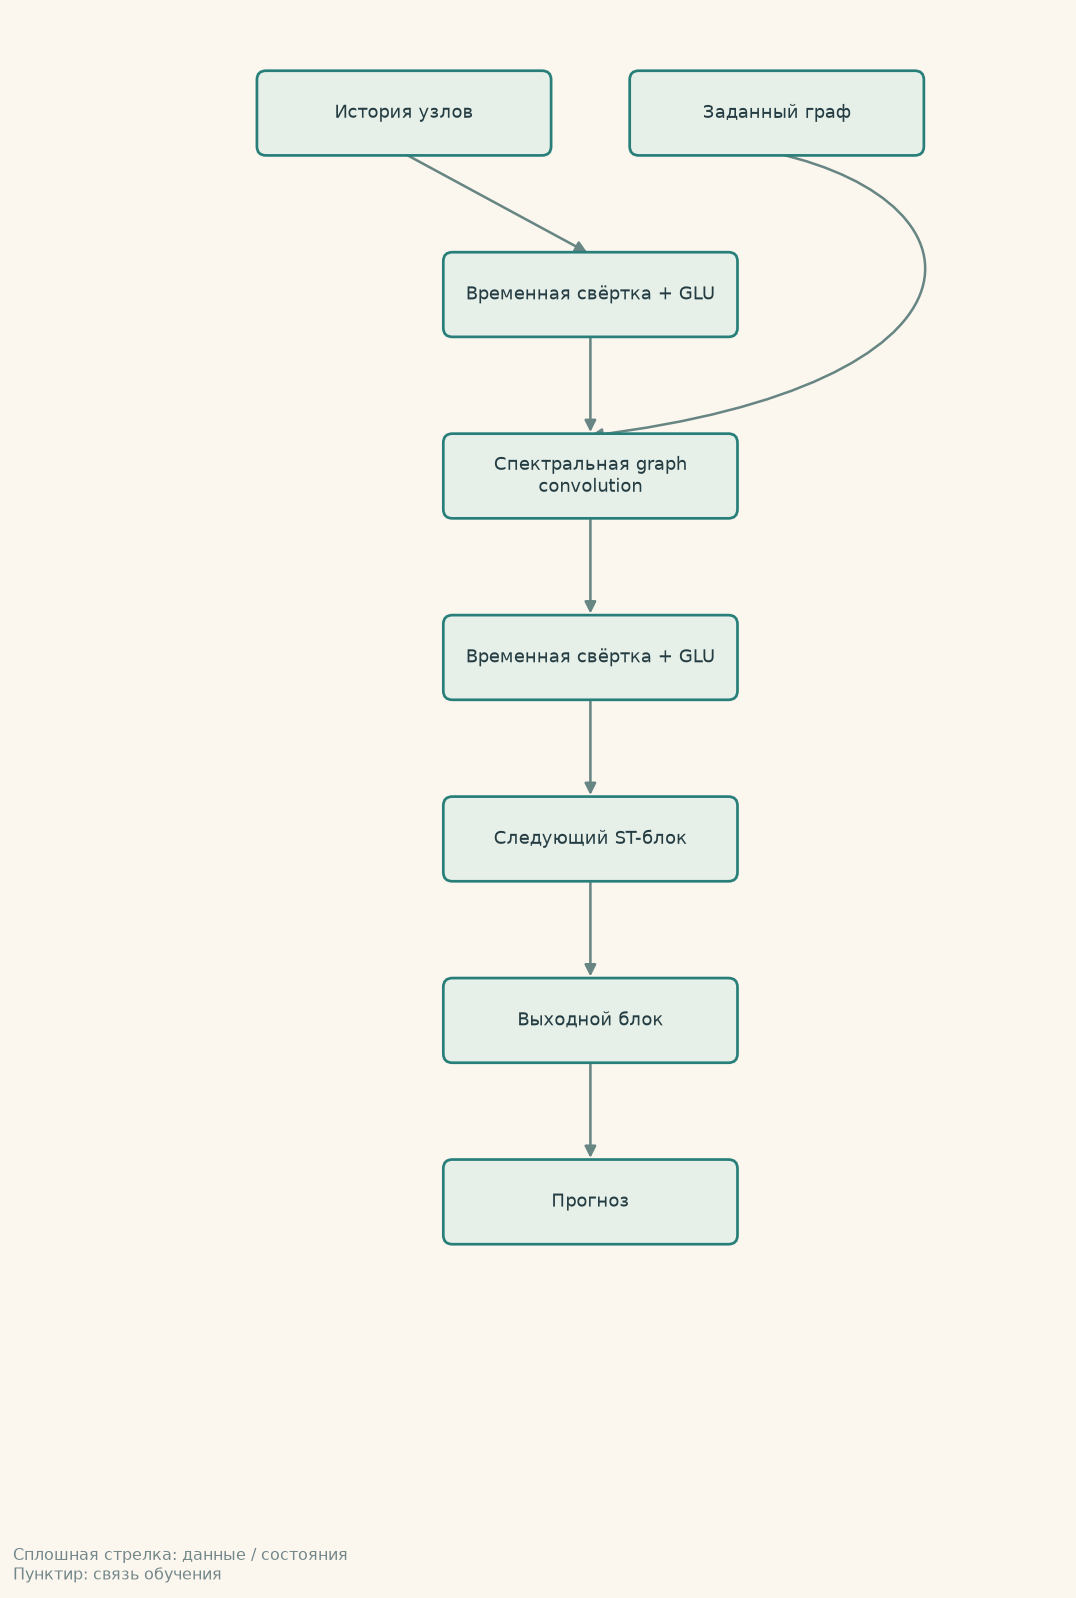
Наша адаптация. У нас проверяются H3/районная опора, self-only и переставленные связи; выход адаптирован к следующему дню, а не исходной traffic-задаче.
Graph WaveNet
Источник: Wu_et_al_2019_Graph_WaveNet_for_Deep_Spatial-Temporal_Graph_Modeling, §3: adaptive dependency matrix, spatial-temporal layers.
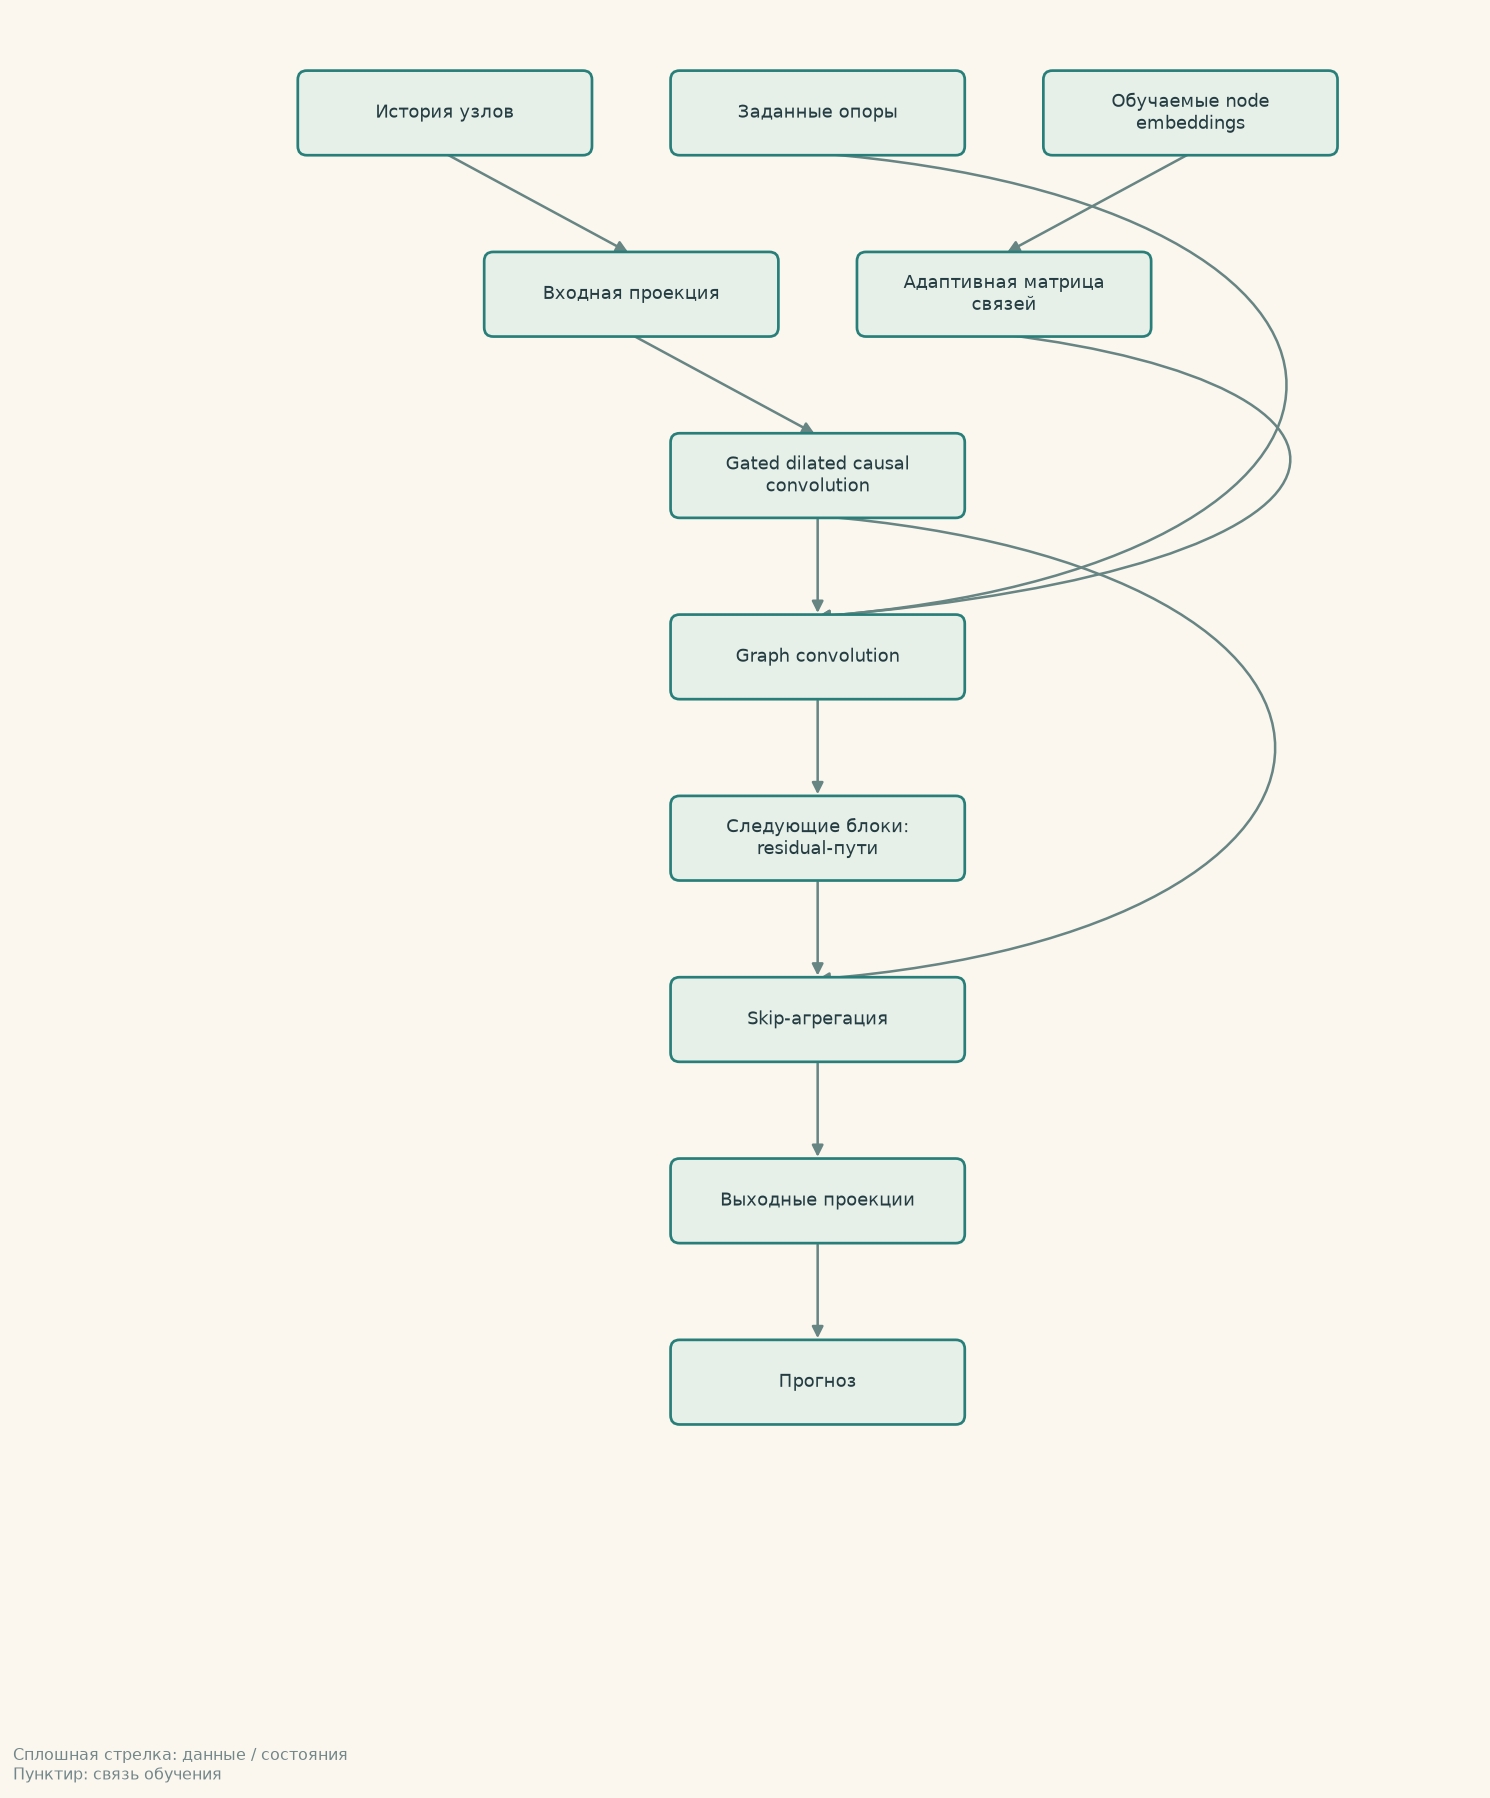
Наша адаптация. В наших экспериментах меняются fixed/adaptive опоры и count-голова. Старый ошибочный оператор исключён из результатов; схема показывает замысел статьи, а не ту ошибочную свёртку.
MTGNN
Источник: Wu_et_al_2020_MTGNN_Connecting_the_Dots_Multivariate_Time_Series_Forecasting_with_GNN, §3: graph learning, mix-hop propagation, dilated inception.
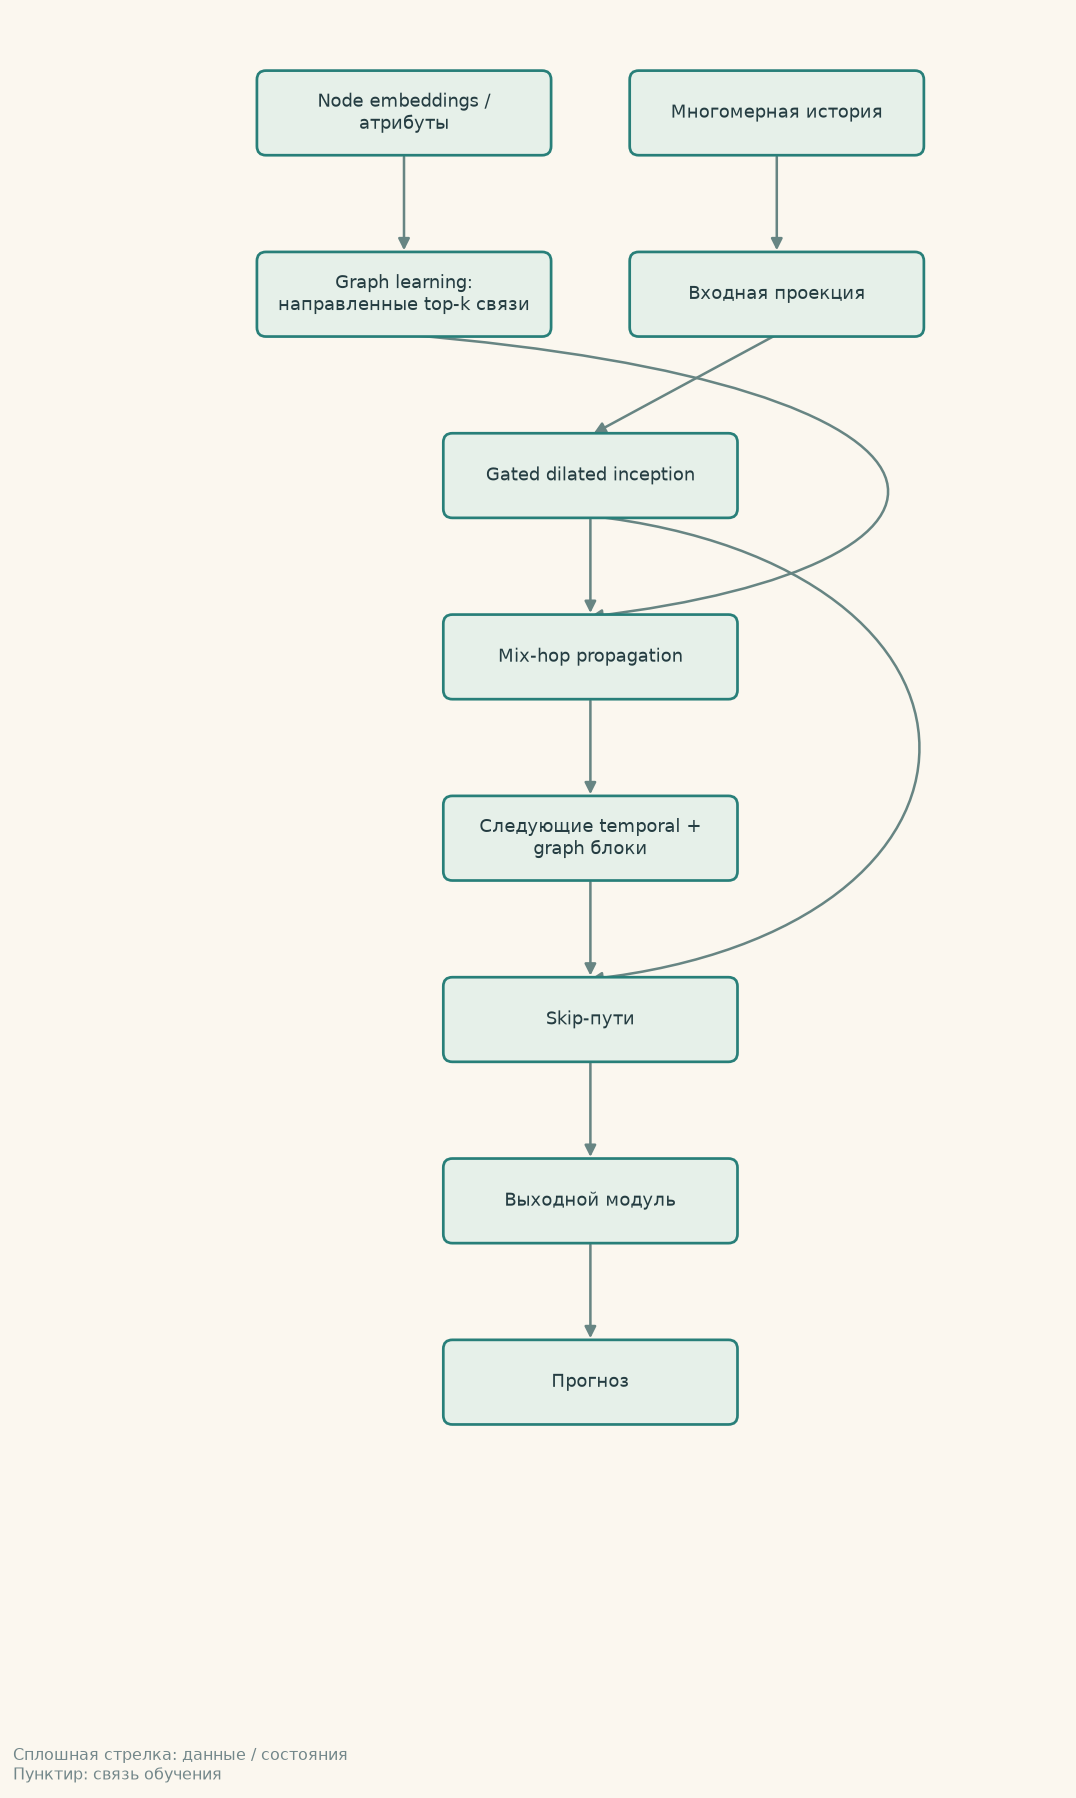
Наша адаптация. В выбранном районном финале mix-hop отключён. Такой результат нельзя интерпретировать как подтверждение пользы изображённого графового блока.
CrimeForecaster
Источник: Sun_et_al_2020_CrimeForecaster_Crime_Prediction_by_Exploiting_Geographical_Neighborhoods, Метод: geographical neighborhoods, DCGRU encoder–decoder.
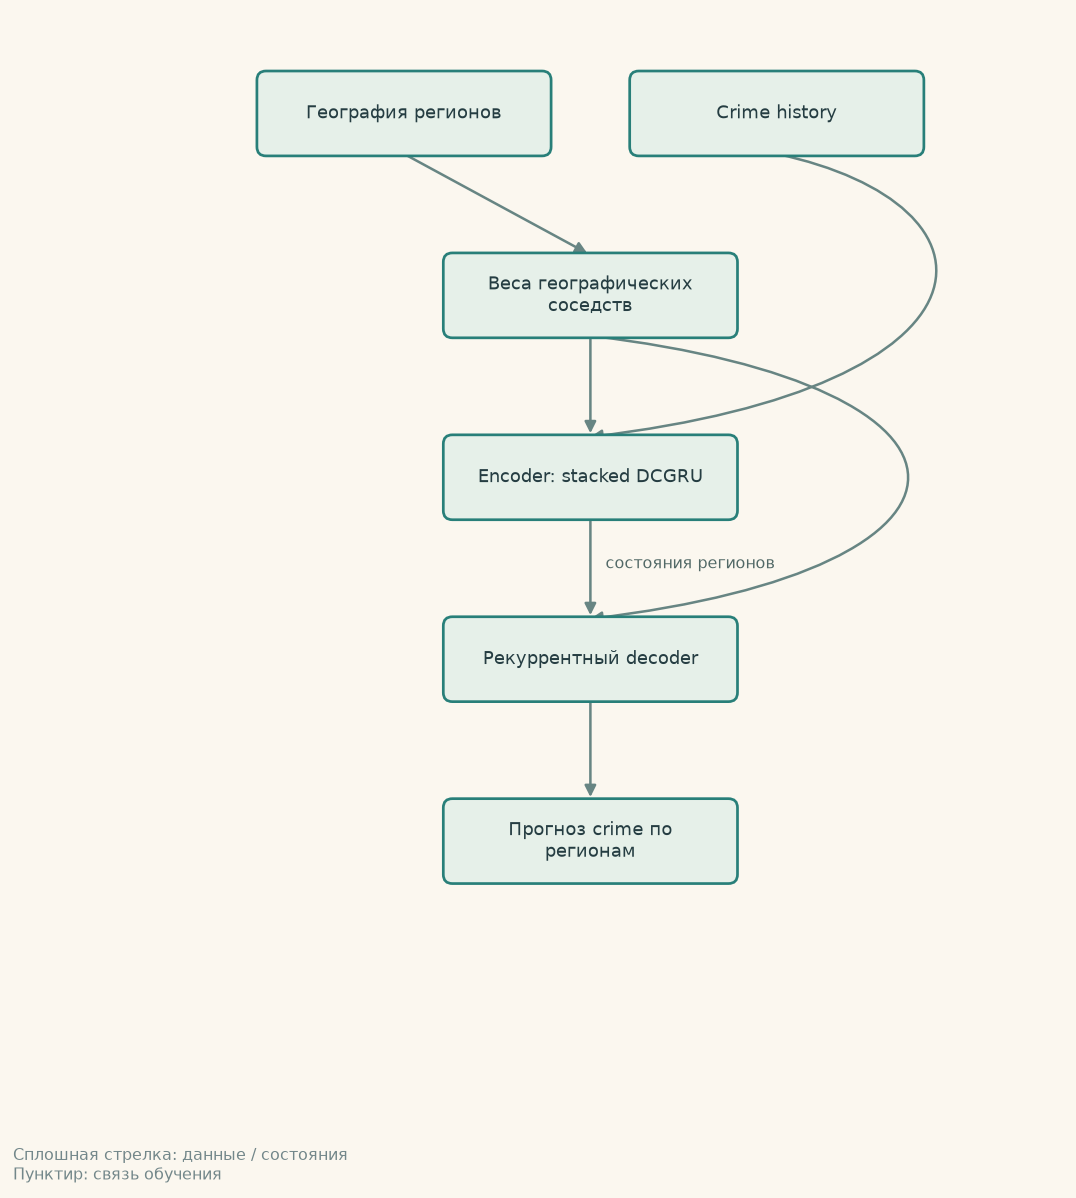
Наша адаптация. В нашем next-day адаптере сохранена идея diffusion/GRU; авторский encoder–decoder целиком не является общим runner-контрактом.
HAGEN
Источник: HAGEN_Homophily_Aware_Graph_Convolutional_Recurrent_Network_for_Crime_Forecasting, Метод: homophily-aware graph learning, diffusion convolution, GRU, MLP decoder.
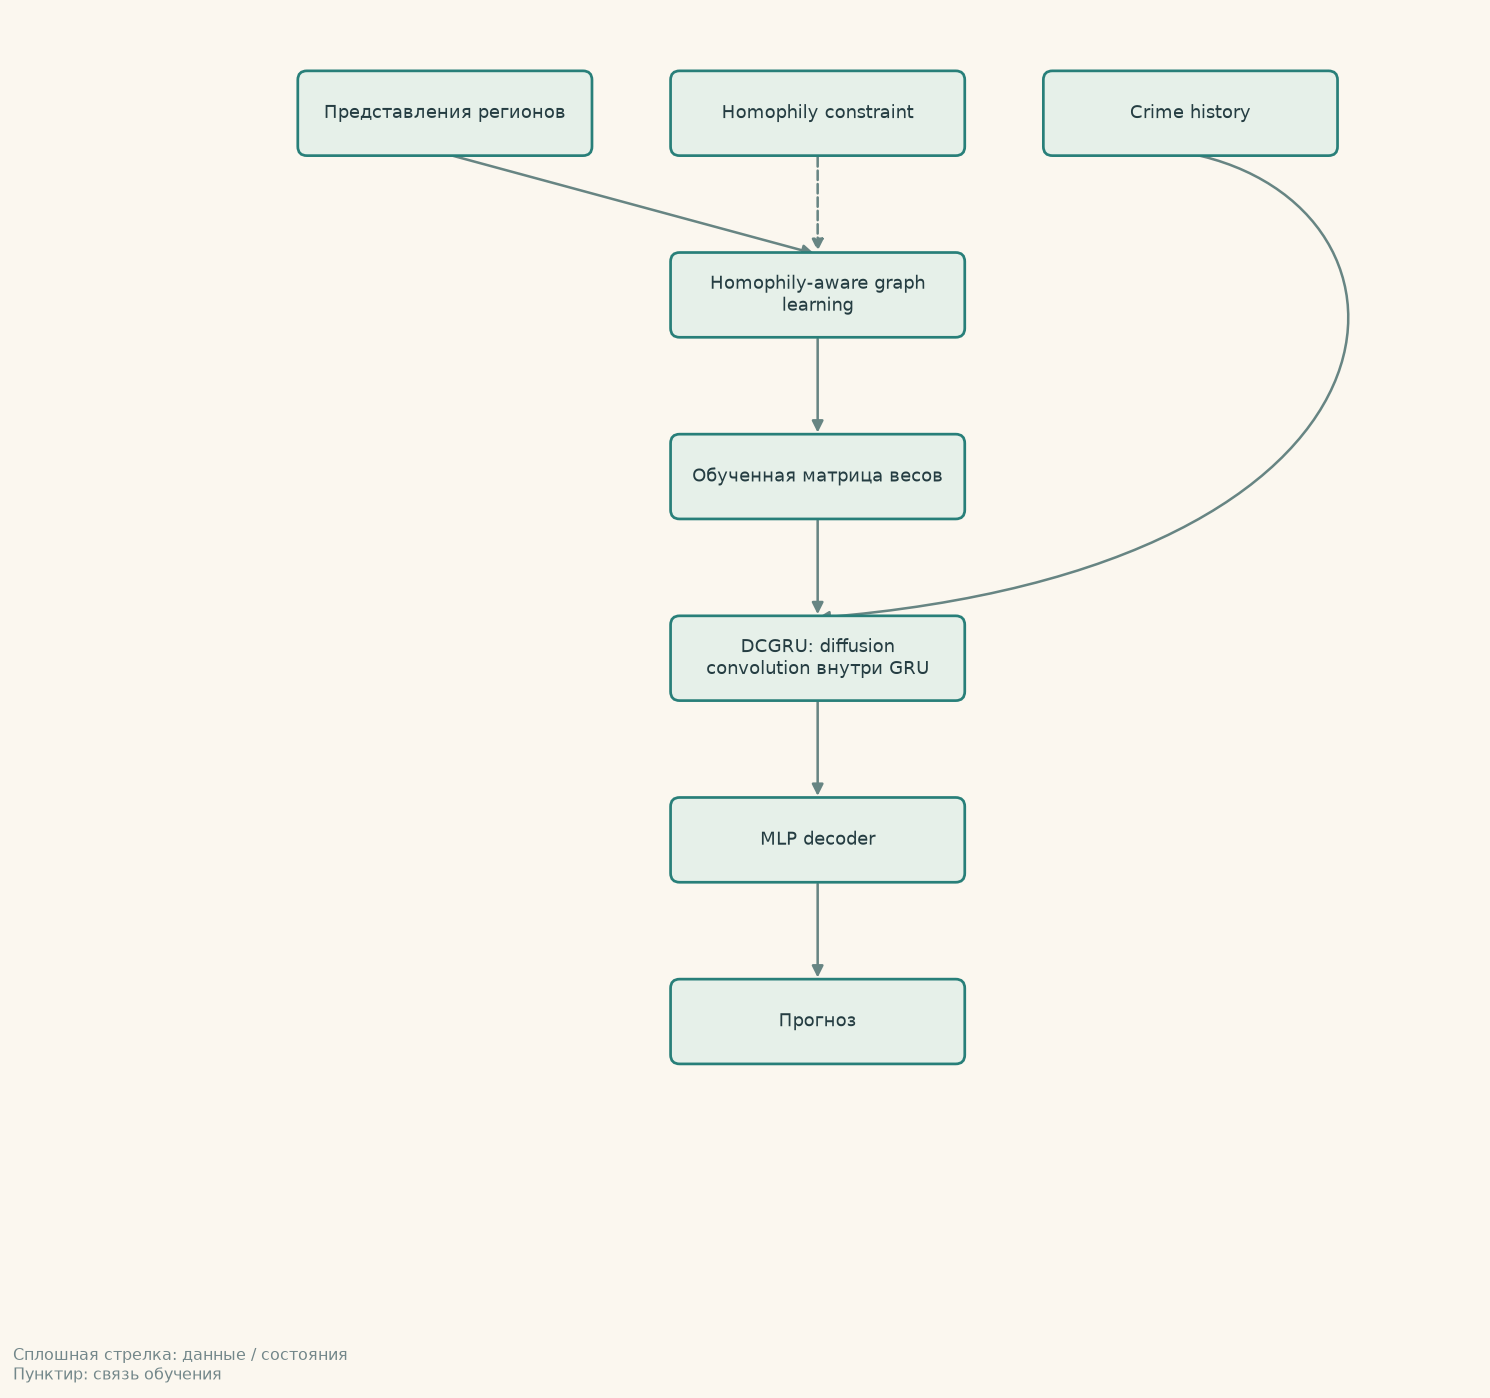
Наша адаптация. Наша multiplicative context×category голова — адаптация, не авторский блок. В сильном варианте используется fixed граф; эффект головы проверяется отдельно от graph learning.
ST-SHN
Источник: Xia_et_al_2021_ST-SHN_Spatial-Temporal_Sequential_Hypergraph_Network_for_Crime_Prediction, Метод: multi-channel routing, spatial hypergraph propagation, temporal relation learning.
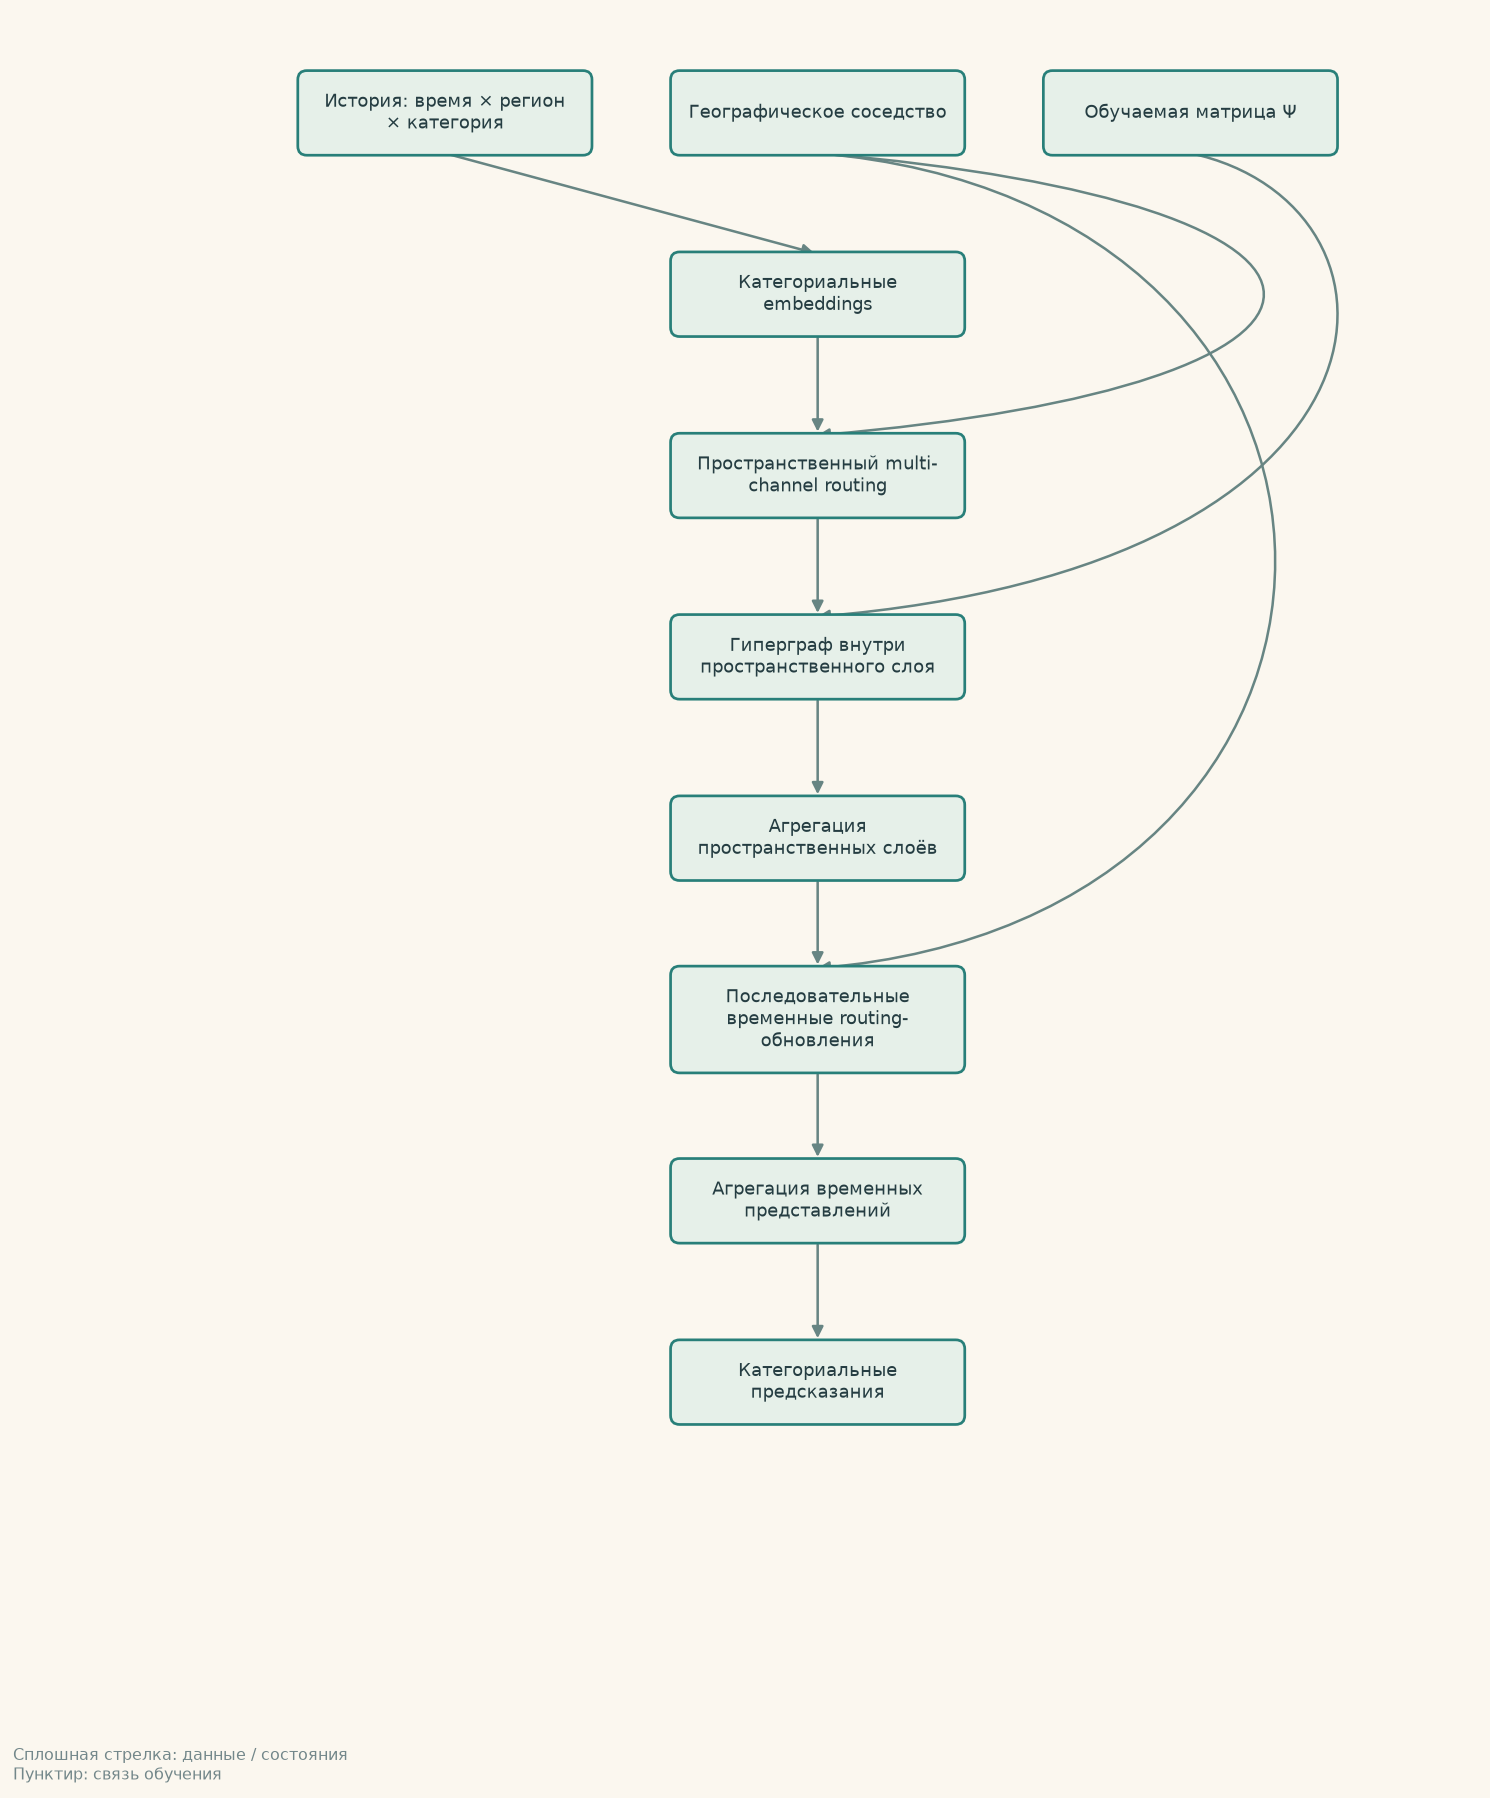
Наша адаптация. Схема относится к авторскому потоку блоков. У Lima sketch гиперграф стоит после пространственного стека, Ψ неотрицательна и нормирована, временные residual/редукции отличаются; см. приложение A.
ST-HSL
Источник: Li_et_al_2022_ST-HSL_Spatial-Temporal_Hypergraph_Self-Supervised_Learning_for_Crime_Prediction, §III.B–E: multi-view spatial-temporal convolution, hypergraph, dual-stage self-supervision.
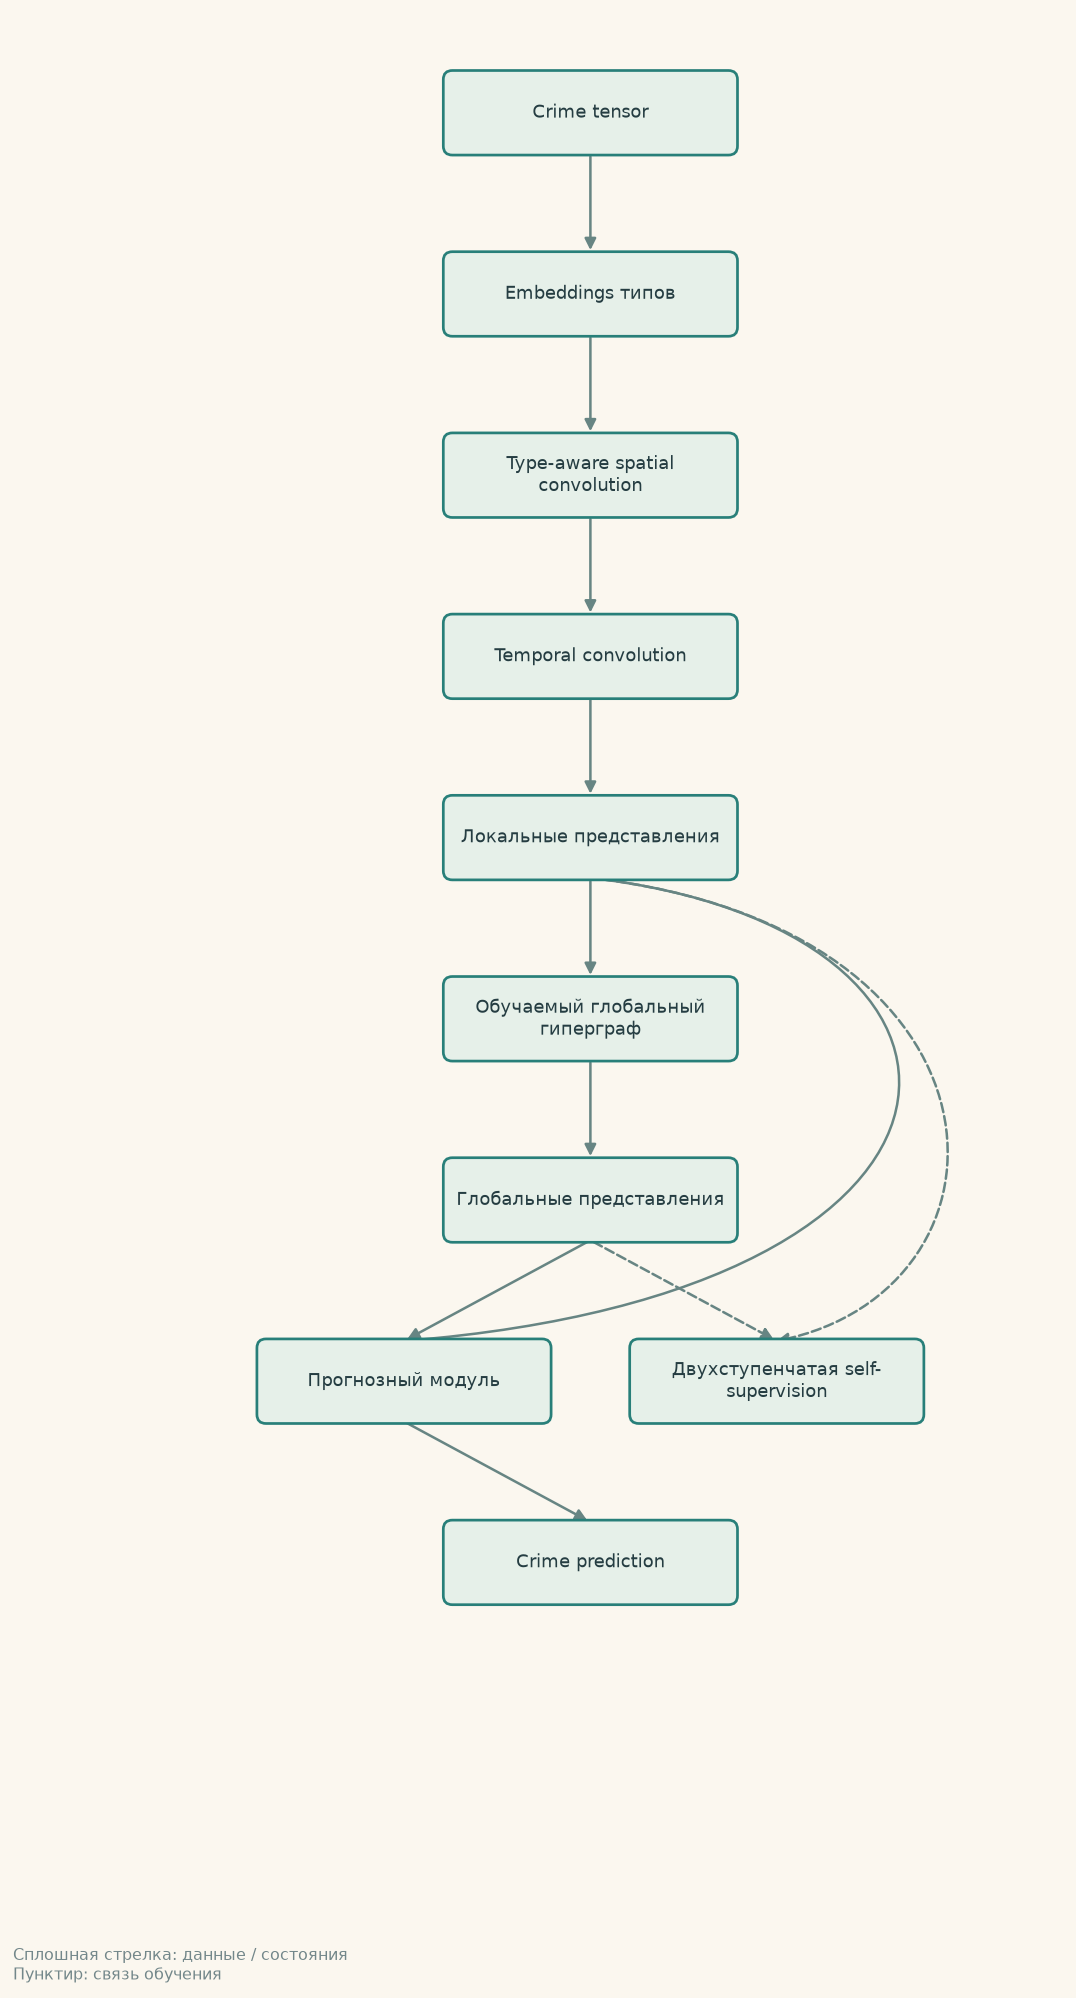
Наша адаптация. Наш районный local encoder — GRU вместо авторского свёрточного multi-view encoder; SSL упрощён до DGI-style задачи. Это существенные отклонения, а не точный порт.
MiST
Источник: MiST-A_Multiview_and_Multimodal_Spatial-Temporal_Learning_Framework_for_Citywide_Abnormal_Event_Forecasting, §3.1–3.4: context-aware recurrence, multimodal fusion, conclusive recurrent network.
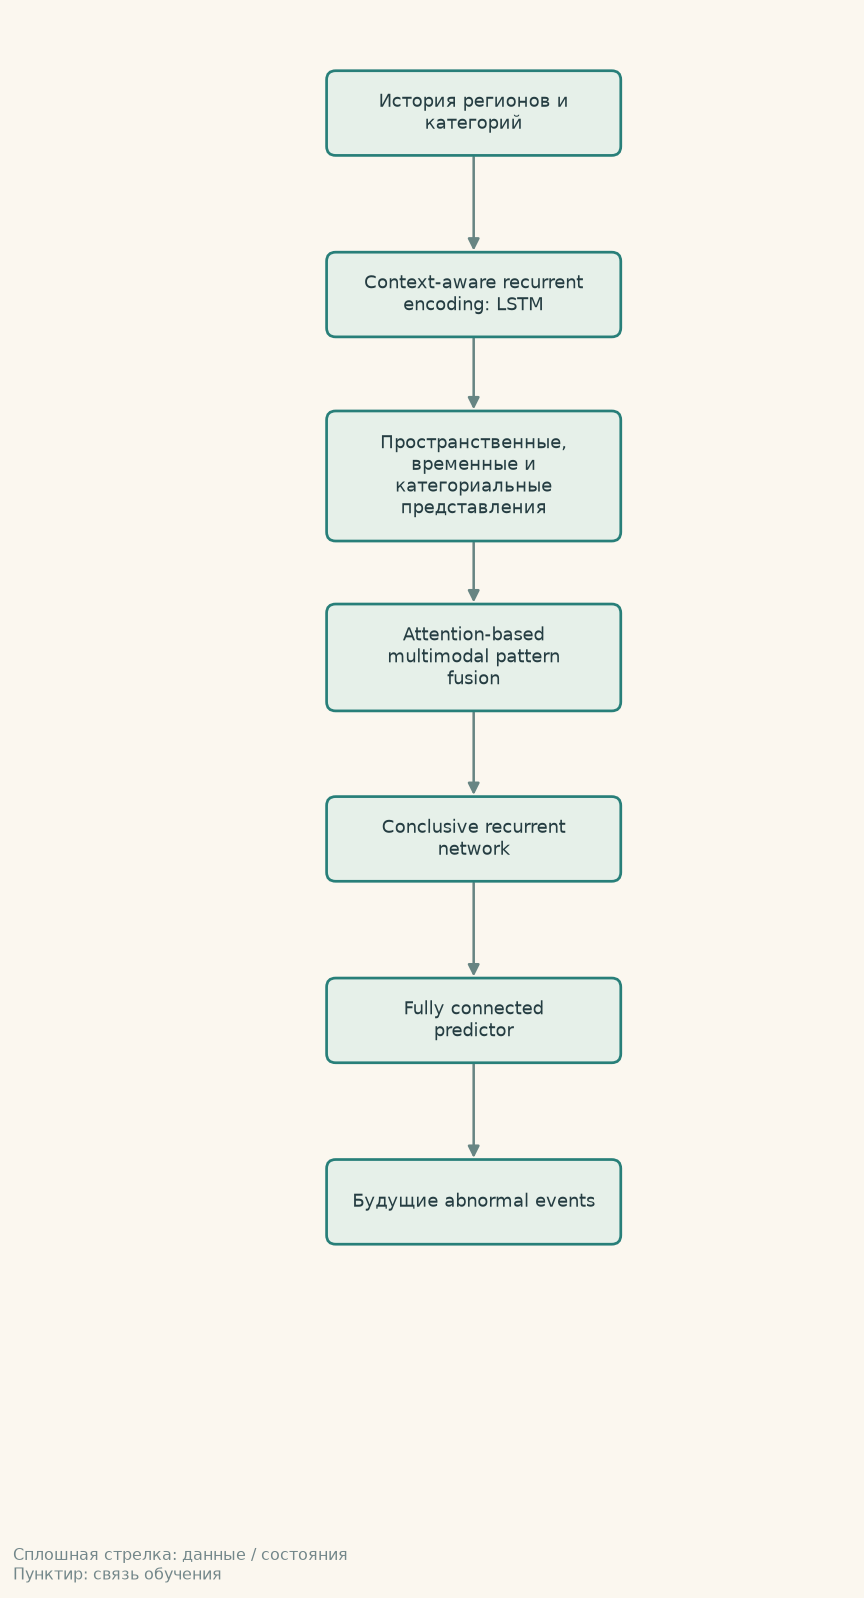
Наша адаптация. В нашей районной реализации recurrent-блоки используют GRU, а не авторские LSTM. Входы и count-цель также ограничены доступными данными.
DeepCrime
Источник: Huang_et_al_2018_DeepCrime_Attentive_Hierarchical_Recurrent_Networks_for_Crime_Prediction, §2.2, §3.1–3.4: region-category encoder, hierarchical recurrence, attention, MLP.
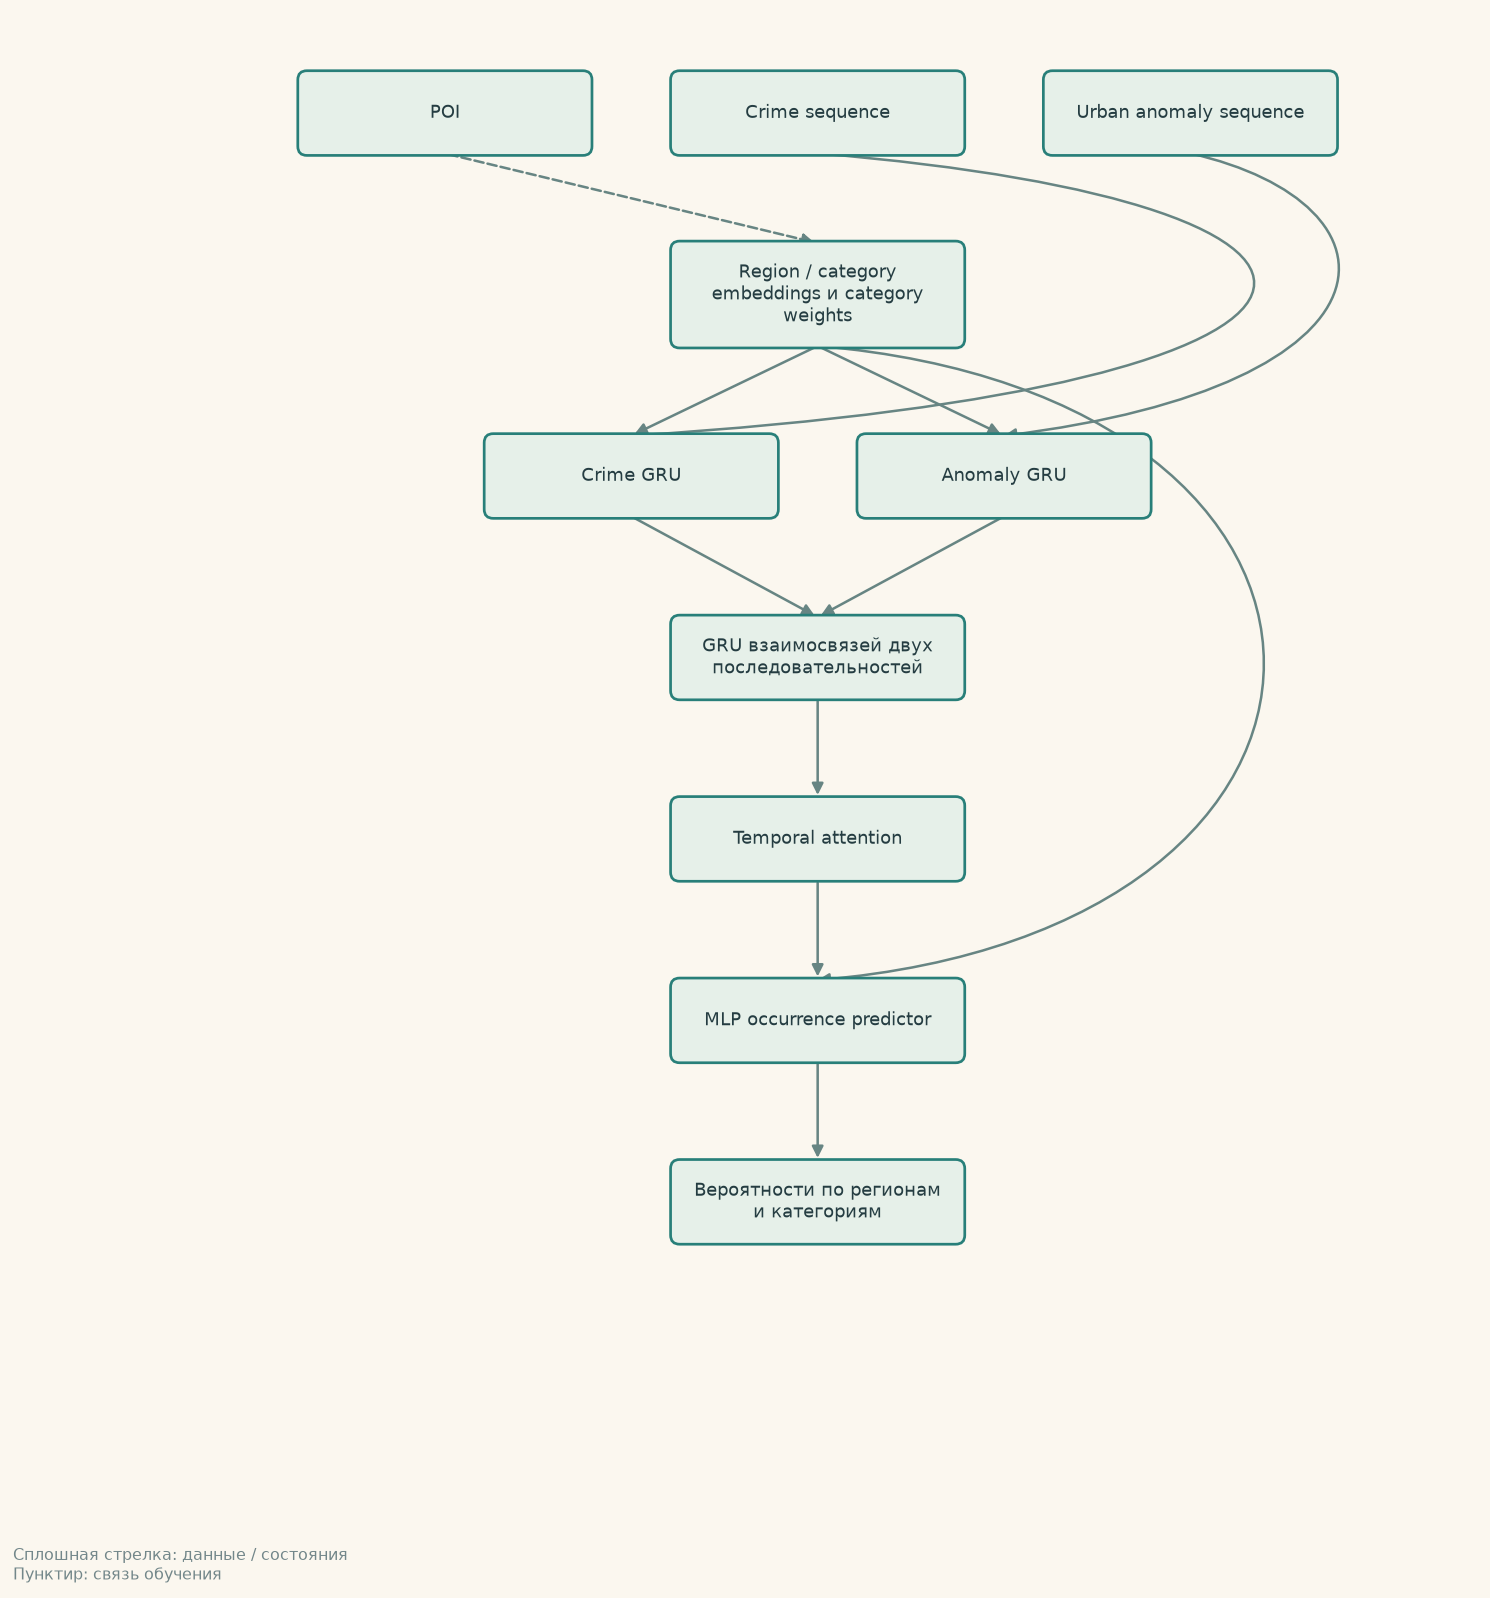
Наша адаптация. Наш crime-only вариант не получает 311/urban anomaly последовательность и не воспроизводит весь набор внешних источников авторов; выход — next-day counts.
HAFusion
Источник: Sun_et_al_2024_HAFusion_Urban_Region_Representation_Learning_with_Attentive_Fusion, §IV.A–B, §V: HALearning, ViewFusion, RegionFusion.
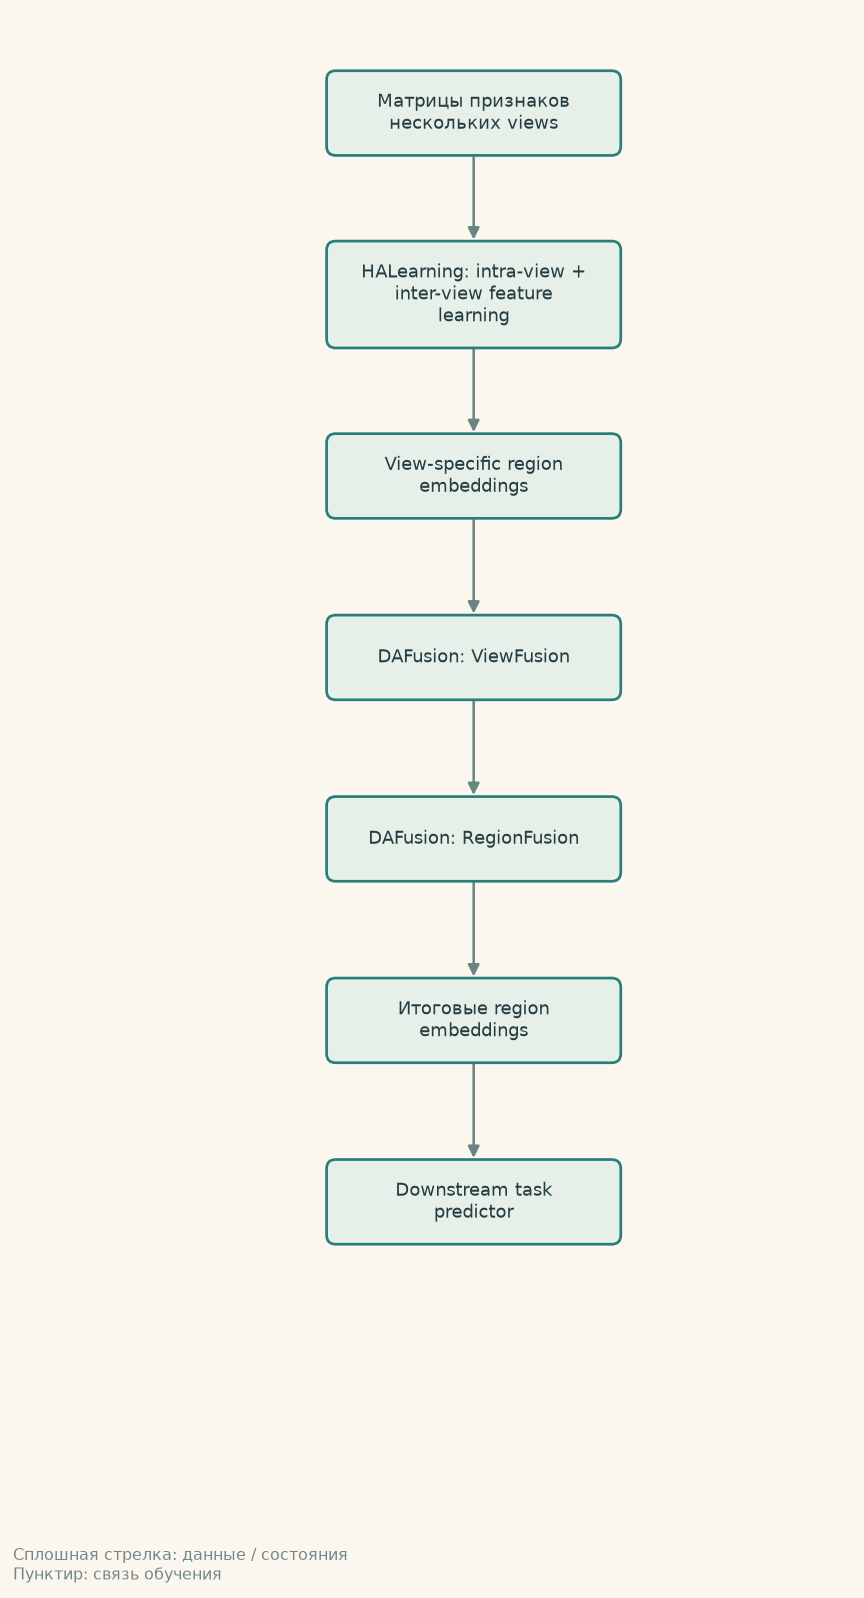
Наша адаптация. Мы используем доступные POI/OD views и замороженный контекст с downstream GRU. GRU — наш прогнозатор, не обязательная часть авторского HAFusion.
AutoST
Источник: Zhang_et_al_2023_AutoST_Automated_Spatio-Temporal_Graph_Contrastive_Learning, Метод: heterogeneous region graph, parameterized view generator, contrastive learning.
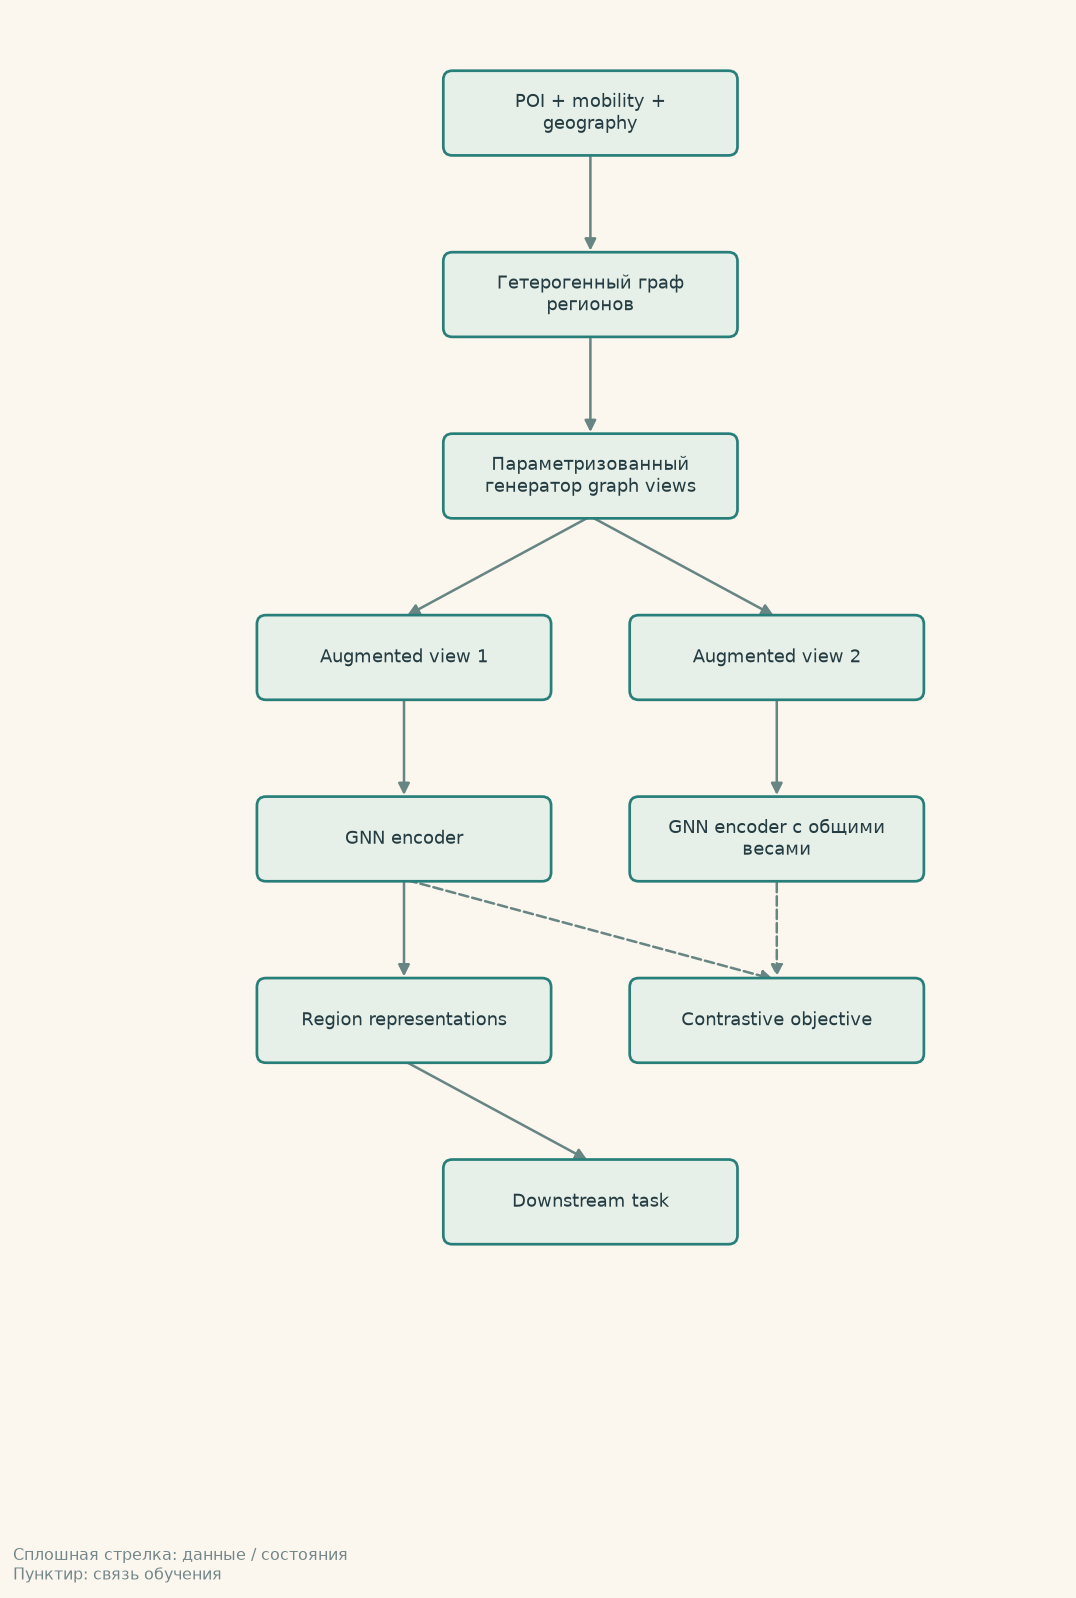
Наша адаптация. Наш day-адаптер ограничен имеющимися POI/mobility и использует общий downstream GRU; fixed/learned/no-contrast — отдельные абляции. Схема не утверждает полное воспроизведение автора.
GraphST
Источник: Spatial_Temporal_Graph_Learning_with_Adversarial_Contrastive_Adaptation, Метод: adversarial graph augmentation, hard samples, cross-view contrastive learning.
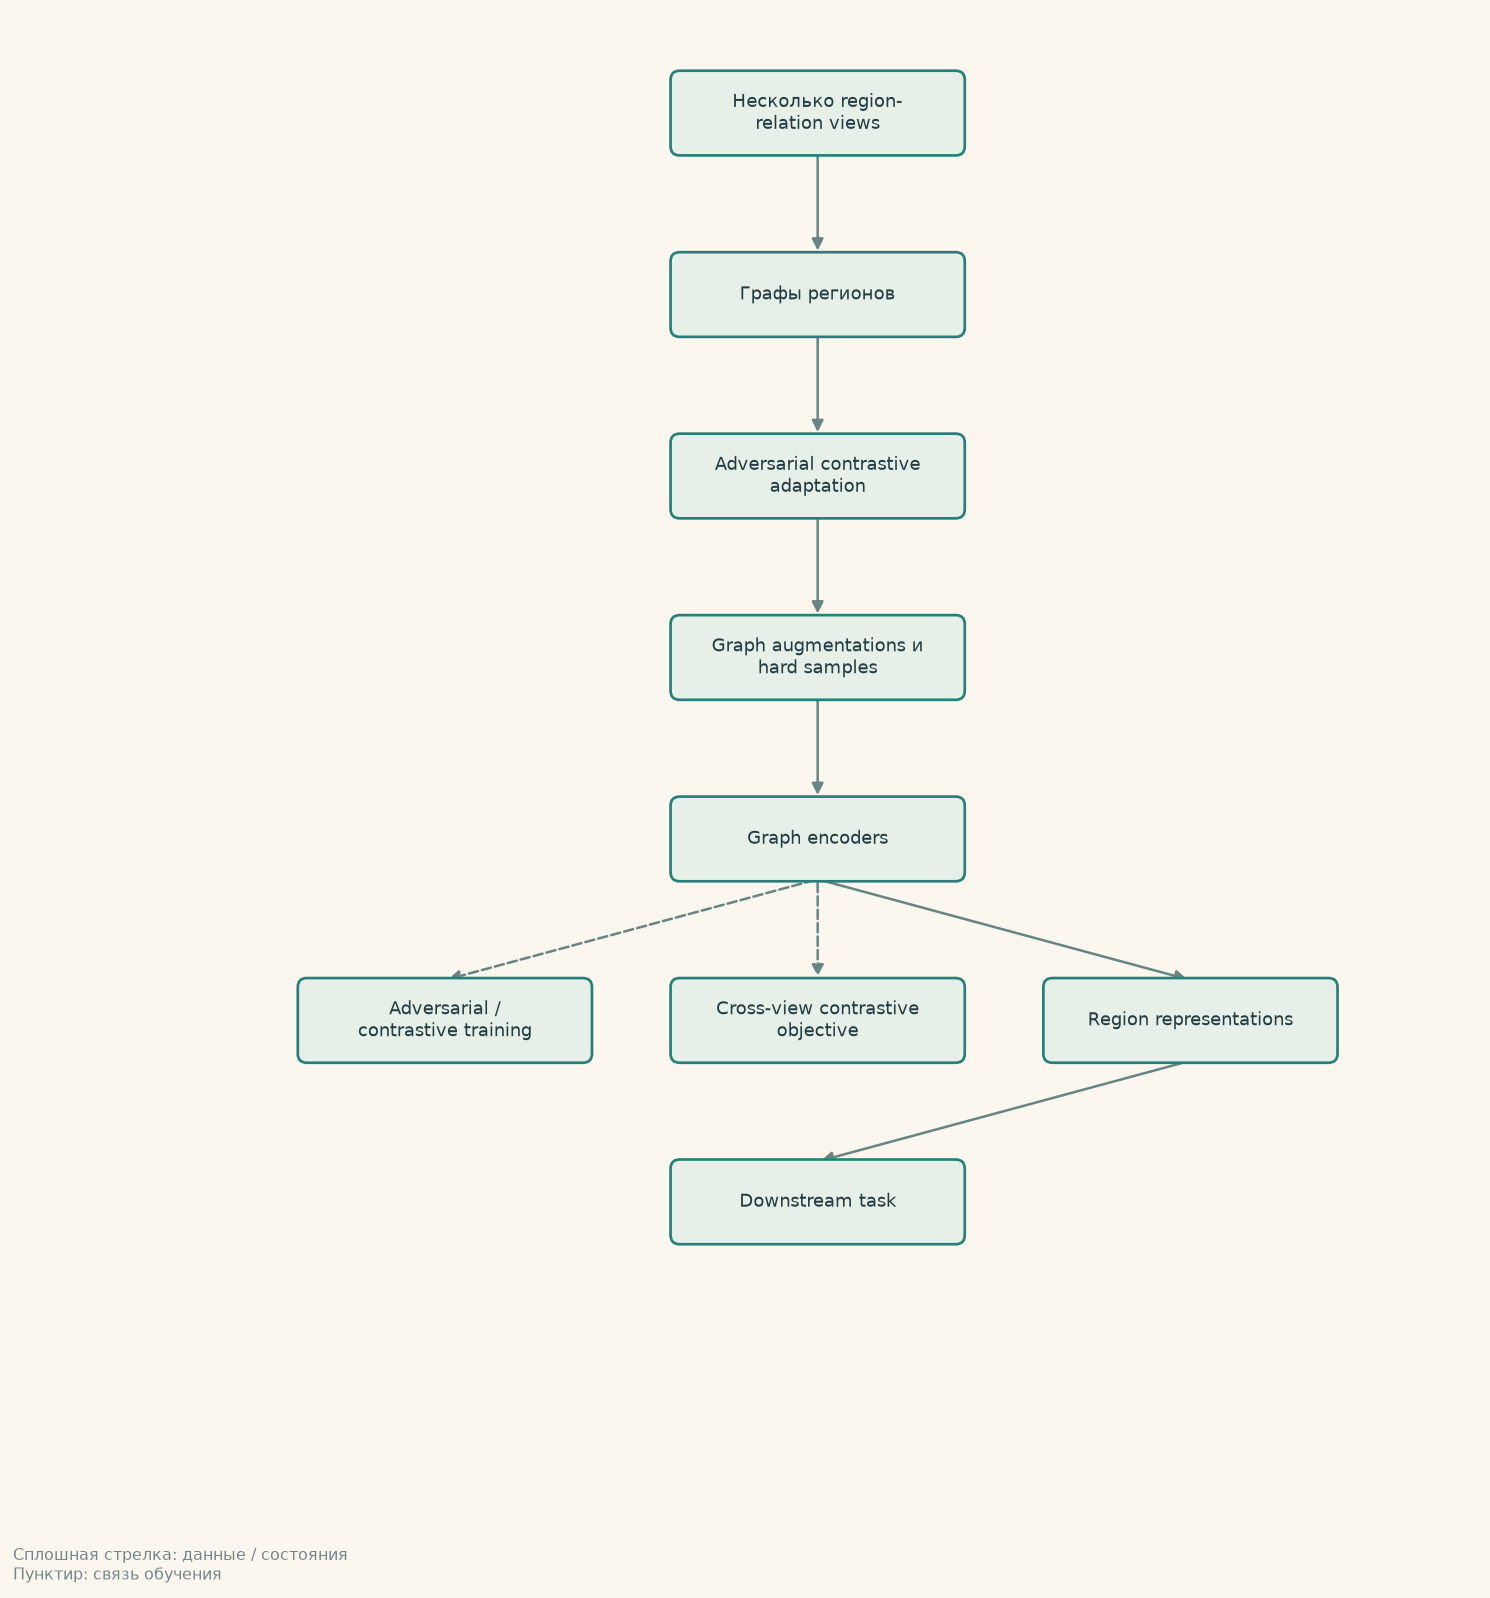
Наша адаптация. Наша дневная адаптация использует frozen context + общий GRU. full/no-adv/no-cross являются проверками выбранных механизмов в этом ограниченном адаптере.
CooKIE
Источник: Namgung_et_al_2025_Less_is_More_Multimodal_Region_Representation_via_Pairwise_Inter-view_Learning, §2: modality encoders, intra-view pretraining, pairwise inter-view information factorization.
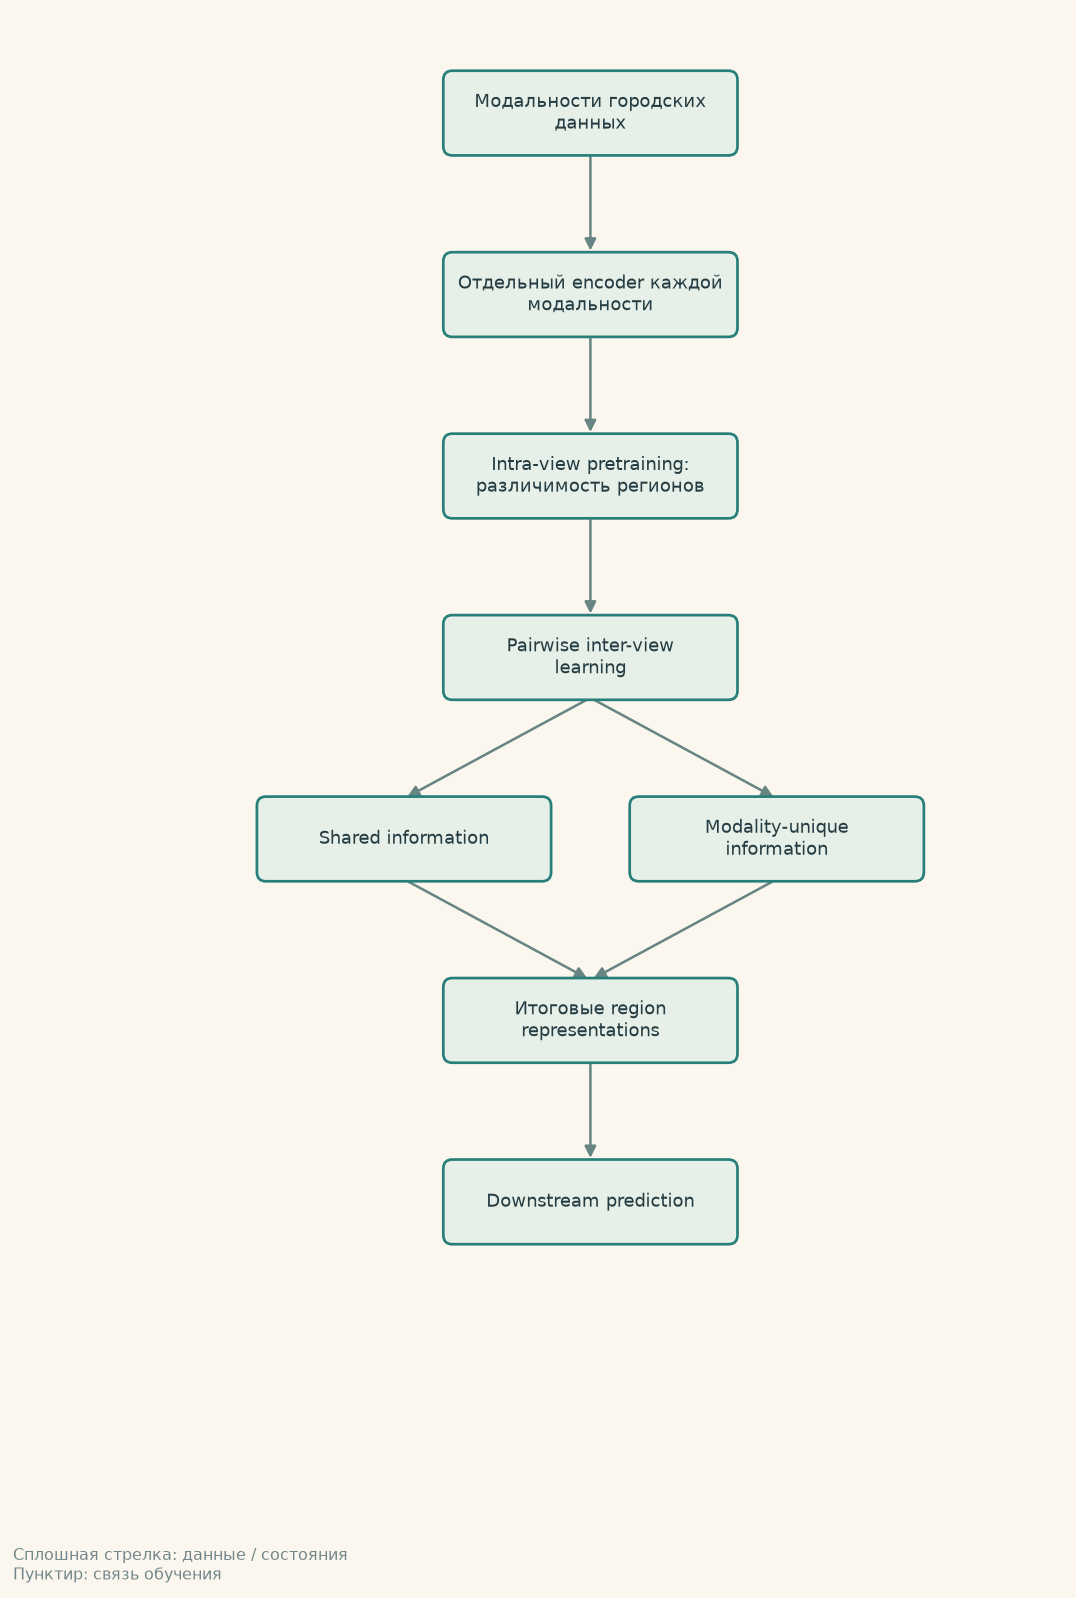
Наша адаптация. В нашей pairwise-модели используются доступные POI/mobility views и общий downstream GRU. Не следует считать её точной реализацией всех авторских MI-оценок и модальностей.