У нас около 570 UI-тестов на XCUITest. Как-то в команде спросили: а насколько они вообще покрывают приложение? Имелись в виду не строки кода. Хотелось понять, задевают ли тесты каждый элемент на каждом экране.
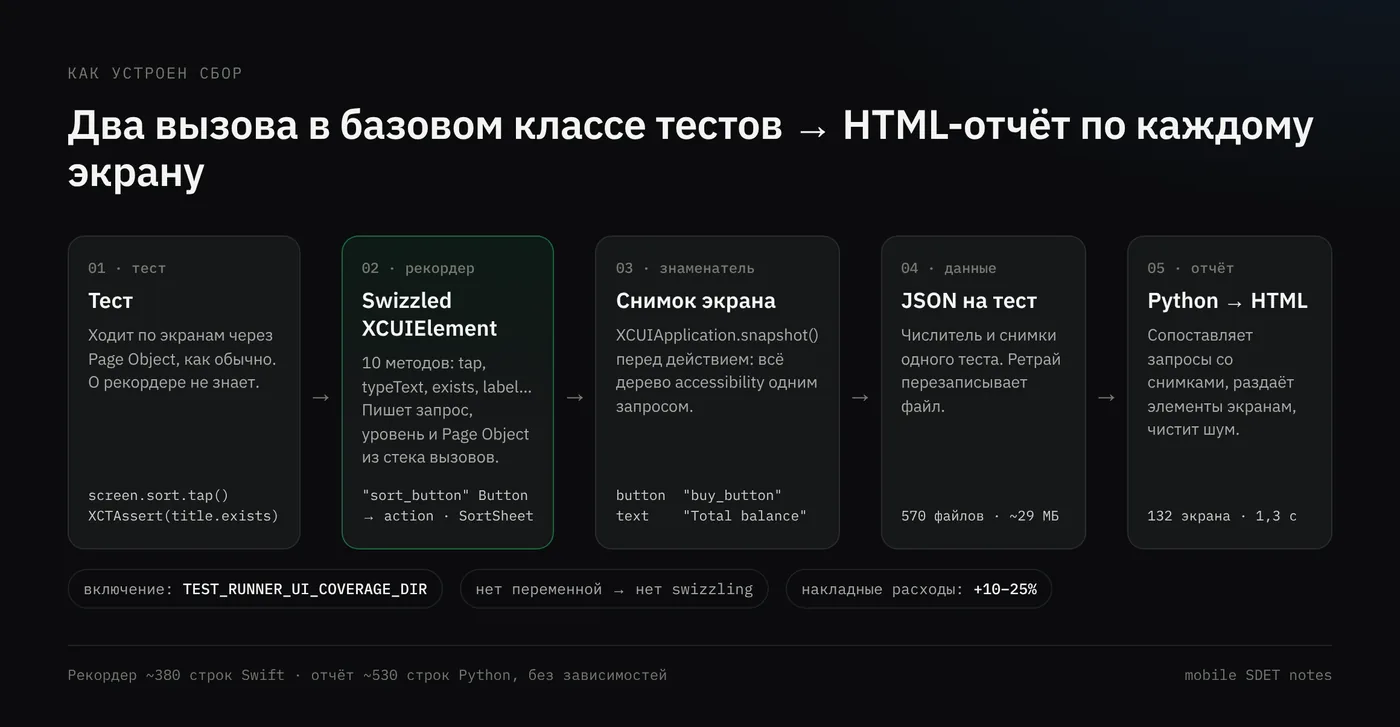
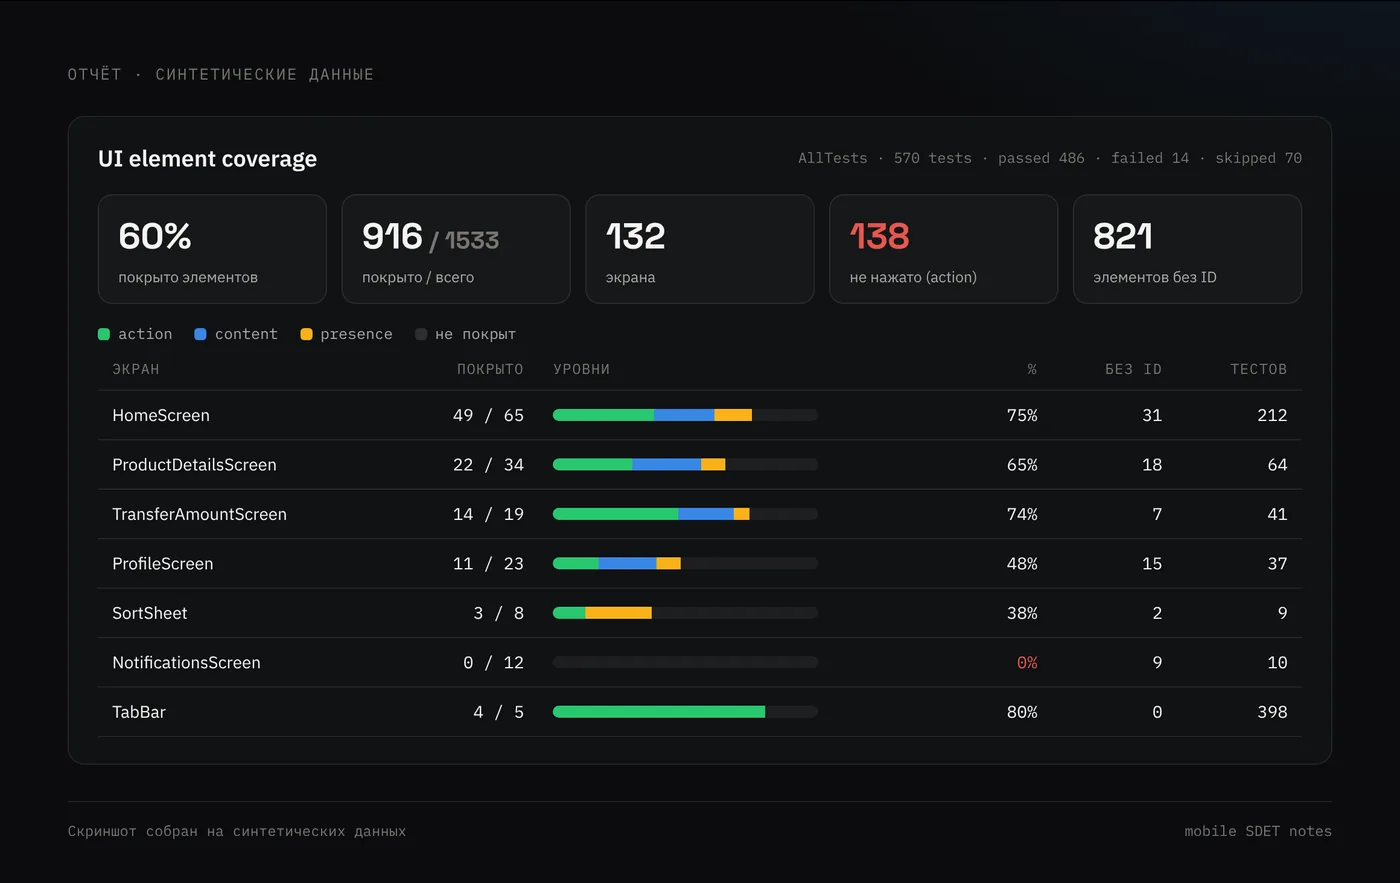
Готового способа это посчитать я не нашёл, поэтому собрал свой инструмент. Рекордер в тестовом таргете (около 380 строк Swift и две строки в базовом классе тестов) записывает, к каким элементам обращаются тесты и как именно. Скрипт на Python сопоставляет это с реальной иерархией экранов и строит HTML-отчёт. Первый полный прогон: 60% элементов задевает хотя бы один тест, 138 кнопок, переключателей и ссылок не нажимает ни один.
В этой части расскажу, как устроен сбор, почему инструмент поначалу ломал тесты, которые сам же измерял, и сколько мусора пришлось вычистить, чтобы цифрам можно было верить. Как этим пользоваться и что делать с результатом — во второй части.
Почему не Code Coverage
Первое, что предложили в команде: включить Code Coverage в тест-плане и посмотреть отчёт Xcode. Для UI-тестов от него почти нет толку.
Code Coverage меряет строки кода приложения, которые выполнились за прогон. Тест открыл экран, отработали body, viewDidLoad и вёрстка, и все строки экрана стали «покрытыми». При этом тест мог не нажать ни одной кнопки. Обработчик кнопки, которую тест не вызвал, останется непокрытым, но связать «строка 142 во ViewModel» с «кнопка X на экране Y» вручную очень дорого, а для SwiftUI-вёрстки ещё и неочевидно. Плюс шум от общего кода: сетевой слой, DI и аналитика выполняются в любом тесте.
Code Coverage отвечает на вопрос «какой код выполнился». Нам нужно было знать, что тест сделал с интерфейсом.
Рассматривали три варианта:
Подход | Что даёт | Почему не подошёл |
|---|---|---|
Статический анализ Page Object | какие элементы описаны в PO и используются в тестах | знаменатель — то, что описал автор PO, а не то, что реально есть на экране |
Логирование в приложении | реальные нажатия | правки в продакшен-коде, и знаменатель всё равно нужен отдельно |
Сбор в рантайме теста | обращения тестов + реальная иерархия экрана | нужно много бороться с шумом |
Выбрали третий: перехватывать обращения тестов к элементам (числитель) и снимать реальную иерархию экрана (знаменатель).
Сам инструмент я собрал с помощью ИИ за пару дней, ещё день ушёл на обкатку и докрутку правил. Уточнять его приходится до сих пор, и дальше будет видно почему.
Что считаем
Прежде чем писать код, пришлось договориться об определениях.
Элемент — узел дерева accessibility, который что-то значит для пользователя: кнопка, текст, поле ввода, переключатель, ссылка, ячейка или картинка с ID.
Экран — Page Object. В нашем фреймворке каждый экран описан классом PO, и это естественная единица.
Покрыт — хотя бы один тест обратился к элементу.
Покрытие экрана — покрытые элементы экрана, делённые на все элементы, которые на нём увидели за прогон. Общее покрытие считается как сумма покрытых по всем экранам, делённая на сумму всех, а не как среднее процентов.
Три уровня обращения
Делить на «покрыт» и «не покрыт» оказалось мало. Тест, который проверил exists, и тест, который нажал кнопку, проверяют разное. Поэтому у каждого обращения есть уровень:
Уровень | Вызовы | Что значит |
|---|---|---|
action |
| с элементом взаимодействовали |
content |
| проверили содержимое или состояние |
presence |
| проверили только наличие |
Элементу засчитывается лучший уровень из всех обращений: action выше content, content выше presence. В отчёте у каждого экрана полоска с долями уровней.
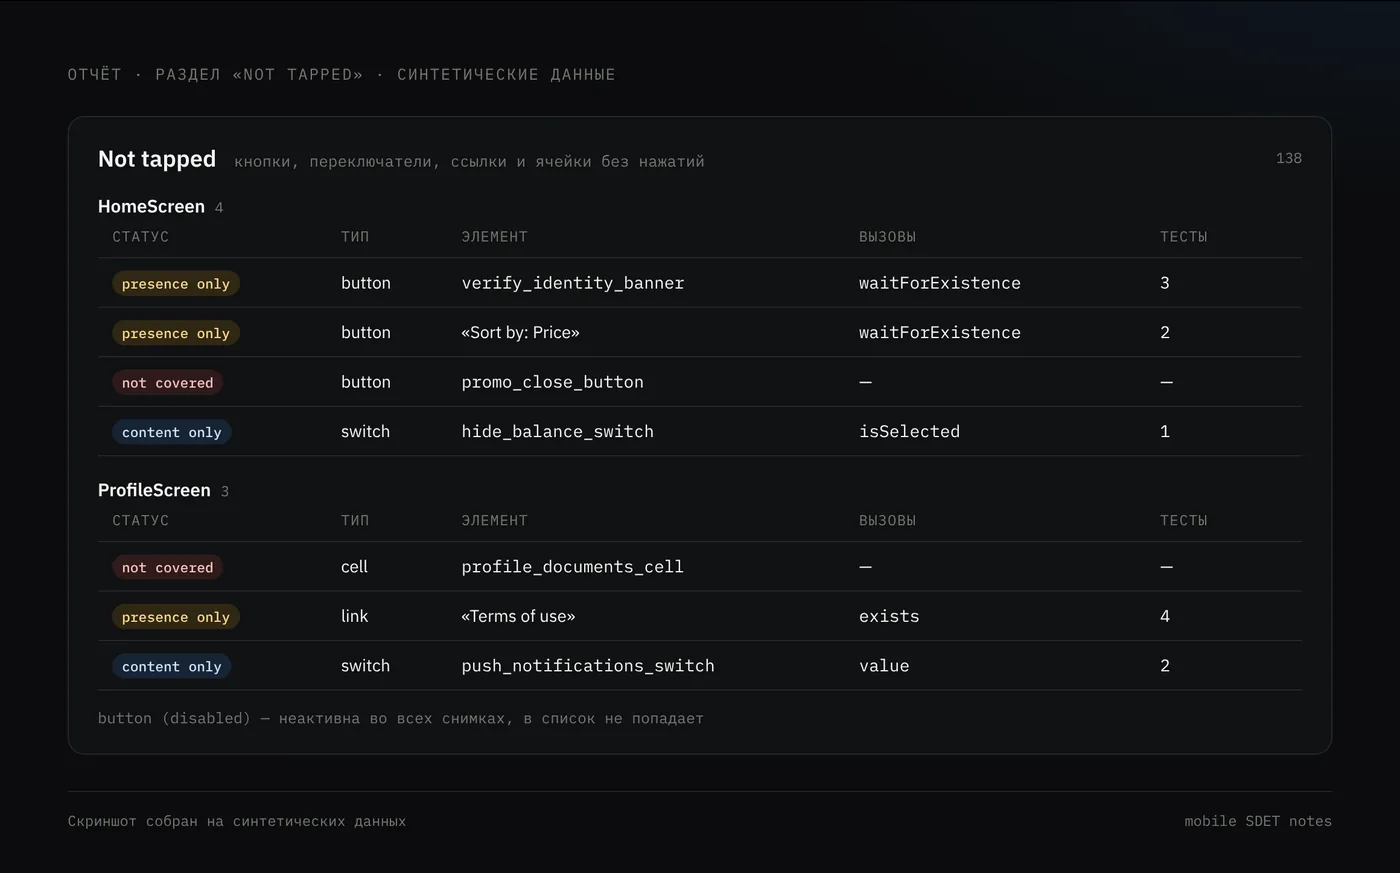
Позже стало понятно, что полоска не отвечает на главный вопрос «какие кнопки никто не нажимал». Экран из одного текста никогда не наберёт action, и это нормально. Поэтому в отчёте появился отдельный раздел «Not tapped»: кнопки, переключатели, ссылки и ячейки, у которых нет обращений уровня action.
Что не входит в знаменатель
Если считать всё подряд, процент тонет в мусоре. Поэтому в знаменатель не попадают:
контейнеры, внутри которых есть другие элементы;
текст внутри кнопки: без ID он дублирует саму кнопку, а если у кнопки есть свой ID, то текст тем более лишний;
динамические тексты без ID с цифрами: цены, проценты, даты;
системные элементы: клавиатура, меню редактирования, «ручка» у шторки;
тот же экран на другом языке;
технические «экраны»: обработчик системных алертов и вызовы, которые не удалось ни к чему привязать.
Таб-бар виден почти на каждом снимке. Если раздавать его элементы экранам, он размажется по всему отчёту, так что у него свой бакет. Это единственный общий компонент, вынесенный отдельно.
Рекордер
Рекордер живёт в тестовом таргете и подключается двумя вызовами в базовом классе тестов:
override func setUpWithError() throws {
    // ... запуск приложения
    UICoverageRecorder.shared.startTest(app: app)
}

override func tearDownWithError() throws {
    let status = testRun?.hasBeenSkipped == true ? "skipped"
        : (testRun?.totalFailureCount ?? 0) == 0 ? "passed" : "failed"
    UICoverageRecorder.shared.finishTest(name: name, status: status)
    // ... остальное
}
Уточню на всякий случай: tearDownWithError выполняется после каждого теста, а не только при ошибке. Из-за названия метода в команде думали иначе.
Включение через переменную окружения
private let outputDirectory = ProcessInfo.processInfo.environment["UI_COVERAGE_DIR"]
private var isEnabled: Bool { outputDirectory != nil }
xcodebuild пробрасывает в тест-раннер переменные с префиксом TEST_RUNNER_ и срезает префикс. Передаём TEST_RUNNER_UI_COVERAGE_DIR=/path/json, а в раннере видим UI_COVERAGE_DIR. Тест-план, схему и launch arguments трогать не нужно.
Если переменной нет, swizzling не выполняется вообще, а каждый метод рекордера начинается с guard isEnabled else { return }. Обычные прогоны о рекордере не знают.
Перехват XCUIElement
Обращения тестов перехватываются через method swizzling у XCUIElement. Методов десять:
let pairs: [(String, String)] = [
    ("tap", "coverage_tap"),
    ("typeText:", "coverage_typeText:"),
    ("pressForDuration:", "coverage_pressForDuration:"),
    ("waitForExistenceWithTimeout:", "coverage_waitForExistenceWithTimeout:"),
    ("exists", "coverage_exists"),
    ("isHittable", "coverage_isHittable"),
    ("label", "coverage_label"),
    ("value", "coverage_value"),
    ("isEnabled", "coverage_isEnabled"),
    ("isSelected", "coverage_isSelected")
]
for (original, swizzled) in pairs {
    guard let o = class_getInstanceMethod(XCUIElement.self, NSSelectorFromString(original)),
          let s = class_getInstanceMethod(XCUIElement.self, NSSelectorFromString(swizzled)) else { continue }
    method_exchangeImplementations(o, s)
}
После обмена реализаций вызов coverage_tap() внутри подменённого метода уходит в оригинальный tap:
extension XCUIElement {
    @objc fileprivate func coverage_tap() {
        UICoverageRecorder.shared.willAct(on: self)   // снимок ДО действия
        coverage_tap()                                // оригинальный tap
        UICoverageRecorder.shared.record(self, kind: .action, call: "tap")
    }

    @objc(coverage_waitForExistenceWithTimeout:)
    fileprivate func coverage_waitForExistence(timeout: TimeInterval) -> Bool {
        let result = coverage_waitForExistence(timeout: timeout)
        if result { UICoverageRecorder.shared.record(self, kind: .presence, call: "waitForExistence") }
        return result
    }
}
Без граблей не обошлось.
Селектор #selector(XCUIElement.tap) становится неоднозначным, если в проекте есть свои расширения с методом tap(...). Поэтому селекторы заданы строками. У методов с аргументами нужно явно указывать ObjC-имя, например @objc(coverage_pressForDuration:). Иначе Swift сгенерирует coverage_pressWithForDuration:, обмен не найдёт метод и молча его пропустит.
Проверки записываются только при успехе. exists == false не значит, что тест «трогал» элемент: типичный случай — XCTAssertFalse(button.exists). Решение спорное, о нём ещё будет в ограничениях.
XCUIApplication тоже наследник XCUIElement, поэтому вызовы вроде app.tap() и app.exists пропускаются. На время записи выставляется флаг, чтобы вложенные вызовы внутри рекордера не попадали в данные.
Что записывается в числитель
Записывается только element.description:
"eye_button" Button (First Match)
"Gainers" Button
Button, {{0.0, 0.0}, {...}}   ← запросы по индексу или предикату, их потом не сопоставить
Настоящие свойства элемента рекордер не читает. description строится из запроса (query), а не из найденного элемента, и не требует обращения к приложению. Любое чтение identifier, label или frame — это синхронный запрос к приложению. Он тормозит тест и, что хуже, сдвигает его тайминг. Расплачиваться за это приходится в отчёте: там строку запроса нужно сопоставить с элементом из снимка.
Записи дедуплицируются по ключу «экран | уровень | вызов | запрос». Тест, который пятьдесят раз ждёт один и тот же элемент, даёт одну запись.
К какому экрану относится вызов
Дальше нужно понять, из какого Page Object пришёл вызов tap(). Это видно по стеку вызовов:
private func currentScreen() -> String {
    var fallback: String?
    for symbol in Thread.callStackSymbols.dropFirst(3) {
        guard let typeName = uiTestsTypeName(in: symbol), typeName != "UICoverageRecorder" else { continue }
        if let cls = NSClassFromString("UITests.\(typeName)") {
            if cls is XCTestCase.Type { break }   // дошли до самого теста, дальше искать нечего
            return typeName                       // первый класс из модуля тестов и есть Page Object
        }
        if fallback == nil { fallback = typeName } // протокол или структура: общий компонент
    }
    return fallback ?? "Unknown"
}
Символы в стеке манглированы, например $s7UITests15DashboardScreenC.... Демэнглить их можно через swift_demangle, который достаётся из рантайма через dlsym(RTLD_DEFAULT, "swift_demangle"). Символ приватный, но стабильный. Из результата вида closure #1 in UITests.DashboardScreen.tapOnSort() -> ... регулярка ^UITests\.([A-Za-z0-9_]+)\. вытаскивает имя типа.
Отдельно пришлось повозиться с расширениями протоколов. Их методы демэнглятся как closure #1 in (extension in UITests):UITests.Sorting.selectOption(...). Наивное разбиение строки по " in " режет её посреди (extension in UITests), и все такие вызовы уезжали в Unknown. Маркер расширения теперь вырезается заранее.
Класс это или нет, проверяет NSClassFromString: хелперы-протоколы и компоненты-структуры классами не являются. Вызовы из них и из самого теста приписываются последнему Page Object, к которому были обращения. Исключение — таб-бар, у него свой бакет. Результаты демэнгла кэшируются: стек снимается на каждый перехваченный вызов, и без кэша это заметно. С кэшем на фоне самих запросов XCUITest разницы не видно.
Снимки иерархии
Знаменатель берётся из XCUIApplication.snapshot(): полное дерево элементов одним запросом. При обходе дерева рекордер:
пропускает поддерево клавиатуры;
берёт только элементы ненулевого размера;
для типов с текстом (кнопка, текст, поле, переключатель, ссылка) берёт элементы с ID или с label;
картинки, ячейки и прочие контейнеры берёт только с ID;
записывает тип, identifier, label (обрезанный до 80 символов), ближайшего предка с ID и
enabled: false, если элемент неактивен;складывает элементы таб-бара в отдельный список.
К снимку прикладывается подсказка candidate — последний Page Object, к которому были обращения. Это именно подсказка: окончательное решение, какому экрану принадлежит снимок, принимает отчёт.
Результат — один JSON на тест в директории из переменной окружения. При ретрае файл перезаписывается, остаётся последняя попытка.
Как инструмент ломал тесты, которые измерял
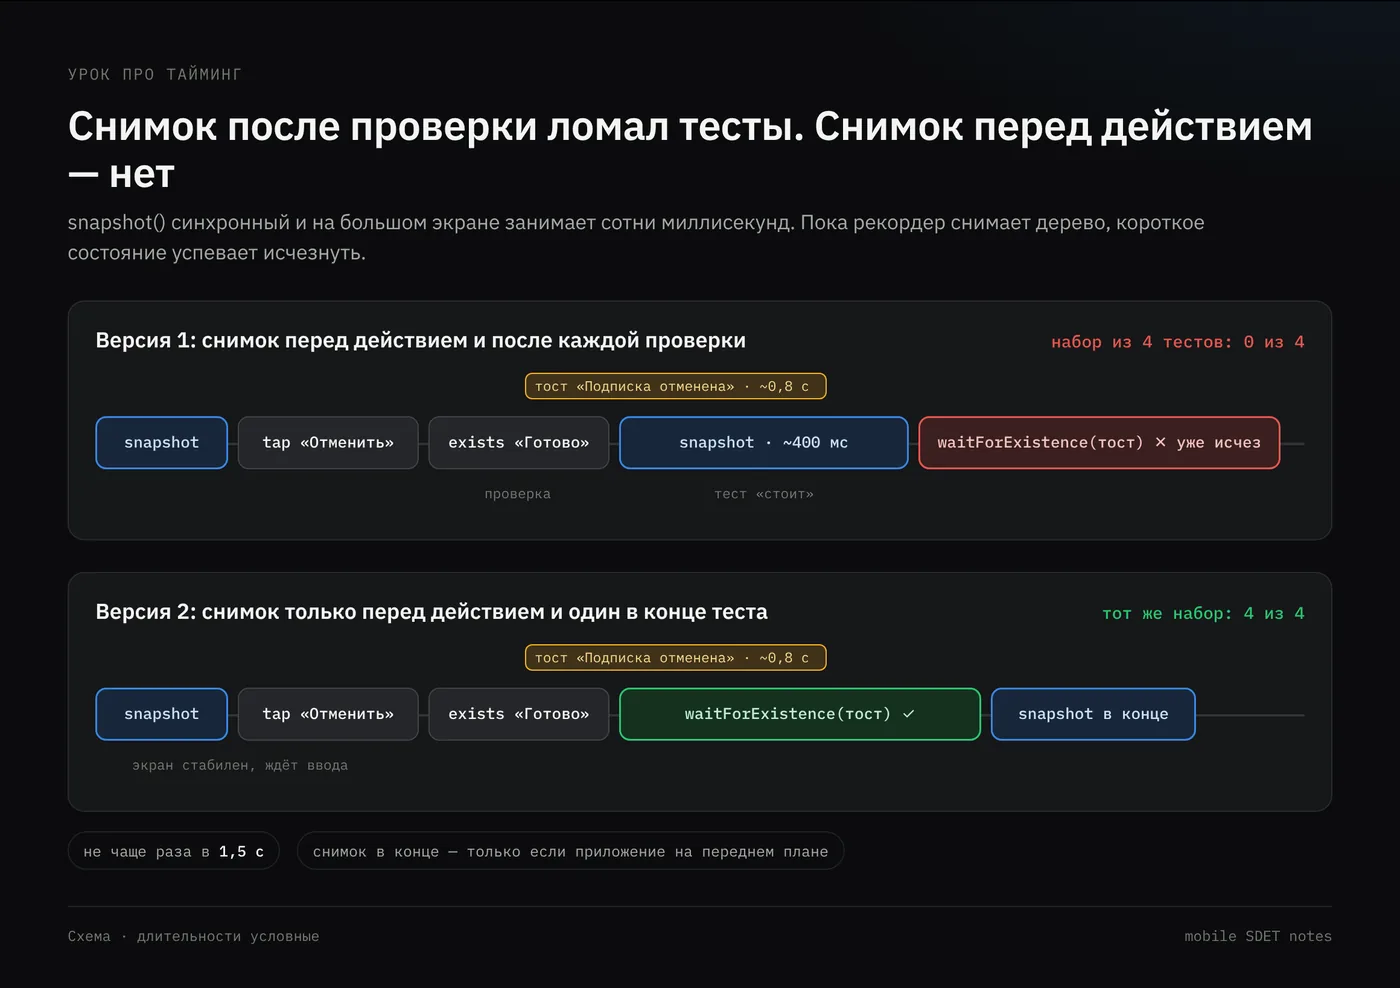
В первой версии снимок иерархии делался перед каждым действием и после каждой проверки. На полном прогоне сразу полезли новые падения. Нагляднее всего это было на наборе из четырёх тестов отмены подписки: со сбором покрытия падали все четыре, без сбора все четыре проходили.
Причина в том, что snapshot() синхронный и тяжёлый: на большом экране это сотни миллисекунд. Снимок после проверки сдвигал следующий шаг теста, и короткие состояния — кнопка в состоянии загрузки, тост — успевали исчезнуть, пока рекордер снимал дерево.
Во второй версии правила такие:
снимок делается только перед действием: экран в этот момент стабилен и ждёт ввода, задержка ничего не меняет;
плюс один снимок в конце теста, потому что последний экран мог быть только с проверками;
не чаще одного снимка в 1,5 секунды;
снимок в конце делается, только если приложение на переднем плане.
После этого все четыре теста прошли и со сбором. Накладные расходы на весь прогон — от 10 до 25% времени, поэтому сбор живёт в отдельной джобе, а не в обычных прогонах.
Вывод я для себя сделал такой: инструмент измерения не должен влиять на то, что меряет, а любой синхронный запрос к приложению после проверки может сделать тест флаки.
Отчёт
Отчёт собирает один скрипт на Python 3.9 без внешних зависимостей, около 530 строк. Python выбрал, потому что он есть на любом CI-маке, а правила против шума на нём быстро менять.
load JSON
  → merge_linked_text            (слова текста со ссылками → один элемент)
  → build_index                  (поиск элемента по ID и label)
  → для каждого теста:
       add_touched               (запросы → элементы, по экранам)
       add_snapshot              (снимок → экран, считаем, сколько раз элемент видели)
  → assign_ownership             (каждый элемент принадлежит одному экрану)
  → drop_duplicates_and_containers
  → mark_disabled                (неактивные во всех снимках)
  → summarise → render HTML
Сопоставление запроса с элементом
Запрос "Gainers" Button означает «кнопка, у которой identifier или label равен Gainers». Его нужно найти среди элементов из снимков:
QUERY = re.compile(r'^"(?P<value>.*)" (?P<type>[A-Za-z]+)')

def resolve(element_type, value, indexes):
    value = normalise_id(value)
    for by_id, by_label in indexes:          # сначала снимки этого теста, потом все
        found = by_id.get((element_type, value)) or by_label.get((element_type, value))
        if found:
            return found
    # не нашли: угадываем, ID это или текст
    looks_like_id = re.fullmatch(r"[A-Za-z0-9_./-]+", value) and re.search(r"[_./]|[a-z][A-Z]", value)
    return {"type": element_type, "identifier": value if looks_like_id else "",
            "label": "" if looks_like_id else value}
Первая версия перебирала все элементы всех снимков на каждый запрос. На полном прогоне это около 4100 снимков, и отчёт собирался больше двух минут. Словари по ключам (тип, id) и (тип, label) сократили это до 1,3 секунды.
Второй уровень индекса появился после коллизии. Тест проверял чип фильтра с текстом «All» на главном экране. На другом экране нашлась кнопка с identifier «All». Глобальный поиск по ID находил её, и чип оставался «не покрытым». Теперь сначала ищем среди элементов из снимков того же теста и только потом глобально.
Запросы по индексу или предикату (buttons.element(boundBy: 2)) не парсятся. Они попадают в список unresolved под экраном и в процент не входят.
Ключ элемента
def element_key(element):
    identifier = normalise_id(element.get("identifier", ""))
    if identifier:
        return f'{element["type"]}|{identifier}'
    return f'{element["type"]}|label:{normalise_label(element.get("label", ""))}'
Без нормализации ничего не работало с первого же прогона. Динамические ID схлопываются по шаблонам: item_0 и item_1 превращаются в item_{n}, строки списка с ID вида {name}Row — в один элемент, а не в столько, сколько продуктов в списке.
С label сложнее. iOS склеивает label дочерних элементов через запятую, и строка профиля выглядит как «Customer ID, 123456789». Берём часть до ", " и заменяем цифры на {n}, иначе каждый тестовый пользователь даёт новый элемент. Для текстов с данными в середине есть label-шаблоны: строка списка «Product A, €1,240.50» превращается в «{name}, {price}».
Какому экрану отдать снимок
На подсказку candidate из рекордера полагаться нельзя. Снимок перед действием на шторке делается в момент, когда последним Page Object ещё мог быть экран под ней. Поэтому владелец снимка определяется по содержимому:
def add_snapshot(snapshot, touched_keys, screens):
    keys = {element_key(e) for e in snapshot["elements"]}
    candidate = snapshot.get("candidate", "")
    # какая доля элементов, тронутых этим PO в тесте, есть в снимке
    scores = {screen: len(k & keys) / len(k)
              for screen, k in touched_keys.items() if k and screen != TAB_BAR}
    ranked = sorted(scores.items(), key=lambda item: (-item[1], item[0] != candidate))
    owner = ranked[0][0] if ranked and ranked[0][1] > 0 else (candidate or None)
    ...
Снимок достаётся Page Object, у которого наибольшая доля тронутых в этом тесте элементов присутствует в снимке. При равенстве побеждает candidate.
Кому принадлежит элемент
На этом держится вся модель, и с первого раза у меня ничего не вышло.
Шторка показывается поверх экрана, и в её снимке есть все элементы экрана под ней. Если считать «элемент есть в снимке экрана X — значит, это элемент X», шторка сортировки забирает себе весь главный экран.
Первая попытка: у шторки есть «хост-экран», вычитаем его элементы. Хосты назначались эвристикой и нашлись только у 27 бакетов из 108, причём иногда взаимно: A хост для B, а B хост для A. Главный экран схлопнулся с 54 элементов до 11.
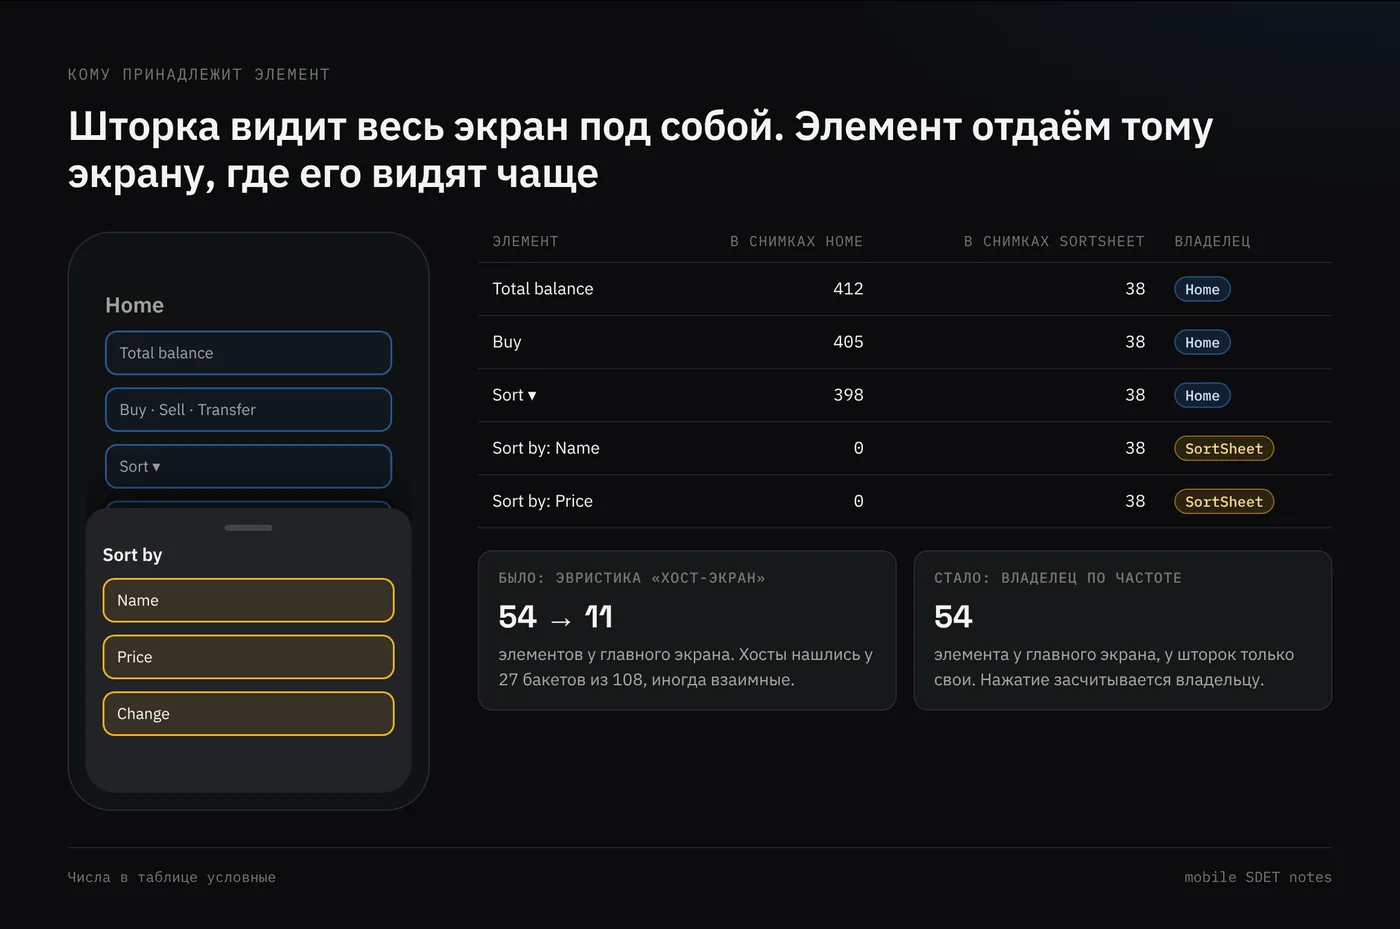
В итоге сработало решение попроще: элемент принадлежит экрану, в снимках которого он встречается чаще всего. Элементы главного экрана видны в сотнях его собственных снимков и в десятках снимков шторок, поэтому остаются у него. Тронутый элемент засчитывается экрану-владельцу, каким бы Page Object его ни тронули.
def assign_ownership(screens):
    owners = {}
    for name, bucket in screens.items():
        for key, seen in bucket["seen"].items():
            best = owners.get(key)
            touched_here = key in bucket["touched"]
            if best is None or (seen, touched_here) > (best[1], best[2]):
                owners[key] = (name, seen, touched_here)
    # дальше элементы раскладываются по владельцам, тронутые переезжают к владельцу
После этого у главного экрана снова 54 элемента, у одного из экранов, который раньше оставался пустым, появился ненулевой знаменатель, а шторки содержат только свои элементы.
Неактивные кнопки
Строки профиля «Customer ID», «Email», «Name» в отчёте выглядели как ненажатые кнопки. В приложении это SwiftUI Button с .disabled(...): accessibility отдаёт тип Button, но isEnabled == false.
Рекордер пишет enabled: false прямо из снимка, без дополнительных запросов. Отчёт считает кнопку некликабельной, только если она неактивна во всех снимках. Кнопка «Continue», неактивная до ввода данных, хотя бы в одном снимке была активной и остаётся обычной кнопкой. Некликабельные кнопки не попадают в «Not tapped», а в таблице помечены как button (disabled). Из знаменателя их не убираем: это видимый контент, и проверка их текста засчитывается.
Что в итоге видно в отчёте
Отчёт — одна HTML-страница без внешних зависимостей, её удобно класть в артефакты CI. Наверху общий процент, число покрытых и всех элементов, число экранов и элементов без ID, счётчики passed, failed и skipped. Ниже таблица экранов с полоской уровней.
Отдельный раздел «Not tapped» по экранам: у каждого элемента статус not covered, presence only или content only. Ещё ниже списки упавших тестов (покрытие занижено, тест не дошёл до конца) и пропущенных, а по каждому экрану таблица: статус, тип, элемент, какими вызовами и в каких тестах к нему обращались.
Все скриншоты в статье собраны на синтетических данных.
Каталог шума
Первый отчёт был честным, но пользы от него было мало: половина «непокрытого» оказалась шумом. Каждое правило ниже появилось после того, как в отчёте всплывало что-то странное.
Что видели | Почему | Правило | Риск правила |
|---|---|---|---|
Кнопки на другом языке «не покрыты» | тест переключения языка снял тот же экран в другой локализации | элемент без ID, чей текст есть только в неанглийских | случайное совпадение текста с переводом; элементы с ID не трогаем |
На экране создания пароля кнопки «I», «have», «read», «the», «&» | текст согласия с несколькими ссылками: iOS отдаёт каждое слово отдельной кнопкой без ID | 4 и больше однословных кнопок без ID с общим родителем, из них 2 и больше со строчной буквы → один элемент «текст со ссылками» | без условия про строчные склеились бы чипы фильтра «All», «New», «Popular» |
Десятки одинаковых чекбоксов и строк с ценой | повтор одного элемента с разными данными | label-шаблоны: | шаблоны пишутся руками |
Новый элемент на каждого тестового пользователя | данные пользователя в label | берём часть до | — |
Return, Emoji, Cut, Copy, Paste, Look Up | клавиатура и меню редактирования | список системных подписей, только для элементов без ID | у кнопки приложения «Copy» обычно есть ID |
Строки профиля как ненажатые кнопки |
| некликабельна, если неактивна во всех снимках | — |
Чип «All» не покрыт | коллизия ID и label с другим экраном | индекс сначала по снимкам этого теста | — |
Шторка забирает весь экран под собой | оверлей | владение по частоте появления | — |
Одну проблему я сознательно не стал лечить в отчёте. Варианты сортировки получали статус presence only, хотя тест их выбирает. Оказалось, тест ждёт кнопку с текстом варианта, а нажимает ближайший к ней по вертикали чекбокс. У всех шести чекбоксов один и тот же ID, отличаются они только координатами. Чинить здесь надо само приложение: вариантам нужны уникальные ID. Выходит, отчёт находит проблемы и в приложении тоже.
Эффект от фильтров на одном и том же прогоне: элементов стало 1533 вместо 1625, покрытие выросло с 56 до 60%, ненажатых кнопок осталось 138 вместо 222.
CI
Сбор живёт в отдельной джобе. Fastlane-лейн:
lane :ui_element_coverage do |params|
  # ... testplan, device, os_version, destination как в обычном лейне UI-тестов
  coverage_dir = File.join(project_root, 'ui_element_coverage')
  json_dir = File.join(coverage_dir, 'json')
  FileUtils.rm_rf(coverage_dir)
  FileUtils.mkdir_p(json_dir)

  # scope:"smoke" - только смоук, иначе весь тест-план
  only_testing = params[:scope].to_s == 'smoke' ? smoke_tests : nil

  # Включает рекордер: xcodebuild передаёт TEST_RUNNER_* в раннер без префикса
  ENV['TEST_RUNNER_UI_COVERAGE_DIR'] = json_dir

  begin
    scan(
      # ... как в обычном лейне
      output_directory: File.join(coverage_dir, 'report'),
      result_bundle: true,
      only_testing: only_testing,
      fail_build: false   # джоба меряет покрытие, а не здоровье тестов
    )
  ensure
    # отчёт собирается и при упавших тестах
    ENV.delete('TEST_RUNNER_UI_COVERAGE_DIR')
    sh("python3", "scripts/ui_element_coverage_report.py", json_dir, File.join(coverage_dir, 'report.html'))
  end
end
И джоба в GitLab, которая запускается вручную или по расписанию, но не в merge request:
ui_element_coverage:
  stage: ui_tests
  variables:
    UI_ELEMENT_COVERAGE_SCOPE: "all"   # отчёт имеет смысл только на полном прогоне
  rules:
    - if: '$CI_PIPELINE_SOURCE == "merge_request_event"'
      when: never
    - if: '$CI_PIPELINE_SOURCE == "web"'
      when: manual
    - if: '$CI_PIPELINE_SOURCE == "schedule" && $SCHEDULE_TYPE == "ui_element_coverage"'
  script:
    - bundle exec fastlane ios ui_element_coverage testplan:"AllTests" scope:"${UI_ELEMENT_COVERAGE_SCOPE}"
  after_script:
    - if [ "$CI_JOB_STATUS" == "canceled" ]; then exit 0; fi
    - ditto -c -k --sequesterRsrc --keepParent ui_element_coverage/report/App.xcresult UITests.xcresult.zip
    - ./scripts/upload_artifact.sh UITests.xcresult.zip   # во внешнее хранилище
  artifacts:
    when: always
    expire_in: 14 days
    paths:
      - ui_element_coverage/report.html
      - ui_element_coverage/json/
По дороге пришлось кое-что поправить.
Сначала по умолчанию стоял смоук. На смоуке процент почти ничего не говорит: 32% против 60% на полном прогоне. Переключили на полный тест-план.
Потом в артефакты добавили архив xcresult, он нужен для разбора падений. С видеозаписями тестов он оказался больше лимита GitLab и получил 413 Request Entity Too Large. Артефакты загружаются одним архивом, поэтому не загрузились даже отчёт и JSON. Теперь xcresult уезжает во внешнее хранилище, а в артефактах лежит ссылка. Сырые JSON на 570 тестов весят около 29 МБ, в архиве около 3 МБ, лимит им не страшен.
scan по умолчанию падает при любом упавшем тесте, и джоба покрытия краснела из-за проблем, к которым не имела отношения. Помог fail_build: false: упавшие тесты и так видны в отчёте и в xcresult.
Тесты, пропущенные через XCTSkip, сначала записывались как passed с пустыми данными. Добавили статус skipped через testRun.hasBeenSkipped.
Полный прогон на одном симуляторе идёт около 2,4 часа и укладывается в таймаут джобы. Параллельный прогон на клонах симулятора я тоже проверил в CI: файл пишется на каждый тест, общей памяти между ними нет, всё работает. Отчёт собирается чуть больше чем за секунду и на время джобы не влияет.
Результаты
Смоук | 96 тестов, 32% (325 из 1029), 99 экранов |
Полный прогон, первая версия отчёта | 570 тестов, 56% (915 из 1625), 132 экрана |
Тот же прогон после фильтров шума | 60% (916 из 1533), 138 ненажатых кнопок вместо 222 |
Снимков иерархии за прогон | около 4100 |
Накладные расходы сбора | +10–25% к времени прогона |
Сырые данные | около 29 МБ JSON, около 3 МБ в архиве |
Сборка отчёта | больше 2 минут → 1,3 секунды |
Объём кода | рекордер около 380 строк Swift, отчёт около 530 строк Python, 2 строки в базовом классе тестов |
Но интереснее цифр то, что нашлось в самом отчёте.
Семь экранов с покрытием 0%. Через один из них проходят десять тестов, и ни один ничего на нём не проверяет.
На главном экране кнопку верификации личности ждут через waitForExistence три теста. Не нажимает ни один.
Из десяти переключателей нажимается один, остальные только читаются. По кнопкам в первом отчёте картина такая: 246 с уровнем action, 14 content, 36 presence и 151 вообще без обращений.
Больше половины элементов (906 из 1625 в первом отчёте) не имеют accessibility ID. Отчёт косвенно меряет ещё и тестопригодность приложения.
А ещё отчёт неожиданно пригодился для разбора падений. По последнему снимку упавшего теста видно, где он остановился. В одном прогоне 11 падений одного раздела остановились на одном и том же экране: одна причина, а не 11 багов. Это быстрее, чем открывать 11 xcresult.
Ограничения
Знаменатель — только то, что тесты увидели. Экраны, которые ни один тест не открыл, в отчёт не попадают, и недостижимый UI так не найти. Для этого нужен статический анализ.
Отчёт не знает, делает ли кнопка что-то. Тип берётся из дерева accessibility.
Шаблоны ID и label и списки системных подписей пишутся руками.
Запросы по индексу и предикату не сопоставляются.
Проверка «элемента нет» (
exists == false) не засчитывается.Если тест нажимает соседний элемент, как в истории с чекбоксами, покрытие уходит соседу.
Swizzling опирается на детали XCTest и может сломаться при обновлении Xcode. На этот случай рекордер пишет в лог «cannot swizzle» и продолжает работу без этого метода.
swift_demangle— приватный символ рантайма.Процент легко накрутить проверками
exists, ничего не улучшив. Поэтому делать его KPI с целевым значением я бы не стал.
Что дальше
Начинал я с метрики, а в итоге получил данные вида «тест ↔ экран ↔ элемент ↔ тип обращения» по всему набору тестов. Процент покрытия — только одно их применение. Из тех же данных можно собрать бэклог недостающих проверок, найти экраны, через которые тесты проходят транзитом, отслеживать новый UI без тестов между прогонами и собирать смоук по данным, а не по интуиции.
Как этим пользоваться и зачем всё затевалось, расскажу во второй части.
А как вы отвечаете на вопрос «насколько наши UI-тесты покрывают приложение»? Меряете что-то кроме количества тестов и Code Coverage?