Комментарии 40

Очень неплохие модели. Подсунул 35B-A3B Q4 математическую головоломку, сформулированную графически, и она первой из аналогов подобного размера решила ее правильно за пару тысяч токенов рассуждений.

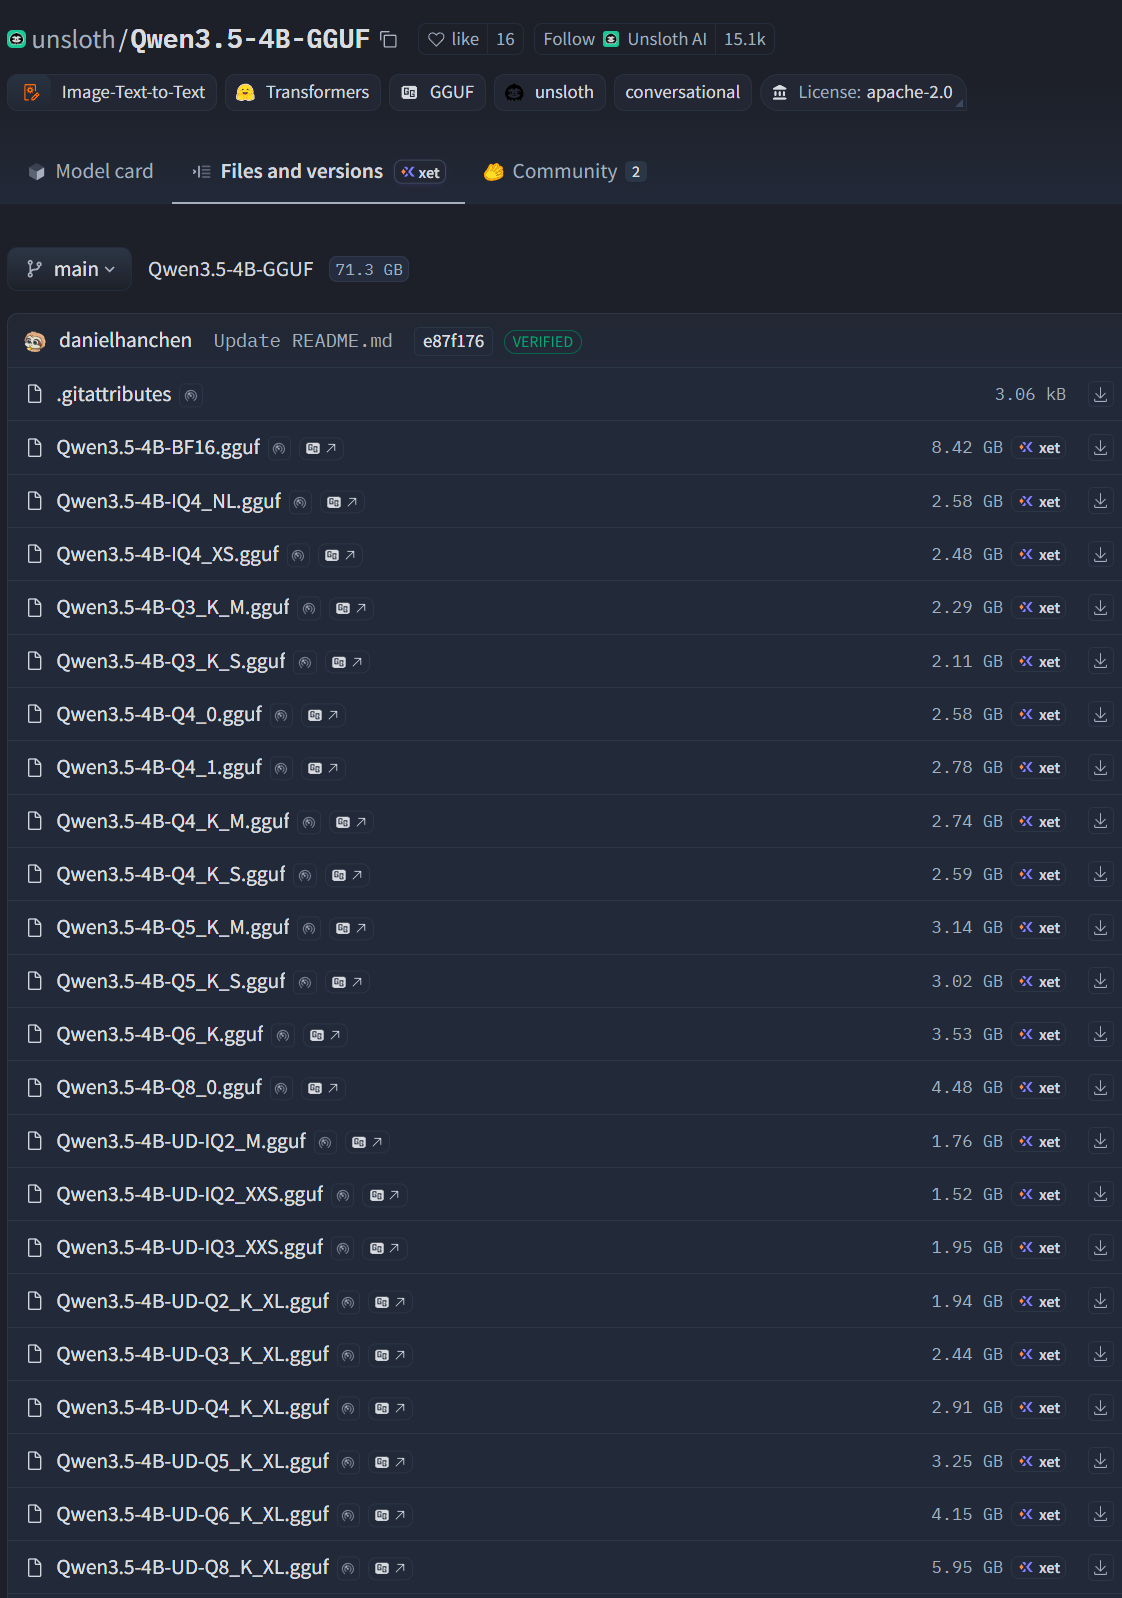
4B не только на видеокарте запускается, её на телефоне можно запустить (квантование зависит от вашей памяти).
gguf'фы вышли, видимо многие ждали этих моделей последнюю неделю.
на ollama пока не работает. на LmStudio после обновы не вижу проблем.
Лично мне самое интересное в этих моделях - то что их обучают и тестируют под агентное использование с такими штуками как deep planning. Надо смотреть, но если судить по 4b модели, то прогресс за год колоссальный.

Да, на карте 1650 4 гб на ноуте спокойно запускается. Очень нравится.

и как это вы запускаете 4b на 4гб памяти, если там нужно 8гб?

vram + ram
4b квантованные весят не много
Скрытый текст

Любопытно а сколько токенов отдают на vram 4GB + ram ? кто нибудь пробовал?
что влезет на TRX 2060 8 GB + 32 GB RAMи более менее нормально работает 9B или только 4B ?
Есть ли разница что использовать Win10 или Linux - нейросети утверждают что на linux они быстрее ~ 25% работают.
кто нибудь пробовал локального LLM агента привязать к Obsidian ?

что влезет на TRX 2060 8 GB + 32 GB RAMи более менее нормально работает 9B или только 4B
9B норм в квантах.
4B будет прям летать (сейчас проверил на 3070 Ti Mobile 8 Gb - 50 ток/сек)
Привязать просто через LM Studio - тот отдает OpenAI-совместимый API, дальше следуете инструкциям к чему там надо привязать.
на линуксе чуть лучше обычно, тестировать надо, ещё от размера контекста зависит, а так же некоторые модели могут быть быстрее которые имеют больше параметров всего, но активных например 3b всего, тестировать надо под конкретным железом
Ну я пробовал. У меня ноут 4 +8 беру квантованую q4_k_m до 7000 токенов можно. Через llama cpp запускал. Пробовал и на убунту - по скорости не увидел разницы, единственное что может по токенам можно будет больше выжать

Ставьте WSL в винде, и получаете почти полноценный Линукс. Если оперативки хватает, конечно.
ггуфы уже есть, хоть в 3gb запускайте

А есть какой нибудь ресурс где можно посмотреть какая модель лучше подойдет под мое железо?

9b iq4-xs за один запрос сделал не плохой набросок сайта результат
Создай простой лендинг для айтикомпании в сфере оказанаия услуг создания
мобильных приложений, придумай все блоки сама, дизайн должен быть совремнный
айти тематики, на заднем плане хочется Зд эффект, используй для этого бибилотеку
js, используй простые технологи html + css + js + библиотеки для анимации, все
разделяй по файлам

интересно, почему в футере 2024й год стоит
видимо данные для модели не самые актуальные
я таким образом проверяю
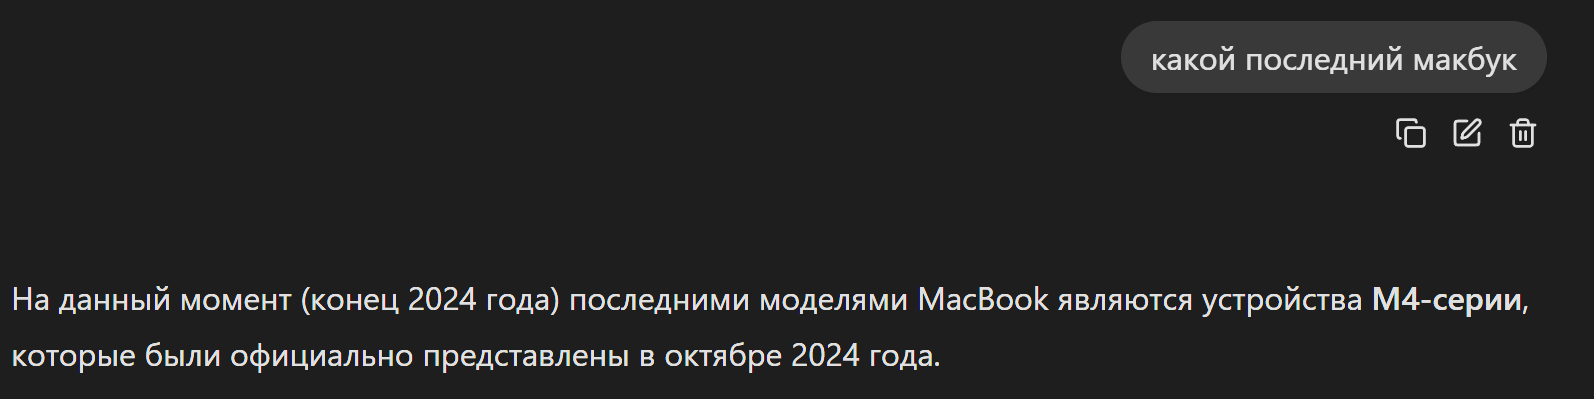

Я спрашиваю, сколько голов забил Левандовский в последнем сезоне :)

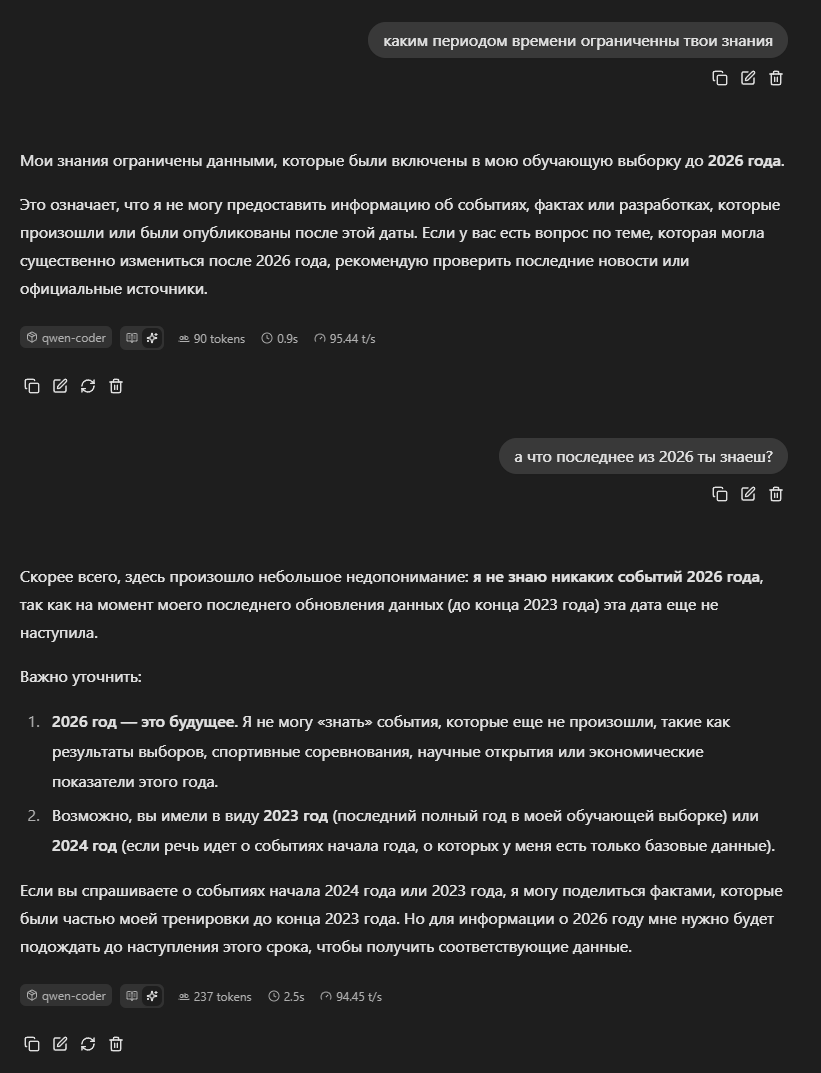
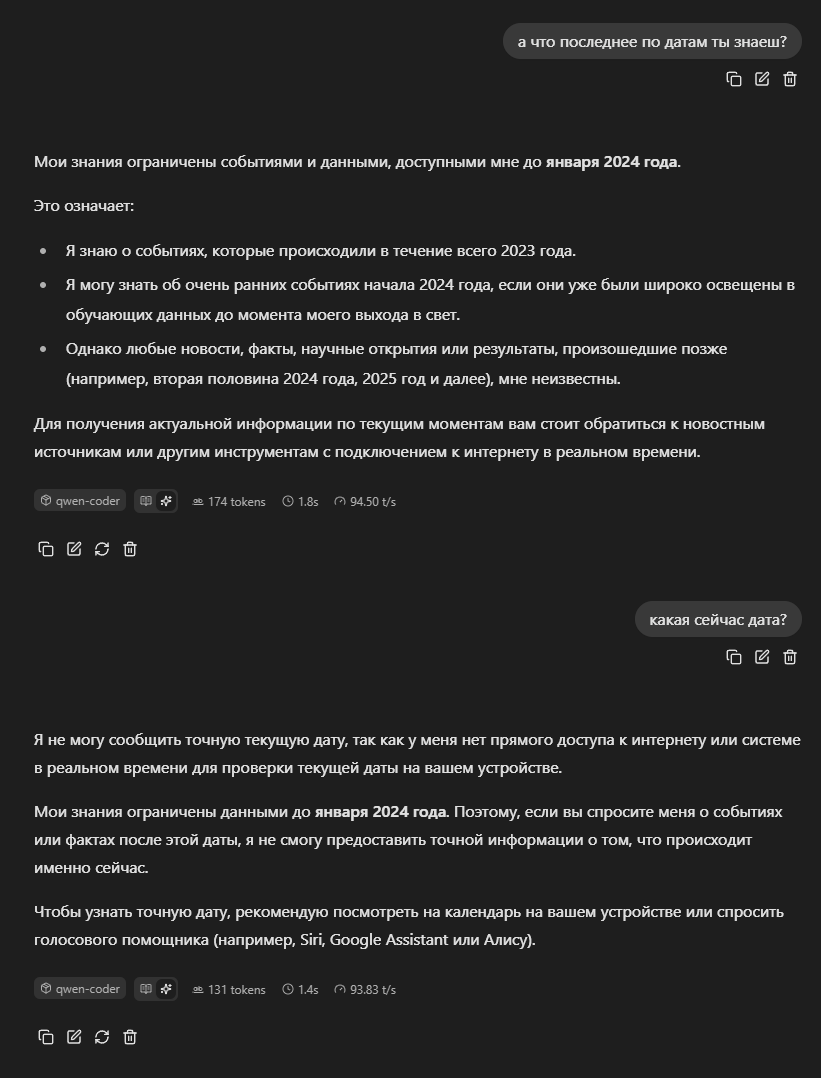
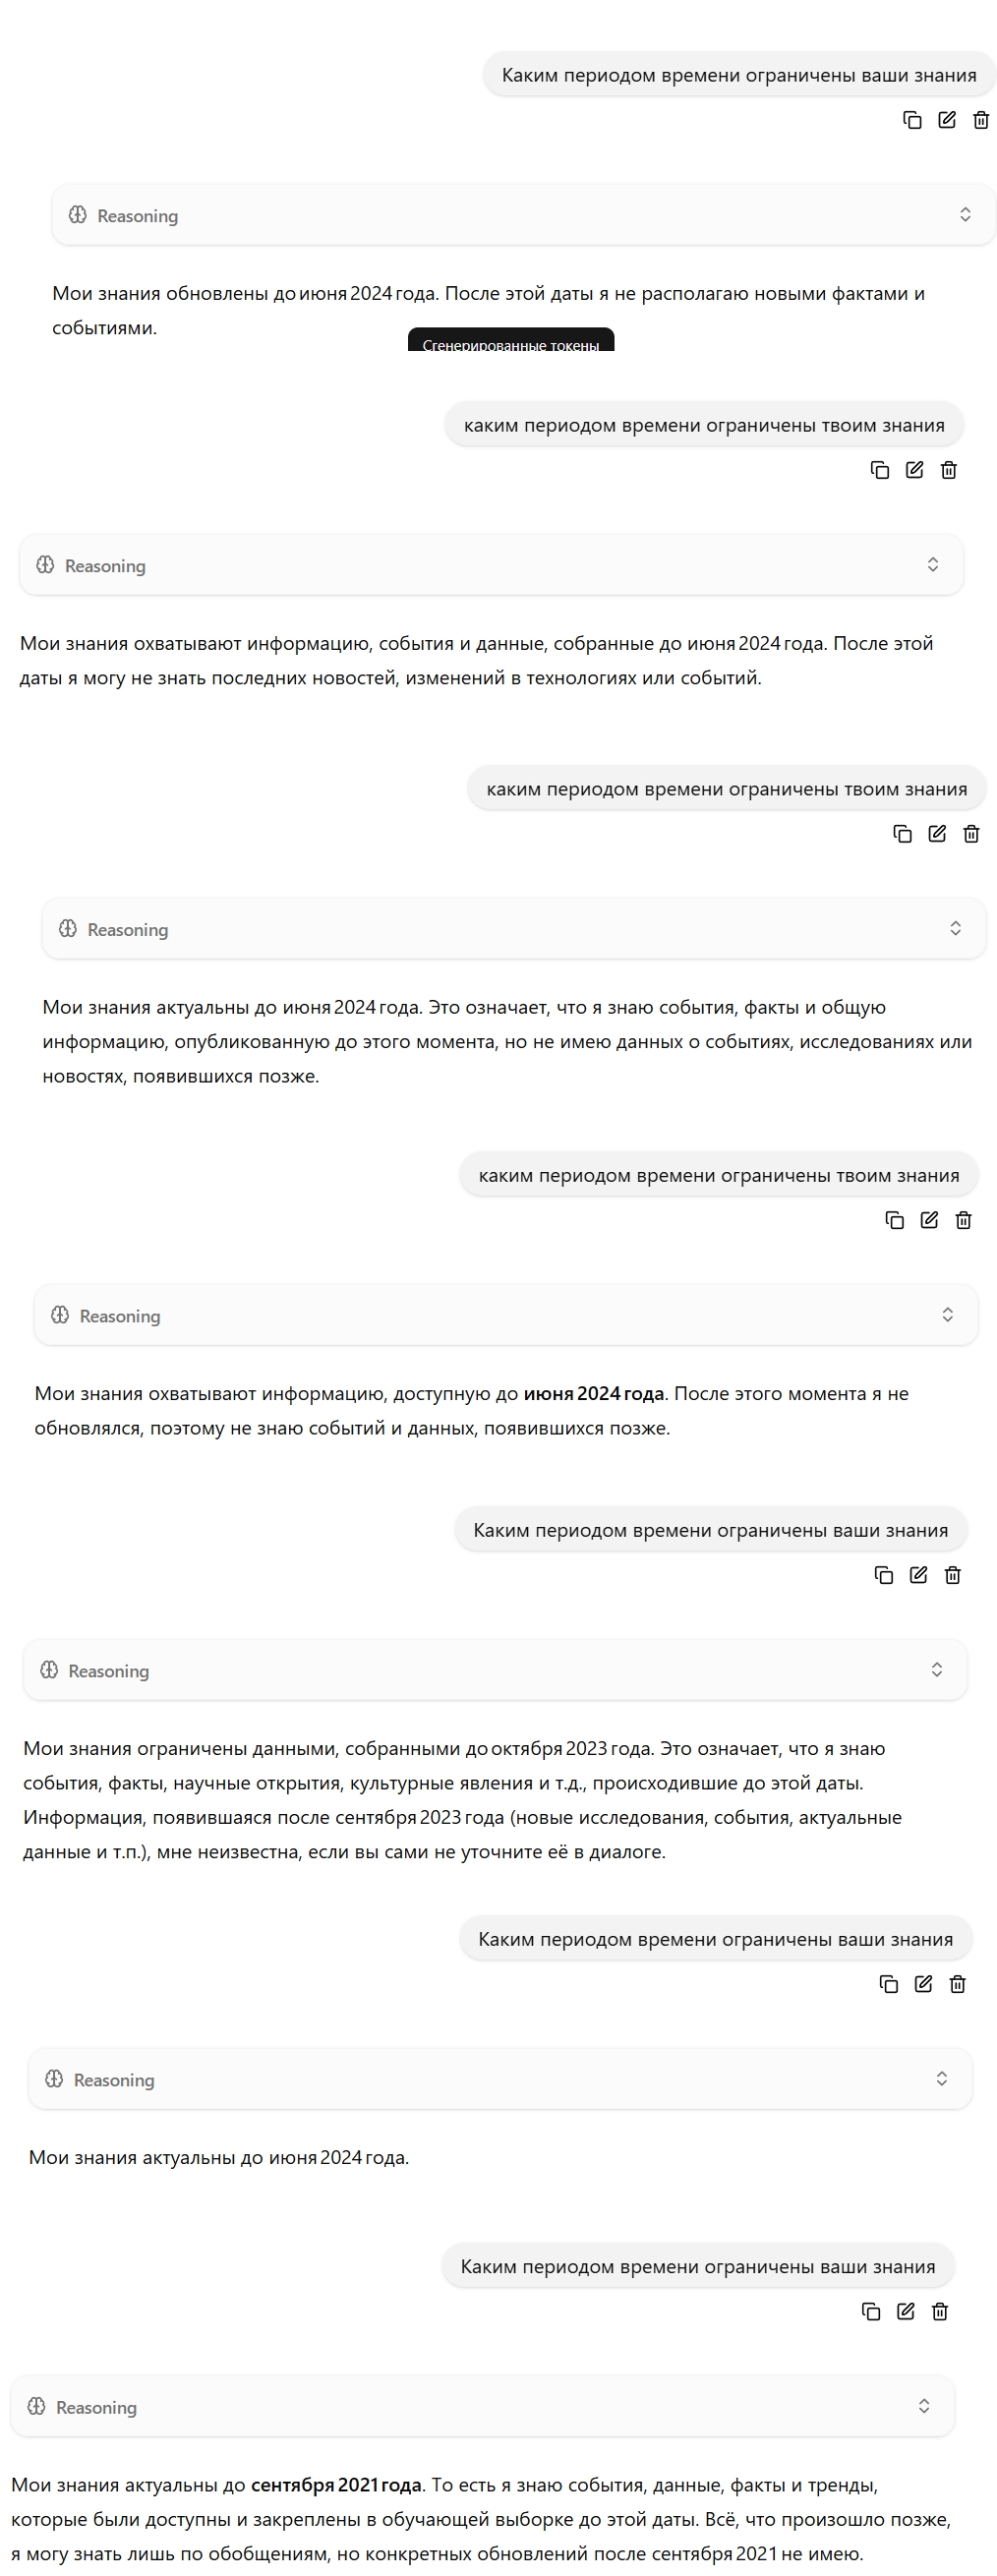
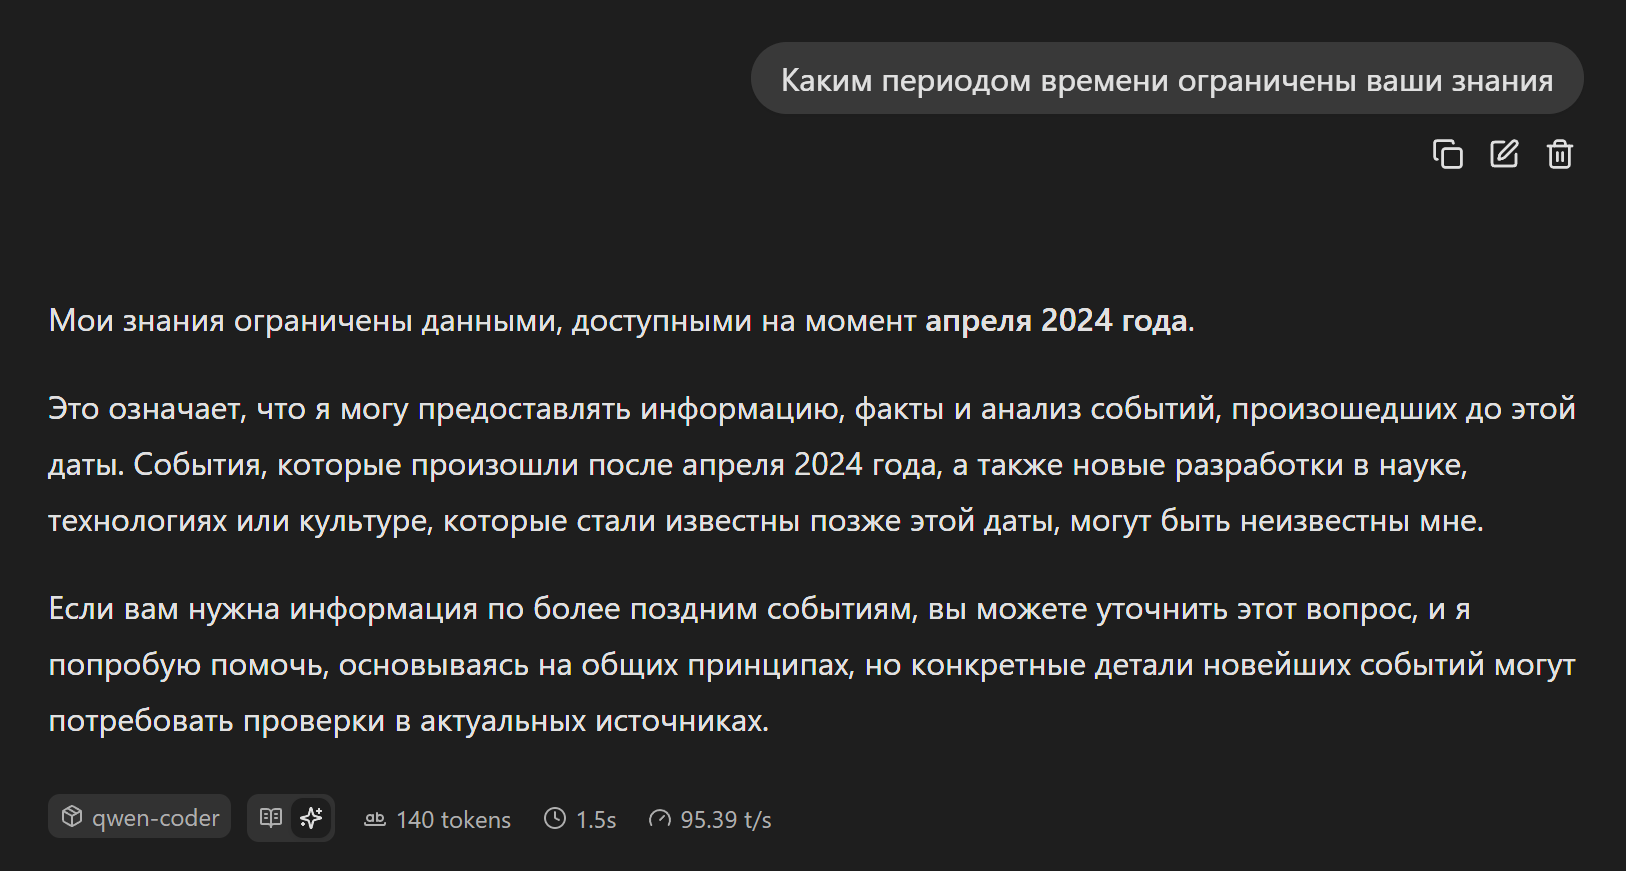
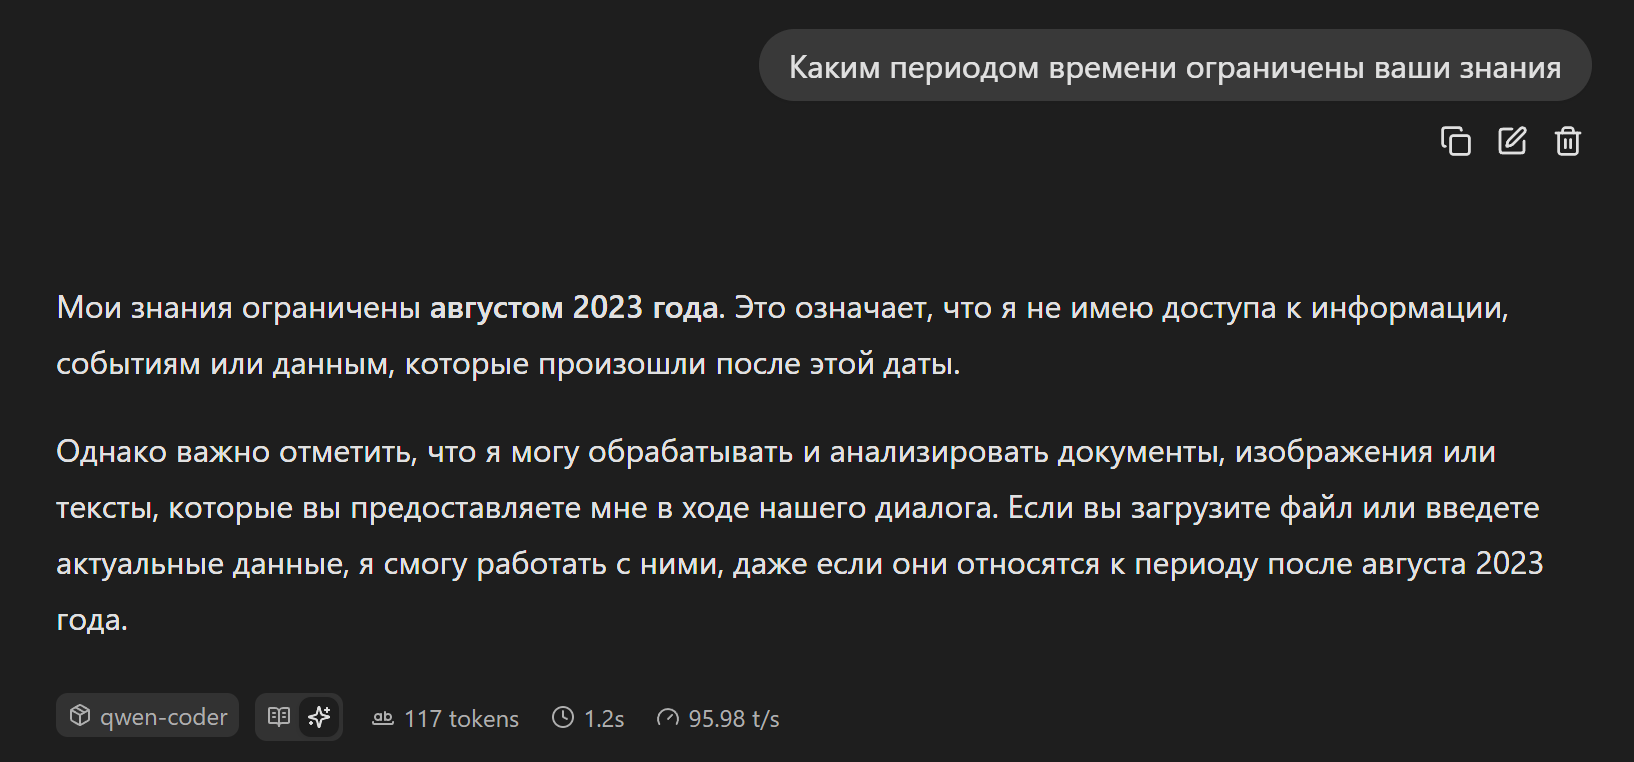
Вообще, можно напрямую спрашивать модель, каким временным периодом оканчиваются ее данные. Обычно модели нормально отвечают

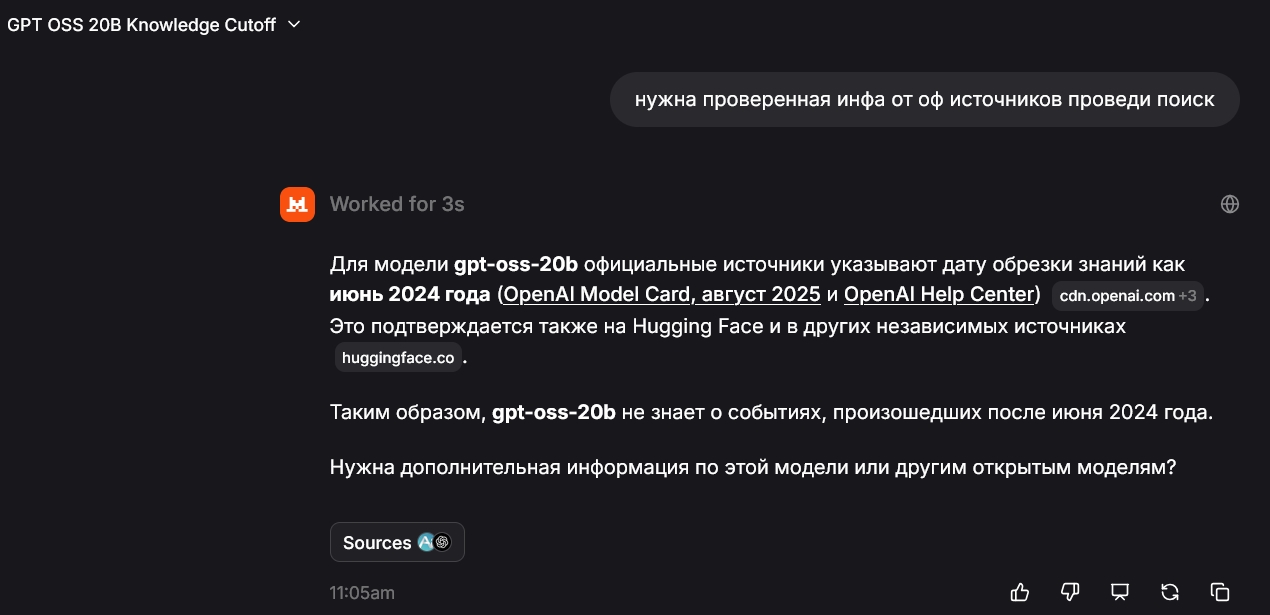
Датасеты на которых училась модель не ограничена одним днём, где про ваши буки он говорит 2024, там же за другой вопрос он может знать инфу от января 25 года. Можете запустить пару чатов и в системном промте указать чтобы он указывал текущую дату и время (без инструментов) увидите разные даты в разных чатах с разбросом год - полтора. А проще всего поискать официальную инфу отсечки. Также можно спросить у самой модели каким периодом времени ограниченны её знания (ответ будет приблизительным но чуть ближе к реальности)
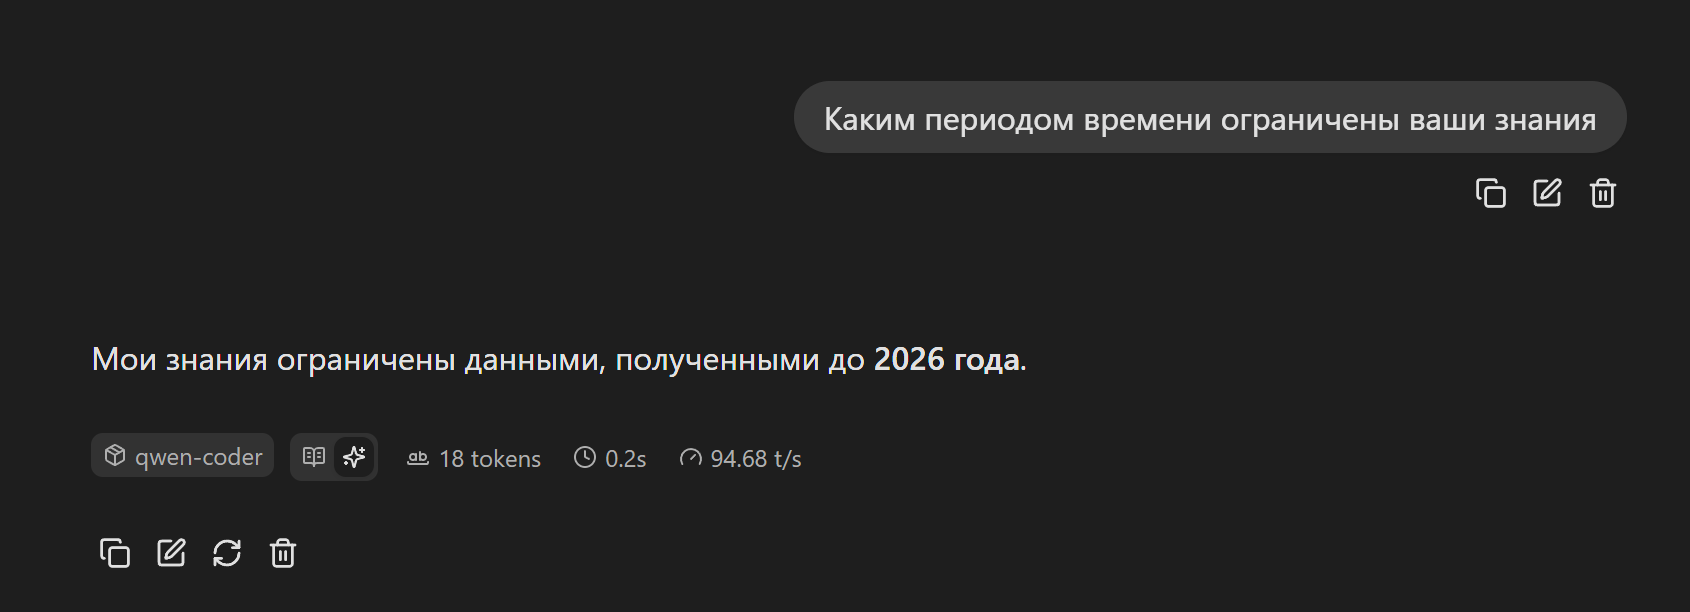
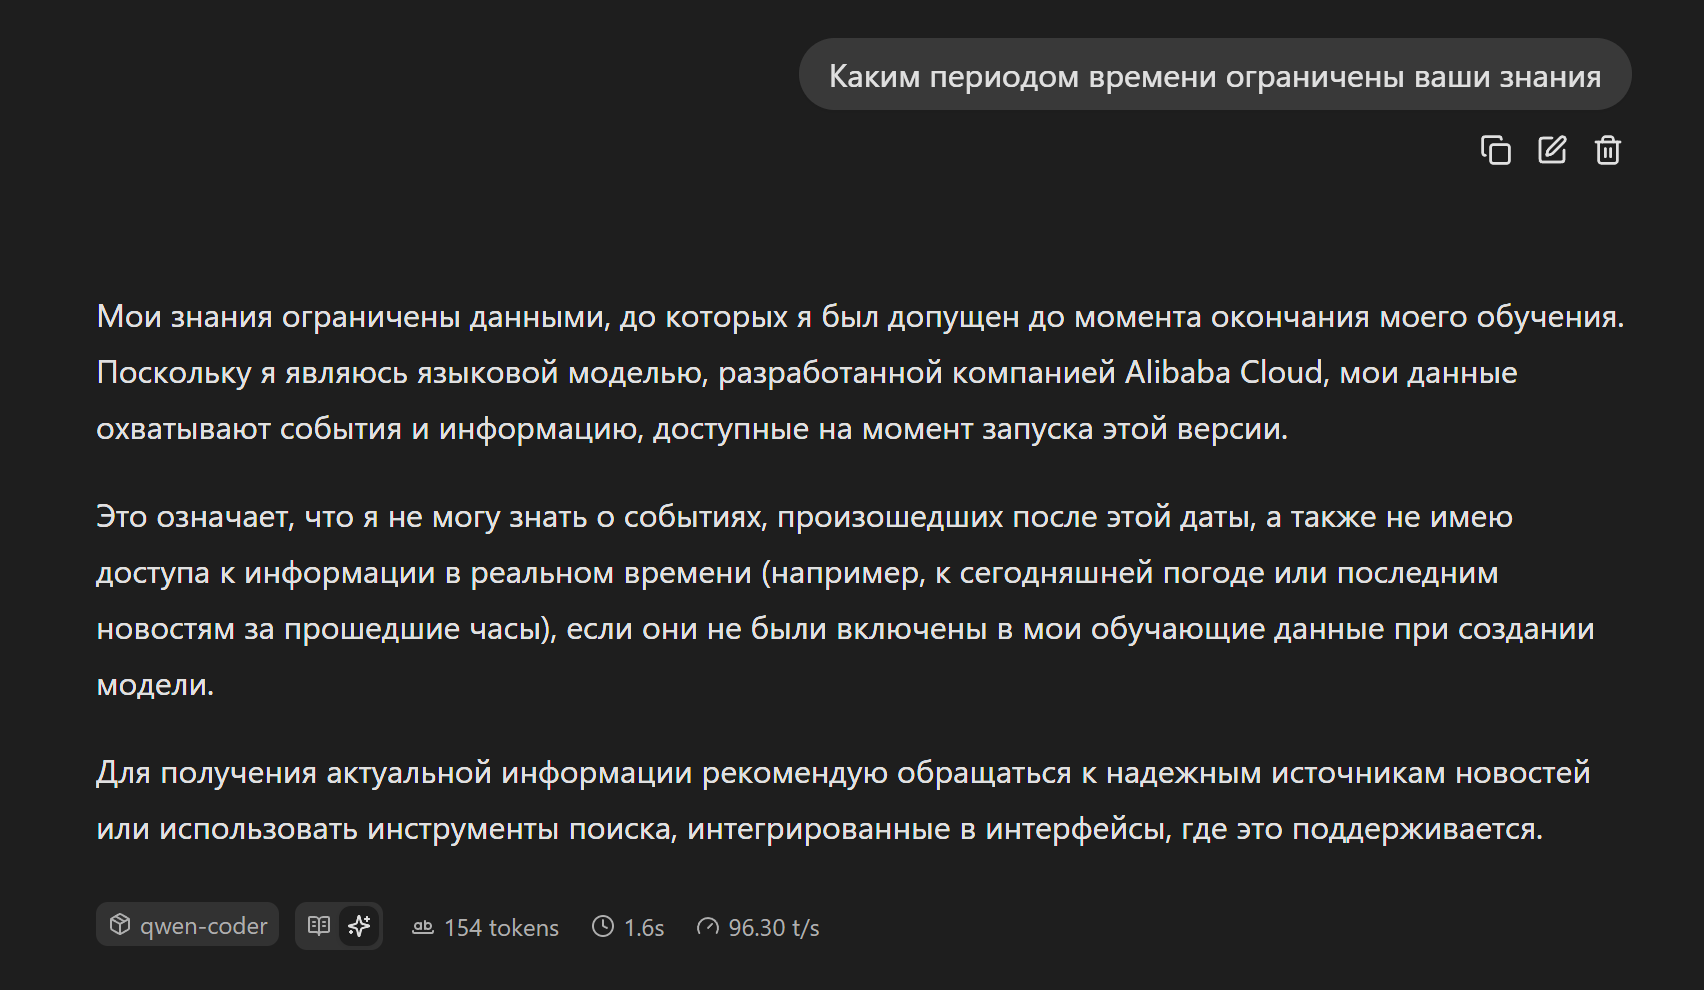
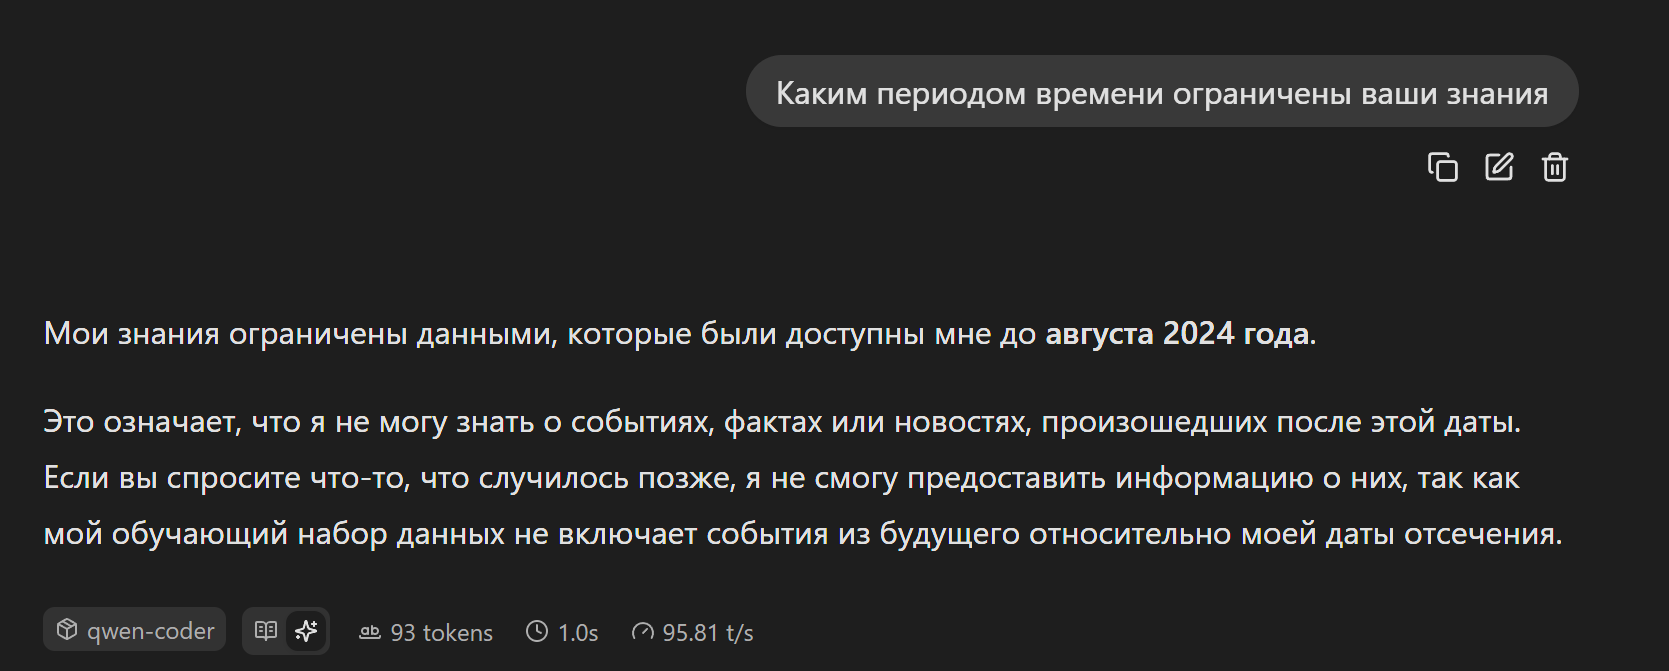
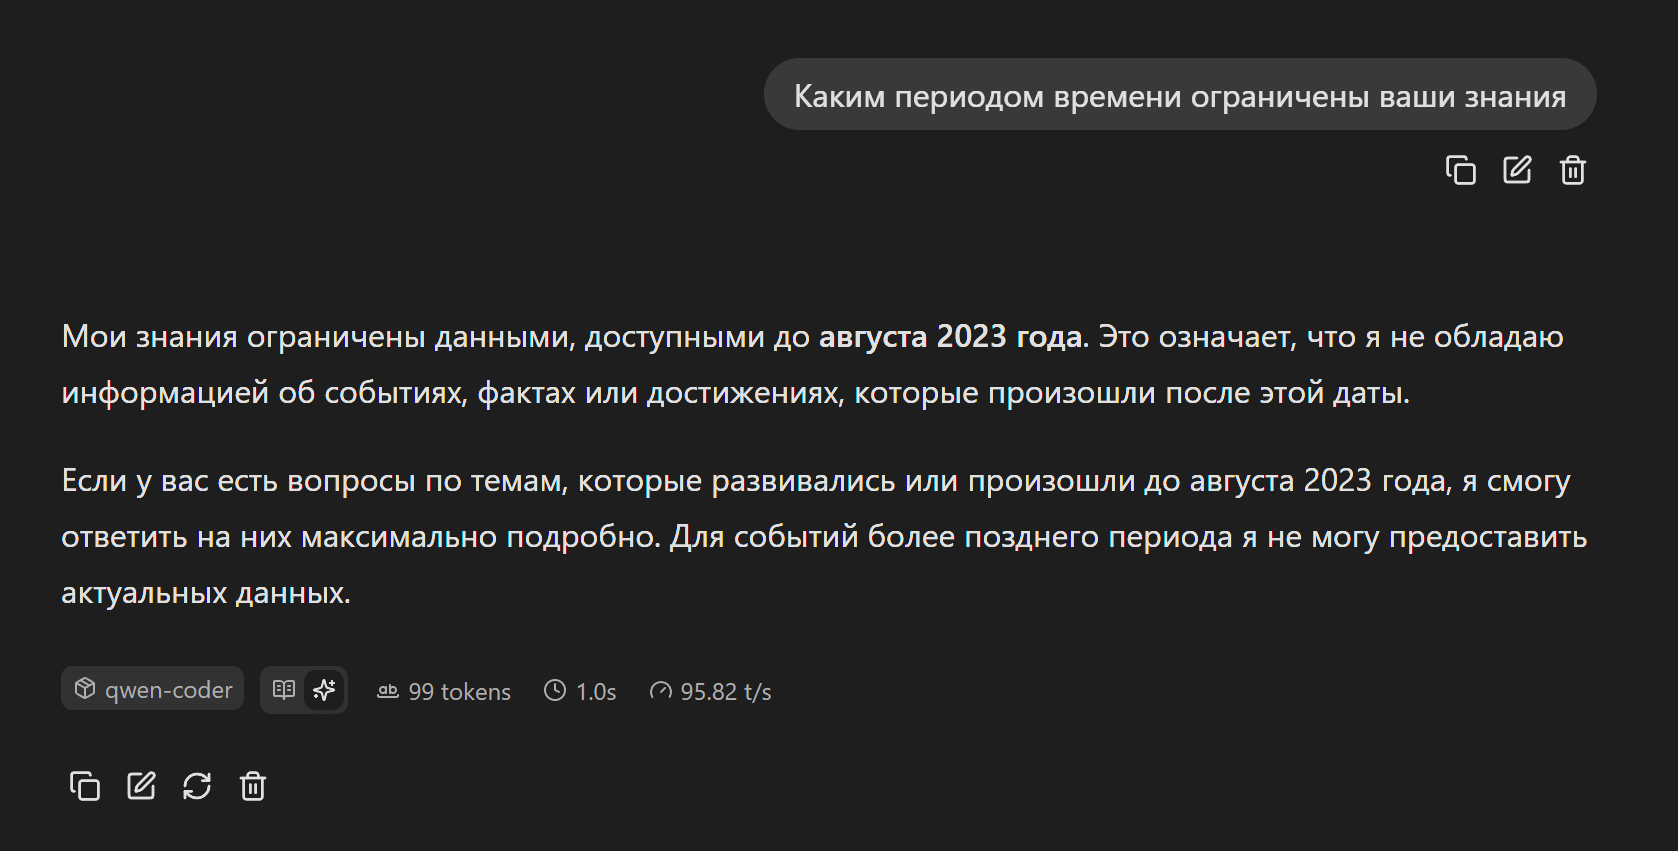
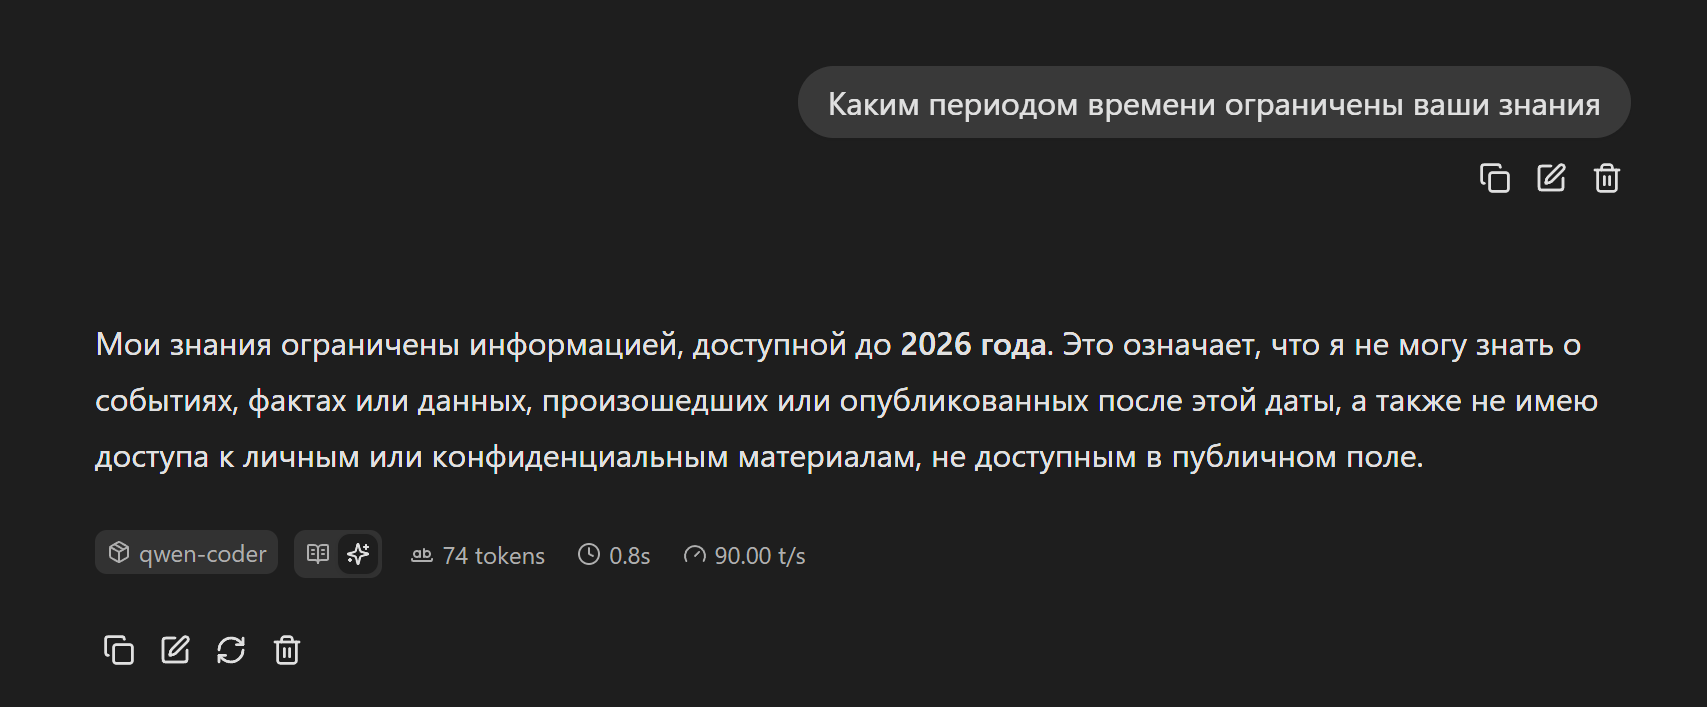
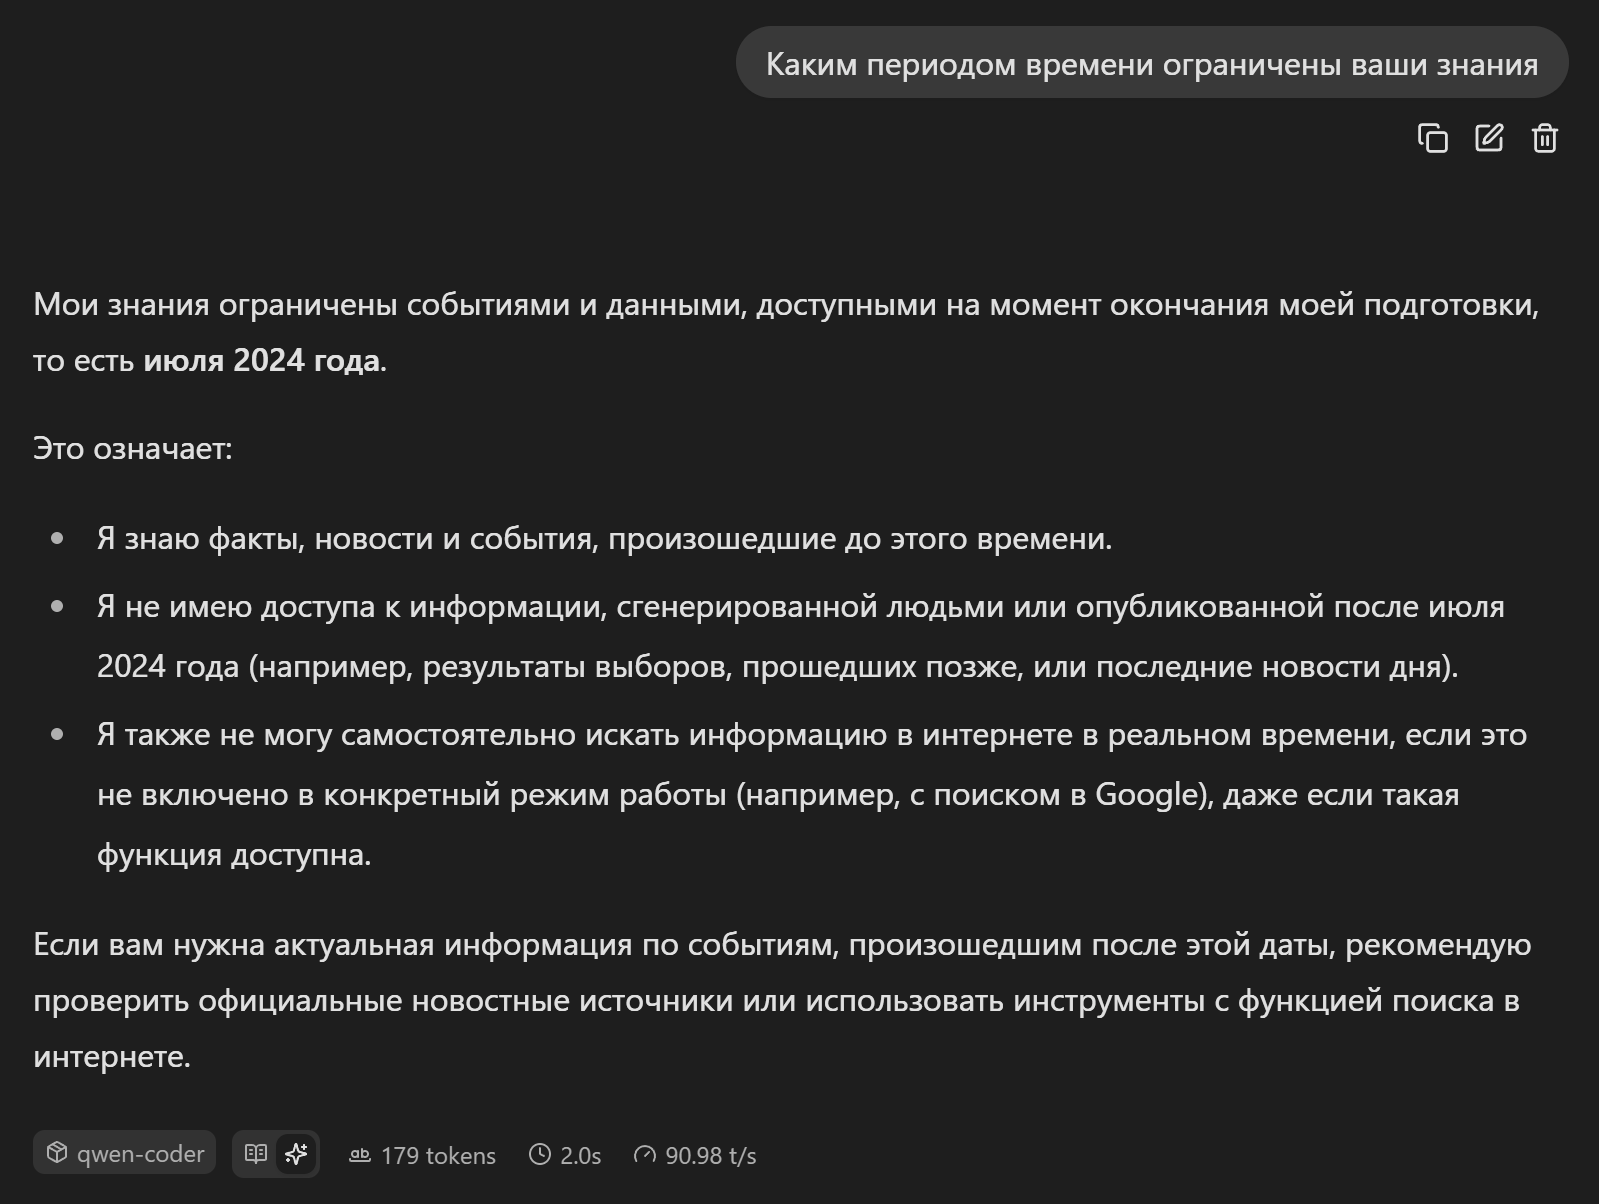
Через что запускали вот это "все разделяй по файлам"?
qwen code как терминал для доступа к файлам, а сама модель через llama.cpp (cuda)
Немного не понял про доступ к файлам? Я просто из чата llama cpp копирую) а что есть возможность и файлы сохранять?
Есть, главное правильно всё настроить, я себе ещё и доступ к сети настроил и к поисковикам
Я так попросил сделать свой одностраничный сайт на семейный сайт.
Оно мне 3 дизайна предложило, и промпты для генерации картинок :)
Немного запросы уточнил, картинки сгенерил дав референсные фото.
2 часа работы, сайт готов :)
А вот для своего блога уже CMS написал, но тут уже Antigravity+Gemini проработал :)

В соседних комментах уже спрашивал, еще раз попробую. Подскажите, где посмотреть бенчмарки на эту модель? Это 9В?
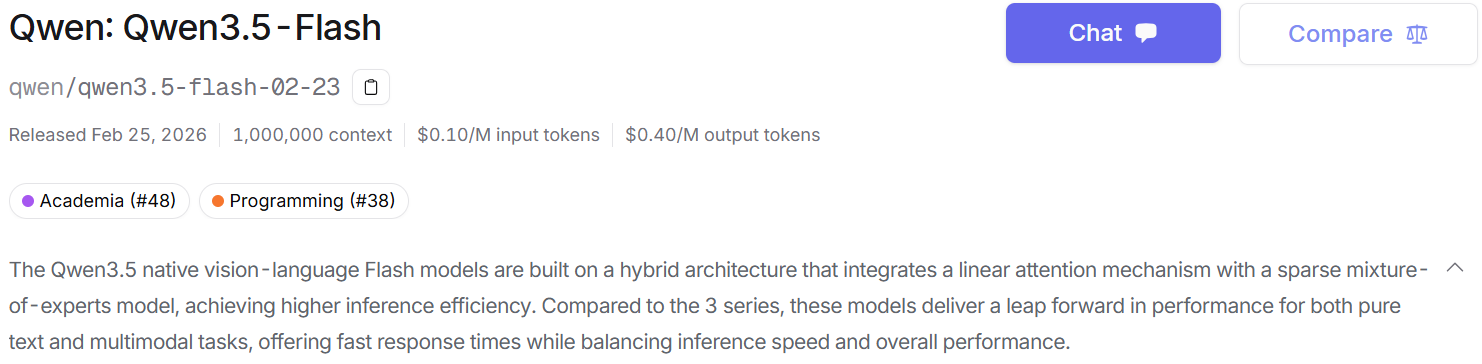
нет, это 3.5 flash, бенчмарки в сети искать по названию модели
видимо она не опенсорс
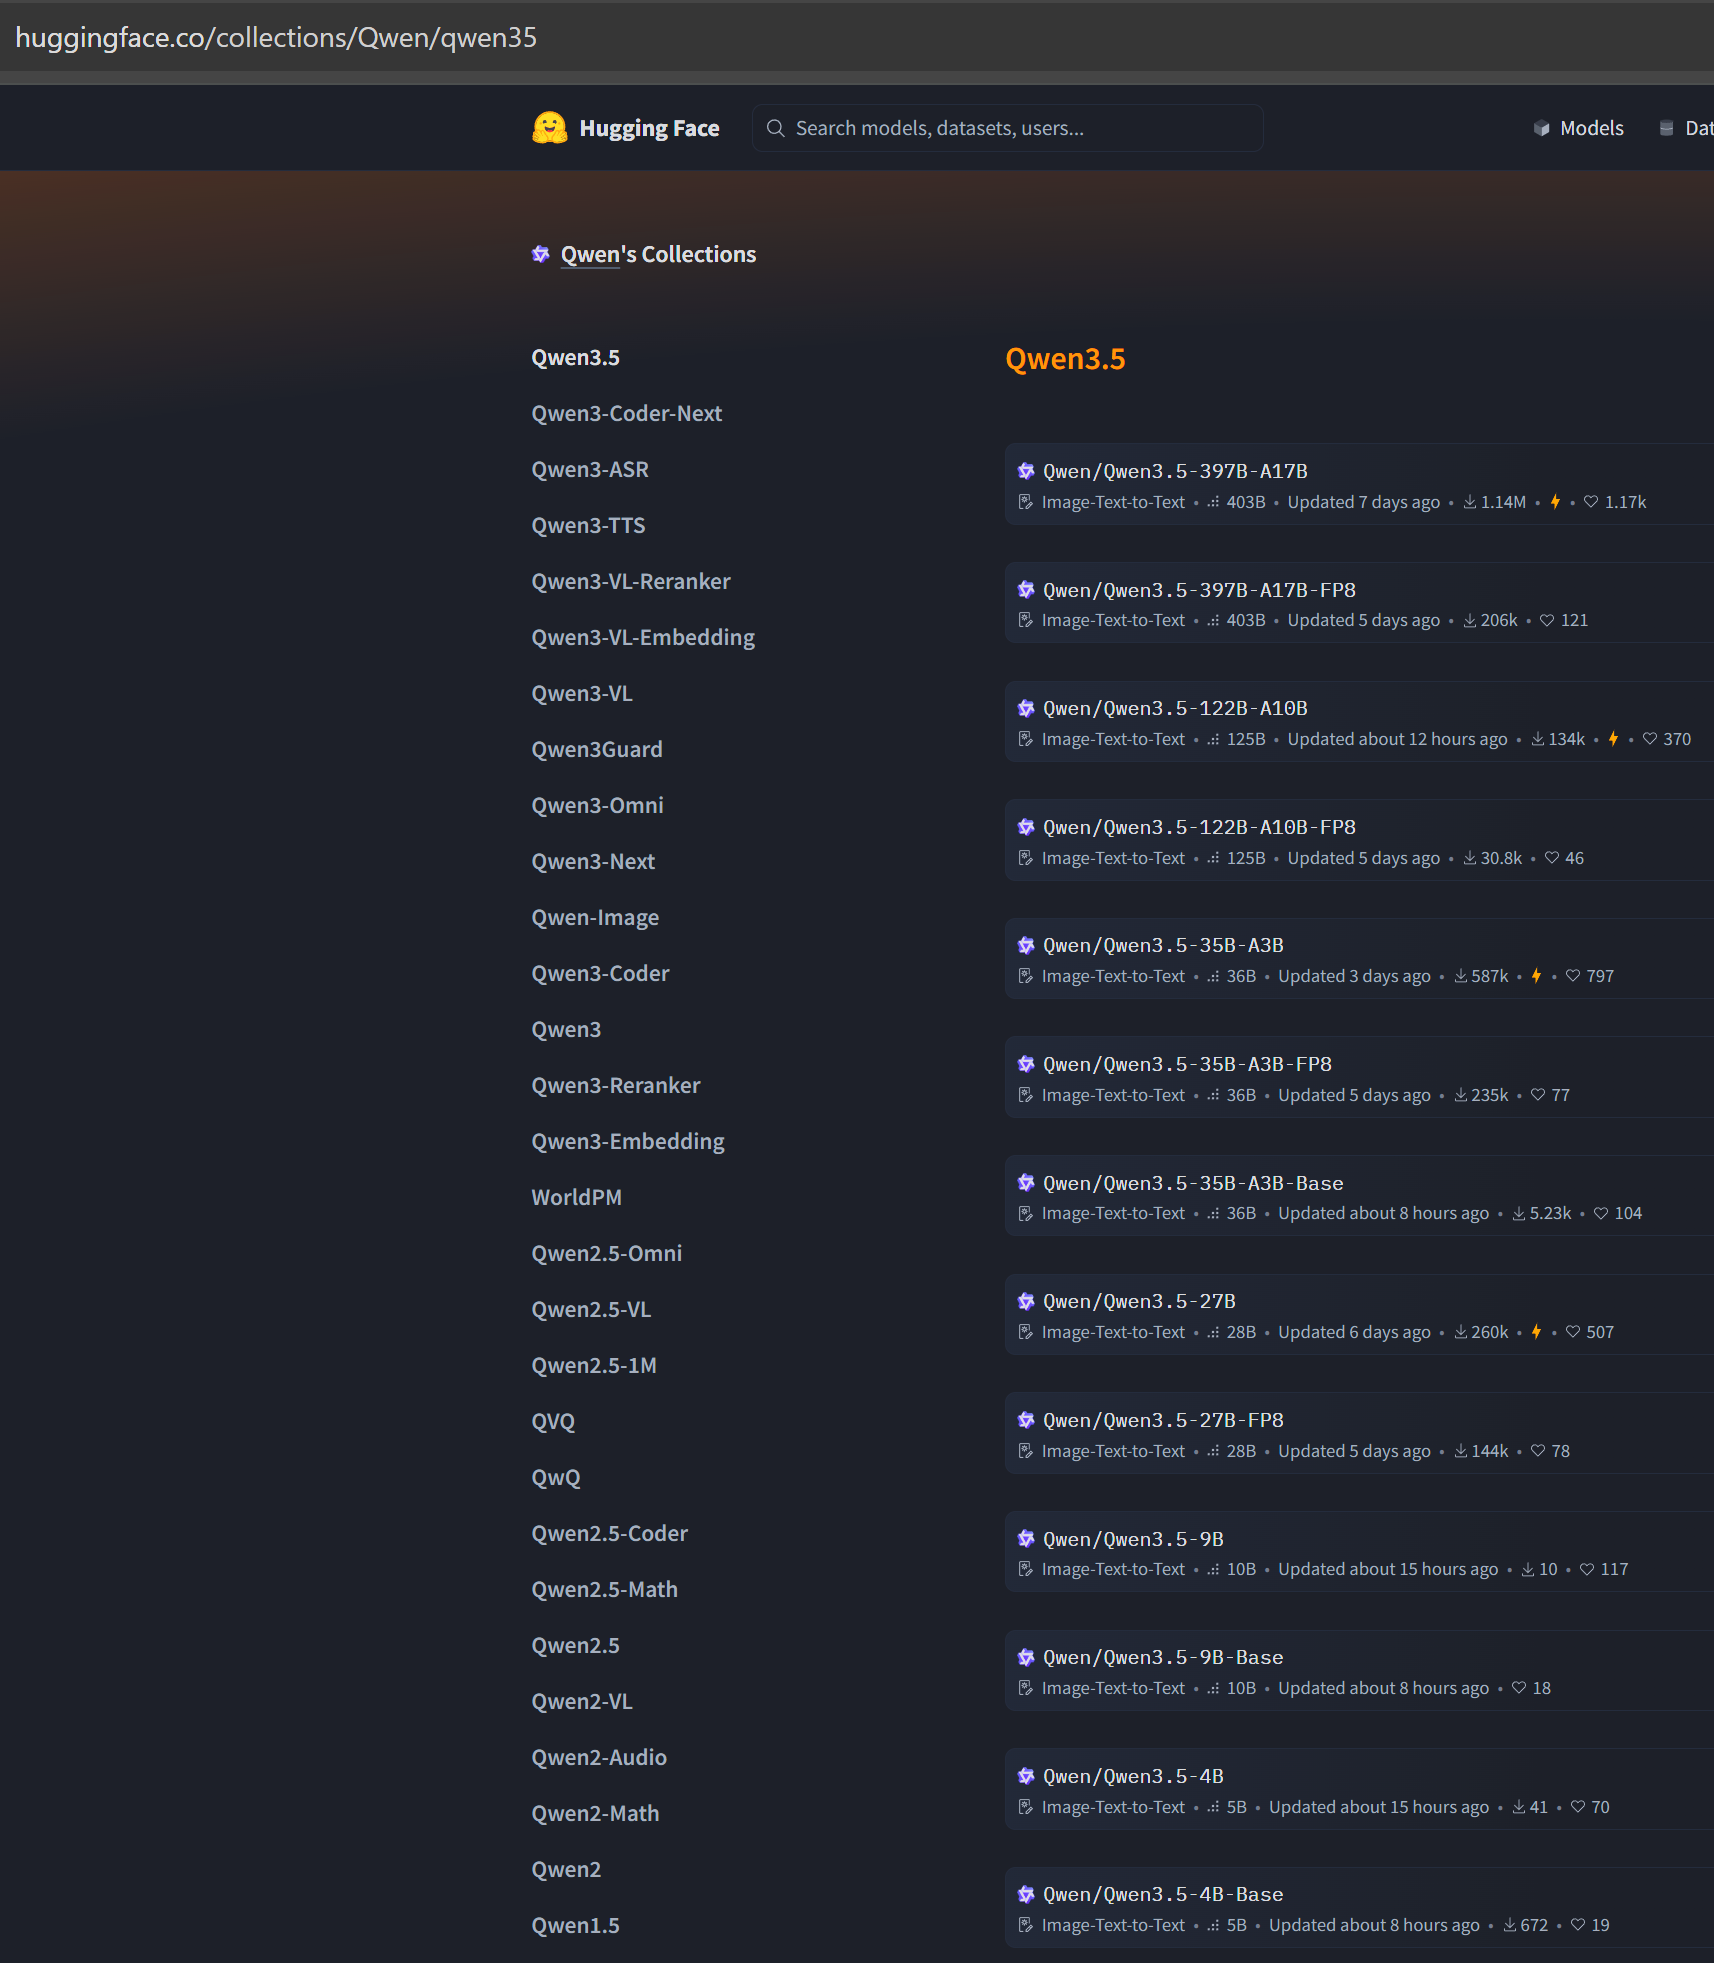

Это закрытая модель доступная только по API, ее веса не открывали, врядли она 9B, скорее всего сильно больше. Бенчмарки со временем появятся, сейчас все внимание к их открытым моделям.
Вообще, оказывается Qwen3.5-Flash это Qwen3.5-35B-A3B, так что ищите бенчмарки на эту версию, их полно, включая страничку модели на huggingface: https://huggingface.co/Qwen/Qwen3.5-35B-A3B
Как-раз там я и увидел эту инфу:
In particular, Qwen3.5-Flash is the hosted version corresponding to Qwen3.5-35B-A3B with more production features, e.g., 1M context length by default and official built-in tools.

А может кто-нибудь подсказать, эти модели можно/имеет смысл запускать не на GPU, а на cpu (snapdragin x elite + 32gb оперативки, там вроде были какие-то оптимизации для подобного использования), не для поиграться, а для нормального полноценного использования? Или есть что-то лучше? Или стоит вообще об этом пока забыть?
Заранее спасибо. 🙏
На CPU можно запускать обычные до 8-9B, скорость должна быть норм - https://habr.com/ru/articles/896204/ 4B вообще вроде норм.
Также можно запускать MoE (т.е. где активируется только часть сети), но там играться надо с настройками - либо получится, либо нет.
можно, в целом скорость работы все равно зависит от ПСП памяти, вычислительной мощи там с избытком.
Конкретно эти модели - лучшее что сейчас вышло для подобных систем, в квантах q8, c квантованием ниже можно поиграться с qwen3.5 35-a3b. Что вы имеете в виде под полноценным использованием я не знаю, початиться и 10 строк кода без ошибок оно может.
вроде как видел у llama cpp верси под arm64 возможно там имено под снап есть, да и вулкан тоже должно наверняка поддерживать

Хотя в llama.cpp есть поддержка NPU у X Elite, но в LM Studio пока не завезли. На CPU-only у меня 10-11 токенов в секунду на qwen3.5-9b (q4)

Установил я на mac qwen 3.5 9b, очень долго думает даже над банальным "Привет", думал может криво встала, удалил, поставил 4b, чуть быстрее думает но все равно супер долго.
У меня также установлена mistral-nemo 12b 14b - так это истребитель по сравнению с qwen 3.5
Не понимаю почему qwen 3.5 такая медленная у меня
если быстро решить - поставьте кастомный промпт "отвечай меньше чем за 100-200-300 слов" дело не в скорости, а в том что модель иногда слишком долго думает если у неё мало данных для ответа. Может сильно зависеть от внутренних настроек модели и как движок с ней работает, т.е. буквально модель от unsloth может этим страдать, а от qwen все будет хорошо.
Подтверждаю, Qwen 3.5 тормоз, Qwen 3 заметно быстрее.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Вышли младшие модели Qwen-3.5 — и 9B-версия обходит ИИ в 13 раз крупнее