Комментарии 20

Я так и не понял, как люди строят работу так, что у них запущено куча агентов которые работают нонстоп.
Я пользуюсь Cursor и мои задачи агенту "Найди в проекте строку связанную с вот таким текстом ...", "В начале этого файла объяви функцию выполняющую..., в конце файла используй эту функцию, передав на вход параметры ...".
Возможно, другие люди используют так "Сделай маркетплейс одежды, составь план и делегируй задачи агентам" и уходят пить кофе?

Некоторые отдают доступ к Джире, а там уже рой агентов сам все делает. И решает, и тестирует, и деплоит... типа такого: https://github.com/garrytan/gstack
Насколько хорошо это работает за пределами стартапов, пока сложно сказать.

Что же это за описание задач в джире такое, что там ИИ может понять и найти контекст что делать. Тут мясные туши обтекают, потому что в джире будет 10 слов и сиди выясняй что там и как.

Приходится прорабатывать тикеты, вести документацию для агентов и давать ему инструменты для тестирования

На самом деле у меня даже обычный qwen-code "умеет" работать с задачами из трекера: через апи получаю название, описание, аттачи, складываю в папку, в headless режиме запускается qwen и читает, смотрит скрин, ищет по коду, при необходимости через девтулзы в браузер ходит - в итоге и пишет алгоритм исправления в комменты, и сам может исправить-закоммитить даже (правда это PoC всего лишь) 🤷

Когда команда делает по правилам то и людям и агентам просто.
По правилам это :
Наличие докстрингов, наличие аналитики в текстовом формате в не только в головах, наличие понятных регламентов разработки. Наличие документации. Соответствующее комментирование коммитов и мров. Наличие сваггера. Наличие описания инфры. Наличие кодстайловых документов.
Мы обычно ленимся с этим, в итоге да - мешкам приходится дергать тимлидов, продуктоводов и они кое как справляются.
Когда у агента есть все написанное выше, промпт в духе "почини тикет из жиры T12335, раскати его на стейдж и проверь e2e" работает прекрасно.

Такое быстро проходит. Потом пишешь - спроектируй структуру файлов, спроектируй приложение.

взаимодействие с Claude Opus стоит втрое дороже стандартного запроса.
зато быстро учишься распределять запросы по сложности между моделями. Там есть из чего выбрать (включая пару бесплатных - gpt5-mini, 4.1, 4o)
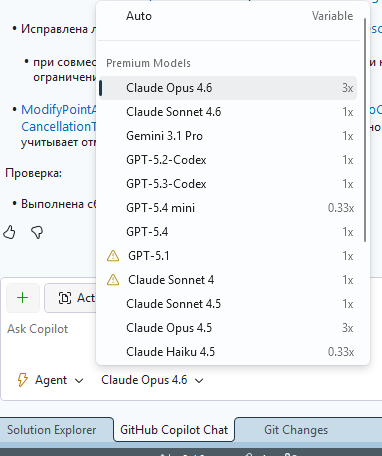

Используйте инструменты Human in the loop и просите агента спрашивать, прежде чем закончить сессию, все ли вас устраивает, это позволит сэкономить много премиум запросов на опус.
ваш комментарий сподвиг меня на поиски этой возможности в копилоте (который github copilot не copilot 365). Не нашел. Если указывать как инструкцию "просить подтверждения" в copilot-instructions.md, то как я понимаю, это будут отдельные запросы.
у вас это было предложение "посмотреть если ли такое", или вы используете это? Если используете, подскажите - как настроить?
Я использую расширение для VSCode (https://marketplace.visualstudio.com/items?itemName=DercasDrol.human-in-the-loop-mcp&ssr=false#overview), которое работает как mcp сервер. Подключаю его в проекте для копилота через файл mcp.json (оно само предлагает там прописаться). И включаю доступ к его инструментам агенту и в конце каждого обращения прописываю агенту чтобы спрашивал перед тем как закончить он обращался ко мне через эти инструменты. Расширение изначально писал под себя и активно им пользуюсь. Если будут замечания и\или пожелания по улучшению, пишите.
Спасибо. Кинул звёздочку и попробовал. Реально работает. Кстати попробовал дать ссылку на MCPсервер в Visual Studio 2026, Copilot увидел сервер, но в чат вопрос выдать не смог, по таймауту отвалился. Дал ссылку на расширение в корпоративном чате, с Opus 4.7 (дурным множителем на 7,5) люди вполне возможно начнут качать...
Это к сожалению так не работает.
Современные модели блистательно овладели искусством мимикрии. Они генерируют убедительный код, пишут складные тексты, набрасывают тесты и с непоколебимой уверенностью могут убедить человека, что работа почти закончена. Проблема в том, что «выглядит как рабочий код» и «работает на проде» — это две непересекающиеся вселенные.
Если попросить зеленые тесты, агент с радостью соберет вам зеленую гирлянду из моков, которая не проверяет ровным счетом ничего. Если попросить "чтобы не падало", он услужливо обернет всё в один гигантский try/catch. В этом нет злого умысла. Это просто бездушная исполнительность. Поэтому хорошее качество в AI-разработке не возникает от удачного промпта — оно выковывается жестким процессом. Надежда — плохая инженерная стратегия.
Здесь кроется важный трюк: если сказать агенту «вот функция, напиши для нее автотест», вы получите вменяемый результат с вероятностью 10–30%. Но если добавить в пайплайн независимого агента-аудитора с задачей: «Проверь, реально ли этот автотест качественно проверяет функцию, и напиши замечания», а потом вернуть этот фидбек первому кодеру со словами «чисти баги» — за 2–3 итерации код скует форму крепкого мидла.

ну если агент отправлял в опус даже задачи, с которым хайку справится... просто потому, что за 200 баксов получался лимит, который можно расходовать без перерыва... то, вероятно, пусть и больно будет звучать... но решение Антропик просто научит относиться экономичнее к выбору модели и настраивать маршрутизаторы.
Я не могу себе представить такой режим и характер работы, чтобы ежедневно требовался только Опус и никто больше...

На самом деле даже сама модель определяет это так: GPT5.4 это Senior, GPT5.4mini это Junior. Тоже актуально и для Haiku. Все, что выходит из дешёвых моделей оставить без присмотра Senior нельзя, там могут быть проблемы или неверные решения. Получается вроде дешёвые модели есть, но всё для чего они годятся это запросы вроде "запусти окружение" (которое уже было настроено до него). То есть это запросы уровня принеси, подай.
Добавь ключ на сервере. Сделай бекапы базы. Я даже не знаю примера, что может такая модель сделать не накосячив. По информации от GPT5.4 даже если вы ставите xhigh дешёвой модели вроде 5.4mini это не спасет, так как просто junior будет много думать, но от этого он не становится senior. Это по словам самой модели.
ну так есть в ходе обсуждения много задач по типу "разбери то", "суммаризируй материал", "найди файл", "подготовь вводную".
не каждый запрос касается "создай новый модуль" или "создай большой тестовый скрипт".
Даже обыченые "напиши ответ в телеграмм", "посмотри логи ошибок и суммаризируй их мне в чат", "запусти уже разработанный файл и напиши результат".
Серьезные задачи, требующие "сложного мозга" ну не могут идти 100% времени. Человеческий мозг не способен работать в таком режиме, он просто не успеет за таким мозгом.
Я уверен, что если эффективно распределять задачи по моделям, то "большой брат" потребуется 30-40% времени, а маленькие справятся с 40-50%. Еще 10-20% будут "под вопросов", такие задачи скорее зависят от сложности задачи и качества промпта. Если промпт хороший, то маленькая справится. Если пользователь ленится, то нужны большие.
Понятно, что это утрирование ситуации. Однако суть замечания в следующем: если пользователь считает, что все его задачи нужно отправлять только в Опус, то он, скорее всего, просто "не чувствует разницы между Опус и Хайку". Хайку обладает всеми теми же знаниями, что и опус, но он хуже решает "сложносоставные задачи", всего-то.
Я уверен, что если эффективно распределять задачи по моделям
Это значит нужно постоянно бегать по переключателю? Заколебаетесь :)
Если у вас 8 часов работы с моделью, переключать - забываешь, не всегда включаешь, включаешь не там. Случайно включил на планирование Haiku...
- Итак мой любимый Haiku собери материалы по такой-то задаче.
- Opus сформируй план, материалы у тебя уже есть.
- Haiku запускай план. (косяк, косяк, косяк.)
- Sonnet проанализируй сделанное и найди ошибки.
Даже сами модели на этот счет говорят, что при таком формате работы, лимитов может уходить больше, чем просто при работе одной нормальной модели Sonnet + Opus.
Тут нужен скорей какой-то инструмент, который может распределять задачи - планирование Opus, написание кода Haiku, проверка Sonnet. То есть я не спорю логика использования Haiku есть, но для этого нужна специальная среда, где если это код, после Haiuky катится Sonnet как шар за Индианой Джонсом и укатывает все сделанное, но катится только по тестам, которые уже были раньше написаны, в другом случае я не вижу экономии.
именно, это и есть "точка роста". И она лучше, чем гонять опус задачами "включи чайник".
Как только убрали халяву, сразу появится и решение для оптимизации затрат. А пока убытки были на стороне Антропик - никто и не парился на этот счет.

А не сталкивались с проблемой, когда после переключения на Соннет или Хайку в любом из контекстов ,в Claude Code , в любой неожиданный момент другой контекст Опуса может переключится на нее без запроса?
Из за этого полностью перестал пользоваться чем то кроме Опуса. Потому как несколько раз попадал на сжатие из-за разницы в размере контекста с потерей всего содержимого.
Даже не знаю где искать корень этого. Субагенты работают при этом нормально.

В итоге выяснится что найм разработчика не такая уж и плохая идея.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
$3650 за $200: разработчик объяснил, почему Anthropic запретила OpenClaw