Комментарии 11

с помощью нейронки сделал более удобные графики для сравнения с qwen 3.6 27b как по мне учитывая размеры моделей квен куда лучше
deepseek-ai/DeepSeek-V4-Flash 160gb
deepseek-ai/DeepSeek-V4-Pro 865gb
Qwen/Qwen3.6-27B 55.6gb
Скрытый текст
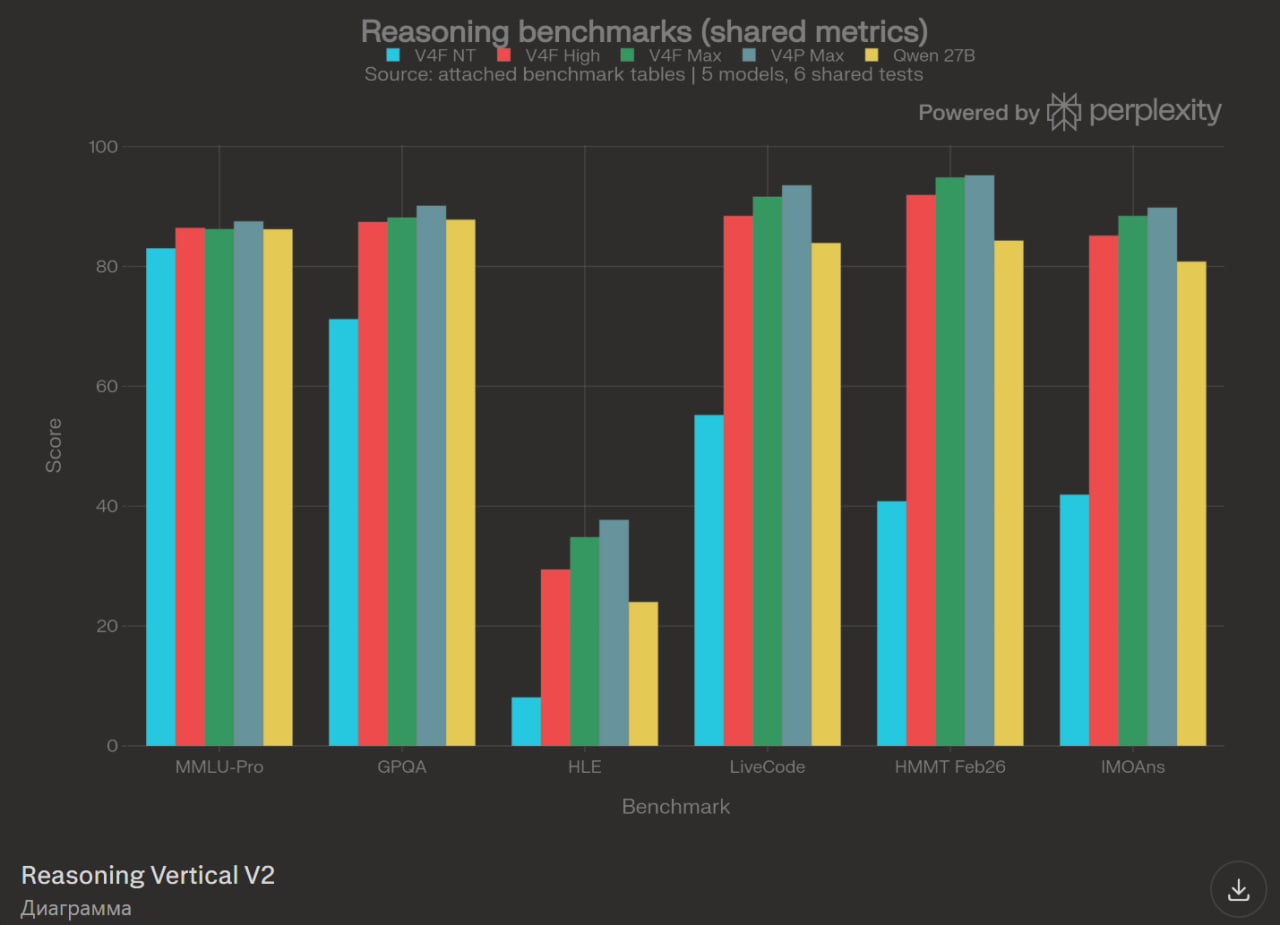
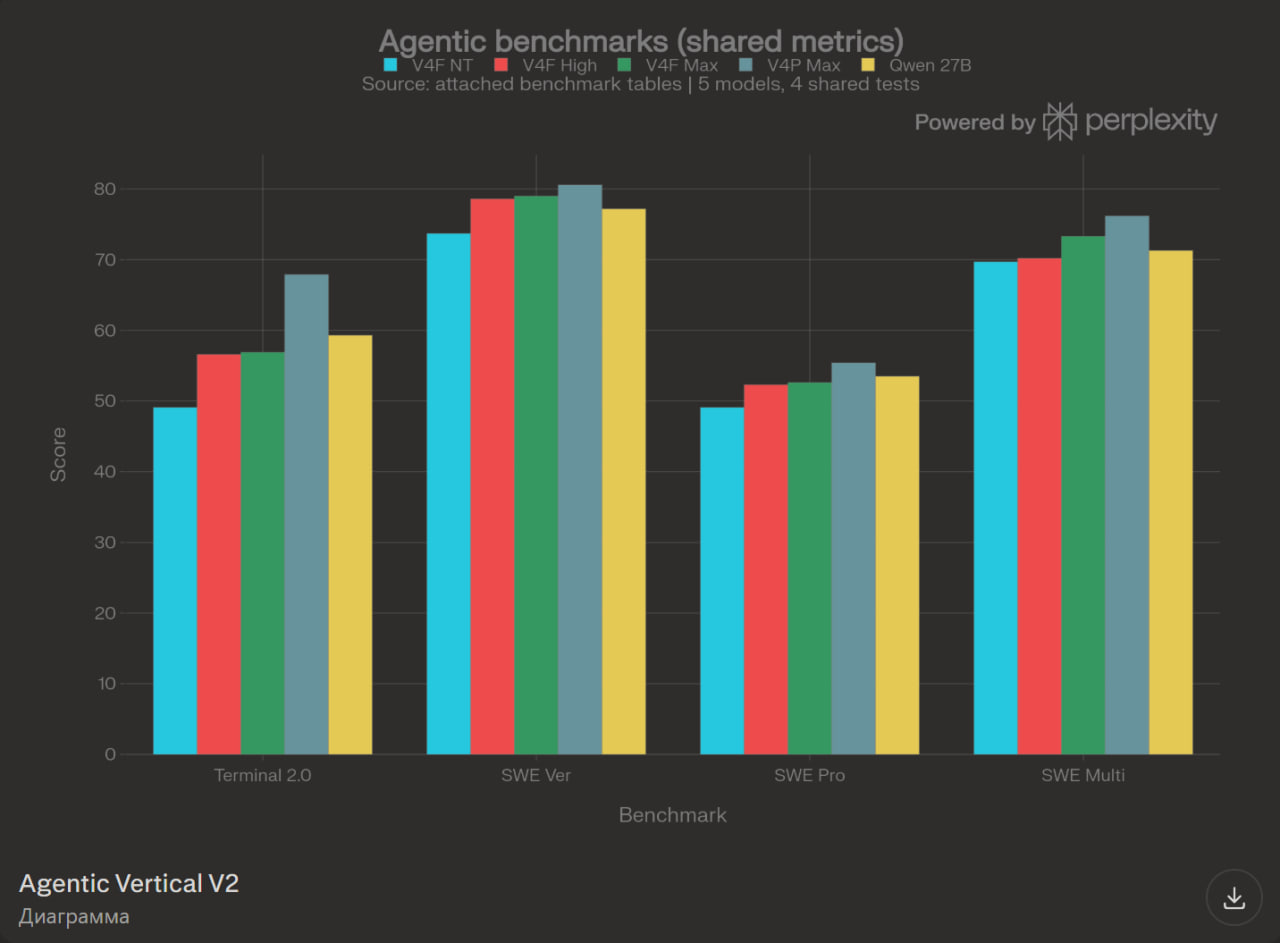

Надроченные бенчмарки ничего не значат, надо смотреть как на нужных задачах работает, зависит как от типа задачи, так и от длительности нужной.
Kimi 2.6 презентовали как аналог opus 4.7, а она элементарных вещей при работе моделью в агенте Opencode не понимает - что надо сказать юзеру что он забыл из plan mode в build mode переключиться после того как дал задачу что-то делать и 10 минут в размышлении мусолила пока я не остановил ее.
Такую элементарную вещь даже самые слабые модели делают без проблем.
Да, возможно докрутить скиллом можно, но такую элементарную вещь не делать из коробки и жрать впустую токены бесконечно рассуждая "Юзер сказал, но режим другой, проверю ещё раз" это дичь какая-то. Где она ещё так может споткнуться на элементарщине и выжрать тонну токенов?

В БигКодеБенч деградация это печально, Опусы 4.6/4.7 да же не представлены. SWE-Bench Pro и ЛайвКодеБенч не опубликованы вообще что, что вызывает подозрение в слабых результатах. В кодефорсе лучше 5.4 хуже 5.5. Верифед средне, Терминал бенч средне, но лучше квин 3.6.

Мое наблюдение:
Примерно месяц назад обнаружил, что чат с DeepSeek перестал переполнятся даже, если решаешь задачу очень долго.
Кроме того скрипты на lua, питоне и функции на СИ DeepSeek стал писать без ошибок и вполне профессионально. Раньше делал много ошибок, но исправлял их.
Сейчас он сразу выдает несколько вариантов и анализирует их по скорости выполнения и затрачиваемой памяти.
Иногда, но редко, бывают ляпы, но у кого их нет.


Это все хорошо, как подписку на него оформить?? Потокенам не предлагать.
Выше я написал ответ DeepSeek на мой вопрос про новости.
Он ответил там на Ваш вопрос. - бесплатно в чате.
Мое впечатление от работы с ним:
Последнее время любые начинания в разработке сначала обсуждаю с ним.
Он замечательно находит нужные мне ссылки делает анализ возможных решений.
Если ошибается, то после указания на ошибку, он извиняется и исправляет ошибки.
Если предлагаю ему оптимизацию алгоритма либо другие варианты,
то он либо их принимает, либо говорит свое мнение,
почему мое решение не лучше.
В конце беседы он всегда подводит итог того, что достигли и дает некоторую оценку процессу беседы.
Правда, как вежливый собеседник, он скорее завышает свою оценку, делая собеседнику комплимент.


Из интересных моментов:
Это превью V4, будут тюнить.
Помимо 1.6T модели, которая вроде и есть в сети, но мало кто запустит, выпустили ещё и 862B params. Что ближе к оригиналу, надо разбираться что там к чему.
Нативной мультимодальности нет, т.е. скрин приложения ему не кинуть на правку, но команда DeepSeek обещает прикрутить.
Engram не прикрутили, но есть суперкомпрессия кэша.
В записках жалуются на сложность обучения большой модели из-за внезапной деградации знаний при небольшой активации.
Дообучали и в fp8 и в fp4.
Если честно, сомнительно, ставить некуда, а по апи не дешево. Но сам факт наличия такой модели внушает.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
DeepSeek представляет флагманскую модель искусственного интеллекта