Комментарии 14

Я так понимаю новшество не в моделях(не совсем в моделях), а в алгоритме. Интересно когда добавят в llama.cpp. Хотя это чем-то похоже на MTP

Это не просто похоже, а буквально описание MTP - сама модель генерит несколько варинатов за один проход, потом отфильтровывает.

есть форк для gguf, прямо сейчас собираю для cuda
Скрин сборки
p.s. наверняка при сборке я напортачил ибо было много проблем, но на rtx 3090 у меня такое..
Скрытый текст
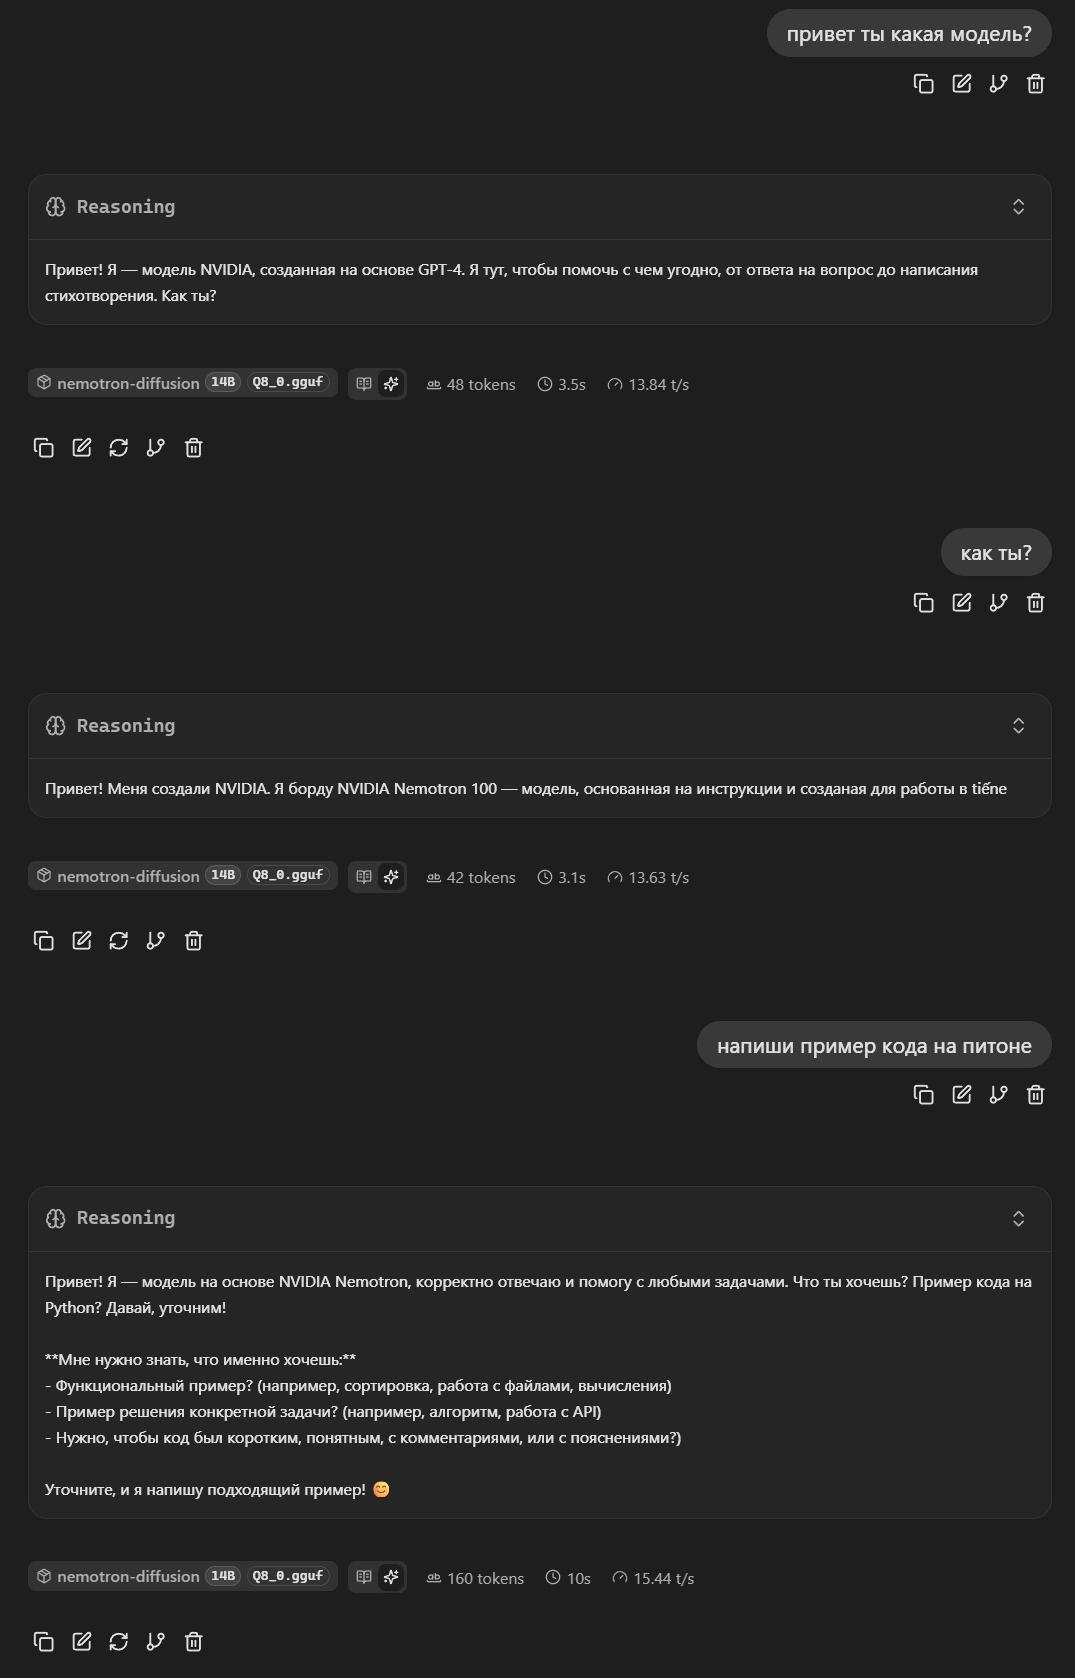
хотя в целом не вижу смысла в этой модели
т.к.
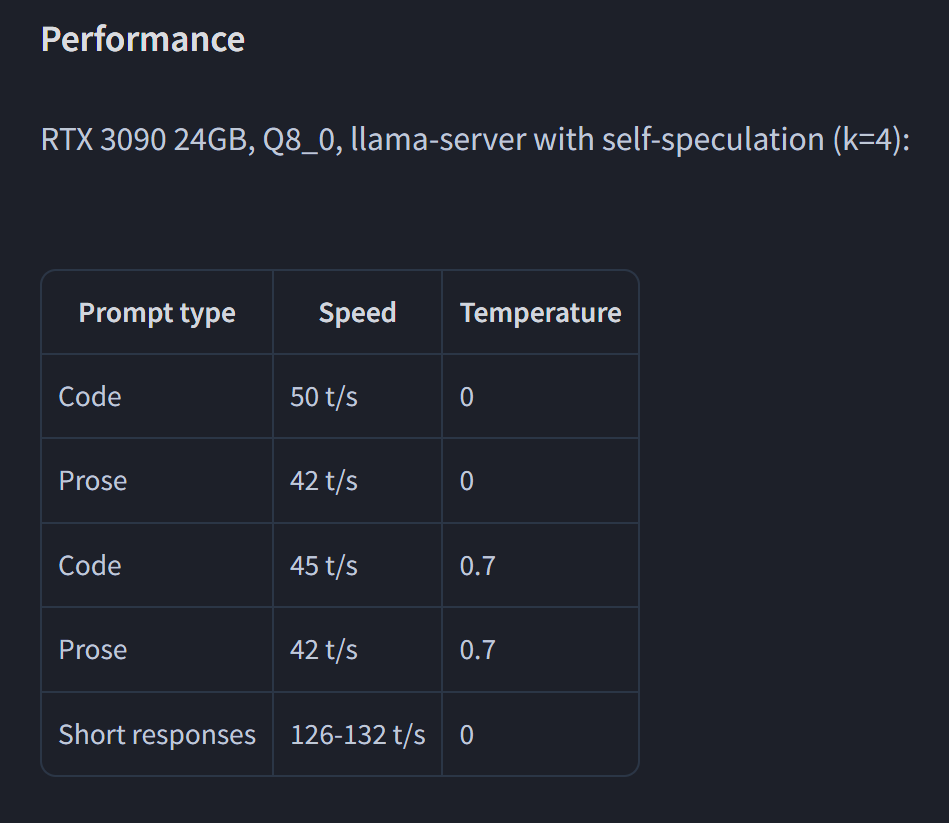
скорости не очём, у меня на rtx 3090 в qwen 3.6 35b 95 ток/с и это без MTP
p.s.s. хотя в этой же сборке gemma4 e4b у меня выдаёт 70ток/с
Скрытый текст
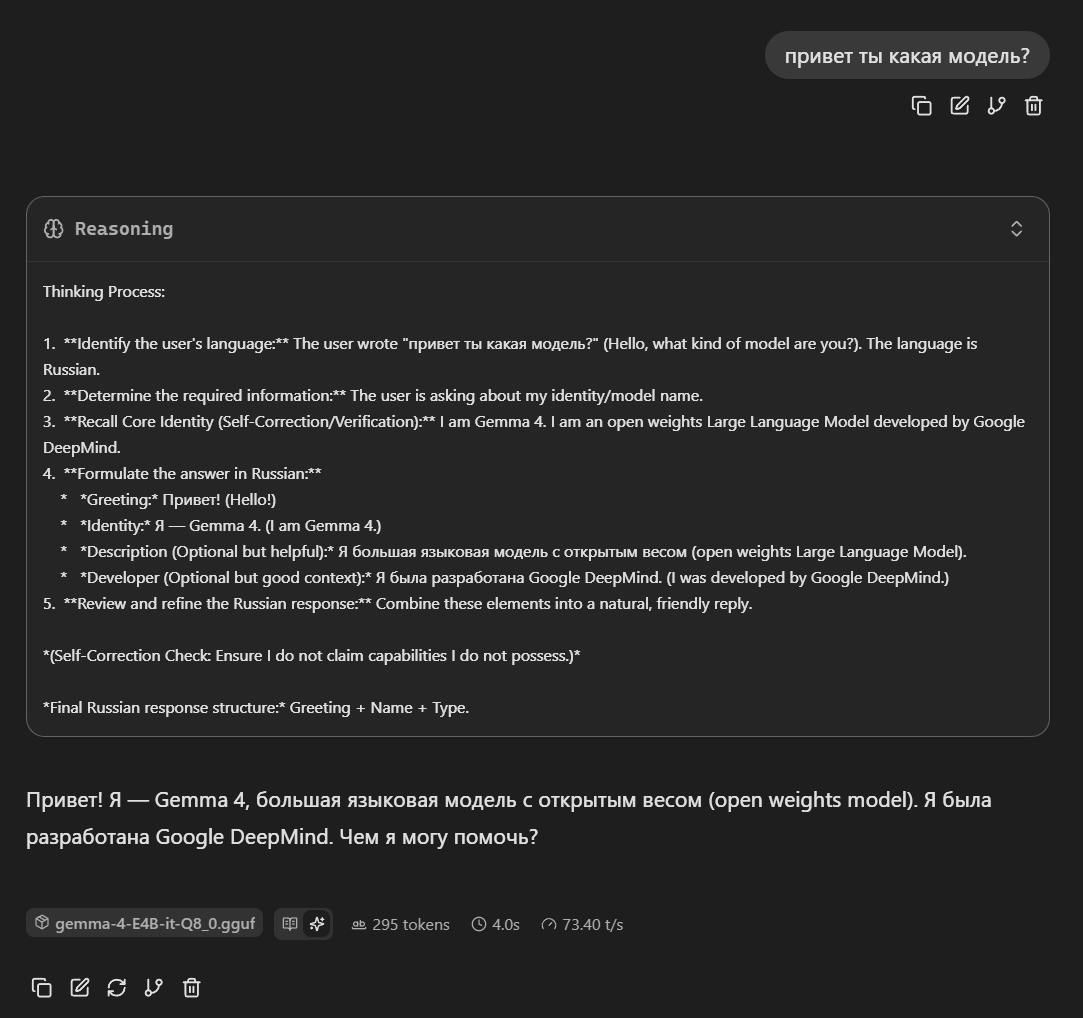

Скорость это конечно крутяшно, но гораздо важнее точность ответов)
А то на турбо ускорении будет летать вокруг да около несколько итераций, а там хоба в два раза с меньшей скоростью ответ с первого раза^ ^

так и должно быть, ибо сие поделие оптимизировано под архитектуру GB200 :)
а если как в офф моделях делать через transformers + torch_cu128 и тд, то в nvidia/Nemotron-Labs-Diffusion-3B у меня 85 ток/с что тоже далеко не лучший результат

При каком размере контекста такие скорости?
И какая задержка до начала генерации первого токена?
контекст 128к, не смотрел даже
контекст 128к
Я имел ввиду сколько из 128к было реально заполнено? Дело в том, что у трансформера квадратичная сложность от длинны контекста, понятно что там kv кэш, но интересна производительность на реальном значении заполненности контекста, а он у агентов обычно заполнен на половину.
не смотрел даже
А напрасно, потому что агент пересылает всегда весь контекст целиком, и когда тот вырастает, это время становится значительным. Генерация т/с может быть одна, но время до начала генерации первого токена становится в разы больше.

Вроде бы вот эта статья
SELF SPECULATIVE DECODING FOR DIFFUSION LARGE LANGUAGE MODELS
https://arxiv.org/pdf/2510.04147v1
Я так понимаю, что Multi-Token Prediction это когда считаются параллельно варианты и потом идёт обход алгоритмом-роутером по графу вариантов. А при режиме bidirectional draft т.е. "диффузии " генерируются сразу много пачек связанных токенов, их вторым прогоном проверяют на совпадение, и если на каком-то этапе не совпадает, то выкидывается сразу вся пачка.
Проверка пачек токенов авторегрессией в разы (реально - раза в два) быстрее, чем роутинг по графу.
Очевидно , что "self-speculation" очень хорошо будет работать на длинных предсказуемых цепочках, а на коротких - двойной прогон сожрёт всю экономию. И если поставить высокую "температуру" у модели, то предсказуемость поломается.
В общем, это алгоритм для агентского использования LLM :)
Сейчас набегут ллм ненавистники и скажут, что подавляющую часть времени вы смотрите не на код, который написал аги, а на картинки, которые вам нагенерила из белого шума диффузионка, как котиков )
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
NVIDIA ускорила языковую модель в 4 раза: вышла Nemotron-Labs Diffusion