Комментарии 16

Т.е. модель c на порядок большим числом параметров, Nemotron 3 Ultra (550B-A55B), превзошла gemma4 (26B-A4B или 31B) и gpt-oss (120B-A5B).
Если бы не превзошла - вот это была бы новость…

Так по скорости работы ведь превзошла, при большем количестве параметров. Но непонятно, на каком железе.

На порядок - это в 10 раз.

порядок это основание. Для десятичной системы 10.
Относительно gpt-oss в ней в 10 раз больше активных параметров. Относительно gemma4 - более чем в 10 раз больше параметров (а с 26B-A4B это справедливо и для активных параметров).
Т.е. каждая модель в чем-то на порядок (более чем в 10 раз) уступает. И каждая модель уступает просто в разы по прочим параметрам.
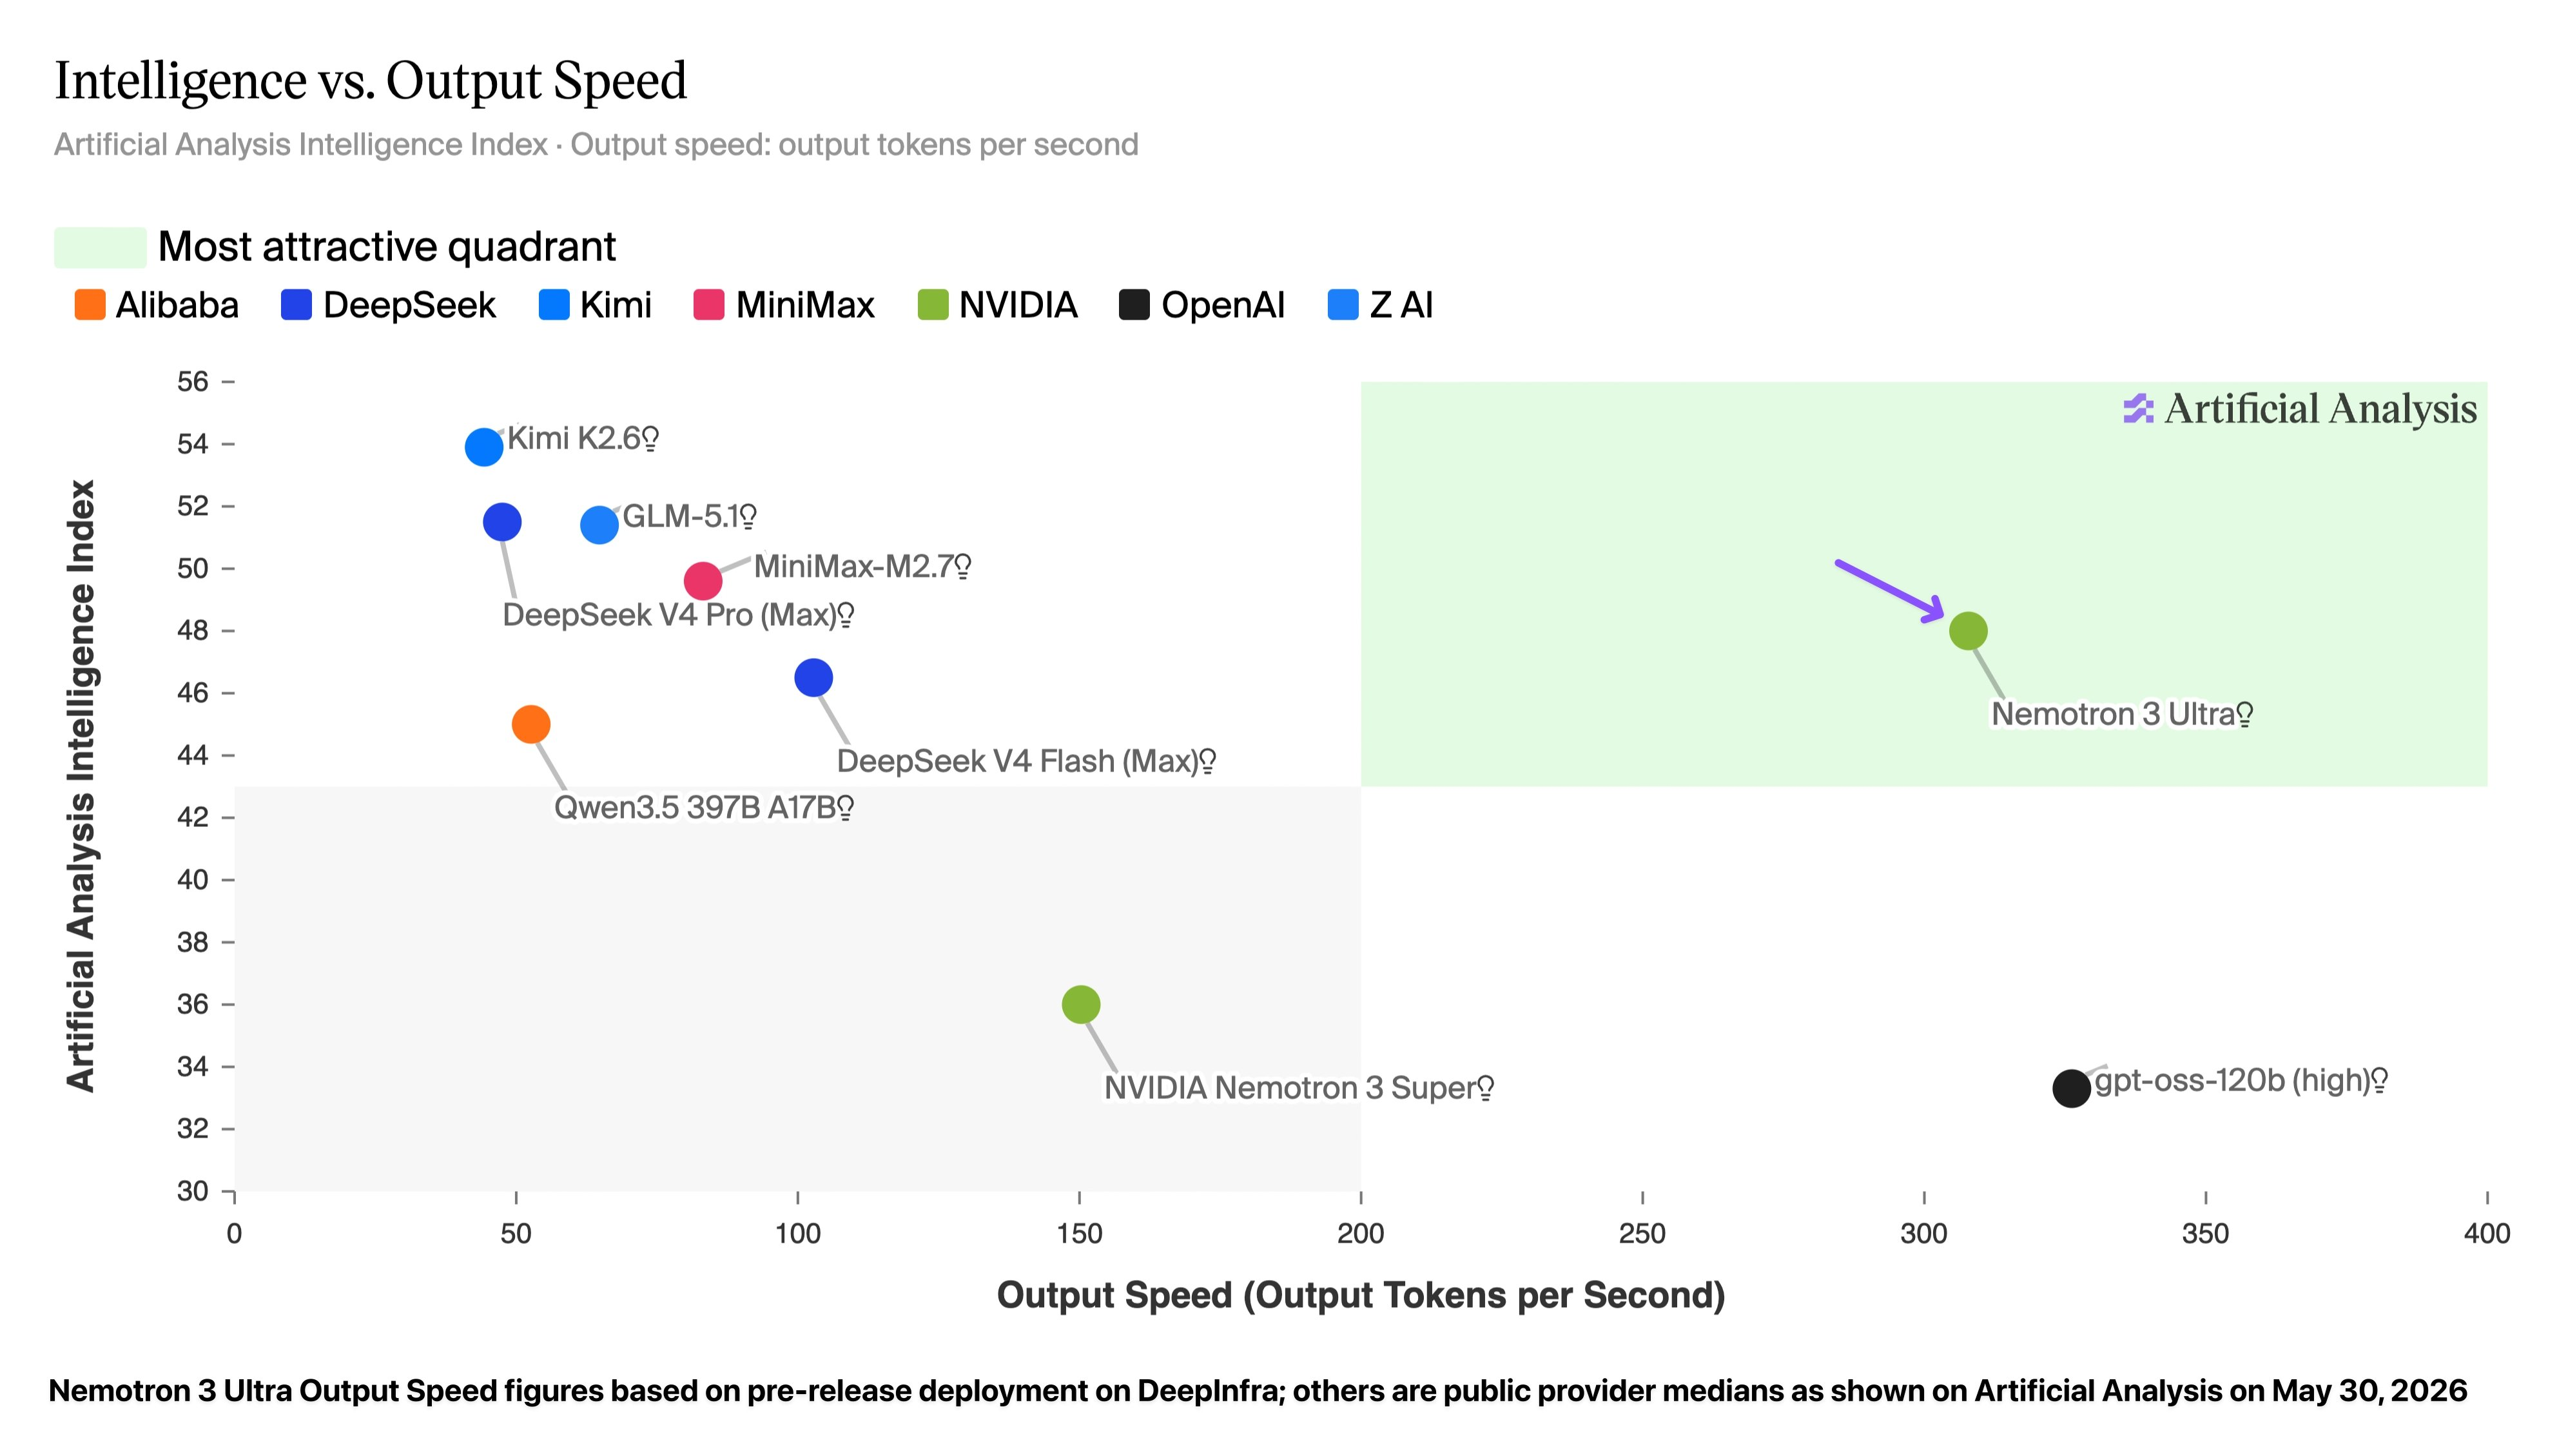
Получается, модель по этому индексу находится между DeepSeek V4 Pro DeepSeek V4 Flash (обе в максимальном "усилии" в токенах), но в 3 раза быстрее (на том же оборудовании).
Это на качестве квантования BF16 . Будет доступна версия с ещё более высокой скоростью инференса с квантованием NVFP4.

Ну вот Gemma 4 и gpt-oss-120b такие себе конкуренты в этом весе, а то что по скорости генерации при активных 55B параметрах обходит по скорости генерации Kimi 2.6 с 32B активных - уже интересно.

Neumotron есть и в удобоваримом весе около 30. Попробую посмотреть.

Немотрон вообще непонятная модель. Слабее китайцев существенно

У модели Neumotron 30 есть одна крутая особенность - она из коробки поддерживает контекст на миллион токенов. Другие открытые модели могут поддерживать миллион, но там надо прикручивать YARN...
Я это использую для работы с большими логами.

Qwen3.6 27B тоже обходит Gemma 4 и gpt-oss-120b, но при этом модель гораздо проще запустить, чем новый Nemotron
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Nemotron 3 Ultra стала самой мощной открытой моделью из США