Комментарии 52

да мы больше gguf ждём в 4 кванте))

Кстати, какой квант посоветуете? Я глянул юнисохов qwen 3.6 27b iq4_nl, но кажется с ним потребление Врам выше чем на q4
Запускаю в lm_studio на Винде
Предвосхищая вопрос, у меня семья 9 резидент проходит


Ну и в NVFP4 лично я.)))

Кто как. Я жду в FP8 веса с BF16 KV-кешем. В такой конфигурации все влезает в одну RTX A6000 без оффлоада и практически без потери точности (что-то около 1% потерь по сравнению с BF16). Q4 к сожалению сильно бьет по качеству на длинных контекстах.

Нужен nvfp4 от unslosh. Потому что пускалки gguf нормально с kv кешем работать не умеют. Осваиваем Vllm и радуемся
вполне себе llama cpp есть с турбоквантом итого q5_k_m + 256к контекста полностью влазят в rtx 3090 24gb vram (даже на вин 11 если закрыть большинство приложений, а q4_k_m ещё оставляет пару гигов запаса)
NVFP4 хорош если у карты есть его аппаратная поддержка, иначе никакой vllm не поможет (сам в большинстве случае использую vllm, но не с NVFP4).

Жду в 2 bit для 12gb vram
2 бита и на 8 gb отлично работает
p.s. но думаю для таких gpu лучше moe 35b, если ram хотя бы от 24 gb а лучше минимум 32

а можешь скинуть свою конфигурацию плиз, у меня 2 bit вылазит за пределы gpu. Сколько t/s выжимается?
всё в статье

Qwen 3.8 MoE надеюсь на очереди. потому как 27b хороши, но уж больно задумчивы на моем железе

Сейчас появляется много моделей класса 30B - это очень хорошо для рядовых пользователей. При умении от них можно получить очень много.


“должна стать самым мощным открытым решением для локальной генерации”. Открытые модельки с триллионами параметров скромно хихикнули.
Самым популярным или народным но явно не самым мощным. *тоже жду
Какая разница сколько да соседней звезды- 3.5 световых года или 4? Никакой- эти расстояния недостижимы в сегодняшних реалиях. Куда реальнее сгонять в соседнюю деревню на мотоцикле.))) Тоже самое и моделями с триллионами параметров для обычных людей.
27В многие запускают, практически народный размер. а 1-2Т конечно недосигаема. тем не менее разница все таки есть. если вы не запускаете дома такое, то оно вам и не надо. через апи зачастую дешевле выйдет. считал примерно 3090 генерирует примерно 3М токенов в сутки. я такой же объём куплю рублей за 10.
Можно скромно хихикнуть как и на чём запускать такие модели. 27B..30B даже в BF16 требуют всего H100 x1 (для квантов вроде Q4_K_M вообще потребительские игровые видеокарты), а для 1T параметров держать кластер дома никто не собирается. И при этом 1Т это всё равно не AGI, и мало чем лучше 27B. Тем временем простые модельки вроде Gemma или Qwen с каждым разом становятся всё лучше и уже почти не уступают гигантам.

У меня две 9060 xt по 16 гб каждая идеально работают с qwen 3.6 27b q8_0 mtp 35-40 t/s аутпут. Запускать еще уметь нужно.

А зачем вам именно восьмой квант? Между ним и шестым квантом разница очень небольшая.
Меньше галлюцинаций. А если меньше галюников то и производительность выше т.к. после определения галюника нужно итерацию агента заново запускать.
Для 8 кванта какое у вас окно контекста на вашем оборудовании? У меня 100к и мне для агентских задач иногда не хватает.

А входящие токены с какой скоростью обрабатываются?

У меня примерно похожая скорость генерации на двух mi50 по 32Гб каждая (vllm). 16 гиговые думаю 15-20 t/s могут дать...
Хотя, с 128к контекста похоже даже на двух 16Гб картах можно получить примерно теже 30-40 t/s, на GPTQ-Int4.
Попытался сэмулировать 16 гиговые карты. Выставил --gpu-memory-utilization 0.48, rocm-smi показал VRAM% 47% на обоих картах.
Запускал с --kv-cache-dtype fp8 --tensor-parallel-size 2 --max-model-len 132144 модель Qwen3.6-27B-GPTQ-Pro-4bit
Получил: Avg generation throughput: 37.4 tokens/s.
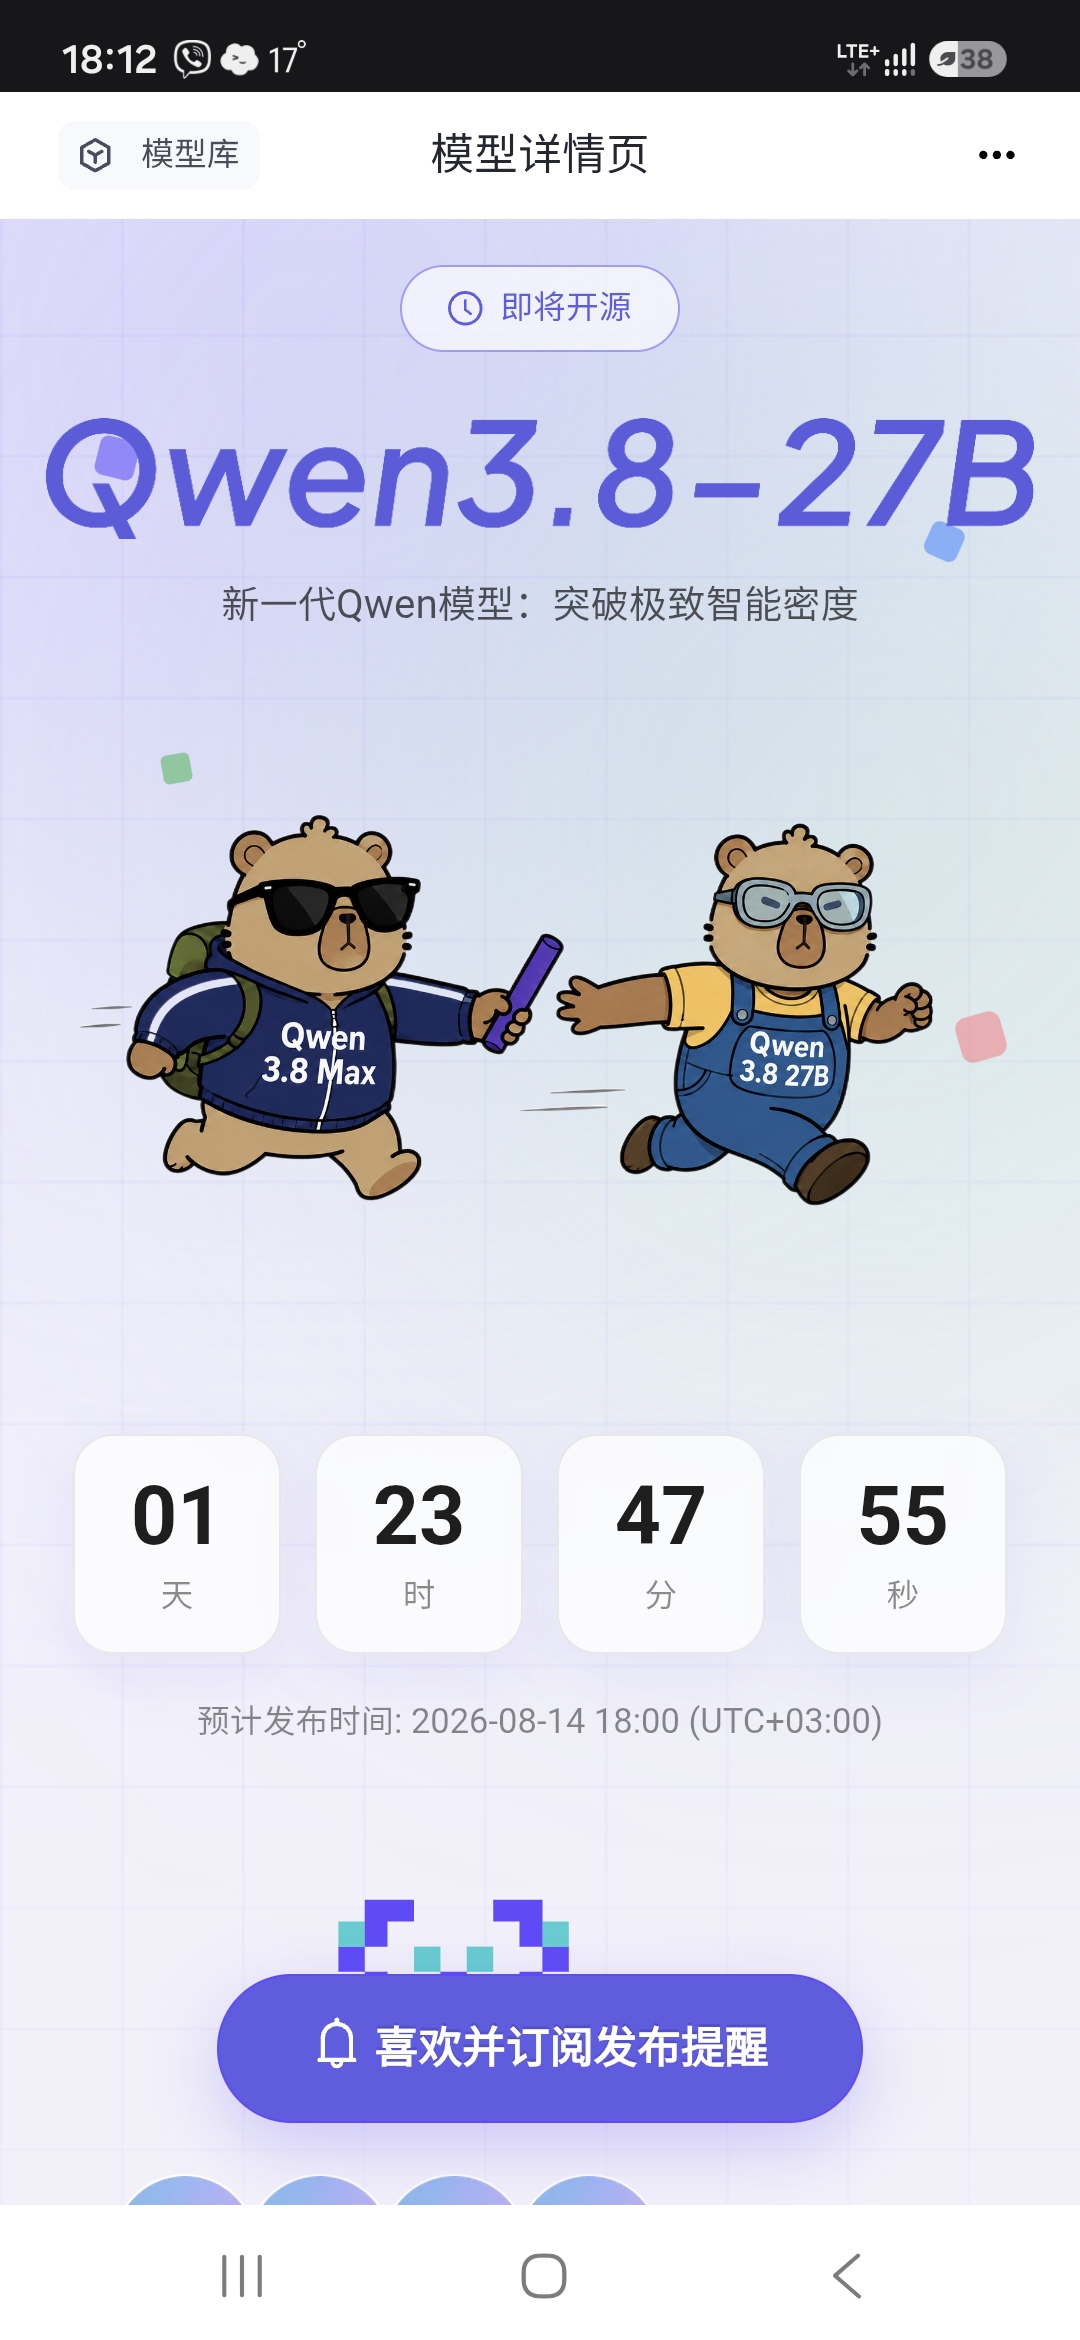
Мне оригинал с маскотами нравился больше, успел заскринить.

а что будет с ценой на апи после выхода 3.8? она упадёт или вырастет?

"Галя, у нас отмена!" - 404 на hf


интересно 35b будет?

Тут есть намек на то, что будет

А тут намек, что не будет ((( https://github.com/modelscope/ms-swift/commit/a45f1d4f73157ba59062a7fd1f55a40dae759156
Ну или решили подержать интригу
Выложили таки! Ура, товарищи!

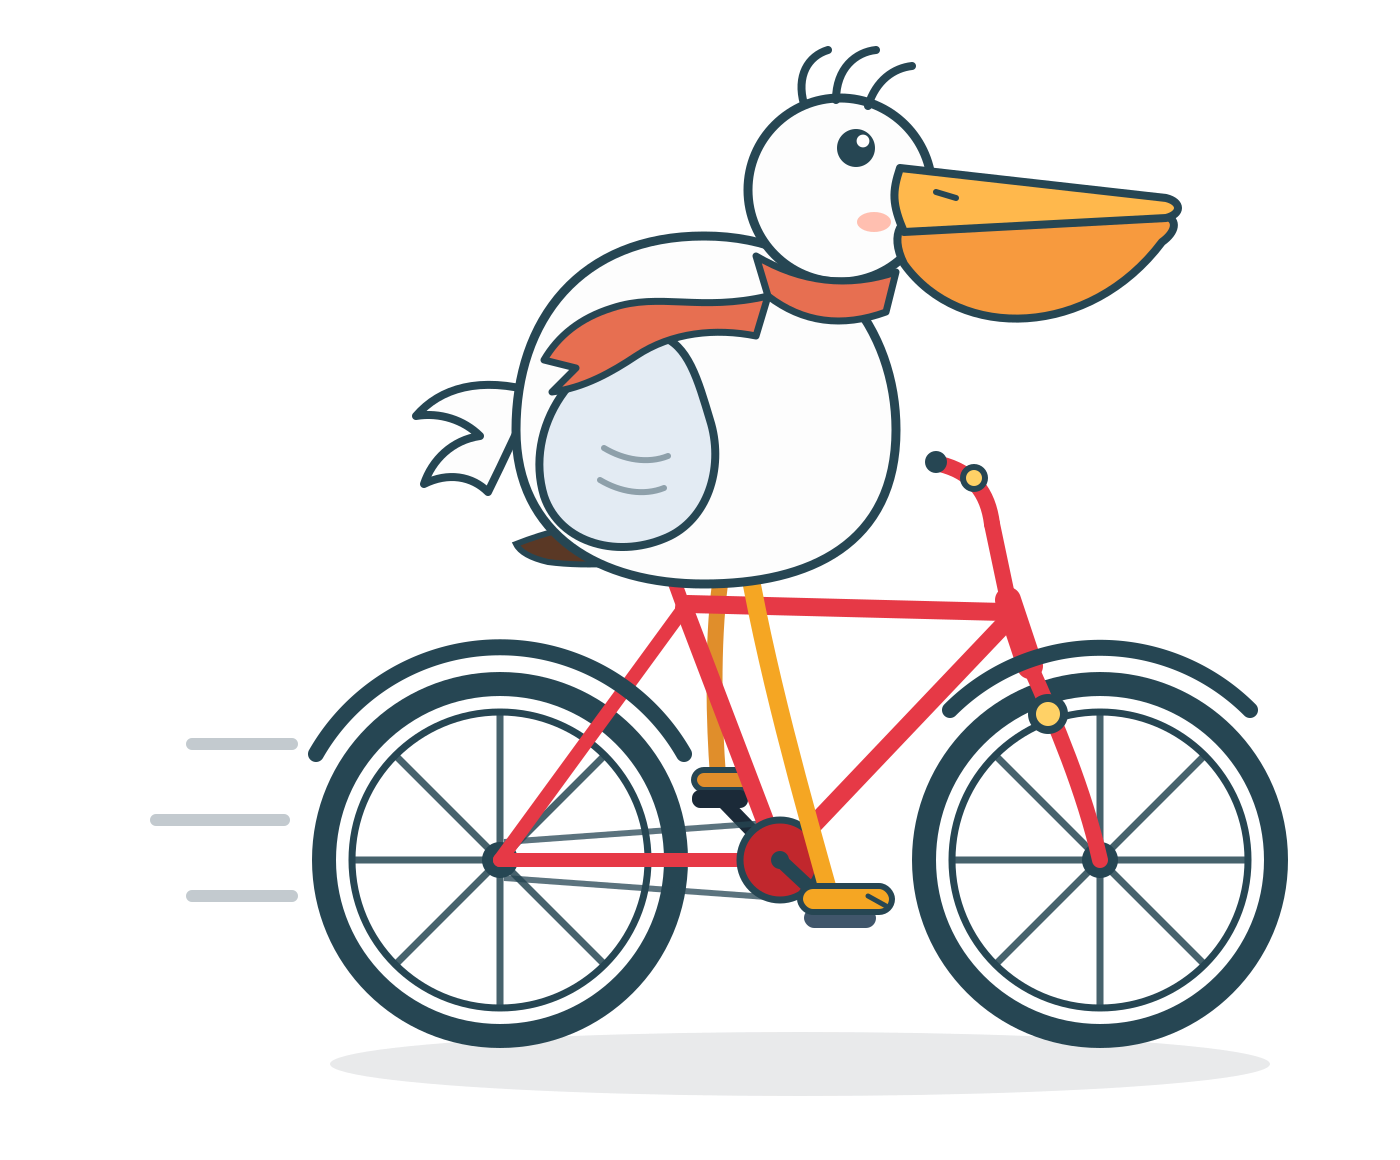
Generate clean SVG code for a whimsical illustration of a friendly pelican riding a vintage bicycle, transparent background, minimalist vector style "Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Qwen 3.8 27B — сутки до выхода модели. На huggingface запущен обратный отсчет