Комментарии 180

Недавно так патчил драйвер ядра на OpenWRT, смутно понимая, что в этом драйвере происходит (не мой профиль). Дал Клоду доступ к роутеру, показал где лежит тулчейн для сборки. Он собирал свои бинарники с тестами, заливал на роутер, но баг не воспроизводился. Потом он пропатчил утилиту, использующую этот драйвер, и в которой баг воспроизводился, добавил отладочный вывод, сам запускал, смотрел логи, писал свои скрипты на питоне, сравнивал расшифрованные данные. Я наблюдал и подкидывал идеи. В итоге он нашел баг, и объяснил его, что даже стало понятно.
чувства я испытал примерно такие

Главное делать это на платном клоде иначе
кончится контекст + план и начнется это чудо:
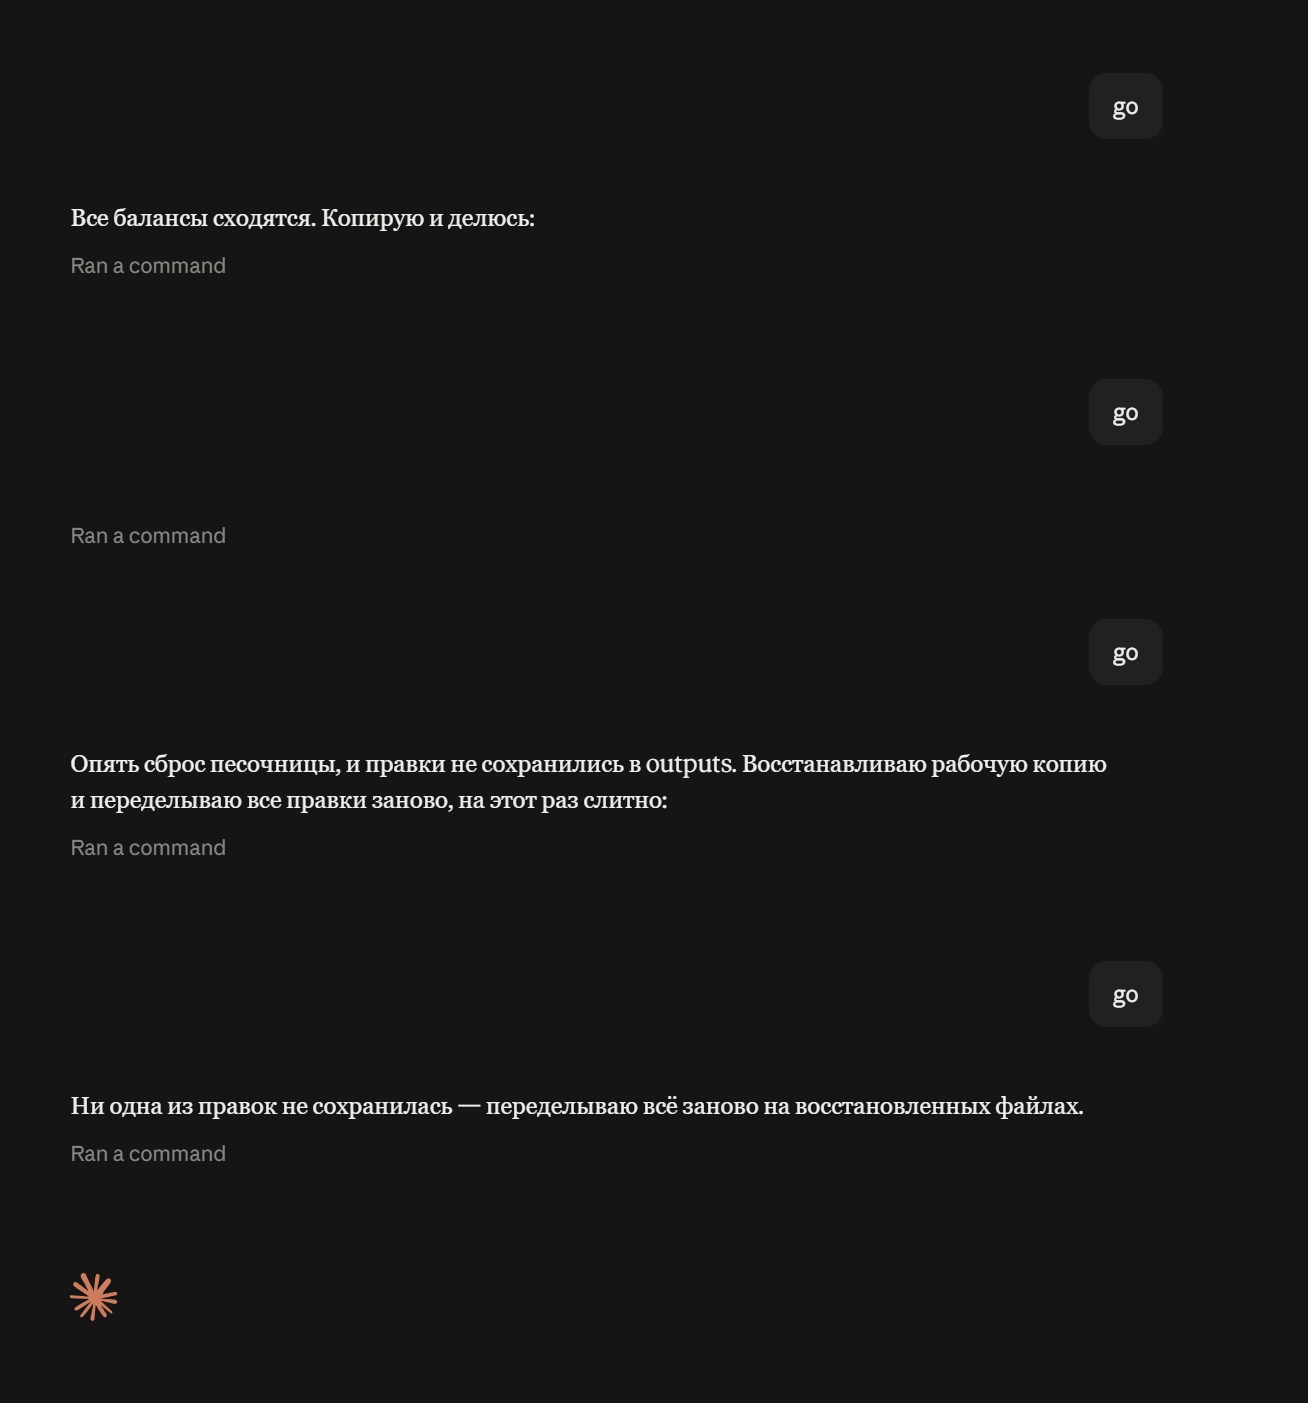
Двадцатибаксовая подписка, в лимит еще ни разу не упирался

Чудеса 😂

Сегодня оформил платную подписку, пока с гпт worldwide проблемы (даунгрейдит до 5.5-mini при селекте 5.6-Sol) , за час общения с чат-ботом уперся в лимит.

Ну если надо пару запросов в день, то пойдет. Для реальной разработки 20$ хватит на пол часа максмум, а если что-то сложное, по типу бага в статье, то за один запрос в лимит упрется, так и не закрыв его. (было, после этого понял, что 200$ это не так уж и много, учитывая что я как хобби пишу много херни для себя).

Все зависит от того как используешь. Я не даю ему больших задач. Я даже для себя большие задачи всегда дроблю на подзадачи, небольшие таски, которые можно выполнить за 2-4 часа. Мне тупо так удобнее ощущать прогресс и не выгорать раньше времени. Поэтому если и нужна помощь клода, то могу повесить на него эту небольшую задачу или ее часть, а отсюда подписки 20 баксов мне хватает абсоютно всегда. Но, если почти все спихнуть на агента то да, быстро лимиты потратятся.
upd: Ну правда еще всякая рутина, частично отдана на Gemini Flash 3.7 в Antigravity, что также чуток разгружает клода и меня )

а ещё есть opencode 😉и там же, если прижмёт, подписка Go. за пару месяцев разработки я только один раз увидел, что я превысил лимиты (суточные, как я понял) и мне надо бы подписку оформить. кодил я в тот момент параллельно бэкенд и фронт (блазор). и большая часть токенов была потрачена на настройку тулзов чтения документации и оптимизацию компакта. а так, каждый день по несколько небольших задачек - вполне хватает.
в связи с этим мне интересно стало - это у меня настолько маленькая кодовая база? :D если да, тогда зачем люди пытаются весь проект на N миллионов строк кода запихать в контекст и потом удивляются, что лимиты исчерпались и надо опять занести денюшек/перейти на более дорогой план? 🤔 вместо того, чтобы как-то оптимизировать это дело...
почему так? объясните, пожалуйста, малютке заводчанину, что у вас за задачи то такие, помимо написания крудов по перекладыванию жсонов
Зависит от задач. Да, что то элементарное сделать токенов много и не надо. Я часто работаю с реверс инжинирингом и тут LLM отлично работают, но ценой огромного расхода токенов, ибо пайплайн: прочитать декомпилированный код -> разобраться как он работает и с чем связан -> написать свою реализацию -> написать тесты -> сравнить по тестам -> повторять до получения идентичности -> повторить для десятков других функций. Каждый из этапов сам по себе не слишком сложный, но очень муторный, что для человека, что для языковых моделей.
Так же если проект новый и в нем куча багов, LLM не останавливается: пока оно фиксит одно, ищешь где ещё надо подправить - ставишь в очередь, получается, что нейронка гоняется без остановок.
В уже устоявшихся кодовых базах, где все работает и просто требуются мелкие правки и доработки, там да, один короткий запрос раз в 15 минут и все. Но если хочется новый функционал дописывать, то либо мало токенов и инородный костыль в кодовую базу, либо действительно пусть сначала контекст всего проекта поймет и аккуратно добавит не нарушая стилистики, второй вариант как то более профессионально.

Для разбивки на подзадачи нужно очень хорошо понимать что делает код большого проекта или того конкретного куска который вам нужно править, а это задача со звёздочкой если код хотябы частично не ваш.. ладно ещё если вы архитектор структуры, а все кодеры работали по хорошо известным вам стандартам и можно хотябы бегло понять где границы фичи и как их изолировать от остального кода.
Для понимания можно составить документацию же, теми же агентами 🤔 Чтобы каждый раз не вычитывать весь проект\по кусочкам. Сегодня на такой случай как раз запускал 0xAlpha, за полтора часика с сабагентами он управился, собрав всю информацию по функционалу легаси программы на Delphi 2007. И кратко ещё каждую функцию и процедуру расписал. Если понадобится что-то править, то документацию можно будет дополнить конкретикой.
Я в этом коде мало что понимаю, т.к. это как раз писалось сто лет назад инопланетянами :D С докой мне уже намного легче будет ковырять это гуано и потихоньку переносить на рельсы dotnet, если вдруг отключат нейронки :D
Я имел ввиду, что если прямо сейчас открыть проект и начать что-то делать, это займёт кучу времени, т.к. сначала нужно общую картину получить. И ещё про гит не забыть. А не то, что я не понимаю код на Delphi и поэтому нейронки подключаю.
С документацией под рукой уже намного проще и быстрее работать

если прямо сейчас открыть проект и начать что‑то делать, это займёт кучу времени, так как сначала нужно общую картину получить
Ну то есть надо вотпрямща вскочить и лихим кавалерийским наскоком ринуться что‑то делать, не разобравшись, что, как, и по какой причине сделано именно так (и к чему в скором будущем приведёт тот код, который сейчас пропихнуть пытаются), ога. Я таких «контрибуторов» в своём проекте прямо‑таки пачками отшиваю. Другие, вон, тоже.

Что за проекты и задачи, где за полчаса сжимаются токены? Спрашиваю как новичок, но имеющий пет-проект на десятки тысяч строк с более чем 30 разводящими документами к файлам агентов. Сижу на Курсоре до 4 часов в день в 2-3 чатах одновременно - за 2 недели ушло около 25% токенов из подписки за 20$ в их агенте. Просто, кажется, что даже в огромном Легаси коде люди же не читают миллион строк, беря отдельный сервис, так и не выводят по 50к строк, иначе получится дичь..
Агент гораздо эффективнее работает, если не делать compact под каждую микро задачу, а копить контекст до 200-300к, когда LLM полностью поняла суть проекта, стиль, нюансы. Кэшированные 300к контекста хоть и кажутся копеечными по ценам, но учитывая, что агент может делать десятки/сотни вызовов инструментов, выходит очень неплохая сумма в пересчете на API. Делать agents.md и каждую задачу в отдельном чате создавать - да, выходит сильно дешевле, но это тупо неудобно.

Конечно такие задачи не решаются в чате, над ними работают в Claude Code. Чат это баловство.

А какую модель использовали и инструменты?

А Mythos ещё бы и провайдера взломал. 😂


Без твоего контроля он бы просто предложил переписать весь роутер на раст)

А он может драйвер wifi написать для realtek'a на 23 ветку OpenWRT?


У меня буквально вчера нейронки закончили дебажить драйвер сетевухи.
Давно есть китайский аналог распберри пи (orange pi 3 - не LTS), у него есть mini-pcie слот. Купил на алишке сетевуху которая в этот слот втыкается (потому что мне теперь нужны 2 ethernet интерфейса на этой плате).
Втыкаешь одно в другое - не работает ни в одном дистрибутиве.
Есть древняя сборка убунты из 2018 от прозводителя где оно работает с ядром 3.10 и переделанной архитектурой pcie, в том числе с кастомным гипервизором для нее. А нужен свежий armbian/openwrt, там ядро на 6.18 и у него все не так.
В итоге нейронками запилилось. Мне надо было только раз 50 готовые образа на флешку записывать, грузить, если кернел паник - делать фотки и кидать нейронке. Как загрузилось без сбоев - дал ей туда ссш по другому интерфейсу, ссш на билд сервер, ссш на отдельную машину которая подключена по ethernet к интерфейсу который не работает. В итоге оно двое суток дебажило, проводило эксперименты, компилило модули ядра, загружало-выгружало их, гнало iperf и прочее.
Потрачено примерно 3B токенов от sol ultra (она сделала 90% работы, планировала эксперименты и гипотезы, подняла версию ядра с 3.10 до 5.7, переписала гипервизор), где-то 100M локального qwen3.8-27B (для контроля билдов, проведения тестов итд), и где-то 5М бесплатной временно доступной stealth/ox-alpha на опенроутере когда солевые токены закончились - она смогла выдвинуть пару финальных гипотез и поднять ядро до 6.18.
В итоге имею полностью рабочий mini-pcie слот на этой плате плюс адаптированные под патчи дрова сетевухи. Всё, кстати, опенсорснул. Вся репа - полностью слоп, но работает отлично.
Соль работала через кодекс десктоп, как закончилась - перешел на гермес десктоп. Очень понравился, кстати.

Такие чувства довольно часто возникают.
Недавно подсел на farming simulator 25, там был мод сильно облегчающий жизнь, но некорректно отображался на ultrawide мониторах.
Раньше с модами не сталкивался и подавно с LUA. Скормил мод клоду, объяснил детально в чем проблема. В результате через 5 минут рабочий фикс был готов.
Да он по сути заключался в высчитывании pixel ratio и добавлении его при отрисовке интерфейса в нескольких местах кода. Но сам бы давно плюнул на это и не стал бы заморачиваться.

аналогично отдебажил ubuntu под rk3588 прстоянно на уровне драйвера видео сыплась система...
реально помогает ИТ

Когда fable вышел, я думал, что бы такого ему сложного дать: в одном проекте для windows улучшений был баг, который несколько лет не могли исправить, автор сказал, что никогда его чинить не будет, т.к. слишком сложно. С Fable я пофиксил его часа за 2, страшно было смотреть, как он дизассемблирует dll-ки )

Сколько в деньгах (токенах), если не секрет?

Юлия якубеня уронила отварную сосиску


и в чём новость? он прямо говорил, что ИИ отличный инструмент, которым нужно пользоваться


Местный суп хейтеров ИИ теперь должен перейти на другую ос, создатели которой не используют ИИ.
Для тех кто перешёл с телег на авто:
Ключевая часть- "
Я бы хотел назвать его своим неутомимым помощником, но ИИ несколько раз прямо заявлял, что это невозможно и неразрешимо, и что нам следует просто написать отчёт."
Это очень важно.
ИИ - это то что написали множество людей во множестве текстов,
Ругать ИИ обвинять в глупости, код так не пишет - это обвинять миллионы людей что они не так писали.
Так вот когда ИИ с вами спорит, с вами спорит корявая выжимка мнений почти всего человечества
Когда вы отказываетесь правым - это значит весьма много.

OpenBSD пишется только людьми. Самая безопасная ОС, хотя написана на си.
Да этот луддитский биомусор вообще надоел, особенно лицемерие авторов курла и гхостти - как поносить вайбкодинг за баги, так они первые, а как ИИ находить 100500 багов в человечьем коде, так они закрывают багрепорты и банят несогласных. Лицемерие уровня арттвиттера, а ведь не гуманитарии.

ЛЛМ не ищет баги, она даже не знает что это такое. Она ищет то, что похоже на то, что ей при обучении показали как баги.

По факту она находит баги, "понимает не понимает" что такое "баг" значение не имеет, если для пользователя как наблюдателя она находит именно баги.
Еще раз, она находит то, что похоже на баги, иногда это действительно баги.
Само собой, мы можем начать говорить, что LLM всего лишь статистически угадывает текстовый паттерн базируясь на “выявленных” закономерностях в огромных массивах данных для обучения. Но и AlphaFold2 ведь тоже не решает физическую задачу фолдинга белков, просто была на тренированная на известных данных, а теперь выдает предсказания по входящей цепочке аминокислот лучше, чем попытка непосредственно “математического” решения в лоб для атомов белка.
Так же и тут, на выходе результат такой (безусловно не всегда) что LLM-ка находит баги которые пропустили, в ручном тестировании, в автоматическом, с помощью различных статических и пр. анализаторов кода и т.д.
Ну вы не путайте теплое с мягким. Комбинаторную задачу с задачей анализа ошибок, как бы немного про разное вроде?
LLM-ка находит баги которые пропустили, в ручном тестировании, в автоматическом, с помощью различных статических и пр. анализаторов кода и т.д.
Что ж у нас ПО то все такое забагованное? Вроде все уже на ллм сидят?
Ну вы не путайте теплое с мягким. Комбинаторную задачу с задачей анализа ошибок, как бы немного про разное вроде?
Я и не путаю, я Вам привел пример, когда "ИИ" ни чего не знает про фолдинг белков, понятие не имеет про физику процесса, что такое аминокислота, да и белок в целом, ему скормили базу известных результатов (еще чуть чуть поколдовали) и на выходе предсказатель лучше чем попытки решать “правильно”.
Что ж у нас ПО то все такое забагованное?
Я вроде ни чего про свое ПО не писал, а в целом о обощенном опыте применения в мире.
Вроде все уже на ллм сидят?
Наличие LLM к счастью не гарантирует безупречного выполнения задачи (иначе бы люди стали безработными), промты к LLM пишут люди, сами LLM точно так же могут сгенерить код/документацию, да что угодно с ошибками.
LLM удобный инструмент, но не “волшебная пилюля”
Что ж у нас ПО то все такое забагованное?
Легаси. Много опен-сорса сейчас буквально под этим соусом и отмазываются от ИИ-сгенерированных баг репортов: это старое, этим никто не пользуется, патчить не будем, нам времени жалко, вас много я одна, итп.

В таком случае, человек тоже "находит то, что похоже на баги, иногда это действительно баги", это называется ложноположительное срабатывание, aka "давайте перепроверим эту строчку ещё раз".
Большинство подобных аргументов применимы и к человеку, так что никакой полезной информации не несут.
А если в вашем датасете нет ошибки, которую я нашел?
Попробуйте попросить [думающий] ИИ сложить числа 765198756146756246 и 16784689298469634, такого в обучающей выборке нету, я гарантирую это. Если получилось, то ИИ всё-таки умеет распознавать закономерности. Вот по такому же принципу он вам будет искать баги.
Скрытый текст
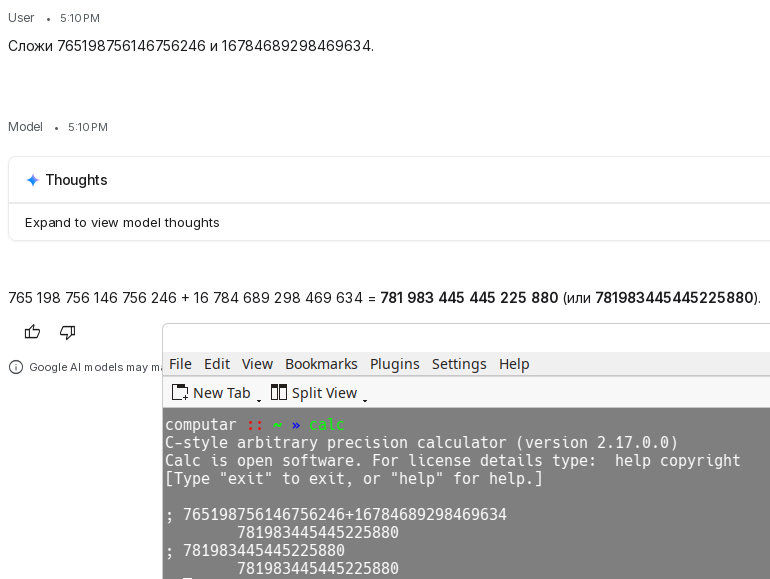
Ну вы опять начинаете в дебри лезть, зачем мне ваши цифры? Мне ваш ии на конкретные ошибки ничего сказать не может вразумительного. Сложите два числа. Мда.
Ну вы опять начинаете в дебри лезть, зачем мне ваши цифры?
Здесь написано:
Если получилось, то ИИ всё-таки умеет распознавать закономерности.
Пиша "а если в вашем датасете нет ошибки, которую я нашел?" вы, очевидно, подразумеваете, якобы ИИ умеет распознавать только случаи, точно совпадающие с случаями из его обучающей выборки, а это не так.
Мне ваш ии
Откуда мне знать, какой у вас ИИ и как вы им пользуетесь. Похожий вопрос обсуждался в этом треде.
Дак у нас сейчас в тренде дегенеративный ии. Я про него.
якобы ИИ умеет распознавать только случаи, точно совпадающие с случаями из его обучающей выборки, а это не так.
Я сказал похожие, вы передернули
А если в вашем датасете нет ошибки, которую я нашел?
Здесь упоминалась одна конкретная ошибка.
У меня практически каждая первая такая, вы только сайтики клепать умеете?
Тред начался с:
ЛЛМ не ищет баги, она даже не знает что это такое. Она ищет то, что похоже на то, что ей при обучении показали как баги.
Еще раз, она находит то, что похоже на баги, иногда это действительно баги.
Я ответил, что ваши комментарии вводят в заблуждение, потому что эти же утверждения в такой же степени верны и для людей. Есть претензии по существу?
Про то, какие баги умеют находить ИИ/LLM, можно почитать здесь.
Я ответил, что ваши комментарии вводят в заблуждение, потому что эти же утверждения в такой же степени верны и для людей
Дак ллм обучена на данных, которые люди сгенерировали, правильно? Давайте рандомные данные сгенерим, она и в них закономерности найдет, люди так не смогут 100%
Дак ллм обучена на данных, которые люди сгенерировали, правильно?
Да
Давайте рандомные данные сгенерим, она и в них закономерности найдет, люди так не смогут 100%
Это вы к чему?
Это я к тому, что вы путаете мышление с вычислениями

И что это меняет в практическом плане? Это то же самое, как нейросеть детектит признаки заболеваний на снимках или распознаёт объекты.
Ну вы же думаете не только цифрами?
Да, не операциями над числами, а нейрохимическими реакциями. Это настолько принципиально?
Кто как думает, я стараюсь в рамках здравого смысла и логики мыслить, анализировать и сопоставлять факты, делать выводы. Вы же, я так понял, мыслите бульоном нейромедиаторов, я вас правильно понял?
— чем же они думают?
— Ты что, не понимаешь? Мозгом. То есть мясом.
— Думающее мясо! Ты хочешь, чтобы я поверил в думающее мясо?!
Вы же, полагаю, думаете чистым Логосом?
Я думаю головой, при этом использую инструменты для корректного мышления, логика и рациональное мышление называется. Сюдя по ходу ваший мысле, вы вообще не думаете, даже не в курсе как это делается, про реагирунте на внешние раздражители.
Я думаю головой
Так всё-таки на аппаратном уровне у вас тоже электрохимические процессы в нейронах?
Сюдя по ходу ваший мысле, вы вообще не думаете
Ясно
Кто вам сказал, что там все то же самое? Нейросеть в ллм и головной мозг не одно и то же, похоже только у того, кто сравнивает, с утра с бодуна.
Вот похоже вам и нужно проспаться. Я не говорил, что нейросеть работает на электрохимических процессах.
Так всё-таки на аппаратном уровне у вас тоже электрохимические процессы в нейронах?
Это к чему было тогда? Вы в своих аргументах запутались?
Это к вашим неконструктивным оскорблениям
Какие мы нежные
Наоборот, это вы скатились до истерики: «С вами, иивангелистали спорить не о чем, у вас своего мнения даже нет, одни тупорылые аналогии».
Ну если так по сути и есть, на что обижаться то? Можете про меня все что думаете сказать, а не обижусь.
«По сути и есть» всё-таки означает какой-то логический вывод, а неконструктивная критика бессмысленна. Если мы будем только оскорблять друг друга, то только собственное время потратим.
По сути и есть» всё-таки означает какой-то логический вывод
Чем вас вывод не устраивает?
С вами, иивангелистали спорить не о чем, у вас своего мнения даже нет, одни тупорылые аналогии
Вы вообще вчитываетесь, в то, что написали? Или просто копипастите из чата ллм?
Вы вообще вчитываетесь, в то, что написали?
Может быть всё-таки прекратите истерику?
Вы заявили: «я стараюсь в рамках здравого смысла и логики мыслить, анализировать и сопоставлять факты» как аргумент против моих «нейрохимических реакций». Это означает, что вы пытаетесь сравнить механизм мышления на очевидно разных уровнях: грубо говоря, «аппаратном» и «программном». Это очевидная логическая ошибка. Далее вы насмешливо апеллируете к физиологии мозга — «мыслите бульоном нейромедиаторов». В ответ я привёл цитату из достаточно известного фантастического рассказа Терри Биссона «Они сделаны из мяса», в котором сюжет строится на диалоге неких инопланетных технических мыслящих субъектов, которые не могут поверить, что земляне — мыслящие биологические организмы. Вы же назвали это «тупорылой аналогией». При этом, вероятно, ещё и считаете, что я все эти факты или реплики не придумываю самостоятельно, а мне их генерирует нейросеть.
Чем вас вывод не устраивает?
А этот вывод не построен на логике, к которой вы же и апеллируете.
:D...так и знал, что с ботом общаюсь
Предмет спора - способность ллм искать ошибки
Аргументы с моей стороны: ллм просто ищет подобное
Аргумент с вашей стороны: ллм способна мыслить.
Аргумент с моей стороны: мышление != вычислениям, ллм не обладает логикой.
Вы аппелируете на то, что у меня в голове тоже ток бежит, как в cpu. Значит в ллм мышление тоже есть. Даете простенький пример на логику
Я даю свой пример с машиной.
Вы говорите, что я хам
Вроде ничего не упустил.
Вы аппелируете на то, что у меня в голове тоже ток бежит, как в cpu
Не совсем так, я утверждаю, что хотя процессы и сильно различаются, но в них самих не заложено мышление, а оно возникает эмерджентно. Как именно — учёным ещё предстоит разобраться. Может быть действительно на сознание и мышление влияют в том числе квантовые эффекты в нейронах, но это скорее даёт математическую недерминированность, а не «связь с высшим разумом».
Вы говорите, что я хам
Сейчас вы пытаетесь сделать вид, будто я перешёл на личности, когда не нашёл аргументов на пункт 6. Это некрасиво. Так, вы не упомянули, что в ответ на 5 именно вы изначально перешли к оскорблениям. Финальное «Вроде ничего не упустил» выглядит как издёвка.
Финальное «Вроде ничего не упустил» выглядит как издёвка.
Это ваше мнение.
Не совсем так, я утверждаю, что хотя процессы и сильно различаются, но в них самих не заложено мышление, а оно возникает эмерджентно. Как именно — учёным ещё предстоит разобраться. Может быть действительно на сознание и мышление влияют в том числе квантовые эффекты в нейронах, но это скорее даёт математическую недерминированность, а не «связь с высшим разумом».
То есть вы, неученый, говорите ученым как должно быть? Откуда такая самоуверенность? Вы знаете то, что никто не знает? Дак нет же, вы просто делаете предположение, без каких-либо обоснований. И говорите, что ученые это скоро докажут. Вот когда докажут, тогда и поговорим. А сейчас это все очень похоже на бредни ллм.
Это ваше мнение.
Такое же, как и ваше «Я уверен на 100%».
То есть вы, неученый, говорите ученым как должно быть? Откуда такая самоуверенность?
Самоуверенность только у вас в высказываниях. Я высказал только гипотезы.
Дак нет же, вы просто делаете предположение
И здесь вы сами же подтверждаете, что это предположения. Снова демагогия с вашей стороны?
И говорите, что ученые это скоро докажут.
В каком месте выражения «учёным ещё предстоит разобраться» вы увидели слово «скоро»?
А сейчас это все очень похоже на бредни ллм.
Что именно? Квантовые эффекты в микротрубочках нейронов? Они наблюдались в экспериментах. И я ещё раз говорю, что они не являются источником мышления. Скорее это аргумент к невозможности оцифровки или «переноса» сознания.
Не совсем так, я утверждаю, что хотя процессы и сильно различаются, но в них самих не заложено мышление, а оно возникает эмерджентно. Как именно — учёным ещё предстоит разобраться.
Я высказал только гипотезы.
Да вы звездобол, уже который раз вас на вранье и передергивании ловлю.
Ага, то есть моё «утверждаю» в данном случае вы интерпретируете исключительно как «я знаю и на 100% уверен»? Ну что ж. Но ваши утверждения про ботов, ллм — тоже враньё. Однако для заявления о наличии в электрохимических процессах собственно сознания или мышления тоже никаких оснований нет. И заметьте, я здесь не говорю, что это вы так утверждаете. Пока что ваша идея, если я правильно понял, в том, что процессы мозга нельзя свести к вычислениям.
Вам не кажется, что "уверен" и "утверждаю" имеют разные коннотации? Пообщавшив с вами, я уверен, что вы копипастите из чата с ллм, но я этого не утверждаю.
Ну что ж. Но ваши утверждения про ботов, ллм — тоже враньё.
Это какие?
Однако для заявления о наличии в электрохимических процессах собственно сознания или мышления тоже никаких оснований нет. И заметьте, я здесь не говорю, что это вы так утверждаете.
Тут вообще каша какая-то.
Пока что ваша идея, если я правильно понял, в том, что процессы мозга нельзя свести к вычислениям.
Задайте себе вопрос: зачем это нужно? Чтобы сделать действительно работающий ии, не нужно копировать мозг человека.
Это какие?
— так и знал, что с ботом общаюсь
— Я уверен на 100%
Задайте себе вопрос: зачем это нужно? Чтобы сделать действительно работающий ии, не нужно копировать мозг человека.
Вероятно, что и не нужно, однако ЛЛМ и так не копируют мозг человека. Пытаться симулировать поведение всего мозга на уровне биохимии, кажется, малореально. Банально не хватит ресурсов.
при этом использую инструменты для корректного мышления, логика и рациональное мышление называется
Давайте рандомные данные сгенерим, она и в них закономерности найдет, люди так не смогут 100%
Решение абстрактных закономерностей посильно и нейросетям, и людям.
Например, задание:
Реши силлогизм:
Все мямры фендюрят хрумки.
Брямс является мямрой.
Нейросети успешно решают его, при этом описывают свой логический вывод. В логике подобные категорические силлогизмы хорошо известны и достаточно тривиальны. При этом все термины выдуманы, то есть нейросеть не может «восстановить по памяти» решение.
Таким образом, ваше замечание «люди так не смогут 100%» в корне неверно.
Логика нейросети основана на датасете, а не на внутренних механизмах.
И каким образом работает этот механизм у LLM для решения вышеприведённого силлогизма по вашему мнению?
Кстати современная наука считает, что формально-логические операции у людей (силлогизмы, логические умозаключения) не являются врождёнными, а приобретаются с обучением, хотя врождённые когнитивные структуры в мозге действительно существуют.
Так же, кае складывают числа, делают наподрбие. А что посложнее уже не шмогет, недавно хохма была: Я хочу помыть машину. Автомойка в 50 метрах. Мне идти пешком или ехать?
А вот тут смысл как раз в том, что у человека больше повседневного опыта. Он неявно подразумевает, что «ехать» уже содержит в себе как раз ту машину, которую он хочет помыть. Если вы задали бы эту задачу в той цивилизации, которая не имеет опыта езды на автомобиле, то они бы, вероятно, тоже её не решили. Таким образом, здесь нет какой-то особой «человеческой» логики. Но да, при решении практических задач, в том числе и в программировании, нейросети тоже может не хватить повседневного опыта для анализа автоматизируемых процессов.
То есть вот это ничего не значит?
Я хочу помыть машину
Вы намеренно опускаете важные аспекты при обсуждении? Или ваше ллм(чем вы там пользуетесь?) их не воспринимает?
Потому что в выражении «Я хочу помыть машину» человек исходя из собственного жизненного опыта закладывает смысл «Я хочу помыть свою собственную машину, которая находится в месте моего расположения», а не, например «Чтобы заработать себе денег, я хочу помыть машину клиента на автомойке, где я работаю».
Смысл как раз в том, что этот жизненный опыт — приобретённое знание, а не какая-то врождённая особенность мышления человека.
С вами, иивангелистали спорить не о чем, у вас своего мнения даже нет, одни тупорылые аналогии, никакого конструктива и элементарнах обоснований.
Пусть мне иивангелисты для начала комикс нормально нарисуют, без грубых ошибок.
Про то, какие баги умеют находить ИИ/LLM, можно почитать здесь.
Надеюсь мы их (баги) больше не увидим
Еще раз, она находит то, что похоже на баги, иногда это действительно баги.
Не могло не напомнить:
— Как делают корабли в бутылках?
— Напихиваем в бутылку щепки, гвозди, лоскутки, наливаем клея, долго трясём. Иногда получаются корабли.

Однако, жОстко поплатились если перестанете смотреть и проверять сгенерированный программный код. Это всего лишь статистически правдоподобный текст, а не какая-то сверх мудрость всего человечества 😂
Мне понравилось разносить поделки кукодеров их же любимой игрушкой. "Их Клод хороший - мой Клод плохой" 🫢
Это всего лишь статистически правдоподобный текст, а не какая-то сверх мудрость всего человечества
То же самое можно сказать и о коде, написанном человеками 🤷♂️
ИИ точнее LLM лишь повторяют написанное кем-то. Если это будет самая распространенная реализация даже с ошибкой то она повторится везде.
В этом плане "бороться" с кукодерами совершенно не нужно. Как оказывается, LLM дают профессиональному инженеру-программисту большую силу чем профану-дилетанту-вайберу-кукодеру 🫢 Мне не трудно побить их хоть руками, хоть их же "оружием" - "бей врага его же оружием"😅 Ну они так думали что оно их. Клод ускорил генерацию - Клод ускорил анализ.

он продолжал добавлять отладочный код и добросовестно анализировать его, когда я отправлял изменения.
Полагаю, правильный перевод "when I pushed" здесь будет "когда я на него давил". Речь не про git push, а про упорство.

Что-то не так с архитектурой если пришлось так мучаться. Прогнило что-то в Датском королевстве
Исходники открыты, Вы можете не только оценить архитектуру, но и поменять её

Главное, не светить своим гражданством...

Пока главный на месте никто архитектуру поменять не даст

Помнится, КДЕшники как-то раз пришли с поклоном к Великому, мол, о, владыка, повелитель терминалов и самодержец системных вызовов. Мы проводили анализ летописей и в скрижали номер такой-то обнаружили опечатку в системном вызове таком-то.
Ой, девочки, что началося! (С)
Дед наконец-то признал, что нейронки годятся не только для генерации мусорного кода
Он не использовал их для генерации кода

Этот дед уже давно с потрахами продался, как и все остальные.
БЯМ LLM хорошо ищут паттерны если их водить по тексту, но генерируют код не ахти как. Постоянно нахожу в поделках кукодеров самые тупейшие ошибки потому что локально вроде норм, а глобально
Вот в данной статье обсуждается тупейшая ошибка: разработчики округлили границу не вниз, а вверх. И даже без нейросетей!
С нейросетями искусственными это повторится если попадет в обучающие выборки как самое распространенное решение. И где-то нейросети сделают вероятностные повороты "додумав" за отсутствием спецификации. Внутри LLM все тот же перцептрон из 1950х-1980х.
В этом плане прописать полную спецификацию может быть намного трудозатранее чем написать детерминированную программу самому. Также нужно учитывать что нейросети не "видят" полного контекста. Python самый LLM-friendly язык и по убывающей к машинным языкам таким как C, C++, Rust
Ещё и статистически правдоподобно вероятностно навихляют на "поворотах" гиперплоскостей внося в текст большего разнообразия чтоб не выглядело каждый раз одинаково пресно. Поэтому результаты не повторяются.
LLM ассистенты пишут что "всё готово" не потому что всё действительно готово, а потому что результат запроса действительно готов и он наиболее статистически правдоподобен
Разбираю как LLM работают "до винтиков". Поверх этого LLM провайдеры вроде OpenAI, Anthropic, Google прикручивают свои алгоритмы и тулзы. В этом плане локальные большие языковые модели вроде Qwen интересны как полной анонимностью и приватностью, так и тем что есть возможность изменить вероятностные веса в модели сняв цензуру
Также нужно учитывать что нейросети не "видят" полного контекста.
Я бы с этим поспорил. Нейросетки в типичном случае выполнения анализируют связи, в том числе и смотрят тесты. В этом отношении скорее человек поленится собрать контекст и сделает локальную правку без учёта возможных нюансов. Нейросети скорее предпочитают минимальные изменения в архитектуре, если им явно это не было сказано. Могу предположить, что таков harness в популярных LLM-клиентах.

круто, но я разочарован после ИИ если честно....

нам следует просто написать отчёт
"Доктор... Но я и есть тот самый клоун Пальяччи."
Овердофига комментариев — и никто (включая, воможно, самого Линуса) не сподобился понять, почему round_up(offset, SZ_128K) не работало, а round_down(offset, SZ_4K) — работает. Вотпрямща для меня это ни разу не очевидно
А у меня баг не считается исправленным, пока я не могу достоверно проследить, каким путём шло исполнение, когда привело к неправильному результату. И пока я не могу написать тест. Вернее, два теста: один — для общего случая, когда всё шло правильно, а второй — для частного, в котором пошло неправильно, но новый код это починил.
Без понимания execution path такая «починка» — это самый что ни на есть карго‑культ: «поменяли одно заклинание на другое — и оно вроде заработало, а почему — Х.Е.З.»
Судя по тексту сабжевого коммита, Линус как раз понял, в чём именно ошибка. Он же даже пример привёл. В коде неправильно вычислялась верхняя граница свободной памяти. Там сверху была страница, выделенная под CCS. Всё, что ниже было свободно. Очевидно, что адрес начала CCS нужно было округлять вниз до начала страницы, а не вверх.
Ежели так, то тогда я не понимаю:
1) Какого X переменная называется offset, а не ccs_start_offset — хуже было бы только если бы её n назвали.
2) Почему Линус так долго искал проблему и зачем ему ещё и Имитация Интеллекта понадобилась: ежу понятно, что если падает из‑за ошибки доступа к памяти, то искать надо, где кто‑то лезет в «чужую» память.
ежу понятно
Не только лишь всем, а исключительно специалистам уровни Wesha. Линус пока не дотянул.
Там функция уже называется get_flat_ccs_offset, переменная offset в ней рабочая. Разработчику не хотелось называть её flat_ccs_offset или flat_ccs_start_offset. Впрочем, думаю, что это не сильно бы повлияло на ошибку. Она как раз и произошла, как мне кажется, потому что в своей ментальной модели разработчик типично выровнял оффсет на начало 128КБ-блока, как если бы ему нужно было определить место для хранения CCS. Задача же функции — вернуть начало блока, где лежит CCS:
	/* minus device usage */
	if (xe->info.has_flat_ccs) {
		int ret = get_flat_ccs_offset(gt, *tile_size, &offset);
Думаю, что Линус воспользовался ИИ не от хорошей жизни, а потому что задолбался вручную проверять кучу гипотез и разбираться в незнакомом коде. Это же не настолько тривиальный баг, иначе его бы давно отловили на других компьютерах, а зависит от фазы Луны. Тем более в видеодрайвере, который, скорее всего, вместе с собой крашит всю систему.
Видите ли, в чём дело... переменная должна называться сообразно тому, что в ней хранится, я это осознал лет тридцать назад (ну, с тех пор, как в компьютерах стало достаточно памяти, чтобы можно было не экономить на комментариях, а тем более на именах переменных). Потому что в этом случае переменная становится автоматическим напоминателем контекста. Да, это менее удобно для меня как писателя — но афигеть как помогает мне (и другим в команде) как читателям: не приходится догадывться, «а что аффтар имел в виду, когда он это писал».
Мне почему-то кажется, что разработчики и так понимали, что это начальная граница, и всё равно бы решили, что нужно округлить: https://github.com/torvalds/linux/commit/37173392741c425191b959acb3adf70c9a4610c0
Из того, что я вижу — тут явная ошибка в ассерте (вернее, не в самом ассерте, а в сообщении, которое он выбрасывает): вместо одной проверки x==y должно было быть две: !(y>x) (“Hole between CCS and GSM.”) и !(x>y) (“Overlap between CCS and GSM.”)
Естественно, когда проблема в наложении областей — а человек все усилия тратит на то, чтобы найти зазор между ними — поиски идут в неправильном направлении.
«Правильно пишите комментарии, дети: это сэкономит вам много нервов.»
Моя памятка для присылающих баги выглядит так:
Подробно и детально опишите действия, которые вы предпринимали непосредственно перед тем, как произошло то, на что вы жалуетесь. Ничего не опускайте. (Упрощённый пример: «запустил программу, появилось основное окно, нажал кнопку [ВВОД ПОКАЗАНИЙ ДАТЧИКА].)»
Опишите, что вы ожидали, что произойдёт. (Упрощённый пример: «ожидал, что откроется окно для ввода показаний датика».)
Опишите, на что именно вы жалуетесь. (Упрощённый пример: «окно для ввода показаний датика» не открылось.)
Объясните, почему вы считаете, что ваши ожидания опавданы. (Упрощённый пример: «потому что я ожидаюю, что кнопка [ВВОД ПОКАЗАНИЙ ДАТЧИКА] покажет мне окно для ввода показаний датика».) — этот пункт может показаться дурацким, но на самом деле он часто критичен — упрощённый пример: окно ввода показаний датика и не должно открыться до тех пор, пока не выбран датчик, показания которого будем вводить.
Опционально — опишите всё необычное, что вы заметили в процессе. (Упрощённый пример: «обычно при нажатии кнопки основное окно моргает один раз, а в этот раз не моргнуло.») — частенько в этом пункте не обнаружится ничего полезного — но уж если обнаружится, то оно окажется критически важным для решения.

Вы предлагаете венгерскую нотацию?
Какого X переменная называется offset, а не ccs_start_offset — хуже было бы только если бы её n назвали.
Она уже так называется, код закоммичен 2 года назад. С этим что делать предлагаете? Вернуться на 2 года назад и переименовать?
ежу понятно, что если падает из‑за ошибки доступа к памяти, то искать надо, где кто‑то лезет в «чужую» память.
Где и куда именно? Памяти уже довольно дофига, Вы это сами признаёте. Руками все варианты перебирать или пусть лучше железка это сделает?
Там было сказано, что ИИ сделал всю grunt-work
Она уже так называется, код закоммичен 2 года назад.
И... что? Если раньше было плохо, то совершенно нет причины, почему и дальше должно быть так же плохо.
С этим что делать предлагаете? Вернуться на 2 года назад и переименовать?
Современные IDE уже умеют определить все места, где конкретная переменная встречается в теле функции, и исправить название во всех местах реально одним нажатием.
От переименования идентификатора баг уйдёт?
От переименования идентификатора баг уйдёт?
От переименования идентификатора баг не возникнет.
«Если бы в январе 2001 года какому‑то чиновнику пришла идея обязать авиакомпании установить на дверях в кабину пилотов замки, на его голову свалилась бы НЕНАВИСТЬ всего мира, и он бы так и умер всеми презираемый — и никто бы так никогда и не узнал, от каких событий он спас мир.» ©
Вы смешали прошлое и будущее.
Вот прямща есть баг и кривой идентификатор. Что произойдёт от замены идентификатора? Ничего.
Что произойдёт от замены идентификатора? Ничего.
Если Вы не можете это увидеть — примите мои соболезнования.
Произойдёт предотвращение возможной ошибки в будущем. Тот самый замок на кабине пилотов, установленный в феврале, который предотвратит падение башен-близнецов в сентябре.
Но никто не сможет этого оценить по достоинству — потому что башни не упадут, и всего связанного с этим многолетнего трындеца на случится.
Так в коммите от 16 сентября 2024 будет примерно такое:
// Spec says SW is expected to round up to the nearest 128K, if not already
// aligned for the CC unit view of CCS. We are seeing the assert sometimes
// pop on BMG to tell us that there is a hole between GSM and CCS, as well
// as popping other asserts with having a vram size with strange alignment,
// which is likely caused by misaligned offset here.

flat_ccs_start_offset = round_up(flat_ccs_start_offset, SZ_128K); /* SW must round up to nearest 128K */
Проблема-то в вводящем в заблуждение ассерте, а не в имени переменной.

Какого X переменная называется
offset, а неccs_start_offset— хуже было бы только если бы еёnназвали.
Потому что есть понятие контекста и размашистые названия в локальной видимости ничего нового не вносят особо.
Ну и такой подход прямо следует из linux kernel coding style:
C is a Spartan language, and so should your naming be. Unlike Modula-2 and Pascal programmers, C programmers do not use cute names like ThisVariableIsATemporaryCounter. A C programmer would call that variable
tmp, which is much easier to write, and not the least more difficult to understand.
C programmer would call that variable
tmp, which is much easier to write,
...что было верно лет 20 назад, пока не завезли автодополнение...
and not the least more difficult to understand.
...что верно для того, кто этот код писал, но не для того, кто этот код читает.
Ну как бы современный Go тоже декларирует такой подход в нейминге и код вроде `func (c *Context) do() { ... }` и короткие имена переменных внутри тела функции - вполне нормально воспринимаются.
Ну и моё личное мнение, что перегруженный контекст в нейминге мешает именно чтению, как раз написать мне не сложно, даже без автодополнения, а читать становится сложно, особенно строки под 120 строк (и с таким неймингом это норма).
Текст авторства самого Линуса идёт внизу в квадратных скобках. Начинается с "[ And this was a debug session from hell... "
Начало сообщения llm сгенерила.
Не факт. Это общепринятое в проекте официальное описание изменений в коммите. А в квадратных скобках — так сказать авторское отвлечение, неофициальный комментарий, потому что ценности для кодовой базы и проекта оно в целом не несёт.
Да и если первую часть написал ИИ, Линус совсем его не читал когда коммитил что ли?

Ахахахха, вы хоть раз писали реальный коммерческий софт в команде, лол?
Да, приятно все знать и контролировать, но при командной разработке приходится мириться с «Окей, если тут 1, а не 2, тогда не крешит это кривое API, хз почему, фиксед».
А по сабжу - не фанат Торвальдса, но он явно покомпетентнее вас будет, и что-то, да понимает в программировании.
Какого культ или нет, но ИИ смогла пофиксить баг, смиритесь. Чем раньше примите реальность, тем проще будет психологически.
ИИ смогла пофиксить баг
Выражение из серии "медицина смогла вылечить больного".
Нет, это врач был, а не медицина.
Тут то же самое. Не ИИ смогла, а человек. Машина по его заданию выполнила всю рутину.
Ахахахха, вы хоть раз писали реальный коммерческий софт в команде, лол?
Ахаха, я этим сильно более двух десятков лет занимаюсь.
при командной разработке приходится мириться с «Окей, если тут 1, а не 2, тогда не крешит это кривое API, хз почему, фиксед».
Примите мои соболезнования. Моё начальство понимает, почему знание кишок продукта критически важно. И да, не запрещает мне потратить два дня на докапывание до сути. Потому что в дальнейшем это знание экономит гораздо больше времени.
Я рад за вас. Вот только ваша компания живет в условиях "рыночка"(если конечно у вас не попил госбабла), а рыночек имеет свойство "порешать" компании, которые не показывают достаточную эффективность.
Поэтому, рано или поздно, ваш начальник придет к вам и скажет "а ты попробуй этот ИИ инструмент", ну либо рыночек постучит в дверь.
Не ИИ, а сам Линус который повозил LLM носом по коду 🫢... настойчиво. Это инструмент статистически правдоподобный, а не deus ex machina

Ну, он молодец... Наверно

Xe драйвер не стабилен. По какой-то причине (вроде при отчистке vram, т. к. в llama.cpp чаще всего падает). Точнее, он виснет, а ядро его убивает. Пробовал собирать разные версии ядра, сейчас на 7.2 rc2, не помогло. Не знаю как Линус с двумя 6К мониторами пользуется, карта у меня тоже G21.
Не шмогла...полезла в ии...дед сдулся, короче..
Хм, неужели на хабре начали минусовать противников ИИ? А когда я в прошлом году писал про ИИ, то ловил тонны минусов. Переворот свершился таки? Может и минусы на плюсы мне перепишите?

Интересно к чему приведет развитие ИИ!)
LLM существуют с 2017. ИИ гораздо дольше. Перцептроны с 1950х. Это не скачкообразный процесс не смотря на всю шумиху. В целом LLM даже вредоносная технология для слабоумных неокрепших мозгов.
В 2024 награждали двух учёных за фундаментальные алгоритмы обучения с подкреплением, разработанные еще в 1980-х годах и легшие в основу современных больших языковых моделей и ИИ. В 2018 ещё двух ученых.
Так что с разморозкой из анабиоза ✍️

Куда движеться этот мир)

Один известный (и уважаемый мной) человек для какой-то задачи использовал иишку... Ну ок.
Потому скажут, что Николас Кейдж использовал иишку для составления плана дел на день.

Базированный Линус

Линус Торвальдс использовал клавиатуру для нажатия клавиши.

Испытываю за Линуса радость примерно как когда моя бабушка осваивает что-нибудь в смартфоне.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Линус Торвальдс использовал ИИ для отладки ошибки в драйвере графического процессора Intel