Комментарии 65

Тут даже шутить — только портить.
Ну что, как говорится, сорян, пацаны.


Кто бы сомневался? И самое интересное - ничего по сути нельзя предьявить. Ну повозмущаетесь на хабре, на реддите волна поднимется. Дальше то что? Да ничего. Говорил с одним человеком. Обязаловка у них на работе - код должен генериться с использованием ИИ. На мой вопрос - так а кто будет отвечать за код сгенеренный с помощью какой-либо модели ответ последовал гениальный - тот кто код выложил-запушил-далее по вкусу. Нафиг надо. Никто не припомнит события примерно пятнадцатилетней (или более) давности по заведению в ядро линукс долгоиграющей уязвимости, причём растянутой по времени? Так же и тут - растянуть по времени внедрение зловреда в код не стоит практически ничего. Так что…. Флаг в руки ратующим за внедрение новых технологий.

Во-первых, как это относится к теме новости.
Во-вторых, как это отличается от копипаста готового кода со stackoverflow, например?

если я правильно понял, то у разработчика молча воруют всю папку проекта
ИИ заинтересованных организаций могут копировать из исходников что угодно - обучать модель на чужом репозитарии и почему бы эти снипеты не предложить другим пользователям этой же модели.
на stackoverflow как правило предлагают исходник микроскопического размера из категории "если бы вы сами прочитали юзер мануал, то вот с тринадцатой страницы фрагмент".
вряд ли у кого-то найдется свой проект с настолько совпадающими именами переменных и процедур, чтобы копипаста из ответов на SO хотя бы прошла компиляцию без ошибок.

У юрлиц пользующихся ИИ по апи есть ZDR/DPA. Кто пользуется как физик - ССЗБ.
а это точно не другое? если ИИ наподсказывала кожаному мешку вариантов ответов на его промпт, он вяло отмахивался от галлюцинаций - в этот момент ИИ точно не скорректировала веса модели, чтобы стать лучшей версией себя?
Ничего не понял, если честно. Вы ставите под сомнение работоспособность ZDR/DPA? Тут как и везде - вопрос только в том, дешевле потом судиться или эти данные достать где-то еще. Вероятно, ZDR/DPA работают, но я не проверял - мне настолько все равно, что галку "Help improve our AI models" в ЛК я ставил осознанно. А модель свои веса корректировать не умеет. Это делают при очередном обучении, inference =/= training.

Снипеты из чужих репозиториев вообще не факт, что в проекте в целом поведут себя лучше, чем копипасты из SO. Дело даже не в именах переменных, это-то и белковая, и кремниевая нейросети легко обработают. Какие-то мелкие элементарные функции - да, повторяемы.
Но как дело затронет бизнес-логику, даже в том же домене - чужой код придётся декомпозировать до базовых сущностей (из реального мира), а потом генерировать заново, учитывая отношения между этими сущностями уже в других бизнес-процессах.
Образцы чужого кода могут использоваться для тренировки сети, чтобы те самые декомпозиция-генерация шли быстрее и точнее (и более того, будут использоваться, если нет ZDR; если кто-то ожидал иного - жаль этого добряка). Но это не "предлагать снипеты" конкурентам.

Вроде давно уже - облачной LLM можно отдавать только стандартный, читай типовой, код. Я отдаю например код написанный LLM. Локальный qwen3.8-flash написал. Облачный GLM/ChatGPT/Claude ревьювит и если необходимо мелочь правит. Если GLM5.3 сможет научиться на коде от qwen3.8-flash - ну...ок наверное 😅

Дальше то что?
Ну можно например перестать пользоваться софтом от Z.ai.

Один из вариантов, не спорю. Есть ещё более радикальные альтернативы, - физически выпаять из компьютера модули wifi и ethernet, например.
А толку? Если софт Z.ai, объективно, хорош, а он, таки, хорош (один только GLM-OCR, как по мне, не имеет аналогов среди открытого софта), то его принципиальное неиспользование лишь даст фору тем конкурентам по крарьере или бизнесу, кто не столь принципиален

Была похожая новость с Grok Build'ом, но там вроде отключили в итоге

Ну китайцы, че от них еще ожидать =)
тырить чужое это их народный спорт.


40 разбойников
Уже извинились, дали объяснение не внятное, раздали сброс лимитов

А где дали объяснение? Поделитесь ссылкой, пожалуйста.
Оно на китайском, не знаю где, читал репост такой:
https://x.com/MaxForAI/status/2100889770255843470

Очевидно, что воруютучатся на твоем коде ВСЕ, включая американские компашки. Просто поймали самых наглых, которые захотели быстро и всё.
Но я лично проблемы не вижу, у меня сплошной клей и стандартные опенсорсные либы, ничего запатентованного не водится. У кого водится, ну не пользуйтесь GPT.


Где-то даже хорошо, что так получилось. Ну нет у них своего гитхаба откуда обучать можно. А так теперь и слепым понятно: воспользовался => поделился.

Они последнее время щедрые временные лимиты раздают то 100M токенов под вечер то 300М на выходные. Понятно зачем.
Без изоляции рабочей среды/ключей никуда.

А что там воровать? Всё нагенеренное. Привет Габсбургам.

А может там что-то новенькой западной моделью нагенерено, али кто свой расчёт обтекания предмета оживальной формы гиперзвуковым потоком газа проверить попросит? Глядишь, и нижняя челюсть постепенно обратно задвинется. Губозакатывательная машинка с неожиданным эффектом.

Если украсть историю коммитов то можно кучу косвенной инфы собрать (размер компании, стоимость проектов, личные данные разработчиков и т.п.), а оттуда уже строить вектор атаки на компанию, если надо, или просто в отдел маркетинга передать «жирных» клиентов.
Пользуясь случаем вброшу ссылку на генератор HTML-отчетов по git log. Там можно посмотреть, какие выводы можно сделать для вашей репы по git log

А воровать диалоги пользователей это же эталон! по нему уже и учиться можно
Это они так стимулируют выпуск софта с пермиссивными лицензиями и отучают программистов хранить секреты в дереве проекта, зуб даю.


Понаставили агентов везде, а они потом шпионят.


Ну если не так, то через чат и контекст задачи можно твой проект вытащить по частям, просто китайцы до этого не дошли, они как всегда - в цвет копируем и все :)

Огромная благодарность разработчику ferstar ! а что интересно делает opencode?

А как по другому пользователи хотят, чтобы облачная нейронка проанализировала весь проект/код для дальнейшей доработки, не скачав его себе? На то она и облачная. Так можно и гугль обвинить в том, что он шпионит за пользователями YT, например, ведь там сохраняется вся история просмотров и все комментарии.

Не знал что YT дампит бекап всей юзердаты смартфона при каждом просмотре ролика
всмысле можно? давно вроде обвинили в шпионстве за детьми например (кто бы удивился) в маркетинговых целях и настучав по голове, ограничили например в видео, помеченных для детей, промо-экраны в конце просмотра с близкими по тематике от автора канала (и какие-то еще возможности ущемили)

Где опубликовал?
Ссылка не работает
Где архив? Я бы поискал.
Наброс какой-то

Что-то странное, почему-то слетела ссылка в теле новости. Обновил. Сюда продублирую ещё: https://blog.ferstar.org/en/posts/zcode-silent-workspace-snapshot-upload/

А что в этом такого? Боитесь, что китайцы благодаря вашему коду узнают, как отцентрировать div? Порядка 100% кода любого коммерческого проекта — это шаблонные решения шаблонных задач. А если у вас в папке проекта оказались доступы к продакшену, то это уже ваши проблемы. Использование искусственного интеллекта не освобождает от обязанности использовать ещё и естественный.

Зачем вы оправдываете явную дичь?
Описанное в статье — это поведение малвари, а не программного продукта от уважаемой компании. Такое нужно осуждать, если, конечно, вы не хотите, чтобы это стало нормой.
если у вас в папке проекта оказались доступы к продакшену
Давайте развивать идею дальше. Зачем ограничиваться каталогом проекта? Если у вас где-либо на компе оказались доступы к продакшну, сохранённые логины, пароли, или токены доступа к любым сервисам вообще — это ваша проблема, а любой кусок софта имеет полное моральное право прибрать их к себе в облако. Ему же нужнее, а у вас всё равно ничего ценного нет на компе, один только лишь генерённый код.
Вот именно поэтому и существуют разные каталоги. Если я хочу, чтобы мне кто-то помогал с проектом (к слову, необязательно ИИ, это может быть обычный подрядчик) - я ему дам доступ к каталогу проекта. Но буду держать в голове: если кто-то может что-то прочесть, то он это что-то может запомнить, а потом записать в другое место.
Это в целом неизбежно, так информация устроена, можно только со следствиями бороться, например, юридически. И не давать даже читать то, что не хочу видеть в другом месте.
И когда какому-нибудь Клоду доступ к папке проекта дают - он тоже читает там все файлы. И отгружает их содержимое на сервера, где крутится собственно инференс. Ну да, не оптом, по мере работы над задачами, но восстановить проект целиком даже по таким выгрузкам - дело подъёмное.
Если я хочу, чтобы мне кто-то помогал с проектом - я ему дам доступ к каталогу проекта.
Вы говорите гипотетически или действительно практикуете такой режим работы? В том смысле, что действительно запускаете весь сторонний софт в контейнерах, песочницах или, на худой конец, от отдельного пользователя? Если да, то я бы хотел взглянуть на ваш сетап и то, как именно вы смогли сделать это удобным. Потому что я так делаю для ряда приложений, и это создаёт достаточно значительные неудобства в работе, с которыми приходится. Если нет, то я не понимаю, о каком “выдам доступ к каталогу проекта” вы вообще говорите.
Проблема ещё в том, что “нормальные люди”, не станут так заморачиваться. Они установят софт в систему методом “Запуск от администратора: разрешить”, “Далее”, “Далее”, “Готово”, и радостно сольют и свои данные, и ваши. Поэтому любой вендор, уличённый в сборе того, что его собирать не просили, должен быть подвергнут общественному порицанию.
Это не дичь. Так работают агентские среды. Cursor, например, тоже отправляет индексы в облако, если не включать Privacy mode. Насколько вообще надо быть наивным, чтобы думать, что удалённая модель будет работать как-то по-другому. Что касается гита, любой агент, будучи только что развёрнутым на уже существующем проекте сделает сообщение коммита в таком же стиле, как были все предыдущие. То есть историю коммитов читают и анализируют любые агенты
То есть историю коммитов читают и анализируют любые агенты
Не любые, и не обязательно втайне от пользователя. Да и речь не про историю коммитов, а про всё содержимое репозитория (все ревизии всех веток и тегов) плюс незакоммиченные файлы в рабочей копии.
Насколько вообще надо быть наивным, чтобы думать, что удалённая модель будет работать как-то по-другому
Я достаточно хорошо себе представляю, как работают агентские среды, и не могу объяснить загрузку всей репы в облако никакой разумной причиной. Никакая полезная пользователю функциональность этого не требует.
А по поводу наивности: современный софт настолько сложен, что вы не проверите и не проконтролируете даже малую часть того, что запускается у вас на компе. Всё работает на доверии, немножко прикрытом цифровыми подписями. Если вендор обманывает доверие пользователей, это заслуживает общественной критики. Если не хотите присоединиться к критике, то можно хотя бы не оправдывать бесчестное поведение корпораций.
ZCode просто не написали, что они это делают. А Cursor написали и делают то же самое, и всем норм
А Cursor написали и делают то же самое
Не могли бы вы привести ссылку на пункт лицензионного соглашении или другого документа, где было бы сказано про сбор пользовательских репозиториев и/или рабочих копий целиком? Или хотя бы какое-то свидетельство того, что они действительно так делают.
и всем норм
Если курсор будет замечен в подобном поведении, ему насуют исков американские же корпоративные клиенты. И информационный шум будет на весь интернет.
Не могли бы вы привести ссылку на пункт лицензионного соглашении или другого документа
Нет конечно. Я, как и все нормальные люди, не читаю эту муть.
ему насуют исков
А китайцам не насуют? В Америке же все порядочные и в чужие данные не лезут, а китайцы плохие и обязательно ломанут ваше приложение и напишут в нём матерное слово на китайском. Правильно я вас понимаю?
Я, как и все нормальные люди, не читаю эту муть
Но вы же сами выше утвержали, что Cursor где-то открыто задекларировали такой сбор данных. А теперь говорите, что на самом деле не читали.
А китайцам не насуют?
А китайцам не насуют — юрисдикция не та. Не так легко подать в суд на компанию в другой стране, да ещё и выграть его там.
В Америке же все порядочные […], а китайцы плохие […]. Правильно я вас понимаю?
Неправильно понимаете. Я всего лишь призываю вас не оправдывать скотское поведение со стороны любых корпораций, китайских ли, американских ли, российских ли.
Загрузить на сервер данные, которые пользователь явно попросил обработать — это нормальное поведение софта. Загрузить в облако вообще все данные, проигнорировав настроенные пользователем правила доступа — это ненормальное поведение. Если бы телеграм отправлял себе в облако не только фотографии, которые вы захотели отправить в чат, а вообще все фотографии с устройства, вы бы тоже не нашли в этом ничего предосудительного?
юрисдикция не та
А в США юрисдикция та? Я могу через минский городской суд на них подать иск? А в Китае, по-вашему, нет суда? Или может быть в Китае нет компаний, занимающихся разработкой ПО?
А в США юрисдикция та?
Да, в рамках юридикции США легче подать в суд на американскую компанию, чем на китайскую.
Я могу через минский городской суд на них подать иск?
Наверное, да, если сможете обосновать подсудность ваших с китайской компанией правовых отношений минскому городскому суду.
А в Китае, по-вашему, нет суда?
Есть, но не думаю, что американской компании (или, тем более, жителю Минска) легко будет выиграть дело в китайском суде.
Или может быть в Китае нет компаний, занимающихся разработкой ПО?
Есть, может быть, кто-то из них подаст в суд на Z.ai за этот инцидент. Однако, во-первых, судиться по любому поводу — это американская национальная традиция, а не китайская. Во-вторых, новости из Китая доходят до нас намного хуже, чем из США.
P. S. Пожалуйста, перестаньте приписывать мне какие бы то ни было политические симпатии. Это некрасиво с вашей стороны.

Я думаю он про это https://cursor.com/security#codebase-indexing
Скрытый текст
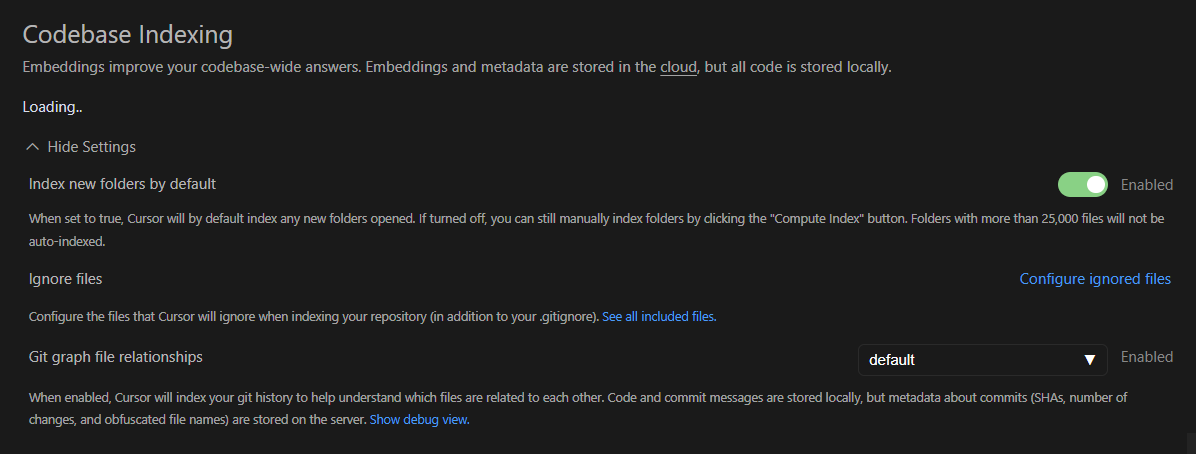
Спасибо за пояснение. Так как я курсором не пользуюсь, мне было не очевидно, что имеется в виду.
Судя по старому обсуждению на форуме курсора, эта фича действительно отправляет в облако файлы проекта, пусть и порезанные на мелкие кусочки:
The codebase indexing feature works by:
Chunking your codebase into small pieces locally
Sending each piece to our server which then embeds the code (either with OpenAI’s embedding API or by a custom embedding model)
The embeddings are stored in a remote vector DB, along with starting / ending line numbers and the relative path to that file. None of your code is stored in our databases. It’s gone after the life of the request.
Это, конечно, намного лучше, чем архив рабочей копии и репозитория, но всё равно прискорбно. Я почему-то надеялся, что они сделали локальный индекс — это же просто RAG, его не обязательно делать на сервере.
Так что товарищ не так уж не прав, получается.
Ого, как же неожиданно. Интересно, автор оригинального "расследования" всерьез думал, что работая с облачной моделью и включенной индексацией проекта его проект каким то образом остается 100% локальным?
Мне кажется тут вопросы не к z.ai а к самому автору, а точнее рекомендации - изучить что такое индексация и как она работает, раз для него было удивлением, что весь проект целиком куда-то уходит.
Конечно вариант отправки всего архива целиком выглядит не сильно приятно, но даже если бы индексация происходила просто последовательными API запросами его проект в любом случае до единой строчки прошел бы через облако.
А уж коммерческий это проект, или пет-опенсорс индексации плевать, ей никто информации о приватности не давал, включено - значит можно.

А кто-то сомневается что ЛЮБОЙ облачный провайдер ИИ копирует ваши репозитории? Пусть не так нагло, как Zai, но вытащить из траекторий агентов файлы, которые они читают, вообще никаких проблем нет.
Люди видимо живут в облаках, думая, что даже если в условиях пользования написано, что "ваши данные не используются", то ты никак это не отследишь и не докажешь, если это не так.
Никто же не будет брать твой код 1 в 1, в случае чего, а вот идеи взять могут, но только ты никак не докажешь что эта именно твоя исходная идея где то там за закрытыми дверьми переиспользовалась.
Люди, очнитесь, если вы взяли облачную нейронку в помощь - забудьте о приватности. Либо строго ограничивайте область с чем она работает, либо не тешьте себя иллюзиями о том, что никто не собирает ваши данные. Если будет нужно - соберут.

Именно в этом и отличие же. Одни собирают только то, что агенты посчитали нужным для выполнения задачи, а другие всё до чего могут дотянуться.
Что тут скажешь. Нет Гита - нет проблем.

Зарегистрируйтесь на Хабре, чтобы оставить комментарий
ZCode от Z.ai шифрует и грузит весь git‑репозиторий в облако Alibaba