Комментарии 27

Как появится нормальный движок для запуска, так обязательно попробую модель. Возиться с ComfiUI будут только те, кто непосредственно работает с генерацией. Языковые модели тоже без нормального движка выходят. Показали Qwen 3.8 flash next, а нормальной скорости так и не достигли, работать с ним не получится. Конечно, если все в видеопамять влезает, то хороший результат будет, но карточка под это дело стоит пару миллионов.
Хотелось бы видеть не новые модели в ближайшее время, а отполированные средства запуска.

Да ладно, в ComfyUI уже выложен официальный пайплайн, там с хорошей карточкой остаётся только промпт ввести и всё.

Вся загвоздка кроется в словосочетании хорошая карточка)) С 15 миллиардами параметров суммарного веса комфортный запуск начинается от 24 гигабайт видеопамяти

Только что собрал docker образ с comfyui:v0.37.0.
В темплейте “Qwen Image 2.1: Text to Image” используются следующие модели:
vae: qwen_image_2.1_vae_bf16.safetensors - 644.22 MB
text_encoders: qwen3vl_8b_int8_convrot.safetensors - 8.71 GB
diffusion_models: qwen_image_2.1_int8_convrot.safetensors - 6.76 GB
Запустилось на RTX5070Ti, в пике видел потребление 15.69GB VRAM.
Генерируются изображения с разрешением 1024x1024.

qwen image отлично работает уже с 12gb, на самом деле и с 8gb проблем не должно быть.
Именно это я и имел в виду, что дефолтный пайплайн может без изменений на более слабой не пойти. На 16 я заменил 3 ноды на кастомные, который делают своп в RAM, и всё норм. По мне, это не особо танцы с бубном, в powerpoint иногда приходится для красивых анимаций выкрутасы почище делать, но кому как.


Ну в приложении unsloth (где движок уже встроен) эта модель появилась, причем от многих людей, какую из них качать не знаю, весят одинаково все, попробую перебором самую последнюю. А так там интерфейс для рисующих и перерисовывающих моделей сильно попроще автоматика (это я специально для тех кто не любит комфи), но результаты порой на уровне нано-бананы выходят, разве что в тексты не умеет. Будем посмотреть.

Я с удовольствием гоняю такое на stable-diffusion.cpp.

В смысле нормальный движок? Если вам нужен максимально простой и нормальный доступ к текстовым - умным моделям, то вам в LMStudio, просто ставиться с exeшника, просто скачивается нужная модель, просто выставляются правильные настройки и всё просто работает. Чем не отполированный запуск? Если вам нужен максимально простой агент, то скачиваете Bionic, от тех же разрабов. И почему это с Qwen3.8FN не достигли нормальной скорости? Всё там достигли, только на strix halo или маках с кучей памяти. Всё, как вы и сказали, зависит от бюджетов, у вас огромная модель, рассчитанная на минимум 32гб врам на обычном компудахтере по волшебству не запуститься со скоростью выше 10токенов сек (то что она с такой скоростью у меня на 16гб АМД видюхе и 64гб озу работает - это уже чудо).

Какой объем VRAM ей нужен, скажем, в ComfyUI?

минимум 8gb
16 гигабайт точно хватает, если использовать вместе с ComfyUI-MultiGPU (https://github.com/pollockjj/ComfyUI-MultiGPU) и делать подкачку из RAM. И текстовый энкодер лучше загружать тоже на GPU, т.к. там 8B параметров, и на CPU уже медленно довольно-таки. У меня получается 25 шагов около 60 секунд с энкодером на CPU и 20 секунд на GPU (RTX 5060 Ti).

Я на своих 8гб памяти сделал скрипт который принимает запрос на тестовый енкодер - кодирует что нужно и результат сохраняет, выгружая текстовый енкодер и загружая потом модель передавая в comfy сохраненный результат енкодера
Таким образом разовая генерация работает, пусть и подольше но мне нормально на моей ноутбучной RT 2070 и 24 гб RAM
Я так понимаю, ComfyUI-MultiGPU то же самое делает, если поставить флаг “выгружать всё остальное при загрузке модели”. Вообще, как пишут, диффузионные модели compute-bound, так что даже с 8 ГБ VRAM и подкачкой в RAM скорость генерации не должна особо страдать, разве что загрузка самой модели с каждым промптом время съедает.
Судя по тому что я вижу при генерации у меня цп занят максимум на 20% а ГПУ на все 100.
Но в целом так и есть при загрузке модель выедает всю память а потом при генерации 10 свободно.
В целом я доволен результатом и при такой схеме на 20 сек быстрее чем просто все держать в памяти, даже ценой переподгрузки моделей.
По поводу выгружать все тут подводный камень. Энкодер не выгружается так как его результат нужен для генерации при ее старте. Ну или я не понял как это настроить.
Поэтому пришлось просто сделать ноду с входящими данными енкодера а результат енкодера хранить отдельно. Благо ии сама это настроила в comfy, а человеку осталось сказать что нужно

Модель в генерации сливает подчистую Krea 2, а в редактировании Flux2 Klein (разве что с прозрачностью выигрывают), такое чувство что они с предыдущей версии не поменяли ничего.

В прод эту штуку без отчислений китайцам все равно не затащишь из-за ограничений в исследовательской лицензии. Для коммерческих продуктов придется либо выбивать отдельный договор с Alibaba, либо ждать чистый опенсорс от комьюнити. Пока это чисто площадка для экспериментов в лаборатории

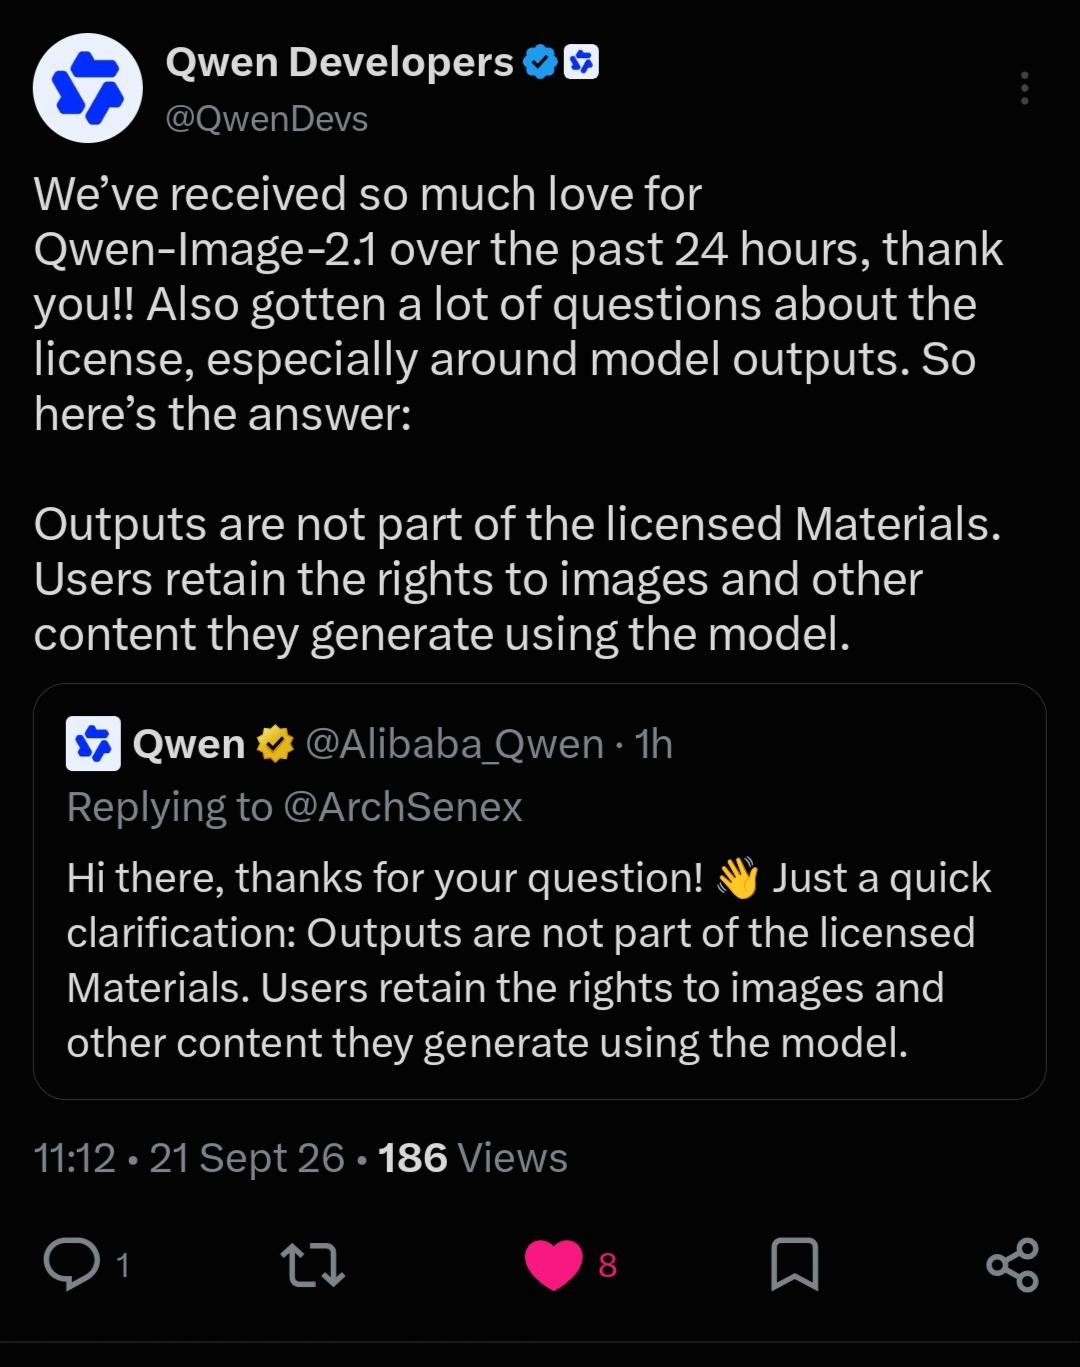

Нативная прозрачность выглядит реально полезной фичей. Если качество подтвердится в независимых тестах, модель очень перспективная

Тестировал сегодня - очень впечатлен. На маке m2 32gb в варианте int8 отлично запускается и работает (правда немного медленно)
При этом качество редактирование на очень впечатляющем уровне. Я гонял в основном удаление мелких деталей - на 60 кейсов ни единого испорченного изображения или пропущенных целевых деталей. Прямо "вау"!

дел
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Alibaba выпустила Qwen‑Image 2.1 с генерацией прозрачных изображений