
Вопрос «банк или ритейл» звучит как выбор между двумя понятными вещами. На практике это выбор между двумя разными типами аналитических задач, двумя видами ограничений и двумя способами видеть результат своей работы. Сравнивать зарплату «среднего аналитика в банке» со «средней зарплатой в ритейле» — значит сравнивать несравнимое. Есть смысл разобрать, чем эти отрасли отличаются по существу. Давайте же сделаем это!
Оглавление
Три мифа, которые мешают выбору
Миф № 1. В банке аналитик считает деньги и строит отчёты
Реальность сложнее. Банковская аналитика охватывает мониторинг транзакций, выявление мошенничества, оценку кредитных рисков, контроль качества финансовых данных, анализ клиентского поведения и измерение эффективности продуктов. В зависимости от команды специалист работает на стыке SQL, статистики, бизнес-логики и инженерии данных.
Конкретный пример: в вакансии, опубликованной на Хабр Карьере в октябре 2026 года, в требованиях — SQL и Python, в обязанностях — корректность учёта и мониторинг остатков. Никаких кредитных моделей. Зато очень конкретная ответственность за целостность данных. Ориентир платформы для похожих позиций — 164-300 тыс. ₽.
Миф № 2. В ритейле задачи проще, потому что это просто продажи
Транзакции нужно связать с товарами, магазинами, ценами, промоакциями, остатками и поставками. Аналитик выясняет, почему выросли продажи: из-за скидки, сезонности, изменения ассортимента, отсутствия товара у конкурента или случайного колебания. Неверный вывод — лишние закупки и потерянная маржа.
Спутать корреляцию с причинностью здесь обходится буквально дорого.
Миф № 3. Для Middle достаточно знать SQL и Python
Синтаксис — лишь начало. От Middle ожидают понимания модели данных, качества источников, статистической неопределённости и бизнес-метрик. На Senior дополнительно ложатся выбор подхода к задаче, проектирование аналитических решений, оценка компромиссов и влияние на решения бизнеса.
Разница между Junior и Senior здесь не в количестве инструментов. В том, кто несёт ответственность за постановку вопроса, а не только за ответ.
Как различаются задачи под капотом
Измерение | Банк | Ритейл |
Основные сущности | Клиент, счёт, транзакция, кредит, договор | Клиент, товар, чек, магазин, цена, остаток |
Типичные задачи | Антифрод, риск-модели, просрочка, эффективность продуктов | Прогноз спроса, промо, ассортимент, отток, оборачиваемость |
Главная сложность | Цена ошибки, объяснимость, доступ к данным, временная корректность | Сезонность, смешение факторов, наличие товара, неоднородность магазинов |
Ключевые метрики | Дефолт, потери от мошенничества, одобрение, риск-скорректированная прибыль | Выручка, валовая маржа, конверсия, средний чек, доступность товара |
Горизонт решения | От секунд (мониторинг) до месяцев (портфель) | От минут (оперативка) до сезонов (планирование спроса) |
Важная оговорка: это не жёсткое разделение. Крупные банки строят продуктовую аналитику. Ритейлеры используют скоринг, рекомендательные системы и потоковую обработку событий.
Как данные превращаются в решения: два технических контура
Главное техническое различие между отраслями — не язык программирования. А то, какой путь проходит информация от первичного события до решения, за которое отвечает бизнес.
Банковский контур
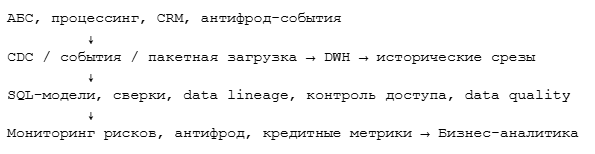
В банке важно не только получить верное число, но и доказать, из каких событий оно получено. Для расчёта просрочки недостаточно соединить таблицу кредитов с таблицей платежей. Нужно определить дату среза, правила учёта частичных погашений, часовой пояс, статус договора и момент, когда информация была доступна. Иначе исторический отчёт использует данные из будущего.
Это называется point-in-time correctness. Нарушение делает любую ретроспективную оценку бессмысленной. Базельский комитет по банковскому надзору отдельно регулирует агрегацию риск-данных: требования к полноте, точности, целостности и своевременности зафиксированы в Basel Framework. Это не абстрактная методология — требования к реальным аналитическим процессам.
Контур ритейла
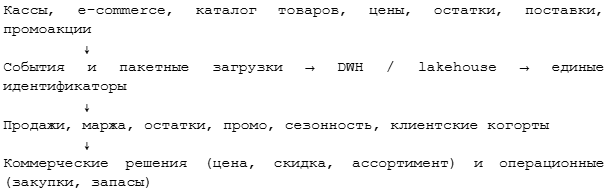
В ритейле особенно опасна потеря контекста. Рост выручки не обязательно означает рост прибыли: скидка может увеличить количество проданных единиц, но снизить маржу. Падение продаж может быть вызвано не снижением спроса, а отсутствием товара на полке.
Что аналитику нужно понимать об архитектуре
Несколько концепций, которые переносятся между отраслями:
- OLTP и OLAP. Операционные системы обслуживают транзакции, аналитические — запросы и агрегации. Прямые тяжёлые запросы к продуктивным системам могут конкурировать с критичными операциями.
- DWH и lakehouse. Важны история, гранулярность, схема, стоимость запросов и договорённости о том, кто отвечает за модели.
- ETL/ELT. Важнее не аббревиатура, а повторяемость вычислений, контроль изменений и восстановление после сбоя.
- Batch и streaming. Для ежедневной отчётности хватит пакетной загрузки. Для антифрод-сценариев нужна низкая задержка. Streaming сам по себе не гарантирует качество данных.
- Data quality и lineage. Проверки уникальности, заполненности, ссылочной целостности и допустимых значений должны выявлять ошибки до того, как они попадут в отчёт или модель.
Зарплаты по грейдам: что можно утверждать, а что — пока гипотеза
Подтверждённой отраслевой разницы по доступным данным недостаточно, чтобы назвать победителя. Зарплатный тезис нужно подавать как гипотезу, а не как установленный факт.
По данным Хабр Карьеры, медианная зарплата аналитика данных в России — 171 тыс. ₽, средняя около 185 тыс. ₽ (выборка из 1 088 анкет). Полезная точка отсчёта, но не ответ на вопрос «кто платит больше»: показатель относится ко всей специализации, а не к двум отраслям с одинаковым грейдом.
Для смежной специализации — SQL-аналитик — Хабр Карьера даёт такие ориентиры по грейдам:
Грейд | Москва | Санкт-Петербург | Удалёнка |
Junior | 80-140 тыс. ₽ | 80-135 тыс. ₽ | 70-120 тыс. ₽ |
Middle | 160-230 тыс. ₽ | 120-172 тыс. ₽ | 126-210 тыс. ₽ |
Senior | 220-300 тыс. ₽ | 190-270 тыс. ₽ | 200-300 тыс. ₽ |
Lead / Architect | 300-400 тыс. ₽ | 260-380 тыс. ₽ | 230-400 тыс. ₽ |
Как проверить тезис о зарплатном преимуществе банка
Без воспроизводимой выборки сравнение не имеет смысла. Минимальная методика:
собрать вакансии банков и ритейлеров за последние 60-90 дней;
разделить роли на грейды; отдельно вынести продуктовую аналитику, BI, риск-аналитику и аналитическую инженерию;
нормализовать регион, удалёнку, gross/net, фиксированную часть и бонусы;
считать медиану только по вакансиям с раскрытой зарплатой, их количество показать отдельно;
проверить устойчивость: не меняется ли вывод, если убрать вакансии с широкими вилками или смешанными ролями.
По одной-двум вакансиям, рейтингу работодателей или верхним границам офферов выводов делать нельзя.
Матрица навыков: Middle и Senior без воды
Навык | Middle | Senior |
SQL | Сложные JOIN, CTE, оконные функции, анализ плана запроса | Проектирование моделей, оптимизация запросов, выбор стратегии расчётов, контроль семантики метрик |
Python | Pandas, NumPy, API, Jupyter, автоматизация расчётов | Повторно используемые библиотеки, тестирование, воспроизводимость |
Статистика | Доверительные интервалы, проверка гипотез, A/B-тесты | Дизайн эксперимента, мощность, смещения, множественные проверки, причинная интерпретация |
BI | Дашборды, фильтры, расчёт показателей | Единые определения метрик, производительность, семантический слой |
Хранилища | Понимание схемы и гранулярности данных | Проектирование витрин, историчность, инкрементальные расчёты, lineage |
Инженерные практики | Git, базовые тесты, документация | Code review, CI/CD, контроль качества, наблюдаемость, архитектурные компромиссы |
Бизнес | Самостоятельное решение аналитической задачи | Постановка проблемы, выбор метрики, оценка эффекта, защита решения |
Что мастхэв, а что зависит от работодателя
Базовый слой: SQL, статистика, бизнес-метрики. Переносится между отраслями. Для Middle критичны оконные функции, понимание кардинальности JOIN, работа с временными срезами и умение объяснить, почему метрика изменилась.
Python и Git. Python полезен для статистики, обработки и автоматизации. Git — для истории изменений и ревью. Глубина требований зависит от того, ближе ли роль к BI, продуктовой аналитике или аналитической инженерии.
DWH, оркестрация, моделирование данных. PostgreSQL, ClickHouse, Airflow и dbt могут быть важны в зависимости от архитектуры работодателя. Middle должен понимать принципы, Senior — эксплуатационные ограничения.
Spark, Kafka, потоковая обработка. Это не универсальные требования к аналитику данных. Spark нужен, когда масштаб задачи оправдывает распределённые вычисления. Учить их ради строчки в резюме — сомнительная стратегия.
Что устаревает
Некорректно объявлять SQL или Excel устаревшими — они работают. Устаревает подход:
расчёты вручную повторяются в десятках таблиц без единого определения метрик;
SQL-запрос нельзя проверить, воспроизвести или передать коллеге;
дашборд создаётся без владельца показателя и проверки качества источника;
аналитик считает корреляцию доказательством причинности;
сложный стек применяется без понятного требования к задержке, объёму или надёжности.
Senior не тот, кто знает больше библиотек. Тот, кто умеет обосновать выбор. Если ежедневная агрегация в SQL решает задачу дешевле и надёжнее распределённого пайплайна — это может быть лучшим инженерным решением.
Четыре ошибки, которые стоят дороже всего
Это и задачи на собеседовании аналитика данных, и реальные проблемы повседневной работы.
Ошибка № 1. Соединить таблицы и получить правдоподобное, но неверное число
У одного заказа несколько строк товаров, к заказу привязаны несколько событий оплаты. JOIN на уровне заказа размножит строки и завысит сумму. Выглядит убедительно — и неправильно.
Решение: определить гранулярность каждой таблицы до соединения, проверить ключи, сравнить суммы до и после JOIN. Для финансовых показателей нужна сверка с контрольным источником.
Ошибка № 2. Перепутать прогноз с причинным эффектом
В ритейле после скидки выросли продажи. Без контрольной группы неизвестно, какой была бы динамика без неё. Возможно, начался сезонный пик. В банке после изменения процесса одобрения заявок снизилась просрочка. Но мог измениться состав клиентов, а не качество решения.
Решение: рандомизированный эксперимент там, где он допустим, либо обоснованный квазиэкспериментальный дизайн. Контролировать сезонность, состав выборки, смешивающие факторы.
Ошибка № 3. Data leakage: данные из будущего
При ретроспективном анализе легко использовать данные, которые на дату принятия решения ещё не были доступны. Это создаёт иллюзию качества модели или эффективности политики.
В банковском скоринге признак может содержать информацию о будущем поведении клиента. В ритейле похожая ошибка возникает, когда прогноз спроса использует окончательные данные об остатках, которых не было в момент прогноза.
Решение: фиксировать дату доступности признаков, строить исторические срезы, проверять, что в обучение не попали данные из будущего.
Ошибка № 4. Оптимизировать метрику, а не бизнес-результат
Рост кликов, конверсии или количества одобрений может сопровождаться ухудшением маржи, ростом мошенничества или увеличением будущих потерь. Это случай, когда guardrail metrics игнорируются ради одного красивого числа.
Решение: заранее определить основную метрику, защитные метрики и критерии остановки эксперимента. Результат оценивается вместе с экономикой и ограничениями процесса.
Практический кейс: одна задача, два бизнеса
Задача: оценить изменение процесса, которое должно увеличить прибыль. В банке — новый сценарий предложения кредитного продукта подходящим клиентам. В ритейле — скидка на выбранную категорию товаров.
Схема принятия решения
1. Постановка гипотезы — какое решение меняем и какой бизнес-эффект ожидаем.
2. Формирование выборки — единица рандомизации, критерии включения, исключение data leakage.
3. Выбор метрик:
- Банк: прибыль на клиента, просрочка, потери от мошенничества, жалобы.
- Ритейл: маржа, выручка на покупателя, наличие товара, возвраты.
4. Проверка результата — доверительный интервал, статистическая значимость, бизнес-значимость, защитные метрики.
5. Решение о запуске — раскатить, доработать или отказаться.
SQL для ритейла: измеряем эффект скидки
Есть таблица experiment_assignments с полями customer_id, variant и таблица orders с полями customer_id, order_date, revenue, gross_margin. Единица рандомизации — клиент.
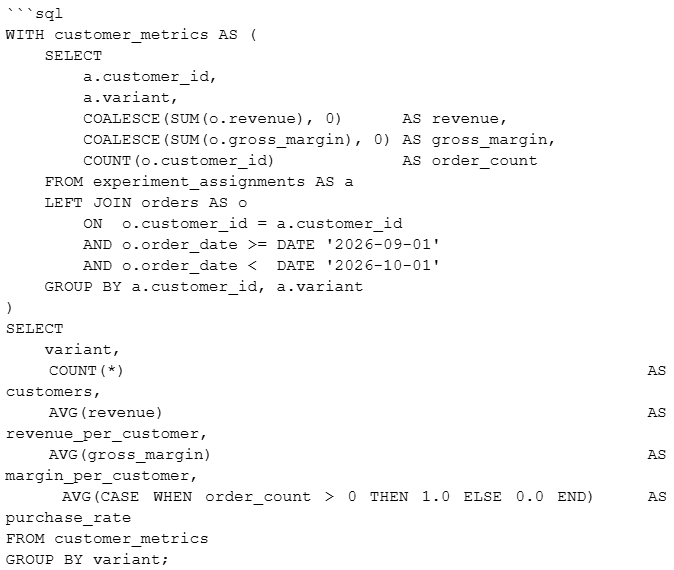
Запрос агрегирует результат до уровня клиента: клиенты без заказов остаются в выборке. Это важно. Если считать средний чек только среди покупателей, можно пропустить изменение вероятности покупки.
Этот SQL не доказывает, что скидка вызвала рост метрики. После агрегации нужно проверить корректность рандомизации, sample ratio mismatch (SRM), статистическую неопределённость и защитные метрики. В реальном проекте также нужно уточнить правила учёта скидок, возвратов, отмен и повторных заказов.
Как меняется кейс в банке
Для банковского предложения строится аналогичная таблица на уровне клиента, но целевая метрика — прибыль после учёта стоимости фондирования и ожидаемых потерь. Потребуется более длинный период наблюдения, если метрика связана с последующей просрочкой.
Не все банковские решения допустимо рандомизировать: есть ограничения по рискам, справедливости и законодательству. В таких случаях нужен наблюдательный или квазиэкспериментальный дизайн с явной фиксацией ограничений.
Как выбрать отрасль под себя
Универсального ответа нет. Но есть полезное разграничение.
Банк подходит лучше, если:
интересны риск, финансовые данные, антифрод и строгие требования к контролю;
привлекает работа с вероятностями и качеством финансовых решений;
не пугают регуляторные ограничения и долгий горизонт оценки;
хочется глубоко разобраться в одной предметной области.
Ритейл подходит лучше, если:
интересны эксперименты, спрос, цены, ассортимент и прямая связь аналитики с операционными решениями;
важно быстро видеть результат своей работы в продажах;
привлекают многофакторные причинно-следственные задачи;
интересна unit economics и экономика продукта.
Зарплата зависит не только от отрасли, но и от близости к решению. Аналитик, который готовит отчёт, и аналитик, чьи расчёты напрямую влияют на риск-политику или закупки, несут разную ответственность. Проверять нужно содержание роли, а не только название компании.
Где закрыть пробелы в навыках
Ниже — четыре программы из каталога Хабр Курсов, каждая привязана к конкретному пробелу, который разобран в статье. Цены актуальны на октябрь 2026 года: перед принятием решения стоит перепроверить условия в каталоге.
Пробел: нет сквозного стека — от SQL до автоматизации
После разбора архитектур DWH и инструментов оркестрации естественный следующий шаг — практика с реальным стеком. В программе «Аналитик данных расширенный» от Яндекс Практикума заявлены SQL, Python, PostgreSQL, Apache Airflow, ClickHouse, A/B-тестирование и PySpark. Широкий набор, который подходит для отработки перехода от разовых запросов к воспроизводимым расчётам.
Яндекс Практикум — Аналитик данных расширенный 12 месяцев, онлайн, 172 500 ₽ или от 7 042 ₽/мес.
Ограничение: программа длительная и дорогая. Наличие Airflow и PySpark в перечне не означает, что студент освоит эксплуатацию корпоративной платформы на уровне Senior. Банковская предметная область потребует отдельной практики.
Подробнее о программе — в каталоге Хабр Курсов
Пробел: нет практики — SQL и проверка гипотез
Теория статистики сама по себе не гарантирует, что аналитик сможет провести исследование от постановки вопроса до вывода. Для тренировки практического цикла можно рассмотреть Симулятор Аналитика от karpov courses: каталог заявляет работу с SQL, Python, BI и проверкой гипотез в формате практических задач.
karpov courses — Симулятор Аналитика 2 месяца практики, онлайн, 46 500 ₽
Ограничение: на странице каталога продолжительность описана неоднозначно (в карточке — месяц, в тексте — два). Перед записью стоит уточнить условия. Практическая программа не заменяет опыт работы с закрытыми финансовыми данными и корпоративными процессами.
Подробнее о программе — в каталоге Хабр Курсов
Пробел: нет целостного цикла — статистика и продуктовые метрики
Если специалисту не хватает практики от извлечения данных до интерпретации метрик, можно сравнить комплексные программы. В программе «Профессия: Аналитик данных + ИИ» от ProductStar × РБК заявлены SQL, Python, статистика, A/B-тестирование и LLM как вспомогательный инструмент.
ProductStar × РБК — Профессия: Аналитик данных + ИИ 12 месяцев, онлайн, 67 651 ₽ или от 2 088 ₽/мес.
Ограничение: широкий охват тем не подтверждает глубину каждой из них. Для уверенного Middle нужно проверить, есть ли в программе реальная практика по оптимизации SQL, экспериментальному дизайну и качеству данных.
Подробнее о программе — в каталоге Хабр Курсов
Пробел: нет фундамента — SQL, Python, статистика
Если аналитик пока не уверен в базовом стеке, не обязательно сразу выбирать длинную программу с распределёнными вычислениями. Сначала стоит закрыть основу: программа «Аналитик данных» от Нетологии охватывает SQL, PostgreSQL, Python, статистику и визуализацию.
Нетология — Аналитик данных 7 месяцев, онлайн, 101 000 ₽ или от 3 118 ₽/мес.
Ограничение: это широкая программа по аналитике, а не отраслевая специализация. Банковский антифрод, исторические срезы кредитных данных или ритейловые модели спроса потребуют отдельного проектного опыта.
Подробнее о программе — в каталоге Хабр Курсов
FAQ
Где выше зарплата — в банке или в ритейле?
По доступным данным на октябрь 2026 года уверенного ответа нет. Медиана по специализации «аналитик данных» на Хабр Карьере — 171 тыс. ₽, но это число не разбито по отраслям и грейдам одновременно. Сравнение имеет смысл только для одинакового грейда, региона и специализации.
Какие задачи на собеседовании аналитика данных спрашивают чаще всего?
SQL с оконными функциями и JOIN, проверка гипотез и A/B-тесты, статистика (p-value, доверительный интервал, мощность теста), интерпретация метрик. В банках добавляются вопросы о point-in-time correctness и data leakage; в ритейле — о причинно-следственных связях и дизайне экспериментов.
Стоит ли учить Spark и Kafka, чтобы получить оффер Middle?
Не обязательно. Это не универсальные требования. Сначала стоит закрыть SQL, статистику и понимание архитектуры хранилищ. Spark и Kafka нужны, когда задача действительно требует распределённых вычислений или потоковой обработки.
Как выбрать курс по аналитике данных онлайн?
Сначала определить конкретный пробел: SQL, статистика, экспериментальный дизайн или моделирование данных. Затем открыть детальный учебный план и проверить наличие практических заданий по нужной теме. Обещания трудоустройства и конкретной зарплаты — не критерии выбора.
