Привет, Хабр! Меня зовут Дима Борщевский, я QA Engineer в Авито Товары и работаю в IT около десяти лет. В последнее время я разбираюсь, какую часть подготовки мобильных E2E-тестов можно передать ИИ-агенту без снижения требований к качеству.
Сгенерировать несколько строк на Kotlin или Swift несложно. Сложнее получить изменение, которое использует инфраструктуру конкретного проекта, подготавливает воспроизводимые данные, проверяет результат каждого действия, компилируется и запускается. Обычного запроса в духе «напиши E2E-тест оформления заказа» для этого недостаточно.
В статье я разберу подход, оформленный как универсальный скилл для мобильных E2E-тестов. Он поддерживает Android и iOS, но не навязывает общий фреймворк: источником правил остаётся целевой репозиторий. Материал будет полезен QA-инженерам и разработчикам, которые уже используют ИИ для работы с кодом и хотят получать от него проверяемый результат.
Содержание
Почему болит мобильный E2E
Главная сложность мобильного E2E — не синтаксис тестового фреймворка. Агенту нужно одновременно восстановить контекст проекта и не потерять смысл пользовательского сценария. Обычно проблемы возникают в четырёх местах.
Неполный сценарий
Фраза «проверь создание заказа» описывает финальную цель, но не задаёт тест. Неясно, в каком состоянии находится приложение, какой товар выбирает пользователь, какие данные вводит, что должно происходить после каждого действия и где проверять созданный заказ. Если агент заполнит пробелы сам, код может выглядеть правдоподобно, но проверять другой сценарий.
Чужие паттерны
В одном Android-проекте используются Compose Test и test tags, в другом — Espresso и resource ID. В iOS-проектах отличаются target, scheme, test plan, правила запуска и accessibility identifiers. Даже внутри одной платформы могут различаться Page Objects, fixtures, аннотации, source sets и команды сборки. Универсальный шаблон редко совпадает с локальными соглашениями.
Хрупкие данные
Тест, который зависит от личного аккаунта, секретного токена или состояния предыдущего запуска, нельзя стабильно повторить. Генерация кода не решает эту проблему. Нужен существующий механизм подготовки данных: fixture, локальный seed, тестовое API или другое средство, которое уже принято в проекте.
Нет проверки
ИИ легко выдаёт код, похожий на рабочий. Этого мало. Изменение должно хотя бы компилироваться в правильном target, а при наличии устройства — проходить точный тестовый запуск. Иначе QA получает заготовку и завершает интеграцию вручную.
Почему обычного промпта недостаточно
Рассмотрим короткий запрос:
Напиши E2E-тест создания заказа для Android и iOS.
В запросе нет начального состояния, шагов, ожидаемых результатов и требований к данным. Также неизвестно, где находится проект и какие абстракции в нём приняты. Агенту остаётся угадывать. Обычно после такой генерации QA приходится самостоятельно:
искать ближайший рабочий тест, правила запуска,
fixture, Page Objects иbuild variant;переносить код в правильный модуль или
targetи заменять нестабильные селекторы;добавлять проверки, компилировать изменение и разбирать ошибки запуска.
Проблема решается не увеличением промпта, а явным процессом. Агент должен понимать, какую информацию нельзя выдумывать, где искать проектные правила и какие проверки обязательны перед завершением задачи.
Что такое скилл
Скилл — это набор инструкций, который задаёт агенту рабочий процесс. В нашем случае он описывает сбор сценария, поиск локальных паттернов, подготовку состояния, реализацию через проектные абстракции и проверку результата. Платформенные детали вынесены в отдельные инструкции для Android и iOS.
Скилл работает в трёх режимах.
Создание. Агент добавляет или изменяет E2E-тест и выполняет доступные проверки.
Ревью. Агент ищет конкретные проблемы и возвращает замечания с привязкой к коду, не переписывая тест без запроса.
Пример. Агент показывает нейтральный шаблон и явно отделяет его от готовой реализации для проекта.
Такое разделение важно. Запрос на ревью не должен неожиданно менять файлы, а демонстрационный пример не должен выглядеть как проверенный production-код.
Сначала воспроизводимый сценарий
Перед реализацией скилл собирает компактный бриф. Обязательны платформа, проект, воспроизводимый precondition, последовательность действий, ожидаемый результат после каждого действия и финальный бизнес-результат. Отдельно фиксируются тестовые данные и специальные проверки: аналитика, сеть, WebView, permissions или ограничения ОС.
Хороший запрос выглядит примерно так:
Создай Android E2E-тест оформления заказа в текущем проекте.
Precondition: в приложении нет сохранённого пользователя и заказов.
1. Войти с синтетическим email.
Ожидаемый результат: открыт каталог.
2. Добавить кофеварку в корзину.
Ожидаемый результат: товар отмечен как добавленный.
3. Открыть корзину.
Ожидаемый результат: в корзине показана кофеварка.
4. Перейти к оформлению и заполнить данные доставки.
Ожидаемый результат: кнопка создания заказа доступна.
5. Создать заказ.
Ожидаемый результат: показан экран успеха с номером заказа.
6. Открыть список заказов.
Ожидаемый результат: заказ отображается со статусом Active.
Используй существующие fixture, Page Objects и команды сборки.
Не добавляй сетевые моки и fixed sleep.
Если precondition или ожидаемые результаты отсутствуют и их нельзя получить из тест-кейса, скилл задаёт уточняющий вопрос. Код приложения помогает найти доступные действия и локаторы, но не заменяет описание намерения теста.
Как получается рабочий E2E
Поиск контракта проекта
Агент сначала читает инструкции репозитория, конфигурацию сборки и ближайший активный тест. Затем он прослеживает все используемые им зависимости: launch rules, fixtures, Page Objects, helpers, locators и регистрацию в suite. Игнорируемые или quarantined-тесты не становятся основным образцом, если рядом есть стабильный вариант.
Это снижает риск создать технически корректный тест, который не вписывается в проект. Код оказывается в нужном source set, использует правильный runner и повторяет локальные соглашения по именованию.
Детерминированное состояние
Скилл переиспользует реальный механизм подготовки состояния. Для офлайн-приложения это может быть очистка локального хранилища перед запуском. Для проекта с backend — тестовое API или генератор данных, уже применяемый соседними тестами. Личные аккаунты, секреты и остаточное состояние устройства не подходят.
Сетевой мок также не добавляется только ради удобства. Если сценарий заявлен как E2E, подмена ответа backend меняет его границы и требует отдельного решения команды.
Сначала Page Object
Если проект использует Page Objects, robots или screen classes, селекторы не попадают в тело теста. Агент сначала ищет подходящий метод в существующей абстракции, затем минимально расширяет её. Новый стабильный идентификатор добавляется в приложение только тогда, когда надёжного локатора действительно нет.
Проверка после действия
Каждый шаг завершается наблюдаемым результатом. После нажатия на кнопку проверяется не факт клика, а состояние, которое видит пользователь: открытый экран, добавленный товар, доступная отправка формы, номер заказа или его статус.
Для синхронизации используются возможности тестового фреймворка и ожидание целевого состояния. Фиксированные паузы и бесконечные polling loops маскируют проблемы и делают тест медленнее.
Компиляция и запуск
Сначала запускается самая узкая команда, которая компилирует изменённый тестовый target. Затем, если доступен совместимый эмулятор, симулятор или устройство, выполняется конкретный тест. Ошибки, вызванные изменением, исправляются до завершения задачи. Недоступное устройство не отменяет статические проверки и компиляцию, но явно указывается как ограничение.
Пример с mobile-e2e-demo-app
Для демонстрации я использовал небольшое Android-приложение с одним пользовательским путём: вход, добавление товара, корзина, оформление заказа, экран успеха и проверка заказа в разделе My orders.
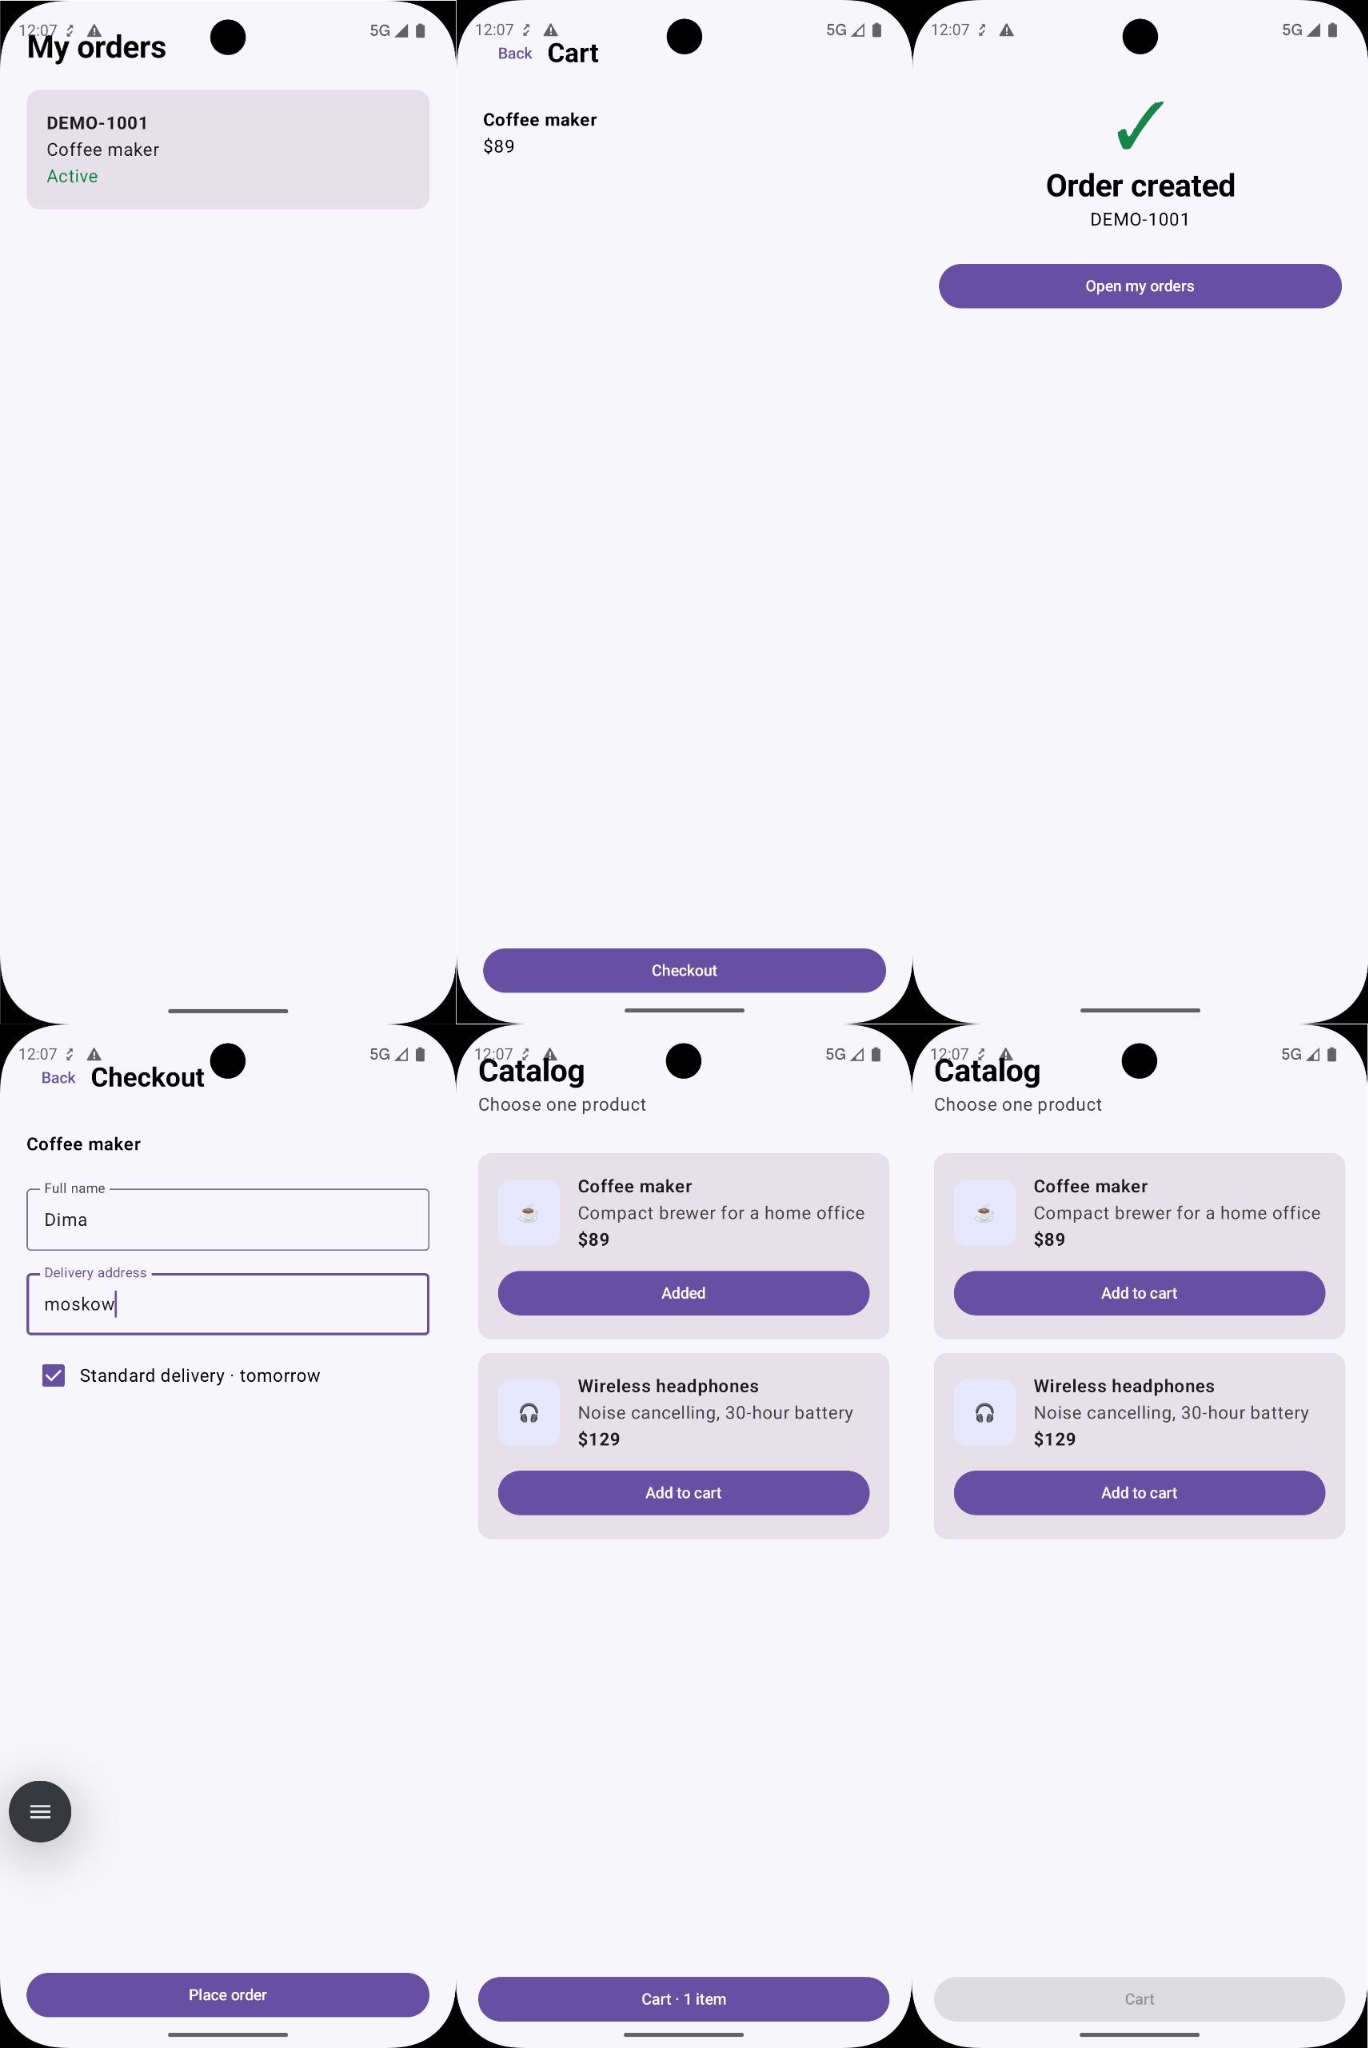
В проекте заранее есть стабильные test tags, Page Objects для всех экранов, правило очистки локальных данных и один рабочий тест авторизации. Полный тест создания заказа намеренно отсутствует. Поэтому агенту не нужно проектировать инфраструктуру: задача состоит в том, чтобы найти её и правильно собрать сценарий.
Сокращённое тело теста выглядит так:
@Test
fun createOrder() {
    precondition("No saved user or orders") {
        login.assertOpened()
    }

    step("Sign in") {
        login.enterEmail("demo@example.com")
        login.submit()
        catalog.assertOpened()
    }

    step("Add a product and open the cart") {
        catalog.addProduct()
        catalog.assertProductAdded()
        catalog.openCart()
        cart.assertProduct("Coffee maker")
    }

    step("Place the order") {
        cart.checkout()
        checkout.fillCustomer("Alex Doe", "10 Main Street")
        checkout.selectDelivery()
        checkout.assertSubmissionAvailable()
        checkout.placeOrder()
        success.assertOrderNumber("DEMO-1001")
    }

    step("Verify the active order") {
        success.openOrders()
        orders.assertActiveOrder("DEMO-1001", "Coffee maker")
    }
}
Это иллюстративный фрагмент. Важен здесь порядок: состояние создаётся заново, действия выполняются через Page Objects, а после каждого перехода проверяется результат. В реальном проекте имена методов, метаданные и команды берутся из репозитория.
В демо сам инструментальный тест выполняется примерно за 6 секунд, весь тестовый набор — примерно за 7,2 секунды. Основное время уходит не на выполнение, а на чтение проекта, создание изменения и первую проверку сборки.
Android и iOS остаются разными
Общий бриф можно использовать для обеих платформ, но реализация должна оставаться нативной.
В Android-ветке агент определяет, используется ли View, Compose или смешанный стек, находит instrumentation runner, rules, test tags и build variant. В iOS-ветке он проверяет XCTest или XCUITest, target, scheme, test plan, launcher и accessibility identifiers.
Скилл не пытается скрыть эти различия общим псевдофреймворком. Он фиксирует единые требования к сценарию и качеству, а код строит по правилам каждой платформы.
Где остаётся работа QA
Скилл снимает поиск и механическую сборку решения, но не принимает продуктовые решения за QA. Инженер по-прежнему определяет, какой пользовательский путь важен, какие состояния считаются корректными и какие данные можно создавать в тестовой среде.
Перед принятием изменения QA проверяет:
соответствует ли precondition реальному состоянию системы;
есть ли после каждого действия проверяемый результат;
подтверждает ли финальная проверка бизнес-результат;
используются ли проектные Page Objects и стабильные локаторы;
нет ли fixed sleep, бесконечных повторов, секретов и личных аккаунтов;
не подменяет ли сетевой мок настоящий E2E;
попал ли тест в правильный
targetилиsuite;прошли ли компиляция и целевой запуск.
ИИ ускоряет подготовку изменения, а ответственность за смысл сценария и принятие кода остаётся у команды.
Как измерять качество
Количество сгенерированных строк ничего не говорит о результате. Для пилота полезнее собирать несколько практических метрик:
Время до первого проходящего теста. От готового брифа до успешного
target run.Компиляция с первой попытки. Доля изменений, которые сразу собираются в нужном
target.Ручные исправления. Сколько изменений QA вносит после генерации и почему.
Стабильность. Доля успешных повторных запусков без изменений кода и данных.
Дефекты ревью. Сколько раз агент пропускает обязательную проверку, использует нестабильный локатор или нарушает границы E2E.
Эти данные показывают, где скилл действительно экономит время, а где его правила нужно уточнить.
Что меняется для QA
Для подготовленного демо-проекта оценка выглядит так:
Этап | Без скилла | Со скиллом | Экономия |
Подготовка сценария | ~ 10 мин | ~ 1 мин | ~ 9 мин |
Поиск паттернов и адаптация | ~ 30 мин | ~ 2 мин | ~ 28 мин |
Проверка и исправления | ~ 20 мин | ~ 5 мин | ~ 15 мин |
Итого на один E2E | ~ 60 мин | ~ 8 мин | ~ 52 мин |
Это оценка для mobile-e2e-demo-app, где уже готовы Page Objects, test tags и детерминированные данные, а Gradle прогрет. Это не универсальный benchmark. В production-проекте время зависит от размера репозитория, качества тестовой инфраструктуры, доступности данных и стабильности окружения.
Как внедрять скилл в команде
Начинать лучше с небольшого пилота на одном стабильном сценарии. Выберите путь, который команда уже умеет выполнять вручную, подготовьте точный бриф и измерьте время до проходящего теста. Затем сравните изменение с локальными стандартами и запишите причины ручных исправлений.
Ошибки пилота должны превращаться в правила скилла. Если агент регулярно выбирает quarantined-тест как образец, это нужно явно запретить. Если путает target или variant, стоит уточнить порядок поиска. Если QA-инженер каждый раз добавляет одну и ту же проверку, она должна стать частью quality gate.
Команде не требуется учиться писать длинные магические промпты. Достаточно уметь формулировать precondition, действие и ожидаемый результат, понимать тестовую архитектуру проекта и проводить код-ревью.
Ограничения и безопасность
Скилл не исправляет отсутствие тестовой инфраструктуры. Если в проекте нет способа подготовить данные, стабильных локаторов или команды для сборки тестового target, агент должен сообщить о конкретном пробеле. Добавление нового фреймворка или широкое изменение архитектуры требует отдельного решения.
Код репозитория и тестовые данные следует считать конфиденциальными. В тестах нельзя хранить пароли, токены, реальные аккаунты и персональные данные. Для публикаций примеры нужно очищать от внутренних package names, endpoints, идентификаторов и названий сервисов. Доступ агента к репозиторию и окружению должен соответствовать правилам команды, а итоговый diff — проходить обычное ревью.
Что можно попробовать сегодня
Выберите один активный мобильный E2E-сценарий или подробно опишите новый.
Запишите воспроизводимый precondition и ожидаемый результат каждого действия.
Убедитесь, что в проекте есть стабильный соседний тест, fixture и команда компиляции.
Запустите скилл в режиме создания и попросите выполнить узкую проверку.
Проведите ревью по
quality gateи зафиксируйте ручные исправления.Повторите пилот на нескольких сценариях и сравните время и стабильность.
Итог
ИИ-агент полезен в мобильном E2E, когда получает не только описание финального экрана, но и рабочий контракт: воспроизводимый сценарий, правила проекта и обязательную проверку изменения. Скилл фиксирует этот контракт и не даёт закончить задачу на правдоподобном фрагменте кода.
На подготовленном проекте это сокращает путь до проходящего теста с десятков минут до 8 минут. В менее зрелой инфраструктуре выигрыш будет другим, но сам процесс быстро показывает, где находится настоящее ограничение: в сценарии, данных, локаторах, сборке или окружении.