Каждый понедельник кто-то в офисе вручную копирует строки из 20 Excel-отчётов в один файл. Три часа уходит на сбор данных, ещё час — на поиск дублей и пустых ячеек. Итого: полрабочего дня на задачу, которую Python решает за 15 минут.
В этой статье — пять практических скриптов для реального сценария: отдел продаж получает еженедельные отчёты из разных источников, проверяет их качество и готовит сводную книгу для руководителя. Каждый пример можно адаптировать под свой процесс.
Оглавление
VBA, Power Query или Python: что выбрать
Три инструмента автоматизации в Excel — и у каждого своя ниша. Их часто противопоставляют, хотя на практике они нередко работают в связке.
VBA по-прежнему полезен для макросов внутри существующих книг. Он встроен в Excel, не требует установки и понятен тем, кто уже работает с приложением. Искать готовые макросы где-то на стороне — плохая идея: неизвестный код VBA может навредить данным или системе. Но писать собственные простые макросы для конкретных книг — вполне разумно.
Power Query — это часть самого Excel. Для типовых преобразований данных он зачастую проще в сопровождении, чем отдельный скрипт. Загрузить файл, привести типы, объединить столбцы, обновить отчёт — всё это Power Query делает без единой строчки кода. Для тех, кто работает исключительно внутри Excel, это более прямой путь, чем сразу изучать Python.
Курс «Excel: от основ до анализа данных» от Нетологии (2 месяца, 30 300 ₽, рассрочка от 2 803 ₽/мес.) охватывает именно этот набор: Power Query, Power Pivot, сводные таблицы и визуализацию. Объективное ограничение: это курс по Excel и анализу данных, а не по Python-автоматизации — написать автономный скрипт он не научит.
Python становится нужным тогда, когда задача выходит за пределы Excel: сложные правила проверки данных, несколько источников, нужен запуск по расписанию, важна повторяемость и логирование. Именно здесь ручной труд превращается в воспроизводимый процесс.
Как Python читает и изменяет Excel-файлы
Три принципиально разных подхода. Выбор влияет на скорость, совместимость и сложность развёртывания.
Без запуска Excel — библиотеки openpyxl и pandas читают файл как набор данных. Excel может даже не быть установлен на машине. Подходит для массовой обработки книг и пакетных операций.
Табличная обработка в памяти — pandas загружает данные в DataFrame, позволяет их очищать, группировать и соединять. Удобно для аналитики, но требует, чтобы данные помещались в оперативную память.
Управление запущенным Excel — xlwings и pywin32 взаимодействуют с самим приложением: листами, пересчётом формул, объектами. Нужно тогда, когда критичны специфические функции приложения, но сложнее в развёртывании и эксплуатации.
Сравнение python excel библиотек
Инструмент | Для чего | Основное ограничение |
openpyxl | Чтение и изменение .xlsx, .xlsm | Не вычисляет формулы самостоятельно |
pandas | Очистка, объединение, группировка данных | Не сохраняет форматирование книги точно |
xlsxwriter | Создание новых книг с оформлением | Не редактирует существующую книгу |
xlwings | Работа с приложением Excel | Зависит от установленного Excel |
pywin32 | COM-автоматизация в Windows | Привязана к Windows |
Есть нюанс, который легко упустить: Excel — не просто сетка ячеек. Книга может содержать формулы, именованные диапазоны, макросы, внешние ссылки, сводные таблицы. openpyxl сохраняет формулу как текст, но не выполняет вычисление. Если открыть файл с data_only=True, вернётся последнее сохранённое значение, а не результат нового расчёта.
Вывод: до написания первого скрипта нужно определить не только, какие данные изменить, но и какие свойства книги должны остаться нетронутыми.
Пять скриптов: от сбора данных до проверенного отчёта
Все пять примеров — части одного процесса. Сначала устанавливаем зависимости:
python -m pip install pandas openpyxl xlsxwriter
Скрипт 1. Объединяем десятки файлов в один
Задача. Сотрудники выгружают еженедельные отчёты по продажам в отдельные файлы. Вместо ручного копирования строк — один скрипт.
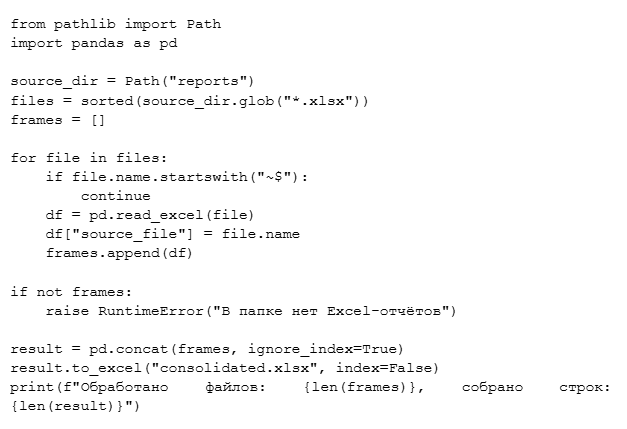
source_file — не просто лишняя колонка. Она позволяет отследить, из какого именно файла пришла ошибочная запись. Без неё отладка превращается в угадайку.
Важно: пример предполагает одинаковую структуру всех отчётов. Если названия столбцов различаются — их нужно привести к единой схеме до объединения.
Скрипт 2. Находим пропуски, дубликаты и подозрительные значения
Задача. В итоговой таблице появились пустые идентификаторы заказов, повторяющиеся строки и отрицательные суммы. Если передать такой отчёт дальше без проверки — ошибка попадёт в финансовую сводку.
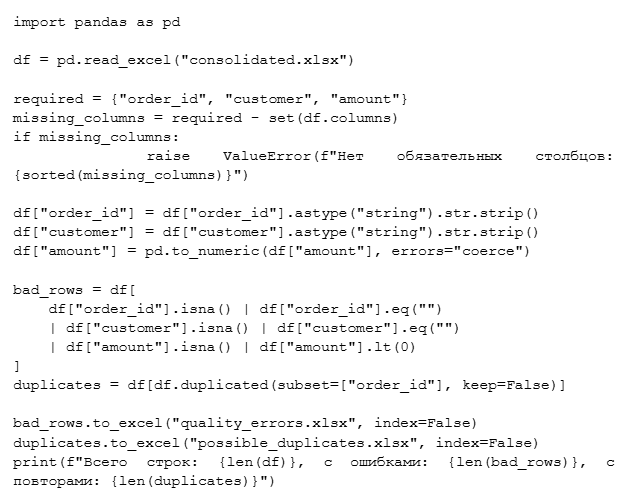
Принципиально важно: скрипт не исправляет данные там, где правило неоднозначно. Две строки с одинаковым order_id могут быть случайным дублем, а могут отражать несколько позиций одного заказа. Отдельный отчёт с ошибками полезнее, чем безусловное удаление подозрительных строк.
Скрипт 3. Объединяем продажи со справочником сотрудников
Задача. В отчёте есть идентификатор менеджера, но нет имени и отдела — они хранятся в отдельном справочнике.
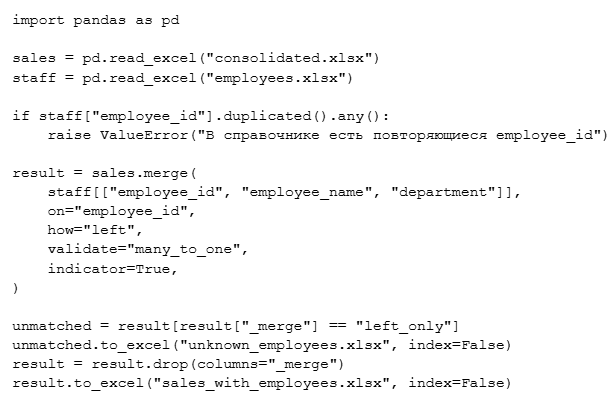
Здесь прослеживается прямая связь с реляционными базами данных. validate="many_to_one" проверяет, что каждой записи справочника соответствует не более одной строки. indicator=True сохраняет перечень записей без соответствия.
Документация pandas предупреждает: соединение «многие ко многим» при повторяющихся ключах с обеих сторон порождает декартово произведение. Если после объединения вместо 50 тысяч строк получилось 180 тысяч — причина, скорее всего, именно в ключах.
Скрипт 4. Формируем ежемесячный отчёт по выручке
Задача. Руководитель каждый месяц получает таблицу с выручкой по отделам. Вместо ручных фильтров, сводных таблиц и копирования — готовая книга.
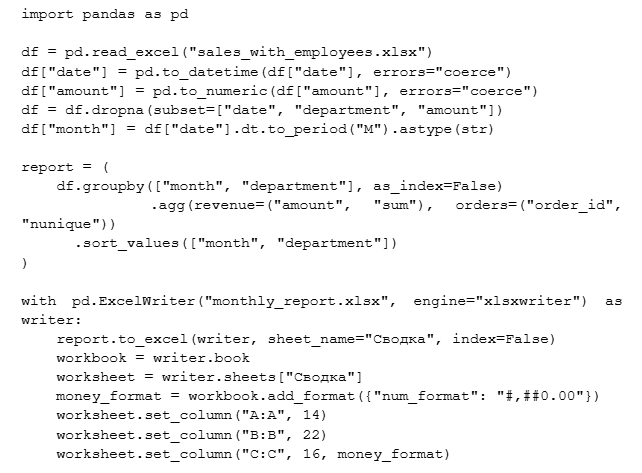
nunique() считает уникальные идентификаторы заказов, а не строки. Если заказ распределён между несколькими отделами, его посчитают в каждом — это вопрос бизнес-логики, а не синтаксиса Python.
Если нужен не просто файл с таблицей, а постоянно обновляемая система показателей — следующий шаг: переход от Excel к Power BI. Курс «Excel academy + Power BI для анализа данных» от SF Education (2 месяца, 25 000 ₽, рассрочка от 2 083 ₽/мес.) охватывает именно этот переход: Excel, Power BI, визуализацию и дашборды. Объективное ограничение: программа ориентирована на аналитику и визуализацию, а не на написание автономных Python-скриптов.
Скрипт 5. Проверяем отчёт перед отправкой
Задача. Скрипт запускается по расписанию. Если входной файл пустой, отсутствует обязательный столбец или суммы содержат нечисловые значения — он не должен молча формировать и отправлять некорректный отчёт.
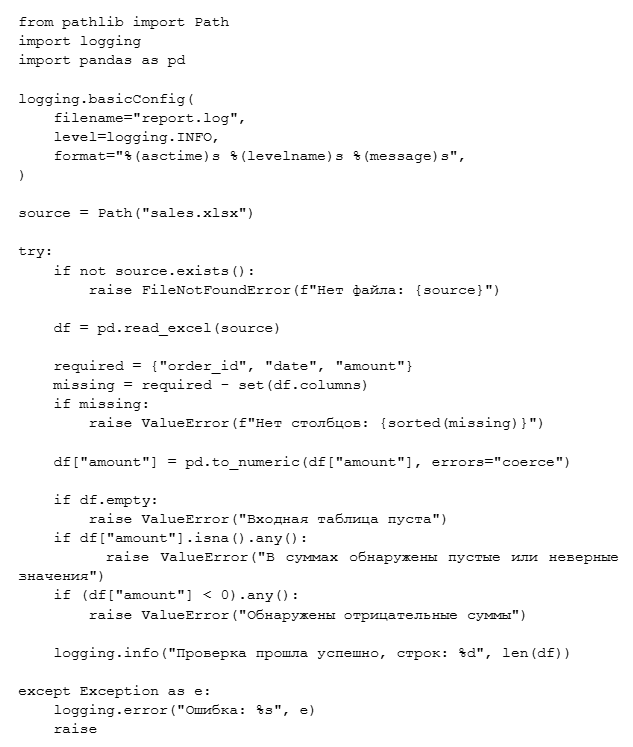
Это заготовка для производственного процесса, а не универсальная валидация финансовых данных. Правила проверки — допустимость отрицательных сумм, уникальность идентификаторов, поведение при пустой таблице — нужно определять для конкретной задачи.
Как пять скриптов работают вместе
Так выглядит процесс целиком:
Сбор — объединяем книги, сохраняем источники (скрипт 1).
Контроль качества — проверяем типы, пропуски, повторы (скрипт 2).
Обогащение — соединяем со справочниками (скрипт 3).
Формирование — группируем и создаём итоговую книгу (скрипт 4).
Валидация — проверяем перед отправкой, записываем журнал (скрипт 5).
В производственной версии скрипты используют общие функции чтения и проверки, а не дублируют логику из файла в файл. Тогда исправление правила в одном месте не потребует ручного изменения пяти программ.
Подводные камни
Книга Excel — не просто таблица
openpyxl не поддерживает все объекты формата. Документация предупреждает: при открытии и повторном сохранении существующей книги часть элементов — фигуры, некоторые настройки — может быть потеряна. Макросы требуют keep_vba=True, а редактировать сам код VBA библиотека не умеет.
Как избежать: работать с копией, проверять сохранённую книгу вручную, использовать специализированные инструменты для книг со сложными объектами.
Ключи соединения могут оказаться неуникальными
Дублирующиеся идентификаторы способны многократно увеличить число строк после merge. Пропуски и различия в форматах ключей — тоже. Как избежать: задавать ожидаемую связь через validate, проверять уникальность ключей заранее, сохранять список несовпадений в отдельный файл.
pandas держит всё в памяти
Несколько крупных книг, промежуточные копии таблиц и операции объединения могут потребовать существенно больше памяти, чем занимает исходный файл на диске.
Как избежать: загружать только нужные столбцы, фильтровать данные при чтении, переносить тяжёлые агрегации в базу данных.
Самая дорогая ошибка — правдоподобный неправильный отчёт
Скрипт может безошибочно выполнить неверное бизнес-правило: удалить законные повторяющиеся позиции заказа, принять пустую сумму за ноль, перепутать дату и текстовое поле. Скрипт, который упал с исключением, заметен сразу. Скрипт, который незаметно умножил строки при соединении таблиц, портит управленческие решения тихо.
Как избежать: сформулировать правила проверки, подготовить тестовые данные с известными результатами и сверять итоговые суммы с ожидаемыми.
Безопасность данных
Корпоративные книги с персональными данными или финансовой информацией не следует отправлять в непроверенные облачные сервисы. Перед использованием Python in Excel или сторонних платформ — сверить с политикой организации. Пароли и ключи доступа не должны попадать в исходный код.
Как развивать навыки дальше
Если логика понятна, а код писать ещё трудно
Адаптировать примеры под свои данные — изменить пути к файлам, названия столбцов, правила проверки — без базового понимания языка не получится. Скрипт будет работать ровно до первой нестандартной ситуации.
«Основы Python» от Хекслет (1 месяц, 495 ₽) — короткая вводная программа: переменные, циклы, функции, файлы. Она закрывает именно тот минимум, который нужен для понимания примеров выше. Объективное ограничение: отдельных занятий по openpyxl, pandas или созданию Excel-отчётов в описании каталога не заявлено.
Если скрипты работают, но процесс ещё нестабилен
Когда задача усложняется — нужна модульная структура, обработка ошибок, мониторинг, визуализация результатов, — курс «Python для инженеров» от Skillbox (2 месяца, 28 789 ₽, рассрочка от 9 596 ₽/мес.) охватывает pandas, Matplotlib и Plotly. Наличие отдельного модуля по openpyxl или созданию Excel-отчётов в каталоге не подтверждено — перед записью стоит уточнить актуальный учебный план.
Что ещё стоит освоить
SQL — когда данные уже находятся в базе, фильтровать и агрегировать рациональнее там, а не выгружать всю таблицу в Excel.
Git — даже небольшой скрипт должен храниться в репозитории: без версионирования история изменений теряется.
Планировщик задач — cron на Linux или «Планировщик заданий» на Windows запускают скрипт по расписанию без ручного вмешательства.
FAQ
Можно ли использовать Python прямо в Excel, без отдельного скрипта?
Да — Microsoft добавила возможность выполнять Python в ячейках Excel 365. Вычисления выполняются в облаке и требуют интернет-соединения; доступность зависит от платформы и подписки. Это не то же самое, что автономный локальный скрипт для массовой обработки файлов — архитектура, ограничения и сценарии применения принципиально разные.
Нужно ли знать программирование, чтобы использовать эти скрипты?
Запустить — нет. Адаптировать под свои данные и разобраться с ошибками — уже нужно базовое понимание Python. Без этого скрипт будет работать ровно до первой нестандартной ситуации: непривычного формата даты, другого названия столбца, неожиданно пустого файла.
Что делать, если в книге есть формулы и макросы?
Работать с копией. Проверять сохранённый файл вручную после каждого изменения. Если нужно сохранить макросы, использовать формат .xlsm и параметр keep_vba=True в openpyxl. Сложные элементы книги — сводные таблицы, внешние связи — могут изменится или исчезнуть при обработке через библиотеку.