Изначально я планировал написать классический лонгрид про своё участие в чемпионате ROADEF 2026. Там я занял «почётное» 48-е место из 78 валидных участников, так что и кодом есть чем делиться, и историями с полей. Но тут на глаза мне попалось объявление на Кворке: какой‑то суровый заказчик предлагал за 500 рублей разработать с нуля связку «Браузер + Поисковик».
Я сидел, смотрел на это и думал: кого же мне порадовать? Дорогого читателя или этого щедрого продюсера с биржи фриланса? Решение пришло компромиссное: мы сделаем Поисковик‑Браузер для хабровчан и пробросим через сервер в народ. А заказчик с Кворка пусть оставит 500 рублей, купит мороженку.
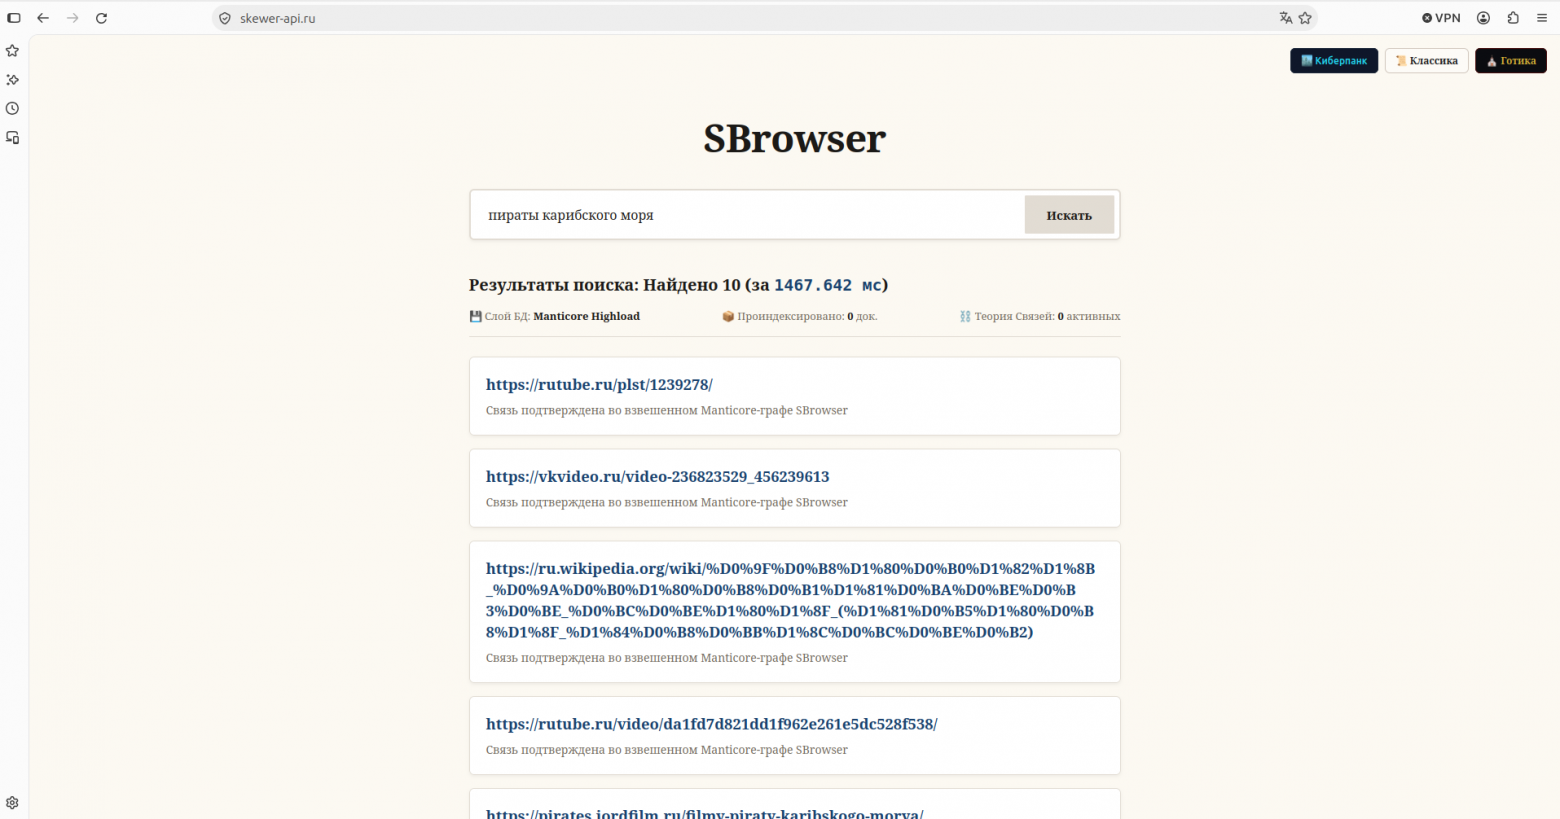
(барабанная дробь) Встречайте SBrowserV2 — легковесный асинхронный поисковый движок.
Архитектура системы: Как устроен SBrowserV2
Проектировать «убийцу Google» на коленке — занятие весёлое, но бессмысленное, поэтому мы сразу заложили взрослую, высоконагруженную архитектуру без синхронных задержек. Весь проект развернут в изолированных Docker‑контейнерах и разделён на четыре компонента:
Асинхронный шлюз (FastAPI): Реактивный бэкенд, который отдаёт фронтенд со сменными стилями (Киберпанк / Классика / Готика) и обрабатывает поисковую строку. Время отдачи интерфейса — доли миллисекунды.
Поисковый слой (Manticore Search RT): Быстрая база данных на C++, заточенная под полнотекстовый поиск. Никакого тяжелого, прожорливого Elasticsearch.
ИИ‑Бустер: Если в локальной базе находится меньше результатов, Бустер на лету имитирует легальные запросы к внешним источникам, вытаскивая свежую выдачу.
Фоновый Паук (
crawler): Асинхронный конвейер, который на лету выкачивает новые страницы, очищает их от HTML‑мусора (скрипты, стили) и зашивает чистый текст в индекс Manticore.
⛓️ Откуда взялась «Теория Связей»?
Само ядро ранжирования основано на концепции «Теории Связей», про которую я узнал от Константина Дьяченко. Было бы крайне некрасиво использовать его идеи и не упомянуть автора.
Суть подхода в том, что поисковая выдача — это не статичный набор документов, а живой граф, который обучается на поведении пользователей. Каждый раз, когда человек кликает по ссылке, веса графа пересчитываются. Документы, которые действительно решают проблему пользователя, начинают стремительно «всплывать» вверх, формируя релевантные связи между поисковым запросом и конкретным URL, оставляя SEO‑мусор далеко позади.
Снаружи всё это прикрыто веб‑сервером Nginx и наглухо зашифровано через SSL Let's Encrypt.
Как мы учили Docker дружить с TLS
Нужно уточнить: первая домашняя версия прототипа собиралась на коленке как десктопное приложение. Это была связка PyQt6 (интерфейс браузера) + файл JSON в качестве локальной базы данных.
Когда пришло время превращать проект в боевой, отказоустойчивый стек FastAPI + наша база Manticore Search, и упаковывать всё в Docker‑контейнеры для деплоя на сервер, мы тут же собрали все классические грабли асинхронности и сетевой изоляции.
Внутри контейнера Бустер сначала наглухо падал на SSL‑рукопожатиях с внешними шлюзами. Оказалось, в базовом python-slim образе хранилище сертификатов не доверяет ряду современных шлюзов. Мы зашили в Dockerfile бэкенда принудительное обновление и регистрацию системных сертификатов Минцифры РФ, без которых защищенные соединения рвались на уровне сокетов.
Для разбавления текста покажу, как выглядит стандартный абстрактный воркер нашего фонового Паука. Код абсолютно тривиален — обычный бесконечный цикл asyncio, который гоняет задачи из очереди:
# Базовый скелет фонового конвейера (Воркер Паука)
async def run_pre_crawl(queue: asyncio.Queue):
    print("🕸️ [Паук] Фоновый асинхронный конвейер запущен...", flush=True)
    while True:
        try:
            # Ждем ссылку из очереди, которую туда подкинул шлюз
            target_url = await queue.get()

            # Стандартная зачистка текста через BeautifulSoup
            async with httpx.AsyncClient(timeout=5.0) as client:
                res = await client.get(target_url)
                if res.status_code == 200:
                    soup = BeautifulSoup(res.text, "lxml")
                    for trash in soup(["script", "style", "noscript"]):
                        trash.extract()
                    clean_text = " ".join(soup.get_text().split())

                    # Дальнейшая магия индексации зашита глубоко в ядре...

            queue.task_done()
        except Exception as e:
            print(f"⚠️ Ошибка воркера: {e}")
Вторым шагом мы полностью переработали логику общения с Manticore SQL. Manticore в секциях VALUES требует только атомарные, заранее вычисленные статические значения. Архитектурно это решается простейшим расчетом уникального числового ID на стороне Python:
# Генерация 64-битного ID для документов Manticore RT
def generate_manticore_id(url_str: str) -> int:
    # Обычный хэш от строки, приведенный к границам BIGINT в C++
    return abs(hash(url_str)) % (2**63 - 1)
24 октября 2026 года. UPD: Большое обновление архитектуры до версии v2.1 (Связи, Кириллица и Живые Подсказки)
Статья вызвала отличный отклик, и поисковик прямо в продакшене начал активно наполняться «коллективным разумом» хабровчан. Стек из FastAPI и Manticore Search показал себя железно, но в процессе эксплуатации мы собрали вторую партию высоконагруженных граблей и оперативно выкатили крупное обновление ядра. Делюсь свежими архитектурными решениями.
🎨 1. Косметическая маска для кириллицы (Защита ядра от рассинхронизации)
Первая проблема, с которой мы столкнулись: при парсинге рунета ссылки улетали в Manticore в родном URL‑encoded формате со знаками процентов (вроде %D0%BC%D0%B0...). Если декодировать их прямо на бэкенде в сырой русский текст, ломается логика Робота‑Паука и сравнение строк при начислении весов в «Теории Связей» — база начинает двоить данные и слепнуть.
Решение: Мы применили принцип «изолированного декодирования только при выводе». Бэкенд и база на 100% продолжают оперировать строгими процентными строками, а на фронтенде в JS‑функцию рендеринга результатов была встроена нативная маска:
let clearRussianText = decodeURIComponent(url);
// В href улетает оригинал с процентами, а пользователь видит красивые русские буквы:
card.innerHTML = `<a href="${url}">${clearRussianText}</a>`;
⚡ 2. Переход на нативный Lifespan и веерный ИИ‑Бустер
Старый механизм инициализации через @app.on_event("startup") в Python 3.12 окончательно признан устаревшим (deprecated) и выдавал тонны предупреждений в консоль, а главное — не гарантировал координацию потоков. При рестарте контейнеров фоновый Паук обрывал транзакции и Manticore «терял» только что добавленные документы.
Мы полностью переписали управление процессами на асинхронный контекстный менеджер lifespan:
@asynccontextmanager
async def lifespan(app: FastAPI):    db_manager.init_manticore() # Старт базы    crawler_task = asyncio.create_task(run_pre_crawl(None)) # Старт Паука    yield    crawler_task.cancel() # Вежливая остановка при деплое без потери кэша на диске
Сам ИИ‑Бустер превратился в асинхронный сетевой веер. Теперь он опрашивает параллельно сразу 4 тактики (DDG, Bing, Startpage, Wikipedia), защищая систему от капчи или блокировки серверного IP. Если один шлюз падает, резервные подхватывают запрос на лету, а встроенный фильтр очищает интерфейсный мусор парсеров (вроде битых стрелочек › от Бинга) до отправки данных в Паук.
🧠 3. Краудсорсинг подсказок (Suggestions «как у Гугла» за 0.5 миллисекунды)
Самая мощная инновация апдейта — живое автодополнение строки ввода, завязанное на «Теорию Связей». Мы хотели сделать подсказки умными, но защищенными от мусора.
Архитектурный алгоритм получился следующим:
Фиксация строго по клику (Пэцканью): Если пользователь просто ввел ошибочный запрос и ушел, система его игнорирует. Но если запрос привел к реальному полезному действию — клику по ссылке, фраза пролетает через бэкенд.
Тройной фильтр безопасности: Монолитный изолированный модуль
suggestions.pyпроверяет фразу перед записью: длина от 3 до 50 символов, строго от 1 до 4 слов, полный запрет на спецсимволы и знаки вопросов. Никакого мусора в базе.Ранжирование популярности в Manticore: Под это дело развернута сверхлегкая RT‑таблица
search_suggestionsбез стемминга (для стопроцентной визуальной точности букв). При каждом полезном клике вес фразы инкрементируется (query_weight += 1).Пословный префиксный поиск: Новый эндпоинт
/api/suggestionsна лету токенизирует ввод пользователя оператором со звездочкой*. База ищет совпадение с начала любого слова во фразе. Вводителедоко...— и система мгновенно выкатывает из RAM‑чонка подсказку «судно ледокол», отсортированную по реальным кликам других людей.
На фронтенде мы прикрыли это парящим меню, перекрашивающимся под выбранную тему (Киберпанк/Готика), и защитили сеть простейшим JS‑дебаунсом (Debounce 250 мс), чтобы не спамить базу на каждую нажатую букву.
📈 Результат дообучения в цифрах
Система стала полностью самообучаемой. При первом поиске по новому запросу счетчик проиндексированных документов в панели метрик Manticore RT равен, например, 117 док.. Вы делаете пару кликов по выдаче — веер на лету рассчитывает дельту свободного места до потолка емкости графа (MAX_CAPACITY = 20), Паук моментально выкачивает новые целевые страницы из интернета, зашивает их в индекс, и счетчик на глазах всей аудитории вырастает до 120 док.. Поисковик растет и умнеет сам с каждым кликом!
🛡️ 4. Автономный «Мусорный Пресс» (Защита сервера от разрыва по объему)
Когда мы запустили веерное дообучение, счетчик базы в панели метрик внезапно начал безостановочно расти: 120, 150, 193 документов! Выяснился интереснейший высоконагруженный нюанс.
Когда пользователь ищет, например, слово «майка», наш асинхронный сетевой веер мгновенно находит 17 уникальных ссылок. Бэкенд в main.py, не теряя времени, нарезает под них пустые строки‑заготовки в Manticore, увеличивая счетчик базы, и кидает их Роботу‑Пауку на скачивание. Паук идет качать страницы, но крупные маркетплейсы (Ozon, Wildberries) намертво блокируют его серверный IP, возвращая ошибки 403 Forbidden или 498. Паук молча выходит из метода, а пустые заготовки так и остаются лежать мертвым грузом в Manticore. База пухнет, а Паук об этом даже не знает.
Решение: Чтобы диск сервера не разорвало от бесконечного количества уникальных запросов, мы применили принцип единственной ответственности (Single Responsibility) и вынесли логику контроля емкости в отдельный независимый модуль cleaner.py.
Теперь наш жесткий боевой лимит (MAX_TOTAL_DOCUMENTS = 10000) охраняет автономный C++ класс‑чистильщик SBrowserCleaner. Метод очистки вызывается превентивно — на самом верхнем уровне в main.py строго перед созданием пустых заготовок веера:
# Внутри цикла веера перед REPLACE INTO заготовок:
if clean_url not in urls_result:    urls_result.append(clean_url)        # Сначала проверяем квоты диска и освобождаем место    SBrowserCleaner.maintenance_limits()         db_manager.execute_sql("REPLACE INTO links_v1 ...")
Если общая база упирается в потолок 10 000 документов, чистильщик за долю миллисекунды выполняет атомарный «естественный отбор» прямо в оперативной памяти Manticore (RAMCHUNK):
SELECT id, url FROM links_v1 ORDER BY user_click_weight ASC, id ASC LIMIT 1
Он находит один самый старый документ с нулевым или минимальным весом кликов пользователей, вырезает его через DELETE и отдает освободившееся место под свежий поисковый тренд. Робот‑Паук перестраховывается и вызывает этот же метод перед коммитом скачанных текстов. База зафиксирована в строгих границах, а полезные сайты защищены от удаления «Теорией Связей»!
Результат в продакшене
Система развернута на копеечном VPS (всего 1 CPU и 2 ГБ оперативной памяти). Благодаря легким индексам Manticore, вся экосистема в рантайме потребляет скромные 375 Мегабайт RAM, оставляя остальное под кэш графа.
Повторные поисковые запросы отдаются из локальной базы за рекордные 0.433 миллисекунды! При этом в фоне вовсю обучается закрытая база «Теории Связей» Константина, накапливая поисковую ценность на основе кликов.
Пощупать Киберпанк‑поиск вживую и проверить скорость можно прямо сейчас: https://skewer‑api.ru/
Посмотреть видео: https://youtu.be/2ZxTsTUFQzY