Привет, Хабр! Вещает Ильсур Мингазов — тестировщик компании TravelLine. Мы разрабатываем платформу автоматизации и инструментов хоспиталити. Мы стараемся делать жизнь отельера легче, проще и более прибыльной.
Более чем за 15 лет существования продукта у нас накопился большой набор автотестов, порядка 6500 E2E‑тестов. Мы и раньше понимали, что тестовую базу нужно актуализировать, но аудит такого объема — это долгая и трудоемкая работа, для которой необходимы ресурсы.
Триггером для аудита стал запланированный переход автотестов с Java на.NET. Для перехода на новый стек были свои причины, на которых в рамках этой статьи подробно останавливаться не будем.
Когда появилась необходимость переносить тесты на другой стек, стало понятно: просто переписать всё «как есть» будет неправильно. Так мы перенесем не только полезные проверки, но и весь накопленный технический долг. Поэтому перед переносом мы решили провести детальный аудит: понять, что стоит переносить, что нужно чинить, что лучше спустить на уровень integration/API, а что можно признать дублем или удалить.
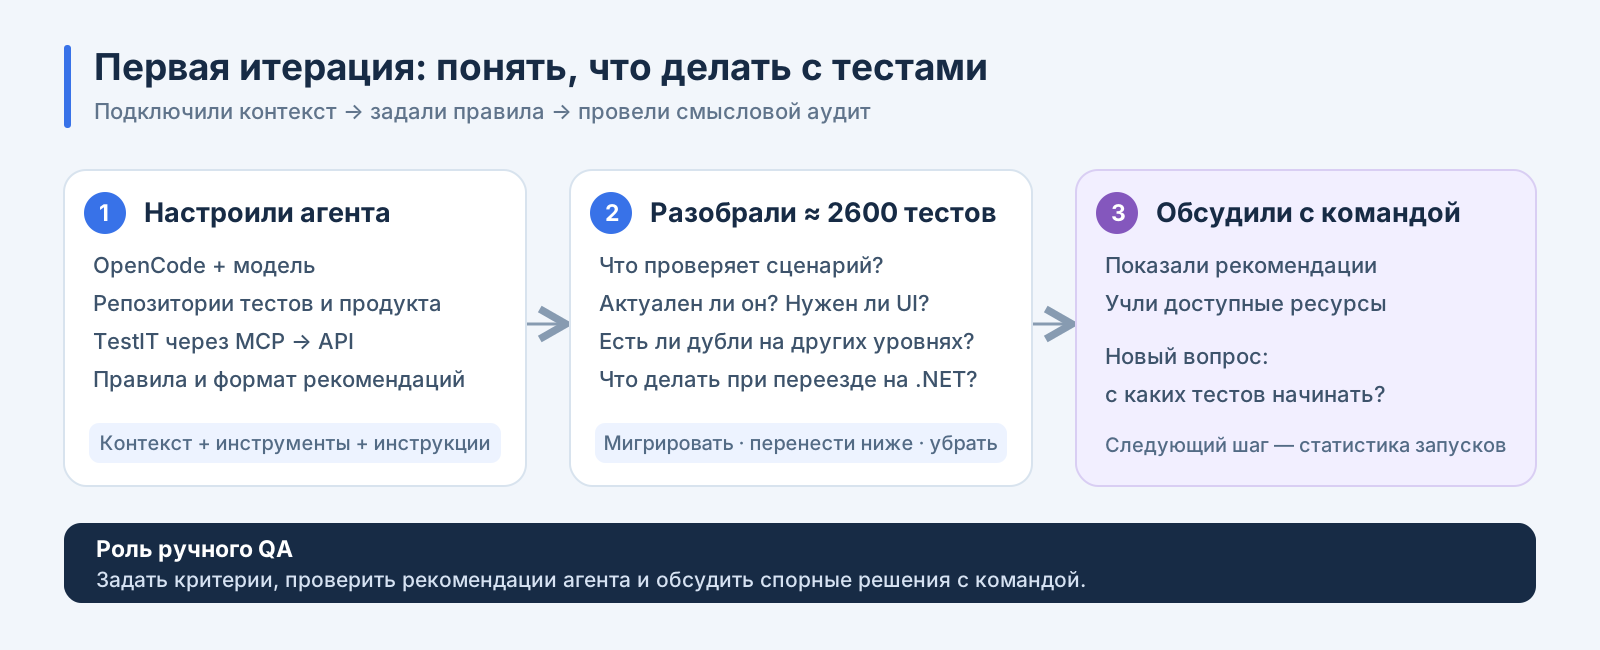
Чтобы ускорить этот процесс, я подключил ИИ‑агента. В статье расскажу, как мы его настроили, какие задачи ему давали и как он помогал мне, ручному тестировщику, разбирать автотесты секция за секцией. В статье описан опыт одной команды. Названия внутренних сущностей и идентификаторы обезличены, объемы тестовой базы округлены.
Сборка ИИ‑аудитора
Для аудита автотестов агенту недостаточно просто «скормить» названия сценариев или выгрузку из TMS. Чтобы принимать решения об оптимизации, ему требовался полный контекст системы — от исходного кода продукта до статистики запусков.
Для аудита мы настроили агента в OpenCode, а чтобы обеспечить ему автономную работу со всеми данными, развернули рабочее окружение:
Локальные репозитории: Склонировали репозиторий продукта и проект с автотестами на локальную машину. OpenCode самостоятельно изучал структуру локальных папок, позволяя агенту искать методы, классы и сопоставлять вызовы без ручного копирования кода в контекст.
Интеграция с TestIT через MCP: На первой итерации мы пробовали прямые запросы к API, но затем перевели взаимодействие на MCP‑сервер (Model Context Protocol). Агент вызывал готовые инструменты MCP, а сервер под капотом ходил в API TestIT, забирая нужные сущности, метаданные и прогоны.
Выбор модели (LLM): В каталоге OpenCode протестировали несколько доступных моделей. От легковесных Flash‑версий отказались сразу: на задачах сопоставления архитектуры и сложной логики они часто теряли детали. В итоге остановились на GPT-5.5 — она отлично удерживала длинный системный промпт с правилами тестовой пирамиды, точно использовала MCP‑тулы и не галлюцинировала при анализе связей между тестами и кодом.
Системный промпт и контракт ответа: Четко зафиксировали правила анализа (критерии деления тестов на E2E и integration) и строгий формат markdown‑отчета, чтобы исключить «воду».
Сложность возникла при настройке агента с TestIT. В интерфейсе я видел привычное дерево: проект, секции, подсекции, тесты. Но когда попросил агента разобрать одну из секций, он вернул мне неполный список. Я сравнил его ответ с TestIT и понял, что нет некоторых тестов: как выяснил по истории его действий и запросов, агент ориентировался на тестовые наборы — suites, а не на секции, по которым я ожидал получить результат. Здесь пришлось объяснить всё очень досконально — я отправил ему скриншот дерева с тестами, указал наше разделение на секции‑подсекции и объяснил откуда надо брать тесты по запросу, сделанному ранее. Когда результат сошелся,попросил закрепить этот порядок работы в его инструкциях. Так первая проверка оказалась проверкой самого агента.
После такой настройки и тестирования агент перестал быть просто чат‑ботом для ответов на вопрос «Что делает этот тест?». Агент сам мог собирать необходимые секции и/или тесты через MCP, читал исходники в репозиториях, сопоставлял сценарии с TestIT, находил дублирующие проверки и формировал структурированные рекомендации.
Первая итерация: мигрировать, переписать, удалить
На первой итерации мы шли от конкретных тестов. Агенту ставилась задача разобрать сценарий и присвоить ему один из статусов:
мигрировать на.NET
опустить на уровень integration/API
не переносить
Выдержка из skill.md:
Активация: Запросы на аудит, оценку покрытия и анализ папки
tests/перед переписыванием на.NET.
Алгоритм:
Сравни Java‑тесты изtests/с актуальным кодом вproduct.core/и классифицируй каждый тест по 3 категориям:
[MIGRATE_TO_NET]— актуальный сценарий, переносим в новый.NET‑фреймворк 1-в-1.
[SHIFT_TO_INTEGRATION]— бизнес‑логика/API, передать бэкендерам для интеграционных тестов.
[OBSOLETE_OR_BROKEN]— функционал удален/изменен или тест не работает, НЕ переносить.Критерии разделения тестов:
E2E (UI): критичный happy path, сквозной пользовательский путь, связка подсистем, навигация и отображение UI.
Integration (API): бизнес‑логика, расчеты, валидация комбинаций данных, сохранение настроек и лимиты — всё, где браузерный UI только замедляет прогон.
Такой формат оказался удобнее, чем простое описание. Агент не просто писал «тест выглядит корректным» или «тут проблема», а давал конкретный следующий шаг.
Например, если тест через UI проверял только создание и сохранение сущностей, он попадал в кандидаты на уровень integration. В нашей команде integration‑тесты пишут разработчики, поэтому рекомендации по переносу мы обсуждали с ними отдельно.
Один из показательных примеров — секция Transfers. В ней было 18 E2E тестов. На первый взгляд это выглядело как нормальное покрытие пользовательских сценариев: тесты проходили через интерфейс, создавали или настраивали трансферы и проверяли результат. Но после разбора агент сопоставил эти сценарии с существующими integration‑тестами и выяснил, что 15 из 18 E2E тестов по смыслу дублируют проверки, которые уже есть на более низком уровне (названия статусов были рабочие: категорию OBSOLETE_OR_BROKEN мы использовали как «не переносить»: в нее попадали в том числе дубли и избыточные UI‑проверки). Эти 15 тестов не давали уникального покрытия проверяемых бизнес‑сценариев, они проверяли то же поведение, но делали это дороже: через UI, дольше по времени и с большим риском нестабильных падений. Рекомендация по секции получилась такая:
Итог по секции Transfers:
Всего тестов: 18
[MIGRATE_TO_NET]: 3 (реальные сквозные UI‑сценарии)
[SHIFT_TO_INTEGRATION]: 0
[OBSOLETE_OR_BROKEN]: 15 (избыточный UI‑оверхед над API CRUD и дубли)
Этот пример хорошо показал, почему прямой перенос был бы ошибкой. Если бы мы просто переписали все 18 тестов на.NET, то перенесли бы 15 лишних E2E‑сценариев, которые уже были покрыты integration‑тестами. Аудит показал, что в реальности это лишняя стоимость: больше времени на прогон, больше падений для разбора и больше кода, который нужно поддерживать.
Таким образом, мы в короткий срок провели первичный аудит порядка 2600 тестов и всю проделанную работу показали технической команде. На встрече учли ограниченные ресурсы команды: продолжать развитие продукта и одновременно перерабатывать всю тестовую базу было невозможно. Поэтому решили сначала заняться сценариями с наибольшими затратами на прогон и сопровождение. Ориентировались на принцип Парето: найти небольшую группу сценариев, работа с которой потенциально даст наибольшую пользу (дольше всего идут в пайплайнах, флакают и отнимают часы на разбор логов у дежурных), и направить силы именно туда.
Но чтобы вычленить эти проблемные зоны, одного анализа структуры кода тестов было уже мало — требовались реальные метрики прогонов. Так мы перешли ко второй итерации.
Вторая итерация: статистика запусков и P85
Первая итерация помогла понять, что проверяют тесты и что с ними делать при миграции. Но оставался вопрос: с каких сценариев начинать? По коду не видно, насколько часто тест падает и сколько времени занимает в реальных прогонах. Поэтому мы дополнили аудит статистикой.
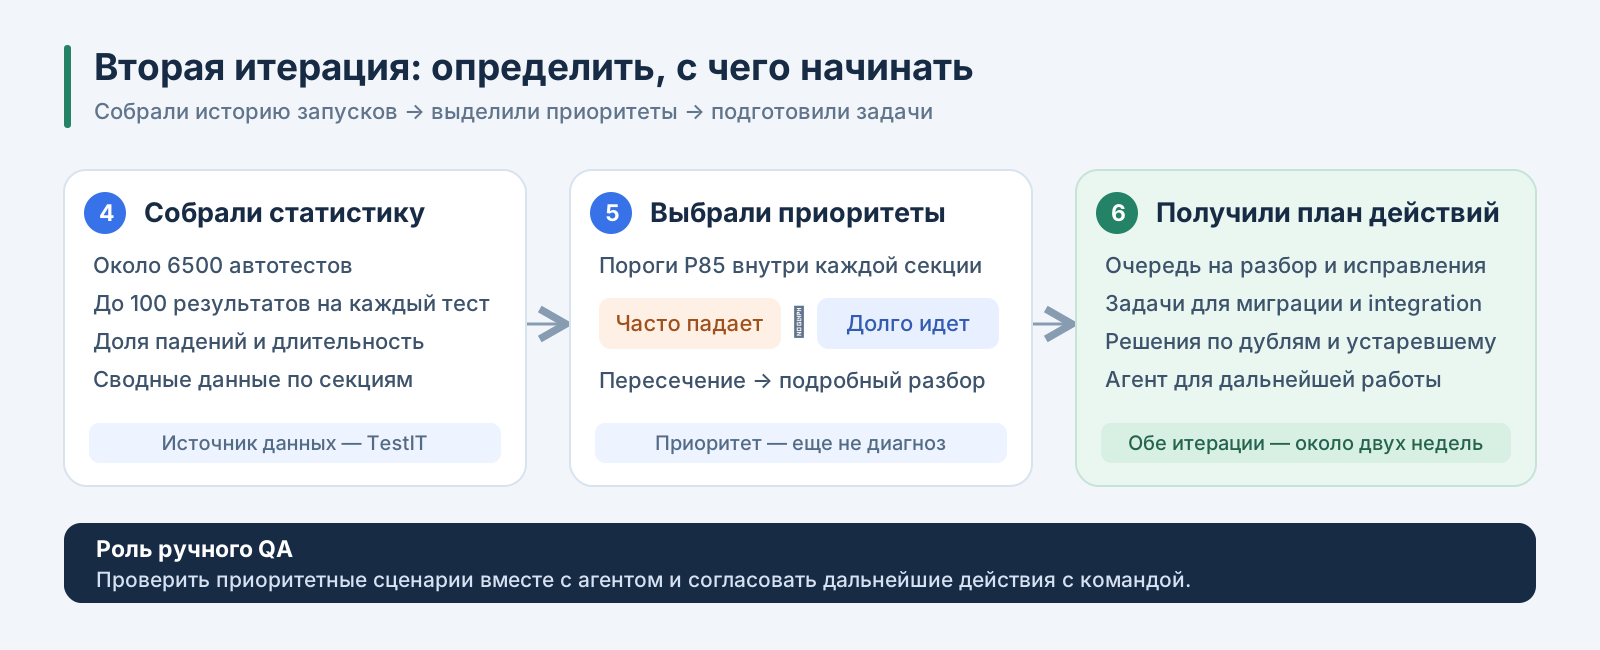
Для каждого теста запросили из TestIT до 100 последних результатов выполнения, затем сгруппировали данные по секциям. Для сравнения использовали два показателя:
Доля падений (fail rate) — число результатов Failed, деленное на общее число полученных результатов. Например, 10 падений из 100 результатов — это 10%.
Длительность успешного выполнения — P85 времени запусков со статусом Passed. Например, значение 90 секунд означает, что не менее 85% учтенных успешных запусков завершились за это время или быстрее. Время упавших запусков в расчет не включали, чтобы не смешивать нормальное выполнение с ожиданием таймаутов при сбоях.
Дальше нужно было выбрать приоритетные тесты из всей базы — около 6500 сценариев. Для этого внутри каждой секции рассчитали два порога: P85 по доле падений и P85 по показателю длительности тестов.
Если объяснить просто, P85 — граница, ниже или на уровне которой находится не менее 85% значений. Мы использовали ее, чтобы выделить тесты с относительно высокой долей падений и большой длительностью среди соседей по секции. В выборку включали значения на уровне порога и выше, поэтому при совпадении значений она могла охватывать больше 15% тестов.
В результате получили четыре группы:
тесты, выделенные только по доле падений;
тесты, выделенные только по длительности;
тесты, которые одновременно часто падают и долго выполняются;
остальные тесты, не попавшие ни под один критерий.
В первую очередь разбирали пересечение — часто падающие и одновременно долгие тесты. Затем переходили к остальным выделенным группам.
Сам по себе долгий тест не обязательно плох: его длительность может быть оправдана важным пользовательским сценарием. Частые падения тоже не доказывают дефект автотеста — причиной может оказаться продукт или окружение. Поэтому статистика не заменяла анализ, а помогала сформировать очередь на него.
Дальше агент разбирал приоритетные сценарии: сопоставлял ошибки с кодом, искал повторяющиеся причины и готовил рекомендации для обсуждения с командой.
Приведу и здесь показательный пример — секция reports (отчеты). Агент дал срез по всей секции:
245 тестов;
24 051 запусков;
1598 падений;
fail rate — 6,6%;
29 тестов попадали в проблемную зону только по падениям;
28 тестов попадали в проблемную зону только по длительности;
9 тестов одновременно были и падающими, и долгими.
Для девяти приоритетных тестов агент подготовил подробный табличный отчет в DOCX и Markdown. Идентификаторы и названия сценариев ниже обезличены; числовые показатели сохранены:
caseId | Сценарий | Java test | Passed | Failed | P85 passed, sec |
|---|---|---|---|---|---|
10 001 | Изменение параметров заказа |
| 87 | 11 | 131.0 |
10 002 | Отмена операции: частичный перерасчет |
| 86 | 11 | 102.0 |
10 003 | Фильтрация данных по параметрам |
| 88 | 10 | 308.0 |
10 004 | Проверка таймзоны в отчетах |
| 78 | 10 | 170.9 |
10 005 | Проверка периодичности в выгрузках |
| 75 | 11 | 162.0 |
10 006 | Подтверждение статуса сущности |
| 74 | 11 | 144.1 |
10 007 | Финализация оформления заказа |
| 75 | 9 | 169.8 |
10 008 | Отправка транзакционных уведомлений |
| 70 | 19 | 240.1 |
10 009 | Обработка платежа и проведение возврата |
| 63 | 33 | 253.7 |
Именно эти 9 тестов стали приоритетом для дальнейшего разбора: сценарии соответствовали обоим критериям — они одновременно замедляли прогон и создавали шум при анализе результатов. Так вместо общего «нужно заняться отчетами» у команды появился конкретный список проблемных сценариев.
Заключение
На всю работу ушло около двух недель. За это время мы провели первичный смысловой аудит примерно 2600 автотестов, а по всей базе — около 6500 тестов — собрали статистику запусков. Подготовили рекомендации по миграции и выделили сценарии для приоритетного разбора.
Результат не остался просто отчетом:
Проработали и убрали дублирующие тесты.
В секции скриншотного тестирования убрали около 450 неактуальных тестов.
По части секций обсудили результаты с разработчиками и завели задачи на integration‑тесты.
Для команды автоматизации подготовили задачи на перенос проверенных сценариев.
Остальные секции поставили в очередь на обсуждение с разработчиками.
Для меня как ручного тестировщика главным результатом стало то, что задача, до которой долго не доходили руки, превратилась в конкретный план действий. Вместо большого списка «всё это нужно переписать на.NET» у нас появились обоснованные решения: что переносить, что исправлять, что проверять ниже уровня UI и от чего отказаться.
Агент взял на себя трудоемкую часть: поиск файлов, чтение кода, сопоставление проверок и сбор статистики. Моя работа заключалась в том, чтобы задавать критерии, проверять его выводы и обсуждать спорные решения с командой. Кроме результатов аудита, у нас остался настроенный агент с доступом к тестовой базе и правилами ее анализа. Теперь к нему можно возвращаться с конкретными задачами: разобрать падение, найти существующее покрытие или оценить новый сценарий. Контекст больше не нужно каждый раз собирать с нуля.